Comment extraire les rapports de laboratoire QC
vers Excel pour le SPC
Le véritable coût de la saisie manuelle des données de laboratoire QC n'est pas la frappe. C'est le délai entre la sortie du dernier résultat de test de l'instrument et la signature du lot par une personne habilitée. Dans une usine de fabrication typique, ce délai est de 4 à 8 heures—non pas parce que le test est long, mais parce que les données doivent être transcrites d'un rapport PDF vers un tableur, puis vérifiées par un superviseur, puis contrôlées à nouveau par l'AQ avant toute décision de libération. Pendant ce temps, la production attend. Chaque heure de retard après qu'un lot est prêt à expédier coûte de l'argent réel en fonds de roulement, en espace d'entrepôt et en échéances clients. L'étape de transcription—celle où un technicien saisit des chiffres d'un relevé d'instrument dans Excel—est le goulot d'étranglement que personne ne budgétise.
Points clés
- 40 % des enregistrements QC à double saisie contiennent des erreurs, quel que soit celui qui les tape — les erreurs de transcription dans votre classeur SPC ne sont pas un problème de négligence, elles sont une garantie structurelle.
- Chaque signal hors contrôle fantôme déclenché par une erreur de frappe habitue vos opérateurs à ignorer la carte SPC — et une fois qu'ils ont appris qu'elle crie toujours au loup, les vrais signaux qualité disparaissent dans le bruit.
- Vos techniciens ont étudié la chimie et l'ingénierie pour réaliser des tests, pas pour taper des chiffres — remplacez 90 minutes de transcription quotidienne par une validation de 10 minutes et les heures récupérées retournent à la science.
Le coût caché de la transcription manuelle des données de laboratoire
Demandez à un responsable QC ce qui ralentit la libération des lots : il répondra « l'attente des résultats d'analyse ». Or les résultats sont prêts quelques minutes après l'injection de l'échantillon dans l'instrument. Ce qu'il attend vraiment, c'est la saisie des données. Le HPLC Shimadzu termine sa série, imprime (ou exporte) un rapport PDF avec 15 paramètres d'analyse. Le titrateur Mettler Toledo achève son analyse et génère un autre PDF. Le testeur de traction Instron en produit un troisième. Quelqu'un doit maintenant lire les chiffres sur chacun de ces rapports et les saisir dans un classeur Excel. Cette étape prend systématiquement plus de temps que les analyses elles-mêmes et introduit des erreurs qui se propagent en aval.
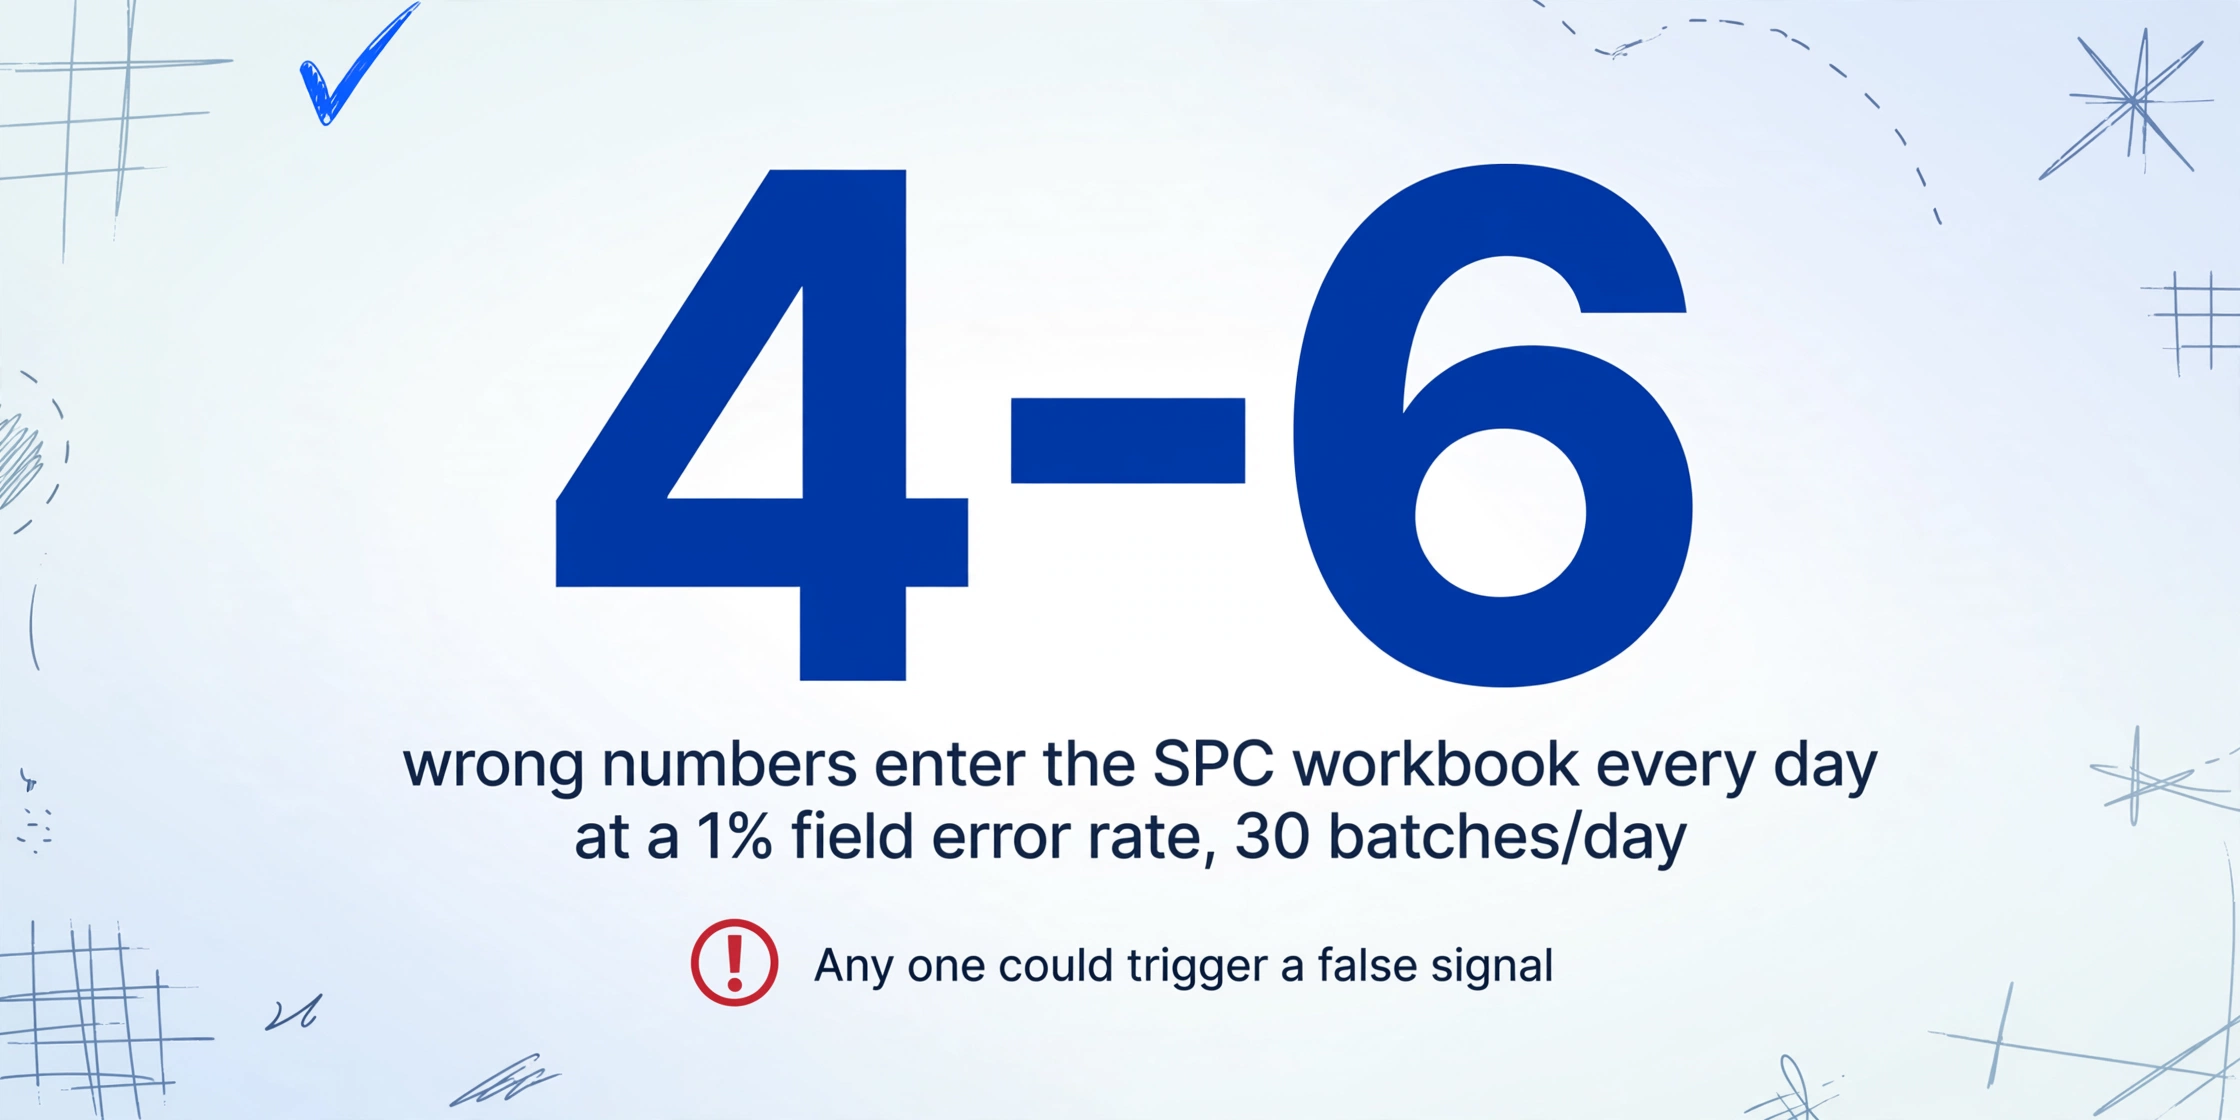
Les taux d'erreur sont bien documentés. Une étude citée par Quality Magazine établit le taux d'erreur de base de la saisie manuelle à environ 1 % par champ. Cela semble gérable jusqu'à ce que l'on fasse le calcul : un rapport de libération de produit fini peut comporter 15–20 paramètres d'analyse. Si un laboratoire traite 30 lots par jour, cela représente 450–600 saisies de champs. Un taux d'erreur de 1 % par champ signifie que 4–6 chiffres erronés entrent chaque jour dans le classeur SPC—n'importe lequel pouvant déclencher un signal hors contrôle, un blocage injustifié de lot ou la libération d'un matériau qui aurait dû être refusé.
Et c'est le scénario optimiste. Les laboratoires QC de fabrication fonctionnant sur papier utilisent un système de saisie en deux phases : le technicien note une mesure sur papier près de l'instrument, puis quelqu'un—souvent le même technicien ou une autre personne—transcrit cette mesure dans le tableur ou la base de données. Selon Beamex, lorsque les données passent par deux points de saisie manuelle, environ 40 % des enregistrements finissent par contenir au moins une erreur. Une usine réalisant 10 000 étalonnages ou essais qualité par an en saisie en deux phases génère statistiquement 4 000 points de données erronés.
Pour un seul laboratoire QC traitant 30 essais de libération de lot par jour, un taux d'erreur de 1 % au niveau des champs signifie 120–180 erreurs de transcription par mois—chacune nécessitant une investigation, une reprise et un retard des décisions de libération.
Comment les rapports de laboratoire QC passent de l'instrument au tableur aujourd'hui
Entrez dans un laboratoire QC de fabrication et le flux de travail est remarquablement cohérent d'un secteur à l'autre—pharmaceutique, automobile, transformation alimentaire, dispositifs médicaux, chimie. Un instrument comme un Shimadzu HPLC ou un Mettler Toledo Karl Fischer titrator termine son analyse et génère un rapport. Dans les laboratoires modernes, il s'agit d'un PDF exporté depuis le logiciel de contrôle de l'instrument—Shimadzu LabSolutions, Mettler Toledo LabX ou Agilent OpenLab. Dans les installations plus anciennes, c'est une impression thermique collée dans un cahier de laboratoire. Dans les deux cas, les données sont enfermées dans un document qui ne peut être interrogé, représenté graphiquement ni analysé statistiquement.
L'étape suivante est la transcription. Un technicien QC lit le rapport et saisit les valeurs dans un tableur : nom du test, limite de spécification, valeur mesurée, conforme/non conforme. Si l'usine utilise Minitab, InfinityQS ProFicient ou JMP pour le SPC, les données peuvent aller directement dans ces plateformes. Mais dans les petites structures—ce qui représente la plupart des usines de fabrication—la destination est un classeur Excel avec des modèles de cartes de contrôle, souvent construit des années plus tôt par un ingénieur qualité qui a depuis quitté l'entreprise.
Cette étape de transcription se situe à l'intersection de deux systèmes qualité qui n'ont jamais été conçus pour communiquer entre eux : les instruments de laboratoire qui génèrent les données, et la plateforme SPC qui les consomme. Entre eux se trouve un pont humain, et c'est là que se concentrent les erreurs et les retards. L'American Society for Quality (ASQ) estime que le coût de la mauvaise qualité (COPQ) absorbe 15 % à 40 % du chiffre d'affaires total d'un fabricant—et une part significative provient de défaillances d'intégrité des données qui remontent à la transcription manuelle.
Les cadres réglementaires renforcent l'importance de ce point. ISO 9001:2015 Clause 7.5 exige que les organismes conservent les informations documentées comme preuve de conformité, y compris la traçabilité jusqu'à la personne autorisant la libération. ISO/IEC 17025:2017 Section 8.4 impose que les enregistrements des laboratoires d'essai contiennent suffisamment d'informations pour répéter un essai dans des conditions aussi proches que possible de l'original—et que toute correction d'un enregistrement ne masque pas l'entrée originale. FDA 21 CFR Part 211 Subpart J exige que les enregistrements de production par lots et de contrôle en laboratoire soient examinés et approuvés par une unité de contrôle qualité avant la libération du lot. Lorsque les données sont transcrites manuellement, chacune de ces exigences devient plus difficile à satisfaire. Un auditeur vérifiant la traçabilité peut trouver une valeur dans le journal de l'instrument et une autre dans le tableur transcrit, sans justification documentée de la différence.
Ce n'est pas seulement un problème de paperasse. Selon Tulip, EY estime que plus de 70 % de l'effort QA est consacré à la revue de la documentation—pas aux investigations, pas à l'amélioration des processus, juste à la vérification des enregistrements. La libération retardée des lots figure parmi les trois principales causes de perturbation de la chaîne d'approvisionnement dans la fabrication pharmaceutique. Chaque heure qu'un lot passe en quarantaine à attendre la vérification des données est une heure de fonds de roulement gelé.
Ce que l'extraction sémantique change pour la saisie des données de laboratoire
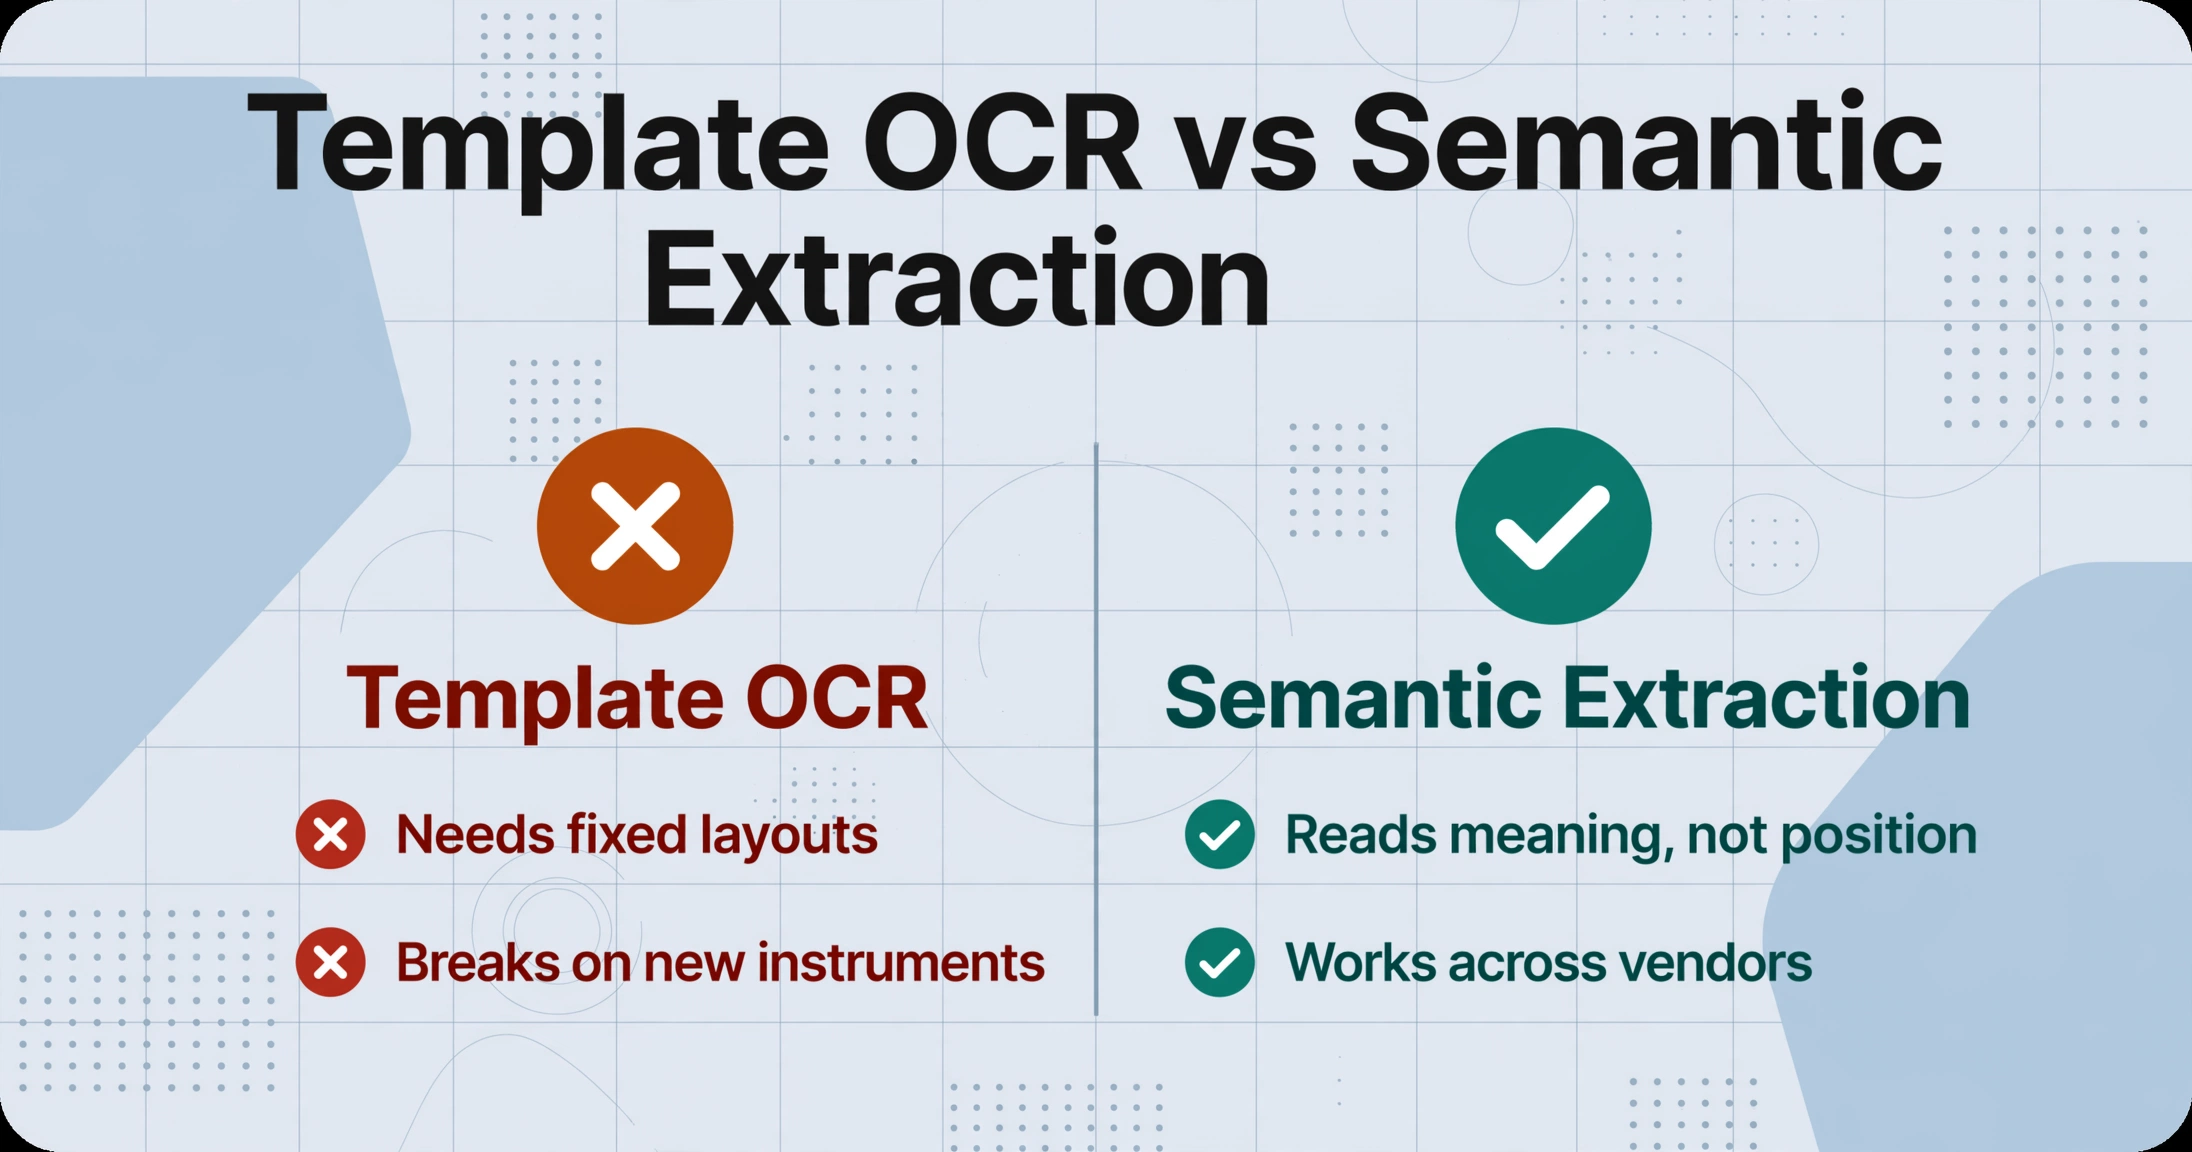
Le véritable goulot d'étranglement n'est pas que les rapports QC soient difficiles à lire. C'est que l'approche traditionnelle pour les automatiser—l'OCR par modèle—est mal adaptée à la réalité d'un laboratoire multi-instruments. Les modèles fonctionnent quand tous les documents se ressemblent. Or un rapport Shimadzu HPLC, une impression de titrateur Mettler Toledo et un PDF d'essai de traction Instron ont des mises en page fondamentalement différentes : positions de colonnes différentes, conventions de nommage des champs différentes, unités de mesure différentes. Créer et maintenir un modèle d'analyse pour chaque combinaison instrument-modèle-rapport est un travail à plein temps en soi—c'est pourquoi la plupart des laboratoires ne s'en donnent pas la peine et restent à la saisie manuelle.
L'extraction sémantique adopte une approche différente. Au lieu de définir où se trouvent les données sur une page (ligne 3, colonne 2), vous précisez ce que vous recherchez (une valeur appelée « pH », « Résistance à la traction » ou « % de dosage »). L'IA lit le document comme le ferait un technicien—en comprenant ce que les mots signifient en contexte, et non en faisant correspondre des coordonnées. Cette approche est parfois appelée Custom Column Extraction : vous saisissez les noms de champs souhaités comme en-têtes de colonnes—« Nom du test », « Limite de spécification », « Valeur mesurée », « Conforme/Non conforme »—et l'IA localise les valeurs correspondantes sur chaque rapport, quel que soit leur emplacement.
Cela importe pour les laboratoires QC car les mises en page des rapports varient non seulement entre fournisseurs d'instruments, mais aussi entre méthodes d'essai exécutées sur le même instrument. Un rapport Shimadzu HPLC pour un test de dosage a une structure de colonnes différente de celle d'un profil d'impuretés, même si les deux proviennent du même logiciel LabSolutions. Avec l'extraction par modèle, chaque variante nécessite son propre modèle. Avec l'extraction sémantique, le même ensemble de noms de colonnes fonctionne pour toutes—car l'IA fait correspondre le sens, pas la position.
L'extraction sémantique fait passer le paradigme d'une approche basée sur la position à une approche basée sur le sens : vous définissez le résultat souhaité, et l'IA lit chaque document pour le trouver—aucun modèle à créer, aucune règle par format à maintenir.
Il ne s'agit pas d'une capacité théorique. ImageToTable.ai utilise des modèles vision-langage (VLM) pour réaliser une extraction sans modèle : il n'est pas nécessaire de créer ou de maintenir des modèles d'analyse pour le format de rapport de chaque instrument. Et c'est Zero-Setup : vous n'avez pas besoin de collecter des rapports d'exemple, d'annoter des données d'entraînement ou de configurer des règles d'extraction. Importez les PDF, nommez vos colonnes, et l'IA extrait les valeurs. Quand Agilent modifie la mise en page de ses rapports via un correctif logiciel l'année prochaine, les mêmes noms de colonnes fonctionnent toujours—car l'IA lit par le sens, pas par les coordonnées. (Pour une vue d'ensemble de l'application de cette technologie aux documents de laboratoire, consultez le guide complet de l'extraction des données de rapports de laboratoire.)
Étape 1 : Définissez vos paramètres d'essai comme colonnes d'extraction
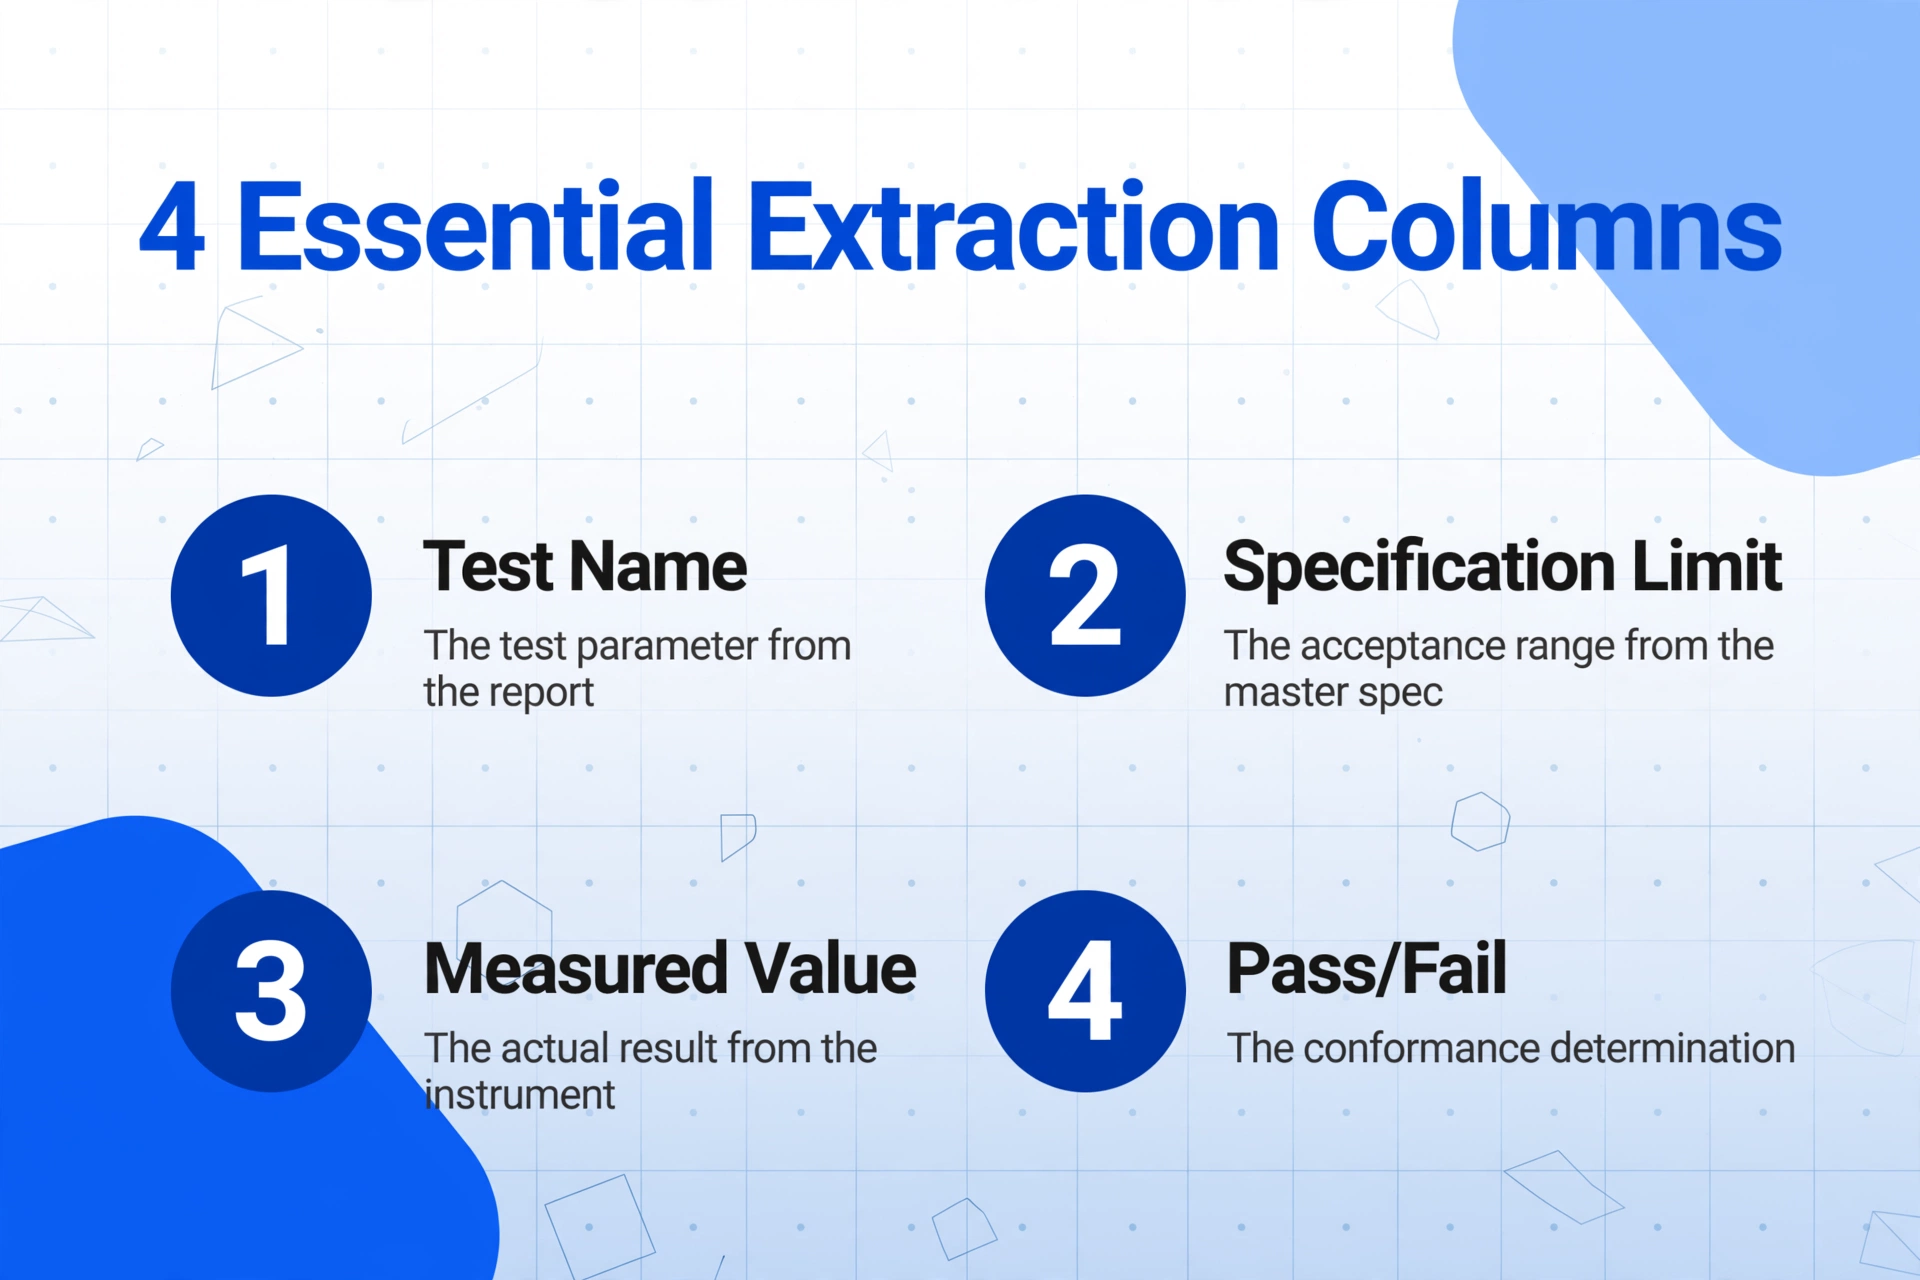
Les colonnes que vous nommez sont celles que vous obtenez. C'est la décision de conception la plus importante de tout le flux de travail—réussissez-la et le résultat alimente directement votre classeur SPC sans reformatage.
Pour un rapport d'essai de libération de produit fini, les colonnes essentielles sont :
| Nom de la colonne | Ce qu'elle capture | Exemple de valeur |
|---|---|---|
| Test Name | Le paramètre d'essai issu du rapport | pH, Viscosity, Assay, Dissolution |
| Specification Limit | La plage d'acceptation issue du cahier des charges principal | 5.0–7.0, NLT 98.0% |
| Measured Value | Le résultat réel fourni par l'instrument | 6.32, 99.1% |
| Pass/Fail | La détermination de conformité | Pass, Fail |
Pour les essais en cours de fabrication, vous pouvez ajouter « Sample Point », « Target » et « Operator ». Pour l'inspection des matières premières, ajoutez « Lot Number » et « Supplier ». Les noms de colonnes sont libres—vous les rédigez comme vous nommeriez des colonnes dans un classeur Excel, et l'IA les met en correspondance sémantique avec ce qu'elle trouve dans chaque rapport.
Deux conseils pratiques qui font une différence mesurable :
Utilisez des colonnes calculées pour l'auto-arbitrage. Au lieu d'extraire le statut Pass/Fail du rapport (qui n'est pas toujours imprimé), définissez-le comme colonne calculée : l'IA compare Measured Value à Specification Limit et produit automatiquement « Pass » ou « Fail ». Cela élimine les jugements subjectifs de l'étape d'extraction—la règle est appliquée de manière cohérente sur chaque rapport. Les colonnes calculées peuvent aussi gérer l'arithmétique : définissez une colonne comme « Line Total (Qty × Unit Price) » pour les composants matière, ou « Deviation (Measured − Target) » pour les contrôles en cours de fabrication.
Alignez les chiffres significatifs sur votre méthode d'essai. ASTM E29, la pratique standard pour l'utilisation des chiffres significatifs dans les données d'essai, précise que les valeurs rapportées doivent refléter la précision de la méthode d'essai, et que les limites de spécification et les valeurs mesurées doivent être exprimées avec le même nombre de chiffres significatifs afin d'éviter des affirmations de précision trompeuses. Si votre méthode de dissolution rapporte à une décimale, vos colonnes d'extraction doivent capturer (et vos graphiques SPC doivent afficher) à une décimale—et non les six décimales que la sortie brute de l'instrument pourrait fournir. Utilisez la fonctionnalité Format Requirement (disponible pour les utilisateurs connectés) pour définir les exigences de format par colonne : nombre de décimales, conventions d'unités et plages de valeurs attendues.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Étape 2 : Traiter les rapports de plusieurs instruments en un seul lot
Une décision de libération de produit fini repose rarement sur un seul rapport. L'unité QC a besoin du dosage HPLC, du résultat d'humidité Karl Fischer, du profil de dissolution, de la mesure de pH et du relevé d'inspection visuelle—chacun provenant probablement d'un instrument différent, chacun dans un format PDF différent. Regrouper manuellement ces éléments en une ligne de tableur par lot est fastidieux, même lorsque tout se passe bien. Lorsqu'un rapport arrive en retard parce qu'un instrument était en cours d'utilisation, la compilation s'étale sur plusieurs heures.
Le traitement par lots résout ce problème en considérant le lot de rapports, et non les documents individuels, comme unité de travail. Téléchargez tous les rapports d'un lot donné en une seule fois—glissez-déposez les PDF exportés depuis Shimadzu LabSolutions, les impressions scannées d'instruments plus anciens, voire les photos prises au téléphone des panneaux d'affichage d'appareils de test autonomes—et le système les traite ensemble. Le résultat est un tableau unique où chaque ligne correspond à un rapport, avec les colonnes remplies à partir de l'extraction. Une seconde feuille de résultats fusionne le tout en une ligne par lot, avec les résultats de test en colonnes.
Il s'agit d'un flux de travail fondamentalement différent des outils d'extraction mono-document qui traitent un fichier à la fois. Dans une conception Traitement par lots en priorité, le traitement multifichier est la norme, et non une réflexion après coup. Lorsque vous téléchargez 20 rapports, vous récupérez un seul fichier Excel—et non 20 fichiers séparés que vous devez ensuite copier-coller dans un tableur maître. (Pour des scénarios connexes impliquant le traitement par lots de documents dans l'industrie manufacturière, consultez notre guide sur le traitement par lots des factures de matières premières pour le suivi des coûts de fabrication.)
Flux de travail réel en laboratoire : L'équipe du matin exécute tous les tests de libération entre 7 h et 10 h. À 10 h 15, tous les rapports d'instruments sont disponibles au format PDF. Téléchargez-les en un seul lot, spécifiez les noms de colonnes une seule fois, et l'extraction s'exécute simultanément sur chaque rapport. À 10 h 17, le tableau Excel consolidé est prêt pour validation. Le temps autrefois consacré à la saisie est désormais consacré à la vérification—une tâche qui exige du jugement plutôt que des frappes au clavier.
Étape 3 : Valider les résultats avant leur intégration dans votre carte SPC
Aucun système d'extraction—IA ou autre—n'est précis à 100 % sur 100 % des documents. L'approche responsable consiste à intégrer un point de contrôle de validation dans le flux de travail : une étape rapide de vérification humaine entre l'extraction et l'import dans le SPC, et non un re-contrôle ligne par ligne de tout ce que l'IA a produit.
L'étape de validation doit être rapide, car l'IA met en évidence ce qui nécessite une attention particulière. Lorsqu'une valeur mesurée sort de la limite de spécification, la colonne Pass/Fail contient « Fail » et cette ligne est signalée visuellement. Lorsque l'IA a un doute sur un champ donné (lecture à faible confiance d'un tirage maculé ou d'une mise en page de rapport inhabituelle), la cellule est mise en surbrillance pour vérification manuelle. Vous examinez les exceptions, pas l'intégralité du tableau. C'est le même principe que la revue par exception—une méthode de plus en plus adoptée dans la libération des lots pharmaceutiques, où l'AQ se concentre sur les écarts signalés plutôt que de vérifier chaque champ conforme.
Ce qui constitue une étape de validation raisonnable dépend de votre environnement réglementaire. Pour un laboratoire accrédité ISO 17025, chaque valeur alimentant un certificat d'analyse (CoA) doit être traçable jusqu'aux données brutes de l'instrument, et toute correction apportée à une valeur extraite doit être documentée. La sortie du système d'extraction sert de saisie initiale des données—analogue à ce qu'un technicien saisirait—et les valeurs validées constituent l'enregistrement officiel. Pour les laboratoires non accrédités, un contrôle ponctuel de 10–20 % des lignes suffit souvent, combiné à un examen complet de toutes les exceptions signalées.
Un flux de travail pratique pour les environnements réglementés : exportez les données extraites par l'IA, examinez les lignes signalées, apportez les corrections nécessaires, puis enregistrez la version révisée comme enregistrement contrôlé. La sortie d'extraction d'origine est conservée comme artefact de données intermédiaire—non comme enregistrement officiel, mais utile pour reconstituer la piste d'audit en cas de questions.
Étape 4 : Alimenter votre plateforme SPC avec des données propres
C'est ici que le flux d'extraction justifie son intérêt. La sortie Excel validée est constituée de données structurées : les en-têtes de colonnes correspondent aux noms des paramètres SPC, les lignes correspondent aux lots ou aux échantillons, et les valeurs numériques sont cohérentes et formatées. Elle peut être chargée directement dans le système SPC utilisé par l'usine.
Si vous utilisez Minitab Real-Time SPC (la référence du secteur, avec 50 ans de méthodologie statistique), le fichier CSV ou Excel exporté peut être importé directement dans un projet de carte de contrôle. Définissez vos sous-groupes, affectez les colonnes, et les cartes Xbar-R ou I-MR se mettent à jour avec les nouvelles données. L'intégration de Minitab avec SAP Digital Manufacturing signifie que, pour les opérations plus importantes, le flux de données peut aller de l'extraction à l'ERP puis au tableau de bord SPC sans intervention humaine.
Si vous utilisez InfinityQS ProFicient (le leader du SPC sur site, déployé dans l'aérospatiale, l'automobile et la fabrication de dispositifs médicaux), le format de données structurées correspond aux spécifications d'import de données. Le module de collecte de données de ProFicient accepte les fichiers délimités, la sortie d'extraction ne nécessite donc aucune transformation.
Si vous utilisez Excel avec QI Macros ou un modèle Xbar-R développé en interne—ce que font de nombreux fabricants de petite et moyenne taille—les données extraites se collent directement dans la grille de données du modèle. Les formules de la carte de contrôle référencent les cellules de données ; la nouvelle sortie d'extraction remplace les valeurs du lot précédent. Aucune ressaisie, aucune correction de format, aucune recherche de la cellule contenant le résultat de pH du lot 4267.
Pour les laboratoires traitant plusieurs produits avec des panels de tests différents, maintenez un modèle de colonnes d'extraction distinct par produit. Les définitions de colonnes (quels tests, quelles spécifications, quelles règles de format) restent cohérentes d'un lot à l'autre ; seuls les PDF de rapports changent. Cela préserve la continuité de la carte SPC—les limites de contrôle calculées à partir des données historiques restent valides car les données qui les alimentent suivent la même structure à chaque fois.
Ce qui change lorsque les données de contrôle qualité circulent sans transcription
Éliminer l'étape de transcription ne fait pas que gagner du temps de saisie. Cela reconfigure la relation entre le laboratoire, l'assurance qualité et la production.
La libération des lots s'accélère. Lorsque les données de test passent de l'instrument au classeur SPC en quelques minutes plutôt qu'en quelques heures, le réviseur QA peut commencer son travail pendant que le laboratoire exécute encore le lot suivant. La revue passe de « quelqu'un a-t-il saisi cela correctement » à « ces données nous disent-elles ce que nous devons savoir sur le lot ». Pour une usine réalisant 20 libérations de lots par semaine, récupérer ne serait-ce que 2 heures par lot représente 40 heures de capacité de production libérées—l'équivalent d'un poste supplémentaire de production sans ajouter d'équipement ni de personnel.
Les signaux SPC deviennent plus fiables. Les cartes de contrôle ne valent que par les données qui les sous-tendent. Lorsqu'une erreur de transcription place un point de données en dehors des limites de contrôle, elle déclenche une investigation hors contrôle qui ne trouve rien—gaspillant le temps d'ingénierie sur un signal fantôme. Sur des mois d'exploitation, ces fausses alertes érodent la confiance des opérateurs dans le système SPC. Lorsque les opérateurs croient que la carte de contrôle « crie toujours au loup », ils ignorent les vrais signaux. Le flux direct de données de l'instrument à la carte SPC élimine la source la plus courante de signaux hors contrôle parasites : les erreurs de frappe humaines.
La préparation aux audits cesse d'être une urgence. Les auditeurs ISO 9001 et ISO 17025 recherchent l'intégrité des données—les principes ALCOA+ : Attribuable, Lisible, Contemporain, Original, Exact. Un tableur transcrit manuellement enfreint « contemporain » (les valeurs peuvent être saisies des heures après la mesure) et « original » (la sortie brute de l'instrument est l'original, le tableur est une copie). Un flux d'extraction qui traite les rapports au moment de la fin du test et horodate la sortie crée une piste de données contemporaine et attribuable. Lorsque l'auditeur demande « montrez-moi les données brutes du lot 3267 de mars », vous pouvez produire le PDF original de l'instrument et l'horodatage d'extraction, et non un tableur saisi manuellement sans chaîne de traçabilité.
Le temps des techniciens se réoriente vers un travail à plus forte valeur. Les techniciens QC n'ont pas étudié la chimie ou l'ingénierie pour passer leurs postes à taper des chiffres. Libérés de la transcription, ils peuvent réaliser plus de tests, examiner les résultats limites, entretenir les instruments ou se former à de nouvelles méthodes. Pour un laboratoire comptant 4–6 techniciens passant chacun 45–90 minutes par jour à la saisie de données, les heures récupérées par semaine sont de 15–27—environ la moitié de la capacité productive d'un employé à temps plein, redirigée de la frappe vers la science.
Les entreprises dotées de systèmes de gestion de la qualité matures atteignent 92 % de livraisons dans les délais contre 74 % pour celles qui n'en ont pas, selon les recherches de l'ASQ. L'écart ne tient pas à des machines plus rapides—il tient au fait que les données circulent à la vitesse des décisions plutôt qu'à celle de la frappe.
Pour un aperçu plus large de la façon dont l'extraction basée sur l'IA se compare aux approches traditionnelles dans les environnements de fabrication, consultez notre sélection d'outils d'extraction de documents pour la fabrication et notre guide pratique sur l'extraction des données de rapports d'inspection qualité vers Excel.
FAQ : Extraire les rapports de laboratoire QC vers Excel
Cet outil peut-il traiter des rapports provenant de différents fabricants d'instruments—Shimadzu, Agilent, Mettler Toledo ?
Oui. L'extraction étant sémantique (fondée sur la compréhension de la signification d'une valeur) plutôt que positionnelle (fondée sur son emplacement sur la page), les mêmes noms de colonnes fonctionnent sur les rapports de différents instruments. Une valeur « pH » sur un rapport Mettler Toledo et une valeur « pH » sur un rapport Shimadzu seront toutes deux capturées, même si les deux rapports ont des mises en page totalement différentes. C'est l'avantage pratique de l'extraction sans modèle dans un laboratoire multi-instruments.
Que faire si nos rapports d'instruments sont des impressions papier scannées, et non des PDF numériques ?
Le système traite les documents scannés et les photos de la même manière que les PDF natifs. La photo prise au téléphone d'une sortie d'imprimante thermique, le scan d'une entrée manuscrite dans un cahier de laboratoire ou un PDF exporté depuis un logiciel d'instrument—tous passent par le même pipeline d'extraction. L'IA lit le contenu visuel quel que soit le format source. La qualité de l'image compte : un scan ou une photo nette et bien éclairée produit une extraction à plus haute confiance qu'un cliché sombre et de travers.
Comment gérer les rapports comportant des résultats ou des corrections manuscrits ?
Les valeurs manuscrites sur des rapports par ailleurs imprimés sont courantes dans les laboratoires où les techniciens annotent les sorties d'instruments—en entourant un résultat, en écrivant une note dans la marge ou en complétant un champ manquant. Le modèle vision-langage peut lire le texte imprimé, l'écriture manuscrite et les documents à contenu mixte. La précision de reconnaissance de l'écriture manuscrite est inférieure à celle du texte imprimé (comme pour un lecteur humain), de sorte que les champs manuscrits gagnent à faire l'objet d'une vérification lors de l'étape de révision.
Cela fonctionne-t-il pour les environnements réglementés GMP (21 CFR Part 211) ?
L'outil traite les données ; il ne remplace pas votre système qualité. Dans un environnement GMP, le résultat de l'extraction doit être considéré comme une étape intermédiaire—analogue à la feuille de travail manuscrite d'un technicien. L'enregistrement validé et approuvé reste la version qui est intégrée à votre dossier de lot et à votre CoA. La proposition de valeur pour les laboratoires GMP est la rapidité : au lieu qu'un technicien passe 45 minutes à transcrire des valeurs avant même que le QA puisse commencer sa revue, l'extraction produit le jeu de données initial en quelques secondes. Le QA examine ensuite, vérifie et approuve—le même processus, mais à partir d'un premier brouillon généré par machine plutôt que saisi manuellement.
Que faire si deux rapports d'essai pour le même lot affichent des résultats conformes/non conformes différents ?
Le système d'extraction rapporte ce qu'il lit—il ne réconcilie pas les résultats contradictoires. Si le rapport A indique « Conforme » et le rapport B « Non conforme » pour le même paramètre, les deux valeurs apparaissent dans le résultat. Le conflit apparaît lors de la validation, ce qui est exactement le moment où il doit apparaître. C'est un avantage par rapport à la saisie manuelle, où un technicien pourrait remarquer l'écart et le « corriger » en silence, supprimant ainsi la piste d'audit. Le flux d'extraction préserve les données d'origine ; la résolution (retest, investigation, rapport de déviation) est une décision humaine.
Puis-je configurer différents modèles de colonnes pour différentes familles de produits ?
Oui. Chaque produit ou famille de produits peut avoir son propre ensemble de définitions de colonnes—un modèle pour les tests de libération des comprimés, un autre pour l'inspection des matières premières, un autre pour les contrôles en cours de fabrication. Les modèles sont enregistrés dans votre compte et peuvent être sélectionnés lorsque vous démarrez un nouveau lot de traitement. C'est ainsi que les laboratoires disposant de portefeuilles de produits diversifiés maintiennent un suivi SPC spécifique aux tests sans redéfinir les colonnes à chaque exécution.
Comment cela se compare-t-il à l'achat d'un LIMS pour l'automatisation de la saisie des données ?
Un LIMS (Laboratory Information Management System) est une plateforme complète qui gère le suivi des échantillons, la planification des tests, l'intégration des instruments et les flux de conformité. C'est l'outil approprié pour les grands laboratoires réglementés disposant d'un budget et d'un support informatique. Mais les implémentations de LIMS coûtent régulièrement $50,000–$200,000+ et prennent 6–18 mois à déployer. Pour les laboratoires de contrôle qualité de petite et moyenne taille—la majorité des usines de fabrication—le prix et les délais sont prohibitifs. L'automatisation par extraction répond au point de douleur spécifique (transférer les données des rapports vers des tableurs) sans la surcharge d'une migration complète vers un LIMS. Pour de nombreux laboratoires, c'est une étape pragmatique qui apporte une amélioration mesurable sans perturbation organisationnelle.