給与明細データ抽出の
完全ガイド
住宅ローンの引受審査担当者が、ブローカーから届いた42ページのPDFを開きます。27ページ目あたり、税申告書や銀行明細書に埋もれて、申請者のADPの給与明細があります。31ページ目にはGustoのもの。35ページ目には、審査担当者がこれまで見たこともない給与プロバイダーのもの — レイアウトもラベルも列の位置も異なります。3つすべてに同じデータが含まれています:従業員名、総支給額、手取り額、YTD合計、控除額。しかし、そのデータを1つの比較行に抽出するには、3つの書類を開き、3つの異なるテンプレートを読み、3つのスプレッドシートのセルに値を入力する必要があります。今月は120件の申請があります。給与明細データ抽出が存在するのは、この掛け算の問題が現実であり、規模が大きくなると手入力のミスがコンプライアンス上の責任に発展するからです。
重要ポイント
- 月120件の申請を処理する住宅ローンの引受審査担当者は、27ページ目に埋もれたADPの給与明細、31ページ目のGusto、35ページ目の見慣れないプロバイダーの明細を開きます — 互換性のない3つのレイアウト、3回のデータ入力作業、1つのローン判断。
- テンプレートベースの抽出は給与明細では機能しません。なぜなら、米国市場を支配する6つの給与プロバイダーは根本的に互換性のないレイアウトを持っており、申請者の雇用主がどのプロバイダーを選ぶかをコントロールできないからです。
- テンプレート不要の抽出は、1つの列定義で6つのプロバイダー形式すべてを読み取ります。「総支給額」と「YTD総支給額」を別々の列に分けると、YTDの数値が組み込みの不正チェックになります:期間総支給額 × 支給回数がYTD合計と一致しなければ、どの給与明細をレビュー用に引き出すべきかが正確にわかります。
給与明細データ抽出が重要な理由
給与明細の抽出は、それ自体が目的になることはほとんどありません。ほとんどの場合、下流のワークフローにおける一工程であり、そのワークフローこそが、優れた抽出機能に求められる要件を定義します。特に頻度が高く、需要を形作る3つのワークフローをご紹介します。
収入確認。住宅ローン審査担当者、賃貸物件管理会社、自動車ローン担当者は、申請者の収入申告が正しいことを確認する必要があります。1件の申請に、複数の雇用主からの給与明細が含まれることもあれば、転職したばかりで前職のものが含まれることもあります。融資担当者は、すべての収入源における手取り額、総支給額、支払頻度、年度累計額を、単一の比較ビューで、アンダーライティング・パイプラインを滞らせないスピードで確認する必要があります。週に30~40件の申請を処理する担当者にとって、給与明細1枚あたり手動入力に2分かかれば、週に数時間ものボトルネックになります。
税務クロスチェック。年末のW-2フォームと四半期ごとの給与明細記録を照合する給与監査人は、W-2のBox 1(賃金)、Box 2(連邦所得税源泉徴収額)、Box 3(社会保障賃金)、Box 5(メディケア賃金)が、その元となった個々の給与期間データとすべて一致することを確認する必要があります。W-2は、12~26枚の個別給与明細の集計です。監査人が不一致を発見した場合、その原因を特定するには、影響を受ける全従業員のすべての給与明細を開く必要があります。これを手作業で行うと、中規模企業の場合、監査人が丸々1週間を費やす可能性があります。給与明細抽出は、これを証拠書類の捜索から表計算ソフトによる照合作業に変えます。つまり、すべての給与明細を抽出して行に並べ、列を合計し、W-2と比較し、不一致を数秒でフラグ付けします。
複数従業員の給与監査。請負業者の請求書と従業員の給与を併せて管理する人事チーム、あるいは50社の中小企業顧客を担当する外部給与計算代行業者は、給与期間、従業員、給与システムをまたいだ報酬データを統合する必要があります。ある従業員が、現在の仕事ではADP、副業ではGusto、前職ではPaychexの給与明細を持っている場合、これら3つのPDFは3つの異なるデータ入力作業を意味します。抽出により、これらは1つのテーブル、1組の列に集約されます。このテクノロジーの詳細と、給与計算ソフトウェアとの違いについては、給与明細データ抽出の実態に関するガイドをご覧ください。
給与明細抽出の特有の課題
給与明細は、請求書や領収書と共通する課題(フォーマットの多様性、ラベルの不統一、スキャン品質のばらつき)を抱えていますが、他の文書タイプではほとんど発生しない3つの問題もあります。
給与プロバイダー間の極端なフォーマット多様性
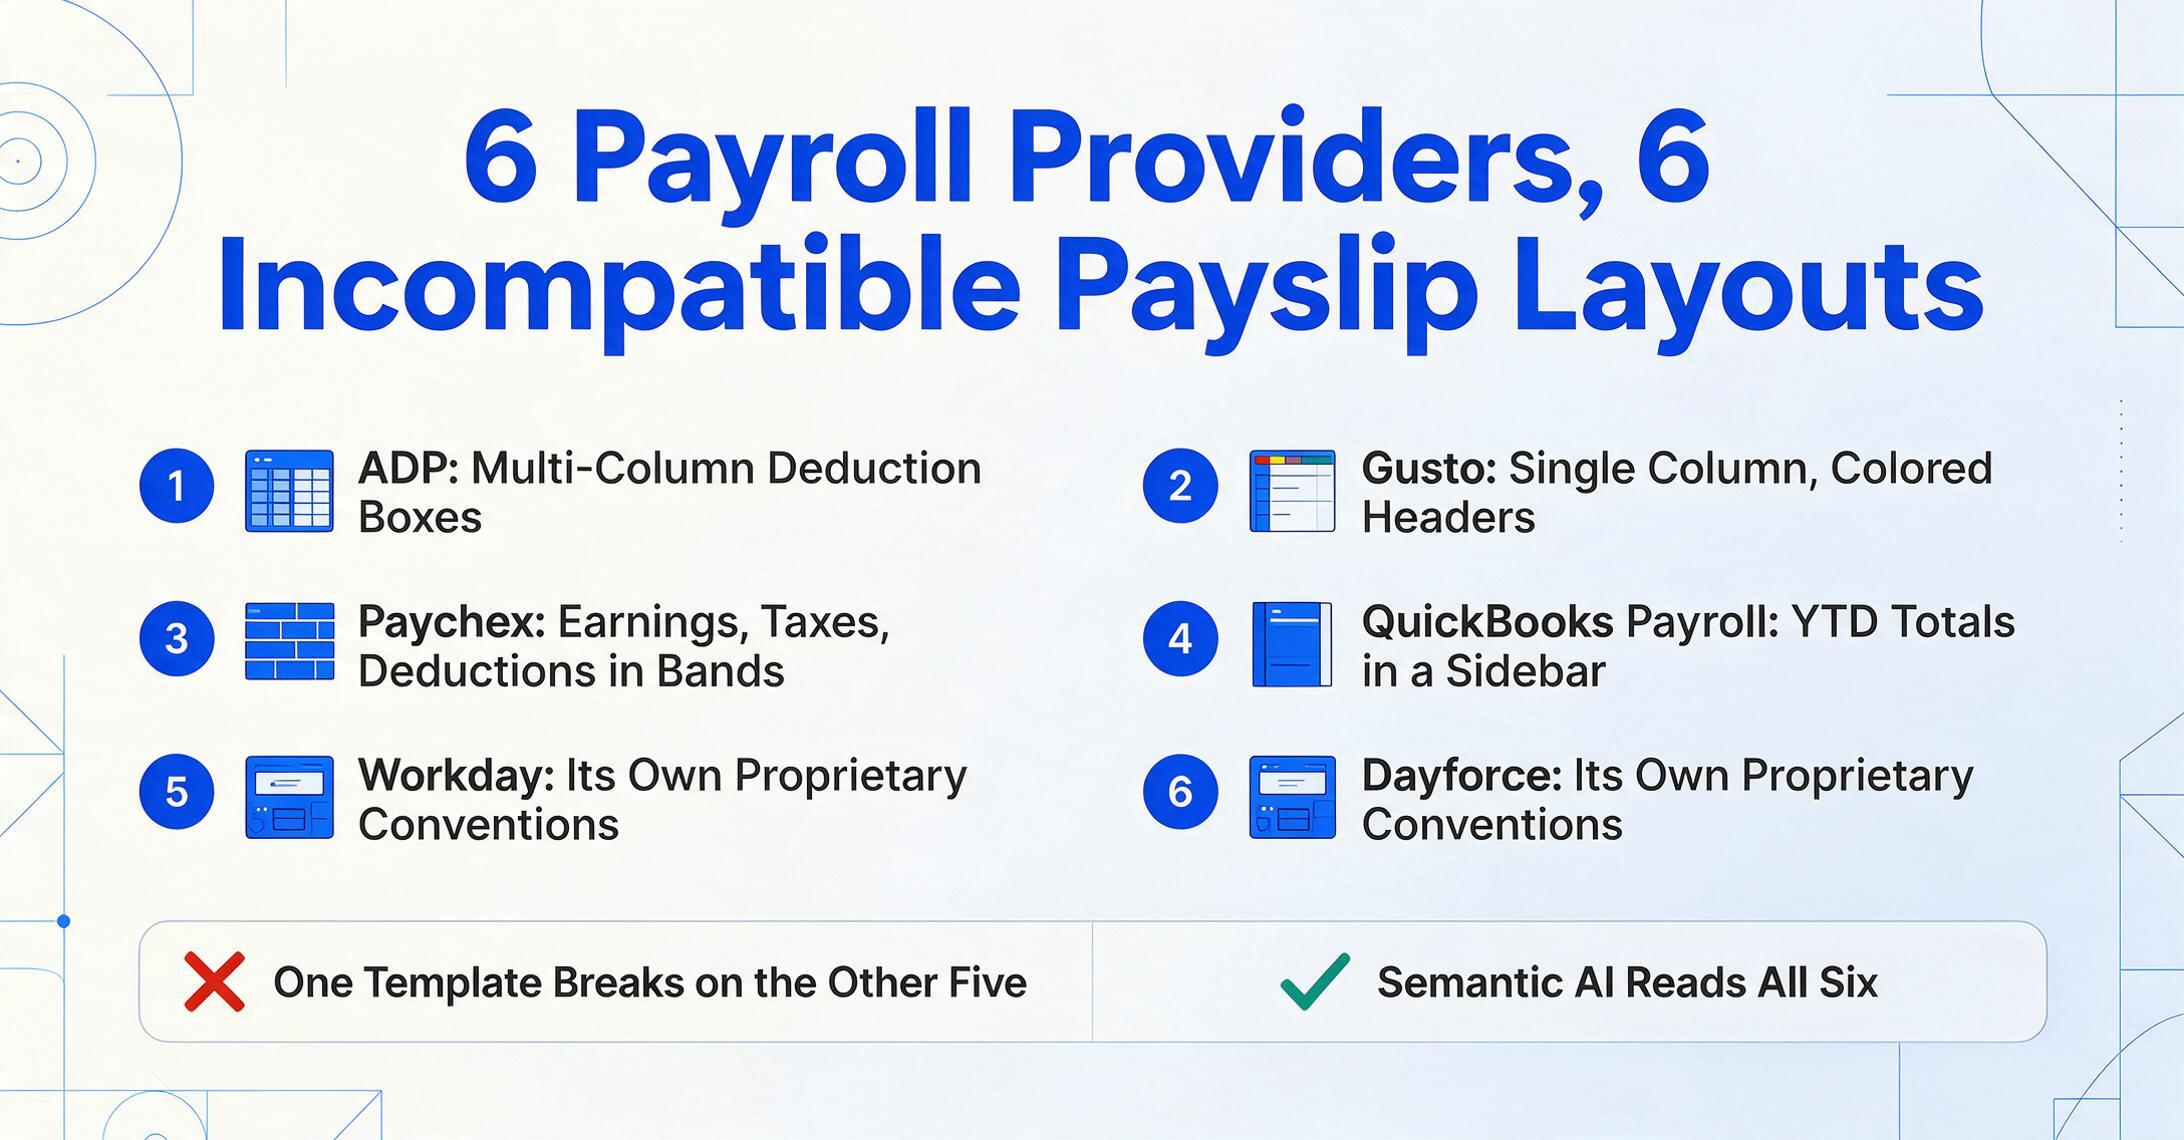
あるベンダーの請求書が別のベンダーの請求書と異なる場合があります。それは課題です。しかし、請求書を発行するベンダーは数千社あり、個々のフォーマットは文書全体のごく一部を占めるにすぎません。給与明細はその逆です。米国の給与明細の大部分は6つの主要な給与プロバイダーが生成しており、それぞれがデータを異なる方法で配置しています。ADPは分類された控除ボックスを備えた複数列レイアウトを使用します。Gustoは色付きのセクションヘッダーを備えたすっきりした単一列デザインを使用します。Paychexは収入、税金、控除を別々の横方向のバンドに分割します。QuickBooks Payrollは年初来累計(YTD)の合計をサイドバーに配置します。WorkdayとDayforceはそれぞれ独自の専用レイアウト規則を持っています。その結果はランダムなフォーマットのロングテールではなく、それぞれが内部的には一貫しているものの互換性のない、6つの異なるレイアウトファミリーの集中したセットです。
ADPの給与明細で機能するテンプレートベースの抽出アプローチは、Gustoの給与明細では機能しません。QuickBooks Payrollで機能するアプローチは、Paychexでは失敗します。給与明細の抽出は、プロバイダーごとの設定なしで、それらすべてに対応する必要があります。なぜなら、抽出を行う人は、従業員の会社がどのプロバイダーを使用しているかをほとんど制御できないからです。
年初来累計(YTD)フィールド
ほとんどの文書タイプでは、文書ごとの値を抽出します。この請求書の合計、この領収書の日付、この発注書の仕入先などです。給与明細にはもう一つの層が加わります。文書ごとの値ではない年初来累計(YTD)の数値です。6月15日締めの給与期間の明細には、今期の総支給額として$3,200、YTD総支給額として$38,400が表示されることがあります。$38,400は、1月1日から6月15日までの全給与期間の総支給額の合計です。両方の数値が同じ文書に表示され、通常は互いに近い場所にあり、別々に抽出する必要があります。
YTD抽出を正しく行うことが重要な理由は3つあります。第一に、収入確認ワークフローではYTDの数値を使用して、期間レベルの給与が年レベルの合計と一致していることを確認します。「今期の総支給額×これまでの給与期間数」と「YTD総支給額」の不一致は、貸し手が特に確認する不正の指標です。第二に、W-2フォームとの税務照合にはYTDデータが必要です。W-2は年間合計を報告し、期間レベルの詳細は報告しないためです。第三に、同じ従業員の複数の給与明細を1年間にわたって処理する場合、12月の給与明細のYTDフィールドは組み込みの検証チェックポイントとして機能します。全期間レベルの総支給額の合計は、12月のYTD総支給額と一致するはずです。一致しない場合、抽出エラーが発生したか、バッチから給与明細が欠落しています。
控除と雇用主拠出 — 反対方向のフィールド
これは給与明細特有の課題であり、汎用抽出ツールが最もつまずくポイントです。すべての給与明細には、賃金以外の金額のカテゴリが2つあり、それらは反対方向を向いています。
- 控除は、従業員の総支給額から差し引かれ、手取り額に到達するまでの金額です。連邦所得税、州税、社会保障(6.2%)、メディケア(1.45%)、401(k)従業員拠出、健康保険料の従業員負担分 — これらは従業員の手取り額を減らします。従業員が稼いだものの、税務当局や給付提供者に支払われるため受け取らないお金です。
- 雇用主拠出は、雇用主が従業員の総支給額に上乗せして支払う金額です。雇用主のマッチング401(k)拠出、健康保険の雇用主負担分、雇用主負担の社会保障(6.2%)とメディケア(1.45%) — これらは雇用主が負担し、従業員の給与明細には通過しないコストです。透明性のために給与明細に表示されますが、手取り額の計算には含まれません。
給与明細の「401(k)」を読み取る汎用抽出ツールは判断を下す必要があります。これは従業員の控除か、雇用主のマッチングか。両方に「401(k)」または「退職金」と異なる金額が表示される場合があります。人間が給与明細を読めば、どの金額が総支給額から差し引かれ、どの金額が雇用主拠出として別途記載されているかを理解できます。AI抽出システムにも同じ文脈理解が必要です。ラベルだけでなく、文書構造内のフィールドの位置を読み取り、各値を正しい列に割り当てる必要があります。
複数給与期間の統合
収入確認において、標準となるのは給与明細1枚ではありません。2〜3ヶ月分の連続した給与明細、場合によってはそれ以上が必要です。住宅ローンの引受審査担当者は、申請者の収入が給与期間を通じて安定していることを確認する必要があります。1枚の給与明細が良く見えるだけでは不十分です。つまり、申請者1人につき4〜6枚の給与明細(隔週払いの場合)を抽出し、それぞれの期間別および年初来累計(YTD)の値を取得して、単一の比較表に統合する必要があります。
手動での統合は、各給与明細PDFを開き、必要な6〜7項目のフィールドを見つけ、スプレッドシートの行に入力し、それを繰り返すことを意味します。申請者30人×給与明細5枚の場合、150件の書類となり、転記するデータポイントは900〜1,050個になります。これらのセルのいずれかで1桁を誤入力すると、YTDのクロスチェックが崩れたり、総支給額から控除額を差し引いた計算と一致しない手取り額が発生したりします。バッチ抽出は、特定の申請者の全給与明細、または全申請者の全給与明細を1回の処理で処理し、各行が1枚の給与明細に対応する単一のスプレッドシートを生成することで、この問題を解決します。従業員名または申請者IDでフィルタリングできます。
従来手法とAI抽出の比較
給与明細データをスプレッドシートに取り込む方法は3つあり、完全手動から完全自動までのスペクトラム上に位置し、各レベルで信頼性のプロファイルが大きく異なります。
| 方法 | 仕組み | 速度(給与明細1枚あたり) | フォーマット多様性への対応 | YTDフィールドへの対応 |
|---|---|---|---|---|
| 手動入力 | PDFを開き、各フィールドを読み取り、セルごとにスプレッドシートへ入力 | 約3分 | 対応(人間が適応) | 対応(人間が理解) |
| テンプレート/ゾーンOCR | プロバイダーごとのレイアウトに座標ゾーンを定義し、各ゾーンのテキストをOCRで読み取り | 約10〜15秒 | 非対応 — 新しいレイアウトで破綻 | 非対応 — テキストは抽出するが期間別とYTDを区別しない |
| AI意味論的抽出 | ビジョンAIがフィールドの意味を理解して文書を読み取り(位置ではなく) | 約5〜10秒 | 対応 — レイアウト非依存 | 対応 — フィールドの文脈で区別 |
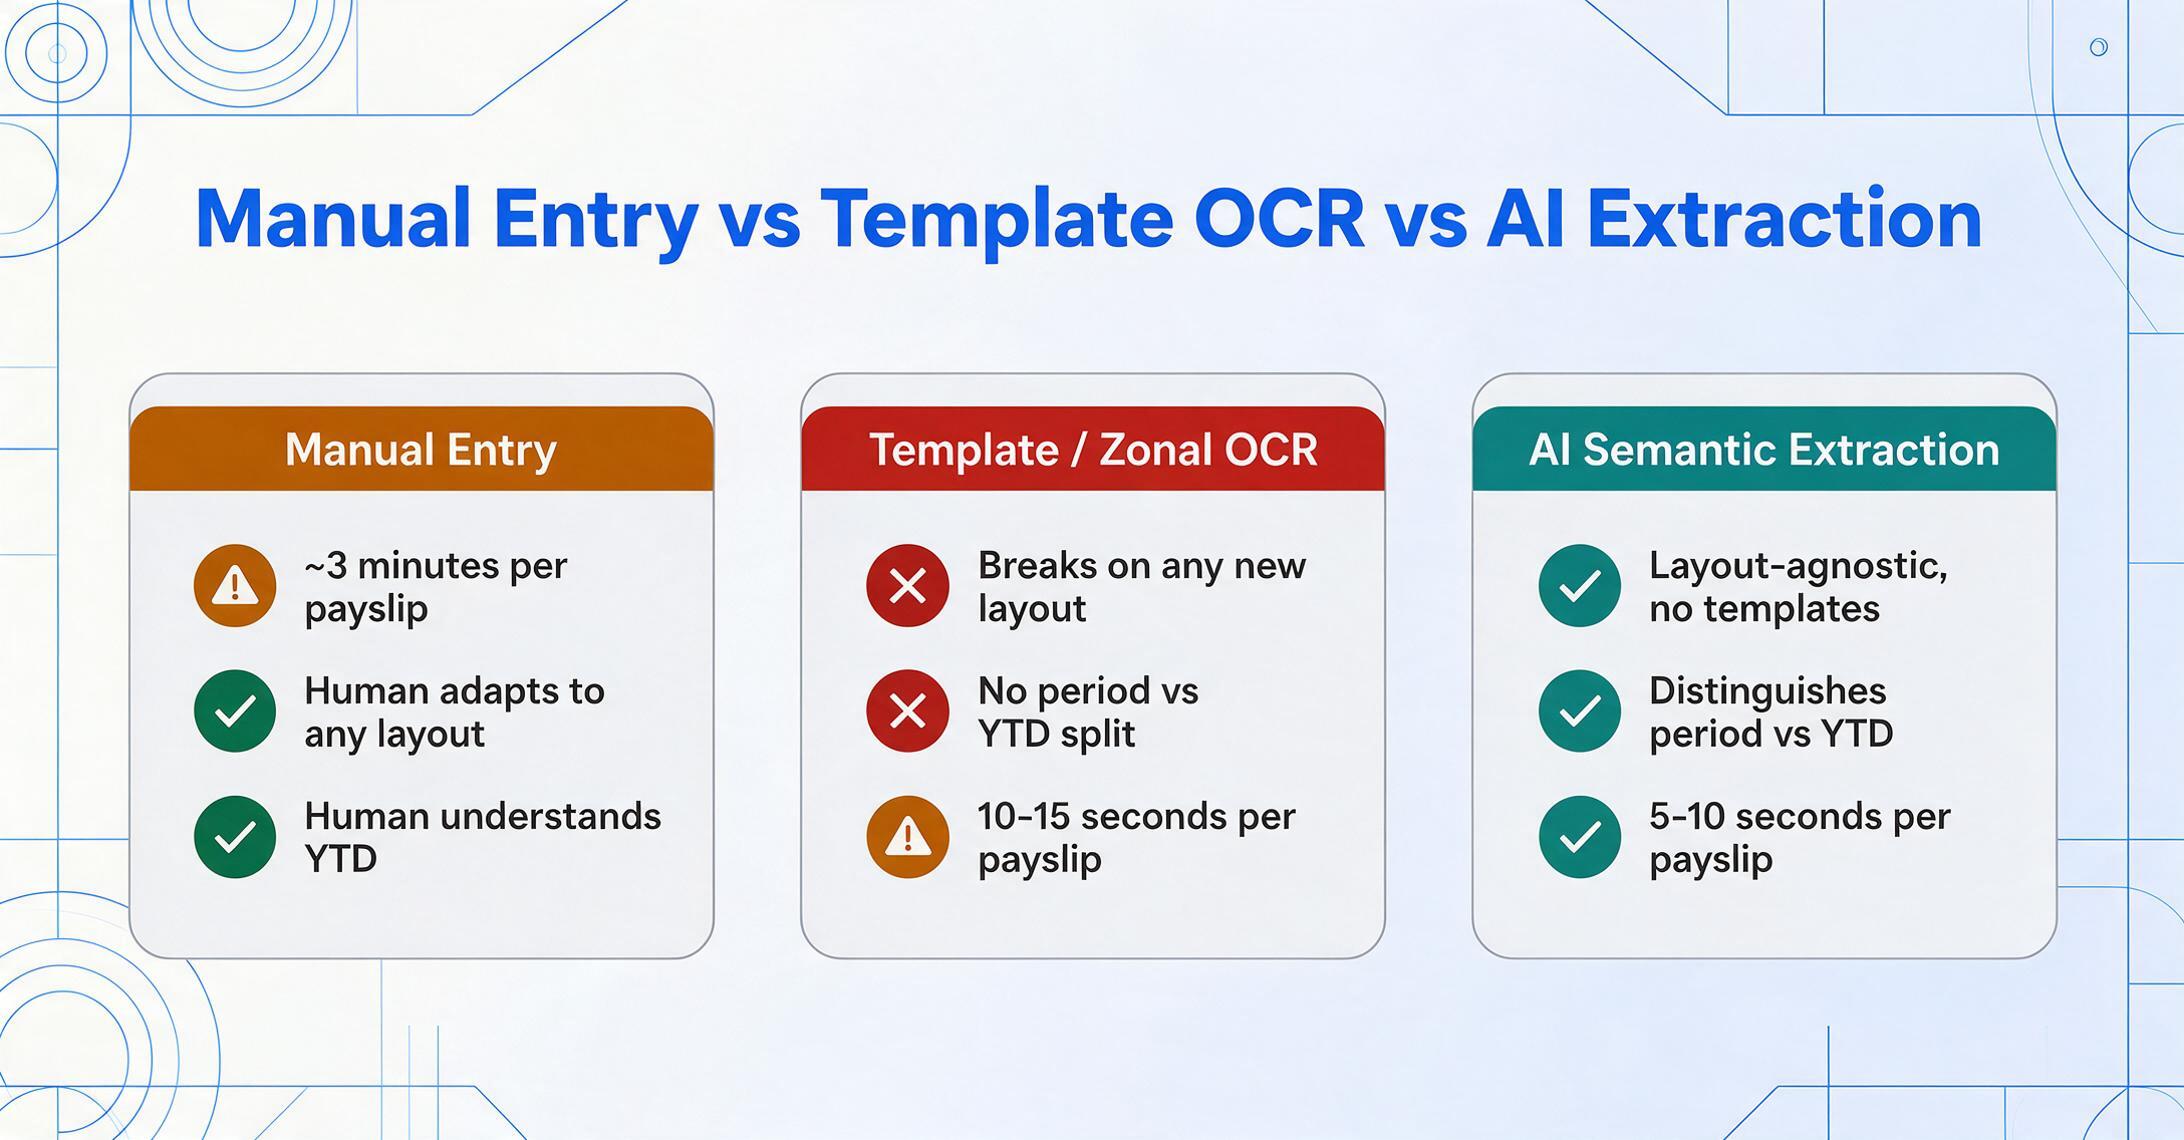
テンプレートベースのOCR(レガシー文書処理ツールで使用される手法)は、文書画像上に長方形のゾーンを描画し、各ゾーン内でOCRを実行する仕組みです。ADPの給与明細テンプレートの座標(420, 680, 520, 700)に「手取り額」のゾーンを定義した場合、システムはその長方形内に表示されるテキストを読み取ります。Gustoからの給与明細が届いた瞬間 — 手取り額がまったく異なる位置にある場合 — ゾーンは空欄または完全に別のフィールドを読み取ります。主要な給与プロバイダー6社はそれぞれ異なるレイアウトを使用しているため、テンプレートシステムには最低6つのテンプレートが必要であり、新しいフォーマットが登場するたびに7つ目のテンプレートを構築する必要があります。これは自動化ではなく、デジタル化された手動設定です。
AIセマンティック抽出は、動作が異なります。データがページのどこにあるかを定義する代わりに、必要なデータが何かを定義します。「従業員名」「総支給額」「差引支給額」「年初来累計(YTD)連邦税」など、必要な列名を入力するだけです。AIは文書全体を読み取り、給与明細の構造内での文脈に基づいて各ラベル付き値の意味を理解し、値がどこに表示されていても対応する列に入力します。これは、位置ベースの抽出からセマンティックベースの抽出への根本的な転換であり、給与プロバイダーごとに設定を行うことなく、複数の給与プロバイダーにわたって給与明細処理を実現可能にするものです。
効率性の違いは測定可能です。アメリカ給与協会の調査によると、手動プロセスに依存する企業の手動給与エラー率は給与総額の1〜8%です。給与明細1枚あたりの手動入力が3分かかるのに対し、AI抽出では5〜10秒で完了し、200枚の給与明細の処理時間は10時間から約20〜30分に短縮されます。これは18倍の改善です。
ファイルは安全に処理され、保存されません。
抽出する主要な給与明細フィールド
何を抽出するかは、あなたのワークフローによって異なります。収入確認のワークフローでは6つのフィールドが必要かもしれません。給与監査では20のフィールドが必要かもしれません。以下は、最も一般的な下流での用途をカバーするフィールドグループで、各フィールドが何を示すか、プロセスのどこに組み込まれるかによって整理されています。
従業員と雇用主
- 従業員名とID
- 雇用主名
- 給与期間の開始日と終了日
- 支給日
- 支給頻度(毎週/隔週/月2回/毎月)
収入
- 総支給額(今期)
- 基本給 / 通常労働時間と時給
- 残業時間と残業代
- 賞与 / 歩合
- 手当(旅費、住宅、食事)
控除(従業員の給与から)
- 連邦所得税
- 州税と地方税
- 社会保障(6.2%)
- メディケア(1.45%)
- 401(k) / 退職金繰延
- 健康/歯科/視力保険料
- 差し押さえ / その他
年初来累計(YTD)と雇用主負担
- YTD総支給額
- YTD連邦/州/地方税
- YTD社会保障とメディケア
- YTD 401(k) / 退職金
- 手取り額(今期)
- YTD手取り額
- 雇用主の401(k)マッチ / 健康保険負担
抽出用の列を定義する際は、2つの点に注意してください。まず、期間値をYTD値から分離して別々の列にすることです。「総支給額」と「YTD総支給額」は、1つの列ではなく2つの列にする必要があります。なぜなら、それらは異なる下流の目的(期間分析と年度末調整)に役立つからです。次に、従業員の控除と雇用主の負担を分離することです。「401(k)従業員」と「401(k)雇用主」を別々の列として作成し、2つの金額を混同する単一の「401(k)」列にしないでください。AIは、別々に要求すればそれらを区別できます。単一の「401(k)」列を要求すると、文書上で最初に遭遇した方の金額を返す可能性があります。
給与明細のバッチ処理の仕組み
バッチ処理こそが、給与明細の抽出を大規模に実用的にする仕組みです。一度に1枚の給与明細を処理する代わりに、特定のバッチに含まれるすべての給与明細(今週の全応募者、今四半期の全従業員、この税年度の全契約社員など)をアップロードすると、システムがまとめて処理し、給与明細1枚につき1行の単一のスプレッドシートを生成します。
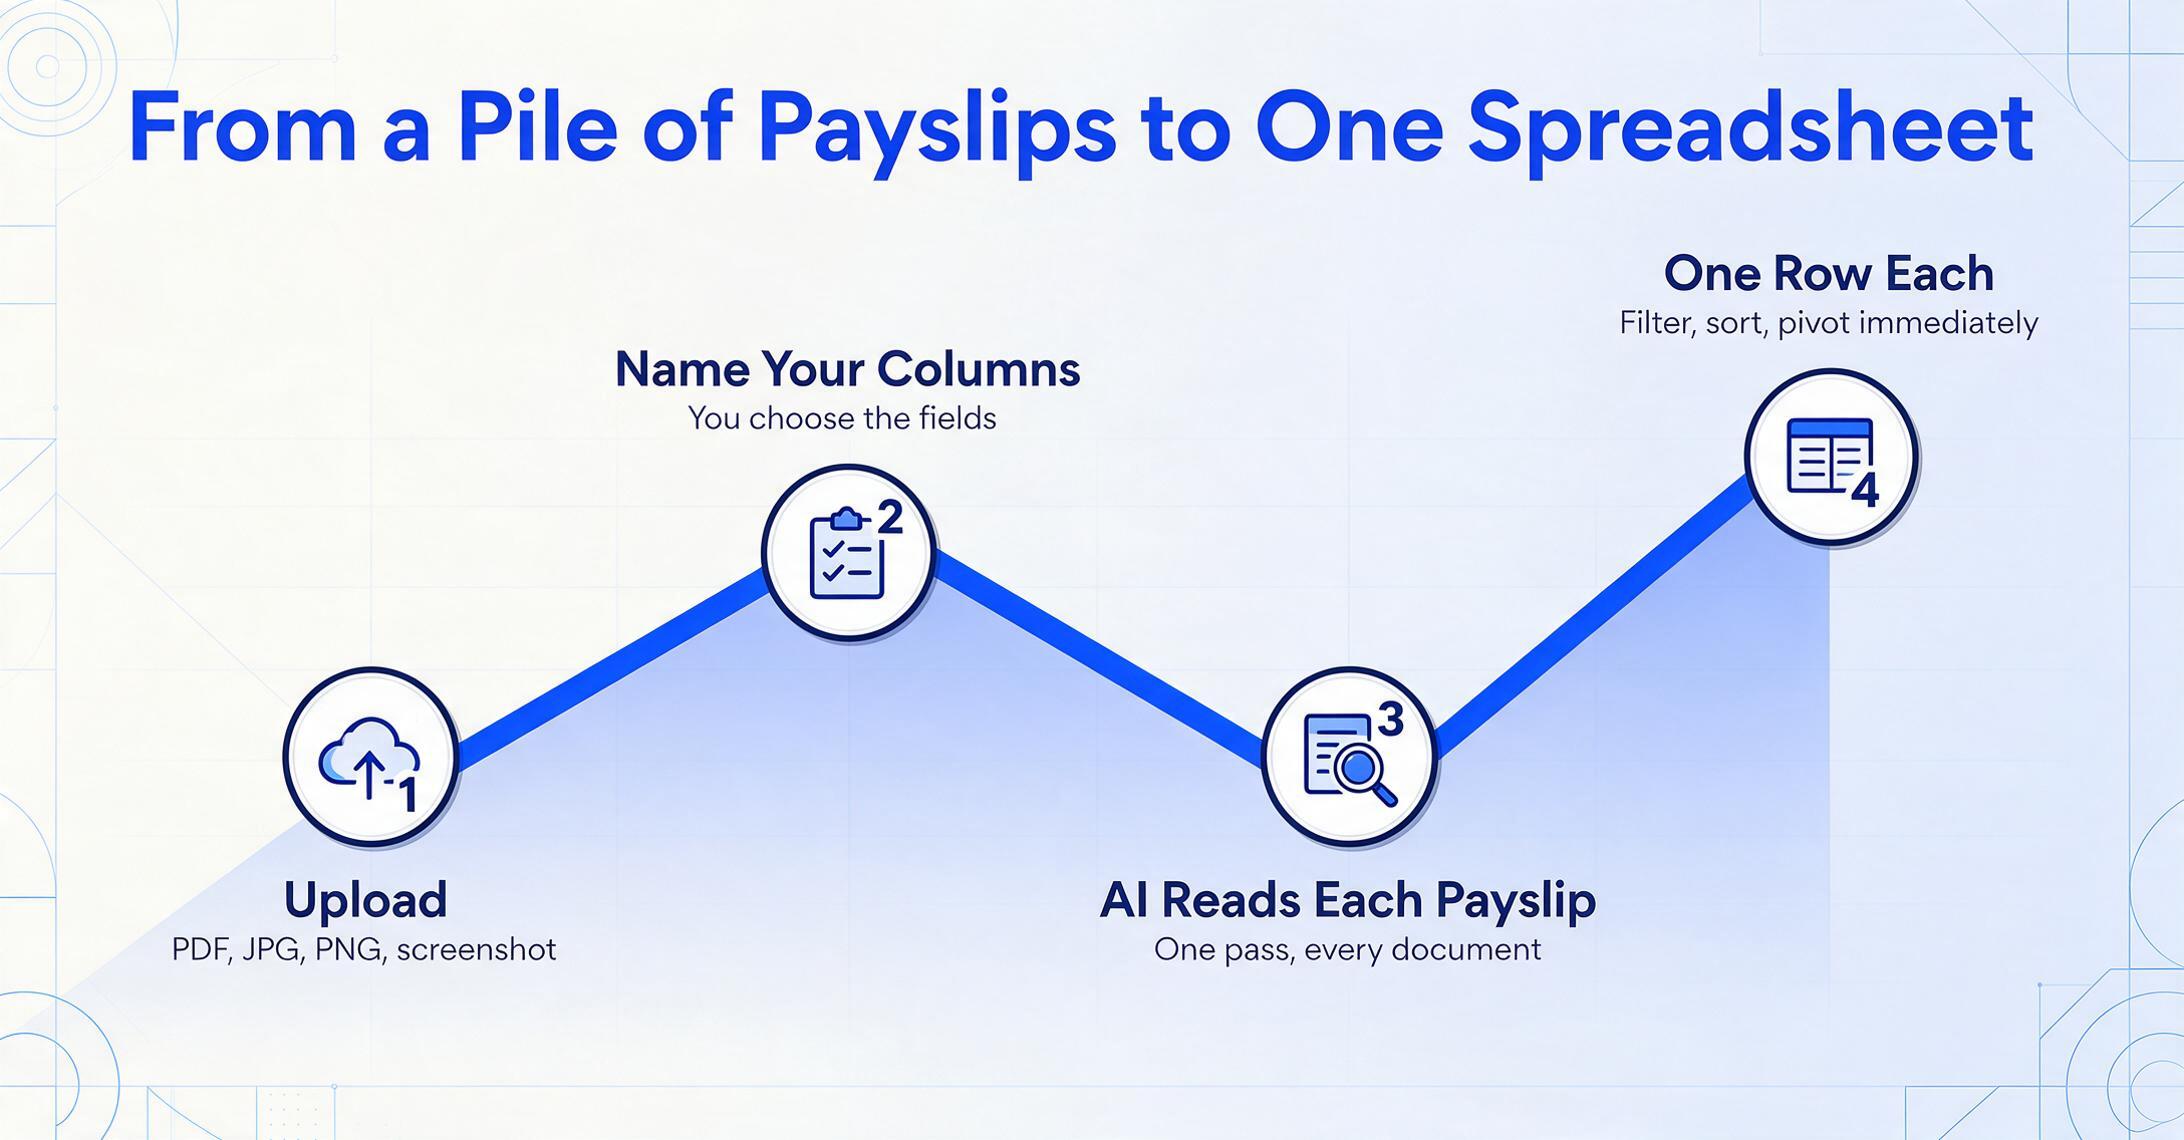
ワークフローは一貫したパターンに従います。文書(あらゆる給与計算プロバイダーからのPDF、JPG、PNG、スクリーンショット)をアップロードし、抽出したい列名を定義し、AIが各文書を読み取って対応する行に入力します。出力は1つのExcelファイルで、各行が1枚の給与明細、各列が1つの抽出フィールドを表し、データをすぐにフィルタリング、並べ替え、ピボットできます。手動での転記、文書間のコピー&ペースト、給与計算期間ごとのスプレッドシート数式の再構築は不要です。
給与明細のバッチ処理が最も重要になるのは、3つのシナリオです。住宅ローンや賃貸申請を一括処理する場合は、応募者全員の給与明細を一度にアップロードし、応募者IDの列を持つ1つのスプレッドシートを取得します。任意の応募者にフィルタリングすると、年初来累計(YTD)の推移がわかる連続した行で全給与明細を確認できます。四半期または年度末の給与計算の照合を処理する場合は、四半期分の給与明細をすべてアップロードし、YTD列に組み込まれた検証機能を活用します。期間中の総支給額の合計が、最終的なYTD総支給額と一致するはずです。複数従業員の人事監査を処理する場合は、従業員と給与計算期間をまたいで給与明細をアップロードし、PDFを1枚も開かずに統合された報酬ビューを構築できます。
応募者、従業員、契約社員など、複数の人から給与明細を収集する必要があるチームには、コレクションリンクが受付側を簡素化します。共有可能なリンクを生成し、給与明細を提出する必要がある各人に送信すると、そのリンクから直接文書をアップロードできます。ファイルは自動的に処理キューに登録されます。メールの添付ファイルを追いかける必要も、受信トレイから抽出ツールへPDFを転送する必要も、応募者に認証情報を持っていないシステムへのログインを求める必要もありません。アップロードする人はリンクと認証コードだけで済みます。
抽出データのエクスポートと活用方法
抽出結果の価値は、対応する出力形式とデータの品質にかかっています。3つのエクスポート形式で、一般的なデータの受け渡し先をカバーします。
- Excel(XLSX) — 給与計算やHR業務の標準形式です。適切な列ヘッダー、標準化された日付形式、数値として書式設定された金額フィールドを含むスプレッドシートでデータが出力されます。そのため、従業員ごとのフィルタリング、月別総支給額の集計、報酬分析のピボットテーブル作成などを、抽出後の日付や通貨の文字列変換作業なしで即座に開始できます。
- CSV — 給与計算ソフト、会計システム、カスタムデータベースへのインポートに適しています。多くの給与計算プラットフォームやERPシステムはCSVインポートに対応しており、クリーンなCSVデータがあれば、インポート用に手動でスプレッドシートを整形する手間が省けます。
- JSON — カスタムアプリケーション、API、自動検証パイプラインとの連携に使用します。給与明細の抽出データを申請書類とプログラムで照合する収入確認ワークフローを構築する場合、JSON出力をそのままロジックに組み込めます。
Google Sheetsユーザー向けには、Google Sheetsサイドバーアドオンを使用すると、アクティブなスプレッドシートに直接抽出できます。Sheets内から給与明細ファイルをアップロードし、列を定義して、抽出行をシートに追加できます。アプリケーションを切り替える必要はありません。給与照合や収入確認の追跡をGoogle Sheetsで行うチームにとって、エクスポートと再インポートのループを回避できる便利な方法です。
給与明細抽出アプローチの選び方
すべての抽出ツールが給与明細に適しているわけではなく、給与明細に重要な機能は請求書に重要な機能とは異なります。評価すべきポイントは以下の通りです。
テンプレート不要の動作。 これは給与明細抽出において最も重要な基準です。ツールが給与プロバイダーごとにテンプレートの作成(ゾーンの定義、サンプルでの学習、レイアウトルールの設定)を必要とする場合、抽出で節約する時間よりもセットアップに時間がかかります。なぜなら、プロバイダーが異なれば給与明細のレイアウトは根本的に異なるからです。テンプレート不要のツールは、プロバイダーごとの設定なしにあらゆる給与明細形式を読み取ります。「Net Pay」がADPの給与明細の右下隅にあろうと、Gustoの給与明細の中央にあろうと、同じ意味であることを理解します。
カスタム列定義。 抽出したいフィールドを名前で正確に定義できる必要があります。固定フィールド(例:「Gross Pay」と「Net Pay」のみ)しか抽出しないツールは、ツールの前提に制限されます。収入確認ワークフローで「YTD Gross Pay」「Pay Frequency」「Employer Name」が必要な場合や、給与監査で「Overtime Hours」「401(k) Employee Deferral」「Garnishments」が必要な場合があります。ツールは、事前設定されたものではなく、ユーザーが指定したものを抽出するべきです。
バッチ処理。 単一ドキュメントの抽出は、単発の確認には便利です。バッチ抽出(50枚や200枚の給与明細をアップロードし、1つのマージされた出力を得る)こそが、ツールを実際のワークフローで実用的にします。住宅ローン申請や四半期ごとの給与照合を処理する場合、バッチ処理はオプションではなく、ツールを使い続けるか、最初の週で放棄するかの分かれ目です。
YTD項目の精度。 ツールを導入する前に、これを必ずテストしてください。期間内総支給額が3,200ドル、YTD総支給額が38,400ドルと記載された給与明細をアップロードし、ツールが両方の値を正しい列に抽出することを確認します。YTD値を期間内総支給額の列に(またはその逆に)配置した場合、そのツールは期間と累計のフィールドの意味的な違いを理解しておらず、調整の信頼性は低くなります。
控除と拠出の区別。 「401(k)従業員拠出」(給与からの控除)と「401(k)雇用主マッチ」(別の雇用主拠出)の両方が表示された給与明細をアップロードします。ツールが両方を混同せずに別々の列に抽出することを確認します。これができない場合、報酬分析で従業員と雇用主の資金が同じ枠に混在することになり、総報酬コストを計算するあらゆるワークフローで重大なエラーが発生します。
よくある質問
給与明細の抽出は、あらゆる給与プロバイダーの明細書に対応できますか?
はい、テンプレートベースのOCRではなく、セマンティックAI抽出を使用するツールであれば可能です。セマンティック抽出は、事前定義されたレイアウトに一致させるのではなく、フィールドの意味を理解して読み取るため、ADP、Gusto、Paychex、QuickBooks Payroll、Workday、Dayforce、および小規模な地域プロバイダーでも機能します。ツールは特定のプロバイダーの形式を事前に「見た」ことがある必要はありません。ドキュメントを読み取り、給与明細の構造における各フィールドの役割に基づいて特定します。
YTD(年度累計)フィールドの抽出精度はどのくらいですか?
YTD抽出の精度は、AIが期間フィールドと累計フィールドを文脈から区別できるかどうかに依存します。主要プロバイダーの鮮明なデジタル給与明細では、YTD抽出は通常95~99%の精度を達成します。YTDと期間フィールドが類似したラベルで近接して表示されるスキャン済みまたは撮影済みの給与明細では、特にスキャン解像度が低い場合やドキュメントが傾いている場合、精度が低下する可能性があります。住宅ローン引受審査などの重要なワークフローでは、抽出データに依存する前に、YTD値を期間レベルの計算(期間総額×これまでの給与支払回数≈YTD総額)と照合することを組み込みの検証手順として推奨します。
ツールは給与明細の手書き注釈を処理できますか?
AI抽出は、印刷テキスト、手書き、および混合コンテンツのドキュメントを読み取ることができます。給与明細に手書きの修正や注釈(管理者のイニシャル、手書きの調整額など)がある場合、AIはそれらの抽出を試みます。ただし、手書きの精度は印刷テキストの精度よりも低く、特に筆記体や小さな注釈の場合は顕著です。給与明細のワークフローで手書きの修正が一般的な場合は、該当するフィールドを手動で確認するか、手書きを含むとフラグが立てられたドキュメントの検証手順を設定してください。
バッチ抽出では、異なる給与期間のデータが1つのスプレッドシートに統合されますか?
はい。複数の給与期間にわたる給与明細(1人の従業員の1年分、または複数の従業員の異なる期間分)をアップロードすると、ツールはすべてのドキュメントをまとめて処理し、1つのスプレッドシートを出力します。各行は独自の給与期間日付を持つ1枚の給与明細であるため、手動で統合することなく、従業員、日付範囲、または支払い頻度でフィルタリング、並べ替え、グループ化できます。
給与明細の真偽確認や不正検出は可能ですか?
AI抽出ツールは不正検出システムではありません。ただし、一貫した抽出により、以下のような独自のチェックが可能です:累計額と期間別計算の比較、手取り額が総支給額から控除額を差し引いた額と一致するかの確認、支給頻度が期間日付と整合しているかの検証。これらの計算に不整合がある場合、抽出エラーまたは改ざんされた書類の可能性を示唆します。専用の給与明細検証ツールには不正検出機能があるものもありますが、汎用抽出ツールはデータを読み取るものであり、書類の真偽を証明するものではありません。
給与明細の抽出に対応しているファイル形式は?
ほとんどのAI抽出ツールは、PDF(デジタルおよびスキャン)、JPG、PNG、WebP、スクリーンショットに対応しています。重要な違いは、テキストが選択可能な形で埋め込まれているデジタルPDFと、書類を写真として取り込んだスキャン/画像PDFの違いです。AI抽出は両方に対応しますが、画像ベースのPDFではAIが最初にOCRを実行する必要があるため、テキストが既に機械可読なデジタルPDFと比較して精度が若干低下する可能性があります。
多言語の給与明細はどのように抽出されますか?
フランス語のfiche de paie、ドイツ語のGehaltsabrechnung、日本語の給与明細など、異なる国の給与明細を処理する場合、AI意味抽出は対応可能です。なぜなら、フィールドのラベルではなく意味を読み取るからです。「Net Pay」「Net à payer」「Nettoverdienst」「差引支給額」はすべて同じ意味であり、多言語AIモデルはこれらを同一の意味フィールドとして認識します。ただし、モデルの学習データが少ない言語やレイアウトでは、抽出精度が若干低下する可能性があります。多言語処理を大量に行う場合は、本番ワークフローに移行する前にサンプルバッチでテストしてください。
抽出したデータを給与計算や会計システムに直接入力できますか?
抽出ツールはデータをExcel、CSV、またはJSON形式で出力しますが、給与計算ソフトへの直接統合は行いません。ほとんどの給与計算システム(ADP、Gusto、Paychex、QuickBooks)や会計プラットフォームはCSVインポートに対応しているため、一般的なワークフローは次のとおりです:給与明細データをCSVに抽出し、そのCSVを対象システムにインポートします。ネイティブ統合と比較すると1ステップ増えますが、手動入力よりはるかに高速です。直接データパイプラインが必要な場合、カスタム統合用のAPIを提供しているツールもあります。
コレクションリンクで他の人の給与明細を収集するにはどうすればいいですか?
コレクションリンクは、アカウントから生成できる共有可能なURLです。住宅ローン申請者、従業員、請負業者など、給与明細を提出する必要がある人にリンクを送信します。相手がリンクを開き、あなたが設定した確認コードを入力し、簡単なWebページから直接書類をアップロードします。ファイルはあなたの処理キューに表示されます。アップロード者はアカウントを作成したりログインしたりする必要はありません。これは、住宅ローン仲介業者が申請者から給与明細を収集する場合、人事チームが新入社員から以前の雇用主の給与明細を集める場合、または会計士がクライアントから四半期ごとの書類を収集する場合に特に便利です。