Le guide complet de
l'extraction de données de fiches de paie
Un souscripteur hypothécaire ouvre un PDF de 42 pages provenant d'un courtier. Quelque part autour de la page 27, enfoui parmi les déclarations de revenus et les relevés bancaires, se trouve le bulletin de paie d'un candidat d'ADP. Page 31, un autre de Gusto. Page 35, un troisième d'un fournisseur de paie que le souscripteur n'a jamais vu auparavant — mise en page différente, libellés différents, positions de colonnes différentes. Tous trois contiennent les mêmes données : nom de l'employé, salaire brut, salaire net, totaux YTD, déductions. Mais extraire ces données dans une seule ligne de comparaison signifie ouvrir trois documents, lire trois modèles différents et saisir des valeurs dans trois cellules de feuille de calcul chacune. Multipliez par 120 demandes ce mois-ci. L'extraction de données de fiches de paie existe parce que ce problème de multiplication est réel, et la saisie manuelle à grande échelle est là où les erreurs se transforment en responsabilité de conformité.
Points clés à retenir
- Un souscripteur hypothécaire traitant 120 demandes par mois ouvre des bulletins de paie d'ADP enfouis à la page 27, de Gusto à la page 31, et d'un fournisseur qu'ils n'ont jamais vu à la page 35 — trois mises en page incompatibles, trois exercices de saisie de données, une décision de prêt.
- L'extraction basée sur des modèles échoue sur les fiches de paie car six fournisseurs de paie dominent le marché américain avec des mises en page fondamentalement incompatibles — et vous ne pouvez pas contrôler le fournisseur choisi par l'employeur de votre candidat.
- Une extraction sans modèle lit les six formats de fournisseurs avec une seule définition de colonne — et lorsque vous séparez « Salaire brut » de « Salaire brut YTD » dans des colonnes distinctes, le chiffre YTD devient un contrôle de fraude intégré : si le brut de la période × les périodes de paie ne correspond pas au total YTD, vous savez exactement quelle fiche de paie extraire pour examen.
Pourquoi l'extraction des fiches de paie est importante
Extraire des fiches de paie n'est rarement le but final. C'est presque toujours une étape dans un processus aval, et ce processus dicte ce qu'une bonne extraction doit réellement apporter. Trois cas d'usage reviennent assez souvent pour définir la demande.
Vérification des revenus. Les prêteurs hypothécaires, les gestionnaires de locations et les agents de crédit auto doivent confirmer que le candidat gagne ce qu'il déclare. Un seul dossier peut contenir des fiches de paie de plusieurs employeurs — ou d'emplois précédents si le candidat a récemment changé de poste. Le prêteur a besoin du salaire net, du salaire brut, de la fréquence de paie et des cumuls annuels de toutes les sources, dans une vue comparative unique, assez rapidement pour ne pas ralentir le pipeline de souscription. Lorsqu'un souscripteur traite 30 ou 40 dossiers par semaine, même deux minutes par fiche de paie pour une saisie manuelle devient un goulot d'étranglement mesuré en heures par semaine.
Recoupement fiscal. Un auditeur de paie qui rapproche les formulaires W-2 de fin d'année avec les relevés de paie trimestriels doit vérifier que les salaires de la case 1, l'impôt fédéral retenu de la case 2, les salaires de la Sécurité sociale de la case 3 et les salaires Medicare de la case 5 correspondent aux données individuelles de chaque période de paie. Un W-2 est un résumé de 12 à 26 fiches de paie individuelles. Lorsque l'auditeur trouve un écart, le retracer signifie ouvrir chaque fiche de paie pour chaque employé concerné — une tâche qui, effectuée manuellement, peut occuper un auditeur pendant une semaine entière pour une entreprise de taille moyenne. L'extraction des fiches de paie transforme cette chasse aux documents en une réconciliation de tableur : extraire toutes les fiches de paie en lignes, additionner les colonnes, comparer avec le W-2, et signaler les écarts en quelques secondes.
Audit de paie multi-employés. Une équipe RH qui gère les factures de prestataires en parallèle de la paie des employés — ou un prestataire de paie externalisé qui gère 50 petites entreprises clientes — doit consolider les données de rémunération sur plusieurs périodes de paie, employés et systèmes de paie. Un employé peut avoir des fiches de paie d'ADP pour son emploi actuel, de Gusto pour une activité secondaire, et de Paychex pour un ancien employeur. Si vous auditez la rémunération totale ou vérifiez l'historique d'emploi, ces trois PDF représentent trois exercices de saisie de données différents. L'extraction les réduit à un seul tableau avec un seul ensemble de colonnes. Pour un aperçu plus approfondi de cette technologie et de ses différences avec les logiciels de paie, consultez notre guide sur ce qu'est réellement l'extraction de données de fiches de paie.
Les défis uniques de l’extraction de fiches de paie
Les fiches de paie partagent certains défis avec les factures et les reçus — diversité des formats, étiquetage incohérent, qualité de numérisation variable — mais elles présentent aussi trois problèmes que presque aucun autre type de document ne crée.
Diversité extrême des formats selon les fournisseurs de paie
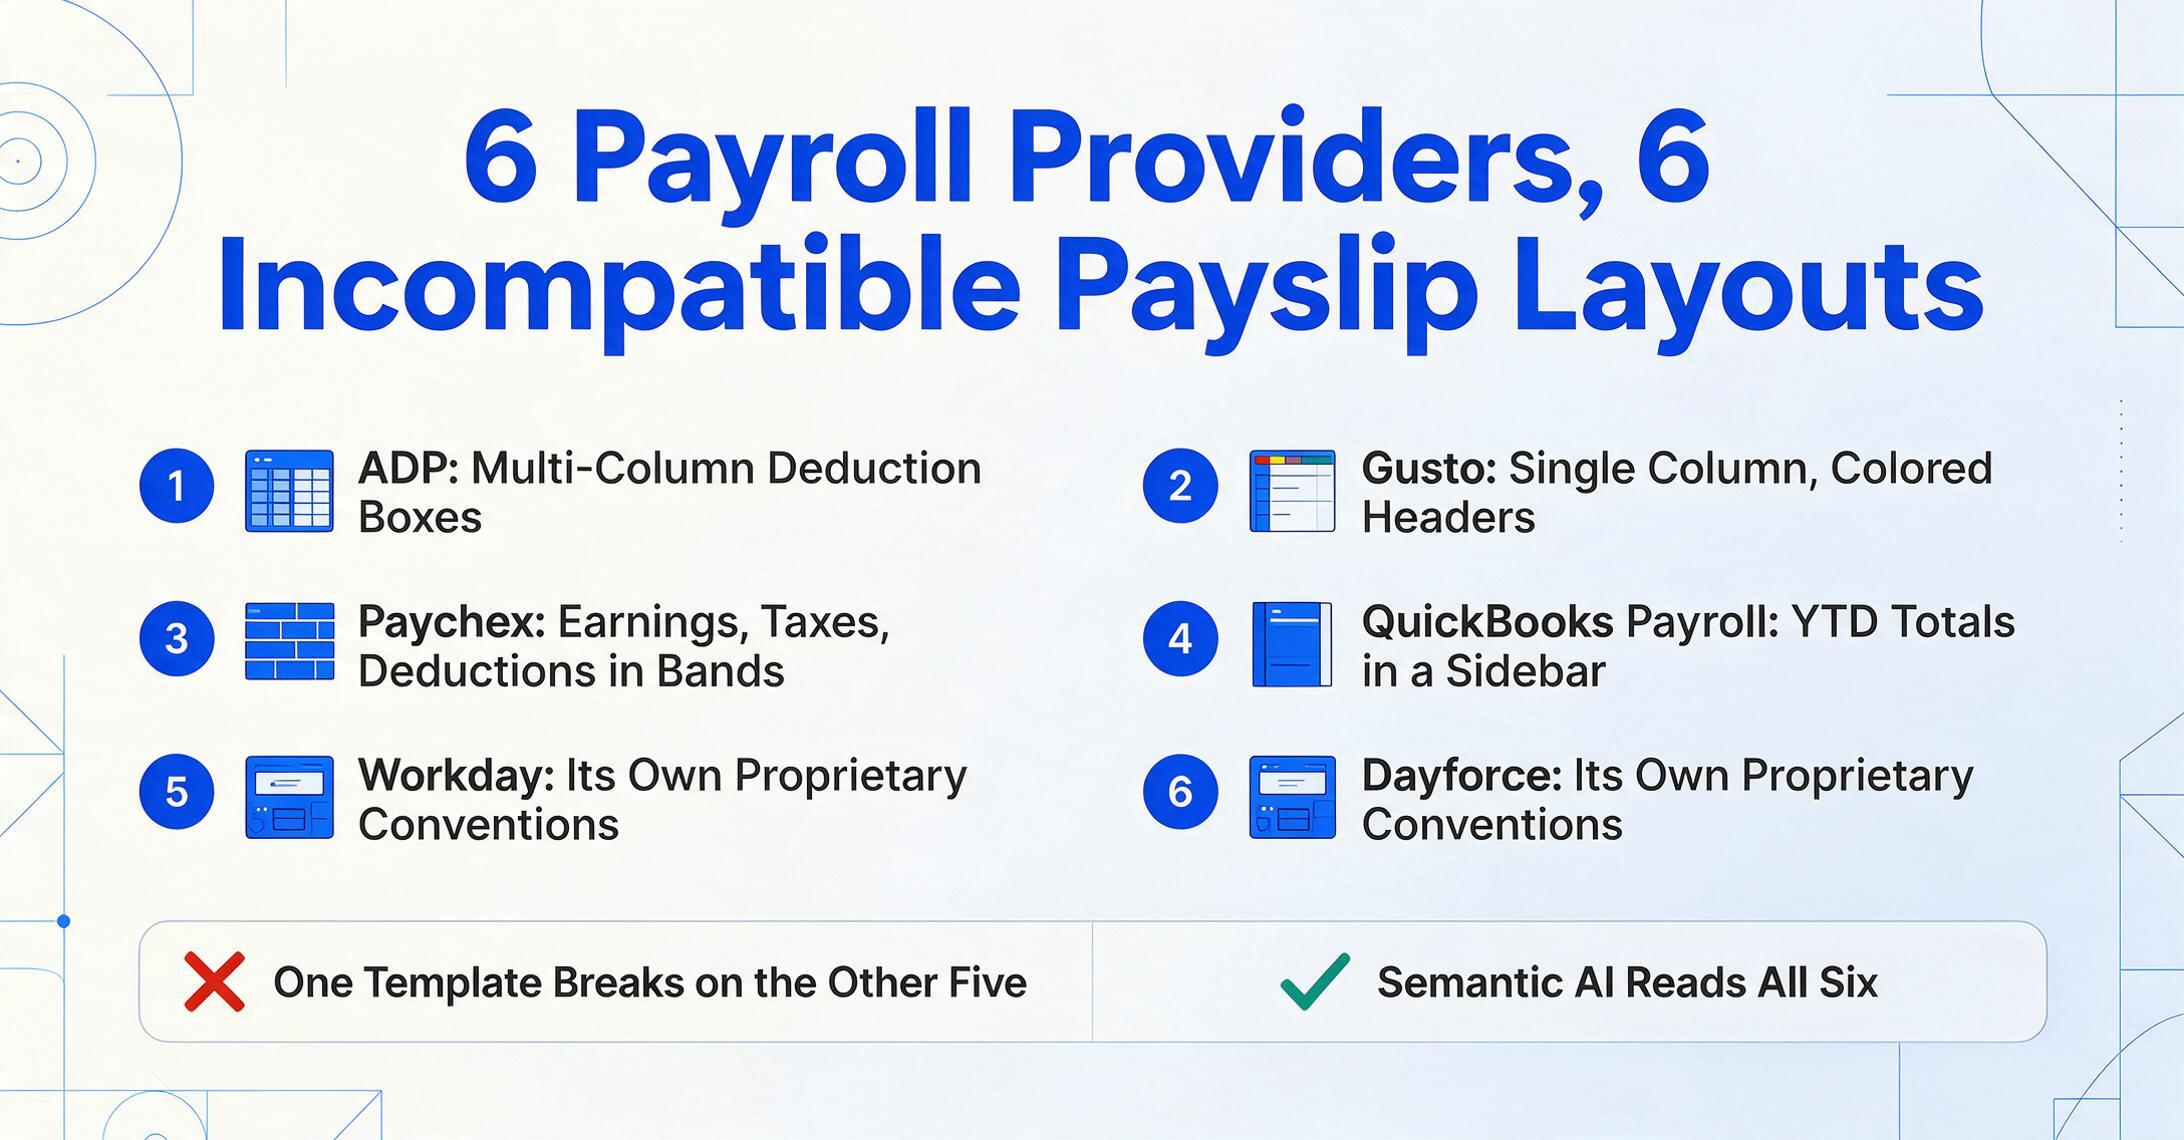
Une facture d’un fournisseur peut différer d’une facture d’un autre fournisseur. C’est un défi. Mais il existe des milliers de fournisseurs émettant des factures — chaque format individuel représente une part infime du total des documents. Les fiches de paie sont l’inverse : six grands fournisseurs de paie génèrent la grande majorité des fiches de paie aux États-Unis, et chacun organise les données différemment. ADP utilise des mises en page multi-colonnes avec des encadrés de déductions catégorisés. Gusto utilise un design plus épuré à une seule colonne avec des en-têtes de sections colorés. Paychex répartit les revenus, les impôts et les déductions dans des bandes horizontales distinctes. QuickBooks Payroll place les totaux YTD dans une barre latérale. Workday et Dayforce ont chacun leurs propres conventions de mise en page propriétaires. Le résultat n’est pas une longue traîne de formats aléatoires — c’est un ensemble concentré de six familles de mises en page distinctes, chacune cohérente en interne mais incompatible avec les autres.
Une approche d’extraction basée sur des modèles qui fonctionne pour les fiches de paie ADP échouera sur les fiches de paie Gusto. Une approche qui fonctionne sur QuickBooks Payroll échouera sur Paychex. L’extraction de fiches de paie doit fonctionner sur toutes, sans configuration par fournisseur, car la personne qui effectue l’extraction contrôle rarement le fournisseur utilisé par l’entreprise de l’employé.
Champs cumulés Year-to-Date
La plupart des types de documents extraient des valeurs par document : le total sur cette facture, la date sur ce reçu, le fournisseur sur ce bon de commande. Les fiches de paie ajoutent une deuxième couche : les chiffres cumulés year-to-date qui ne sont pas des valeurs par document. Une fiche de paie pour la période se terminant le 15 juin peut afficher 3 200 $ de salaire brut pour cette période — et 38 400 $ de salaire brut YTD. Les 38 400 $ correspondent à la somme du salaire brut de chaque période de paie du 1er janvier au 15 juin. Les deux chiffres apparaissent sur le même document, ils sont généralement proches l'un de l'autre, et ils doivent être extraits séparément.
Bien extraire les données YTD est important pour trois raisons. Premièrement, les flux de vérification de revenus utilisent les chiffres YTD pour confirmer que le salaire au niveau de la période est cohérent avec les totaux annuels — un écart entre « salaire brut de cette période × périodes de paie écoulées » et « salaire brut YTD » est un indicateur de fraude que les prêteurs vérifient spécifiquement. Deuxièmement, le rapprochement fiscal avec les formulaires W-2 exige les données YTD, car le W-2 indique les totaux de l'année complète, pas le détail par période. Troisièmement, lors du traitement de plusieurs fiches de paie du même employé sur une année, le champ YTD de la fiche de décembre sert de point de contrôle de validation intégré : la somme de tous les salaires bruts par période doit être égale au salaire brut YTD de décembre. Si ce n'est pas le cas, soit une erreur d'extraction s'est produite, soit une fiche de paie manquait dans le lot.
Retenues vs cotisations patronales — des champs opposés
C'est le défi spécifique aux fiches de paie qui piège le plus les outils d'extraction génériques. Chaque fiche de paie comporte deux catégories de montants hors salaire, et elles vont dans des directions opposées :
- Retenues : les montants soustraits du salaire brut de l'employé avant d'arriver au salaire net. Impôt fédéral sur le revenu, impôt d'État, Sécurité sociale (6,2 %), Medicare (1,45 %), report 401(k) de l'employé, part de prime d'assurance maladie — tout cela réduit le montant net perçu par l'employé. C'est de l'argent que l'employé a gagné mais ne reçoit pas, car il va aux autorités fiscales ou aux prestataires de prestations.
- Cotisations patronales : les montants que l'employeur paie en plus du salaire brut de l'employé. La contribution 401(k) de contrepartie de l'employeur, la part d'assurance maladie payée par l'employeur, la Sécurité sociale (6,2 %) et Medicare (1,45 %) payées par l'employeur — ce sont des coûts supportés par l'employeur qui ne transitent jamais par la ligne de paie de l'employé. Ils apparaissent sur la fiche de paie par souci de transparence mais ne font pas partie du calcul du salaire net.
Un outil d'extraction générique qui lit « 401(k) » sur une fiche de paie doit décider : s'agit-il de la retenue de l'employé ou de la contrepartie patronale ? Les deux peuvent indiquer « 401(k) » ou « Retraite » avec des montants différents. Un humain qui lit la fiche de paie comprend quel montant est soustrait du salaire brut et lequel est listé séparément comme cotisation patronale. Un système d'extraction par IA a besoin de la même compréhension contextuelle — lire la position du champ dans la structure du document, pas seulement son libellé — pour attribuer chaque valeur à la bonne colonne.
Consolidation sur plusieurs périodes de paie
En matière de vérification de revenus, la norme n'est pas un seul bulletin de paie, mais deux à trois mois de bulletins consécutifs, parfois plus. Un souscripteur hypothécaire qui examine une demande doit constater que les revenus sont stables d'une période à l'autre — pas seulement qu'un bulletin semble bon. Cela signifie extraire 4 à 6 bulletins par demandeur (pour un paiement bihebdomadaire), chacun avec ses propres valeurs de période et YTD, puis les consolider dans un tableau comparatif unique.
La consolidation manuelle implique d'ouvrir chaque bulletin en PDF, de trouver les six ou sept champs nécessaires, de les saisir dans une ligne de feuille de calcul, et de répéter l'opération. Avec 30 demandeurs et 5 bulletins chacun, cela représente 150 documents — et 900 à 1 050 points de données à transcrire. Une seule erreur de saisie dans l'une de ces cellules compromet le recoupement YTD ou produit un salaire net qui ne correspond pas au calcul brut-moins-déductions. L'extraction par lots résout ce problème en traitant tous les bulletins d'un demandeur donné — ou tous les bulletins de tous les demandeurs — en une seule passe, produisant une feuille de calcul unique où chaque ligne correspond à un bulletin et où vous pouvez filtrer par nom d'employé ou identifiant de demandeur.
Méthodes traditionnelles vs extraction par IA
Il existe trois façons de faire entrer les données des bulletins de paie dans une feuille de calcul, et elles se situent sur un spectre allant du totalement manuel au totalement automatisé — avec des profils de fiabilité très différents à chaque niveau.
| Méthode | Fonctionnement | Vitesse (par bulletin) | Gère la diversité des formats | Gère les champs YTD |
|---|---|---|---|---|
| Saisie manuelle | Ouvrir le PDF, lire chaque champ, saisir dans la cellule de la feuille de calcul une par une | ~3 minutes | Oui (l'humain s'adapte) | Oui (l'humain comprend) |
| Modèle / OCR zonal | Définir des zones de coordonnées par mise en page du fournisseur ; l'OCR lit le texte dans chaque zone | ~10-15 secondes | Non — échoue sur les nouvelles mises en page | Non — extrait le texte mais ne distingue pas période vs YTD |
| Extraction sémantique par IA | L'IA visuelle lit le document en comprenant le sens des champs, pas leur position | ~5-10 secondes | Oui — indépendant de la mise en page | Oui — distingue selon le contexte du champ |
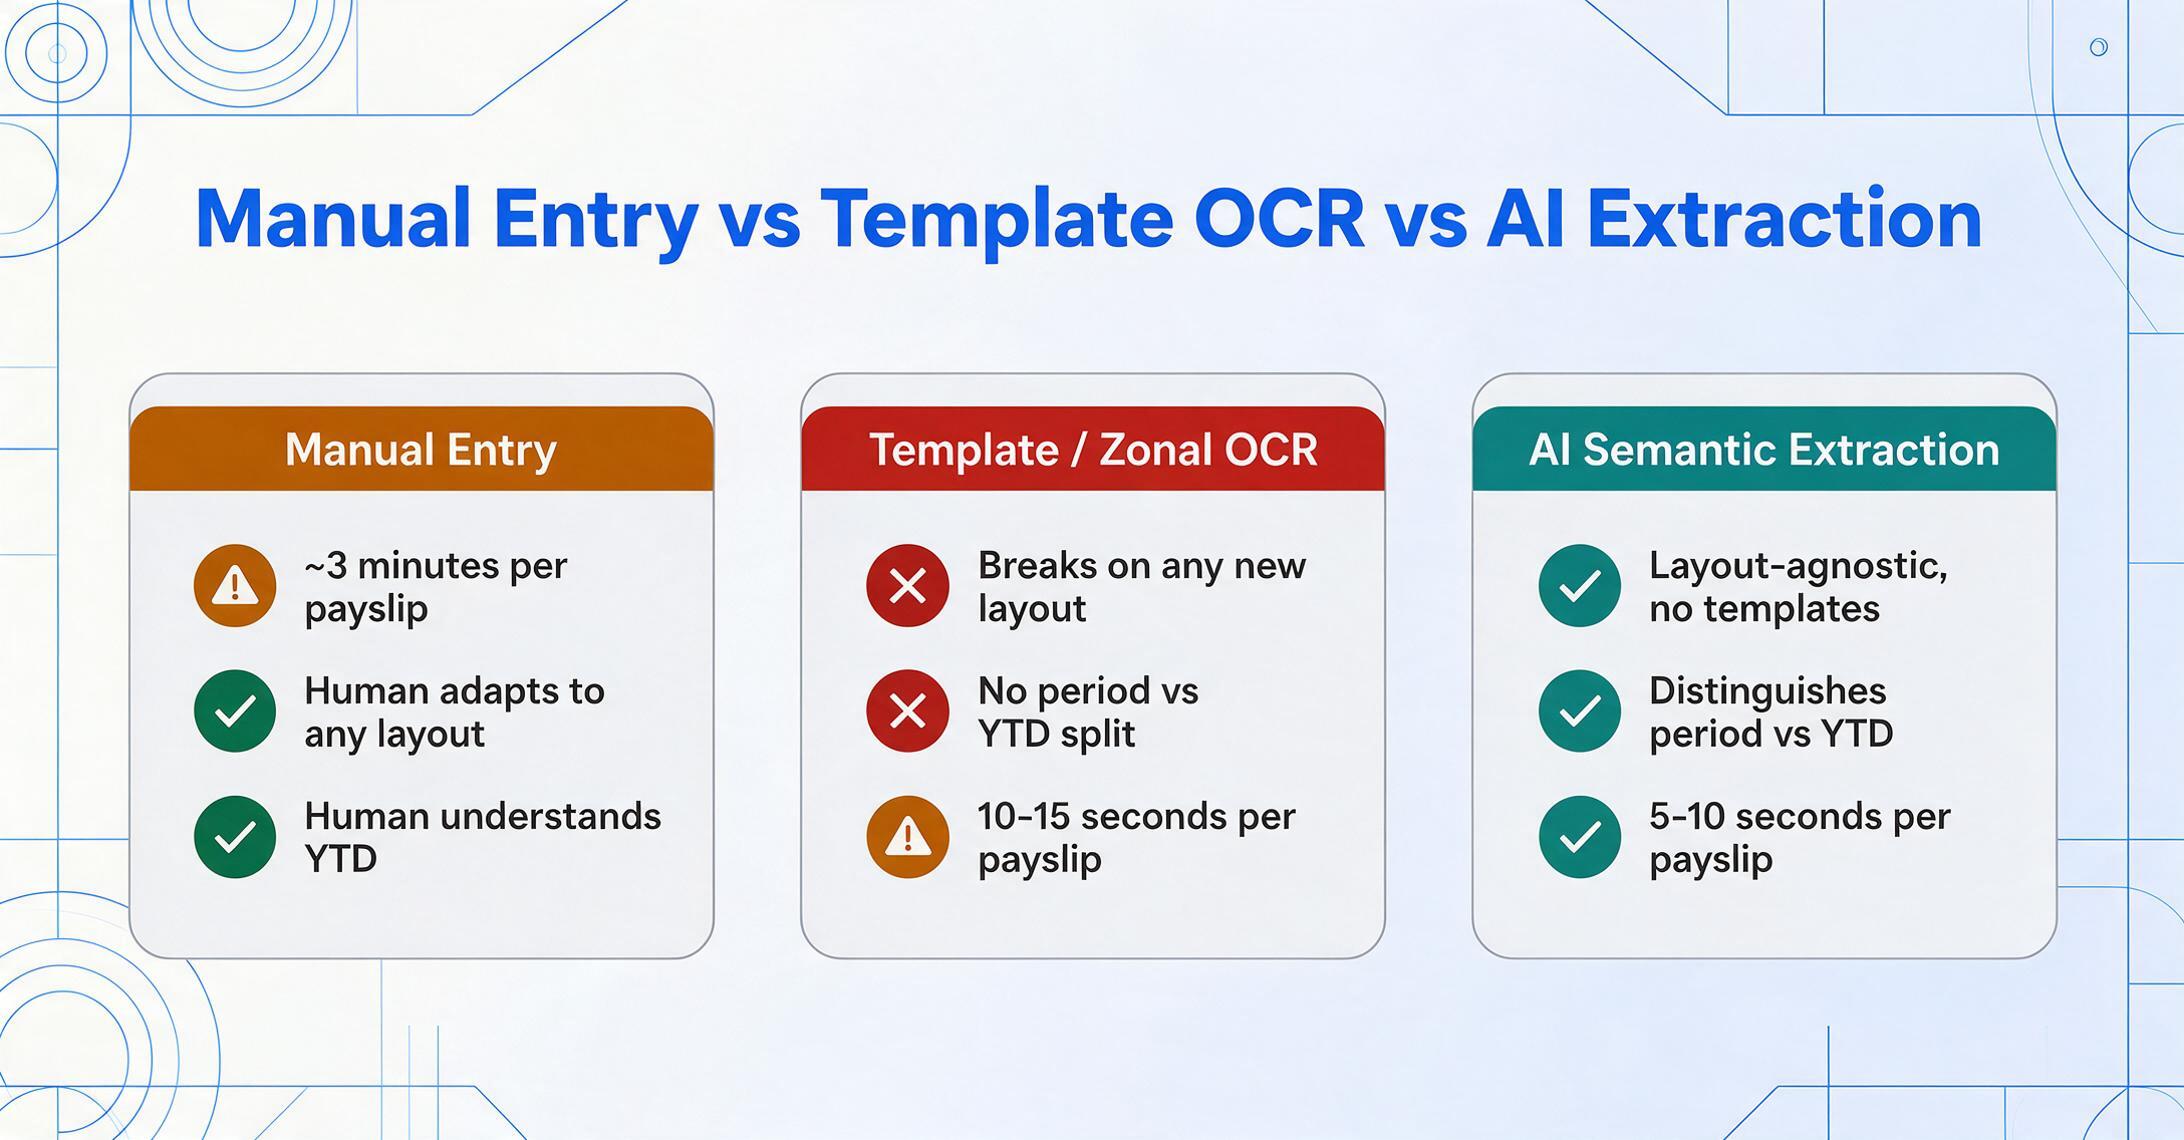
L'OCR basé sur des modèles — l'approche utilisée par les outils de traitement documentaire hérités — fonctionne en dessinant des zones rectangulaires sur une image de document et en exécutant l'OCR dans chaque zone. Si vous définissez une zone pour « Salaire net » aux coordonnées (420, 680, 520, 700) sur un modèle de bulletin ADP, le système lit le texte qui apparaît dans ce rectangle. Dès qu'un bulletin arrive de Gusto — où le salaire net se trouve à une position complètement différente — la zone lit un espace vide ou un champ erroné. Comme les six principaux fournisseurs de paie utilisent chacun des mises en page différentes, un système à modèles nécessite au minimum six modèles, et tout nouveau format exige d'en construire un septième. Ce n'est pas de l'automatisation ; c'est de la configuration manuelle numérisée.
L'extraction sémantique par IA fonctionne différemment. Au lieu de définir où se trouvent les données sur la page, vous définissez quelles données vous voulez — en saisissant les noms de colonnes dont vous avez besoin, comme « Nom de l'employé », « Salaire brut », « Salaire net », « Impôt fédéral YTD ». L'IA lit l'intégralité du document, comprend ce que signifie chaque valeur étiquetée en fonction de son contexte dans la structure du bulletin de paie, et remplit la colonne correspondante, quel que soit l'endroit où la valeur apparaît. C'est le changement fondamental entre l'extraction basée sur la position et l'extraction sémantique — et c'est ce qui rend le traitement des bulletins de paie viable pour plusieurs fournisseurs de paie sans configuration par fournisseur.
La différence d'efficacité est mesurable. Les recherches de l'American Payroll Association situent les taux d'erreur de paie manuels à 1 à 8 % de la masse salariale totale pour les entreprises qui s'appuient sur des processus manuels. À 3 minutes par bulletin de paie pour la saisie manuelle contre 5 à 10 secondes pour l'extraction par IA, le traitement de 200 bulletins de paie passe de 10 heures à environ 20 à 30 minutes — une amélioration de 18 fois.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Champs clés à extraire d'un bulletin de paie
Ce que vous extrayez dépend de votre flux de travail. Un flux de vérification de revenus peut nécessiter six champs. Un audit de paie peut en nécessiter vingt. Voici les groupes de champs qui couvrent les usages en aval les plus courants, organisés selon ce que chaque champ vous indique et où il s'intègre dans votre processus.
Employé et employeur
- Nom et identifiant de l'employé
- Nom de l'employeur
- Date de début et de fin de la période de paie
- Date de paie
- Fréquence de paie (hebdomadaire/bihebdomadaire/bimensuelle/mensuelle)
Rémunération
- Salaire brut (cette période)
- Salaire de base / heures régulières et taux
- Heures supplémentaires et rémunération
- Primes / commissions
- Indemnités (déplacement, logement, repas)
Retenues (sur le salaire de l'employé)
- Impôt fédéral sur le revenu
- Impôt d'État et local
- Sécurité sociale (6,2 %)
- Medicare (1,45 %)
- 401(k) / report de retraite
- Primes santé/dentaire/vision
- Saisies sur salaire / autres
YTD et cotisations patronales
- Salaire brut YTD
- Impôt fédéral / d'État / local YTD
- Sécurité sociale et Medicare YTD
- 401(k) / retraite YTD
- Salaire net (cette période)
- Salaire net YTD
- Contribution patronale 401(k) / cotisation santé
Lorsque vous définissez des colonnes pour l'extraction, gardez deux choses à l'esprit. Premièrement, séparez les valeurs de période des valeurs YTD dans des colonnes distinctes — « Salaire brut » et « Salaire brut YTD » doivent être deux colonnes, pas une, car elles servent des objectifs en aval différents (analyse de période vs rapprochement de fin d'année). Deuxièmement, séparez les retenues employé des cotisations patronales — créez « 401(k) Employé » et « 401(k) Employeur » comme colonnes distinctes plutôt qu'une seule colonne « 401(k) » qui confond les deux montants. L'IA peut les distinguer si vous les demandez séparément ; si vous demandez une seule colonne « 401(k) », elle peut renvoyer l'un ou l'autre montant selon celui qu'elle rencontre en premier sur le document.
Comment fonctionne le traitement par lots pour les fiches de paie
Le traitement par lots est ce qui rend l'extraction des fiches de paie pratique à grande échelle. Au lieu d'extraire un bulletin de paie à la fois, vous téléversez tous les bulletins de paie pour un lot donné — tous les candidats cette semaine, tous les employés ce trimestre, tous les entrepreneurs cette année fiscale — et le système les traite ensemble, produisant une seule feuille de calcul avec une ligne par bulletin de paie.
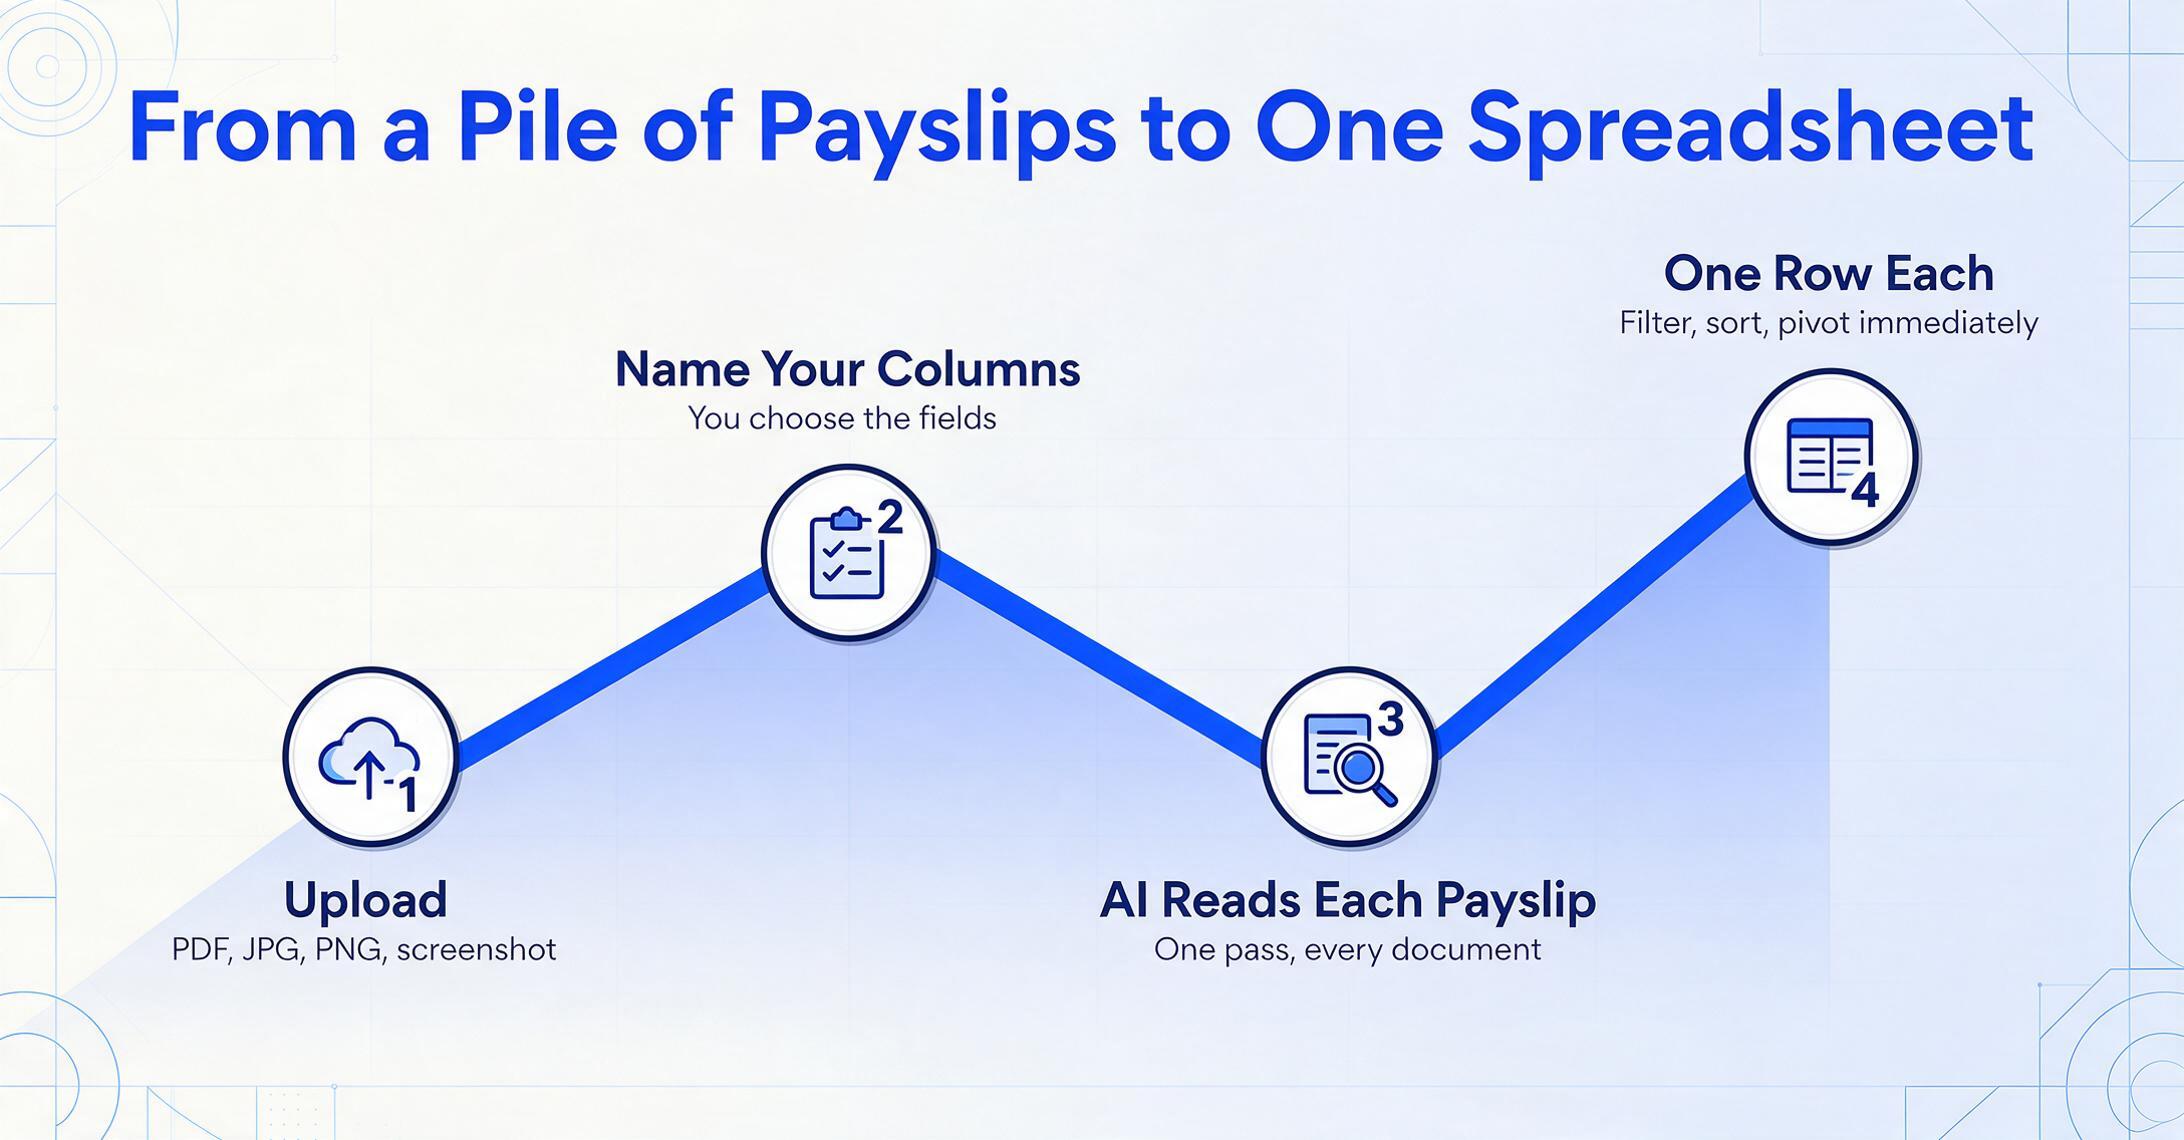
Le flux de travail suit un schéma cohérent : téléversez vos documents (PDF, JPG, PNG ou captures d'écran de n'importe quel fournisseur de paie), définissez les noms de colonnes que vous souhaitez extraire, et laissez l'IA lire chaque document et remplir la ligne correspondante. Le résultat est un fichier Excel où chaque ligne représente un bulletin de paie, chaque colonne représente un champ extrait, et vous pouvez filtrer, trier et pivoter les données immédiatement — aucune transcription manuelle, aucun copier-coller entre documents, aucune reconstruction de formules de feuille de calcul à chaque période de paie.
Le traitement par lots des fiches de paie est particulièrement important dans trois scénarios. Lors du traitement de demandes hypothécaires ou locatives en volume, téléversez tous les bulletins de paie des candidats en une fois et obtenez une feuille de calcul avec une colonne pour l'identifiant du candidat — filtrez pour n'importe quel candidat afin de voir tous ses bulletins de paie en lignes consécutives avec la progression YTD visible. Lors du traitement de rapprochements de paie trimestriels ou de fin d'année, téléversez un trimestre entier de bulletins de paie et laissez les colonnes YTD fournir une validation intégrée — la somme de toutes les valeurs de rémunération brute de la période doit correspondre au chiffre final de rémunération brute YTD. Lors du traitement d'audits RH multi-employés, téléversez des bulletins de paie de plusieurs employés et périodes de paie pour construire une vue consolidée de la rémunération sans ouvrir un seul PDF.
Pour les équipes qui doivent collecter des fiches de paie auprès de plusieurs personnes — candidats, employés, entrepreneurs — un Lien de collecte simplifie le côté réception. Vous générez un lien partageable, vous l'envoyez à chaque personne qui doit soumettre des bulletins de paie, et elles téléversent leurs documents directement via ce lien. Les fichiers arrivent automatiquement dans votre file de traitement. Pas de chasse aux pièces jointes par e-mail, pas de transfert de PDF de votre boîte de réception vers l'outil d'extraction, pas de demande aux candidats de se connecter à un système pour lequel ils n'ont pas d'identifiants. La personne qui téléverse n'a besoin que du lien et d'un code de vérification.
Exportation et utilisation de vos données extraites
Le résultat de l'extraction n'est utile que si les formats sont adaptés et les données propres. Trois formats d'export couvrent les usages les plus courants :
- Excel (XLSX) — Le format par défaut pour la plupart des workflows RH et paie. Les données arrivent dans un tableur avec des en-têtes de colonnes, des dates normalisées et des champs numériques formatés en nombres (pas en texte). Vous pouvez immédiatement filtrer par employé, additionner le salaire brut par mois ou créer un tableau croisé dynamique pour l'analyse des rémunérations — sans nettoyage post-extraction des dates stockées en texte ou des montants monétaires.
- CSV — Idéal pour importer les données dans un logiciel de paie, un système comptable ou une base de données personnalisée. La plupart des plateformes de paie et ERP acceptent les imports CSV pour la saisie en masse. Un CSV propre issu de l'extraction vous évite de formater manuellement un tableur avant l'import.
- JSON — Pour l'intégration avec des applications sur mesure, des API ou des pipelines de vérification automatisés. Si vous construisez un workflow de vérification des revenus qui compare les données extraites des fiches de paie aux formulaires de demande, le JSON s'intègre directement dans cette logique.
Pour les utilisateurs de Google Sheets, un module complémentaire Google Sheets permet l'extraction directement dans le classeur actif — importez les fiches de paie depuis Sheets, définissez vos colonnes et ajoutez les lignes extraites sans changer d'application. Utile pour les équipes qui travaillent dans Google Sheets pour le rapprochement de paie ou le suivi des revenus et veulent éviter l'aller-retour export-réimport.
Choisir une approche d'extraction des fiches de paie
Tous les outils d'extraction ne gèrent pas bien les fiches de paie, et les fonctionnalités importantes pour les fiches de paie diffèrent de celles pour les factures. Voici les critères à évaluer :
Fonctionnement sans modèle. C'est le critère le plus important pour l'extraction de fiches de paie. Si un outil nécessite de créer un modèle par fournisseur de paie — définir des zones, s'entraîner sur des échantillons ou configurer des règles de mise en page — vous passerez plus de temps en configuration que vous n'en gagnerez en extraction, car les fiches de paie de différents fournisseurs ont des mises en page radicalement différentes. Un outil sans modèle lit n'importe quel format de fiche de paie sans configuration par fournisseur. Il comprend que « Salaire net » signifie la même chose, qu'il apparaisse en bas à droite d'un bulletin ADP ou au milieu d'un bulletin Gusto.
Définition personnalisée des colonnes. Vous devez pouvoir définir exactement les champs à extraire, par leur nom. Un outil qui extrait un ensemble fixe de champs — par exemple, toujours « Salaire brut » et « Salaire net » mais rien d'autre — vous limite à ses hypothèses sur ce qui est important. Votre workflow de vérification des revenus peut nécessiter « Salaire brut cumulé », « Fréquence de paie » et « Nom de l'employeur ». Votre audit de paie peut nécessiter « Heures supplémentaires », « Cotisation 401(k) employé » et « Saisies sur salaire ». L'outil doit extraire ce que vous demandez, pas ce qu'il a été préconfiguré pour trouver.
Traitement par lots. L'extraction d'un seul document est utile pour des vérifications ponctuelles. L'extraction par lots — importer 50 ou 200 fiches de paie et obtenir un seul fichier fusionné — est ce qui rend l'outil viable pour des workflows réels. Si vous traitez des demandes de prêt hypothécaire ou des rapprochements de paie trimestriels, le traitement par lots n'est pas optionnel ; c'est la différence entre un outil que vous utilisez et un outil que vous abandonnez après la première semaine.
Précision des champs CUM. Testez ce point avant de choisir un outil. Importez un bulletin où le salaire brut de la période est de 3 200 € et le salaire brut cumulé (CUM) de 38 400 € — vérifiez que l'outil place chaque valeur dans la bonne colonne. S'il met la valeur CUM dans la colonne du salaire de la période (ou l'inverse), l'outil ne comprend pas la différence sémantique entre champs périodiques et cumulés, et votre rapprochement sera peu fiable.
Distinction retenue / cotisation. Importez un bulletin qui mentionne à la fois « 401(k) Salarié » (une retenue sur le salaire) et « 401(k) Part patronale » (une cotisation employeur distincte). Vérifiez que l'outil extrait les deux dans des colonnes séparées sans les confondre. Dans le cas contraire, votre analyse de rémunération mélangera l'argent du salarié et celui de l'employeur dans le même poste — une erreur matérielle pour tout processus calculant le coût total de la rémunération.
Questions fréquentes
L'extraction de fiches de paie fonctionne-t-elle avec n'importe quel logiciel de paie ?
Oui, si l'outil utilise l'extraction par IA sémantique plutôt que la reconnaissance optique basée sur des modèles. L'extraction sémantique lit les champs en comprenant leur signification, sans correspondre à une mise en page prédéfinie. Elle fonctionne donc avec ADP, Gusto, Paychex, QuickBooks Payroll, Workday, Dayforce et des prestataires régionaux plus petits. L'outil n'a pas besoin de connaître le format d'un fournisseur particulier : il lit le document et localise chaque champ selon son rôle dans la structure de la fiche de paie.
Quelle est la précision de l'extraction des champs cumul annuel ?
La précision de l'extraction du cumul annuel dépend de la capacité de l'IA à distinguer les champs de période des champs cumulatifs par le contexte. Sur les fiches de paie numériques bien formatées des grands prestataires, l'extraction atteint généralement 95 à 99 % de précision. Sur les fiches scannées ou photographiées où les champs cumul annuel et période sont proches avec des libellés similaires, la précision peut baisser, surtout si le scan est de faible résolution ou si le document est de travers. Pour les processus critiques comme le montage de prêt hypothécaire, vérifiez les valeurs cumul annuel par rapport au calcul de période (brut période × nombre de périodes de paie à ce jour ≈ cumul annuel brut) comme étape de validation intégrée avant d'utiliser les données extraites.
L'outil peut-il traiter les annotations manuscrites sur les fiches de paie ?
L'extraction par IA peut lire le texte imprimé, l'écriture manuscrite et les documents à contenu mixte. Si une fiche de paie comporte des corrections ou annotations manuscrites — initiales d'un responsable, montant d'ajustement écrit à la main — l'IA tentera de les extraire. Cependant, la précision pour l'écriture manuscrite est inférieure à celle du texte imprimé, surtout pour l'écriture cursive ou les petites annotations. Si les corrections manuscrites sont fréquentes dans votre flux de fiches de paie, vérifiez ces champs manuellement ou mettez en place une étape de validation pour les documents signalés comme contenant de l'écriture manuscrite.
L'extraction par lot fusionne-t-elle les données de différentes périodes de paie dans un seul tableur ?
Oui. Lorsque vous téléchargez des fiches de paie couvrant plusieurs périodes — que ce soit pour un seul employé sur une année ou pour plusieurs employés sur différentes périodes — l'outil traite tous les documents ensemble et produit un seul tableur. Chaque ligne correspond à une fiche de paie avec ses propres dates de période, vous permettant de filtrer, trier et regrouper par employé, plage de dates ou fréquence de paie sans consolidation manuelle.
L'outil peut-il vérifier l'authenticité d'un bulletin de paie ou détecter une fraude ?
Les outils d'extraction par IA ne sont pas des systèmes de détection de fraude. Cependant, une extraction cohérente vous permet d'effectuer vos propres vérifications : comparer les cumuls annuels avec les calculs périodiques, vérifier que le net correspond au brut moins les déductions, et s'assurer que la fréquence de paie correspond aux dates de la période. Des incohérences dans ces contrôles mathématiques peuvent indiquer soit une erreur d'extraction, soit un document manipulé — les deux méritent une enquête. Certains outils spécialisés de vérification de bulletins de paie offrent une détection dédiée des fraudes, mais les outils d'extraction à usage général lisent les données ; ils n'authentifient pas le document.
Quels formats de fichiers sont pris en charge pour l'extraction des bulletins de paie ?
La plupart des outils d'extraction par IA prennent en charge le PDF (numérique et scanné), JPG, PNG, WebP et les captures d'écran. La distinction clé se fait entre les PDF numériques (où le texte est intégré sous forme de texte sélectionnable) et les PDF scannés ou image (où le document est une photographie du papier). L'extraction par IA gère les deux, bien que les PDF basés sur une image nécessitent que l'IA effectue d'abord une OCR, ce qui peut légèrement réduire la précision par rapport aux PDF numériques où le texte est déjà lisible par machine.
Comment l'extraction gère-t-elle les bulletins de paie multilingues ?
Si vous traitez des bulletins de paie de différents pays — une fiche de paie française, un Gehaltsabrechnung allemand, un 給与明細 japonais — l'extraction sémantique par IA peut les gérer car elle lit le sens du champ, pas son libellé. "Net Pay", "Net à payer", "Nettoverdienst" et "差引支給額" signifient tous la même chose, et un modèle d'IA multilingue les reconnaît comme le même champ sémantique. Cependant, la précision de l'extraction peut être légèrement inférieure pour les langues ou les mises en page sur lesquelles le modèle dispose de moins de données d'entraînement. Pour un traitement multilingue à volume élevé, testez avec un échantillon avant de vous engager dans un workflow de production.
Puis-je utiliser l'extraction pour alimenter directement mon système de paie ou de comptabilité ?
Les outils d'extraction produisent des données au format Excel, CSV ou JSON — pas une intégration directe dans un logiciel de paie. La plupart des systèmes de paie (ADP, Gusto, Paychex, QuickBooks) et plateformes comptables acceptent les importations CSV, donc le workflow typique est : extraire les données du bulletin de paie en CSV, puis importer le CSV dans votre système cible. C'est une étape supplémentaire par rapport à une intégration native, mais c'est toujours massivement plus rapide que la saisie manuelle. Certains outils offrent un accès API pour des intégrations personnalisées si vous avez besoin d'un pipeline de données direct.
Comment fonctionne le lien de collecte pour récupérer les fiches de paie d'autres personnes ?
Un lien de collecte est une URL partageable générée depuis votre compte. Vous envoyez ce lien à toute personne devant soumettre des fiches de paie — candidats à un prêt immobilier, employés, sous-traitants. Ils ouvrent le lien, saisissent un code de vérification que vous avez défini, et téléversent leurs documents directement via une page web simple. Les fichiers apparaissent dans votre file de traitement. Le déposant n'a pas besoin de créer de compte ni de se connecter. Cela est particulièrement utile pour les courtiers en prêts immobiliers collectant les fiches de paie des candidats, les équipes RH récupérant les fiches de paie d'anciens employeurs auprès des nouvelles recrues, ou les comptables rassemblant la documentation trimestrielle des clients.