建築基準法の提出要件、
1,000ページに埋もれて
r/estimatorsの積算担当者は、この仕事を一文で表現しました。「私は現在、Ctrl+Fでベースラインの材料要件(15mm銅配管、アイソレーションバルブ、特定のメーターボックスなど)をすべて見つけるのに苦労しています。」スレッドのタイトルは「150ページの仕様書でのCtrl+Fが私を苦しめている」でした。150ページの仕様書を1,000ページの建築基準法に置き換えると、この方法は機能しなくなります。ただし、タイピングが遅くなるからではありません。
文書内で単語を検索すると、その単語が現れるすべての場所が見つかります。しかし、別の言葉で書かれた要件を見つけることはできません。このギャップには情報検索の分野で名前があります:再現率、つまり検索が実際に見つけた関連アイテム全体の割合です。対照的に適合率は、返された結果のうち関連するものの割合です。Ctrl+Fは適合率が高く再現率が低く、1,000ページの規範文書では、欠落した部分が数週間後のレビューサイクルを停滞させます。
重要なポイント
- 米国の手戻りの48パーセントは不十分なプロジェクトデータに起因し、Ctrl+Fでは別の言葉で書かれた要件を見つけることはできません。
- 要件セットは、Division 01のルール、各セクションのSubmittals記事、図面注記、参照規格にわたる和集合です。
- 最初に5つの列を定義し、次に抽出した各行をImageToTable.aiのReview Modeでソースページと照合して確認します。
3週間後に顕在化する見落とし
提出要件の見落としは、見落とされた時点で気づかれることはほとんどありません。それは後になって、リードタイムの長い項目が製作段階に達し、誰も施工図を承認していないことが判明したとき、あるいはレビュー担当者が提出されていない証明書を求めたときに表面化します。商業プロジェクトでは、提出物は各専門工事の調達と据付のゲートとなるものです。1つの項目が欠落するだけで、その専門工事はパッケージのレビューが完了するまで保留されます。
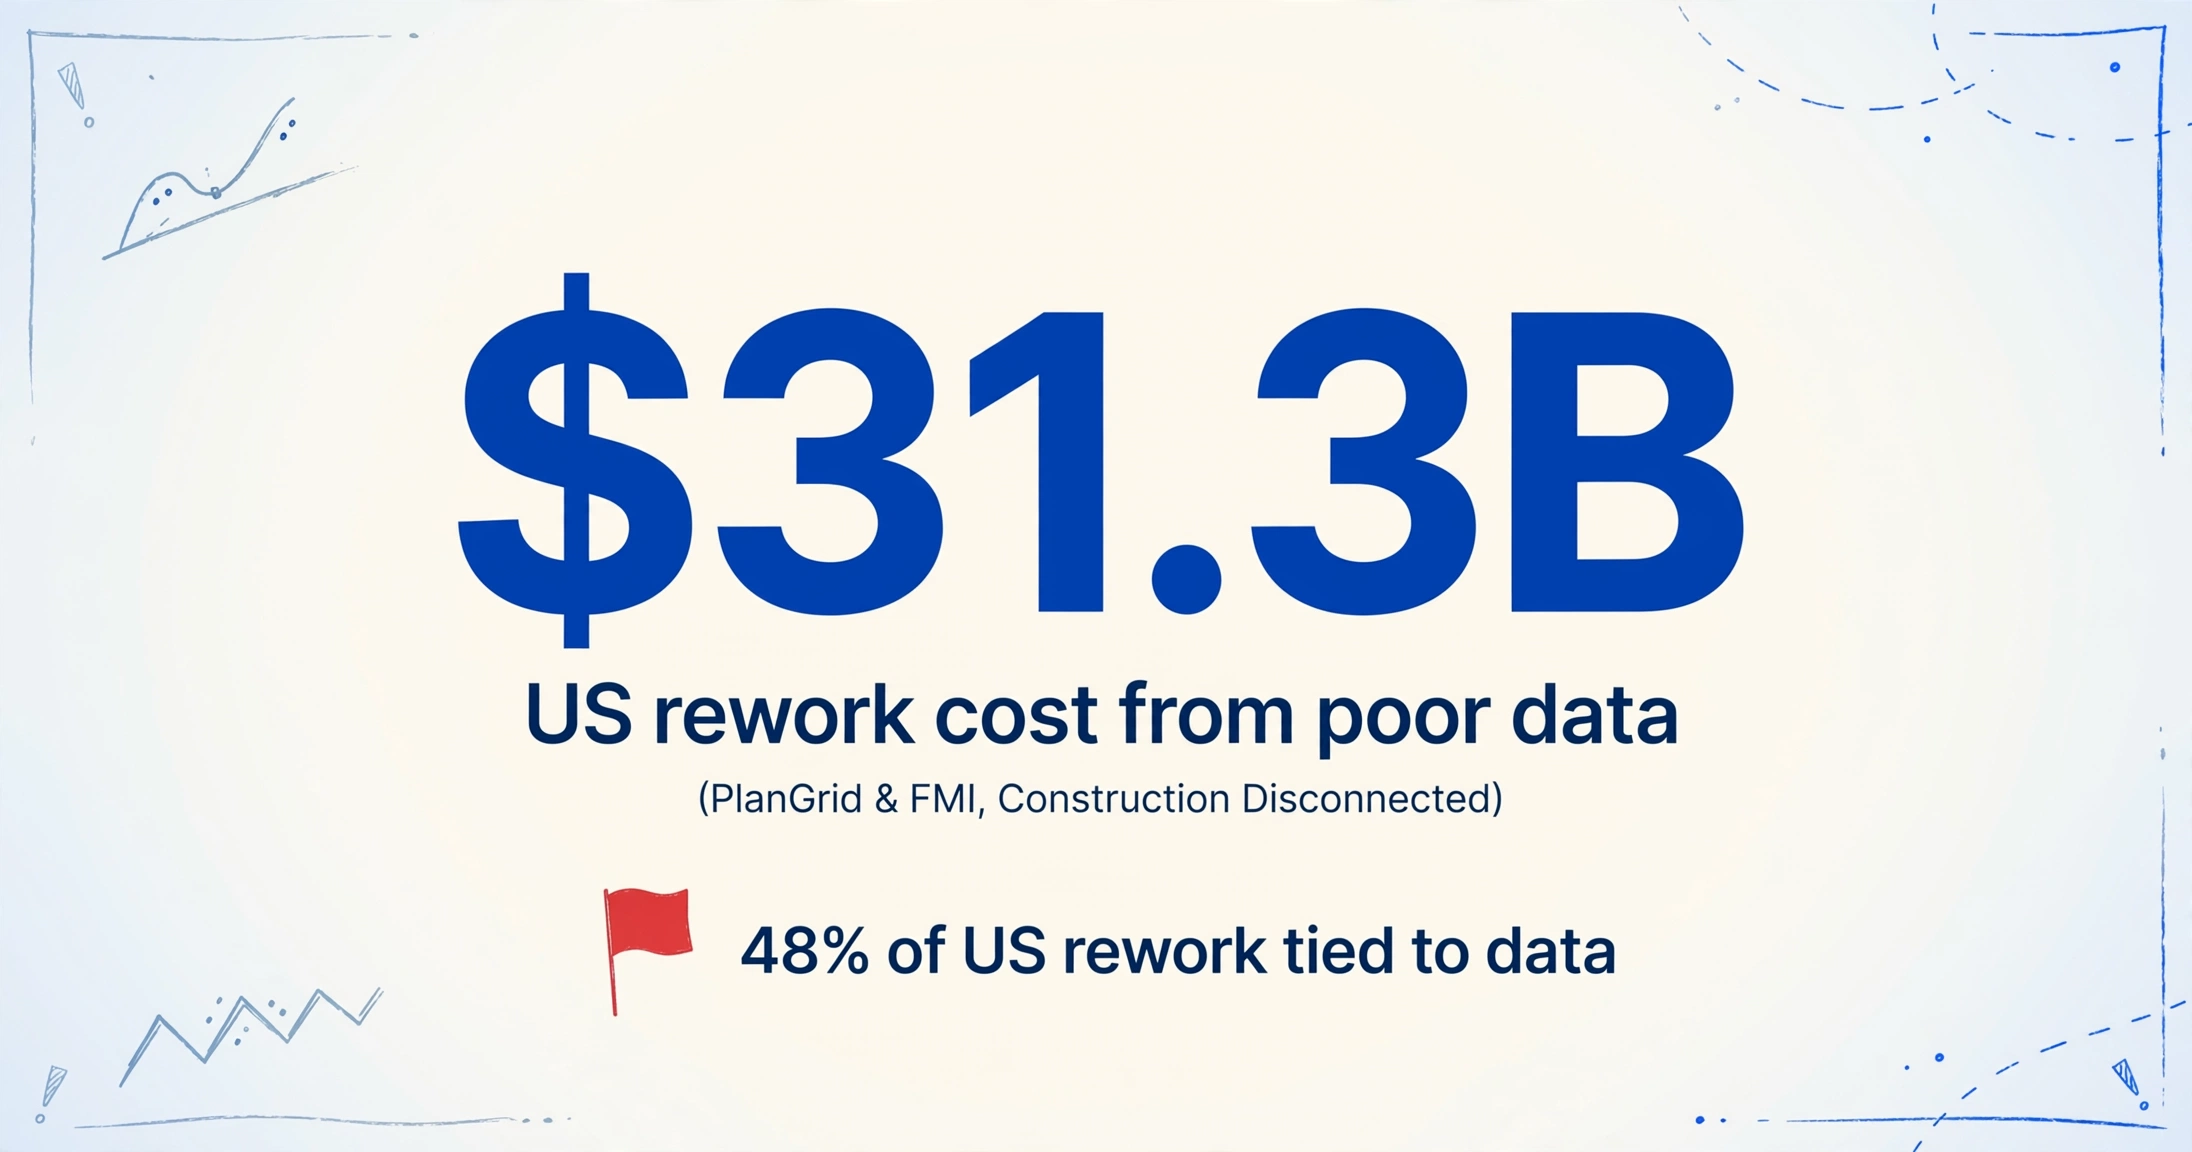
そのパターンのコストは、逸話ではなく測定可能なものです。PlanGridとFMIが共同で実施した、約600人の建設専門家を対象とした調査、Construction Disconnectedは、米国の手直しの48%、世界全体では52%が、不十分なプロジェクトデータと誤ったコミュニケーションに起因するとし、その金額は米国だけで単年度に313億ドルに上るとしています。欠落またはアクセス不能なプロジェクト情報は、その内訳のデータ側に位置します。手作業で作成され、完全であることを期待された要件リストは、まさにこの調査が指摘している種類の文書です。
提出要件が実際に存在する場所
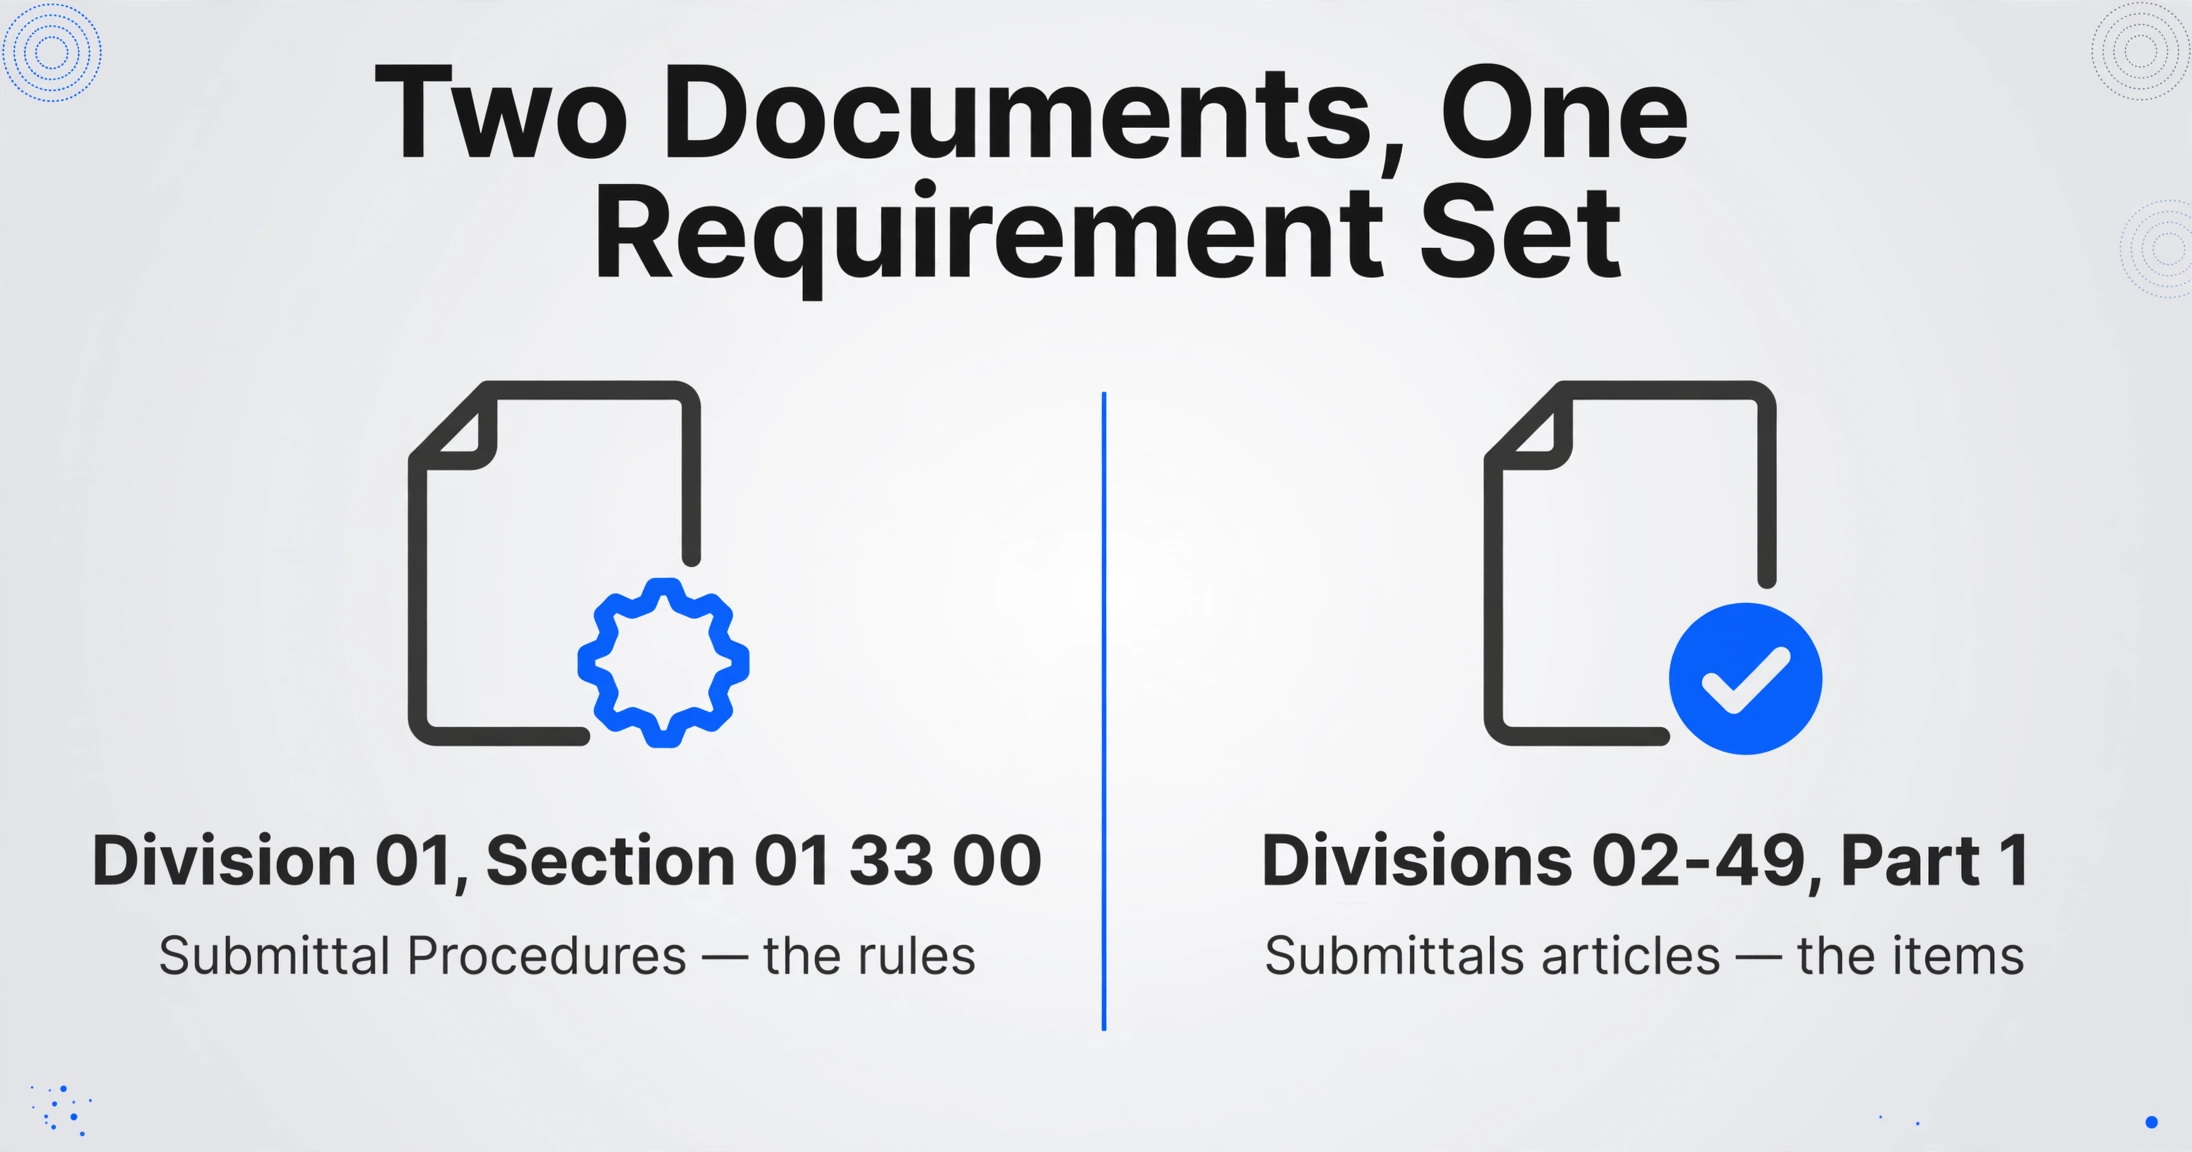
標準的なプロジェクトマニュアルでは、提出物に関するルールは1つのセクションに記載されていますが、何を提出すべきかのリストはそこにはありません。この2つは異なる役割を担う異なる文書であり、建築基準法の提出要件の完全なセットを組み立てるには、両方に目を通す必要があります。
ルールはCSI MasterFormat Division 01、Section 01 33 00「Submittal Procedures」に記載されており、施工図、製品データ、サンプル、証明書、および提出物の写しに関する管理上および手続き上の要件が定められています(CSI MasterFormat)。スケジュールはSection 01 32 19「Submittals Schedule」に記載されており、各パッケージの提出期限が定められています。どちらのセクションにもすべての項目が記載されているわけではありません。実際の項目は、Divisions 02から49にわたる各技術仕様セクションのPart 1, Generalにあり、「Submittals」の条項で、その専門工事が提出すべき施工図、製品データ、サンプルが指定されています。コンクリートのセクションは、プロセスについては01 33 00を参照し、そのうえで自部門の製品を指定します。このパターンはすべてのセクションで繰り返され、図面は仕様書が再掲しない要件を追加します。
ツールチェーンもこの分断を反映しています。Adobe Acrobatは単一ファイルを開いて検索し、Bluebeam RevuはStudio Sessionsで共同レビューのために文書にマークアップを施し、Procore Submittalsはプロジェクト全体のパッケージとステータスを追跡します。レジスター自体は依然としてスプレッドシートにあり、これらのツールはすべてそこにデータを供給しています。
建築基準法とは、性質の異なる長文書です。2024年版のInternational Building Codeは35の章と750ページ以上に及び(ANSI)、そのすべての要件を自らが担うわけではありません。第35章「Referenced Standards」は、義務の大部分をASCE 7、ACI 318、NFPA 13などの外部文書に委ねており(ICC)、また採択は地域ごとに行われるため、施行される版は州や都市ごとに修正されています。実務者が「建築基準法」と呼ぶものは、単一のファイルではなく、文書群にまたがる集合体です。その集合体が1つの巨大なPDFとして届いた場合、それをセクション境界に沿って分割するのは別の作業であり、数千ページのPDFの扱い方で説明しています。
要件一式が1か所に保存されることは決してありません。それはDivision 01の規則、各技術セクションのSubmittals記事、図面注記、参照規格の集合体であり、そのすべてを見つけることは、ファイル内の検索ではなく、コーパスに対する検索問題のように振る舞います。
Ctrl+Fが失敗する理由: これは再現率の問題です
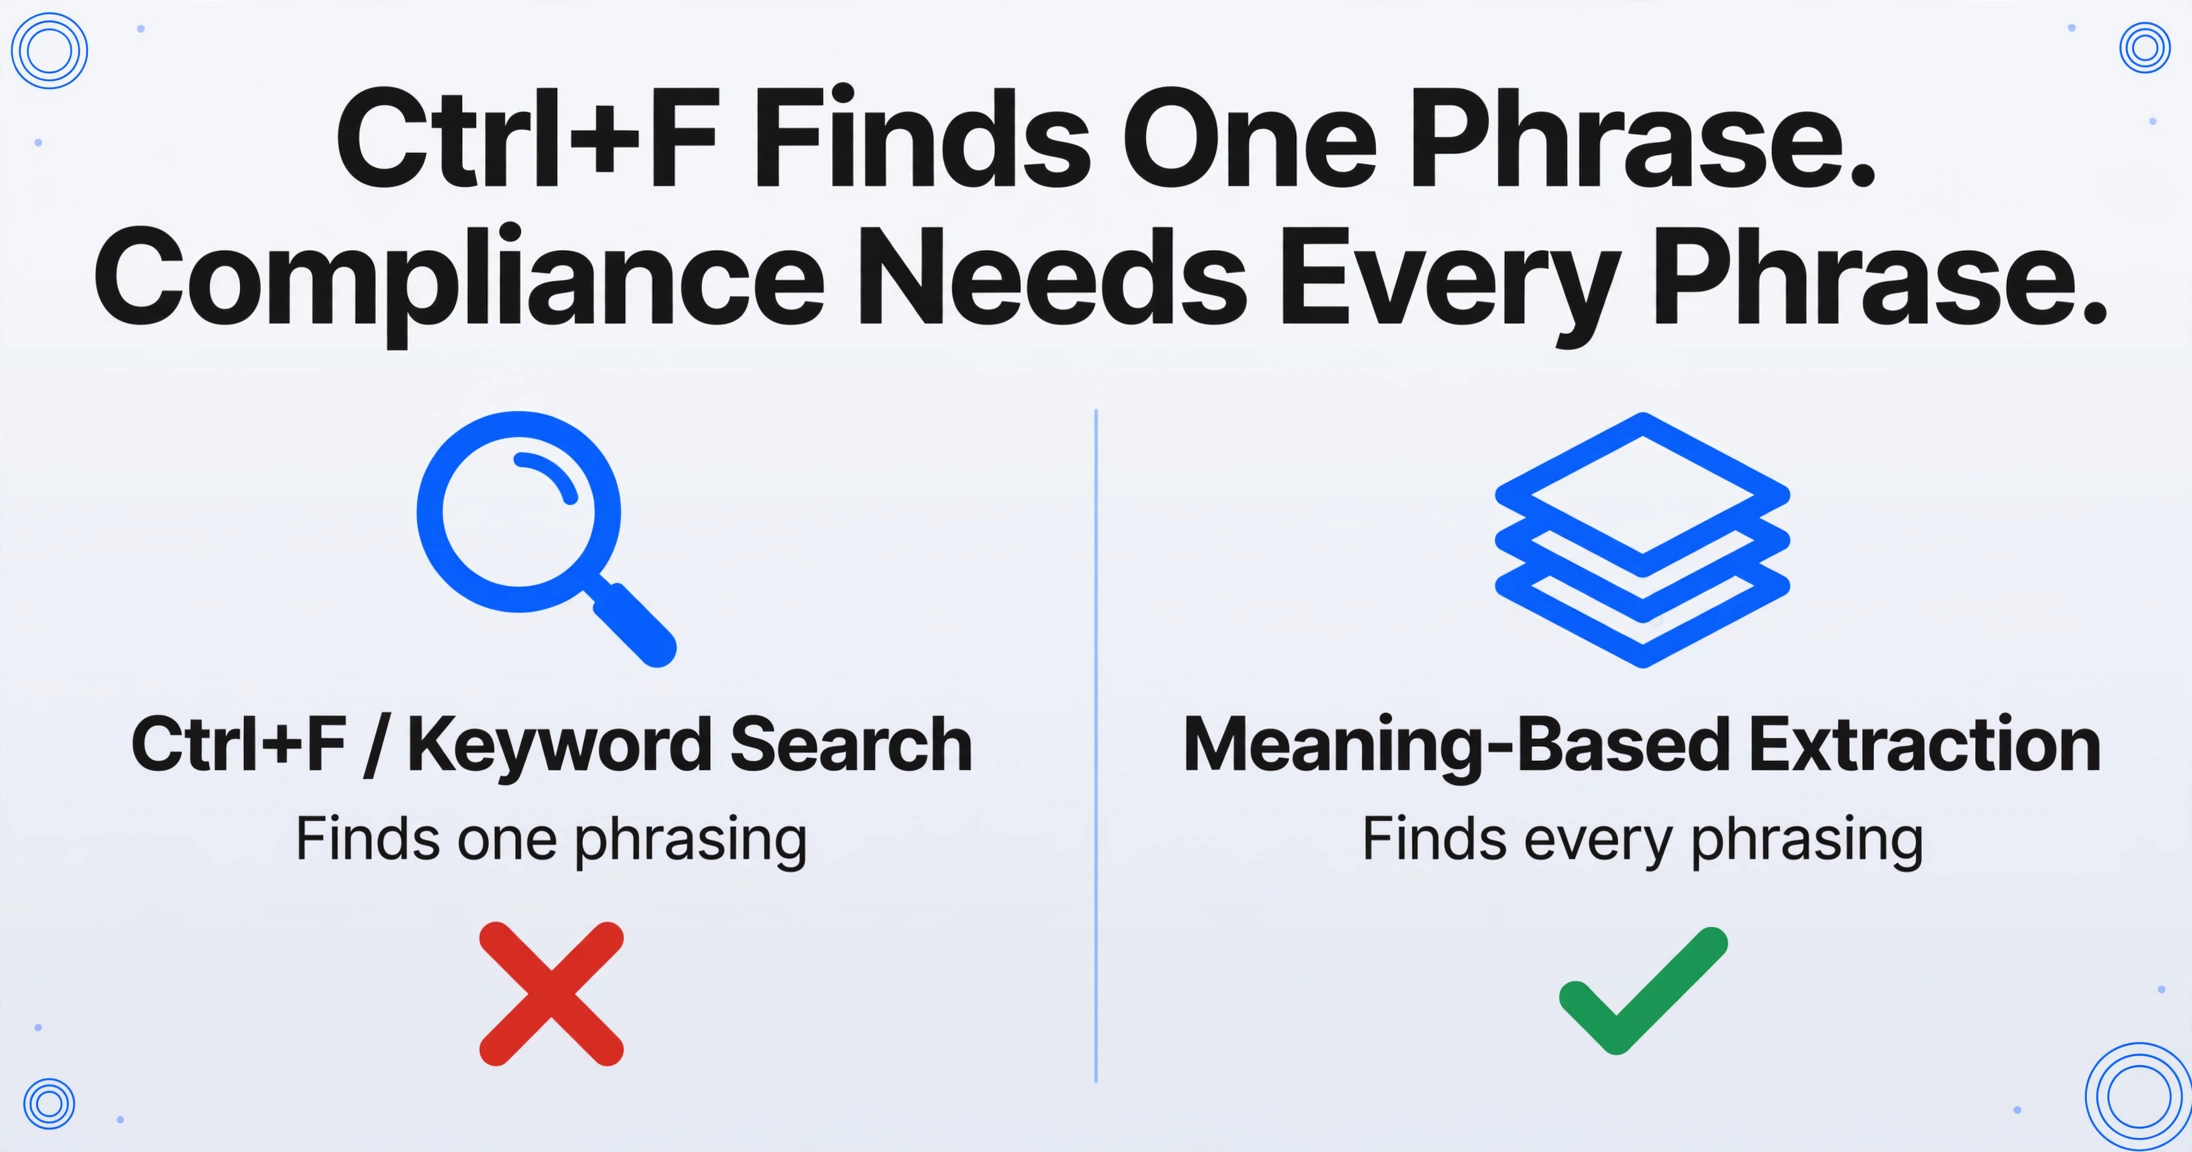
この失敗は機械的なものであり、個人的なものではありません。Ctrl+Fは入力した正確な文字列のすべての出現箇所を返すため、適合率は高く、再現率はあなたが推測した1つの表現に限定されます。提出要件が単一の名前で現れることはほとんどありません。同じ義務が「submittal(提出物)」、「shop drawing(施工図)」、「product data(製品データ)」、「sample(サンプル)」、「certificate(証明書)」、「test report(試験報告書)」、あるいは「submit ... for review」とだけ記載されることもあります。1つのキーワードで提出要件を抽出すると、一部分しか見つかりません。
情報検索は、この緊張関係を数十年にわたって枠組み化してきました。Robert Fairthorneは、適合率を重視する「Only-But-Not-All」と、再現率を重視する「All-But-Not-Only」という2つのシステムタイプを提唱しました。ウェブ検索は前者を望みます。なぜなら、誰も最初の1ページ以降を読まないからです。コンプライアンス業務は後者を望みます。なぜなら、誤検知は一瞥で済みますが、見逃しはスケジュールに影響するからです。Ctrl+FからPDFリーダーの検索バーまで、仕様書に対して人々が使うツールは、再現率の仕事に向けられた適合率重視の道具なのです。
文書全体を手で読むことは高再現率の選択肢ですが、量が増えると能力が低下します。r/ConstructionManagersのスレッドは「なぜ提出物はそれほど厄介なのか」という問いで始まり、最初の返信は「常に苦痛だ。仕事ごとに仕様が異なる」です。このばらつきこそが、平易な言葉で表現された再現率の問題です。チームが自動化を試みると、信頼のギャップも表面化します。仕様を読み、必要な提出物のExcelリストを返すソフトウェアを求める別のスレッドで、ある管理者はProcoreの自動レジスタが「たいてい多くのエラーを生む」と報告し、別の管理者に「手作業で1日費やせ。そうすれば正しいと分かる」と助言しました(r/ConstructionManagers)。その反対意見は、自動化が遅いということではありません。検証されていないリストは信頼できないということなのです。
ステップ1:抽出前に列セットを定義する
コードから要件を抽出する確実な方法は、まず要件がどのようなものかを決め、そのフィールドだけを抽出することです。これは通常の文書処理の順序とは逆です。ツールに1,000ページを要約させる代わりに、必要な5つの列を指定し、ツールにそれぞれの意味に基づいて各項目を特定させます。
ImageToTable.aiでは、これはカスタム列抽出です。列名を入力すると、AIは各フィールドがどこにあるかではなく何を意味するかを理解して、文書内のどこでも一致する値を見つけます。文書ごとのテンプレートもトレーニングセットも不要です。提出要件リストの場合、有効な列セットは次のとおりです:
- Spec Section:要件を課すセクション番号とタイトル(例:05 12 00 Structural Steel)。
- Requirement:提出する項目(文書の表現のまま)。
- Submission Type:Shop Drawing、Product Data、Sample、Certificate、Test Report、Mockupなどの管理されたリストから選択。
- Deadline:セクションまたはSubmittals Scheduleが定める日付またはリードタイム。
- Responsibility:それを担当する業種または当事者。
これらの列のうち2つは、意図的に構築する価値があります。Submission Typeは推論列であり、AIが文脈から要件を分類して、文書に「Shop Drawing」というラベルが印刷されていない場合でも、リストしたオプションにマッピングします。Responsibilityも同様に機能します。ログイン中のユーザーには、ルール形式によって列名をクリーンに保ち、正規化をJSONルールに移行できます。これは、すべての日付を1つの形式に揃えたり、すべてのセクション番号をゼロ埋めしたりする場合に重要です。この演習のポイントは、要件リストが文書の要約ではなく、小さく名前付きのスキーマであるということです。
ステップ2:抽出し、行をページと照合する
抽出によってリストが生成されます。ページレベルの検証こそが、それを説得力のあるものにするのです。レビュー担当者が必要とするのは、行からその要件を含む文への迅速な経路だからです。
抽出側では、長い文書は1つのファイルではなくバッチで処理されます。WebアプリとAPIは1回のアップロードを10 MB・50ページに制限しているため、1,000ページのコードはチャンク単位で処理され、1つのスプレッドシートにマージされます。各チャンクから同じ名前の列が抽出されます。仕組みはフォルダに対するバッチ実行と同じで、目的もPDFをExcelに変換するのと同じであり、1つのファイルからコードブック全体にスケールされます。テキストレイヤーが作業をどう変えるかは、マルチページ抽出でできることとできないことで説明しています。
検証側では、Review Modeが抽出された各セルを、Bbox(AIが値の取得元の領域の周囲に描画するバウンディングボックス)を通じてソースの位置とペアリングします。スプレッドシートの任意のセルにホバーすると、元のページ上の対応する領域がハイライトされます。ページ上の領域をクリックすると、ビューが対応するセルにジャンプします。これは1ファイル単位で起動でき、1クレジット消費します。また、自動注釈をオンにすると、処理完了時にボックスがすでに生成されています。実際の効果として、1,000ページのソースに対する行の確認が手作業の探索ではなく数秒で完了し、同じメカニズムが検証チェックリストを実行する価値を生み出しています。
ファイルは安全に処理され、保存されません。
レビュープラン:広くサンプリングし、重要な箇所を再読する
レビュープランは、見落としによるコストに見合った労力を割くべきであり、300行に均等に分散させるべきではありません。提出物リストのほとんどの行は、リスクの低い製品データです。しかし、一部の行はプロジェクト全体を左右します。
リスクの大部分をカバーする3つの方法があります:
ソースに対してランダムサンプルをスポットチェックする
異なるディビジョンにまたがる行を選び、それぞれをBboxで開きます。リスクの低い行の誤った値は、今修正するのは安価ですが、クローズアウト時に見つかると高くつきます。同じセクションの2行がソースと一致しない場合、そのセクションはその2行だけでなく、より詳細な確認が必要です。
影響度の高いセクションを直接再読する
リードタイムの長い項目、建築基準法で要求される特別検査、複数のトレードを左右するセクションは、抽出された行と照らし合わせて行ごとの確認に値します。これらは、1つの欠落がスケジュールを止めるセクションです。リストだけでなく、ソースを読みましょう。ルールは、レビューの労力を影響度に合わせることです。
Submittals Scheduleと照合する
Section 01 32 19またはプロジェクトの提出スケジュールが存在する場合は、そのエントリを抽出した行と双方向で比較します。スケジュール項目に対応する行がない場合は、ユーザー側の再現率の見落としです。スケジュールにない行は、スケジュール自体が要件を省略している可能性があります。
上記のr/ConstructionManagersスレッドのマネージャーは、同じ考えを一文で述べています。「提出物は常に、それを要求する正確な仕様セクションまたは図面注記まで遡って確認すること。」レビュープランとは、その指示を反復可能な手順に変換したものであり、目に留まった行ではなく、影響を及ぼす可能性のあるセクションでトレースが行われるようにします。
ここでどのツールも約束できないこと
1,000ページの規範文書に対して完全性を保証できるモデルはなく、それを主張する製品は、コードブックではなくデモを説明しているにすぎません。再現率は列セットとその中の文言に制約されます。要件が列で決して説明されない表現で書かれている場合、モデルはそれを見逃す可能性があり、まさにそのためにレビュープランが存在し、抽出ではなくプランが保証を担うのです。
また、このツールはコードを解釈しません。要求した要件テキストを抽出するだけで、要件がスコープに適用されるかどうか、参照された規格が義務を変更するかどうか、最終的に作成する提出物が準拠しているかどうかを判断するものではありません。これらは専門的判断です。要件の一部がChapter 35の参照や地域の修正条項に存在する文書では、抽出は提供したファイルのみをカバーでき、完全な文書セットの組み立ては、どの抽出ツールも代行しないステップです。
これら2つの限界を合わせて読むと、誠実な方法が定義されます。再現率を高めるための定義済み列セットと、見逃しのリスクに応じた規模のレビュープランです。それ以外は、誰も裏付けられない主張です。
FAQ
AIは1,000ページの建築基準法のすべての提出要件を見つけられますか?
保証付きでは不可能です。ビジョンベースの抽出ツールは、キーワード検索よりもはるかに高い再現率で文書全体から定義済みの列セットを引き出せ、ページレベルの検証で結果を確認できます。完全性は依然として列セットと、見逃しが高くつくセクションのレビューパスに依存します。
コード全体を1つのファイルでアップロードすべきですか?
いいえ。1回のアップロードは10 MBと50ページに制限されており、長い文書をチャンク化してマージすると処理精度がより安定します。コードを独自のセクション境界に沿って分割し、チャンクを1つのバッチとして処理し、各チャンクから同じ列を抽出してください。複数ファイル実行の仕組みは複数ファイルの一括処理と同じです。
異なる表現で書かれた要件をどのように見つけられますか?
文字列ではなくフィールドを記述してください。オプションリストを持つ推論列(例:Submission Type を Shop Drawing、Product Data、Sample、Certificate、Test Report、Mockup に設定)により、モデルはキーワードの一致ではなく文脈から要件を分類できます。これが検索と抽出の違いです。
これは提出物ログを置き換えるものですか?
いいえ。抽出はログの元となる最初のリストを生成します。ステータス、レビュー担当者、承認日付の追跡は、引き続き提出物管理ツールまたはスプレッドシートで行います。変更されるのは、ログが誰も完全に検証できない手作業のリストではなく、確認可能なリストから始まることです。
要件が自分のスコープに適用されるかどうかを教えてくれますか?
いいえ。このツールは要件テキストと指定したフィールドを抽出します。適用性の判断、参照規格の読み解き、適合性の確認は引き続き人間の判断に委ねられており、レビュープランがそれらの判断を行う場です。
長い文書を Ctrl+F で検索する直感は正しいものです。ただ、間違った指標を狙っています。検索は適合率を重視し、コンプライアンスは再現率を重視します。その差こそ、見逃された提出物が待ち構えている場所です。列を定義し、その列だけを抽出し、見逃しが実際にコストになるセクションにレビュー時間を費やしてください。ページまで遡れる要件リストは、完全に見えるが遡れないリストよりも価値があります。