5つのベンダー見積書を
1つのGoogleスプレッドシート比較表に変換する方法
r/procurementの「5つの異なるPDF見積書を正気を保ちながら比較するにはどうしてる?」というRedditスレッドで、最も多かった回答はどれも似たような内容でした。各PDFを開いて、数字を見つけて、スプレッドシートに入力して、それを繰り返す。あるコメンターは加重スコアリングの計算式を自動化していました — 条件付き書式、ピボットテーブル、その他もろもろ。それでもボトルネックは最初のステップ、つまりPDFからデータを取り出してセルに入れる作業でした。この記事では、そのステップがGoogleスプレッドシートのサイドバー内で完結する場合について説明します。5つの見積書を1回のセッションでアップロードし、比較列を一度定義すれば、1つの比較表がシートに直接書き込まれます。
重要なポイント
- 毎月4〜6時間が、5つの異なるサプライヤー見積書PDFから1つの比較スプレッドシートへ数字を手作業で転記する作業に消えています。
- ImageToTable.aiの列名抽出は、3つの異なるPDFの「Rate」「Price Per Each」「Unit Price」を、各フィールドの意味を認識して同じスプレッドシートの列にマッピングします。ページ上の位置ではなく、意味に基づいて判断するのです。
- 5社のRFQラウンドが、60分の手入力から2分未満に短縮されます — 45倍の高速化により、ベンダー比較は半日かかる定例作業から、コーヒーを注いでいる間に終わる作業へと変わります。
5社からのRFQ:同じデータ、5つの異なるレイアウト
調達のベストプラクティスは一貫した数字に収束します:RFQごとに3~5社の適格サプライヤーを招待することです。3社未満では競争圧力が生まれません。5社を超えると、評価の複雑さが限界的な価格メリットを上回ります。Institute for Supply Managementとアリゾナ州立大学のW. P. Carey School of Businessが共同で後援するCAPS Researchは、20の業界セクターにわたる調達プロセスをベンチマークしており、3~5社という範囲はセクターを問わず構造的なデフォルトです(APQC調達ベンチマーク)。
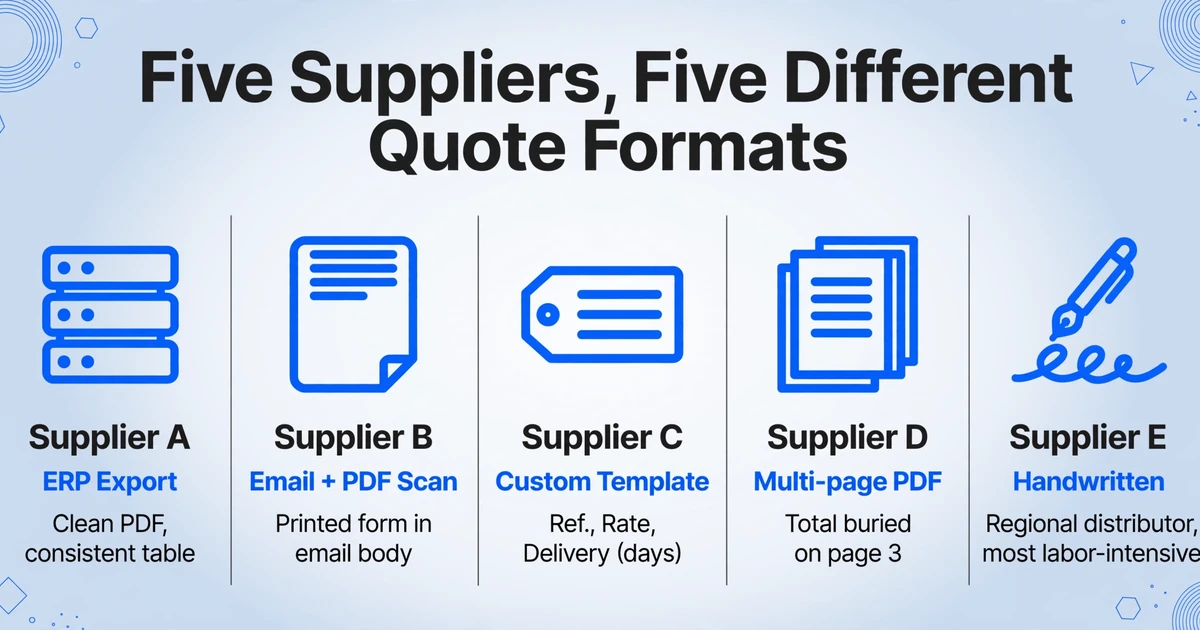
5社の適格サプライヤーは、5件の見積書回答を意味します。そして5件の回答は、5つの異なるフォーマットを意味します。サプライヤーAは自社のERPからエクスポートします—品目コード、説明、単価、リードタイムが一貫した表にまとめられたクリーンなPDFです。サプライヤーBは見積書をメール本文に書き、印刷フォームのPDFスキャンを添付します。サプライヤーCは独自の見積テンプレートを使用し、見たこともない列ラベルを使います:「Ref.」の代わりに「Item Code」ではなく、「Rate」の代わりに「Unit Price」ではなく、「Delivery (working days)」の代わりに「Lead Time」ではなく。サプライヤーDは行ごとに明細化しますが、合計は3ページ目に記載します。サプライヤーEのPDFは、小規模な地域販売代理店からの手書き見積書のスキャンです—最もコスト競争力のある選択肢であり、最もデジタル化に手間がかかる選択肢です。
あなたのGoogle スプレッドシート比較テンプレートは、この多様性を気にしません。クリーンな列があります:サプライヤー名、品目説明、数量、単価、明細合計、リードタイム、支払条件、納入条件。フォーマットのギャップ—「5つの乱雑なPDF」と「1つのクリーンなスプレッドシート」の間にあるもの—はあなたであり、見積ラウンドごとに60~90分かけてデータをフォーマット間で手動変換しているのです。
構造的な問題:r/supplychainの調達マネージャーは、自社のRFQサイクルを「数カテゴリの部品について5社のベンダーの見積書を手動で比較する」と表現しました。各比較ラウンドは半日かかりました—比較ロジックが複雑だったからではなく、各サプライヤーのPDFが同じフィールドを見つけるために異なる視覚的スキャンパターンを必要としたからです。脳はすぐに適応します。手はそうはいきません。
エンタープライズソフトウェアはこれを解決する——エンタープライズ価格で
SAP AribaとCoupaはSource-to-Pay市場を支配しており、両社とも2025年および2026年のガートナー マジック・クアドラント(Source-to-Payスイート部門)でリーダーに選ばれています。両社のeソーシングモジュールはまさにこの問題を解決します。構造化されたRFQをサプライヤーに送信し、標準化された回答を受け取り、自動比較テーブルを生成します。PDFからスプレッドシートへの変換は不要です——プラットフォームが最初から構造を強制するからです。
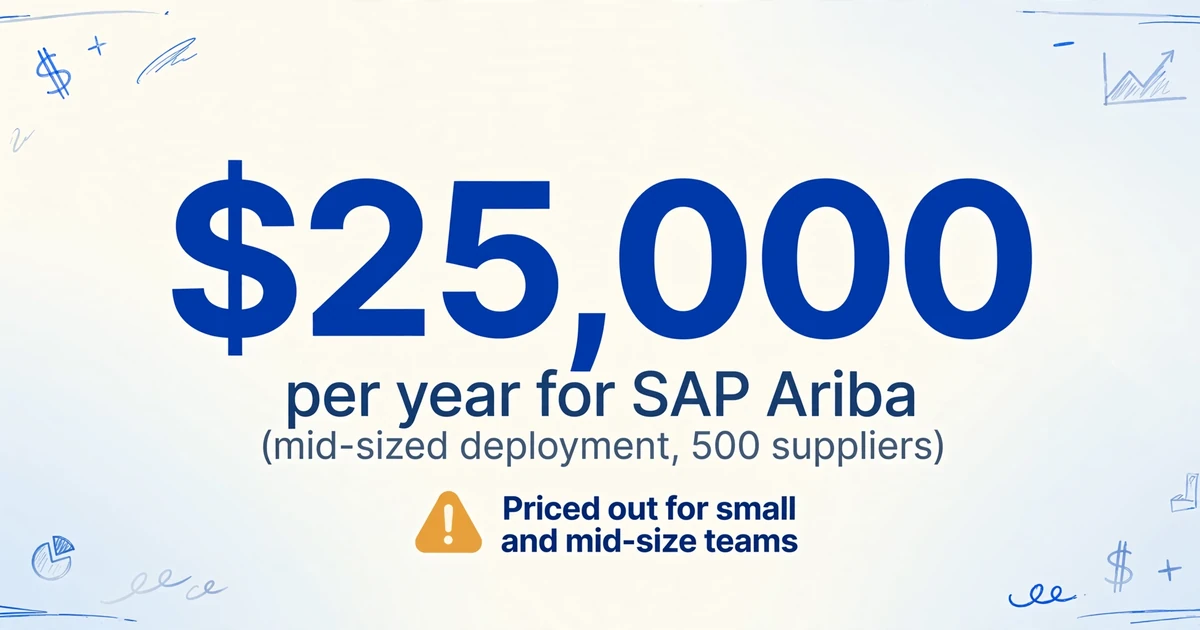
しかし、その価格帯により、この作業の大半を担う中小規模の調達チームには手が届きません。SAP Aribaは、サプライヤー500社・ユーザー5名のSupplier Lifecycle & Performanceモジュールを導入する中規模展開で、年間約$25,000から始まります。Coupaの初期費用は月額約$2,500で、典型的な中堅市場展開では年間$200,000~$800,000に加え、導入費用として$100,000~$400,000がかかります。中小企業向けの専用RFQツールであるAuraVMSは月額$5から始まりますが、サプライヤーがそのプラットフォーム経由で提出する必要があり、受信トレイに届いているPDFを処理することはできません。
調達ソフトウェア市場は2024年に$66億と評価されました。$250,000以上の展開向けに作られたツールも、月額$5のRFQ自動化向けに作られたツールも、共通の前提を共有しています:サプライヤーがツールの提出形式を使用することです。小規模な調達チームの現実は、見積書がメール添付ファイル(PDF、スキャン済みフォーム、時折Excelファイル)として届き、比較はプラットフォームが要求するものではなく、手元にあるもので行わなければならないということです。
シートをシステムとして使う現実 — そして欠けているもの
小規模企業や中堅企業の調達チームが6桁のSource-to-Payスイートを導入できない場合、標準的なツール構成はシンプルです:比較用のGoogle スプレッドシート + PDF受信用のGmail + 両者をつなぐ手動データ入力。これは調達の洗練度が低いわけではありません。利用可能なツールへの合理的な適応です — スプレッドシートはリアルタイムコラボレーション、共有リンク、数式ベースのスコアリングを、IT調達やベンダーオンボーディングなしで提供します。
この構成で欠けているのは分析レイヤーではありません。Google スプレッドシートは条件付き書式、加重スコアリング、ピボットテーブル集計を、どの調達プラットフォームにも劣らず処理できます。欠けているのは取り込みレイヤー — 5つのPDF添付ファイルを、人間による転記なしに5行の構造化データに変換する仕組みです。
単一見積書の抽出 — 1社のベンダー見積書PDFからスプレッドシートへのデータ取得 — については、ステップバイステップガイドでアドオンによる列名抽出の基本を解説しています。バッチ処理は同じサイドバーインターフェースを基盤としますが、単一ファイル規模では存在しない課題を導入します:用語が異なるサプライヤー間での一貫した列マッピング、一部の見積書にのみ存在するフィールドの処理、そしてソース形式に関係なく全行が同じ列構造に揃う比較用テーブルの生成です。
列名抽出が5つの異なる見積書形式を統合する仕組み
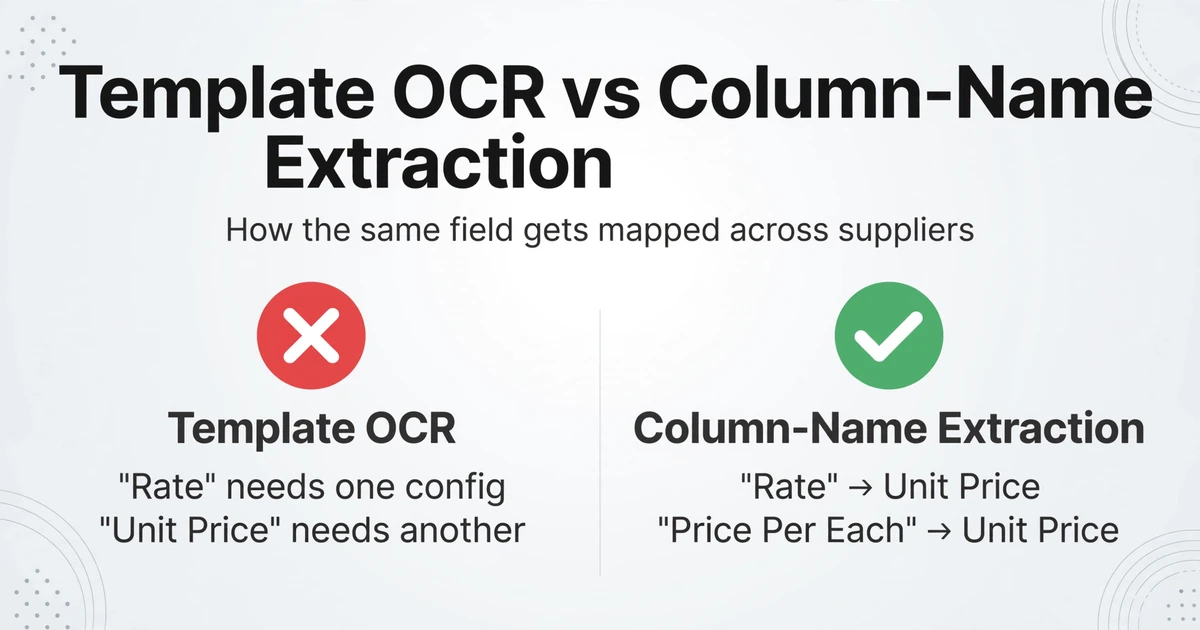
不整合な形式をまたいでバッチ処理を機能させるエンジンは列名抽出です:ツールに各サプライヤーPDFのどこにデータがあるかを指示する代わりに — フィールドにボックスを描いたり、サプライヤーごとのテンプレートを作成したり — 何を抽出したいかを指示します。比較列を一度定義するだけです:「サプライヤー名 / 品目説明 / 単価 / MOQ / リードタイム(日数)/ 支払条件」。AIは各ドキュメント内の各値を、ページ上の位置ではなく意味論的に理解することで特定します。
これがサプライヤー間の語彙問題を処理する仕組みです。サプライヤーAのPDFはフィールドを「Rate」とラベル付けします。サプライヤーBは「Unit Price」とラベル付けします。サプライヤーCは「Price Per Each」とラベル付けします。テンプレートベースのツールは3つの異なるフィールド名を認識し、3つの個別設定を必要とします。列名抽出は、3つすべてが同じ調達コンセプト — 単価 — を指していることを認識し、自動的に同じ出力列にマッピングします。これが抽出と理解の違いです:従来のOCRは位置によってテキスト文字列を抽出します;列名抽出は意味的役割によってデータポイントを抽出します。
実際のRFQラウンドの形式多様性 — ERP生成PDF、メール本文テキスト、スキャンした手書きフォーム — に対して、抽出アプローチは3つすべてで同一です。サプライヤーごとに列定義を変更する必要はありません。形式ごとにテンプレートをトレーニングする必要もありません。一度定義した列名は、バッチ内のすべてのドキュメントから同じテーブルの行を生成します。
バッチワークフロー:5件すべてをアップロードして、1つのテーブルを取得
Google スプレッドシートのアドオンは、スプレッドシート内で開くサイドバーパネルです。比較シートと同じウィンドウとタブの「拡張機能」メニューからアクセスできます。これは、ウェブサイト上で見積書を処理してファイルをエクスポートし、それをスプレッドシートにインポートするという別のツールではありません。スプレッドシート内で動作する抽出インターフェースそのものであり、アクティブなシートが直接の出力先となります。
バッチでのベンダー見積書比較において、このアーキテクチャは1つの点で重要です。サイドバーが5件の見積書PDFを受け取り、同じ列定義を使用してすべてからデータを抽出し、すべての結果を連続した行として、表示中のシートに直接書き込みます。ダウンロードボタンも、「CSVをスプレッドシートにインポート」の手順も、中間ダッシュボードもありません。対応フィールドタイプ、形式、プラン詳細などの全機能については、Google スプレッドシート抽出機能ページをご覧ください。
バッチワークフローは次の3つの操作で構成されます。
サイドバーを開き、サプライヤー間で比較したいフィールド名を入力します:「サプライヤー名 / 品目説明 / 単価 / MOQ / リードタイム(日数) / 支払条件」。これらがテーブルのヘッダーになります。APIキーでログインすると、サイドバーがこの設定を保存するため、次のRFQラウンドでは比較列がすでに設定されています。
サイドバーでアップロードをクリックし、すべての見積書PDFを選択します。サプライヤーAのERPエクスポート、サプライヤーBのPDFスキャン、サプライヤーCの手書きフォームなどです。確認すると、アドオンはPDF、JPG、PNG、WebPを受け付けます。5件すべてが同じ列構造で同じバッチ内で処理されます。
AIが各ファイルを読み取り、列名に一致する値を特定し、アクティブなシートの下部に新しい行として追加します。サプライヤーAのデータは2行目、サプライヤーBのデータは3行目。同じ列、同じ順序です。既存の比較計算式は、出力領域の上または右側にそのまま残ります。
ファイルは安全に処理され、保存されることはありません。
欠落フィールドの問題:サプライヤーAが支払条件を記載し、サプライヤーBが記載しない場合
単一の見積書ワークフローでは、欠落フィールドは小さな不便にすぎません。「N/A」と入力するかセルを空白のままにして次に進むだけです。同じ比較テーブルに取り込む5件の見積書のバッチでは、欠落フィールドは構造上の問題を生み出します。サプライヤーAが支払条件に「Net 30」と明記しているのに、サプライヤーBの見積書に支払条件がまったく記載されていない場合、比較列にギャップが生じます。支払条件を含む加重基準でサプライヤーをスコアリングしている場合、サプライヤーBの欠落データはスコアを引き下げます。それは条件が悪いからではなく、条件を明記していないからです。
このアドオンは、欠落フィールドを一貫した戦略で処理します:定義した列がサプライヤーのドキュメントに存在しない場合、そのサプライヤーのその列の出力セルは空のままになります。エラーもありません。プレースホルダーテキストもありません。空のセル — これは、手動でデータを入力していてフィールドが見つからなかった場合に作成するものとまったく同じです。
これは比較テーブルにとって正しい動作です。条件付き書式で欠落セルを強調表示できます。スコアリング数式は、空のセルをゼロではなく「未提供」として扱うことができます。1つのサプライヤーがフィールドを省略しても出力構造は壊れません。すべての行は同じ列を同じ順序で持ち、ソースドキュメントにデータがなかった箇所は空白になります。
実際には、複数サプライヤーの見積書比較では、欠落フィールドは例外ではなく標準です。r/procurement の調達専門家は、標準的なRFQプロセスを9つの手動ステップで説明し、ステップ5 —「サプライヤーが提供したものと当社が要求したものの包含/除外の比較」— が最も時間のかかるステップであると述べていました。構造化された回答の代わりにパンフレットを送るサプライヤーもいます。明細行ごとに項目を列挙しても、必要な集計フィールドを省略するサプライヤーもいます。すべてのデータがあるものの4ページにまたがり、合計が4ページ目に埋もれているPDFもあります。抽出アプローチはこれらすべてを処理します:データがドキュメントのどこかに存在すれば、AIが意味的に見つけ出して正しい列にマッピングします。存在しなければ、セルは空白になります。テンプレートの破損もありません。行のずれもありません。手動調整も不要です。
スピード倍増効果:1回のセッションで5件の見積書を処理 vs. 5回の個別セッション
バッチ処理の効率向上は加算的ではなく、構造的なものです。サイドバーで1件の見積書を処理するのにかかる時間は約15~30秒です。PDFをアップロードし、AIが定義済みのフィールドを特定し、データがスプレッドシートに表示されます。5件の見積書を1件ずつ処理する場合(5回のアップロードセッション、5回の個別抽出ラウンド)は、合計で約2~3分に加え、各ファイルを開いてアップロードを確認する時間がかかります。これは、1件あたり約3分かかる手動データ入力(読み取り、各フィールドの特定、入力)と比較して、すでに10~20倍高速です。
バッチ処理はこれをさらに圧縮します:5件の見積書ファイルを1回のアップロードで選択し、1回の抽出セッションを開始すると、5行すべてがスプレッドシートに表示されます。5回の抽出は順次実行されます(各ファイルの読み取り、各値セットの特定、各行の追加)が、バッチの開始は1回だけです。5社のサプライヤーによるRFQラウンドの場合、ファイルの選択からSheetsで比較可能な行が揃うまでのデータ抽出フェーズ全体が、2分未満で完了します。
| 方法 | 5社RFQの所要時間 | 月間(RFQ 4回) | 主な制約 |
|---|---|---|---|
| 手動コピー&ペースト | 60~90分 | 4~6時間 | 転記ミス、フォーマット切替による疲労 |
| 単一見積書の抽出(×5セッション) | 2~3分 | 8~12分 | 5回の個別アップロードセッション |
| サイドバーのバッチ処理(5件を一括) | <2分 | <8分 | ファイルがブラウザデバイスからアクセス可能である必要がある |
月間での複利効果は、構造的な違いが明確になるところです。週に1回のRFQラウンド(月4回、各5社のサプライヤーを比較)を実行する場合、手動データ入力は転記だけで月に4~6時間を消費します。サイドバーでのバッチ抽出により、これは8分未満に短縮されます。これは2倍の改善ではありません。5倍でもありません。およそ45倍の削減です。「毎回半日かかるタスク」から「コーヒーを淹れている間に完了するタスク」へと変わります。
複数のカテゴリにまたがって見積書を処理する調達チーム(原材料はあるサプライヤー群から、包装材は別の群から、物流サービスはさらに別の群から)にとって、毎週のRFQ負荷は3〜4回の見積ラウンドに達することがあります。各60〜90分かかる手作業での比較は、調達担当者の1週間のうちで最も大きな活動になります。これは、調達担当者が調達タスクに1日平均2時間45分を費やしており、その多くが戦略的評価ではなくデータ統合に充てられているというデータと一致しています。
ベンダー見積を超えて:文書タイプを横断するバッチ処理
アドオンのサイドバーにあるバッチ機能は、文書タイプに関係なく同じように動作します—列が変わるだけで、ワークフローは変わりません。調達を担当し、同じGoogle スプレッドシートの追跡システムでサプライヤー請求書も処理している場合、バッチ請求書処理ワークフローも同じパターンに従います:請求書の列を定義し、すべてのサプライヤー請求書を一度にアップロードし、1つの台帳テーブルを取得します。調達業務が経費精算にまで及ぶ場合、バッチ経費報告書処理も同様に機能します—チームの月次提出物をアップロードすると、1つの払い戻しテーブルが得られます。また、税務目的でベンダー見積書と並行して領収書を追跡している組織では、バッチ領収書処理ガイドが、領収書の量に対応する同じサイドバーパターンを説明しています。
SheetsのサイドバーではなくWebインターフェースで作業している方—ImageToTable.aiのウェブサイトにアップロードしてExcelにエクスポートする場合—は、一般的なバッチベンダー見積比較ガイドで、同じ列名抽出メカニズムを使ったWebベースのワークフローを説明しています。抽出エンジンは同じです。異なるのは配信方法だけです。
共通するのは、Google スプレッドシートがすでに記録のシステムであるということです—ベンダー比較、請求書追跡、費用精算のいずれにおいても。アドオンはスプレッドシートを置き換えるものではありません。それを支えるデータ入力を置き換えるのです。異なる用語を使う5つのベンダー見積書を処理するのと同じ列名抽出が、異なるレイアウトの30枚のサプライヤー請求書や、異なるPOSシステムからの100枚の領収書も処理します。サイドバーは、スプレッドシートをシステムとして使うアーキテクチャに常に欠けていた取り込み層なのです。
すでにGoogle スプレッドシートでベンダー見積書を手動で比較しているチーム—しかし、加重スコアリング、条件付き書式、複雑化したスプレッドシートで起こりうる問題を含む完全な比較フレームワークも必要な場合—は、一般的なベンダー見積比較の失敗に関する記事で、バッチ抽出では解決できないスプレッドシート側の落とし穴を説明しています。また、手動での見積比較がそもそも意味を持つのかというより広い問いについては、手動とAIの比較ワークフローで、抽出が任意ではなくなる損益分岐点を検証しています。
よくある質問
このアドオンは、サプライヤーごとに複数の品目がある見積もりを処理できますか?
はい。サプライヤーの見積もりに複数の明細行が含まれている場合、「品目説明 / 数量 / 単価 / 明細合計」のように、繰り返し構造を捉える列を定義してください。AIはこれらのフィールドが明細行ごとに繰り返されることを認識し、品目ごとに個別の行を作成します。つまり、サプライヤーAに5つの明細行があれば、同じサプライヤー名で異なる品目データを持つ5行が生成されます。比較目的で、ピボットテーブルやQUERY関数を使用してシート内でサプライヤーごとにグループ化できます。
サプライヤーによって通貨が異なる場合はどうなりますか?
アドオンはドキュメントに表示されている通貨のまま値を抽出します。サプライヤーAがUSD、サプライヤーBがEURで見積もっている場合、抽出された数値は元の通貨を反映します。通貨間で比較するには、「通貨」列を追加し、隣接する列にGOOGLEFINANCE数式(例:=GOOGLEFINANCE("CURRENCY:EURUSD"))を各行に適用して換算します。抽出自体は通貨を変換せず、ページ上の値をそのまま取得します。
サプライヤーごとに異なる列名を設定する必要がありますか?
いいえ。「単価」「最小注文数量」「リードタイム」など、一度設定した列定義は、各サプライヤーが使用する用語に関係なく、すべてのサプライヤーで機能します。これが列名抽出の核となる仕組みです。AIは「レート」「1個あたりの価格」「単価」がすべて同じ調達概念を指すことを認識します。サプライヤーごとにマッピングを設定する必要はありません。
スキャンした手書きの見積もりでも機能しますか?
はい。AIエンジンはスキャン文書や手書きテキストを、デジタルPDFと同様に処理します。手書きの精度は読みやすさに依存します。明確なブロック体の手書きは印刷テキストと同程度に確実に抽出できますが、高度に装飾された筆記体や密集した手書き文字では精度が低下する可能性があります。エンジンは視覚言語モデルを通じて印刷テキストと手書きの両方を識別し、印刷データでは最大99%の認識精度を達成します。手書きの見積もりの場合、購入判断の基礎として使用する前に出力内容を確認することをお勧めします。
5社以上のサプライヤーを比較する必要がある場合はどうなりますか?
サイドバーの一括アップロードでは、1回のセッションで5社、10社、20社と、任意の数のファイルを処理できます。唯一の制約は、同じブラウザセッションからファイルをアップロードする必要があることです。バッチごとのファイル数制限はありません。