Cómo procesar por lotes 5 cotizaciones de proveedores
en una tabla comparativa de Google Sheets
En un hilo de Reddit en r/procurement titulado "¿Cómo comparan ustedes 5 cotizaciones en PDF diferentes sin volverse locos?", las respuestas principales eran variaciones de la misma respuesta: abrir cada PDF, encontrar los números, escribirlos en una hoja de cálculo y repetir. Un comentarista había automatizado sus fórmulas de puntuación ponderada — formato condicional, tablas dinámicas, todo el arsenal. El cuello de botella seguía siendo el primer paso: extraer los datos de los PDF y llevarlos a las celdas. Este artículo trata sobre lo que ocurre cuando ese paso se traslada al panel lateral de Google Sheets — donde subes las cinco cotizaciones en una sola sesión, defines tus columnas de comparación una vez y obtienes una tabla comparativa única escrita directamente en tu hoja.
Conclusiones clave
- De 4 a 6 horas cada mes se pierden copiando manualmente números de cinco PDF de cotizaciones de proveedores distintos a una hoja de cálculo comparativa.
- La extracción por nombre de columna de ImageToTable.ai asigna "Rate", "Price Per Each" y "Unit Price" de tres PDF diferentes a la misma columna de la hoja de cálculo al reconocer qué significa cada campo en lugar de dónde se encuentra en la página.
- Una ronda de RFQ con 5 proveedores pasa de 60 minutos de escritura a menos de 2 minutos — un aumento de velocidad de 45× que convierte la comparación de proveedores de una tarea recurrente de medio día en algo que ocurre mientras sirves una taza de café.
La RFQ de 5 proveedores: los mismos datos, cinco diseños distintos
Las mejores prácticas de adquisiciones convergen en un número consistente: invitar a entre tres y cinco proveedores calificados por RFQ. Con menos de tres, no se genera tensión competitiva. Con más de cinco, la complejidad de la evaluación supera el beneficio marginal del precio. CAPS Research, copatrocinado por el Institute for Supply Management y la W. P. Carey School of Business de Arizona State University, compara procesos de adquisición en 20 sectores industriales — y el rango de tres a cinco es el estándar estructural en todos los sectores (APQC Procurement Benchmarking).
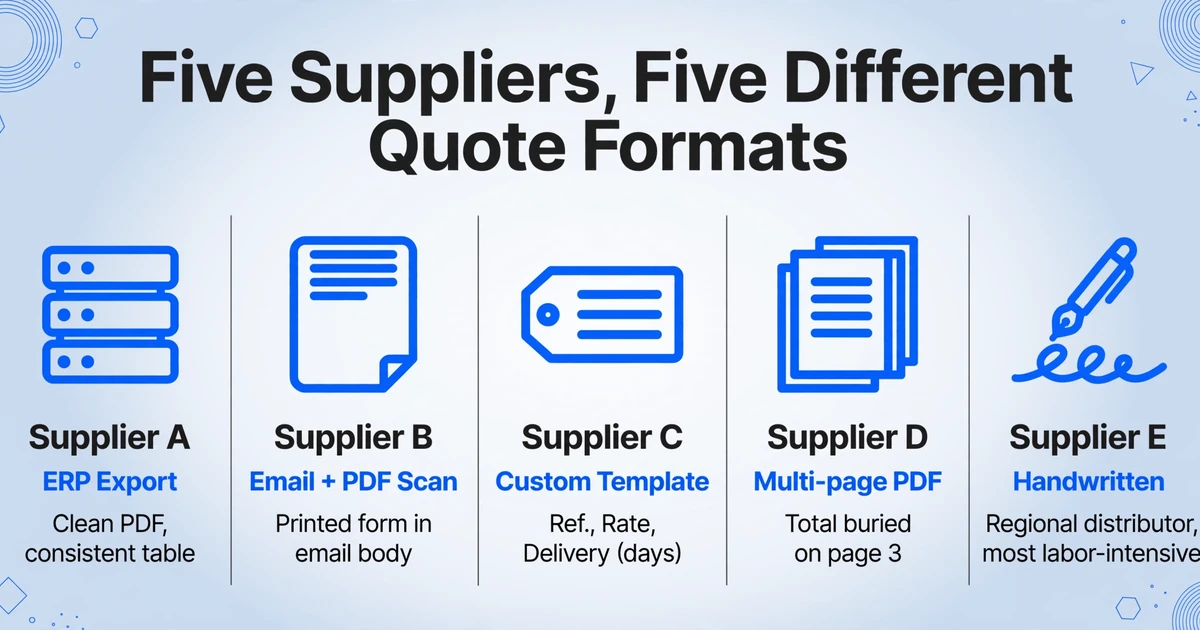
Cinco proveedores calificados significa cinco respuestas de cotización. Y cinco respuestas significa cinco formatos distintos. El proveedor A exporta desde su ERP — un PDF limpio con códigos de artículo, descripciones, precios unitarios y plazos de entrega en una tabla consistente. El proveedor B escribe su cotización en el cuerpo de un correo electrónico y la adjunta como un escaneo en PDF de un formulario impreso. El proveedor C usa su propia plantilla de cotización con etiquetas de columna que nunca ha visto: «Ref.» en lugar de «Código de artículo», «Tarifa» en lugar de «Precio unitario», «Entrega (días hábiles)» en lugar de «Plazo de entrega». El proveedor D detalla por fila, pero pone el total en la página 3. El PDF del proveedor E es un formulario de cotización manuscrito escaneado de un distribuidor regional más pequeño — su opción más competitiva en precio y la más laboriosa de digitalizar.
Su plantilla de comparación en Google Sheets no le importa toda esta diversidad. Tiene columnas limpias: Nombre del proveedor, Descripción del artículo, Cantidad, Precio unitario, Total de la línea, Plazo de entrega, Condiciones de pago, Condiciones de entrega. La brecha de formato — lo que se encuentra entre «cinco PDF desordenados» y «una hoja de cálculo limpia» — es usted, traduciendo manualmente los datos entre formatos durante 60 a 90 minutos por ronda de cotización.
El problema estructural: Un gerente de adquisiciones en r/supplychain describió su ciclo de RFQ como «comparar manualmente cotizaciones de 5 vendedores para algunas categorías de componentes». Cada ronda de comparación tomaba medio día — no porque la lógica de comparación fuera compleja, sino porque el PDF de cada proveedor requería patrones de escaneo visual distintos para localizar los mismos campos. El cerebro se adapta rápido. Las manos no.
El software empresarial resuelve esto, a precios empresariales
SAP Ariba y Coupa dominan el mercado de source-to-pay, ambos nombrados Líderes en el Gartner Magic Quadrant 2025 y 2026 para suites Source-to-Pay. Sus módulos de e-sourcing resuelven exactamente este problema: envían RFQ estructurados a los proveedores, reciben respuestas estandarizadas y generan tablas de comparación automáticas. No se requiere traducción de PDF a hoja de cálculo: la plataforma impone la estructura desde el inicio.
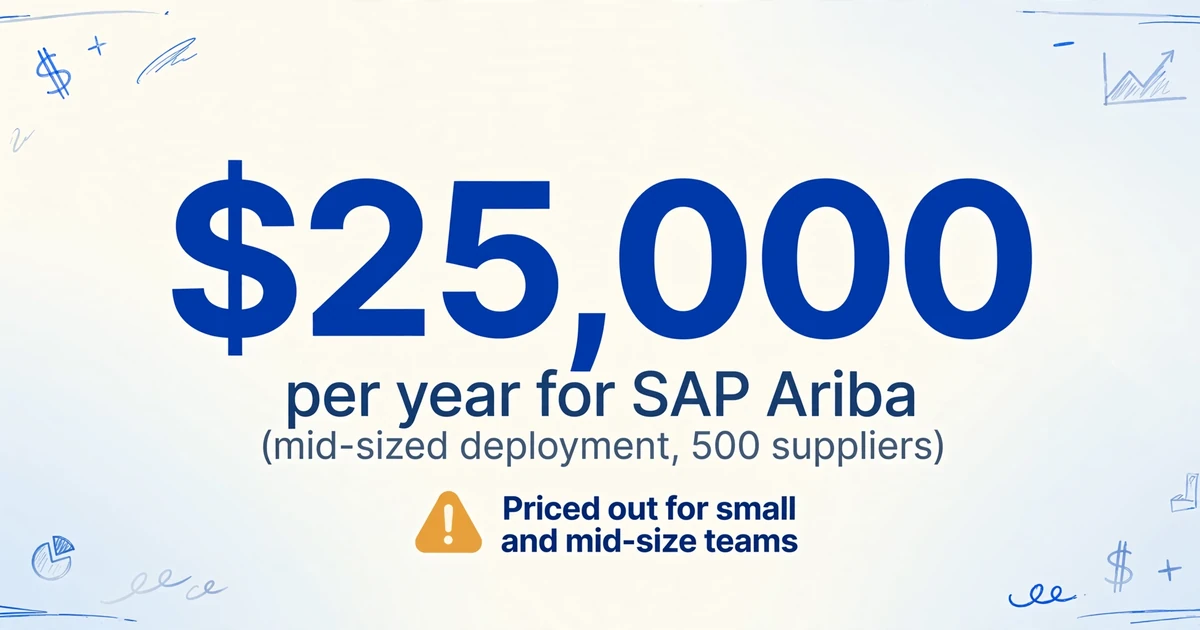
El precio los hace irrelevantes para los equipos de compras pequeños y medianos que realizan la mayor parte de este trabajo. SAP Ariba comienza en aproximadamente $25,000 por año para una implementación de tamaño mediano con 500 proveedores y cinco usuarios en el módulo Supplier Lifecycle & Performance. El precio inicial de Coupa es de alrededor de $2,500 por mes, con implementaciones típicas de mercado medio que oscilan entre $200,000 y $800,000 anuales, más $100,000 a $400,000 en costos de implementación. AuraVMS, una herramienta de RFQ dedicada para pequeñas empresas, comienza en $5 por mes, pero requiere que los proveedores envíen a través de su plataforma, lo que significa que no puedes procesar los PDF que ya están en tu bandeja de entrada.
El mercado de software de adquisiciones se valoró en $6.6 mil millones en 2024. Las herramientas diseñadas para implementaciones de $250,000+ y las herramientas diseñadas para la automatización de RFQ de $5 por mes comparten una suposición común: que el proveedor utilizará el formato de envío de la herramienta. La realidad para un equipo de compras pequeño es que las cotizaciones llegan como archivos adjuntos de correo electrónico — PDF, formularios escaneados y, ocasionalmente, un archivo de Excel — y la comparación debe hacerse con lo que tienes, no con lo que una plataforma requiere.
La realidad del sistema basado en hojas de cálculo — y lo que falta
Cuando un equipo de adquisiciones de una pequeña empresa o de mercado medio no puede justificar una suite source-to-pay de seis cifras, el conjunto de herramientas predeterminado es sencillo: Google Sheets para la comparación + Gmail para recibir PDF + entrada manual de datos para conectar ambos. Esto no es un fracaso de la sofisticación en adquisiciones. Es una adaptación racional a las herramientas disponibles: Sheets ofrece colaboración en tiempo real, enlaces compartibles y puntuación basada en fórmulas sin necesidad de adquisición de TI ni incorporación de vendedores.
Lo que falta en esta combinación no es la capa de análisis. Google Sheets maneja el formato condicional, la puntuación ponderada y los resúmenes de tabla dinámica tan bien como cualquier plataforma de adquisiciones. Lo que falta es la capa de ingesta: el mecanismo que convierte cinco archivos PDF adjuntos en cinco filas de datos estructurados sin transcripción humana.
Para la extracción de una sola cotización — transferir datos de un PDF de cotización de un proveedor a una hoja de cálculo — una guía paso a paso cubre los fundamentos de la extracción por nombre de columna mediante el complemento. El procesamiento por lotes se basa en la misma interfaz del panel lateral, pero introduce desafíos que no existen a escala de un solo archivo: mapeo consistente de columnas entre proveedores con terminología diferente, manejo de campos que aparecen en algunas cotizaciones pero no en otras, y producción de una tabla lista para comparar donde cada fila se alinea con la misma estructura de columnas independientemente del formato de origen.
Cómo la extracción por nombre de columna unifica cinco formatos de cotización diferentes
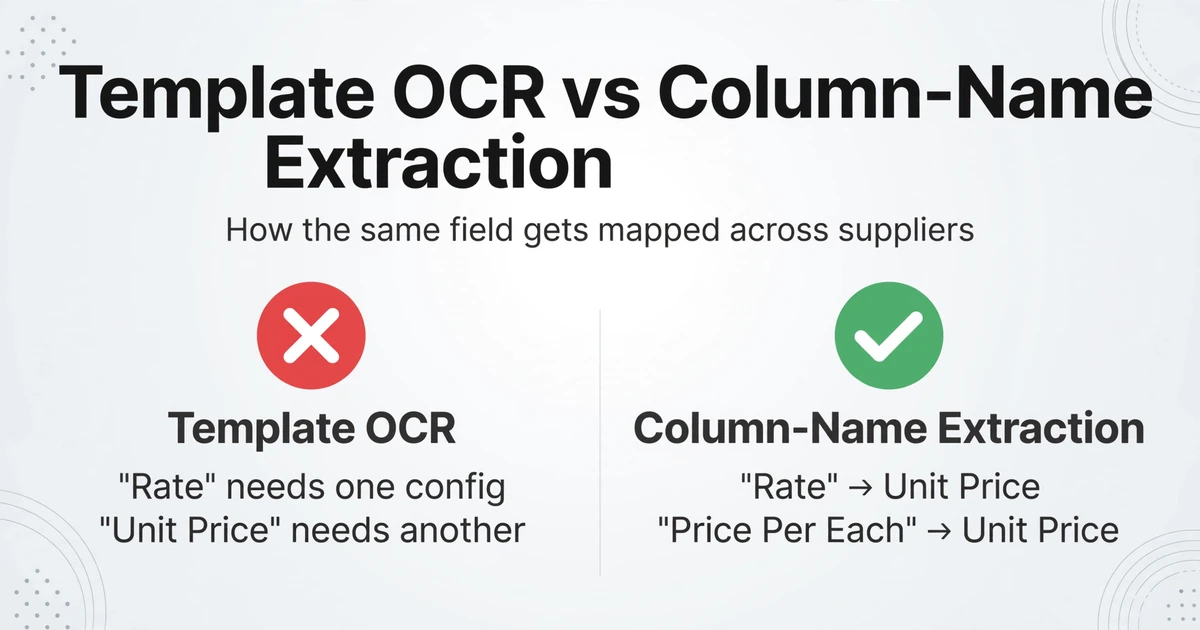
El motor que hace que el procesamiento por lotes funcione en formatos inconsistentes es la extracción por nombre de columna: en lugar de indicar a la herramienta dónde encontrar los datos en el PDF de cada proveedor — dibujando cuadros alrededor de los campos, creando plantillas por proveedor — se le indica qué se desea extraer. Usted define sus columnas de comparación una vez: "Nombre del proveedor / Descripción del artículo / Precio unitario / MOQ / Plazo de entrega (días) / Condiciones de pago". La IA localiza cada valor en cada documento comprendiendo lo que significa semánticamente, no dónde se encuentra en la página.
Este es el mecanismo que resuelve el problema de vocabulario entre proveedores. El PDF del proveedor A etiqueta un campo como "Rate". El proveedor B lo etiqueta como "Unit Price". El proveedor C lo etiqueta como "Price Per Each". Una herramienta basada en plantillas ve tres nombres de campo diferentes y requiere tres configuraciones separadas. La extracción por nombre de columna reconoce que los tres se refieren al mismo concepto de adquisiciones — precio unitario — y los asigna automáticamente a la misma columna de salida. Esta es la diferencia entre extracción y comprensión: el OCR tradicional extrae cadenas de texto por posición; la extracción por nombre de columna extrae puntos de datos por función semántica.
Para la diversidad de formatos de una ronda de RFQ real — un PDF generado por ERP, un texto en el cuerpo de un correo electrónico, un formulario manuscrito escaneado — el enfoque de extracción es idéntico en los tres casos. No cambia sus definiciones de columna por proveedor. No entrena plantillas por formato. Los nombres de columna que definió una vez producen filas en la misma tabla a partir de cada documento del lote.
El flujo de trabajo por lotes: suba las cinco, obtenga una tabla
Un complemento de Google Sheets es un panel lateral que se abre dentro de su hoja de cálculo, accesible desde el menú Extensiones en la misma ventana y pestaña que su hoja de comparación. No es una herramienta separada que procesa cotizaciones en un sitio web y exporta un archivo que luego importa a Sheets. Es la interfaz de extracción, que se ejecuta dentro de la hoja de cálculo, con la hoja activa como destino directo de salida.
Para la comparación por lotes de cotizaciones de proveedores, esta arquitectura importa de una manera específica: el panel lateral recibe cinco PDF de cotizaciones, extrae datos de todos ellos usando las mismas definiciones de columnas y escribe cada resultado como filas consecutivas directamente en la hoja que está viendo — sin botón de descarga, sin paso de "importar CSV a Sheets", sin panel intermedio. Para ver la descripción completa de capacidades — tipos de campos admitidos, formatos y detalles de planes — consulte la página de funciones de extracción de Google Sheets.
Este es el flujo de trabajo por lotes en tres acciones:
Abra el panel lateral, escriba los nombres de los campos que desea comparar entre proveedores: "Nombre del proveedor / Descripción del artículo / Precio unitario / MOQ / Plazo de entrega (días) / Condiciones de pago". Estos se convierten en los encabezados de su tabla. Cuando inicia sesión con una clave de API, el panel lateral guarda esta configuración — en la próxima ronda de RFQ, sus columnas de comparación ya estarán definidas.
Haga clic en subir en el panel lateral, seleccione cada PDF de cotización — la exportación ERP del Proveedor A, el escaneo PDF del Proveedor B, el formulario manuscrito del Proveedor C — y confirme. El complemento acepta PDF, JPG, PNG y WebP. Las cinco se procesan en el mismo lote con la misma estructura de columnas.
La IA lee cada archivo, localiza los valores que coinciden con los nombres de sus columnas y los agrega como nuevas filas al final de su hoja activa. Los datos del Proveedor A en la fila 2, los del Proveedor B en la fila 3 — mismas columnas, mismo orden. Sus fórmulas de comparación existentes permanecen intactas arriba o a la derecha del área de salida.
Los archivos se procesan de forma segura y no se almacenan.
El problema de los campos faltantes: cuando el proveedor A indica las condiciones de pago y el proveedor B no
En un flujo de trabajo de una sola cotización, un campo faltante es un inconveniente menor: se escribe «N/A» o se deja la celda en blanco y se continúa. En un lote de cinco cotizaciones que alimentan la misma tabla comparativa, los campos faltantes crean problemas estructurales. Si el proveedor A especifica «Net 30» en sus condiciones de pago, pero la cotización del proveedor B no menciona las condiciones de pago, la columna de comparación tiene un vacío. Si se puntúa a los proveedores con criterios ponderados que incluyen las condiciones de pago, los datos faltantes del proveedor B reducen su puntuación, no porque sus condiciones sean peores, sino porque no las indicaron.
El complemento gestiona los campos faltantes con una estrategia coherente: cuando una columna definida no aparece en el documento de un proveedor, la celda de salida para ese proveedor en esa columna se deja vacía. Sin error. Sin texto de marcador de posición. Una celda vacía, que es exactamente lo que se crearía si se ingresaran los datos manualmente y no se encontrara el campo.
Este es el comportamiento correcto para una tabla comparativa. El formato condicional puede resaltar las celdas faltantes. La fórmula de puntuación puede tratar las celdas vacías como «no proporcionado» en lugar de cero. La estructura de salida no se rompe porque un proveedor omitió un campo: cada fila tiene las mismas columnas en el mismo orden, con espacios en blanco donde no había datos en el documento de origen.
En la práctica, los campos faltantes son la norma, no la excepción, en la comparación de cotizaciones de múltiples proveedores. Un profesional de adquisiciones en r/procurement describió su proceso estándar de RFQ con nueve pasos manuales y señaló que el paso 5 —«comparar inclusiones/exclusiones entre lo que ofrecieron los proveedores y lo que solicitamos»— era el paso que más tiempo consumía. Algunos proveedores envían folletos en lugar de respuestas estructuradas. Algunos detallan línea por línea, pero omiten los campos de resumen necesarios. Algunos PDF contienen todos los datos, pero distribuidos en cuatro páginas, con el total oculto en la página 4. El enfoque de extracción maneja todos estos casos: si los datos están presentes en cualquier parte del documento, la IA los encuentra por significado semántico y los asigna a la columna correcta. Si no están presentes, la celda queda en blanco. Sin plantillas que se rompan. Sin desalineación de filas. Sin conciliación manual.
El multiplicador de velocidad: cinco cotizaciones en una sola sesión frente a cinco sesiones separadas
La ganancia de eficiencia del procesamiento por lotes no es aditiva, sino estructural. Procesar una cotización a través del panel lateral toma entre 15 y 30 segundos: se sube el PDF, la IA localiza los campos definidos y los datos aparecen en la hoja. Procesar cinco cotizaciones una a la vez —cinco sesiones de carga, cinco rondas de extracción separadas— toma aproximadamente de 2 a 3 minutos en total, más el tiempo de abrir cada archivo y confirmar la carga. Eso ya es de 10 a 20 veces más rápido que la entrada manual de datos, que requiere unos 3 minutos por cotización para leer, localizar cada campo y escribir.
El procesamiento por lotes comprime esto aún más: seleccione los cinco archivos de cotización en una sola carga, inicie una sesión de extracción y las cinco filas aparecerán en la hoja. Las cinco extracciones se ejecutan de forma secuencial —se lee cada archivo, se localiza cada conjunto de valores, se añade cada fila—, pero usted inicia el lote una sola vez. Para una ronda de RFQ con 5 proveedores, toda la fase de extracción de datos, desde seleccionar los archivos hasta tener filas listas para comparar en Sheets, se completa en menos de 2 minutos.
| Método | Tiempo para RFQ de 5 proveedores | Mensual (4 RFQ) | Limitación clave |
|---|---|---|---|
| Copiar y pegar manual | 60–90 minutos | 4–6 horas | Errores de transcripción; fatiga por cambio de formato |
| Extracción de una sola cotización (×5 sesiones) | 2–3 minutos | 8–12 minutos | Cinco sesiones de carga separadas |
| Lote en el panel lateral (las 5 a la vez) | <2 minutos | <8 minutos | Los archivos deben ser accesibles desde el dispositivo del navegador |
La acumulación mensual es donde la diferencia estructural se hace visible. Si realiza una ronda de RFQ por semana —cuatro rondas al mes, cada una comparando cinco proveedores—, la entrada manual de datos consume de 4 a 6 horas mensuales solo en transcripción. La extracción por lotes a través del panel lateral reduce esto a menos de 8 minutos. Eso no es una mejora de 2×. No es de 5×. Es una reducción de aproximadamente 45× —de «esta es una tarea recurrente de medio día» a «esto ocurre mientras se toma un café».
Para los equipos de adquisiciones que procesan cotizaciones de múltiples categorías — materias primas de un grupo de proveedores, empaques de otro, servicios logísticos de un tercero — la carga semanal de RFQ puede alcanzar tres o cuatro rondas de cotización separadas. A 60 a 90 minutos cada una, la comparación manual se convierte en la actividad dominante en la semana de un profesional de adquisiciones — un hallazgo consistente con datos que muestran que los profesionales de adquisiciones dedican un promedio de 2 horas y 45 minutos diarios a tareas de abastecimiento, gran parte de ello en consolidación de datos en lugar de evaluación estratégica.
Más allá de las cotizaciones de proveedores: procesamiento por lotes en distintos tipos de documentos
El mecanismo de procesamiento por lotes en el panel lateral del complemento funciona de manera idéntica en todos los tipos de documentos — las columnas cambian, el flujo de trabajo no. Si usted gestiona adquisiciones y también procesa facturas de proveedores a través del mismo sistema de seguimiento en Google Sheets, el flujo de trabajo de procesamiento por lotes de facturas sigue el mismo patrón: defina las columnas de factura, cargue todas las facturas de proveedores a la vez, obtenga una tabla de libro mayor. Si su función de adquisiciones se extiende a la conciliación de gastos, el procesamiento por lotes de informes de gastos funciona de la misma manera — cargue los envíos mensuales de su equipo, obtenga una tabla de reembolsos. Y si su organización realiza un seguimiento de recibos para fines fiscales junto con las cotizaciones de proveedores, la guía de procesamiento por lotes de recibos cubre el mismo patrón del panel lateral para volúmenes de recibos.
Para quienes trabajan a través de la interfaz web en lugar del panel lateral de Sheets — cargando al sitio web de ImageToTable.ai y exportando a Excel — la guía general de comparación de cotizaciones de proveedores por lotes cubre el flujo de trabajo basado en web con el mismo mecanismo de extracción por nombre de columna. El motor de extracción es el mismo; el método de entrega es lo que difiere.
El hilo común es que Google Sheets ya es el sistema de registro — para comparaciones de proveedores, para seguimiento de facturas, para conciliación de gastos. El complemento no reemplaza la hoja de cálculo. Reemplaza la entrada de datos que la alimenta. La misma extracción por nombre de columna que maneja cinco cotizaciones de proveedores con terminología diferente también maneja treinta facturas de proveedores con diseños distintos y cien recibos de diferentes sistemas POS. El panel lateral es la capa de ingesta que siempre faltó en la arquitectura de Sheets como sistema.
Para equipos que ya comparan cotizaciones de proveedores manualmente en Google Sheets — pero que también desean el marco completo de comparación, incluida la puntuación ponderada, el formato condicional y lo que sale mal cuando esas hojas de cálculo se vuelven complejas — nuestro artículo sobre errores comunes en la comparación de cotizaciones de proveedores cubre los inconvenientes del lado de la hoja de cálculo que la extracción por lotes no resuelve. Y para la pregunta más amplia de si la comparación manual de cotizaciones sigue teniendo sentido, el flujo de trabajo de comparación manual vs. IA examina el punto de equilibrio donde la extracción deja de ser opcional.
Preguntas frecuentes
¿Puede el complemento manejar cotizaciones con varios productos por proveedor?
Sí. Cuando una cotización contiene varios productos, define tus columnas para capturar la estructura repetitiva: "Descripción del artículo / Cantidad / Precio unitario / Total por línea". La IA reconoce que estos campos se repiten por cada producto y crea una fila separada por artículo. Así, el Proveedor A con cinco productos genera cinco filas, cada una con el mismo nombre de proveedor pero datos de producto distintos. Para comparar, puedes agrupar por proveedor en tu hoja usando una tabla dinámica o la función QUERY.
¿Qué pasa si un proveedor cotiza en otra moneda?
El complemento extrae los valores tal como aparecen en el documento. Si el Proveedor A cotiza en USD y el Proveedor B en EUR, los números extraídos reflejan sus monedas originales. Para comparar entre monedas, agrega una columna "Moneda" y usa una fórmula GOOGLEFINANCE en una columna adyacente para convertir — por ejemplo, =GOOGLEFINANCE("CURRENCY:EURUSD") — aplicada una vez por fila. La extracción no convierte monedas; captura lo que está en la página.
¿Necesito configurar nombres de columna distintos para cada proveedor?
No. Las definiciones de columna que configures una vez — "Precio unitario", "Cantidad mínima de pedido", "Plazo de entrega", etc. — funcionan con todos los proveedores, independientemente de la terminología que use cada uno. Este es el mecanismo central de la extracción por nombre de columna: la IA reconoce que "Tarifa", "Precio por unidad" y "Precio unitario" se refieren al mismo concepto de adquisición. No necesitas configurar asignaciones por proveedor.
¿Funcionará el complemento con cotizaciones manuscritas escaneadas?
Sí. El motor de IA procesa documentos escaneados y texto manuscrito de la misma manera que los PDF digitales. La precisión para escritura a mano depende de la legibilidad: la escritura clara en mayúsculas se extrae tan fiablemente como el texto impreso, mientras que la cursiva muy estilizada y la escritura densa pueden tener menor precisión. El motor identifica tanto texto impreso como manuscrito mediante su modelo de lenguaje visual, con una precisión de reconocimiento de hasta el 99% para datos impresos. Para cotizaciones manuscritas, se debe revisar el resultado antes de usarlo como base para decisiones de compra.
¿Qué pasa si necesito comparar más de cinco proveedores?
La carga por lote en la barra lateral procesa cualquier cantidad de archivos en una sola sesión: cinco, diez, veinte. La única condición es que los archivos se suban desde la misma sesión del navegador. No hay límite de archivos por lote.