Como Agrupar 5 Cotações de Vendedores
Em Uma Única Tabela de Comparação no Google Sheets
Em um tópico do Reddit em r/procurement intitulado "Como vocês comparam 5 cotações em PDF diferentes sem enlouquecer?", as respostas mais votadas eram variações da mesma resposta: abrir cada PDF, encontrar os números, digitá-los em uma planilha, repetir. Um comentarista havia automatizado suas fórmulas de pontuação ponderada — formatação condicional, tabelas dinâmicas, tudo. O gargalo continuava sendo o primeiro passo: extrair os dados dos PDFs e colocá-los nas células. Este artigo aborda o que acontece quando essa etapa passa a ocorrer dentro do painel lateral do Google Sheets — onde você envia todas as cinco cotações em uma única sessão, define suas colunas de comparação uma vez e obtém uma única tabela de comparação escrita diretamente na sua planilha.
Principais Conclusões
- De 4 a 6 horas por mês desaparecem copiando manualmente números de cinco PDFs de cotações de fornecedores diferentes para uma única planilha de comparação.
- A extração por nome de coluna do ImageToTable.ai mapeia "Rate", "Price Per Each" e "Unit Price" de três PDFs diferentes para a mesma coluna da planilha, reconhecendo o significado de cada campo em vez de sua posição na página.
- Uma rodada de RFQ com 5 fornecedores cai de 60 minutos de digitação para menos de 2 minutos — um aumento de velocidade de 45× que transforma a comparação de vendedores de uma tarefa recorrente de meio dia em algo que acontece enquanto você serve uma xícara de café.
RFQ com 5 Fornecedores: Mesmos Dados, Cinco Layouts Diferentes
As melhores práticas de compras convergem para um número consistente: convide três a cinco fornecedores qualificados por RFQ. Menos de três e você não cria tensão competitiva. Mais de cinco e a complexidade da avaliação supera o benefício marginal de preço. A CAPS Research, co-patrocinada pelo Institute for Supply Management e pela W. P. Carey School of Business da Arizona State University, compara processos de compras em 20 setores industriais — e a faixa de três a cinco é o padrão estrutural entre os setores (APQC Procurement Benchmarking).
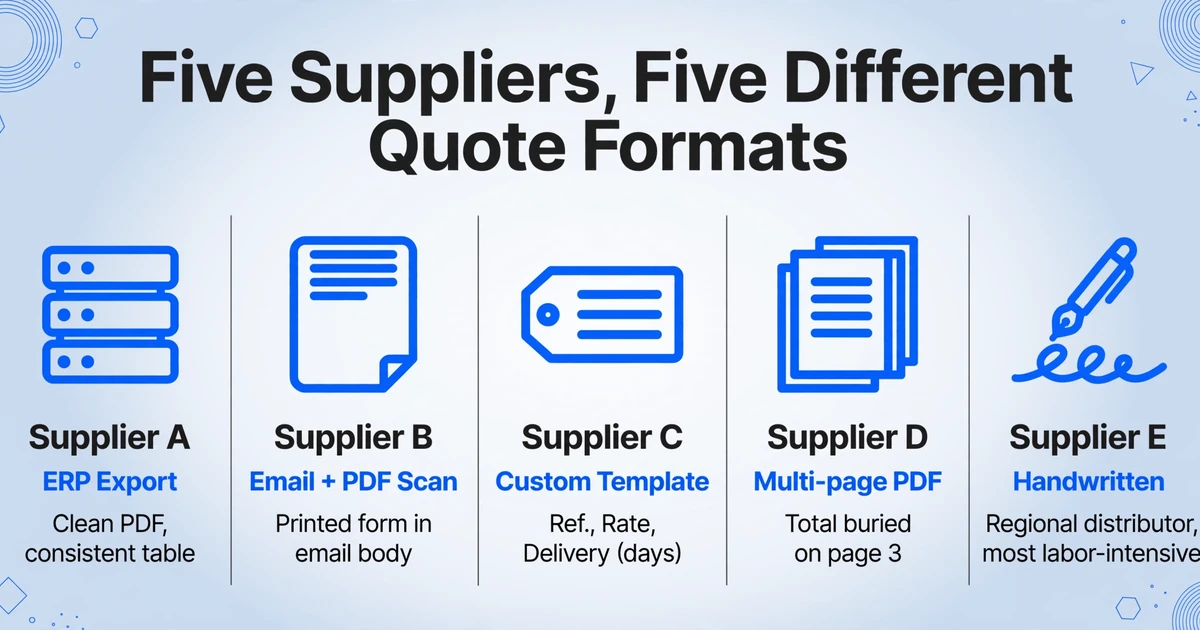
Cinco fornecedores qualificados significam cinco respostas de cotação. E cinco respostas significam cinco formatos diferentes. O Fornecedor A exporta do ERP — um PDF limpo com códigos de item, descrições, preços unitários e prazos de entrega em uma tabela consistente. O Fornecedor B escreve a cotação no corpo do e-mail e anexa um PDF escaneado de um formulário impresso. O Fornecedor C usa o próprio modelo de cotação, com rótulos de coluna que você nunca viu: "Ref." em vez de "Código do Item", "Taxa" em vez de "Preço Unitário", "Entrega (dias úteis)" em vez de "Prazo de Entrega". O Fornecedor D detalha por linha, mas coloca o total na página 3. O PDF do Fornecedor E é um formulário de cotação manuscrito escaneado de um distribuidor regional menor — sua opção mais competitiva em custo e a mais trabalhosa de digitalizar.
Seu modelo de comparação no Google Sheets não se importa com toda essa diversidade. Ele tem colunas limpas: Nome do Fornecedor, Descrição do Item, Quantidade, Preço Unitário, Total da Linha, Prazo de Entrega, Condições de Pagamento, Condições de Entrega. A lacuna de formato — o que fica entre "cinco PDFs bagunçados" e "uma planilha limpa" — é você, traduzindo dados manualmente entre formatos por 60 a 90 minutos a cada rodada de cotação.
O problema estrutural: Um gerente de compras no r/supplychain descreveu seu ciclo de RFQ como "comparar manualmente cotações de 5 fornecedores para algumas categorias de componentes". Cada rodada de comparação levava meio dia — não porque a lógica de comparação fosse complexa, mas porque o PDF de cada fornecedor exigia padrões diferentes de varredura visual para localizar os mesmos campos. O cérebro se adapta rápido. As mãos, não.
O Software Empresarial Resolve Isso — a Preços Empresariais
SAP Ariba e Coupa dominam o mercado de source-to-pay, ambos nomeados Líderes no Gartner Magic Quadrant 2025 e 2026 para Suítes Source-to-Pay. Seus módulos de e-sourcing lidam exatamente com esse problema: enviam RFQs estruturados para fornecedores, recebem respostas padronizadas e geram tabelas de comparação automatizadas. Nenhuma tradução de PDF para planilha é necessária — a plataforma impõe estrutura desde o início.
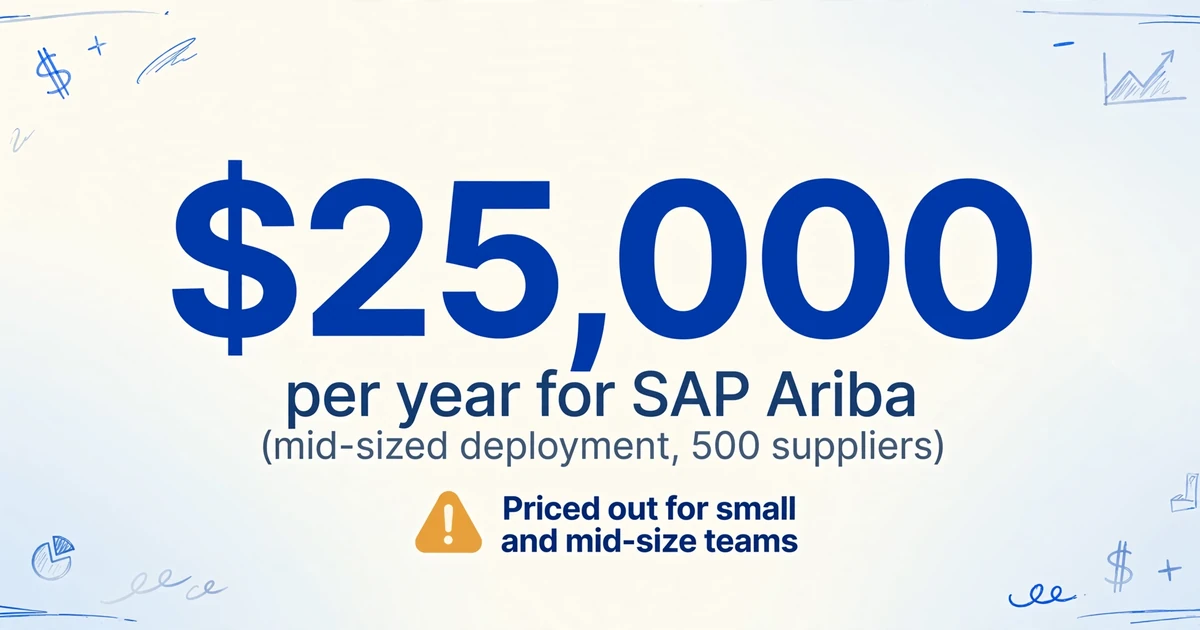
O preço os torna irrelevantes para as equipes de compras pequenas e médias que fazem a maior parte desse trabalho. O SAP Ariba começa em aproximadamente US$ 25.000 por ano para uma implantação de médio porte com 500 fornecedores e cinco usuários no módulo Supplier Lifecycle & Performance. O preço inicial do Coupa é de cerca de US$ 2.500 por mês, com implantações típicas de médio porte custando de US$ 200.000 a US$ 800.000 por ano, mais US$ 100.000 a US$ 400.000 em custos de implementação. O AuraVMS, uma ferramenta de RFQ dedicada para pequenas empresas, começa em US$ 5 por mês — mas exige que os fornecedores enviem pela plataforma, o que significa que você não pode processar os PDFs que já estão na sua caixa de entrada.
O mercado de software de compras foi avaliado em US$ 6,6 bilhões em 2024. As ferramentas construídas para implantações de US$ 250.000+ e as ferramentas construídas para automação de RFQ de US$ 5 por mês compartilham uma suposição comum: que o fornecedor usará o formato de envio da ferramenta. A realidade para uma pequena equipe de compras é que as cotações chegam como anexos de e-mail — PDFs, formulários digitalizados e, ocasionalmente, arquivos Excel — e a comparação tem que acontecer com o que você tem, não com o que uma plataforma exige.
A Realidade da Planilha como Sistema — e o Que Está Faltando
Quando uma equipe de compras de pequena ou média empresa não pode justificar uma suíte source-to-pay de seis dígitos, o conjunto de ferramentas padrão é direto: Google Sheets para comparação + Gmail para receber PDFs + entrada manual de dados para conectar os dois. Isso não é uma falha de sofisticação em compras. É uma adaptação racional às ferramentas disponíveis — o Sheets oferece colaboração em tempo real, links compartilháveis e pontuação baseada em fórmulas sem necessidade de TI ou integração de vendedores.
O que falta nessa pilha não é a camada de análise. O Google Sheets lida com formatação condicional, pontuação ponderada e resumos de tabela dinâmica tão bem quanto qualquer plataforma de compras. O que falta é a camada de ingestão — o mecanismo que converte cinco anexos em PDF em cinco linhas de dados estruturados sem transcrição humana.
Para extração de cotação única — puxar dados de um PDF de cotação de um vendedor para uma planilha — um guia passo a passo cobre os fundamentos da extração por nome de coluna através do complemento. O processamento em lote se baseia na mesma interface do painel lateral, mas introduz desafios que não existem na escala de arquivo único: mapeamento consistente de colunas entre fornecedores com terminologias diferentes, lidar com campos que aparecem em algumas cotações, mas não em outras, e produzir uma tabela pronta para comparação onde cada linha se alinha à mesma estrutura de colunas, independentemente do formato de origem.
Como a Extração por Nome de Coluna Unifica Cinco Formatos de Cotação Diferentes
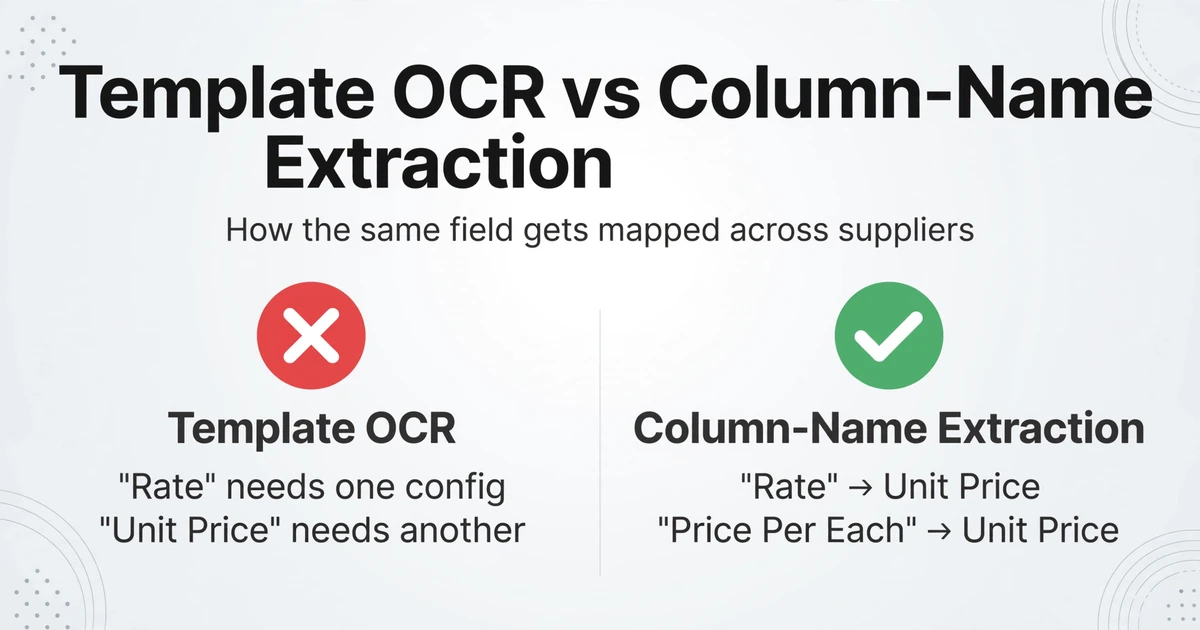
O mecanismo que faz o processamento em lote funcionar em formatos inconsistentes é a extração por nome de coluna: em vez de dizer à ferramenta onde encontrar os dados em cada PDF do fornecedor — desenhando caixas ao redor dos campos, criando modelos por fornecedor — você diz a ela o que deseja extrair. Você define suas colunas de comparação uma vez: "Nome do Fornecedor / Descrição do Item / Preço Unitário / MOQ / Prazo de Entrega (Dias) / Condições de Pagamento." A IA localiza cada valor em cada documento entendendo o que ele significa semanticamente, não onde está na página.
Este é o mecanismo que lida com o problema de vocabulário entre fornecedores. O PDF do Fornecedor A rotula um campo como "Rate". O Fornecedor B o rotula como "Unit Price". O Fornecedor C o rotula como "Price Per Each". Uma ferramenta baseada em modelos vê três nomes de campo diferentes e exige três configurações separadas. A extração por nome de coluna reconhece que todos os três se referem ao mesmo conceito de compras — preço unitário — e os mapeia para a mesma coluna de saída automaticamente. Esta é a diferença entre extração e compreensão: o OCR tradicional extrai strings de texto por posição; a extração por nome de coluna extrai pontos de dados por função semântica.
Para a diversidade de formatos de uma rodada de RFQ real — um PDF gerado por ERP, um texto no corpo de e-mail, um formulário manuscrito escaneado — a abordagem de extração é idêntica nos três casos. Você não altera suas definições de coluna por fornecedor. Você não treina modelos por formato. Os nomes de coluna que você definiu uma vez produzem linhas na mesma tabela a partir de cada documento no lote.
O Fluxo de Trabalho em Lote: Envie os Cinco, Receba Uma Tabela
Um complemento do Google Sheets é um painel lateral que abre dentro da sua planilha — acessível pelo menu Extensões na mesma janela e aba da sua planilha de comparação. Não é uma ferramenta separada que processa cotações em um site e exporta um arquivo que você importa no Sheets. Ele é a interface de extração, rodando dentro da planilha, com a planilha ativa como destino direto da saída.
Para comparação de cotações de fornecedores em lote, essa arquitetura importa de uma forma específica: o painel lateral recebe cinco PDFs de cotação, extrai dados de todos eles usando as mesmas definições de coluna e grava cada resultado como linhas consecutivas diretamente na planilha que você está vendo — sem botão de download, sem etapa de "importar CSV para o Sheets", sem painel intermediário. Para a visão completa dos recursos — tipos de campo suportados, formatos e detalhes do plano — veja a página de recursos de extração do Google Sheets.
Aqui está o fluxo de trabalho em lote em três ações:
Abra o painel lateral, digite os nomes dos campos que você quer comparar entre fornecedores: "Nome do Fornecedor / Descrição do Item / Preço Unitário / MOQ / Prazo de Entrega (Dias) / Condições de Pagamento." Eles se tornam os cabeçalhos da sua tabela. Quando você está logado com uma chave de API, o painel lateral salva essa configuração — na próxima rodada de RFQ, suas colunas de comparação já estarão definidas.
Clique em enviar no painel lateral, selecione cada PDF de cotação — a exportação do ERP do Fornecedor A, o PDF escaneado do Fornecedor B, o formulário manuscrito do Fornecedor C — e confirme. O complemento aceita PDF, JPG, PNG e WebP. Todos os cinco são processados no mesmo lote com a mesma estrutura de colunas.
A IA lê cada arquivo, localiza os valores que correspondem aos nomes das suas colunas e os adiciona como novas linhas na parte inferior da sua planilha ativa. Os dados do Fornecedor A na linha 2, os do Fornecedor B na linha 3 — mesmas colunas, mesma ordem. Suas fórmulas de comparação existentes permanecem intactas acima ou à direita da área de saída.
Os arquivos são processados com segurança e não são armazenados.
O Problema dos Campos Ausentes: Quando o Fornecedor A Informa as Condições de Pagamento e o Fornecedor B Não Informa
Em um fluxo de cotação única, um campo ausente é um pequeno inconveniente — você digita "N/A" ou deixa a célula em branco e segue em frente. Em um lote de cinco cotações alimentando a mesma tabela de comparação, campos ausentes criam problemas estruturais. Se o Fornecedor A especifica "Net 30" nas condições de pagamento, mas a cotação do Fornecedor B não menciona condições de pagamento, sua coluna de comparação fica com uma lacuna. Se você está pontuando fornecedores por critérios ponderados que incluem condições de pagamento, os dados ausentes do Fornecedor B reduzem a pontuação dele — não porque as condições sejam piores, mas porque ele não as declarou.
O complemento lida com campos ausentes com uma estratégia consistente: quando uma coluna que você definiu não aparece no documento de um fornecedor, a célula de saída para esse fornecedor nessa coluna fica vazia. Sem erro. Sem texto de espaço reservado. Uma célula vazia — exatamente o que você criaria se estivesse inserindo os dados manualmente e não encontrasse o campo.
Este é o comportamento correto para uma tabela de comparação. Sua formatação condicional pode destacar células ausentes. Sua fórmula de pontuação pode tratar células vazias como "não informado" em vez de zero. A estrutura de saída não quebra porque um fornecedor omitiu um campo — cada linha tem as mesmas colunas na mesma ordem, com espaços em branco onde os dados não estavam presentes no documento de origem.
Na prática, campos ausentes são a norma, não a exceção, na comparação de cotações de múltiplos fornecedores. Um profissional de compras no r/procurement descreveu seu processo padrão de RFQ com nove etapas manuais e observou que a etapa 5 — "comparar inclusões/exclusões entre o que os fornecedores ofereceram e o que solicitamos" — era a etapa mais demorada. Alguns fornecedores enviam brochuras em vez de respostas estruturadas. Alguns detalham item por item, mas pulam os campos de resumo que você precisa. Alguns PDFs têm todos os dados, mas distribuídos em quatro páginas, com o total enterrado na página 4. A abordagem de extração lida com tudo isso: se os dados estiverem presentes em qualquer lugar do documento, a IA os encontra por significado semântico e os mapeia para a coluna correta. Se não estiverem presentes, a célula fica em branco. Nenhum modelo quebra. Nenhum desalinhamento de linha. Nenhuma reconciliação manual.
O Multiplicador de Velocidade: Cinco Cotações em Uma Sessão vs. Cinco Sessões Separadas
A eficiência do processamento em lote não é aditiva — é estrutural. Processar uma cotação pelo painel lateral leva cerca de 15 a 30 segundos: envie o PDF, a IA localiza os campos definidos, os dados aparecem na planilha. Processar cinco cotações uma a uma — cinco sessões de envio, cinco rodadas de extração separadas — leva cerca de 2 a 3 minutos no total, além do tempo para abrir cada arquivo e confirmar o envio. Isso já é de 10 a 20 vezes mais rápido do que a entrada manual de dados, que leva cerca de 3 minutos por cotação para leitura, localização de cada campo e digitação.
O processamento em lote comprime ainda mais: selecione todos os cinco arquivos de cotação em um único envio, inicie uma sessão de extração e todas as cinco linhas aparecem na planilha. As cinco extrações são executadas sequencialmente — cada arquivo é lido, cada conjunto de valores é localizado, cada linha é adicionada — mas você inicia o lote apenas uma vez. Para uma rodada de RFQ com 5 fornecedores, toda a fase de extração de dados, desde a seleção dos arquivos até ter linhas prontas para comparação no Sheets, é concluída em menos de 2 minutos.
| Método | Tempo para RFQ de 5 Fornecedores | Mensal (4 RFQs) | Limitação Principal |
|---|---|---|---|
| Copiar e colar manual | 60–90 minutos | 4–6 horas | Erros de transcrição; fadiga por alternância de formato |
| Extração de cotação única (×5 sessões) | 2–3 minutos | 8–12 minutos | Cinco sessões de envio separadas |
| Lote no painel lateral (todos os 5 de uma vez) | <2 minutos | <8 minutos | Os arquivos devem estar acessíveis no dispositivo do navegador |
O acúmulo mensal é onde a diferença estrutural se torna visível. Se você realizar uma rodada de RFQ por semana — quatro rodadas por mês, cada uma comparando cinco fornecedores — a entrada manual de dados consome de 4 a 6 horas mensais apenas com transcrição. A extração em lote pelo painel lateral reduz isso para menos de 8 minutos. Isso não é uma melhoria de 2×. Não é 5×. É uma redução de aproximadamente 45× — de "esta é uma tarefa recorrente de meio dia" para "isso acontece enquanto você toma um café".
Para equipes de compras que processam cotações em múltiplas categorias — matérias-primas de um grupo de fornecedores, embalagens de outro, serviços logísticos de um terceiro — a carga semanal de RFQs pode chegar a três ou quatro rodadas de cotação separadas. Com 60 a 90 minutos cada, a comparação manual se torna a atividade dominante na semana de um profissional de compras — um resultado consistente com dados que mostram que profissionais de compras gastam em média 2 horas e 45 minutos por dia em tarefas de sourcing, muito disso em consolidação de dados, e não em avaliação estratégica.
Além das Cotações de Fornecedores: Processamento em Lote Entre Tipos de Documento
O mecanismo de lote no painel lateral do complemento funciona de forma idêntica entre tipos de documento — as colunas mudam, o fluxo de trabalho não. Se você atua em compras e também processa faturas de fornecedores pelo mesmo sistema de rastreamento no Google Sheets, o fluxo de processamento em lote de faturas segue o mesmo padrão: defina as colunas da fatura, envie todas as faturas de fornecedores de uma vez, obtenha uma tabela de razão. Se sua função em compras se estende à conciliação de despesas, o processamento em lote de relatórios de despesas funciona da mesma forma — envie os envios mensais da sua equipe, obtenha uma tabela de reembolso. E se sua organização rastreia recibos para fins fiscais junto com cotações de fornecedores, o guia de processamento em lote de recibos cobre o mesmo padrão de painel lateral para volumes de recibos.
Para quem trabalha pela interface web em vez do painel lateral do Sheets — enviando para o site ImageToTable.ai e exportando para Excel — o guia geral de comparação de cotações de fornecedores em lote cobre o fluxo baseado na web com o mesmo mecanismo de extração por nome de coluna. O motor de extração é o mesmo; o método de entrega é o que difere.
O ponto em comum é que o Google Sheets já é o sistema de registro — para comparações de fornecedores, para rastreamento de faturas, para conciliação de despesas. O complemento não substitui a planilha. Ele substitui a entrada de dados que a alimenta. A mesma extração por nome de coluna que lida com cinco cotações de fornecedores com terminologias diferentes também lida com trinta faturas de fornecedores com layouts diferentes e cem recibos de sistemas POS distintos. O painel lateral é a camada de ingestão que sempre faltou na arquitetura de planilha como sistema.
Para equipes que já comparam cotações de fornecedores manualmente no Google Sheets — mas que também querem o framework completo de comparação, incluindo pontuação ponderada, formatação condicional e o que dá errado quando essas planilhas ficam complexas — nosso artigo sobre erros comuns na comparação de cotações de fornecedores cobre as armadilhas do lado da planilha que a extração em lote não resolve. E para a questão mais ampla de se a comparação manual de cotações ainda faz sentido, o fluxo de comparação manual vs. IA examina o ponto de equilíbrio em que a extração deixa de ser opcional.
Perguntas Frequentes
O complemento consegue lidar com orçamentos com itens de linha — vários produtos por fornecedor?
Sim. Quando o orçamento de um fornecedor contém vários itens de linha, defina suas colunas para capturar a estrutura repetida: "Descrição do Item / Quantidade / Preço Unitário / Total da Linha." A IA reconhece que esses campos se repetem para cada item de linha e cria uma linha separada por item — então, o Fornecedor A com cinco itens de linha gera cinco linhas, cada uma com o mesmo nome do fornecedor, mas dados de itens diferentes. Para fins de comparação, você pode agrupar por fornecedor em sua planilha usando uma tabela dinâmica ou a função QUERY.
E se um fornecedor cotar em uma moeda diferente?
O complemento extrai os valores conforme aparecem no documento. Se o Fornecedor A cotar em USD e o Fornecedor B em EUR, os números extraídos refletem suas moedas originais. Para comparar entre moedas, adicione uma coluna para "Moeda" e use uma fórmula GOOGLEFINANCE em uma coluna adjacente para converter — por exemplo, =GOOGLEFINANCE("CURRENCY:EURUSD") — aplicada uma vez por linha. A extração em si não converte moedas; ela captura o que está na página.
Preciso configurar nomes de colunas diferentes para cada fornecedor?
Não. As definições de colunas que você configura uma vez — "Preço Unitário", "CMP", "Prazo de Entrega", etc. — funcionam para todos os fornecedores, independentemente da terminologia que cada um usa. Este é o mecanismo central da extração por nome de coluna: a IA reconhece que "Taxa", "Preço por Unidade" e "Preço Unitário" se referem ao mesmo conceito de compras. Você não precisa configurar mapeamentos por fornecedor.
O complemento funcionará com orçamentos manuscritos digitalizados?
Sim. O mecanismo de IA processa documentos digitalizados e texto manuscrito da mesma forma que processa PDFs digitais. A precisão para manuscrito depende da legibilidade — letras de forma claras são extraídas com a mesma confiabilidade que texto impresso, enquanto cursivas muito estilizadas e escrita densa podem ter menor precisão. O mecanismo identifica tanto texto impresso quanto manuscrito por meio de seu modelo de linguagem visual, com precisão de reconhecimento de até 99% para dados impressos. Para orçamentos manuscritos, a saída deve ser revisada antes de usá-la como base para decisões de compra.
O que acontece se eu precisar comparar mais de cinco fornecedores?
O upload em lote na barra lateral processa qualquer número de arquivos em uma única sessão — cinco, dez, vinte. A única restrição é que os arquivos devem ser enviados na mesma sessão do navegador. Não há limite de arquivos por lote.