AI文書ルーティングの本質は
文書分類に尽きる
あらゆる文書ワークフローの最初に立ちはだかる問いは、ルーティングの問題のように見えます。このファイルはどのキューに入れるべきか、そのデータはどのシステムに送るべきか、次に誰が確認すべきか。「AI文書ルーティング」を売るプラットフォームは、その答え一式をまとめて提供します。文書が何であるかを判定する分類器、複数の文書がまとまったファイルを分割するスプリッター、そして結果をQuickBooks、Xero、またはAPIに送り込む宛先フックです。請求書・明細書・領収書が混在するバッチを1つのスプレッドシートや台帳にまとめるチームにとって、その仕組みの大半は的外れです。実際に仕分けを行い、各文書が何であるかを判定する部分は、バッチ出力の1列に収まり、設定するワークフローも維持するものもありません。
重要ポイント
- AI文書ルーティングは3つの役割を1つの製品にまとめています。文書の分類、複数の文書が含まれるPDFの分割、そして結果をQuickBooks、Xero、またはAPIに送信することです。
- バッチ内のすべてのファイルが同じスプレッドシートに格納される場合、スプリッターと宛先フックは何もする必要がないため、配信レイヤーが何も配信しないのにセットアップ費用を支払うことになります。
- 実際に山を仕分ける部分は1列だけです。「文書タイプ」と名付ければ、AIが各ファイルを意味に基づいて読み取り、請求書、明細書、領収書、またはその他を自動入力します。
「どこに送るか」の中に隠れた2つの判断
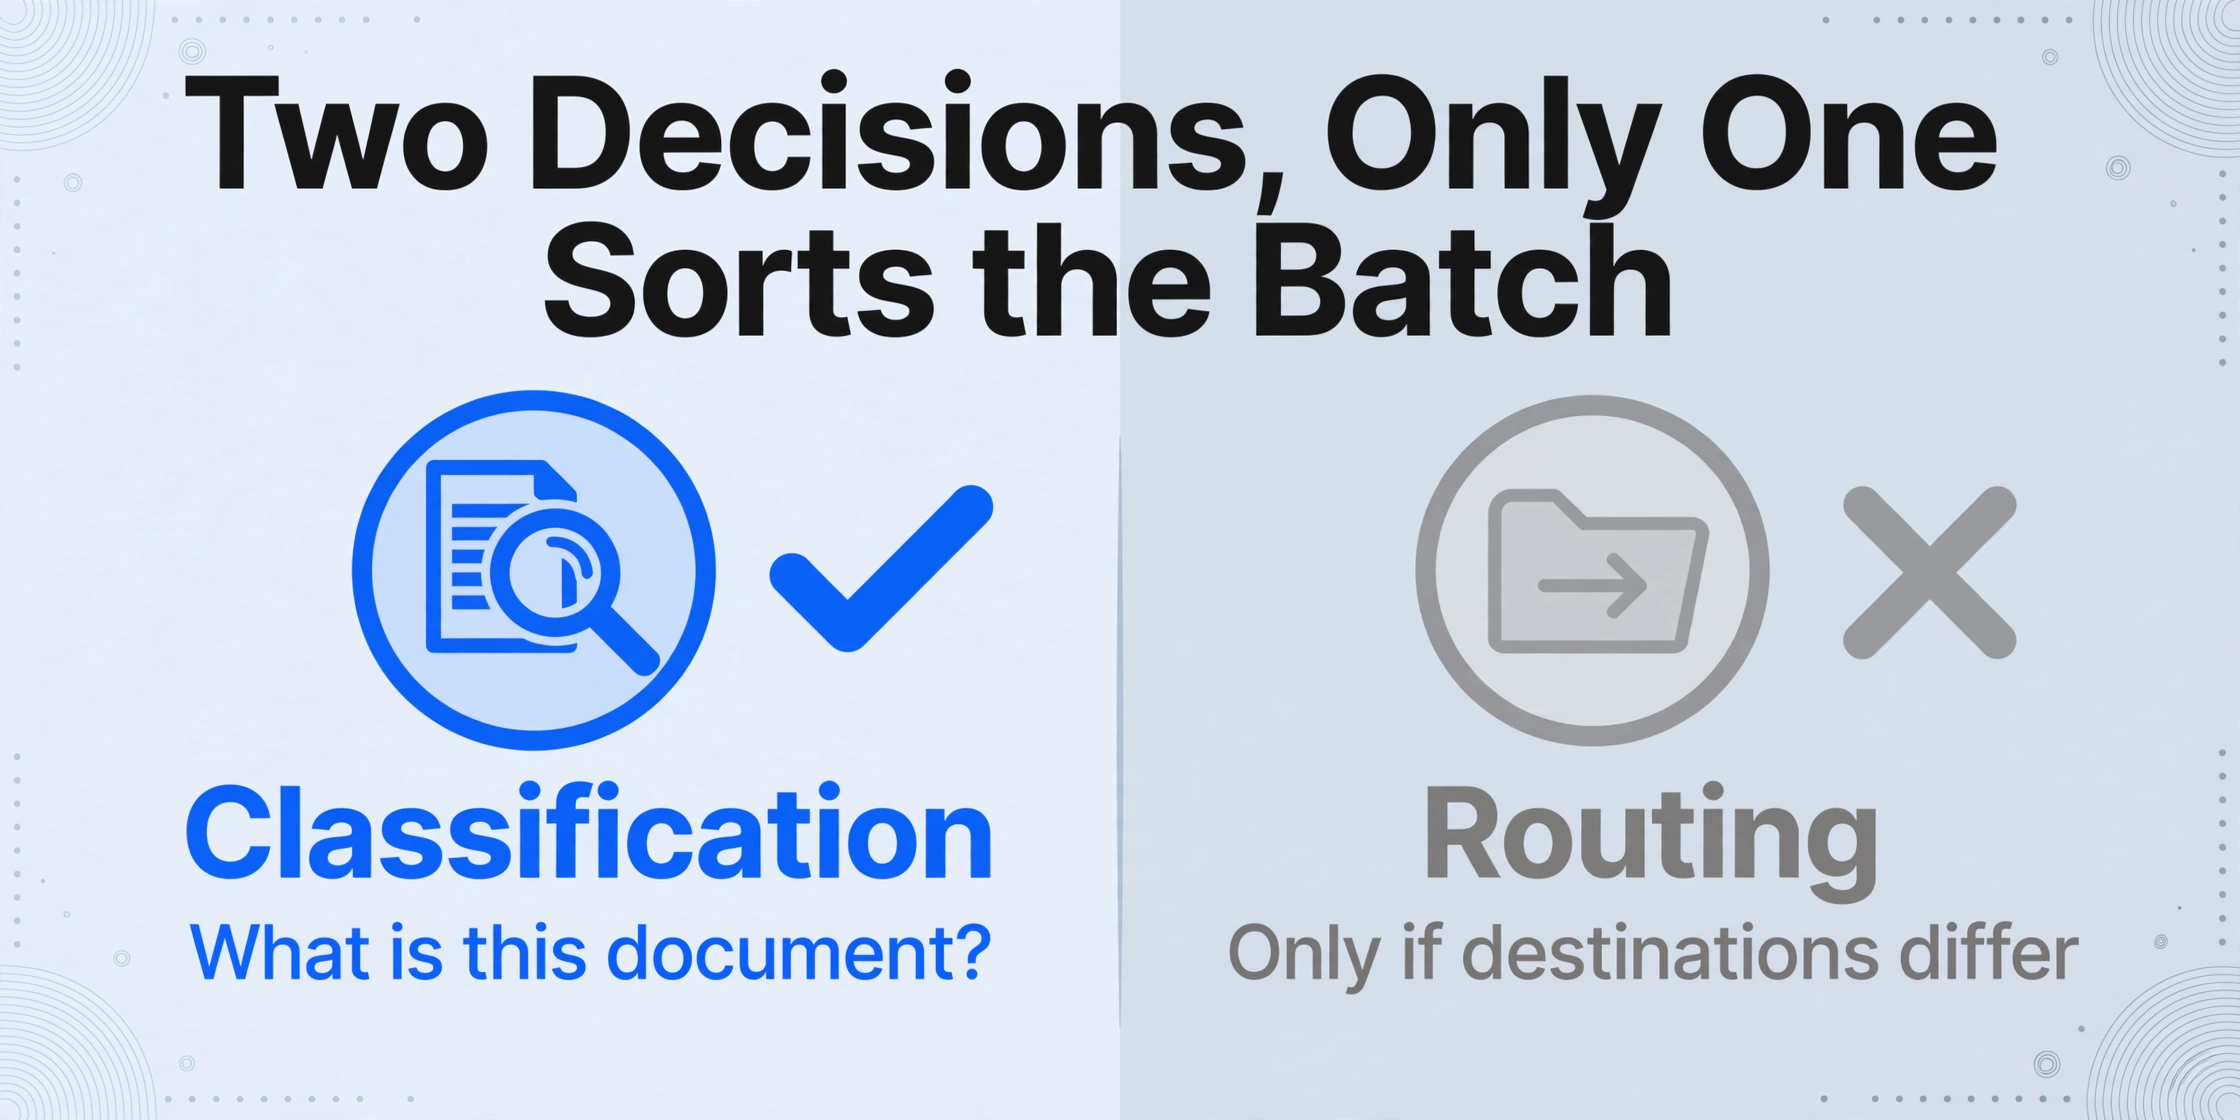
文書分類と文書ルーティングは、通常1つの製品として販売される2つの異なる判断です。分類は「このドキュメントは何か?」に答えます。請求書、銀行明細書、領収書、納品書などです。ルーティングは「どこに送るか?」に答えます。どのパーサーが読むか、どのシステムがデータを受け取るか、どの担当者が承認するかです。業界の定義では分類が先に来ます。インテリジェント情報管理の協会であるAIIMは、インテリジェント文書処理は抽出と検証の前に、コンテンツと構造による文書分類から始まると説明しています(AIIM)。分類ラベルがなければ、ルーティングプラットフォームはルーティングの判断材料を持ちません。
手動でのフローは簡単に理解できます。ほとんどのチームが経験済みだからです。ドキュメントは受信トレイ、共有フォルダ、スキャナ、転送されたメールアドレスを通じて届きます。誰かが各ファイルを開いて内容を確認します。同じ担当者が送信先を決め、その後ドキュメントが処理されます。請求書は入力されて承認用に回され、領収書は経費カテゴリにコード化され、明細書は行ごとに照合されます。中間にいる担当者が分類者です。APアシスタントは40社のベンダーからの請求書をすべて開きます。簿記担当者はクライアントの領収書を月と種類で仕分けます。オペレーションコーディネーターは納品書と返品ラベルを分けます。全員が同じステップを実行します。ドキュメントを読み、それが何かを判断し、その答えに基づいて行動します。
手作業の仕分けは、複雑さではなく量で破綻する
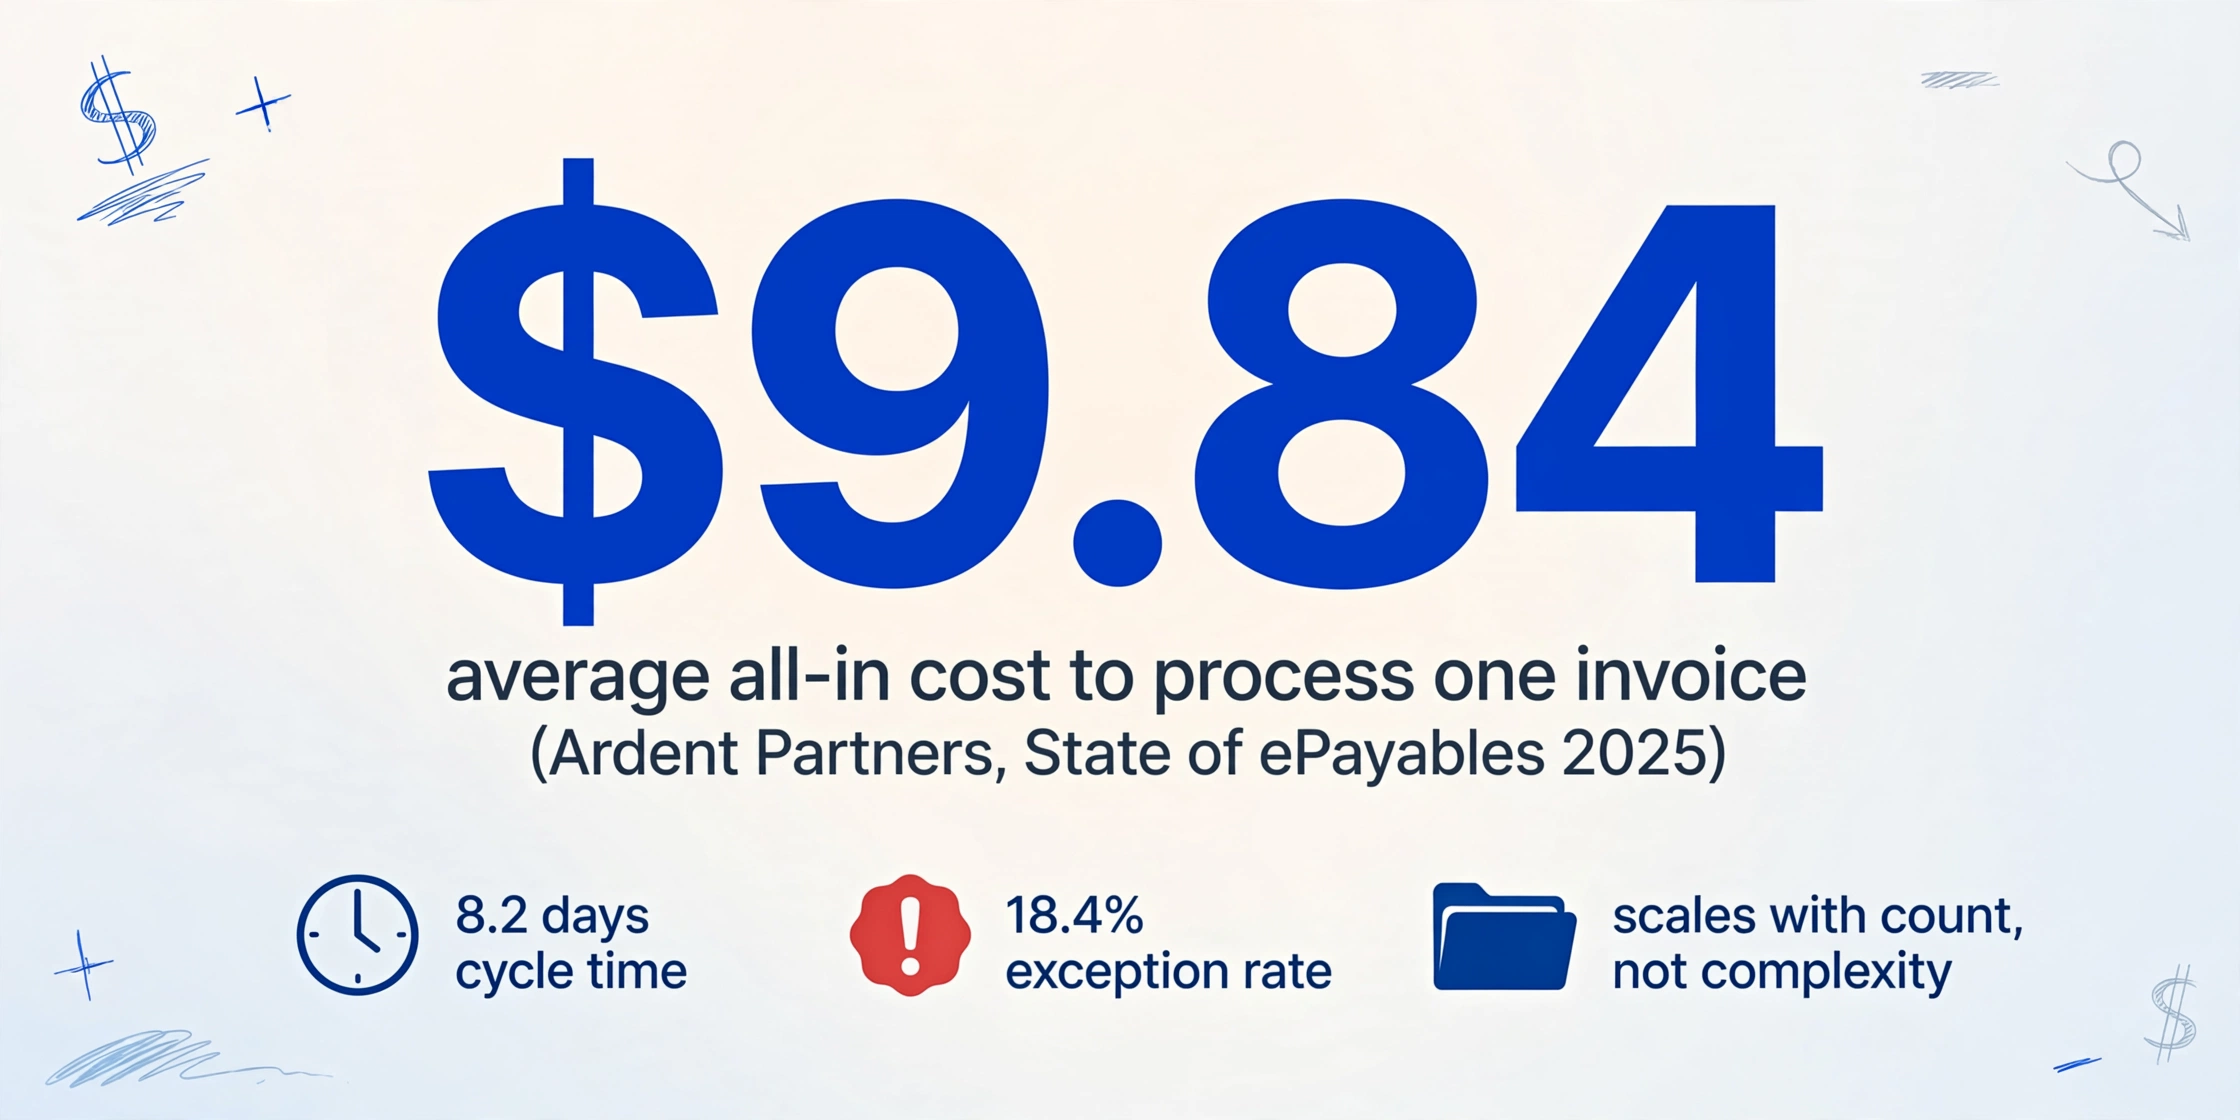
手動による文書分類は難しい仕事ではありません。だからこそ、意味を成さなくなる規模になっても、人手で処理され続けているのです。 仕分けのステップはコストベンチマークに明示されることはほとんどありませんが、その内側には含まれています。Ardent PartnersのState of ePayables 2025によると、請求書1件の処理にかかる平均総コストは$9.84、平均サイクルタイムは8.2日、例外率は18.4%です(State of ePayables 2025)。受領、開封、仕分け、転送は、その数字に含まれる手作業であり、それらは各ドキュメントの複雑さではなく、ドキュメントの件数に応じて増加します。
量が多い場合のエラーは、難しさではなくスピードから生じます。ある実務者は、税理士のためにPDFを正しいフォルダーへドラッグするのに週に約1時間を費やし、急いだときにファイルを間違った場所に置いてしまうという経理担当者の同僚について語っていました。税理士から返ってきた質問は直接的でした。「なぜホテルの請求書が医療費のフォルダーにあるのですか?」(r/VibeCodersNest)。ホテルの請求書を仕分けること自体は、理解するのが難しいことではありません。それを100回連続で一貫して行うことが難しいのです。
ルールベースの仕分けは、逆の方向で失敗します。新しい入力が来るまでは一貫しているのです。1日500〜1,000件のドキュメントを処理する物流チームは、5つのベンダーでは機能した正規表現ルールを導入しましたが、50に達した時点で静かに崩壊しました。新しいベンダーのレイアウトが来るたびにルールを書き直す必要があったからです(r/dataengineering)。テンプレートベースの抽出を困難にする脆さは、位置ベースの仕分けにも同様に当てはまります。その理由も同じで、それは「このベンダー、このレイアウト、このページ」をエンコードしているからです。
このパターンはチームを問わず繰り返されます。AP自動化に関する経理スレッドでは、次のように総括されていました。「多くのチームがスキャンステップを購入しても、ルーティングの部分が先に整理されていないため、結局メールで請求書を追いかけることになる」(r/automation)。仕分けのステップには、利便性だけでなく、コンプライアンス上の側面もあります。IRSの記録保持ガイダンスでは、裏付け書類を年ごと、および収入または経費の種類ごとに整理し、電子保存システムが索引付けされ、判読可能な形式で検索可能であることを求めています(IRS recordkeeping guidance)。分類されていないドキュメントは、誰かに求められたときに見つけられないドキュメントです。
混在バッチがすべて1つのスプレッドシートに集約される場合、送信先の決定はすでに完了しています。手動で残る判断はラベル付けだけです。つまり、このドキュメントは何か、ということです。これは分類の作業であり、ルーティングの作業ではありません。
宛先ルーティングが本当に設定する価値がある場合
ルーティングプラットフォームは、文書タイプごとに異なる後続アクションが発生する場合に真価を発揮します。 請求書は承認キューに入り、会計システムを通じて支払われる必要があります。銀行明細書は照合に使われ、契約書は法務レビューが必要です。宛先システムのスキーマと管理者が異なる場合、配信レイヤーには実際の価値があります。そのような立場のチームは通常、実務者のスレッドに登場するものと同じ、目的特化型のスタックを実行しています。請求書フロー用のBill、Tipalti、Rossum、DextなどのAPプラットフォームや、中間層用のn8n、Unstract、Docsumoなどの軽量ワークフローツールです。これらのツールが存在するのは、ドキュメントが下流で何も共有していないからです。
ルーティングプラットフォームはまた、複数ドキュメントを含むPDFを分割し、5つの請求書が入った1つのスキャンファイルを5つのドキュメントに分離してから、各部分をそれぞれのパーサーにルーティングします。分割は分類とは別の機能であり、到着時に乱雑な単位がファイル自体である場合には常に重要です。
逆のケースも同様に現実的です。バッチ内のすべてのファイルが同じ宛先に到達する場合、ルーティングは選別価値のない設定コストです。下流では文書タイプによって動作が変わりません。トリガーされる承認フローも、行を待つセカンドシステムもありません。チームが必要とするのは、数百のファイルに高速かつ一貫して適用されるラベルだけであり、それ以外は何も必要ありません。混在したメールバッチを処理する中小規模の財務チームのほとんどは、ここに該当します。すべてがスプレッドシートに集約されます。
分類を列にしてルーティング設定をスキップする
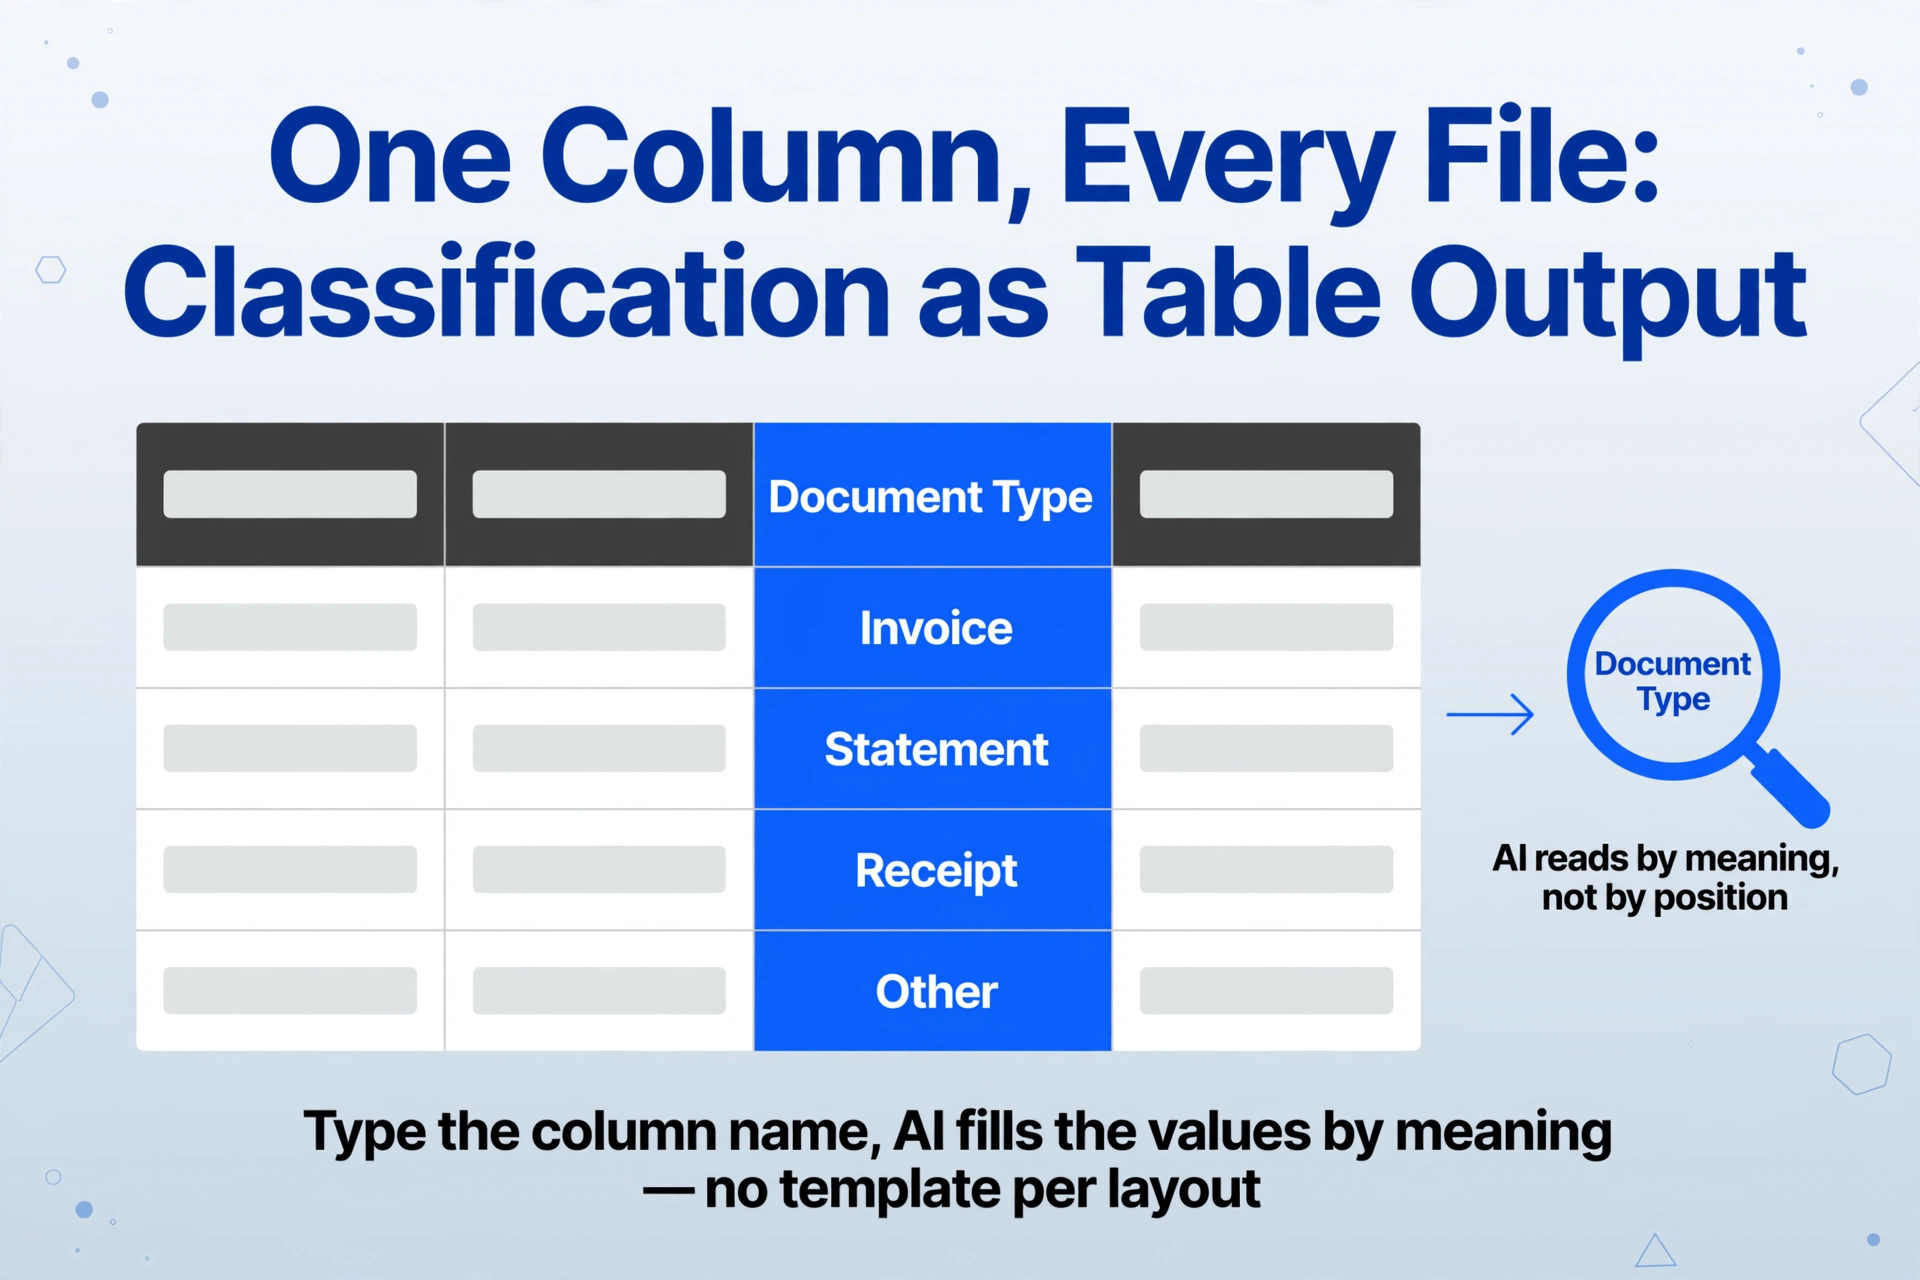
分類を単純なテーブル出力に変える仕組みは、カスタム列抽出です。 必要な列名を入力すると、AIが各ドキュメントを読み取り、ページ上の位置ではなく意味に基づいて値を入力します。これにより、1セットの列名が、同じアップロード内の請求書PDF、撮影された領収書、銀行明細書にわたって、レイアウトごとのテンプレートなしで機能します。ここで重要なモードは推論列です。これは、ドキュメントのどこにも印刷されていないが、ドキュメントの内容から判断できる値を持つ列です。請求書に「私は請求書です」という言葉が印刷されることはありません。「文書タイプ(オプション:請求書 / 明細書 / 領収書 / その他)」という名前の列を追加すると、AIが各ファイルを読み取ってカテゴリを割り当てます。抽出と分類は、バッチ全体に対して同じパスで実行されます。
これにより、ワークフローの通常の順序が逆転します。処理前に文書を分類・仕分けするために停止する代わりに、先に処理を行い、その結果として仕分けが出力に現れます。混在フォルダを1つのバッチとしてアップロードします。結果は、すべての行に文書タイプが含まれる単一のExcelファイルです。スプレッドシートを「請求書」でフィルタリングすれば、山積みの書類は実質的に一度で仕分けられたことになります。それは誰もが見て再利用できる列の中であり、一人の頭の中にあるわけではありません。ボトルネックから抜け出す経路は、宛先接続ではなく、フィルタなのです。
混在する書類の山を1回のアップロードで投入
請求書、明細書、領収書の写真、スキャン画像をまとめて扱います。同じ列セットがすべてのファイルに適用されます。これが事前仕分けなしで任意の文書タイプを1つのバッチで処理するというポイントです。
分類列に名前を付ける
実際に抽出するフィールド(仕入先、日付、金額など)と並べて、「文書タイプ(オプション: 請求書 / 明細書 / 領収書 / その他)」と入力します。カテゴリは、ユーザーが管理するルールではなく、文書を読み取ることで決定されます。
山を仕分ける代わりに出力をフィルタリング
結合されたテーブルを開き、カテゴリでフィルタリングします。境界線上の行は、仕分け完了と見なす前に簡単に確認できます。その判断は、ファイルを開いた人ではなく、列の中に存在します。
定期的なバッチ処理では、専用のルーティング受信トレイなしで、取り込みが同じフローに供給できます。メールと添付ファイルをメールキューに転送するか(請求書と領収書を処理キューに転送する)、共有可能なコレクションリンクを通じてクライアントからファイルを収集します。分類列は、ファイルがどのように届いたかに関係なく、同じように適用されます。また、その山が一度きりの整理であれば、ワークフローを一切使わないアドホックな抽出も同様に適しています。
ファイルは安全に処理され、保存されません。
同じアイデアを「文書タイプ」列と混在アップロードで試してみてください。領収書、明細書、見積書などです。ルーティングプラットフォームがプラットフォーム機能として販売している分類ステップが、出力テーブルの列として戻ってきます。
この仕組みが初めて本格的に解説されたのは、税務シーズンでした。税務ソース文書のトリアージのチュートリアルでは、分類列を使って、確定申告に必要なページと、ファイルに添付されているだけのページを分けています。そこでの判断基準は、特定の申告への関連性です。ここでの判断基準は、混在バッチのタイプと送信先であり、同じ列がその役割を果たします。
分類列でできないこと
ラベル列はバッチを分類するだけで、何かを移動させるわけではありません。請求書をQuickBooksに取り込んだり、Zapierワークフローを起動したりはしません。異なる文書タイプを異なる稼働中のシステムに送り込む必要がある場合、送信先レイヤーは依然として構築する必要があります。その場合、スプレッドシートがルーティングレイヤーになります。フィルタリングされた行を、その文書タイプを所有するシステムにエクスポートし、承認すべき担当者がそこから引き継ぎます。
また、複数の文書をまとめた単一のPDFを分割することもできません。それぞれに独自のレコードと送信先が必要な5つの請求書を含む1つのファイルは、分割とルーティングが必要であり、これは混在フォルダの分類とは別の問題です。1ファイルに1文書のバッチでは、分割は発生しません。
判断が必要なケースもあります。主に類似した文書間で、一見すると請求書に見える明細書、同じベンダーからの2枚の領収書などです。その確認は人間によるレビューパスに委ねるべきです。出力の任意のセルにカーソルを合わせると、ツールがその値が元のページのどこから来たのかを正確にハイライトするため、確信が持てない文書タイプも、ソースと照合するための1クリックで確認できます(抽出ワークフローにおける人間によるレビューステップの位置づけ)。ラベルが安価に確認できる場合、誤ったラベルの影響は小さくなります。
FAQ
文書分類と文書ルーティングの違いは何ですか?
分類は文書が何であるかをラベル付けします。請求書、明細書、領収書、契約書などです。ルーティングは、それを処理すべきワークフローやシステムに移動させます。分類はルーティング内のステップであり、ルーティングプラットフォームはまず分類し、次に配信します。
すべての文書がスプレッドシートに保存される場合、AI文書ルーティングソフトウェアは必要ですか?
下流で文書タイプによって処理が変わらない場合、宛先レイヤーは仕分けの価値を追加せずに設定を追加するだけです。分類列は、実際に時間のかかる判断、つまり各文書が何であるかを決定することをカバーします。
テンプレートやトレーニングなしで文書タイプはどのように決定されますか?
AIは文書全体を読み取り、その内容を列名のカテゴリオプションと照合します。意味に基づいて機能するため、新しいベンダーや再設計されたレイアウトでも新しいテンプレートは不要で、同じ列がこれまで見たことのない文書も分類できる理由です。
1つのPDFに複数の異なる文書が含まれている場合はどうなりますか?
それは分割作業であり、分類とは別です。複数の文書をまとめたファイルは、各部分を個別に処理する前に分離する必要があります。1ファイルに1文書のバッチは影響を受けません。
正しいラベルが割り当てられたことを確認するにはどうすればよいですか?
レビューモードでは、クリックしたセル(文書タイプのセルを含む)について、元の文書のソース領域がハイライト表示されます。全体を読む代わりに境界線上のファイルをスポットチェックすれば、バッチは数分で検証されます。
文書ルーティングのコストがかかる部分は、配信の工程であることはまれです。それは「これは何か」という判断であり、ファイルを開く人が何度も繰り返し、その答えの記録は残りません。分類列はその判断をバッチごとに1行ずつ記録し、フィルタリング、監査、アクションが可能な形で返します。次の混合バッチを1回のアップロードで処理して、仕分けと転送のステップがどれほど早く人の手を必要としなくなるかを確認してください。