Le routage de documents par IA se résume
à la classification des documents
La question au sommet de chaque flux de travail documentaire ressemble à un problème de routage : dans quelle file ce fichier doit-il entrer, quel système doit recevoir ses données, quelle personne doit l'examiner ensuite. Les plateformes qui vendent le « routage de documents par IA » regroupent la réponse complète : un classificateur qui indique ce qu'est un document, un séparateur pour les fichiers contenant plusieurs documents, et des connecteurs de destination qui poussent les résultats vers QuickBooks, Xero ou une API. Pour les équipes qui traitent des lots mixtes de factures, relevés et reçus dans une seule feuille de calcul ou un grand livre, la majeure partie de cette machinerie est hors de propos. La partie qui fait réellement le tri, décider ce qu'est chaque document, tient dans une seule colonne de la sortie du lot, sans flux de travail à configurer ni rien à maintenir.
Points clés à retenir
- Le routage de documents par IA regroupe trois tâches en un seul produit : classifier un document, séparer les PDF contenant plusieurs documents, et pousser les résultats vers QuickBooks, Xero ou une API.
- Si chaque fichier de votre lot aboutit dans la même feuille de calcul, le séparateur et les connecteurs de destination n'ont rien à faire, vous payez donc une configuration pour une couche de livraison qui ne livre jamais.
- La partie qui trie réellement la pile tient en une colonne : nommez-la « Type de document », et l'IA lit chaque fichier par sens et remplit Facture, Relevé, Reçu ou Autre.
Deux décisions se cachent derrière « Où va ce document ? »
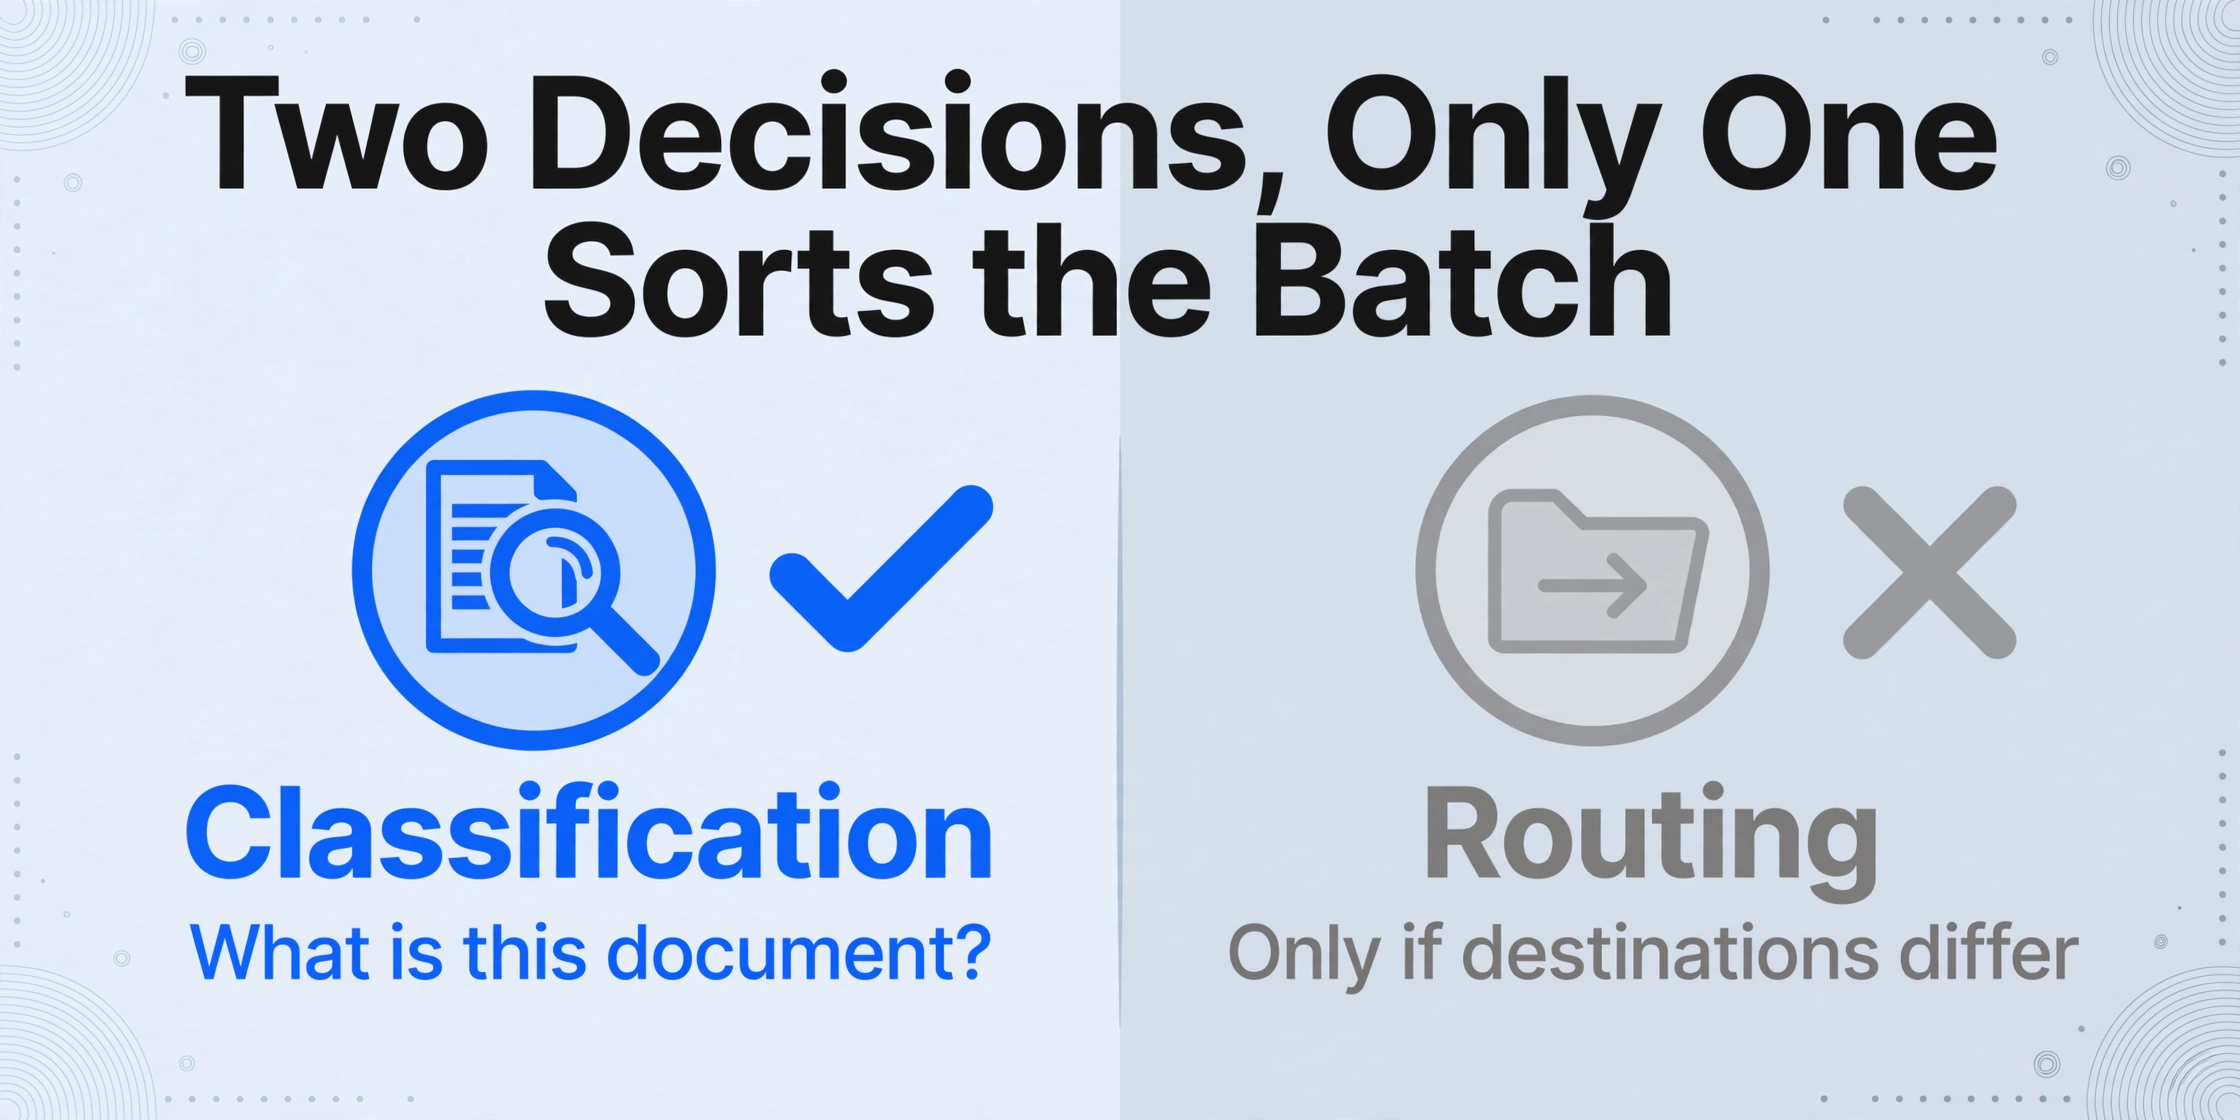
La classification de documents et le routage de documents sont deux décisions différentes qui sont généralement vendues comme un seul produit. La classification répond à la question « qu'est-ce que ce document ? » : une facture, un relevé bancaire, un reçu, un bon de livraison. Le routage répond à la question « où va-t-il ? » : quel analyseur le lit, quel système reçoit les données, quelle personne l'approuve. Les définitions du secteur placent la classification en premier. L'AIIM, l'association pour la gestion intelligente de l'information, décrit le traitement intelligent des documents comme commençant par la classification des documents selon leur contenu et leur structure, avant l'extraction et la validation (AIIM). Sans l'étiquette de classification, une plateforme de routage n'a rien sur quoi fonder son routage.
La version manuelle du flux est facile à parcourir, car la plupart des équipes l'ont vécue. Les documents arrivent via une boîte de réception, un dossier partagé, un scanner ou une adresse e-mail transférée. Quelqu'un ouvre chaque fichier pour voir ce que c'est. Cette même personne décide où il doit aller, puis le document est traité : une facture est saisie et classée pour approbation, un reçu est imputé à une catégorie de dépenses, un relevé est rapproché ligne par ligne. La personne au milieu est le classificateur. Un assistant AP ouvre chaque facture de quarante fournisseurs. Un comptable trie les reçus des clients par mois et par type. Un coordinateur des opérations sépare les bons de livraison des étiquettes de retour. Tous exécutent la même étape : lire le document, décider ce que c'est, agir en conséquence.
Le tri manuel atteint ses limites avec le volume, pas avec la complexité
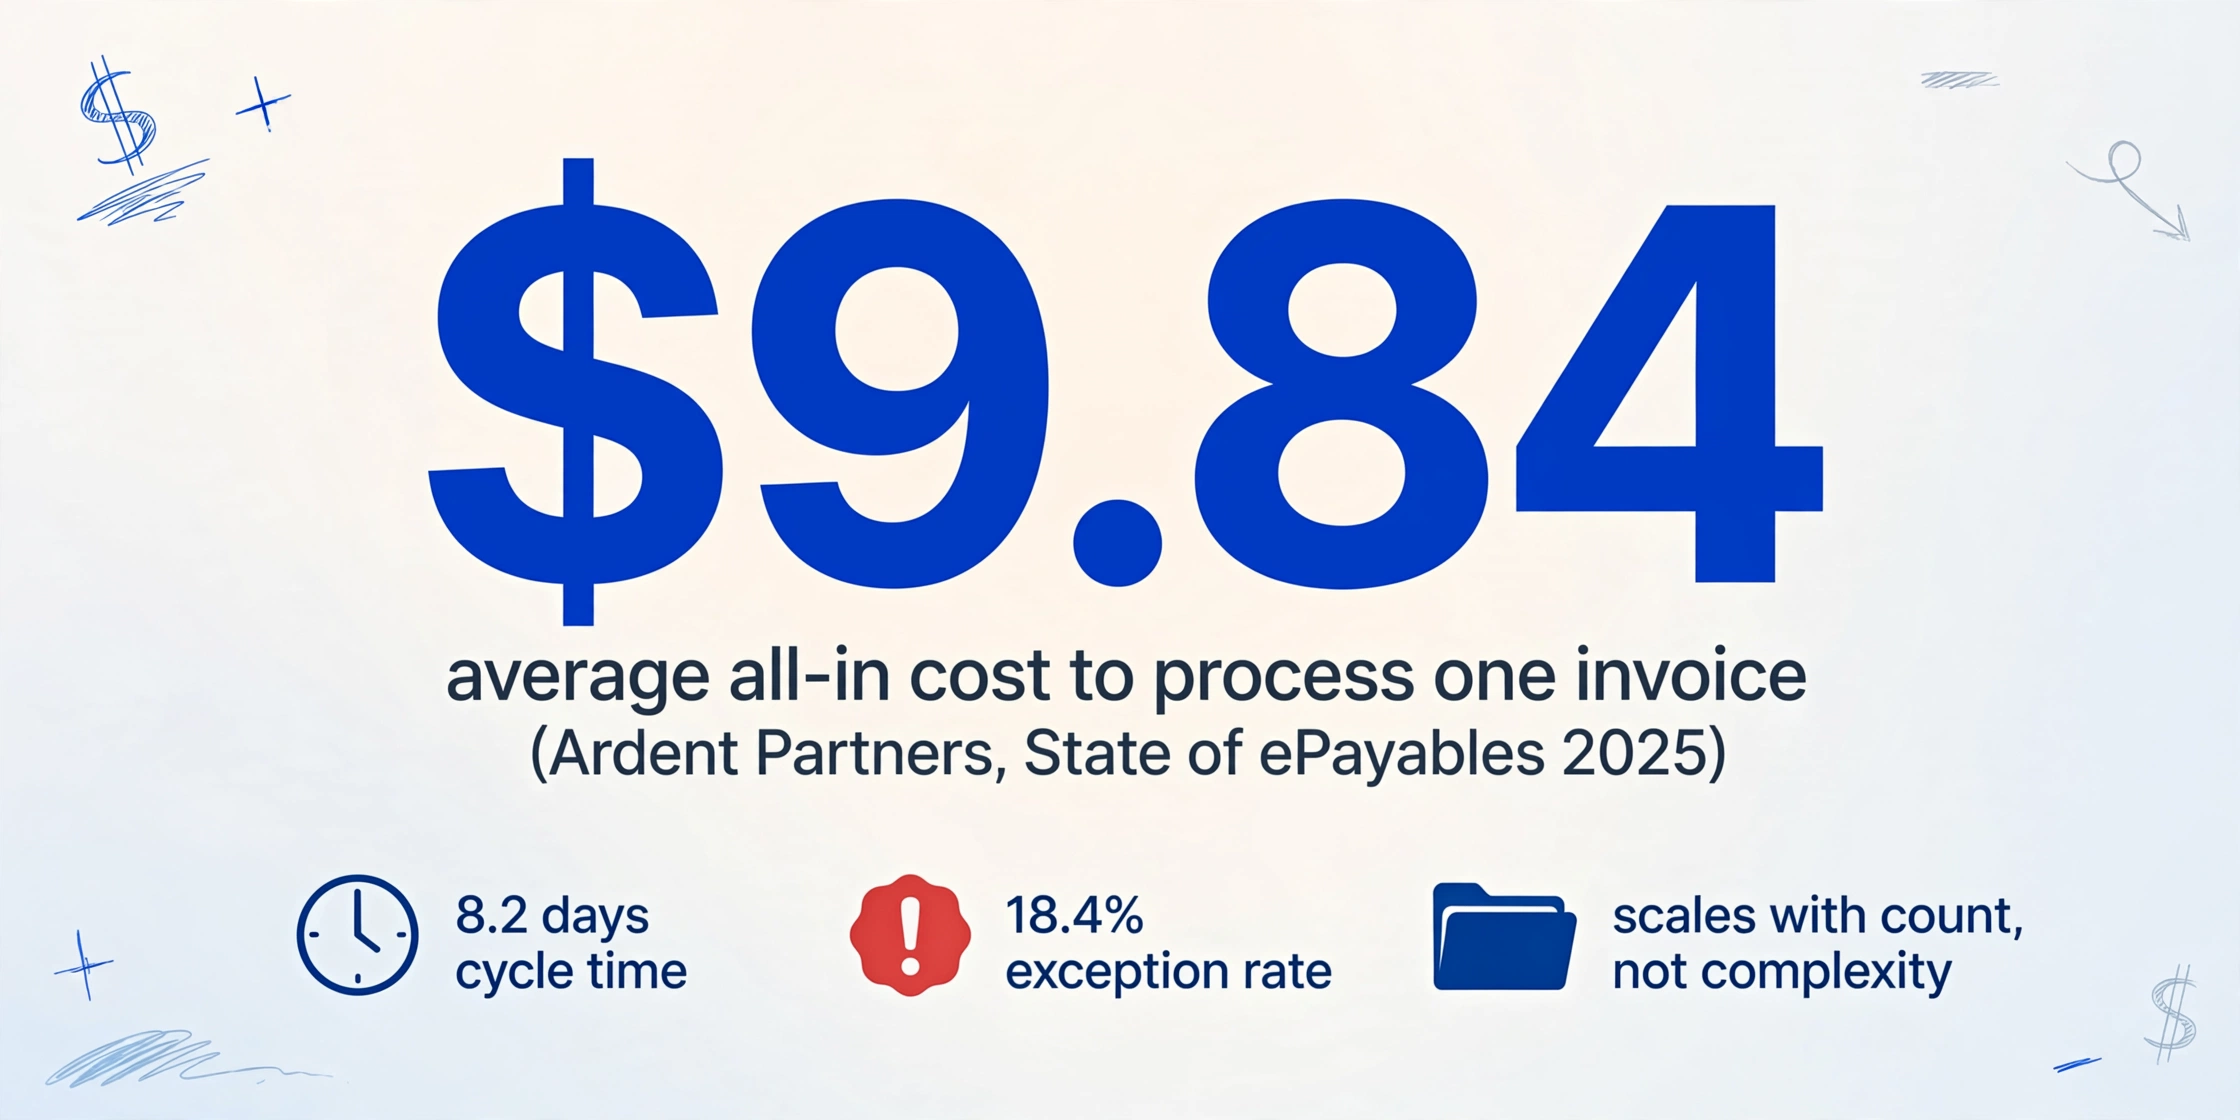
La classification manuelle n'est pas une tâche difficile, et c'est précisément pour cela qu'elle continue d'être effectuée à la main à une échelle où elle n'a plus de sens. L'étape de tri apparaît rarement dans les référentiels de coûts, mais elle en fait partie. Le rapport State of ePayables 2025 d'Ardent Partners estime le coût moyen tout compris du traitement d'une seule facture à 9,84 $, avec un délai de traitement moyen de 8,2 jours et un taux d'exceptions de 18,4 % (State of ePayables 2025). La réception, l'ouverture, le tri et le transfert sont les interventions manuelles incluses dans ce chiffre, et elles évoluent avec le nombre de documents, pas avec le degré de complexité de chaque document.
Les erreurs à grande échelle proviennent de la rapidité, pas de la difficulté. Un praticien a décrit une collègue des finances qui passait environ une heure par semaine à glisser des PDF dans les bons dossiers pour le préparateur fiscal, les fichiers atterrissant au mauvais endroit dès qu'elle se pressait. La question posée par le préparateur était directe : « pourquoi une facture d'hôtel se trouve-t-elle dans le dossier médical ? » (r/VibeCodersNest). Rien dans le tri d'une facture d'hôtel n'est difficile à comprendre. Ce qui est difficile, c'est de le faire de manière cohérente cent fois de suite.
Le tri basé sur des règles échoue dans la direction opposée : cohérent jusqu'à l'arrivée d'une nouvelle entrée. Une équipe logistique traitant 500 à 1 000 documents par jour a commencé avec des règles regex qui tenaient bon chez cinq fournisseurs et se sont discrètement effondrées à cinquante, car chaque nouvelle mise en page de fournisseur impliquait de réécrire les règles (r/dataengineering). La même fragilité qui rend l'extraction basée sur des modèles pénible s'applique au tri basé sur la position, et pour la même raison : elle encode ce fournisseur, cette mise en page, cette page.
Le schéma se répète dans toutes les équipes. Un fil de discussion sur la finance à propos de l'automatisation de la comptabilité fournisseurs l'a bien résumé : « Beaucoup d'équipes achètent l'étape de numérisation, puis finissent encore par courir après les factures dans les e-mails parce que la partie routage n'a jamais été nettoyée en premier » (r/automation). L'étape de tri a aussi une dimension de conformité, pas seulement de commodité. Les directives de tenue de registres de l'IRS exigent que les pièces justificatives soient organisées par année et par type de revenu ou de dépense, et que les systèmes de stockage électronique restent indexés et récupérables sous une forme lisible (directives de tenue de registres de l'IRS). Un document non classifié est un document que vous ne pouvez pas retrouver quand quelqu'un le demande.
Pour un lot mixte qui aboutit dans une seule feuille de calcul, la décision de destination est déjà prise. La seule décision manuelle restante est l'étiquette : qu'est-ce que ce document ? C'est une tâche de classification, pas de routage.
Quand le routage de destination vaut réellement la peine d'être configuré
Les plateformes de routage justifient leur place lorsque les types de documents alimentent différentes actions en aval. Une facture doit entrer dans une file d'approbation et être payée via un système comptable ; un relevé bancaire alimente le rapprochement ; un contrat nécessite une revue juridique. Lorsque les systèmes de destination ont des schémas et des propriétaires différents, la couche de livraison apporte une réelle valeur. Les équipes dans cette situation utilisent généralement des piles spécialisées, celles-là mêmes qui apparaissent dans les fils de discussion des praticiens : des plateformes AP comme Bill, Tipalti, Rossum ou Dext pour les flux de factures, et des outils de workflow plus légers comme n8n, Unstract ou Docsumo pour la couche intermédiaire. Ces outils existent parce que les documents ne partagent rien en aval.
Les plateformes de routage divisent également les PDF multipages, séparant un fichier scanné contenant cinq factures en cinq documents, avant d'acheminer chaque partie vers son propre analyseur. La division est une capacité distincte de la classification, et elle importe chaque fois que l'unité qui arrive en désordre est le fichier lui-même.
Le contre-exemple est tout aussi réel. Lorsque chaque fichier du lot aboutit à la même destination, le routage est un coût de configuration sans valeur de tri. Rien en aval ne réagit différemment selon le type de document : aucun flux d'approbation à déclencher, aucun second système attendant des lignes. L'équipe a besoin de l'étiquette, rapide et cohérente, appliquée à des centaines de fichiers, et rien d'autre. La plupart des petites et moyennes équipes financières qui traitent des lots d'e-mails mixtes se trouvent ici. Tout aboutit dans la feuille de calcul.
Faites de la classification une colonne et évitez la configuration de routage
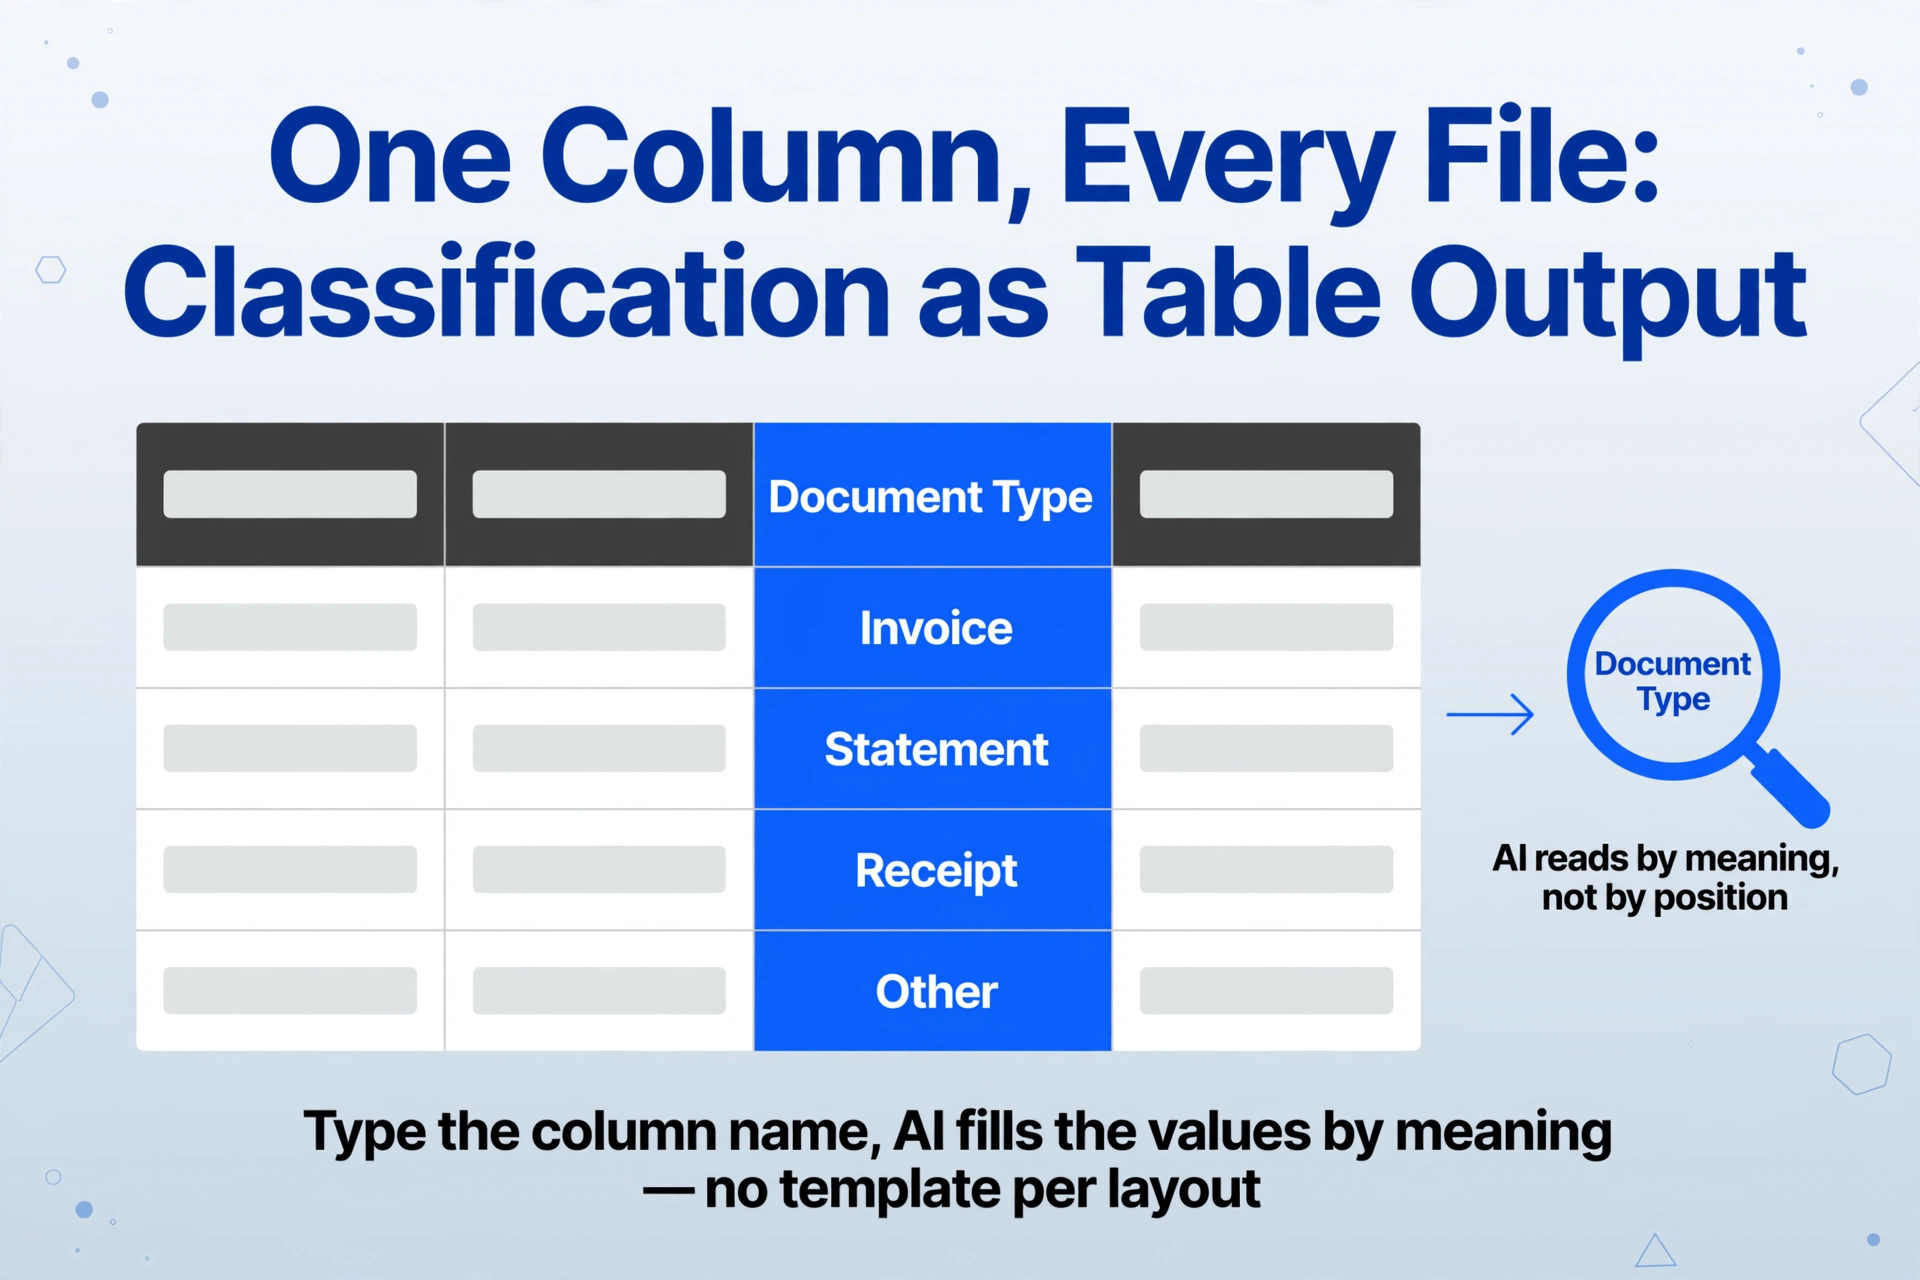
Le mécanisme qui transforme la classification en simple sortie de tableau est l'Extraction de colonnes personnalisées. Vous saisissez les noms de colonnes souhaités, et l'IA lit chaque document et remplit les valeurs par sens, et non par position sur la page. C'est ce qui permet à un même ensemble de noms de colonnes de fonctionner sur un PDF de facture, un reçu photographié et un relevé bancaire dans le même téléversement, sans modèle par mise en page. Le mode qui compte ici est la colonne inférée : une colonne dont la valeur n'est imprimée nulle part sur le document mais peut être déterminée à partir de ce que contient le document. Aucune facture n'imprime les mots « Je suis une facture ». Ajoutez une colonne nommée « Type de document (options : Facture / Relevé / Reçu / Autre) », et l'IA lit chaque fichier et attribue la catégorie. L'extraction et la classification se font en une seule passe, sur l'ensemble du lot.
Cela inverse l'ordre habituel du flux de travail. Au lieu de s'arrêter pour classer et trier les documents avant le traitement, vous traitez d'abord et le tri apparaît dans la sortie. Téléversez le dossier mixte comme un seul lot. Le résultat est un fichier Excel unique où chaque ligne porte son type de document. Filtrez la feuille de calcul sur « Facture » et la pile est effectivement triée pour vous, une fois, dans une colonne que tout le monde peut voir et réutiliser, au lieu d'être dans la tête d'une seule personne. La sortie du goulot d'étranglement est un filtre, pas une connexion de destination.
Déposez toute la pile mixte en un seul téléversement
Factures, relevés, photos de reçus et scans ensemble. Le même ensemble de colonnes fonctionne sur chaque fichier, c'est tout l'intérêt de traiter tout type de document en un seul lot sans pré-tri.
Nommez la colonne de classification
Saisissez « Type de document (options : Facture / Relevé / Reçu / Autre) » en plus des champs que vous extrayez réellement, comme Fournisseur, Date et Montant. La catégorie est déterminée en lisant le document, pas par une règle que vous maintenez.
Filtrez la sortie au lieu de trier la pile
Ouvrez le tableau fusionné et filtrez par catégorie. Les lignes limites reçoivent un coup d'œil rapide avant d'être considérées comme triées, et le jugement vit dans une colonne, pas dans la personne qui a ouvert les fichiers.
Pour les lots récurrents, la réception peut alimenter le même flux sans boîte de routage dédiée : transférez le courrier et les pièces jointes dans une file d'attente e-mail (transférer les factures et reçus dans une file de traitement), ou collectez les fichiers des clients via un lien de collecte partageable. La colonne de classification s'applique de la même manière, peu importe comment un fichier arrive. Et si la pile est un nettoyage ponctuel, une extraction ad hoc sans aucun flux de travail convient tout aussi bien.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Essayez la même idée avec une colonne « Type de document » et un téléversement mixte : un reçu, un relevé, un devis. L'étape de classification que les plateformes de routage vendent comme une fonctionnalité de plateforme revient comme une colonne dans votre tableau de sortie.
La saison des impôts est le premier endroit où ce mécanisme a été entièrement documenté. Notre procédure pas à pas sur le tri des documents sources fiscaux utilise une colonne de classification pour séparer les pages dont dépend une déclaration de celles qui ne servent qu'au dossier. La décision là-bas porte sur la pertinence pour une déclaration spécifique. Ici, la décision porte sur le type et la destination d'un lot mixte, et la même colonne fait le travail.
Ce qu'une colonne de classification ne peut pas faire
Une colonne d'étiquettes trie le lot ; elle ne déplace rien. Elle ne poussera pas une facture dans QuickBooks ni ne déclenchera un workflow Zapier. Si différents types de documents doivent atterrir dans différents systèmes en production, la couche de destination doit encore être construite. Dans ce cas, la feuille de calcul devient la couche de routage : exportez les lignes filtrées vers le système qui gère ce type de document, et les personnes chargées de les approuver gèrent la transmission à partir de là.
Elle ne divisera pas non plus un PDF unique qui regroupe plusieurs documents. Un fichier contenant cinq factures, chacune nécessitant son propre enregistrement et sa propre destination, exige une division et un routage, ce qui est une question distincte du tri d'un dossier mixte. Pour les lots d'un document par fichier, la division ne se pose jamais.
Des décisions subjectives existent, surtout entre des documents similaires : un relevé qui ressemble à une facture au premier coup d'œil, deux reçus du même fournisseur. La vérification appartient à une étape de relecture humaine. Survolez n'importe quelle cellule de la sortie et l'outil met en évidence exactement d'où vient cette valeur sur la page d'origine, donc un type de document dont vous n'êtes pas sûr se vérifie en un clic par rapport à la source (où l'étape de relecture humaine se situe dans un workflow d'extraction). Une étiquette erronée fait moins de dégâts quand elle est rapide à vérifier.
FAQ
Quelle est la différence entre la classification de documents et le routage de documents ?
La classification indique ce qu'est un document : facture, relevé, reçu, contrat. Le routage l'achemine vers le flux de travail ou le système qui doit le traiter. La classification est une étape du routage, et une plateforme de routage classe d'abord, puis achemine.
Ai-je besoin d'un logiciel de routage de documents par IA si tous les documents finissent dans un tableur ?
Si rien en aval ne réagit différemment selon le type de document, la couche de destination ajoute de la configuration sans apporter de valeur de tri. Une colonne de classification couvre le jugement qui prend réellement du temps : décider ce qu'est chaque document.
Comment le type de document est-il déterminé sans modèle ni formation ?
L'IA lit le document dans son ensemble et fait correspondre son contenu aux options de catégorie du nom de colonne. Elle fonctionne par le sens, donc un nouveau fournisseur ou une mise en page repensée ne nécessite pas de nouveau modèle, c'est pourquoi la même colonne peut classer des documents qu'elle n'a jamais vus.
Que se passe-t-il si un seul PDF contient plusieurs documents différents ?
C'est une tâche de séparation, distincte de la classification. Les fichiers qui regroupent plusieurs documents doivent être séparés avant que chaque partie puisse être traitée individuellement. Les lots d'un document par fichier ne sont pas concernés.
Comment vérifier que la bonne étiquette a été attribuée ?
Le mode de révision met en évidence la zone source sur le document original pour toute cellule sur laquelle vous cliquez, y compris la cellule du type de document. Vérifiez les fichiers limites au lieu de lire toute la pile, et le lot est vérifié en quelques minutes.
La partie coûteuse du routage de documents est rarement l'étape de livraison. C'est le jugement, « qu'est-ce que c'est », répété des centaines de fois par celui qui ouvre les fichiers, sans trace de la réponse. Une colonne de classification enregistre ce jugement une fois par ligne, par lot, et le restitue sous une forme filtrable, auditable et exploitable. Passez votre prochain lot mixte en un seul téléversement et voyez à quelle vitesse l'étape de tri et d'acheminement n'a plus besoin d'une personne.