KI-Dokumenten-Routing läuft letztlich
auf Dokumentklassifizierung hinaus
Die Frage am Anfang jedes Dokument-Workflows liest sich wie ein Routing-Problem: In welche Warteschlange soll diese Datei, welches System soll ihre Daten erhalten, welche Person soll sie als Nächstes prüfen? Die Plattformen, die „KI-Dokumenten-Routing" verkaufen, bündeln die vollständige Antwort: einen Klassifizierer, der sagt, was ein Dokument ist, einen Splitter für Dateien, die mehrere Dokumente enthalten, und Ziel-Hooks, die Ergebnisse in QuickBooks, Xero oder eine API übertragen. Für Teams, die gemischte Batches aus Rechnungen, Kontoauszügen und Belegen in einer einzigen Tabelle oder einem Hauptbuch verarbeiten, ist der Großteil dieser Mechanik nebensächlich. Der Teil, der die Sortierung tatsächlich übernimmt – die Entscheidung, was jedes Dokument ist – passt in eine einzige Spalte der Batch-Ausgabe, ohne Workflow, der eingerichtet werden muss, und ohne Wartungsaufwand.
Die wichtigsten Erkenntnisse
- KI-Dokumenten-Routing bündelt drei Aufgaben in einem Produkt: ein Dokument klassifizieren, PDFs mit mehreren Dokumenten aufteilen und Ergebnisse in QuickBooks, Xero oder eine API übertragen.
- Wenn jede Datei in Ihrem Batch in derselben Tabelle landet, haben der Splitter und die Ziel-Hooks nichts zu tun – Sie zahlen also für die Einrichtung einer Übertragungsebene, die nie etwas überträgt.
- Der Teil, der den Stapel tatsächlich sortiert, ist eine Spalte: Benennen Sie sie „Dokumenttyp", und die KI liest jede Datei nach Bedeutung und füllt Rechnung, Kontoauszug, Beleg oder Sonstiges aus.
Zwei Entscheidungen verstecken sich in „Wohin damit?"
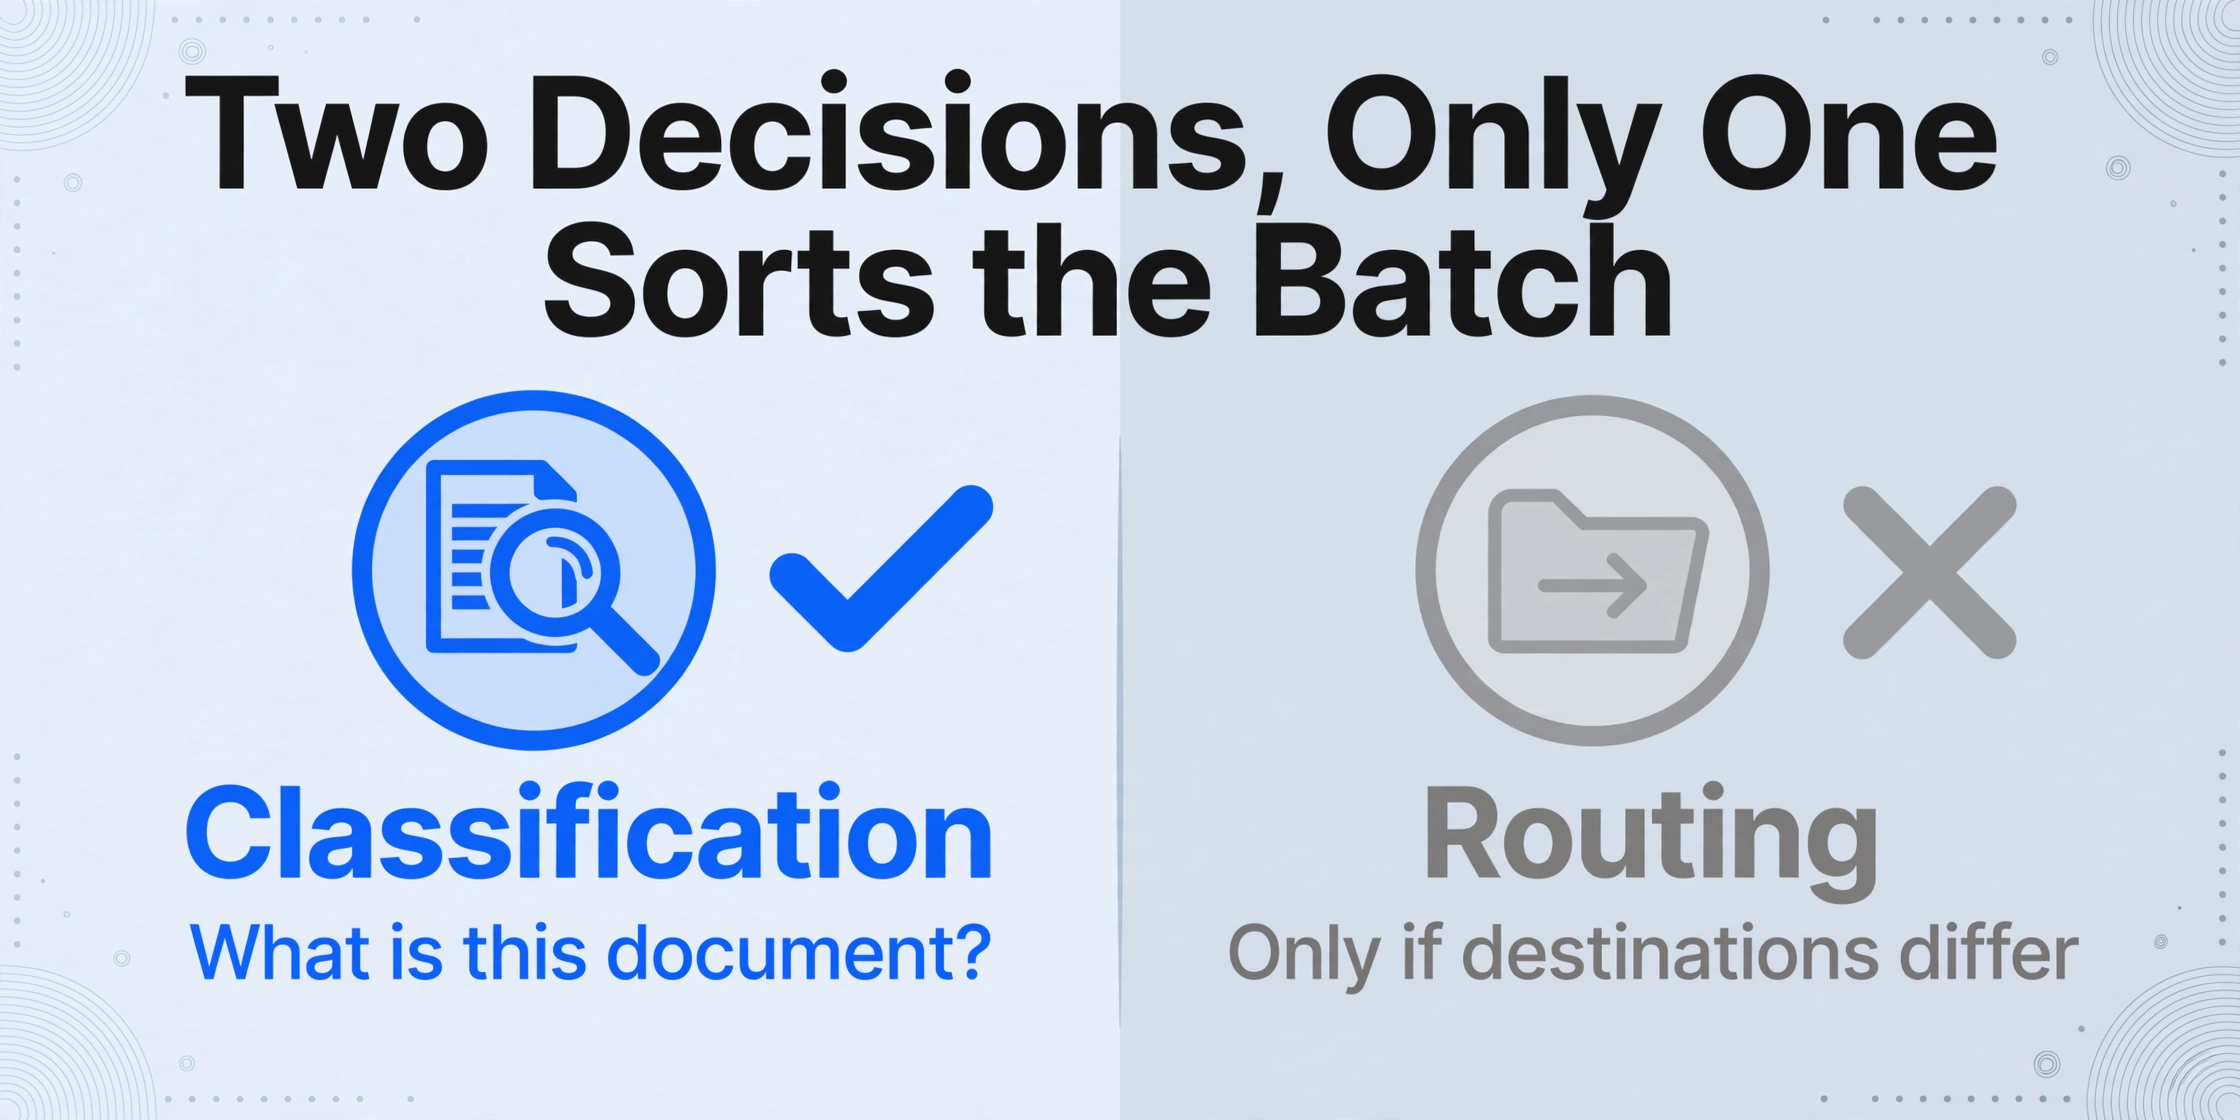
Dokumentklassifizierung und Dokument-Routing sind zwei verschiedene Entscheidungen, die meist als ein Produkt verkauft werden. Die Klassifizierung beantwortet „Was ist dieses Dokument?": eine Rechnung, ein Kontoauszug, ein Beleg, ein Lieferschein. Das Routing beantwortet „Wohin geht es?": welcher Parser es liest, welches System die Daten erhält, welche Person es genehmigt. Branchendefinitionen stellen die Klassifizierung an den Anfang. AIIM, der Verband für intelligentes Informationsmanagement, beschreibt intelligente Dokumentenverarbeitung als beginnend mit der Klassifizierung von Dokumenten nach Inhalt und Struktur, bevor Extraktion und Validierung erfolgen (AIIM). Ohne das Klassifizierungslabel hat eine Routing-Plattform nichts, worauf sie routen könnte.
Die manuelle Version des Ablaufs lässt sich leicht nachvollziehen, weil die meisten Teams sie erlebt haben. Dokumente treffen über einen Posteingang, einen gemeinsamen Ordner, einen Scanner oder eine weitergeleitete E-Mail-Adresse ein. Jemand öffnet jede Datei, um zu sehen, was sie ist. Dieselbe Person entscheidet, wohin sie gehört, und dann wird das Dokument verarbeitet: Eine Rechnung wird erfasst und zur Genehmigung abgelegt, ein Beleg wird einer Ausgabenkategorie zugeordnet, ein Kontoauszug wird Zeile für Zeile abgeglichen. Die Person in der Mitte ist der Klassifizierer. Ein AP-Assistent öffnet jede Rechnung von vierzig Lieferanten. Ein Buchhalter sortiert Kundenbelege nach Monat und Typ. Ein Ops-Koordinator trennt Lieferscheine von Retourenetiketten. Alle führen denselben Schritt aus: Dokument lesen, entscheiden, was es ist, entsprechend handeln.
Die manuelle Sortierung scheitert am Volumen, nicht an der Komplexität
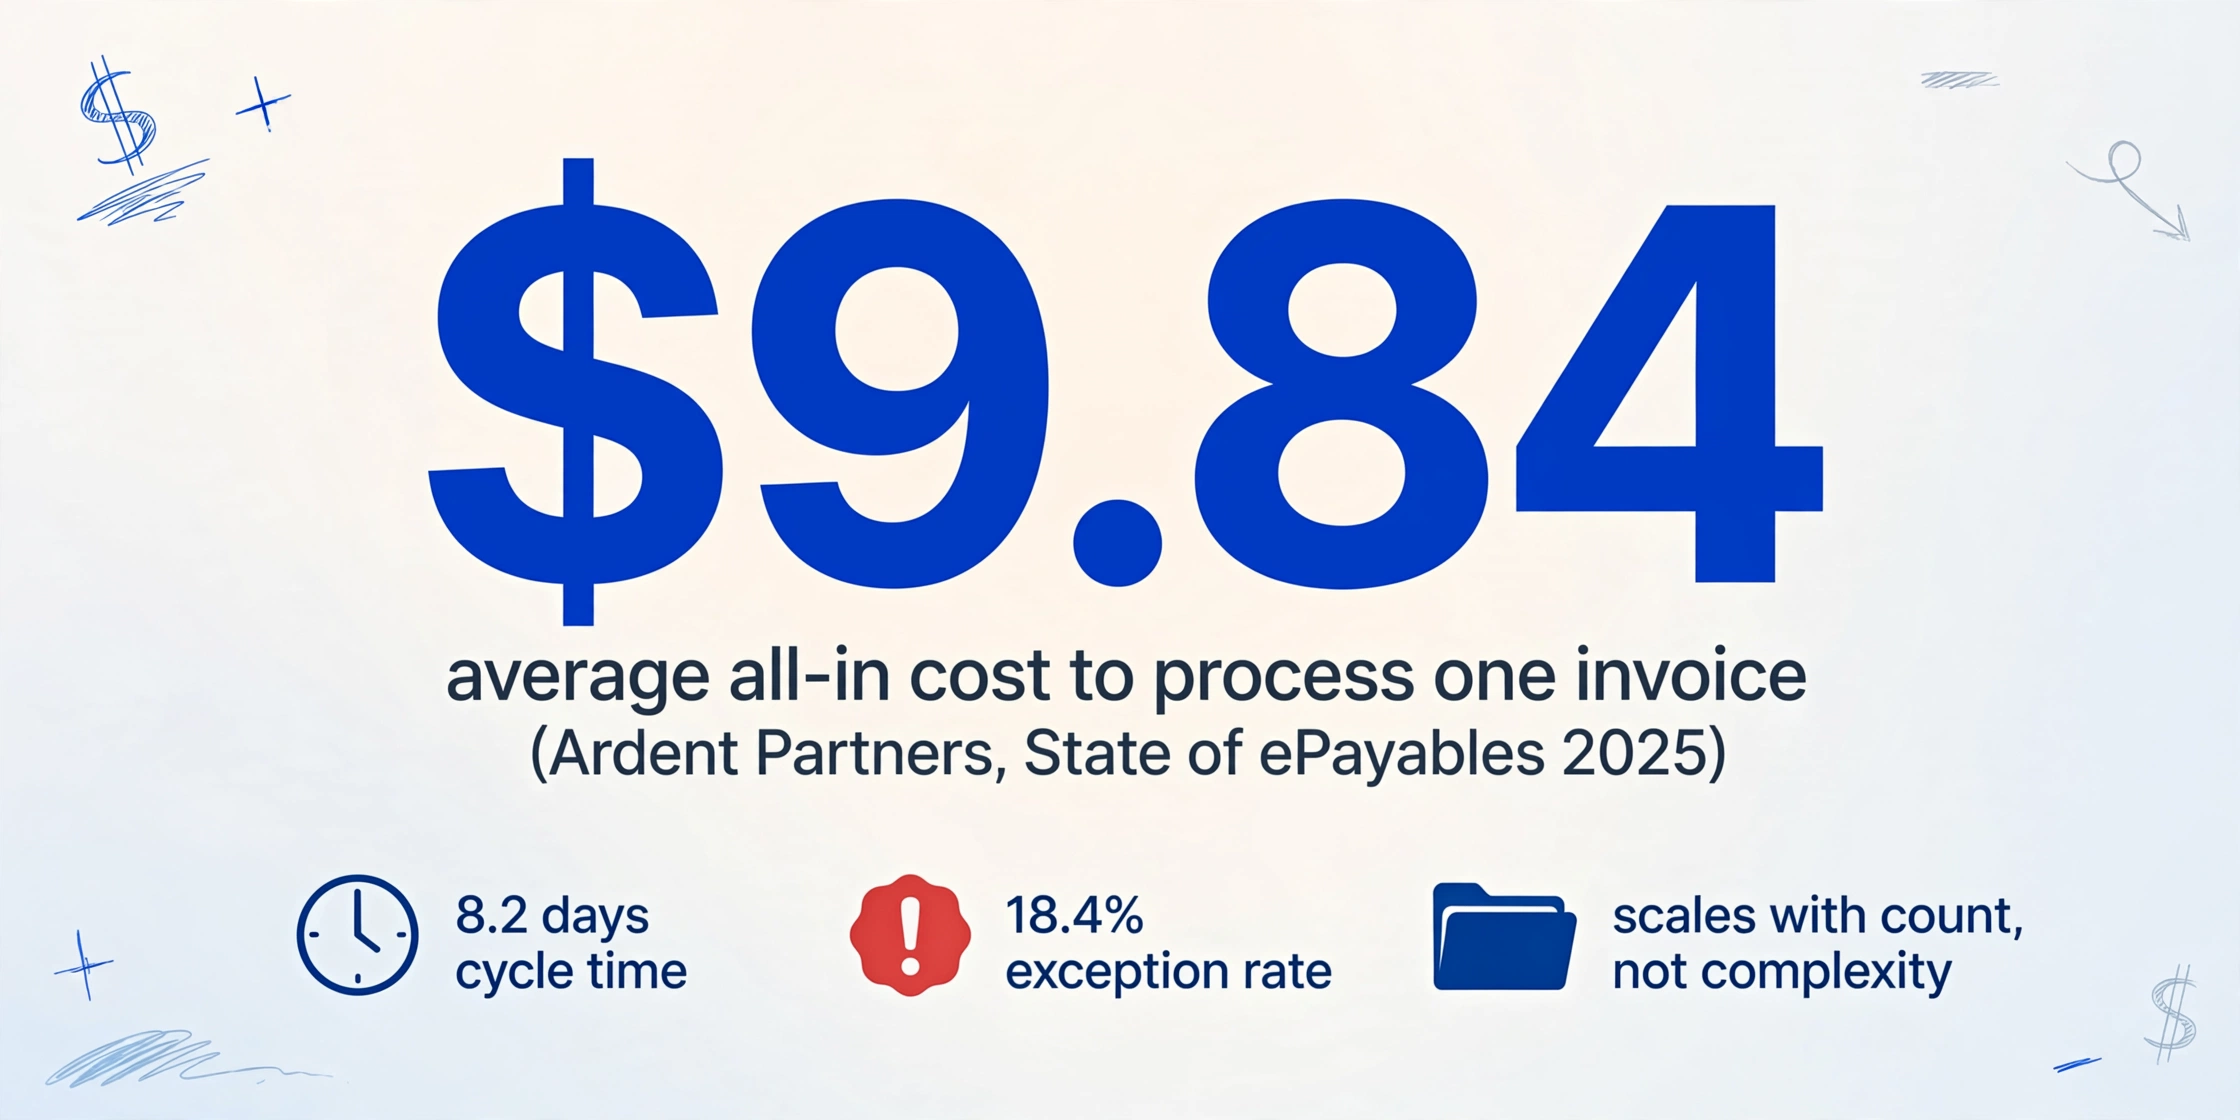
Manuelle Klassifizierung ist keine schwierige Aufgabe, und genau deshalb wird sie in einer Größenordnung weiterhin von Hand erledigt, in der sie keinen Sinn mehr ergibt. Der Sortierschritt taucht in Kosten-Benchmarks selten auf, aber er steckt in ihnen. Der State of ePayables 2025 von Ardent Partners beziffert die durchschnittlichen Gesamtkosten für die Verarbeitung einer einzelnen Rechnung auf $9.84, mit einer durchschnittlichen Zykluszeit von 8.2 Tagen und einer Ausnahmefälle-Quote von 18.4 Prozent (State of ePayables 2025). Empfangen, Öffnen, Sortieren und Weiterleiten sind die manuellen Arbeitsschritte in dieser Zahl, und sie skalieren mit der Dokumentanzahl, nicht mit der Komplexität des jeweiligen Dokuments.
Fehler bei hohem Volumen entstehen durch Geschwindigkeit, nicht durch Schwierigkeit. Ein Praktiker beschrieb eine Finanzkollegin, die etwa eine Stunde pro Woche damit verbrachte, PDFs für den Steuerberater in die richtigen Ordner zu ziehen – wobei Dateien immer dann am falschen Ort landeten, wenn sie es eilig hatte. Die Rückfrage des Steuerberaters war direkt: „Warum liegt eine Hotelrechnung im Ordner für medizinische Belege?" (r/VibeCodersNest). Am Sortieren einer Hotelrechnung ist nichts schwer zu verstehen. Es ist schwer, es hundertmal hintereinander konsistent zu tun.
Regelbasiertes Sortieren scheitert in die entgegengesetzte Richtung: konsistent, bis eine neue Eingabe eintrifft. Ein Logistikteam, das 500 bis 1.000 Dokumente pro Tag verarbeitet, begann mit Regex-Regeln, die über fünf Anbieter hinweg hielten und bei fünfzig stillschweigend auseinanderfielen, weil jedes neue Anbieter-Layout bedeutete, die Regeln neu zu schreiben (r/dataengineering). Dieselbe Sprödigkeit, die die Extraktion auf Vorlagenbasis mühsam macht, gilt für positionsbasiertes Sortieren – und aus demselben Grund: Es kodiert diesen Anbieter, dieses Layout, diese Seite.
Das Muster wiederholt sich in Teams. Ein Finanz-Thread über AP-Automatisierung fasste es zusammen: „Viele Teams kaufen den Scan-Schritt, jagen dann aber trotzdem noch Rechnungen in E-Mails hinterher, weil der Routing-Teil nie zuerst bereinigt wurde" (r/automation). Der Sortierschritt hat auch eine Compliance-Dimension, nicht nur eine der Bequemlichkeit. Die IRS-Aufzeichnungsrichtlinien erwarten, dass Belege nach Jahr und nach Art der Einnahmen oder Ausgaben organisiert sind und dass elektronische Speichersysteme indexiert und in lesbarer Form abrufbar bleiben (IRS-Aufzeichnungsrichtlinien). Ein Dokument, das nicht klassifiziert ist, ist ein Dokument, das man nicht finden kann, wenn jemand danach fragt.
Bei einem gemischten Batch, der vollständig in einer einzigen Tabelle landet, ist die Entscheidung über das Ziel bereits gefallen. Die einzige manuelle Entscheidung, die bleibt, ist die Beschriftung: Was ist dieses Dokument? Das ist eine Klassifizierungsaufgabe, kein Routing.
Wann sich Ziel-Routing wirklich lohnt
Routing-Plattformen sind dann ihren Platz wert, wenn verschiedene Dokumenttypen unterschiedliche nachgelagerte Aktionen auslösen. Eine Rechnung muss in eine Genehmigungswarteschlange und über ein Buchhaltungssystem bezahlt werden; ein Kontoauszug speist den Abgleich; ein Vertrag benötigt eine rechtliche Prüfung. Wenn die Zielsysteme unterschiedliche Schemata und unterschiedliche Verantwortliche haben, trägt die Zustellebene echten Wert. Teams in dieser Position betreiben typischerweise zweckgebundene Stacks – dieselben, die in Praktiker-Foren auftauchen: AP-Plattformen wie Bill, Tipalti, Rossum oder Dext für Rechnungsworkflows und leichtere Workflow-Tools wie n8n, Unstract oder Docsumo für die mittlere Ebene. Diese Tools existieren, weil die Dokumente nachgelagert nichts gemeinsam haben.
Routing-Plattformen teilen außerdem mehrseitige PDFs auf, trennen eine gescannte Datei mit fünf Rechnungen in fünf Dokumente, bevor jeder Teil an seinen eigenen Parser weitergeleitet wird. Das Aufteilen ist eine separate Fähigkeit von der Klassifizierung und zählt immer dann, wenn die Einheit, die unordentlich ankommt, die Datei selbst ist.
Der Gegenfall ist genauso real. Wenn jede Datei im Batch am selben Ziel endet, ist Routing Einrichtungskosten ohne Sortierwert. Nichts downstream verhält sich je nach Dokumenttyp anders: kein Genehmigungsablauf wird ausgelöst, kein zweites System wartet auf Zeilen. Das Team braucht die Beschriftung, schnell und konsistent, auf Hunderte von Dateien angewendet, und sonst nichts. Die meisten kleinen und mittleren Finanzteams, die gemischte E-Mail-Batches verarbeiten, befinden sich hier. Alles landet in der Tabelle.
Klassifizierung als Spalte umsetzen und das Routing-Setup überspringen
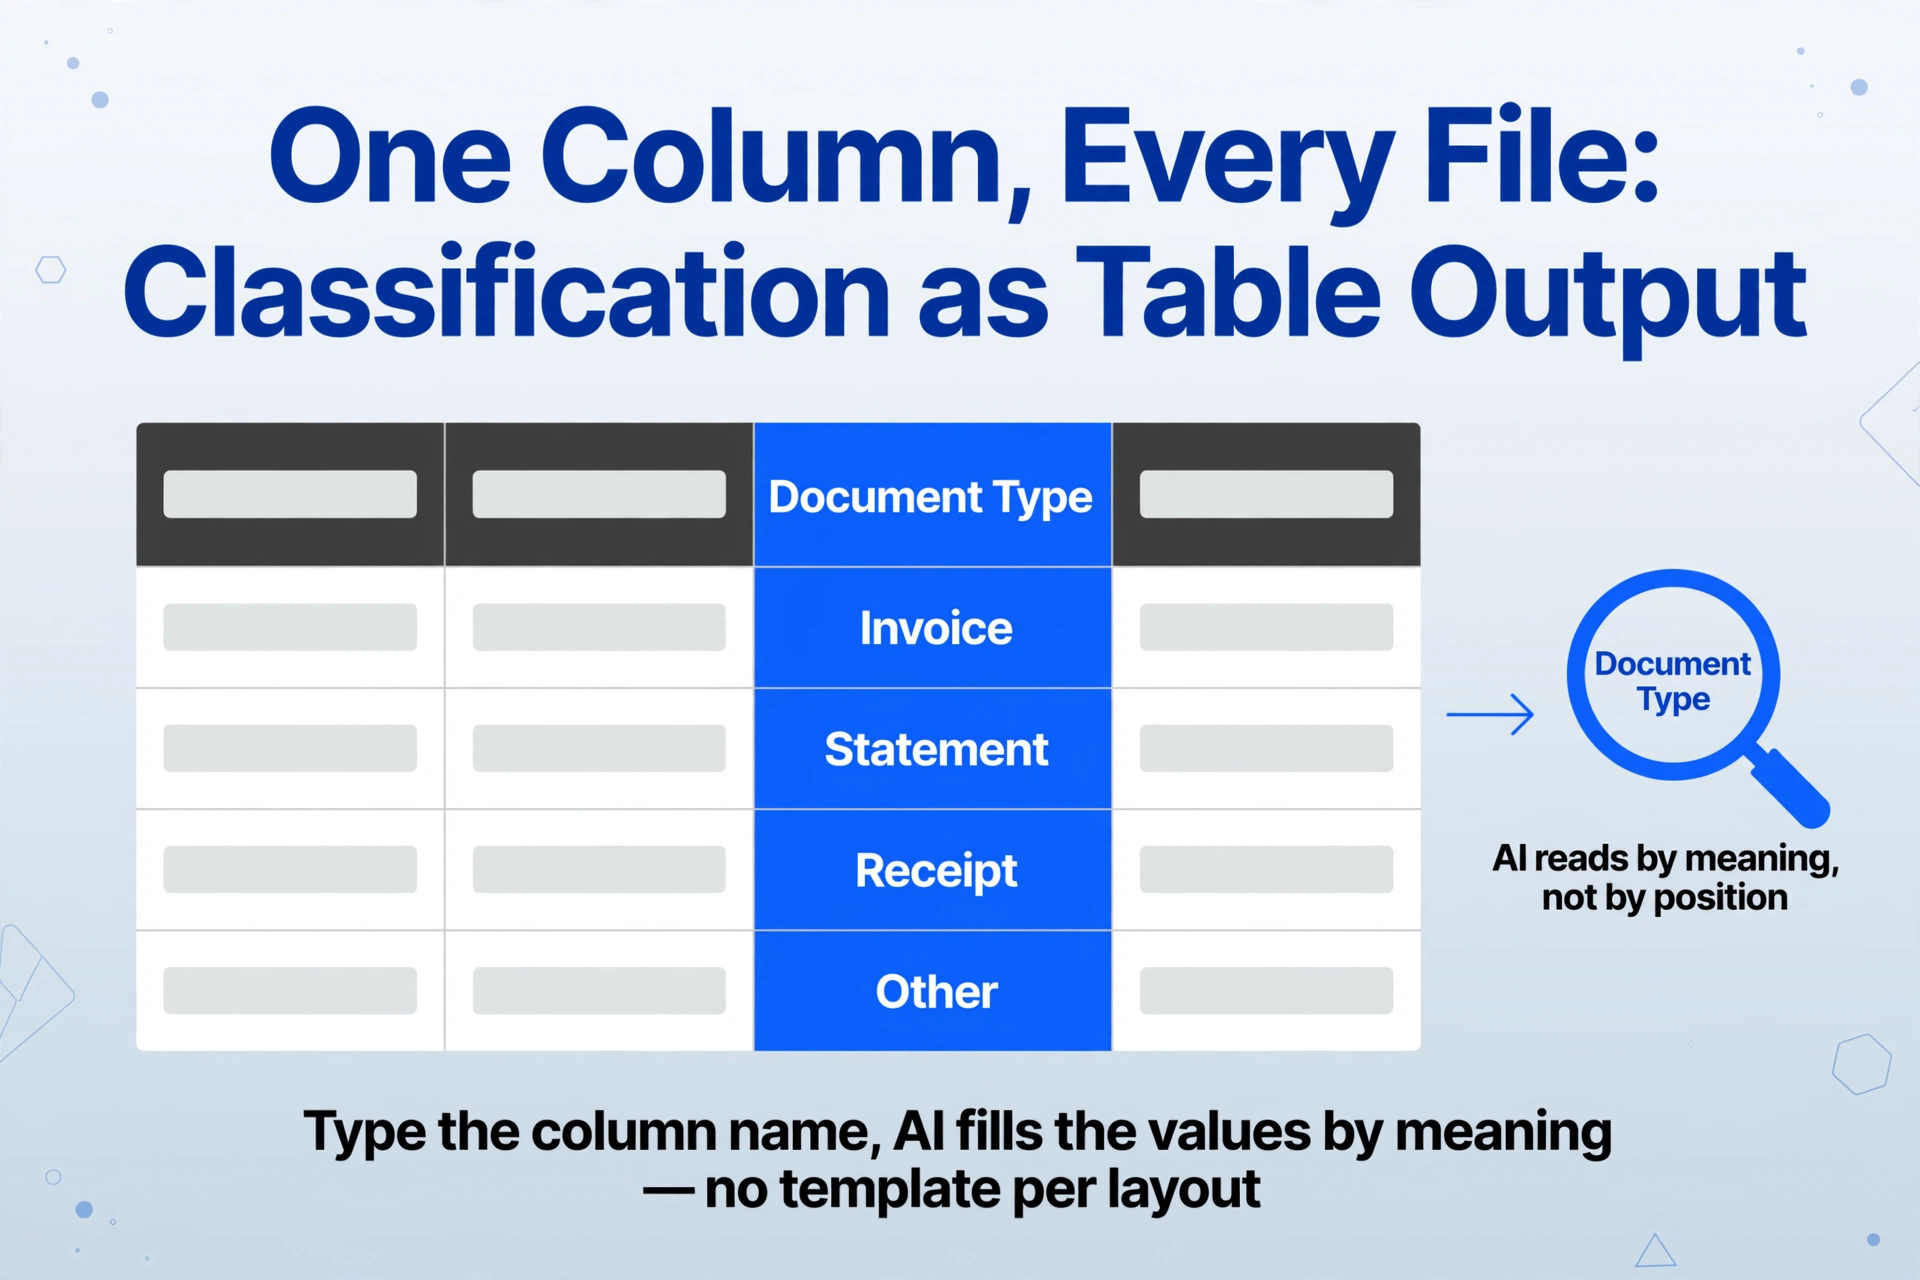
Der Mechanismus, der Klassifizierung in eine einfache Tabellenausgabe verwandelt, ist die Benutzerdefinierte Spaltenextraktion. Sie geben die gewünschten Spaltennamen ein, und die KI liest jedes Dokument und füllt die Werte nach Bedeutung, nicht nach Position auf der Seite. Dadurch kann ein Satz von Spaltennamen in demselben Upload für eine Rechnungs-PDF, einen fotografierten Beleg und einen Kontoauszug funktionieren, ohne Vorlage pro Layout. Der Modus, der hier zählt, ist die abgeleitete Spalte: eine Spalte, deren Wert nicht auf dem Dokument gedruckt ist, aber aus dem Inhalt des Dokuments entschieden werden kann. Keine Rechnung druckt die Worte „Ich bin eine Rechnung". Fügen Sie eine Spalte mit dem Namen „Dokumenttyp (Optionen: Rechnung / Kontoauszug / Beleg / Sonstiges)" hinzu, und die KI liest jede Datei und weist die Kategorie zu. Extraktion und Klassifizierung erfolgen im selben Durchlauf, über den gesamten Batch.
Dies kehrt die übliche Reihenfolge des Workflows um. Statt vor der Verarbeitung Dokumente zu klassifizieren und zu sortieren, wird zuerst verarbeitet und die Sortierung erscheint im Ergebnis. Die gemischte Sammlung wird als ein Batch hochgeladen. Das Ergebnis ist eine einzige Excel-Datei, in der jede Zeile ihren Dokumenttyp trägt. Filtert man die Tabelle auf „Rechnung“, ist der Stapel effektiv für einen sortiert worden – einmal, in einer Spalte, die jeder sehen und wiederverwenden kann, statt im Kopf einer einzelnen Person. Der Weg aus dem Engpass ist ein Filter, keine Zielverbindung.
Den gesamten gemischten Stapel in einem Upload ablegen
Rechnungen, Kontoauszüge, Belegfotos und Scans zusammen. Derselbe Spaltensatz funktioniert für jede Datei – das ist der Sinn von Verarbeitung beliebiger Dokumenttypen in einem Batch ohne Vorsortierung.
Die Klassifizierungsspalte benennen
„Dokumenttyp (Optionen: Rechnung / Kontoauszug / Beleg / Sonstiges)“ neben den Feldern eingeben, die tatsächlich extrahiert werden, wie Lieferant, Datum und Betrag. Die Kategorie wird durch das Lesen des Dokuments bestimmt, nicht durch eine Regel, die gepflegt werden muss.
Das Ergebnis filtern statt den Stapel zu sortieren
Die zusammengeführte Tabelle öffnen und nach Kategorie filtern. Grenzfälle werden kurz geprüft, bevor sie als sortiert gelten, und die Beurteilung liegt in einer Spalte, nicht bei der Person, die die Dateien geöffnet hat.
Bei wiederkehrenden Batches kann der Eingang denselben Ablauf ohne dediziertes Routing-Postfach speisen: E-Mails und Anhänge in eine E-Mail-Warteschlange weiterleiten (Weiterleitung von Rechnungen und Belegen in eine Verarbeitungswarteschlange) oder Dateien von Kunden über einen teilbaren Sammellink sammeln. Die Klassifizierungsspalte funktioniert unabhängig davon, wie eine Datei ankommt, auf dieselbe Weise. Und wenn der Stapel eine einmalige Bereinigung ist, passt eine Ad-hoc-Extraktion ganz ohne Workflow genauso gut.
Dateien werden sicher verarbeitet und nicht gespeichert.
Dieselbe Idee lässt sich mit einer Spalte „Dokumenttyp“ und einem gemischten Upload ausprobieren: ein Beleg, ein Kontoauszug, ein Angebot. Der Klassifizierungsschritt, den Routing-Plattformen als Plattformfunktion verkaufen, erscheint als Spalte in der Ausgabetabelle.
Die Steuersaison war der Ort, an dem dieser Mechanismus erstmals vollständig beschrieben wurde. Unser Walkthrough zur Steuerbeleg-Sortierung verwendet eine Klassifizierungsspalte, um Seiten, von denen eine Steuererklärung abhängt, von Seiten zu trennen, die nur für die Akte vorhanden sind. Die Entscheidung dort betrifft die Relevanz für eine bestimmte Steuererklärung. Die Entscheidung hier betrifft Typ und Ziel für einen gemischten Batch, und dieselbe Spalte übernimmt die Arbeit.
Was eine Klassifizierungsspalte nicht leisten kann
Eine Bezeichnungsspalte sortiert den Batch; sie verschiebt nichts. Sie wird keine Rechnung in QuickBooks übertragen oder einen Zapier-Workflow auslösen. Wenn verschiedene Dokumenttypen in verschiedenen Live-Systemen landen müssen, muss die Ziel-Ebene weiterhin aufgebaut werden. In diesem Fall wird die Tabelle zur Routing-Ebene: Die gefilterten Zeilen werden in das System exportiert, das den jeweiligen Dokumenttyp verwaltet, und die Personen, die sie genehmigen sollen, übernehmen die Übergabe von dort.
Sie wird auch keine einzelne PDF-Datei aufteilen, die mehrere Dokumente bündelt. Eine Datei mit fünf Rechnungen, die jeweils einen eigenen Datensatz und ein eigenes Ziel benötigen, erfordert Aufteilung und Routing – eine andere Frage als das Sortieren eines gemischten Ordners. Bei Batches mit einem Dokument pro Datei stellt sich die Frage der Aufteilung nicht.
Ermessensentscheidungen gibt es, meist zwischen ähnlichen Dokumenten: ein Kontoauszug, der auf den ersten Blick wie eine Rechnung aussieht, zwei Belege vom selben Anbieter. Die Prüfung gehört in einen manuellen Review-Schritt. Wenn man im Output über eine Zelle fährt, markiert das Tool genau, woher dieser Wert auf der Originalseite stammt, sodass ein unsicherer Dokumenttyp mit einem Klick gegen die Quelle verifiziert werden kann (wo der manuelle Review-Schritt in einem Extraktions-Workflow hingehört). Ein falsches Label schadet weniger, wenn das Label leicht zu prüfen ist.
FAQ
Was ist der Unterschied zwischen Dokumentklassifizierung und Dokument-Routing?
Die Klassifizierung legt fest, was ein Dokument ist: Rechnung, Kontoauszug, Beleg, Vertrag. Das Routing leitet es an den Workflow oder das System weiter, das es verarbeiten soll. Die Klassifizierung ist ein Schritt innerhalb des Routings, und eine Routing-Plattform klassifiziert zuerst und liefert dann aus.
Braucht man eine KI-Dokument-Routing-Software, wenn jedes Dokument in einer Tabelle landet?
Wenn nachgelagerte Prozesse nicht je nach Dokumenttyp unterschiedlich handeln, fügt die Ziel-Ebene Einrichtung ohne Sortiernutzen hinzu. Eine Klassifizierungsspalte deckt die Beurteilung ab, die tatsächlich Zeit kostet: zu entscheiden, was jedes Dokument ist.
Wie wird der Dokumenttyp ohne Vorlagen oder Training bestimmt?
Die KI liest das Dokument als Ganzes und gleicht seinen Inhalt mit den Kategorieoptionen im Spaltennamen ab. Sie arbeitet nach Bedeutung, daher erfordert ein neuer Anbieter oder ein neu gestaltetes Layout keine neue Vorlage – deshalb kann dieselbe Spalte Dokumente klassifizieren, die sie noch nie gesehen hat.
Was, wenn eine einzelne PDF mehrere verschiedene Dokumente enthält?
Das ist eine Trennungsaufgabe, getrennt von der Klassifizierung. Dateien, die mehrere Dokumente bündeln, müssen aufgeteilt werden, bevor jeder Teil einzeln behandelt werden kann. Batches mit einem Dokument pro Datei sind nicht betroffen.
Wie lässt sich überprüfen, ob das richtige Label vergeben wurde?
Der Prüfmodus hebt den Quellbereich im Originaldokument für jede angeklickte Zelle hervor, einschließlich der Zelle für den Dokumenttyp. Stichproben bei den Grenzfällen genügen, statt den ganzen Stapel zu lesen, und der Batch ist in Minuten verifiziert.
Der teure Teil des Dokument-Routings ist selten der Übertragungsschritt. Es ist die Beurteilung „Was ist das?“, hundertmal wiederholt von der Person, die die Dateien öffnet, ohne Aufzeichnung der Antwort. Eine Klassifizierungsspalte hält diese Beurteilung einmal pro Zeile und Batch fest und gibt sie als etwas zurück, das man filtern, prüfen und nutzen kann. Man lege den nächsten gemischten Batch in einem Upload hoch und sehe, wie schnell der Sortier- und Weiterleitungsschritt keine Person mehr braucht.