El enrutamiento de documentos con IA se reduce
a la clasificación de documentos
La pregunta que encabeza todo flujo de trabajo documental parece un problema de enrutamiento: ¿en qué cola debe entrar este archivo, qué sistema debe recibir sus datos, qué persona debe revisarlo a continuación? Las plataformas que venden "enrutamiento de documentos con IA" incluyen la respuesta completa: un clasificador que indica qué es un documento, un divisor para archivos que contienen varios documentos y conectores de destino que envían los resultados a QuickBooks, Xero o una API. Para los equipos que procesan lotes mixtos de facturas, estados de cuenta y recibos en una sola hoja de cálculo o libro mayor, la mayor parte de esa maquinaria es irrelevante. La parte que realmente hace la clasificación, decidir qué es cada documento, cabe en una sola columna de la salida del lote, sin flujos de trabajo que configurar ni nada que mantener.
Conclusiones clave
- El enrutamiento de documentos con IA combina tres tareas en un solo producto: clasificar un documento, dividir PDF que contienen varios documentos y enviar los resultados a QuickBooks, Xero o una API.
- Si cada archivo de su lote termina en la misma hoja de cálculo, el divisor y los conectores de destino no tienen nada que hacer, por lo que paga una configuración por una capa de entrega que nunca entrega.
- La parte que realmente ordena el montón es una columna: asígnele el nombre "Tipo de documento" y la IA leerá cada archivo por significado y completará Factura, Estado de cuenta, Recibo u Otro.
Dos decisiones se esconden en "¿A dónde va?"
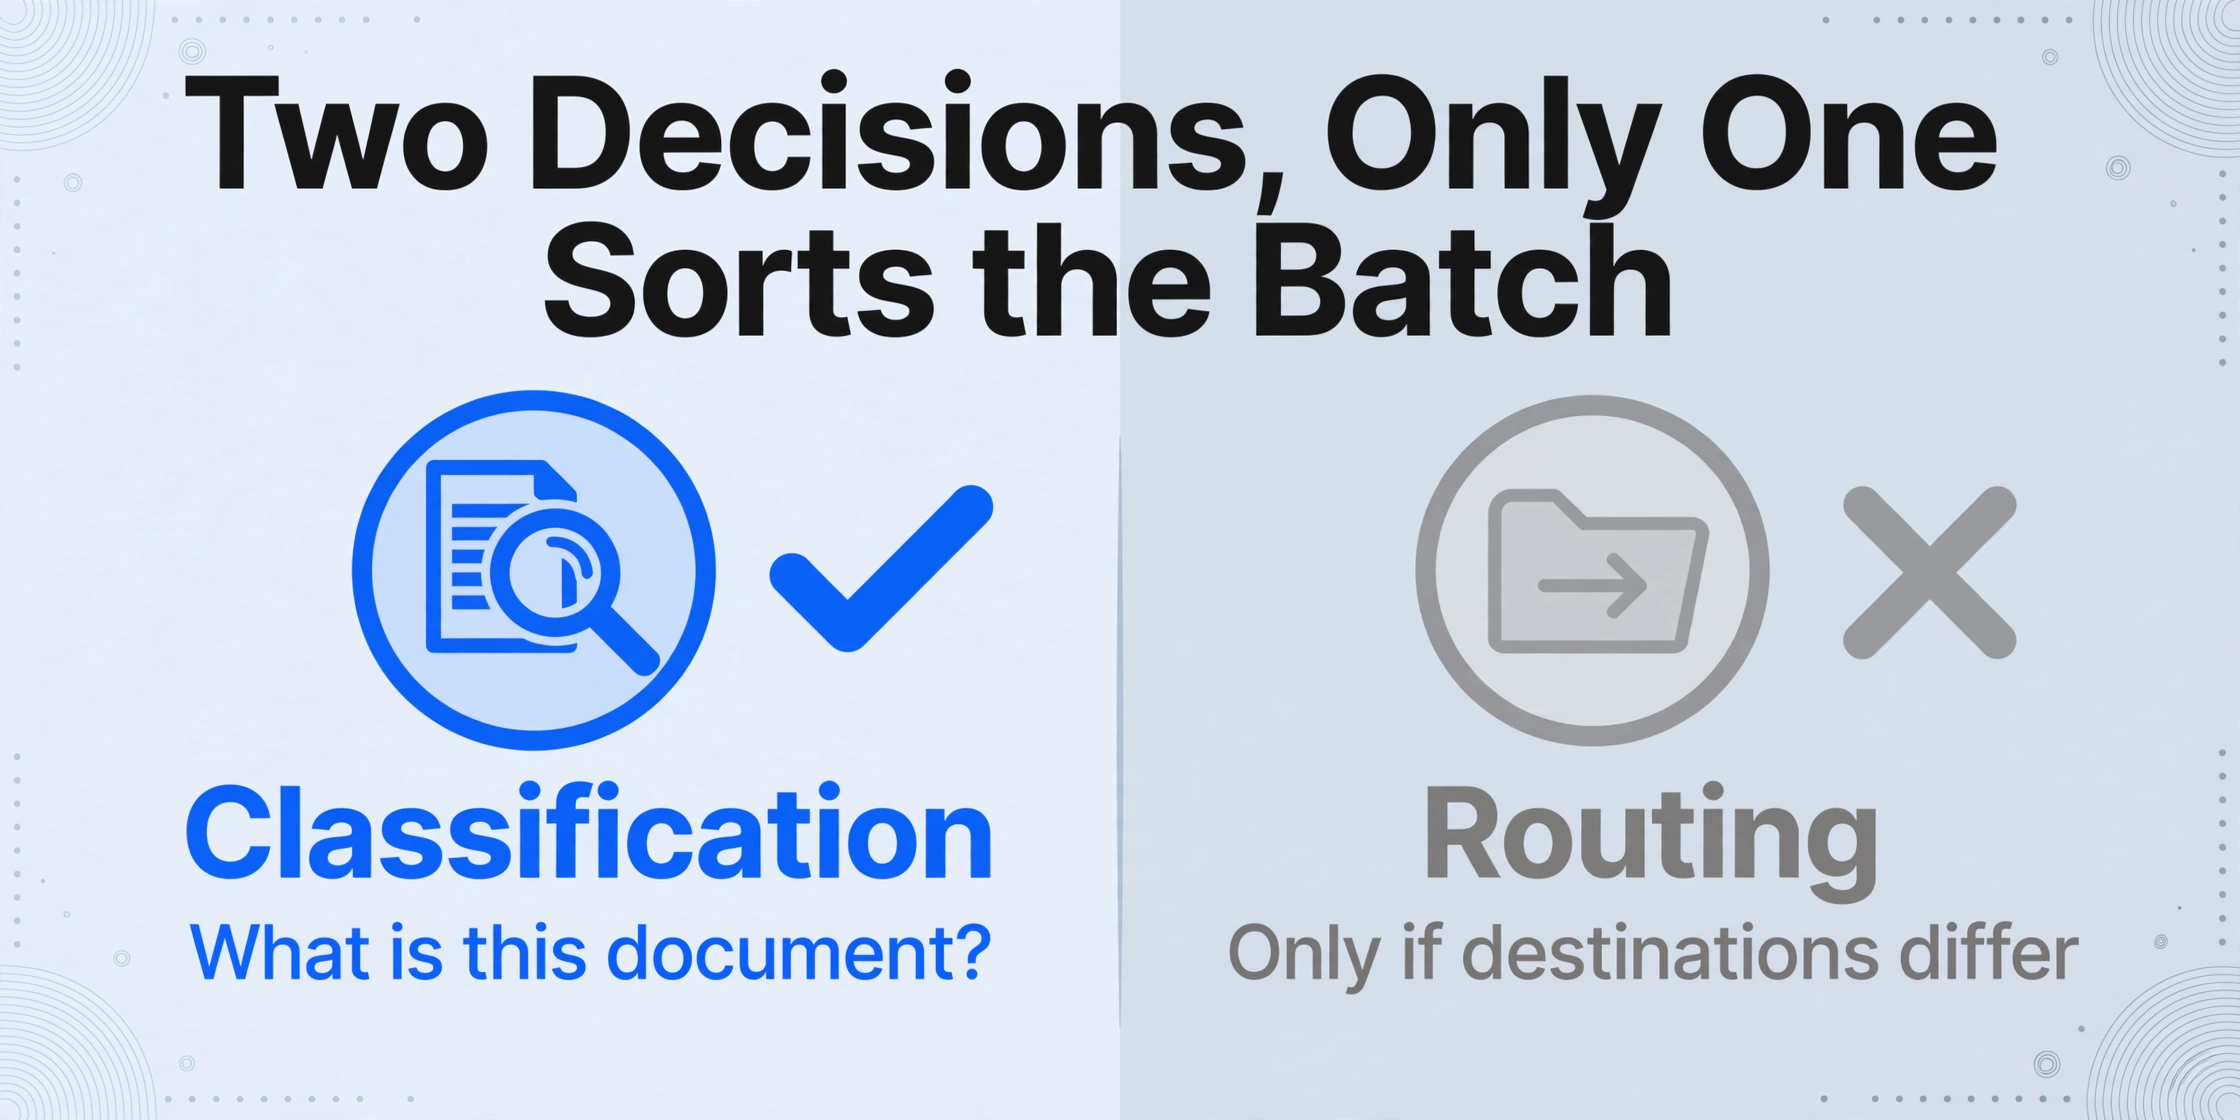
La clasificación de documentos y el enrutamiento de documentos son dos decisiones diferentes que normalmente se venden como un solo producto. La clasificación responde "¿qué es este documento?": una factura, un estado de cuenta bancario, un recibo, un albarán. El enrutamiento responde "¿a dónde va?": qué analizador lo lee, qué sistema recibe los datos, qué persona lo aprueba. Las definiciones de la industria ponen la clasificación primero. AIIM, la asociación para la gestión inteligente de la información, describe el procesamiento inteligente de documentos como algo que comienza clasificando los documentos por contenido y estructura, antes de que ocurran la extracción y la validación (AIIM). Sin la etiqueta de clasificación, una plataforma de enrutamiento no tiene nada sobre lo que enrutar.
La versión manual del flujo es fácil de recorrer, porque la mayoría de los equipos la han vivido. Los documentos llegan a través de una bandeja de entrada, una carpeta compartida, un escáner o una dirección de correo reenviada. Alguien abre cada archivo para ver qué es. Esa misma persona decide a dónde debe ir, y luego el documento se procesa: una factura se ingresa y se archiva para aprobación, un recibo se codifica en una categoría de gastos, un estado de cuenta se concilia línea por línea. La persona en el medio es el clasificador. Un asistente de cuentas por pagar abre cada factura de cuarenta proveedores. Un tenedor de libros ordena los recibos de los clientes por mes y tipo. Un coordinador de operaciones separa los albaranes de las etiquetas de devolución. Todos ejecutan el mismo paso: leer el documento, decidir qué es, actuar según la respuesta.
La clasificación manual falla por volumen, no por complejidad
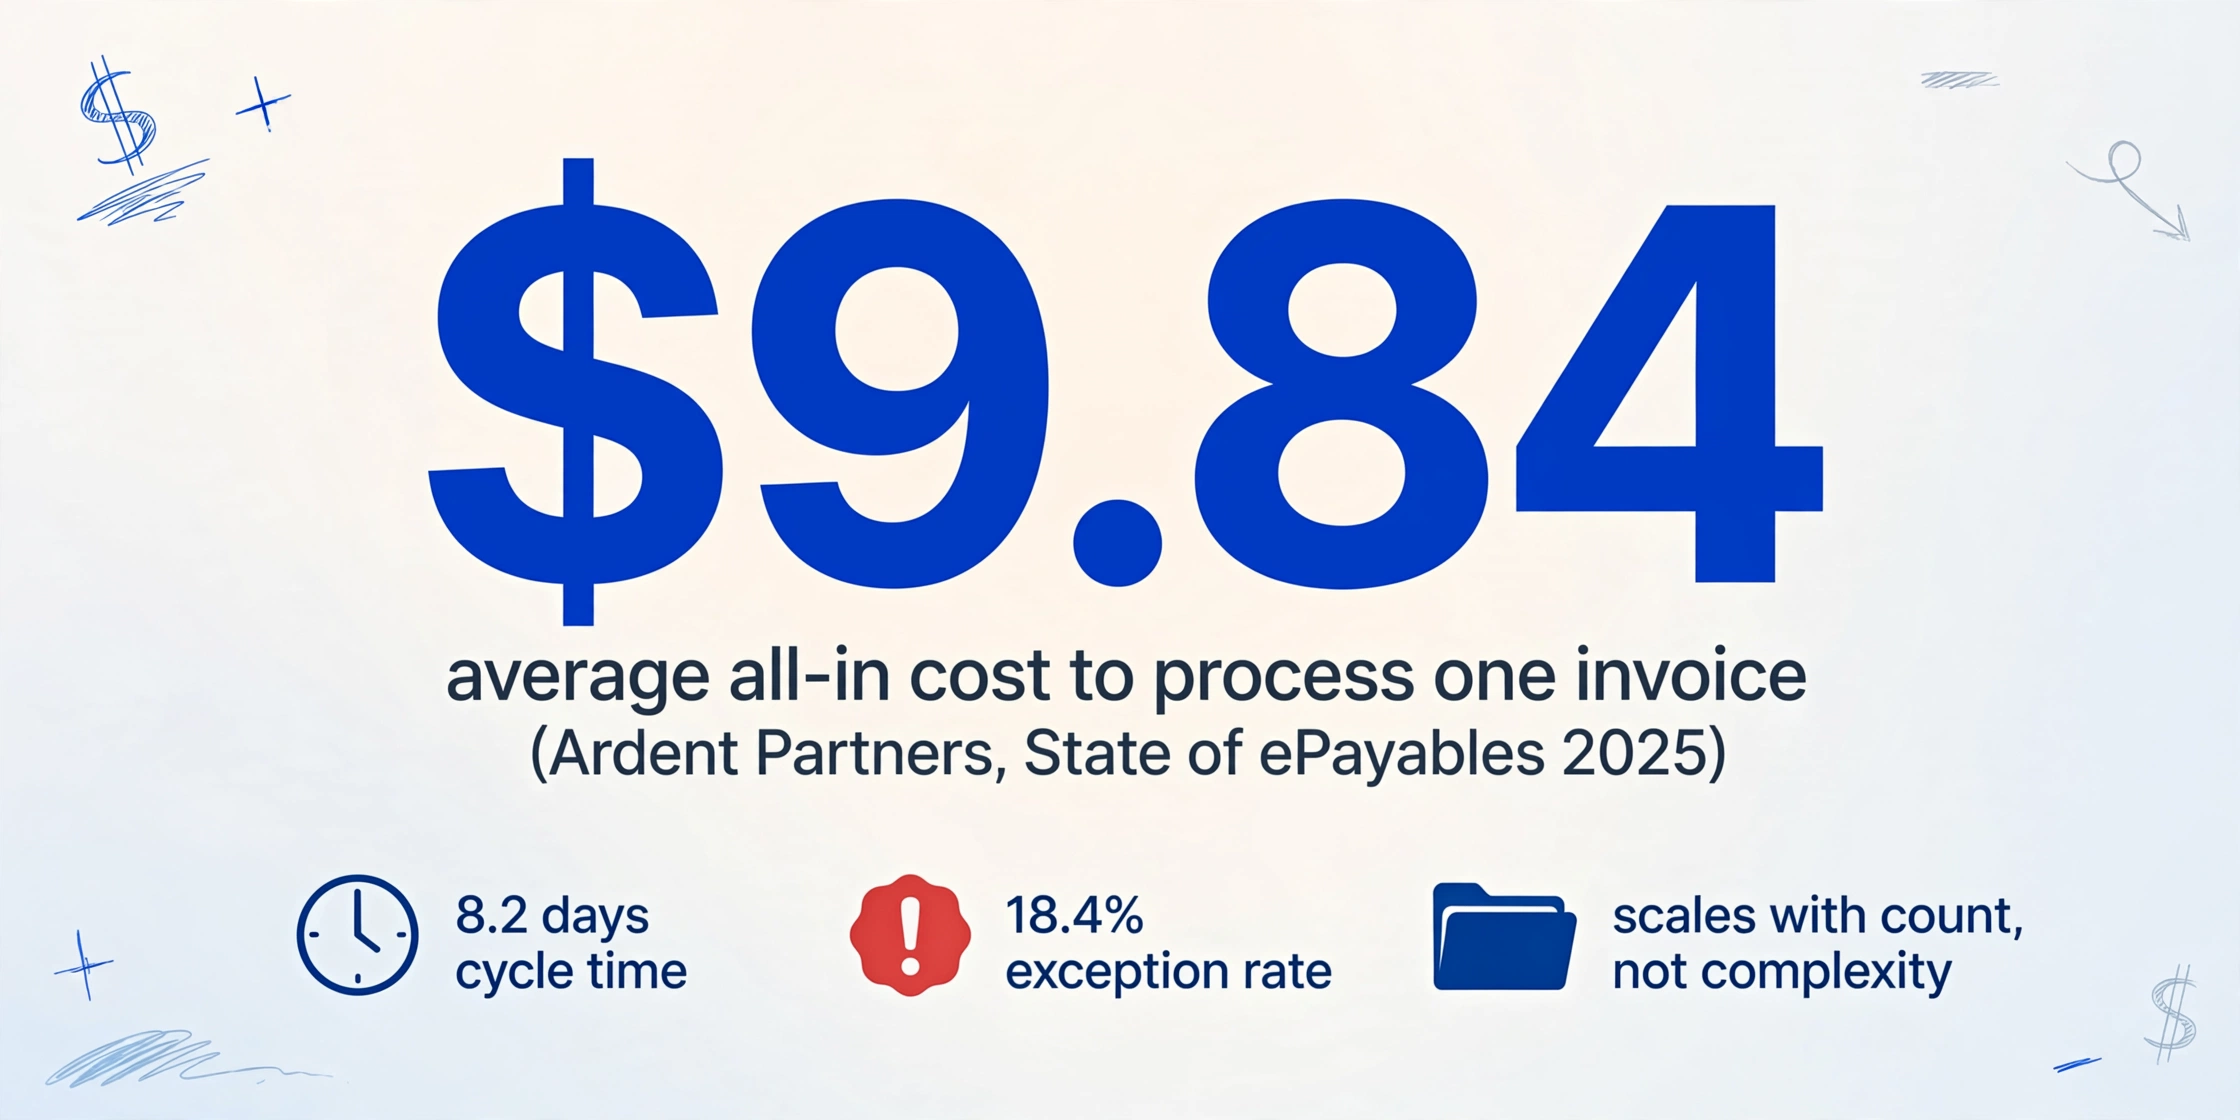
La clasificación manual no es una tarea difícil, y es precisamente por eso que se sigue haciendo a mano en un volumen donde ya no tiene sentido. El paso de clasificación rara vez aparece en los puntos de referencia de costos, pero está incluido en ellos. El informe State of ePayables 2025 de Ardent Partners sitúa el costo promedio integral de procesar una sola factura en $9.84, con un tiempo de ciclo promedio de 8.2 días y una tasa de excepción del 18.4 por ciento (State of ePayables 2025). Recibir, abrir, clasificar y reenviar son las tareas manuales que se incluyen en esa cifra, y escalan con el número de documentos, no con lo complicado que sea cada uno.
Los errores a gran volumen provienen de la velocidad, no de la dificultad. Un profesional describió a una colega de finanzas que dedicaba aproximadamente una hora a la semana a arrastrar PDFs a las carpetas correctas para el preparador de impuestos, y los archivos terminaban en el lugar equivocado cada vez que tenía prisa. La pregunta que devolvió el preparador fue directa: "¿por qué hay una factura de hotel en la carpeta de médicos?" (r/VibeCodersNest). No hay nada difícil de entender en clasificar una factura de hotel. Lo difícil es hacerlo de forma consistente cien veces seguidas.
La clasificación basada en reglas falla en la dirección opuesta: es consistente hasta que llega una entrada nueva. Un equipo de logística que procesaba de 500 a 1,000 documentos al día comenzó con reglas regex que funcionaron con cinco proveedores y se desmoronaron silenciosamente al llegar a cincuenta, porque cada nuevo formato de proveedor implicaba reescribir las reglas (r/dataengineering). La misma fragilidad que hace dolorosa la extracción basada en plantillas se aplica a la clasificación basada en posición, y por la misma razón: codifica este proveedor, este formato, esta página.
El patrón se repite en todos los equipos. Un hilo de finanzas sobre automatización de cuentas por pagar lo resumió así: "Muchos equipos compran el paso de escaneo, pero luego terminan persiguiendo facturas en el correo electrónico porque el componente de enrutamiento nunca se resolvió primero" (r/automation). El paso de clasificación también tiene una dimensión de cumplimiento, no solo de conveniencia. Las pautas de conservación de registros del IRS esperan que los documentos de respaldo estén organizados por año y por tipo de ingreso o gasto, y que los sistemas de almacenamiento electrónico permanezcan indexados y recuperables en forma legible (pautas de conservación de registros del IRS). Un documento que no está clasificado es un documento que no se puede encontrar cuando alguien lo solicita.
Para un lote mixto que termina en una sola hoja de cálculo, la decisión de destino ya está tomada. La única decisión manual restante es la etiqueta: ¿qué es este documento? Eso es una tarea de clasificación, no de enrutamiento.
Cuándo el Enrutamiento de Destino Realmente Justifica la Configuración
Las plataformas de enrutamiento valen la pena cuando los tipos de documento alimentan diferentes acciones posteriores. Una factura debe entrar en una cola de aprobación y pagarse a través de un sistema contable; un estado de cuenta bancario alimenta la conciliación; un contrato requiere revisión legal. Cuando los sistemas de destino tienen esquemas diferentes y propietarios diferentes, la capa de entrega aporta valor real. Los equipos en esa posición suelen usar pilas especializadas, las mismas que aparecen en los foros de profesionales: plataformas de AP como Bill, Tipalti, Rossum o Dext para flujos de facturas, y herramientas de flujo de trabajo más ligeras como n8n, Unstract o Docsumo para la capa intermedia. Esas herramientas existen porque los documentos no comparten nada aguas abajo.
Las plataformas de enrutamiento también dividen PDFs de varios documentos, separando un archivo escaneado que contiene cinco facturas en cinco documentos, antes de enrutar cada parte a su propio analizador. La división es una capacidad separada de la clasificación, y es importante siempre que la unidad que llega desordenada es el archivo en sí.
El caso contrario es igual de real. Cuando cada archivo del lote termina en el mismo destino, el enrutamiento es costo de configuración sin valor de clasificación. Nada aguas abajo actúa de manera diferente según el tipo de documento: no hay flujo de aprobación que activar, no hay un segundo sistema esperando filas. El equipo necesita la etiqueta, rápida y consistente, aplicada a cientos de archivos, y nada más. La mayoría de los equipos financieros pequeños y medianos que reciben lotes mixtos por correo electrónico están aquí. Todo termina en la hoja de cálculo.
Convierte la Clasificación en una Columna y Omite la Configuración de Enrutamiento
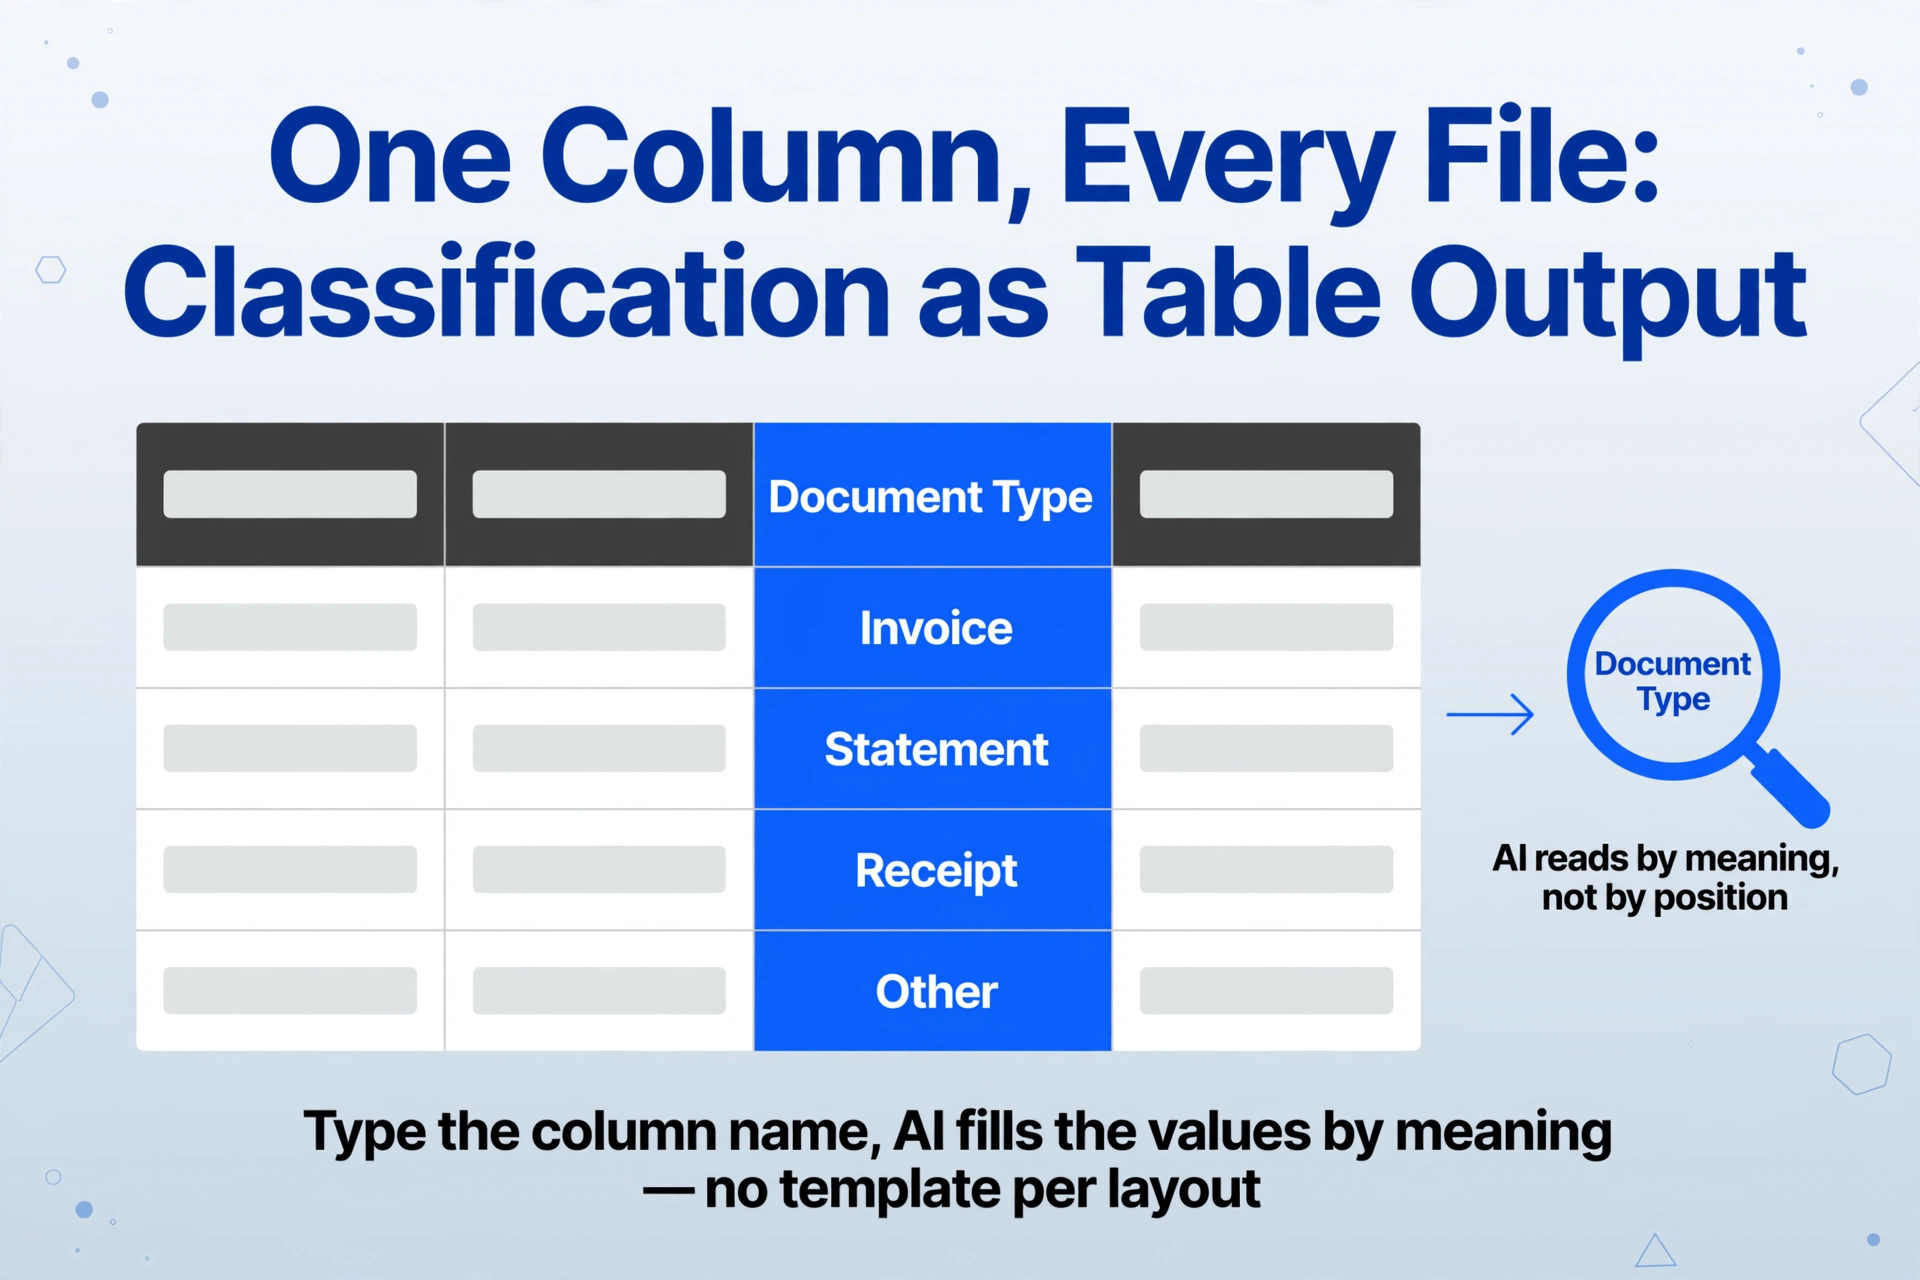
El mecanismo que convierte la clasificación en salida de tabla simple es la Extracción de Columnas Personalizadas. Escribes los nombres de las columnas que quieres, y la IA lee cada documento y completa los valores por significado, no por posición en la página. Eso es lo que permite que un mismo conjunto de nombres de columna funcione en un PDF de factura, un recibo fotografiado y un estado de cuenta bancario en la misma carga, sin plantilla por diseño. El modo que importa aquí es la columna inferida: una columna cuyo valor no está impreso en ningún lugar del documento pero puede decidirse a partir de lo que contiene el documento. Ninguna factura imprime las palabras "soy una factura". Añade una columna llamada "Tipo de documento (opciones: Factura / Estado de cuenta / Recibo / Otro)", y la IA lee cada archivo y asigna la categoría. La extracción y la clasificación ocurren en la misma pasada, en todo el lote.
Esto invierte el orden habitual del flujo de trabajo. En lugar de detenerse a clasificar y ordenar los documentos antes de procesarlos, usted procesa primero y la clasificación aparece en el resultado. Suba la carpeta mixta como un solo lote. El resultado es un único archivo de Excel donde cada fila lleva su tipo de documento. Filtre la hoja de cálculo por "Factura" y el montón quedará ordenado de forma efectiva, una sola vez, en una columna que todos pueden ver y reutilizar, en lugar de depender de la memoria de una sola persona. La salida del cuello de botella es un filtro, no una conexión de destino.
Sube todo el montón mixto en una sola carga
Facturas, estados de cuenta, fotos de recibos y escaneos juntos. El mismo conjunto de columnas funciona en todos los archivos, que es el objetivo de procesar cualquier tipo de documento en un solo lote sin clasificación previa.
Nombre la columna de clasificación
Escriba "Tipo de documento (opciones: Factura / Estado de cuenta / Recibo / Otro)" junto a los campos que realmente extrae, como Proveedor, Fecha y Monto. La categoría se decide leyendo el documento, no mediante una regla que usted deba mantener.
Filtre el resultado en lugar de ordenar el montón
Abra la tabla fusionada y filtre por categoría. Las filas dudosas reciben una revisión rápida antes de considerarse ordenadas, y el criterio vive en una columna, no en quien abrió los archivos.
Para lotes recurrentes, la entrada puede alimentar el mismo flujo sin una bandeja de enrutamiento dedicada: reenvíe el correo y los archivos adjuntos a una cola de correo electrónico (reenviar facturas y recibos a una cola de procesamiento), o recopile archivos de los clientes mediante un enlace de recopilación compartible. La columna de clasificación se aplica de la misma manera sin importar cómo llegue un archivo. Y si el montón es una limpieza puntual, una extracción ad hoc sin ningún flujo de trabajo también encaja perfectamente.
Los archivos se procesan de forma segura y no se almacenan.
Pruebe la misma idea con una columna de "Tipo de documento" y una carga mixta: un recibo, un estado de cuenta, una cotización. El paso de clasificación que las plataformas de enrutamiento venden como una función de plataforma vuelve como una columna en su tabla de salida.
La temporada de impuestos es donde este mecanismo tuvo su primera descripción completa. Nuestro recorrido de clasificación de documentos fuente de impuestos usa una columna de clasificación para separar las páginas de las que depende una declaración de las que solo están ahí para el archivo. La decisión allí es la relevancia para una declaración específica. La decisión aquí es el tipo y el destino de un lote mixto, y la misma columna hace el trabajo.
Lo que una columna de clasificación no puede hacer
Una columna de etiquetas ordena el lote; no mueve nada. No insertará una factura en QuickBooks ni activará un flujo de trabajo de Zapier. Si los distintos tipos de documento deben llegar a distintos sistemas en vivo, la capa de destino aún debe construirse. En ese caso, la hoja de cálculo se convierte en la capa de enrutamiento: exporte las filas filtradas al sistema que sea dueño de ese tipo de documento, y las personas que deban aprobarlas gestionan la entrega desde allí.
Tampoco dividirá un solo PDF que agrupe varios documentos. Un archivo que contenga cinco facturas, cada una con su propio registro y su propio destino, requiere división y enrutamiento, lo cual es una cuestión distinta de ordenar una carpeta mixta. Para lotes de un documento por archivo, la división nunca surge.
Existen criterios de juicio, sobre todo entre documentos similares: un estado de cuenta que parece una factura a simple vista, dos recibos del mismo proveedor. La verificación corresponde a una revisión humana. Pase el cursor sobre cualquier celda de la salida y la herramienta resalta exactamente de dónde proviene ese valor en la página original, de modo que un tipo de documento del que no esté seguro se verifica contra la fuente con un clic (dónde corresponde el paso de revisión humana en un flujo de extracción). Una etiqueta incorrecta duele menos cuando es barata de verificar.
Preguntas frecuentes
¿Cuál es la diferencia entre la clasificación de documentos y el enrutamiento de documentos?
La clasificación etiqueta qué es un documento: factura, estado de cuenta, recibo, contrato. El enrutamiento lo mueve al flujo de trabajo o sistema que debe gestionarlo. La clasificación es un paso dentro del enrutamiento, y una plataforma de enrutamiento clasifica primero y entrega después.
¿Necesito software de enrutamiento de documentos con IA si todos los documentos terminan en una hoja de cálculo?
Si nada aguas abajo actúa de manera diferente según el tipo de documento, la capa de destino añade configuración sin añadir valor de ordenación. Una columna de clasificación cubre el juicio que realmente toma tiempo: decidir qué es cada documento.
¿Cómo se decide el tipo de documento sin plantillas ni entrenamiento?
La IA lee el documento en su totalidad y compara su contenido con las opciones de categoría en el nombre de la columna. Funciona por significado, por lo que un nuevo proveedor o un diseño rediseñado no requiere una nueva plantilla, razón por la cual la misma columna puede clasificar documentos que nunca ha visto.
¿Qué sucede si un solo PDF contiene varios documentos diferentes?
Eso es una tarea de división, separada de la clasificación. Los archivos que agrupan múltiples documentos deben separarse antes de que cada parte pueda tratarse por sí sola. Los lotes de un documento por archivo no se ven afectados.
¿Cómo verifico que se asignó la etiqueta correcta?
El modo de revisión resalta la región de origen en el documento original para cualquier celda en la que haga clic, incluida la celda de tipo de documento. Verifique los archivos límite en lugar de leer todo el montón, y el lote se verifica en minutos.
La parte costosa del enrutamiento de documentos rara vez es el salto de entrega. Es el juicio, "¿qué es esto?", repetido cien veces por quien abre los archivos, sin registro de la respuesta. Una columna de clasificación registra ese juicio una vez por fila, por lote, y lo devuelve como algo que puede filtrar, auditar y sobre lo que puede actuar. Envíe su próximo lote mixto mediante una sola carga y vea qué tan rápido el paso de ordenar y reenviar deja de necesitar a una persona.