E-mails de prospects immobiliers vers le CRM
sans ressaisie
Harvard Business Review a audité 2 241 entreprises en 2011 et a constaté que seulement 37 % répondaient à un nouveau lead web dans l'heure, que 23 % ne répondaient jamais du tout, et que le délai moyen de réponse parmi ceux qui répondaient était de 42 heures. Cet écart entre l'arrivée d'un lead et le moment où quelqu'un le traite réellement est l'endroit où meurent la plupart des opportunités immobilières.
Le profil 2025 des acheteurs et vendeurs de la National Association of Realtors ajoute la partie que la plupart des agents ressentent déjà : 67 % des primo-accédants et 76 % des acheteurs récurrents n'ont interviewé qu'un seul agent avant de choisir. Le premier agent qui contacte un acheteur prêt, eh bien, obtient généralement l'affaire. Ce qui rend l'étape sans gloire entre la boîte de réception et le CRM, la partie où le nom, le numéro de téléphone et la question d'un lead sont saisis manuellement dans une fiche contact, le goulot d'étranglement le moins défendu de tout le pipeline.
Points clés à retenir
- L'entreprise moyenne mettait 42 heures à répondre à un nouveau lead web, et 23 % ne répondaient jamais du tout, c'est là que la plupart des transactions immobilières meurent silencieusement.
- Les 20 minutes de ressaisie par lead représentent l'endroit où ce délai se situe réellement, pas du tout du temps de réflexion, et aucun modèle n'y survit car chaque portail, fournisseur IDX et feuille manuscrite formate ses champs différemment.
- Définissez les sept colonnes de contact une fois, et l'IA retrouve ces valeurs dans les alertes de portail, les formulaires IDX et l'écriture manuscrite d'open house, afin que les trois sources de leads aboutissent dans un seul CSV que votre CRM importe déjà.
Les leads immobiliers n'arrivent pas sous forme de fiches contact
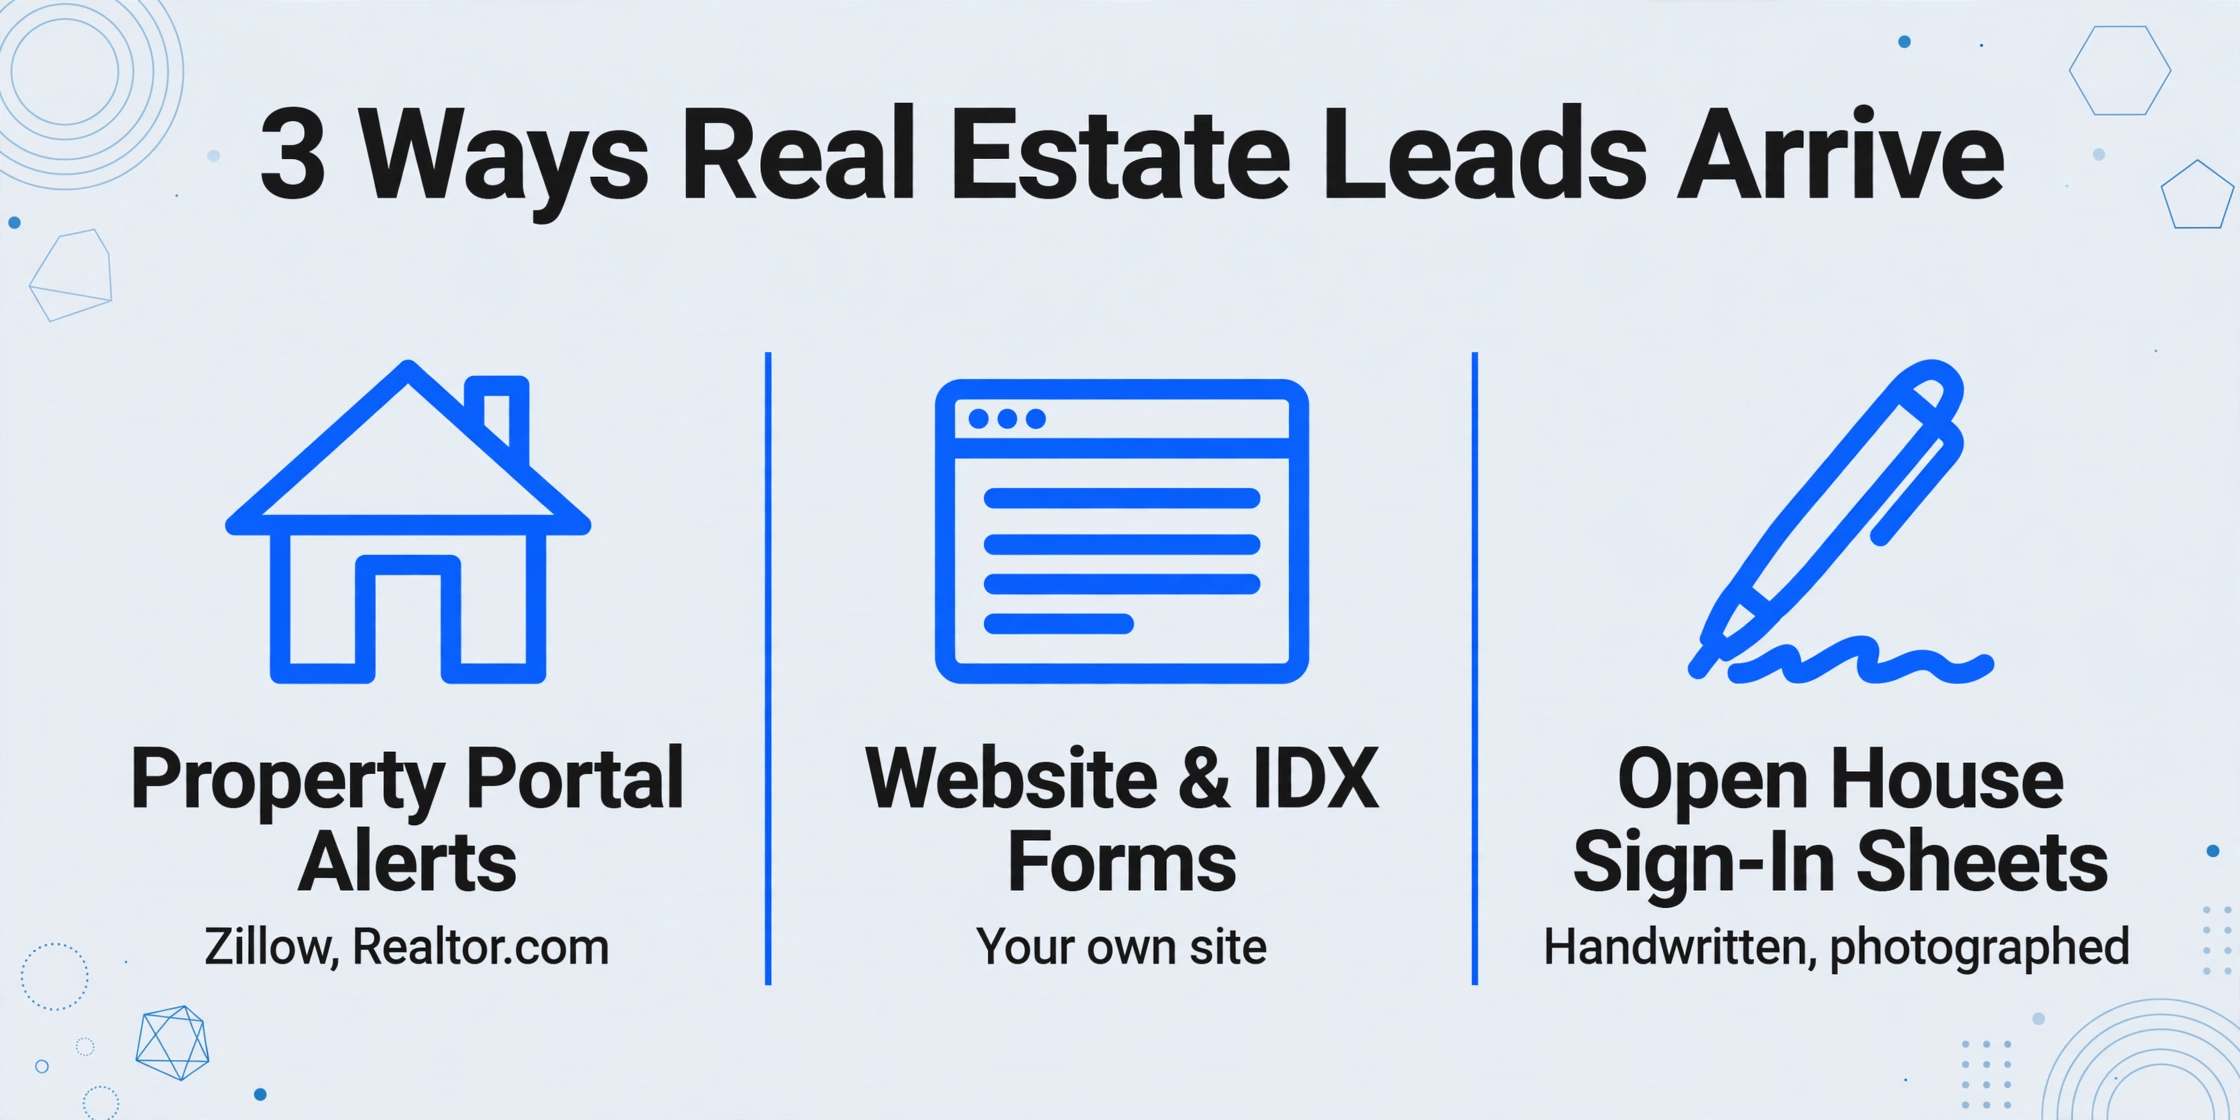
Avant qu'une discussion sur l'automatisation ait un sens, il est utile d'examiner les matières premières. Un « lead » en immobilier n'est pas une ligne de tableur qui n'attend qu'à être ouverte. Il arrive sous l'une de trois formes, et chaque forme demande un degré d'effort différent pour devenir un contact CRM :
Alertes des portails immobiliers. L'acheteur remplit un formulaire de demande sur Zillow, Realtor.com ou Trulia, et le portail vous envoie par e-mail une notification avec le nom, le numéro de téléphone, l'adresse e-mail de l'acheteur et le bien sur lequel il s'est renseigné. Propre, mais cela reste un texte dans un e-mail. Si vous utilisez le système de leads du portail lui-même, les données sont déjà structurées côté portail, et le problème devient de les extraire du portail.
Notifications de formulaires du site et IDX. La demande passe par les formulaires de votre propre site, généralement l'outil de recherche IDX qui permet aux acheteurs de parcourir les biens. La notification par e-mail arrive dans la boîte de réception que votre équipe consulte réellement, souvent un compte d'équipe partagé ou la boîte personnelle de l'administrateur. Le format varie d'un fournisseur IDX à l'autre, et les champs changent selon les fournisseurs.
Feuilles de présence d'open house. Les leads les plus engagés de la semaine, des personnes qui ont physiquement visité un bien, écrites à la main sur une feuille de papier, photographiées avec un téléphone et envoyées par e-mail à l'administrateur le lendemain matin. Chaque open house dans le pays produit les mêmes conséquences : une page d'écriture manuscrite qui doit être lue, déchiffrée et ressaisie avant de devenir un contact.
Le rapport NAR 2025 remet cette dernière source en perspective : 43 % des acheteurs ont jugé les open houses comme une source d'information très utile pendant leur recherche. Les visiteurs qui ont parcouru votre bien ne sont ni extractibles, ni adossés à une API, ni saisis. Ce sont les leads immobiliers les moins chers que la plupart des agents obtiennent, et aussi les plus susceptibles de ne jamais arriver dans le CRM, parce que personne ne ressaisit de l'écriture manuscrite à 23 h.
Le transfert où le temps de réponse meurt réellement
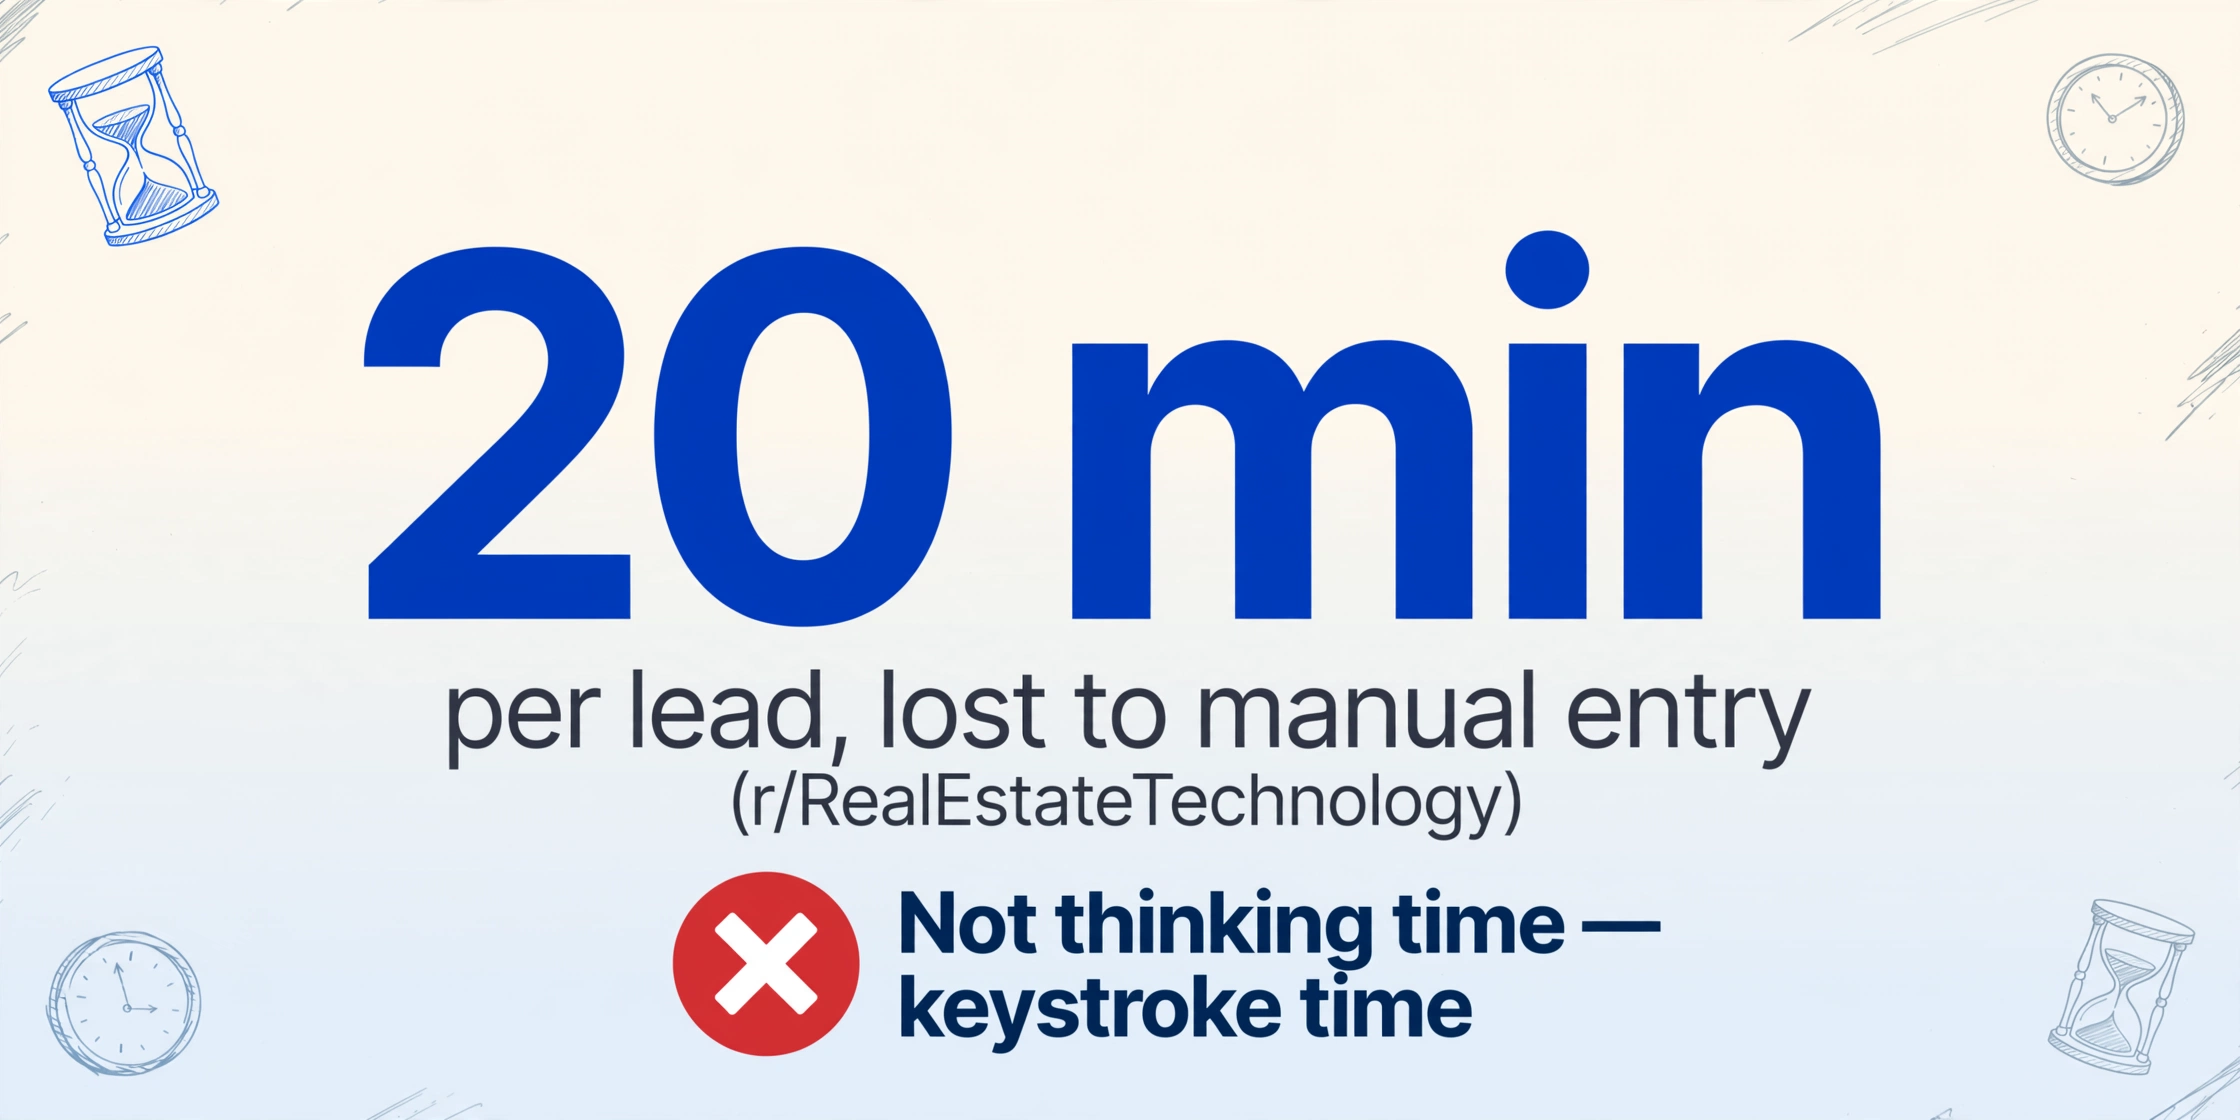
L'étude HBR a mesuré le temps entre « lead soumis » et « réponse de l'entreprise ». Dans l'immobilier, cet intervalle est rarement consacré à décider quoi dire. Il est consacré à la saisie de données entre l'e-mail entrant et l'enregistrement CRM.
Les agents décrivent l'étape simplement. Un affichiste axé sur l'acquisition dans r/RealEstateTechnology a écrit qu'il gardait deux assistants virtuels pour la rapidité de réponse et le suivi, « dépensant près de 2 200 $ par mois, tout compris », et la prise de conscience qui l'a brisé a été de tirer les chiffres et de constater que 68 % des transactions conclues provenaient de leads de plus de 45 jours. Un autre fil sur la saisie de données CRM a chiffré le coût par lead à « 20 minutes perdues par lead » rien que pour la saisie manuelle. Dans r/automation, quelqu'un qui a construit un pipeline de leads pour un courtage a décrit l'état pré-automatisation comme « copier-coller les données de leads des portails dans des feuilles de calcul », quatre heures par jour, réduites à 15 minutes de révision.
Le schéma est le même dans chaque compte : le délai n'est pas du temps de réflexion, c'est du temps de frappe. Un administrateur qui ouvre une alerte de portail à 9 h, copie le nom et le numéro de téléphone dans le CRM, définit une tâche de suivi et répète la séquence douze fois n'a répondu à aucun acheteur à midi. Une équipe où cette étape s'exécute seule répond aux mêmes acheteurs pendant que l'administrateur dort. En d'autres termes, le chemin d'un e-mail de lead immobilier au contact CRM passe actuellement par la saisie manuelle de données, et c'est exactement ce segment que cet article vise à raccourcir.
Il y a aussi un deuxième coût qui n'apparaît jamais dans les études de temps de réponse : les leads qui ne sont jamais saisis du tout. Un chiffre mal lu sur une feuille de présence manuscrite, une adresse e-mail avec une lettre de travers, une feuille qui finit dans un tiroir parce que personne n'a trente minutes pour la transcrire. Ce ne sont pas des réponses lentes, ce sont des non-réponses, et les visiteurs d'open house en particulier les acceptent. La conséquence médiane, de r/Real_Estate, est familière : « Le lead arrive, est enregistré sur WhatsApp. Le suivi se fait via WhatsApp. La transaction se conclut et l'agent s'en souvient. »
Pourquoi l'analyse de leads basée sur des modèles échoue sans cesse
La plupart des outils conçus pour ce problème précis, les parseurs d'e-mails qui créent des contacts CRM, utilisent des modèles. La promesse semble parfaite : le parseur surveille la boîte de réception, fait correspondre l'e-mail entrant à une mise en page prédéfinie, extrait les champs de leurs positions fixes et pousse le contact vers le CRM automatiquement.
Les modèles fonctionnent lorsque le format d'entrée est garanti. Les alertes de portail s'en rapprochent, mais uniquement pour une version spécifique de portail à la fois. La réalité de la réception de leads est que le format est l'élément le moins fiable :
Chaque portail et chaque fournisseur IDX produit une mise en page d'e-mail différente. La structure d'alerte de Zillow n'est pas celle de Realtor.com, et aucune ne correspond à la notification de votre fournisseur IDX. Un modèle adapté à une source nécessite un modèle frère pour chaque autre source, et dès qu'un portail redessine son e-mail de notification, ce modèle commence silencieusement à extraire les mauvais champs.
Les feuilles de présence manuscrites n'ont aucune mise en page. Un modèle est un ensemble de coordonnées. Une feuille d'open house photographiée contient une écriture manuscrite à des positions arbitraires, traversant parfois les lignes du tableau, avec des numéros de téléphone sans indicatif et des e-mails écrits en abrégé. Aucun système de coordonnées ne survit au contact avec une vraie feuille de présence.
Les champs de contact eux-mêmes diffèrent selon la source de leads. Un acheteur de portail arrive avec un budget et un bien d'intérêt. Un visiteur d'open house arrive avec la case « travaille déjà avec un agent ? » cochée. Un e-mail de recommandation porte un contexte dans le corps que aucun modèle ne sait chercher. Le schéma de sortie est souvent la seule chose que toutes les sources partagent, et inversement la seule chose que les parseurs à modèles codent en dur par source.
C'est la distinction que les outils à modèles révèlent rarement : l'extraction basée sur la position répond à « où se trouve le numéro de téléphone sur cette mise en page exacte », tandis que l'extraction sémantique répond à « à quoi ressemble un numéro de téléphone sur ce document, quelle que soit la mise en page ». La deuxième approche est ce qui permet à un seul pipeline de traiter les trois formes de leads sans étape de configuration par source. Pour en savoir plus sur pourquoi les deux approches diffèrent en pratique, notre comparaison sans modèle versus basée sur modèle détaille le mécanisme sur des documents réels.
Un seul jeu de colonnes pour les e-mails, les pièces jointes et l'écriture manuscrite
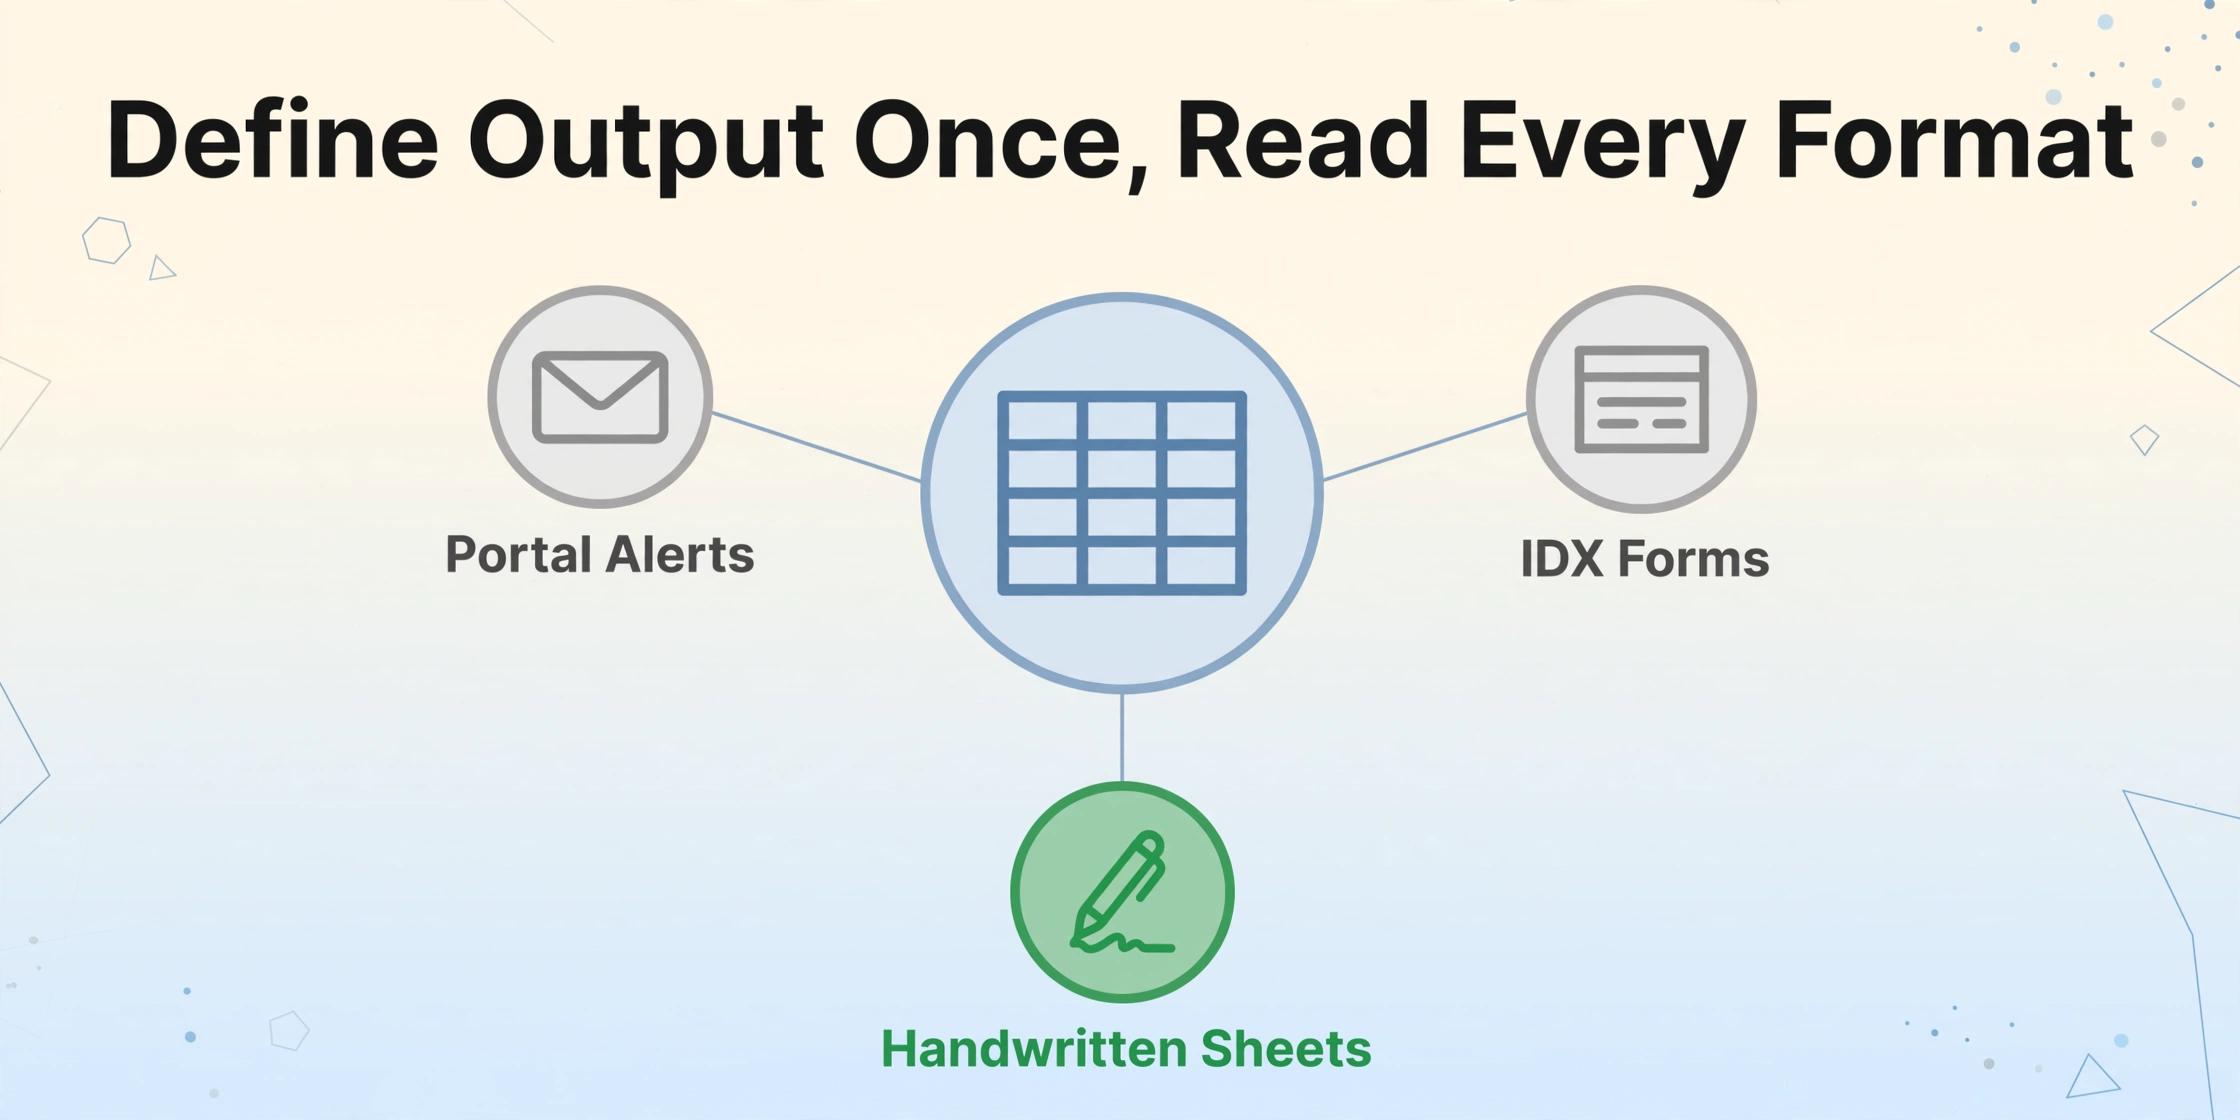
Un pipeline de collecte de leads sans modèle fonctionne dans l'autre sens. Au lieu de configurer l'analyseur pour chaque format entrant, vous définissez la sortie une seule fois : les colonnes dont la fiche contact a besoin. Ensuite, l'IA lit chaque document entrant et trouve ces valeurs, où qu'elles se trouvent, quelle qu'en soit la source.
Pour la collecte de leads immobiliers, un premier jeu de colonnes fonctionnel ressemble à ceci :
| Colonne | Ce qu'elle capture | Source typique |
|---|---|---|
| Nom | Nom complet de l'acheteur ou du vendeur | Alerte du portail, feuille de présence, e-mail de recommandation |
| Téléphone | Numéro de contact principal | Alerte du portail, feuille de présence |
| Adresse de réponse | Alerte du portail, formulaire du site web, notification IDX | |
| Type de demande | Achat, vente, demande de visite, visite d'open house | Objet et corps de l'e-mail |
| Bien d'intérêt | Adresse de l'annonce ou référence MLS | Alerte du portail, formulaire du site web |
| Budget | Fourchette de prix si indiquée | Alerte du portail, corps de l'e-mail de recommandation |
| Source du lead | Zillow, Realtor.com, formulaire du site web, open house | Inférée à partir du document ou de l'en-tête de l'e-mail |
Avec ces colonnes définies, chaque document entrant arrive dans le même format : une ligne par lead, sept colonnes, prêt pour le CRM. Le package est complet sans modèles par source : vous automatisez la collecte de leads immobiliers en définissant la sortie une seule fois, et l'IA trouve les valeurs dans chaque format reçu. L'IA infère la colonne Source du lead même lorsqu'aucun nom de source n'apparaît dans le document, ce qui est important pour le reporting sur le canal qui génère des revenus. Pour savoir comment ajuster les définitions de colonnes et extraire les champs exactement comme le reste de l'équipe les attend, le guide pour extraire les champs directement du corps d'un e-mail montre la même idée appliquée à la facturation, avec les mécanismes détaillés étape par étape.
La manière dont les documents arrivent compte tout autant que les colonnes. Le flux de travail commence par une adresse de boîte de réception dédiée qui vit dans l'outil d'extraction, et non dans votre boîte mail personnelle. Les alertes du portail, les notifications IDX et les e-mails photo des open houses y sont transférés, et les pièces jointes arrivent directement dans la file de traitement, sans page de téléversement. Une fois qu'un ensemble de colonnes est lié à cette boîte mail, le traitement démarre dès la réception du courrier, y compris les pièces jointes PDF chiffrées lorsque le mot de passe est enregistré à l'avance, ce qui arrive plus souvent dans ce secteur qu'on ne veut bien l'admettre. Une liste blanche d'expéditeurs limite la file aux sources de leads connues, afin qu'un e-mail isolé provenant d'une adresse inconnue ne se retrouve pas mélangé à vos lignes de contacts. La configuration de l'analyse des e-mails couvre les options de configuration, notamment le choix de lire uniquement les pièces jointes, uniquement le corps de l'e-mail, ou les deux, car certains portails inscrivent chaque détail d'acheteur dans le texte du message sans aucune pièce jointe.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Des lignes de feuille de calcul aux tâches de suivi
L'extraction place le lead dans une ligne propre. Intégrer cette ligne dans le CRM est une étape distincte, généralement fastidieuse, et la version honnête de cet article ne prétend pas qu'il existe un bouton magique qui écrit directement dans LionDesk ou Follow Up Boss. Deux voies réalistes s'offrent à vous, et les deux sont standard.
Voie une : exportation et importation. Chaque CRM immobilier digne de son abonnement importe des fichiers CSV. Les acheteurs de Zillow deviennent un ensemble de lignes dans une feuille de calcul, vous le téléchargez, et l'outil d'importation du CRM crée les contacts, ce qui est exactement la façon dont la plupart des équipes poussent déjà les données du portail. Les résultats d'extraction qui atterrissent directement dans Google Sheets rendent cela encore moins pénible, car la feuille est déjà le fichier d'importation.
Voie deux : l'API. Pour les équipes disposant d'un développeur, ou pour un volume de leads plus important, l'extraction elle-même est disponible sous forme d'API REST avec notifications webhook, de sorte que les lignes de leads traitées peuvent être poussées dans un pipeline en aval dès leur création. C'est l'option pour les courtages qui acheminent déjà les leads vers un composeur ou un CRM distribué. C'est aussi la voie qui permet à une équipe de conserver sa propre logique de déduplication, d'attribution et de SMS avant l'étape de création du contact. Cet article ne revendique délibérément aucune intégration CRM native de notre côté : la formulation honnête est que la sortie est des données structurées, et que les plateformes CRM parlent toutes CSV ou disposent d'une API prête à les recevoir.
Chaque voie aboutit au même résultat que le processus manuel tentait d'atteindre : une fiche contact avec un numéro de téléphone, un e-mail et une raison de faire un suivi, créée pendant que le lead est encore chaud. Les chiffres de HBR disent que tout le jeu consiste à y arriver en quelques minutes, pas en quelques heures. La configuration de l'extraction elle-même est un effort ponctuel, et ensuite le coût hebdomadaire est une passe de vérification sur les lignes, pas une session de ressaisie.
Ce que l'automatisation ne remplace pas : la vérification et le consentement
Un pipeline sans modèle élimine la saisie, mais pas le jugement, et le traiter comme s'il le faisait est la façon dont les leads se perdent dans l'autre sens. Trois éléments maintiennent un humain dans la boucle, et l'article promettrait trop sans être explicite à leur sujet.
Les champs en écriture manuscrite méritent un coup d'œil avant d'entrer dans le CRM. Un numéro de téléphone écrit à la hâte, une adresse e-mail avec un caractère taché, ce sont exactement les champs où une extraction IA peut se tromper. Comme les documents de leads sont généralement courts, un balayage rapide des lignes extraites est une assurance peu coûteuse. Le flux de vérification humaine pour les documents extraits explique comment structurer ce contrôle pour attraper les mauvaises lignes sans revérifier chaque bonne ligne une seconde fois. Une écriture manuscrite douteuse est l'endroit où un niveau de traitement plus précis rentabilise son coût, ce qui est bon à savoir lors des semaines à fort trafic d'open house.
Les messages de suivi automatisés nécessitent des règles de consentement, pas seulement du contenu. Envoyer un SMS automatique à un nouveau lead est réglementé aux États-Unis : la Telephone Consumer Protection Act exige un consentement écrit préalable exprès avant les SMS marketing, et la règle de consentement un-à-un de la FCC a renforcé cela en 2025. L'e-mail relève du régime plus léger de désinscription CAN-SPAM, mais il n'est pas non plus exempt de consentement. Les directives de télémarketing et d'appel à froid de la NAR pour les agents constituent la référence de départ appropriée avant d'activer toute séquence de sensibilisation automatisée. L'extraction résout le goulot d'étranglement de la saisie de données ; elle n'accorde pas la permission de contacter qui que ce soit.
Le premier appel téléphonique doit toujours être passé par une personne. L'automatisation fait entrer un contact dans le CRM pendant que l'acheteur est encore en train de chercher. Tout ce qui suit — la lecture d'un intérêt exprimé, la question sur le financement, l'écoute — est un travail humain, et c'est la moitié du métier qui ne passe pas à l'échelle. Un pipeline qui ressaisit les leads à la vitesse d'une machine laisse plus de temps à l'agent pour précisément cet appel, et c'est tout l'intérêt.
Deux scénarios voisins mériteraient chacun un article dédié. Un dossier de documents de clôture immobilier est la paperasse transactionnelle d'une affaire déjà en cours, et l'extraction de baux est une donnée de portefeuille pour les gestionnaires immobiliers, tous deux plus loin dans le calendrier que la saisie de leads. La portée de cet article s'arrête à la fiche contact.
FAQ
ImageToTable.ai peut-il créer des contacts directement dans LionDesk ou Follow Up Boss ?
Pas nativement. Il n'existe pas de connecteur intégré qui écrit directement dans un CRM immobilier. Le résultat de l'extraction est une feuille de calcul (Excel ou CSV) ou du JSON, et tous les CRM immobiliers courants importent le CSV, donc le chemin standard est l'export puis l'import. Les équipes qui souhaitent un envoi direct utilisent l'API REST avec un webhook comme pont maison.
Le côté e-mail gère-t-il les pièces jointes, ou seulement le corps du message ?
Les deux. La boîte de réception e-mail est une adresse dédiée vers laquelle les leads sont redirigés, et le traitement peut être configuré pour lire uniquement les pièces jointes, uniquement le corps de l'e-mail, ou les deux. Certains portails placent les détails de l'acheteur dans le corps, d'autres joignent des PDF, et certaines notifications IDX mettent tout dans un bloc de signature. Configurer corps-plus-pièces jointes couvre la combinaison réaliste.
Peut-il vraiment lire les feuilles de présence manuscrites des open houses ?
Oui, avec une réserve honnête : le texte imprimé est extrait avec une très grande précision, et l'écriture manuscrite est bien lue mais pas parfaitement, ce qui explique pourquoi une étape de vérification rapide compte davantage pour les feuilles de présence que pour les e-mails de portail. Une feuille photographiée se téléverse comme n'importe quelle image et produit les mêmes lignes de contact. Pour les semaines à forte écriture manuscrite, le niveau de traitement à plus haute précision réduit sensiblement le nombre de lignes à revoir.
L'envoi automatisé de SMS aux nouveaux leads est-il autorisé ?
Uniquement avec une conformité intégrée. En vertu du droit américain, les SMS marketing envoyés via un autocomposeur exigent un consentement écrit préalable explicite, et la règle de consentement individuel de la FCC s'applique à partir de janvier 2025. La page d'orientation de la NAR pour les agents couvre ces règles dans le contexte du courtage. Rien dans l'extraction de documents ne confère un consentement à l'envoi de SMS ; la collecte du consentement doit donc faire partie de la conception de la collecte des leads, et non être ajoutée ultérieurement.
Est-ce adapté à un agent indépendant, ou uniquement aux équipes ?
Un agent indépendant en tire proportionnellement plus de valeur qu'une équipe, car il n'y a pas d'assistant pour absorber la saisie. Le coût de mise en place est le même dans les deux cas : un ensemble de colonnes défini une seule fois, une règle de transfert, et le flux de travail de la feuille de présence pour les dimanches d'open house. Le seuil de volume est plus bas que ce que la plupart des gens supposent ; environ une poignée de leads par semaine suffit déjà à le justifier.
Quelle est la différence avec le système de livraison de leads du portail lui-même ?
Les portails qui s'intègrent directement à un CRM (certains le font, via le fournisseur du CRM) livrent des données structurées sans aucune extraction, et lorsque cela fonctionne, c'est l'option la plus propre. Cela ne couvre toutefois que ce portail. Toutes les autres sources, des autres portails à vos formulaires IDX en passant par les feuilles d'open house, arrivent toujours dans une boîte de réception. Une couche d'extraction sans modèle est la seule approche qui traite les trois formes comme un même problème, et elle existe précisément parce que les connecteurs portail-CRM ne couvrent qu'une infime partie de la semaine réelle.
Les leads se refroidissent pendant qu'un acheteur attend une réponse moyenne de 42 heures, et la majeure partie de ce temps est consacrée à ressaisir les détails du lead dans une fiche contact, plutôt qu'à décider quoi dire. Pour un acheteur qui ne consulte qu'un seul agent, cette attente marque souvent la fin de la conversation.
C'est précisément cette lacune qu'un pipeline d'admission sans modèle élimine : trois sources de leads, un ensemble de colonnes, un fichier d'importation, et le premier vrai appel de l'agent commence quelques minutes après l'arrivée du lead, au lieu d'attendre que l'assistant rattrape son retard. Essayez-le sur un e-mail de lead réel ou une feuille de présence et voyez combien de lignes de contacts sont générées.