E-mails de Leads Imobiliários para o CRM
Contatos Sem Redigitar
A Harvard Business Review auditou 2.241 empresas em 2011 e descobriu que apenas 37 por cento respondeu a um novo lead da web em até uma hora, 23 por cento nunca respondeu, e o tempo médio de resposta entre os que responderam foi de 42 horas. Essa lacuna entre o lead chegar e alguém realmente trabalhar nele é onde a maioria das oportunidades imobiliárias morre.
O Perfil de Compradores e Vendedores de Casas de 2025 da National Association of Realtors acrescenta a parte que a maioria dos corretores já sente: 67 por cento dos compradores de primeira viagem e 76 por cento dos compradores recorrentes entrevistaram exatamente um corretor antes de escolher. O primeiro corretor que alcança um comprador pronto, bem, geralmente fica com o negócio. O que torna a etapa sem glamour entre a caixa de entrada e o CRM, a parte onde o nome, o telefone e a pergunta de um lead são digitados em um registro de contato à mão, o gargalo menos defendido em todo o pipeline.
Principais Conclusões
- A empresa média levou 42 horas para responder a um novo lead da web, e 23 por cento nunca respondeu, que é onde a maioria dos negócios imobiliários morre silenciosamente.
- 20 minutos de redigitação por lead é onde esse atraso realmente mora, não é tempo de pensamento, e nenhum modelo sobrevive a isso porque cada portal, fornecedor de IDX e folha manuscrita formata seus campos de maneira diferente.
- Defina as sete colunas de contato uma vez, e a IA encontra esses valores em alertas de portal, formulários IDX e escrita à mão de open house, para que todas as três fontes de lead cheguem em um único CSV que seu CRM já importa.
Leads Imobiliários Não Chegam como Registros de Contato
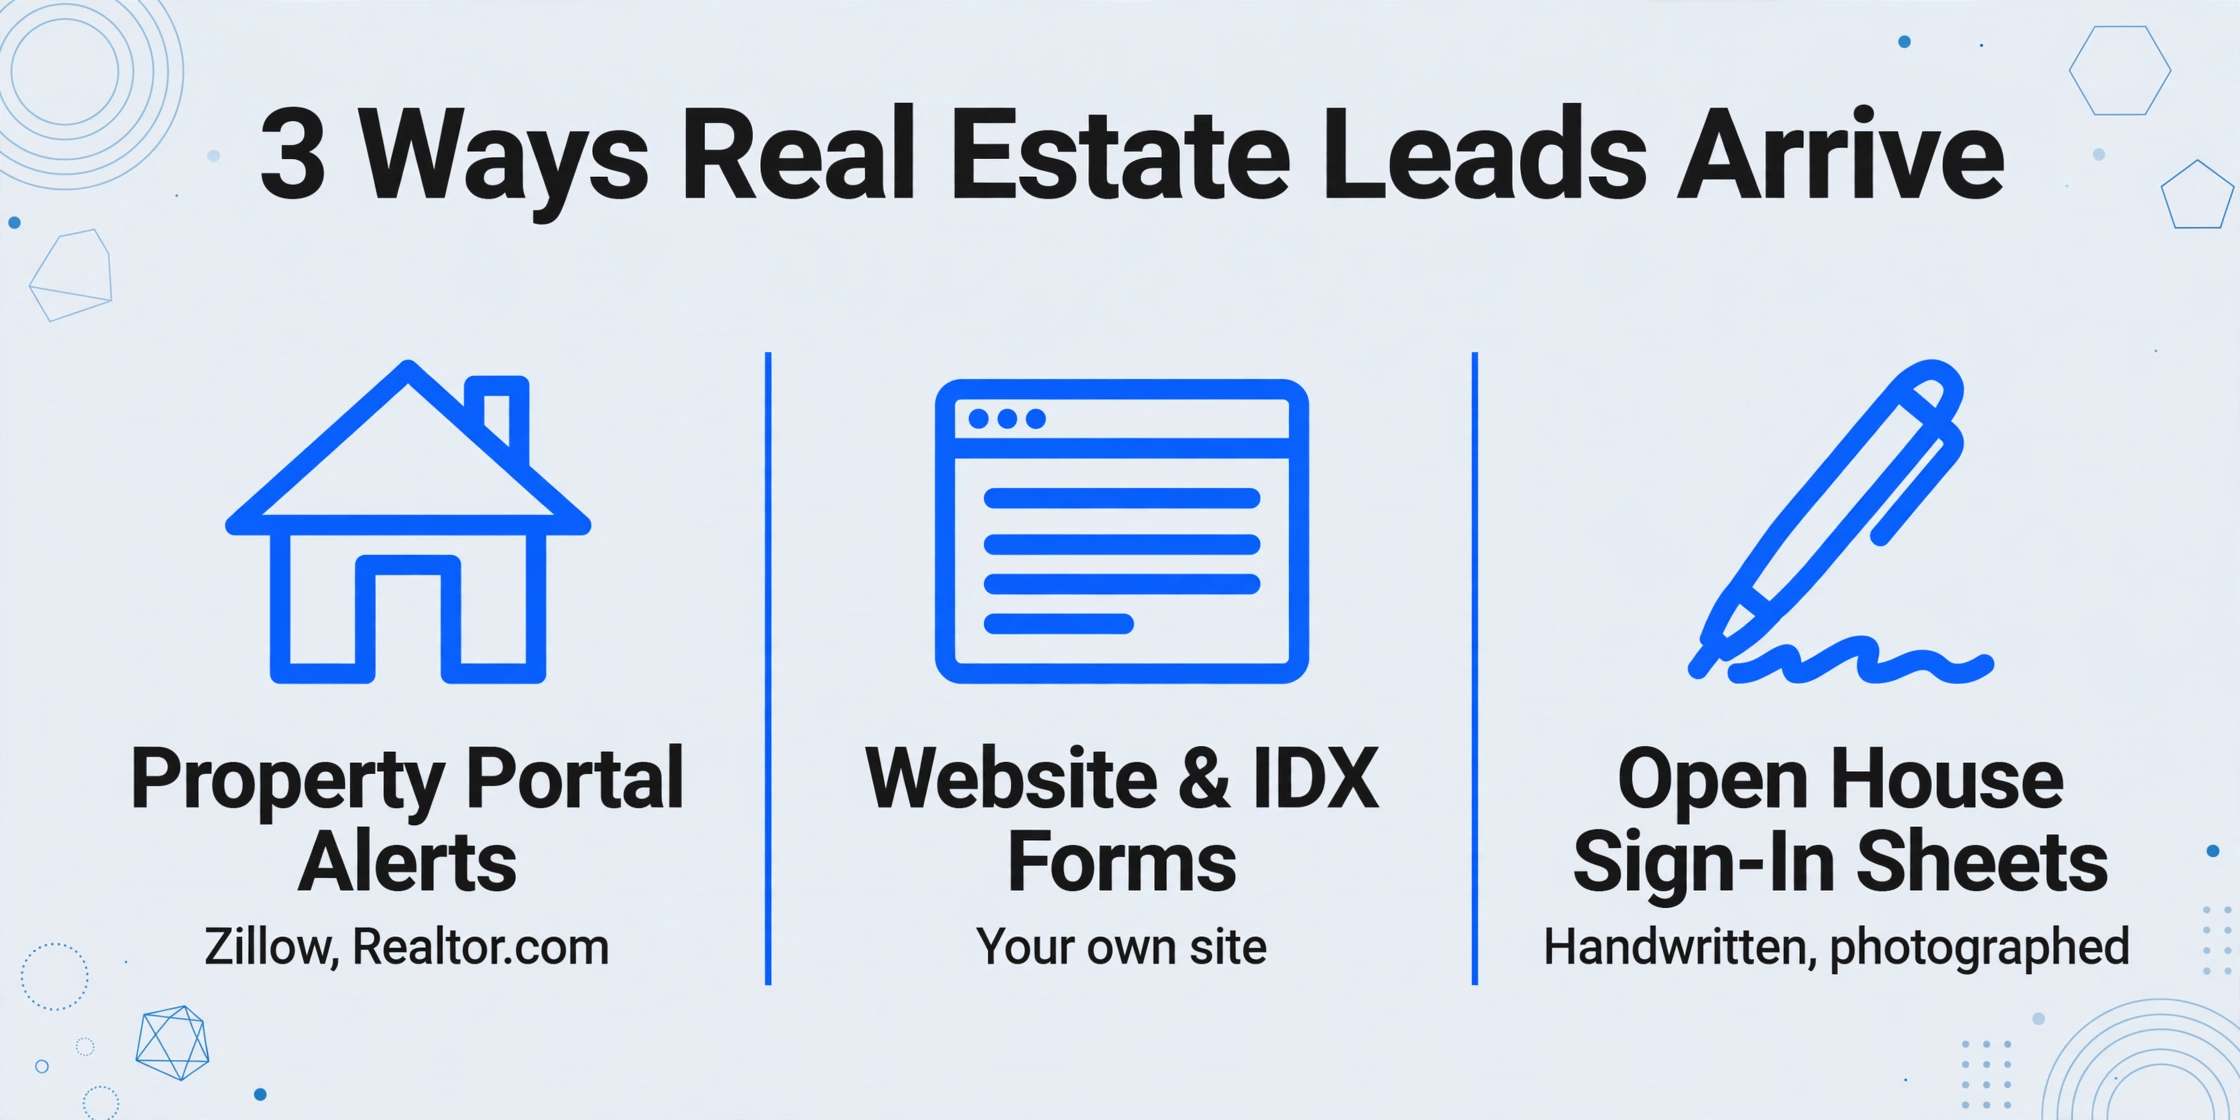
Antes de qualquer conversa sobre automação fazer sentido, é útil olhar para a matéria-prima. Um "lead" no setor imobiliário não é uma linha de planilha esperando para ser aberta. Ele chega em uma de três formas, e cada forma exige um nível diferente de esforço para se tornar um contato no CRM:
Alertas de portal de imóveis. O comprador preenche um formulário de consulta no Zillow, Realtor.com ou Trulia, e o portal envia uma notificação por e-mail com o nome, telefone, e-mail do comprador e o anúncio sobre o qual ele perguntou. Limpo, mas ainda chega como texto dentro de um e-mail. Se você usar o sistema de leads do próprio portal, os dados já estão estruturados no lado do portal, e o problema passa a ser extraí-los de lá.
Notificações de formulários do site e IDX. A consulta chega pelos formulários do seu próprio site, geralmente a ferramenta de busca IDX que permite aos compradores navegar pelos anúncios. A notificação por e-mail chega na caixa de entrada que sua equipe realmente verifica, muitas vezes uma conta compartilhada ou a conta pessoal do administrador. O formato varia de um provedor de IDX para outro, e os campos mudam entre provedores.
Folhas de presença de open house. Os leads de maior intenção da semana — pessoas que visitaram fisicamente um imóvel — escritos à mão em uma folha de papel, fotografados no celular e enviados por e-mail ao administrador na manhã seguinte. Todo open house no país produz o mesmo resultado: uma página de escrita à mão que precisa ser lida, decifrada e redigitada antes de se tornar um contato.
O relatório de 2025 da NAR coloca essa última fonte em perspectiva: 43% dos compradores classificaram open houses como uma fonte de informação muito útil durante sua busca. Os visitantes que percorreram seu anúncio não são extraíveis, não têm API e não digitaram nada. Eles são os leads imobiliários mais baratos que a maioria dos corretores já conseguiu, e também os mais propensos a nunca entrar no CRM, porque ninguém redigita escrita à mão às 23h.
O Ponto de Entrega Onde o Tempo de Resposta Realmente Morre
O estudo da HBR mediu o tempo entre "lead enviado" e "empresa responde." No setor imobiliário, esse intervalo raramente é gasto decidindo o que dizer. Ele é gasto na entrada de dados entre o e-mail recebido e o registro no CRM.
Os agentes descrevem a etapa de forma simples. Um usuário focado em aquisição no r/RealEstateTechnology escreveu que mantinha dois assistentes virtuais para velocidade de resposta e acompanhamento, "gastando cerca de $2.200 por mês com tudo incluído," e a percepção que o abalou foi puxar os números e descobrir que 68 por cento dos negócios fechados vieram de leads com mais de 45 dias. Outro tópico sobre entrada de dados no CRM colocou o custo por lead em "20 minutos perdidos por lead" apenas com digitação manual. No r/automation, alguém que construiu um funil de leads para uma corretora descreveu o estado pré-automação como "copiar e colar dados de leads dos portais para planilhas," quatro horas por dia disso, reduzido a 15 minutos de revisão.
O padrão é o mesmo em todas as contas: o atraso não é tempo de pensar, é tempo de digitar. Um administrador que abre um alerta do portal às 9h, copia o nome e o telefone para o CRM, define uma tarefa de acompanhamento e repete a sequência doze vezes não atendeu nenhum comprador ao meio-dia. Uma equipe onde essa etapa roda sozinha atende os mesmos compradores enquanto o administrador dorme. Em outras palavras, o caminho de um e-mail de lead imobiliário para o contato no CRM atualmente passa pela entrada manual de dados, e é exatamente esse trecho que este artigo pretende encurtar.
Há também um segundo custo que nunca aparece nos estudos de tempo de resposta: os leads que nunca são digitados. Um dígito lido errado em uma folha de presença escrita à mão, um endereço de e-mail com uma letra errada, uma folha que vai para a gaveta porque ninguém tem trinta minutos para transcrevê-la. Esses não são respostas lentas, são não-respostas, e os visitantes de open house em particular as aceitam. A consequência mediana, do r/Real_Estate, é familiar: "Lead chega, salvo no WhatsApp. O acompanhamento acontece pelo WhatsApp. O negócio fecha e o agente lembra dele."
Por que a análise de leads baseada em modelo continua falhando
A maioria das ferramentas voltadas para esse problema exato, parsers de e-mail que criam contatos no CRM, aborda isso com modelos. A promessa parece perfeita: o parser monitora a caixa de entrada, compara o e-mail recebido com um layout predefinido, extrai os campos das posições fixas e envia o contato para o CRM automaticamente.
Os modelos funcionam quando o formato de entrada é garantido. Os alertas do portal estão perto disso, mas apenas para uma versão específica do portal por vez. A realidade da captação de leads é que o formato é a coisa menos confiável nesse processo:
Cada portal e cada provedor de IDX produz um layout de e-mail diferente. A estrutura de alerta da Zillow não é a do Realtor.com, e nenhuma delas corresponde à notificação do seu fornecedor de IDX. Um modelo ajustado para uma fonte precisa de um modelo irmão para cada outra fonte, e no momento em que um portal redesenha seu e-mail de notificação, esse modelo silenciosamente começa a capturar os campos errados.
Folhas de presença escritas à mão não têm layout algum. Um modelo é um conjunto de coordenadas. Uma folha de open house fotografada é escrita à mão em posições arbitrárias, às vezes cruzando linhas da tabela, com números de telefone sem DDD e e-mails escritos de forma abreviada. Nenhum sistema de coordenadas sobrevive ao contato com uma folha de presença real.
Os próprios campos de contato diferem por fonte de lead. Um comprador de portal vem com orçamento e imóvel de interesse. Um visitante de open house vem com "já trabalha com um corretor?" marcado. Um e-mail de indicação carrega contexto no corpo que nenhum modelo sabe procurar. O esquema de saída costuma ser a única coisa que todas as fontes compartilham e, inversamente, a única coisa que os parsers baseados em modelo codificam por fonte.
Essa é a distinção que as ferramentas baseadas em modelo raramente apresentam: a extração baseada em posição responde "onde neste layout exato está o número de telefone", enquanto a extração semântica responde "como um número de telefone se parece neste documento, independentemente do layout". A segunda abordagem é o que permite que um único pipeline lide com todos os três formatos de lead sem uma etapa de configuração por fonte. Para saber mais sobre por que as duas abordagens diferem na prática, nossa comparação sem modelo versus baseada em modelo explica o mecanismo em documentos reais.
Um Conjunto de Colunas para E-mail, Anexos e Escritura à Mano
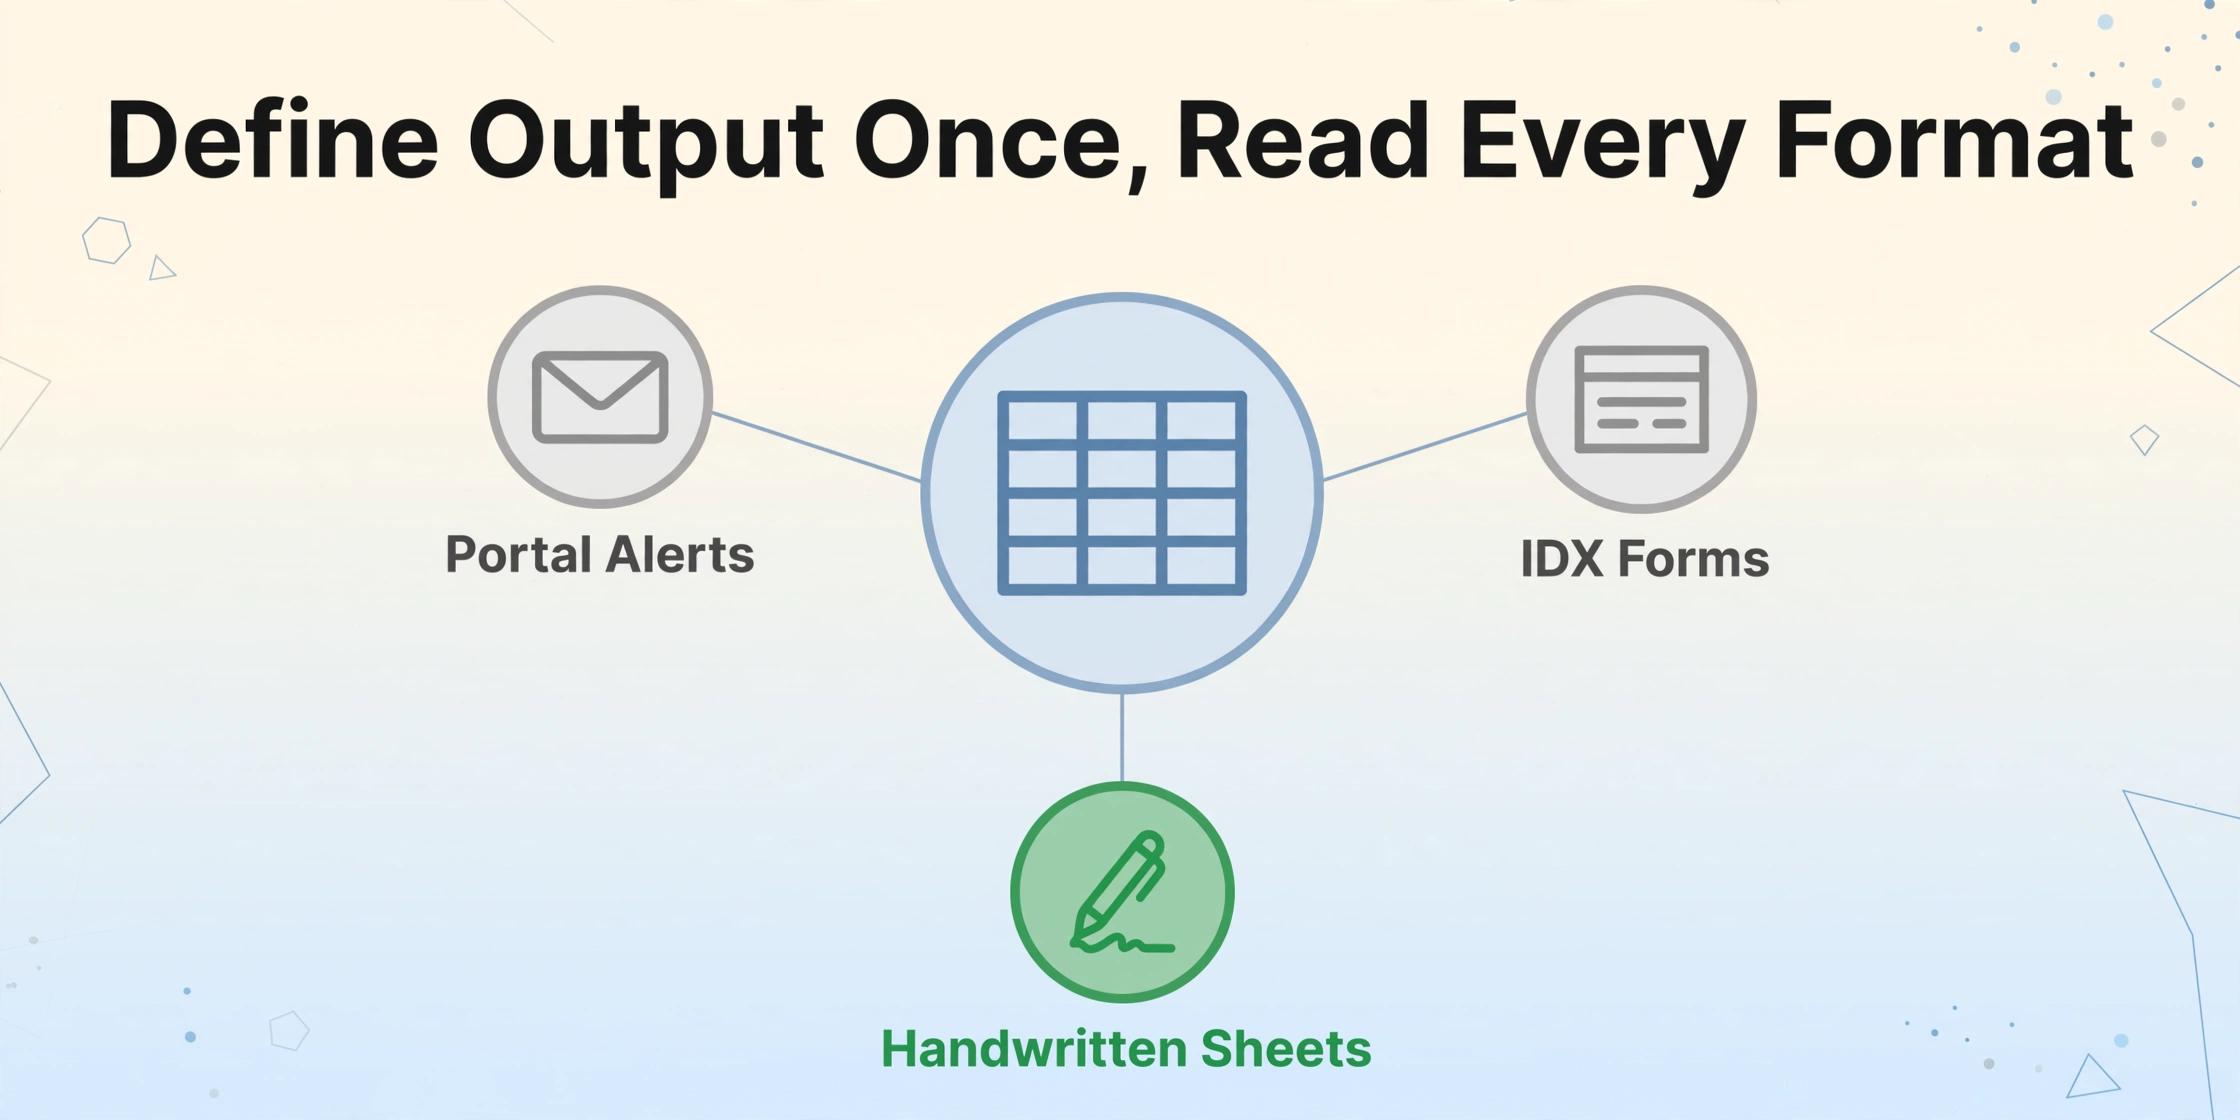
Um pipeline de captação de leads sem modelo funciona ao contrário. Em vez de configurar o parser para cada formato recebido, você define a saída uma única vez: as colunas que o registro de contato precisa. Então a IA lê cada documento recebido e encontra esses valores, onde quer que estejam, qualquer que seja a fonte.
Para a captação de leads imobiliários, um primeiro conjunto de colunas viável é assim:
| Columna | O que captura | Fonte típica |
|---|---|---|
| Nome | Nome completo do comprador ou vendedor | Alerta de portal, folha de presença, e-mail de referência |
| Telefone | Número de contato principal | Alerta de portal, folha de presença |
| Endereço de resposta | Alerta de portal, formulário do site, notificação IDX | |
| Tipo de Consulta | Comprar, vender, solicitar visita, visita a open house | Assunto e corpo do e-mail |
| Propriedade de Interesse | Endereço do anúncio ou referência MLS | Alerta de portal, formulário do site |
| Orçamento | Intervalo de preço, se indicado | Alerta de portal, corpo do e-mail de referência |
| Fonte do Lead | Zillow, Realtor.com, formulário do site, open house | Inferida do documento ou cabeçalho do e-mail |
Com estas colunas definidas, cada documento recebido chega no mesmo formato: uma linha por lead, sete colunas, pronto para o CRM. O pacote está completo sem modelos por fonte: você automatiza a captação de leads imobiliários definindo a saída uma única vez, e a IA encontra os valores em cada formato que chega. A IA infiere a columna Fonte do Lead mesmo quando nenhun nome de fonte aparece no documento, o que importa para reportar sobre qual canal paga o alquiler. Para ajustar as definições de colunas e extraer campos exatamente como o resto da equipe espera, o guia para extraer campos diretamente do corpo de um e-mail mostra a mesma ideia aplicada à facturação, com a mecánica explicada passo a passo.
A forma como os próprios documentos chegam importa tanto quanto as colunas. O fluxo de trabalho começa com um endereço de caixa de entrada dedicado que fica na ferramenta de extração, não na sua caixa de entrada pessoal. Alertas do portal, notificações IDX e e-mails com fotos de open houses são encaminhados para lá, e os anexos caem direto na fila de processamento, sem página de upload. Quando um conjunto de colunas está vinculado a essa caixa de entrada, o processamento começa no momento em que o e-mail chega, incluindo anexos PDF criptografados quando a senha é salva antecipadamente, o que acontece com mais frequência neste setor do que qualquer um gosta de admitir. Uma lista de remetentes permitidos limita a fila a fontes de lead conhecidas, então um e-mail avulso de um endereço desconhecido não acaba misturado nas suas linhas de contato. A configuração de parsing de e-mail cobre as opções de configuração, incluindo a escolha de ler apenas anexos, apenas o corpo do e-mail, ou ambos, porque alguns portais escrevem todos os detalhes do comprador no texto da mensagem sem nenhum anexo.
Os arquivos são processados com segurança e não são armazenados.
De Linhas de Planilha a Tarefas de Acompanhamento
A extração coloca o lead em uma linha limpa. Colocar essa linha no CRM é uma etapa separada, em sua maioria entediante, e a versão honesta deste artigo não finge que existe um botão mágico que escreve diretamente no LionDesk ou no Follow Up Boss. Existem dois caminhos realistas, e ambos são padrão.
Caminho um: exportar e importar. Todo CRM imobiliário que vale a assinatura importa CSV. Compradores do Zillow viram um conjunto de linhas de planilha, você baixa e a ferramenta de importação do CRM cria contatos, que é exatamente como a maioria das equipes já distribui dados do portal. Resultados de extração que vão direto para o Google Sheets tornam isso ainda menos trabalhoso, porque a planilha já é o arquivo de importação.
Caminho dois: a API. Para equipes com um desenvolvedor, ou um volume maior de leads, a extração em si está disponível como uma API REST com notificações via webhook, então linhas de leads processadas podem ser enviadas para um pipeline downstream no momento em que existem. Essa é a opção para corretoras que já direcionam leads para um discador ou um CRM distribuído. É também o caminho que permite à equipe manter sua própria lógica de deduplicação, atribuição e SMS antes da etapa de criação de contato. Este artigo deliberadamente não afirma uma integração nativa de CRM do nosso lado: a redação honesta é que a saída são dados estruturados, e as plataformas de CRM falam CSV ou têm uma API esperando por eles.
Qualquer um dos caminhos termina com o mesmo resultado que o processo manual tentava alcançar: um registro de contato com telefone, e-mail e um motivo para acompanhar, criado enquanto o lead ainda está quente. Os números da HBR dizem que o jogo inteiro é chegar lá em minutos, não em horas. A configuração da extração em si é um esforço único e, depois disso, o custo semanal é uma revisão das linhas, não uma sessão de redigitação.
O Que a Automação Não Substitui: Revisão e Consentimento
Um pipeline sem modelo remove a digitação, mas não remove o julgamento, e tratá-lo como se removesse é como leads se perdem na outra direção. Três coisas mantêm um humano no processo, e o artigo estaria prometendo demais sem ser explícito sobre elas.
Campos escritos à mão merecem uma olhada antes de entrar no CRM. Um telefone escrito com pressa, um e-mail com um caractere borrado — esses são exatamente os campos onde uma extração de IA pode errar. Como os documentos de lead costumam ser curtos, uma verificação rápida das linhas extraídas é um seguro barato. O fluxo de revisão humana para documentos extraídos explica como estruturar essa checagem para pegar as linhas ruins sem revisar cada linha boa uma segunda vez. Escrita à mão ilegível é onde um nível de processamento de maior precisão se paga, o que vale saber em semanas de muito movimento de open house.
Mensagens de acompanhamento automatizadas precisam de regras de consentimento, não apenas de conteúdo. Enviar SMS automaticamente para um lead novo é regulamentado nos Estados Unidos: a Telephone Consumer Protection Act exige consentimento expresso por escrito antes de mensagens de marketing, e a regra de consentimento individual da FCC endureceu isso ainda mais em 2025. O e-mail tem o regime mais leve de opt-out do CAN-SPAM, mas também não é livre de consentimento. O guia de telemarketing e chamadas frias da NAR para corretores é a referência inicial certa antes de qualquer sequência automatizada de contato ser ativada. A extração resolve o gargalo de entrada de dados; ela não concede permissão para contatar ninguém.
A primeira ligação de verdade ainda precisa ser feita por uma pessoa. A automação coloca um contato no CRM enquanto o comprador ainda está pesquisando. Tudo depois disso — a leitura de um interesse demonstrado, a pergunta sobre financiamento, a escuta — é trabalho humano e é a metade do trabalho que não escala. Um pipeline que digita leads em velocidade de máquina deixa mais tempo do dia do agente exatamente para essa ligação, que é o objetivo.
Dois cenários adjacentes merecem artigos diferentes cada um. Um pacote de documentos de fechamento imobiliário é a papelada transacional de um negócio já em andamento, e a extração de contratos de locação é dado de portfólio para administradores de imóveis, ambos mais adiante na linha do tempo do que a captação de leads. O escopo deste artigo termina no registro do contato.
FAQ
O ImageToTable.ai pode criar contatos diretamente no LionDesk ou Follow Up Boss?
Não nativamente. Não há conector integrado que grave diretamente em um CRM imobiliário. A saída da extração é uma planilha (Excel ou CSV) ou JSON, e todo CRM imobiliário mainstream importa CSV, então o caminho padrão é exportar e depois importar. Equipes que querem um envio direto usam a API REST com um webhook como ponte própria.
O lado do e-mail lida com anexos, ou apenas com o corpo da mensagem?
Ambos. A Caixa de Entrada de E-mail é um endereço dedicado para onde os leads são encaminhados, e o processamento pode ser configurado para ler apenas anexos, apenas o corpo do e-mail, ou ambos. Alguns portais colocam os dados do comprador no corpo, alguns anexam PDFs, e algumas notificações de IDX colocam tudo em um bloco de assinatura. Configurar corpo-mais-anexos cobre a mistura realista.
Ele realmente consegue ler folhas de presença de open house escritas à mão?
Sim, com uma ressalva honesta: material impresso é extraído com altíssima precisão, e escrita à mão é lida bem, mas não perfeitamente, por isso uma etapa rápida de revisão importa mais para folhas de presença do que para e-mails de portal. Uma folha fotografada é enviada como qualquer imagem e produz as mesmas linhas de contato. Para semanas com muita escrita à mão, o nível de processamento de maior precisão reduz significativamente o número de linhas que precisam de uma segunda olhada.
O envio automatizado de mensagens de texto para novos leads é permitido?
Somente com conformidade integrada. De acordo com a lei dos EUA, mensagens de marketing enviadas com um discador automático exigem consentimento expresso por escrito, e a regra de consentimento individual da FCC se aplica a partir de janeiro de 2025. O guia da NAR para corretores cobre as regras no contexto da corretora. Nada na extração de documentos concede consentimento para envio de mensagens, então a captura de consentimento precisa fazer parte do design de captura de leads, não ser adicionada depois.
Isso é adequado para um corretor autônomo ou apenas para equipes?
Um corretor autônomo obtém proporcionalmente mais valor do que uma equipe, porque não há assistente para absorver a digitação. O custo de configuração é o mesmo nos dois casos: um conjunto de colunas definido uma vez, uma regra de encaminhamento e o fluxo da folha de presença para open houses aos domingos. O volume mínimo é menor do que a maioria imagina; cerca de alguns leads por semana já justifica o uso.
Qual é a diferença entre isso e o sistema de entrega de leads do próprio portal?
Portais que se integram diretamente a um CRM (alguns fazem isso, por meio do fornecedor do CRM) entregam dados estruturados sem extração, e quando isso funciona, é a opção mais limpa. Mas cobre apenas aquele portal. Todas as outras fontes, de outros portais aos seus formulários IDX e folhas de presença de open house, ainda chegam na caixa de entrada. Uma camada de extração sem modelo é a única abordagem que trata as três formas como o mesmo problema, e ela existe justamente porque os conectores portal-CRM cobrem muito pouco da semana real.
Leads esfriam enquanto um comprador espera por uma resposta média de 42 horas, e a maior parte desse tempo é gasta redigitando os dados do lead em um registro de contato, não decidindo o que dizer. Para um comprador que entrevista exatamente um corretor, essa espera geralmente é o fim da conversa.
Essa é a lacuna que um pipeline de captura sem modelo elimina: três fontes de leads, um conjunto de colunas, um arquivo de importação, e a primeira ligação real do corretor começa minutos depois do lead, em vez de depois que o assistente se atualiza. Experimente com um e-mail real de lead ou folha de presença e veja quantas linhas de contato retornam.