So verarbeiten Sie japanische Lieferscheine mehrerer Lieferanten im Batch zu einem einheitlichen Wareneingangsprotokoll
Verarbeiten Sie die 納品書 (Nōsho) eines Tages von mehreren japanischen Lieferanten im Batch zu einem einheitlichen Wareneingangsprotokoll – ohne Einrichtung von Vorlagen pro Lieferant.
Warum der japanische Warenannahmebereich auf manueller Dateneingabe basiert
Der japanische 3PL-Markt – der Logistik für Fertigung, Einzelhandel und E-Commerce in verschiedenen Branchen bereitstellt – soll bis 2031 48,38 Milliarden US-Dollar erreichen. Doch das Dokument, das belegt, was auf dem Lkw angekommen ist, wird immer noch so verarbeitet wie vor 30 Jahren: Jemand liest es, tippt die Daten ein und hofft, dass keine Ziffer vertauscht wurde.
Lagermanagementsysteme in Japan haben nahezu jeden physischen Prozess automatisiert. Barcode-Scanner an der Rampe erfassen Paletten-IDs. RFID-Tags verfolgen den Lagerort in Echtzeit. Automatisierte Fahrzeuge bewegen Waren ohne menschliches Eingreifen zwischen Zonen. Nippon Express (NX GROUP), der größte 3PL des Landes, betreibt WMS-Plattformen, die Wareneingang, Einlagerung und Kommissionierung mit millisekundengenauer Präzision orchestrieren. Doch jedes dieser Systeme hat dieselbe Abhängigkeit: Sie benötigen strukturierte Daten, um ihre Arbeit aufzunehmen. Ein WMS kann Lagerbestände aktualisieren, wenn es eine digitale Transaktion erhält – aber diese Transaktion kann erst erstellt werden, nachdem jemand den Lieferschein gelesen und die Daten eingegeben hat.
Dies ist kein Versagen der japanischen Logistiktechnologie. Es ist ein Dokumentformatproblem, das sich als Dateneingabeproblem tarnt. Der Lieferschein (納品書) ist nach japanischem Handelsrecht kein gesetzlich vorgeschriebenes Dokument – anders als die Rechnung (請求書), die das Qualifizierte Rechnungssystem (インボイス制度) seit Oktober 2023 standardisiert. Der Lieferschein hat kein vorgeschriebenes Format, keine Pflichtfelder und keinen digitalen Standard, der Peppol oder Factur-X entspricht. Jeder Lieferant druckt, tippt oder schreibt seinen Lieferschein so, wie es sein Backoffice produziert.
Japans Logistiktechnologie hat den Transport von Waren automatisiert. Sie hat nicht das Lesen der Dokumente automatisiert, die diese Waren identifizieren. Die Lücke zwischen einem Barcode auf einer Palette und den Lieferscheindaten, die dem System mitteilen, zu welchem Bestellauftrag die Palette gehört – diese Lücke wird weiterhin von einem Menschen und einer Tastatur überbrückt.
Warum Ihr WMS Paletten sieht, aber keine Lieferscheine
Um zu verstehen, warum diese Lücke besteht, hilft ein Blick darauf, was an einem typischen Dienstagmorgen tatsächlich an einer japanischen Warenannahme eintrifft.
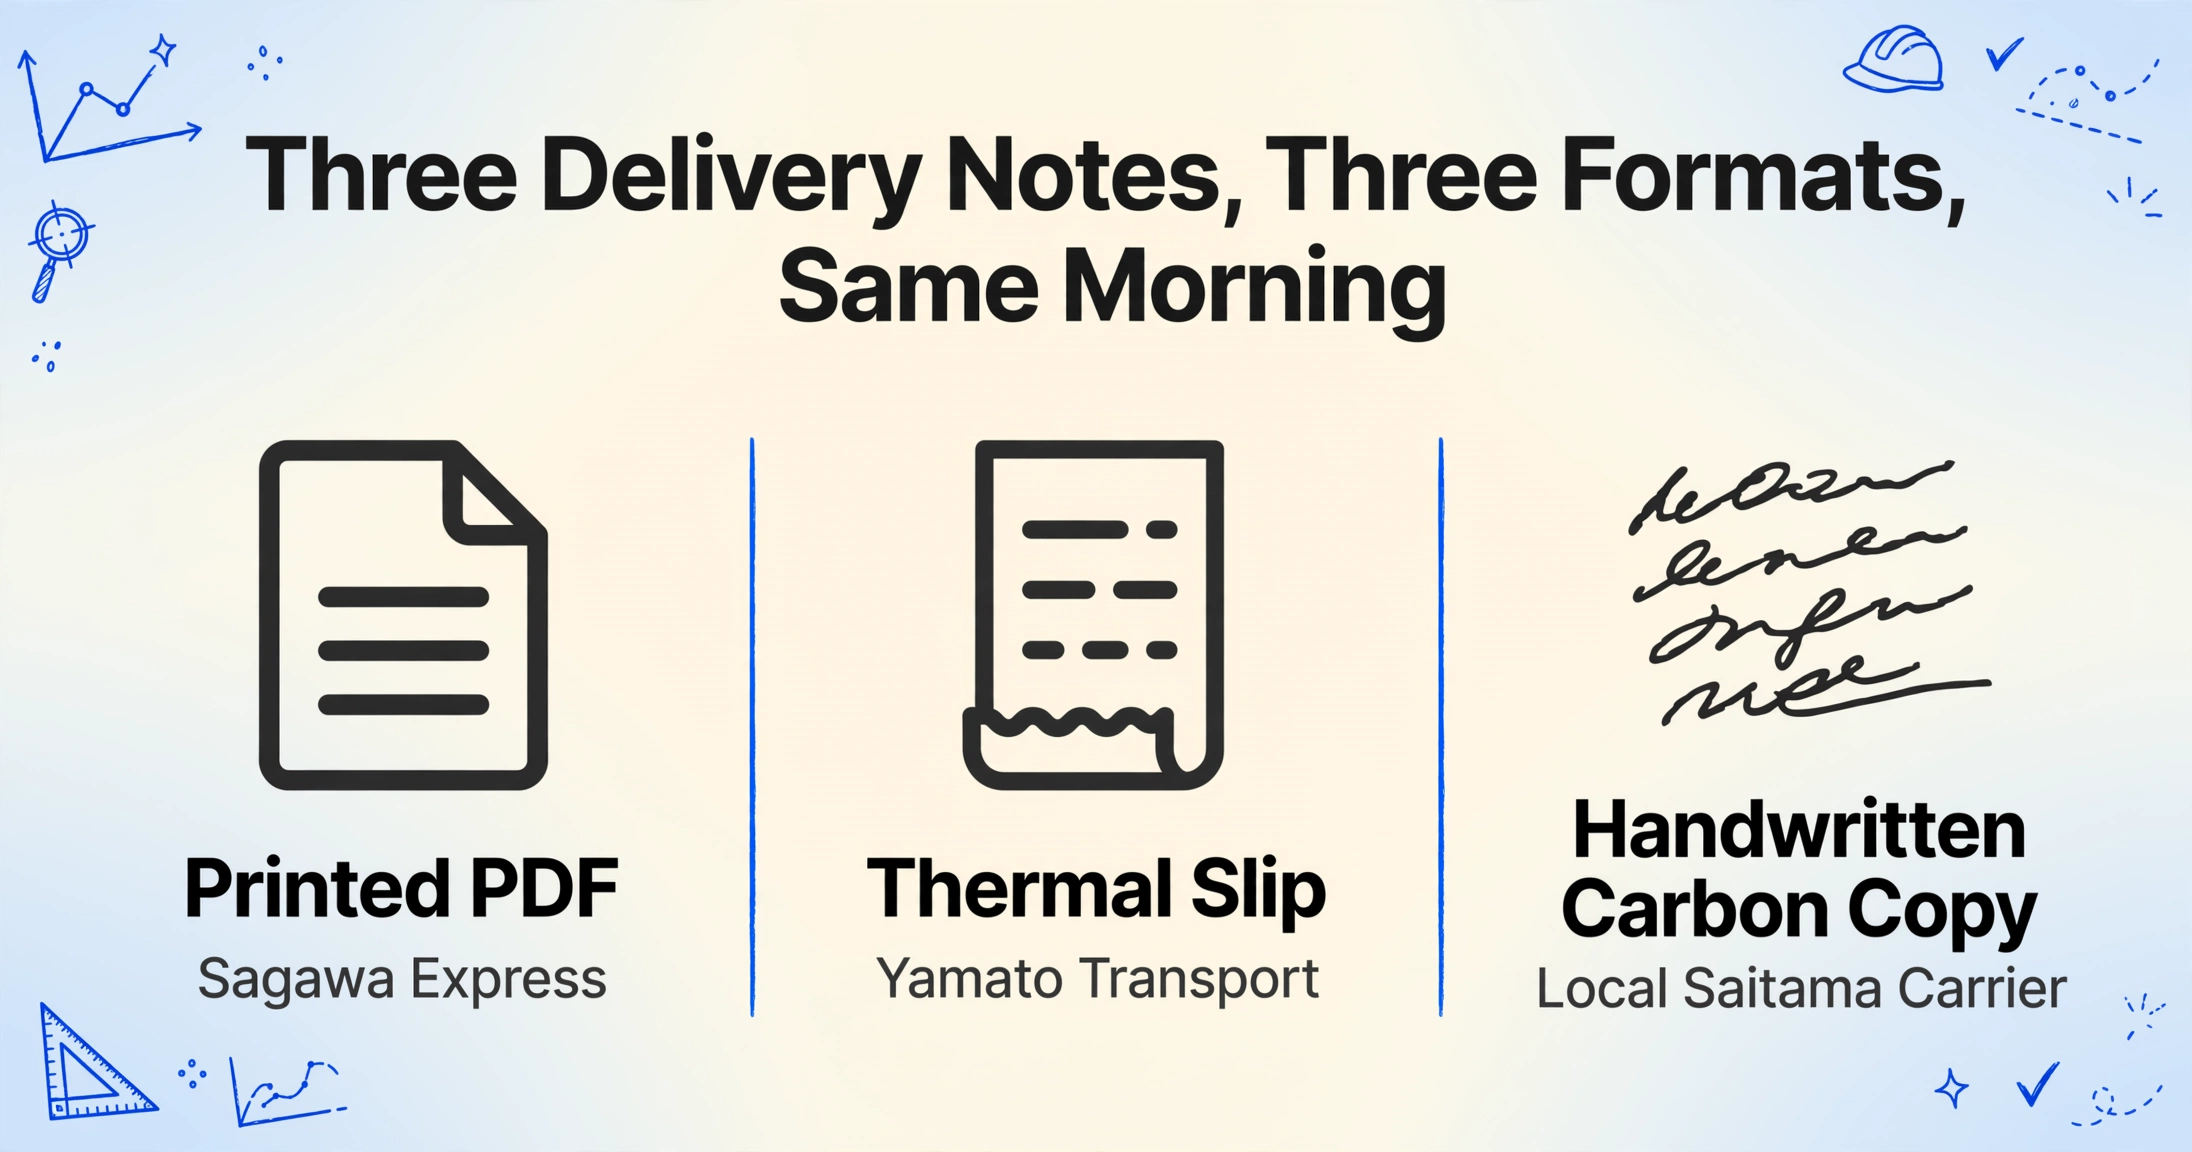
Sagawa Express liefert eine Sendung eines Herstellers aus der Region Kansai. Der Lieferschein kommt als gedrucktes PDF – sauberes Layout, mehrspaltige Tabelle, Artikelnummern und Mengen klar beschriftet. Aber die Feldnamen sind auf Japanisch (品名/数量/単位), das Datum verwendet das japanische Ära-Format (令和8年6月16日), und der Firmenname des Lieferanten erscheint im Kopfbereich ohne explizite Kennzeichnung als „Lieferant".
Yamato Transport bringt eine Sendung eines Lebensmittelzulieferers aus Hokkaido. Deren Lieferschein ist ein Thermorollenbeleg, der von einem Yamato-Logistikzentrum erzeugt wurde – anderes Layout, andere Feldbezeichnungen, andere Spaltenreihenfolge. Ein lokaler Spediteur, der kleine Hersteller in Saitama beliefert, liefert drei Kartons mit einem handschriftlichen Durchschlags-Lieferschein ab. Die Handschrift ist eilig, die Mengen sind in Kartons statt Einheiten angegeben, und der Lieferantenname ist ein Stempel (印鑑) statt gedrucktem Text.
Diese drei Dokumente – die innerhalb desselben 30-Minuten-Fensters eintreffen – stellen völlig unterschiedliche Formate dar. Ein vorlagenbasiertes OCR-Tool bräuchte drei separate Vorlagen, die für drei verschiedene Layouts trainiert wurden. Wenn nächste Woche ein vierter Lieferant mit einem weiteren Format auftaucht, muss das System erneut trainiert werden. Wenn Sagawa im Januar ihre Lieferscheinvorlage ändert (was vorkommt), bricht die alte Vorlage. Deshalb versuchen die meisten japanischen Logistikunternehmen nie, die Lieferscheinerfassung zu automatisieren: Die Wartungskosten für Vorlagen übersteigen die Datenerfassungskosten, die sie eliminieren wollen.
Der Engpass liegt nicht darin, dass Lieferscheindaten komplex sind. Sondern darin, dass dieselben Felder – Lieferantenname, Lieferdatum, Bestellreferenz, Artikelnummer, Menge – auf jedem Dokument an unterschiedlichen Stellen mit unterschiedlichen Bezeichnungen erscheinen. Die traditionelle Automatisierungslösung – eine Vorlage pro Format – scheitert an der Formatvielfalt.
Die Datenfelder auf japanischen Lieferscheinen sind erstaunlich konsistent. Laut dem easymakedocs-Leitfaden zu japanischen Lieferscheinen sind die Standardelemente: Dokumenttitel (納品書), Lieferscheinnummer, Lieferdatum, Kundendaten, Lieferantendaten, Artikeldetails (Name, Menge, Spezifikationen, optionaler Stückpreis) und ein Lieferantenstempel. Die Abweichung entsteht durch das Layout, nicht durch den Inhalt. Ein Yamato-Lieferschein enthält dieselben konzeptionellen Felder wie der handschriftliche Beleg eines lokalen Spediteurs – der Unterschied liegt darin, wo diese Felder auf der Seite stehen und wie sie beschriftet sind. Die Extraktionsherausforderung besteht nicht darin, dass sich die Informationen unterscheiden. Sondern darin, dass das Auffinden über Formate hinweg ein Verständnis dafür erfordert, was ein Feld bedeutet, nicht wo es steht.
Batch-Verarbeitung: Von 30 Dokumenten zu einem strukturierten Wareneingangsprotokoll
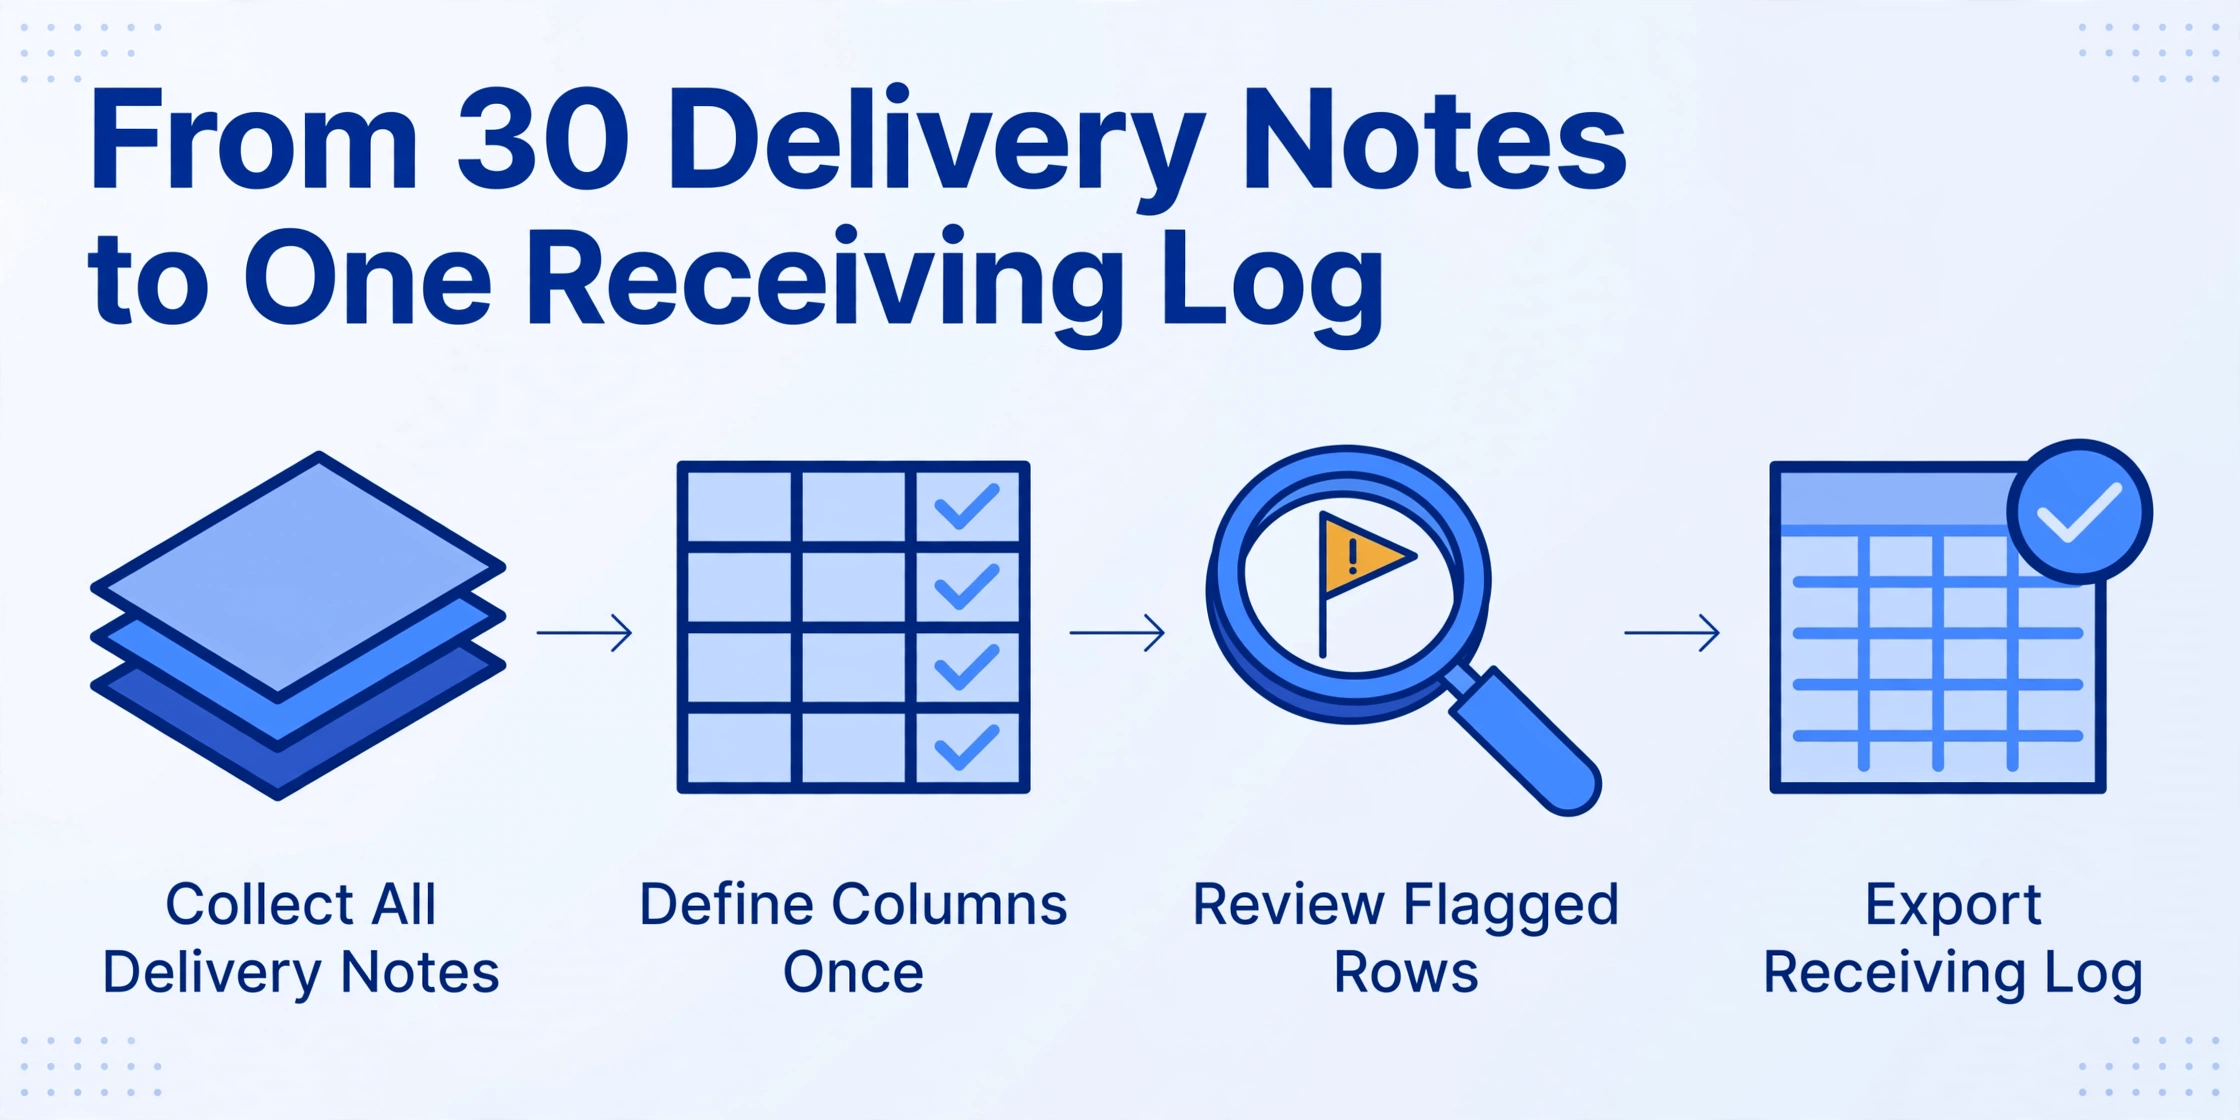
Hier unterscheidet sich die semantische, spaltennamenbasierte Extraktion von der Template-OCR. Statt ein Tool darauf zu trainieren, zu erkennen, wo ein Feld auf dem Layout von Lieferant A und dem Layout von Lieferant B platziert ist, definieren Sie die gewünschten Felder einmal – anhand dessen, was sie darstellen – und die Extraktions-Engine lokalisiert jeden Wert in jedem Dokument des Batches, indem sie dessen Bedeutung versteht.
ImageToTable.ai verwendet die Benutzerdefinierte Spaltenextraktion: Sie geben die Spaltenüberschriften ein, die Sie in Ihrem finalen Wareneingangsprotokoll wünschen – „Lieferantenname", „Lieferdatum", „Bestellnummer", „Artikelcode", „Artikelbeschreibung", „Gelieferte Menge", „Einheit" – und die KI liest jeden Lieferschein im Batch, lokalisiert jedes Feld unabhängig davon, wo es auf der Seite erscheint, und füllt die entsprechende Spalte. Eine Spalte mit dem Namen „Lieferantenname" findet den Lieferanten, egal ob er im Kopfbereich als „株式会社〇〇" gedruckt, als Inkan-Siegel gestempelt oder als „納入元" beschriftet ist – denn die Extraktion ist semantisch, nicht positionsbasiert.
Dateien werden sicher verarbeitet und nicht gespeichert.
Der Arbeitsablauf für ein japanisches Logistik-Wareneingangsteam:
Der Effizienzgewinn ist messbar. Ein einseitiger Lieferschein wird in 5–10 Sekunden durch die Extraktion verarbeitet — eine 18-fache Verbesserung gegenüber der durchschnittlichen manuellen Erfassung von 3 Minuten. Der bedeutendere Gewinn liegt jedoch in der Fehlerreduzierung. Bei 30 Lieferscheinen pro Tag mit durchschnittlich 5 Positionen pro Beleg erzeugt die manuelle Erfassung rund 150 Datenpunkte. Selbst bei einer konservativen Übertragungsfehlerquote von 1 % sind das 1–2 Fehler pro Tag — eine vertauschte Ziffer in einer Artikelnummer, ein falsches Dezimalkomma bei einer Menge. Über einen Monat gelangen 30–60 Fehler in das WMS, in das Drei-Wege-Abgleichsystem und in den Kreditoren-Workflow. Die Batch-Extraktion macht die Prüfung nicht überflüssig — aber sie verwandelt sie von einer Transkriptionsaufgabe in eine Bestätigungsaufgabe, die um Größenordnungen schneller und weniger fehleranfällig ist.
Vom Wareneingangsprotokoll zum Drei-Wege-Abgleich und zur E-Book-Gesetzeskonformität
Das Wareneingangsprotokoll ist nicht der Endpunkt. Es ist die vorgelagerte Eingabe für zwei kritische nachgelagerte Prozesse, die bestimmen, ob ein japanisches Logistikunternehmen korrekt bezahlt wird und prüfbereit bleibt.
Nach dem japanischen Gesetz zur Aufbewahrung elektronischer Bücher (電子帳簿保存法) müssen alle elektronisch gespeicherten Transaktionsdokumente nach drei Kriterien durchsuchbar sein: Transaktionsdatum (取引年月日), Transaktionsbetrag (取引金額) und Geschäftspartner (取引先). Für Unternehmen mit einem Jahresumsatz von über 50 Millionen Yen sind diese Suchbarkeitsanforderungen verpflichtend.
Ein Ordner mit 30 PDF-Lieferscheinen, die nach Belieben des Lieferanten benannt sind – „納品書_20260616.pdf", „delivery_sagawa.pdf", „Scan001.pdf" – besteht den Suchbarkeitstest nicht. Eine strukturierte Tabelle, in der jede Zeile Lieferantenname, Lieferdatum, Bestellnummer, Spediteur, Artikelcode und gelieferte Menge enthält – besteht ihn automatisch. Jedes Kriterium, nach dem das Gesetz eine Suche verlangt, ist eine Spalte in Ihrer Tabelle. Datumsbereichsfilterung, Betragsfilterung, Geschäftspartnersuche – all das wird zu nativen Tabellenkalkulationsvorgängen, nicht zu einer manuellen dateiweisen Suche.
Dies ist ein sekundärer Vorteil der Stapelerfassung, den die meisten Diskussionen über Dokumentenautomatisierung übersehen: Die Extraktion strukturierter Daten aus Lieferscheinen erfüllt gleichzeitig die japanischen Anforderungen an die elektronische Speicherung. Die Original-PDFs müssen weiterhin für die gesetzliche Aufbewahrungsfrist aufbewahrt werden (7 Jahre für Transaktionsdokumente nach dem Verbrauchsteuergesetz, 10 Jahre für Handelsbücher nach dem Handelsgesetz) – aber für den schnellen Zugriff während einer Steuerprüfung ist die extrahierte Tabelle das Werkzeug, das Ihr Team tatsächlich verwendet.
Das Wareneingangsprotokoll speist auch direkt in den Drei-Wege-Abgleich ein, der die Zahlung an den Lieferanten autorisiert. Nach gängiger japanischer Beschaffungspraxis sollte keine Rechnung genehmigt werden, bis die Mengen und Artikel auf dem Lieferschein sowohl gegen die Bestellung (発注書) als auch gegen die Rechnung (請求書) bestätigt wurden. Dies ist die Bestellung → Lieferschein → Rechnung Prüfkette. Der Drei-Wege-Abgleich kann jedoch nur automatisiert werden, wenn alle drei Dokumente strukturierte Daten sind:
Ein strukturiertes Wareneingangsprotokoll – exportiert aus der Batch-Extraktion in Excel oder CSV – wird zur Brücke, die den Kreislauf des Drei-Wege-Abgleichs schließt. Die extrahierten Daten können direkt in freee, MoneyForward Cloud, Yayoi (弥生) oder das WMS des Unternehmens importiert werden. Für Unternehmen, die SAP Japan, GLOVIA smart (Fujitsu) oder EXPLANNER (NEC) einsetzen, lässt sich der CSV-Export auf Standard-Importformate für Wareneingangsbuchungen abbilden. Der Drei-Wege-Abgleich wandelt sich von einem manuellen, dokumentenweisen Abgleich zu einer systematischen Ausnahmeprüfung: Nur die Zeilen, in denen die Bestellmenge ≠ gelieferte Menge ist, erfordern menschliche Aufmerksamkeit.
Für Logistikunternehmen, die täglich 30 Lieferungen von Lieferanten über eine Mischung aus großen Spediteuren (NX, Sagawa, Yamato) und lokalen Transportunternehmen abwickeln, ist der Unterschied zwischen einem strukturierten und einem unstrukturierten Wareneingangsprotokoll der Unterschied zwischen einer 2,5-stündigen Tippschicht und einer 5-minütigen Tabellenprüfung. Hochgerechnet auf 20 Arbeitstage im Monat bedeutet das 50 gewonnene Stunden – mehr als eine Vollzeitstelle – für Ausnahmeuntersuchungen, Spediteurkommunikation oder jede andere Aufgabe, die eine Tastatur nicht automatisieren kann.
Häufig gestellte Fragen
Kann das Lieferhinweise von großen japanischen Spediteuren und kleinen lokalen Transportunternehmen verarbeiten?
Ja. Die semantische Extraktion liest Lieferscheine, indem sie die Bedeutung jedes Feldes versteht – nicht dessen Position auf der Seite. Eine Spalte mit dem Namen „Lieferantenname“ findet den Lieferanten, egal ob er im Kopf eines Sagawa-PDFs gedruckt, als Inkan-Stempel auf einem Durchschlag oder handschriftlich auf dem Lieferschein eines lokalen Spediteurs vermerkt ist. Dies ist der grundlegende Unterschied zur templatebasierten OCR, die für jedes Layout eine separate Vorlage benötigt. Sie definieren Ihre Wareneingangsspalten einmal, und sie funktionieren über alle Lieferantenformate hinweg – auch für neue, die Sie noch nicht gesehen haben.
Was ist, wenn ein Lieferschein japanische Jahresdaten (令和) anstatt gregorianische verwendet?
Das Extraktionsergebnis kann das ursprüngliche Jahresformat beibehalten oder beim Export automatisch umwandeln. Falls Ihr nachgelagertes System gregorianische Daten erfordert (z. B. für den ERP-Import), konvertiert die Nachbearbeitungsebene des Tools 令和8年6月16日 beim Export in 2026-06-16. Sie definieren die Spalte als „Lieferdatum“ und steuern das Ausgabeformat – keine manuelle Datumsumrechnung erforderlich.
Wie lässt sich das in unser bestehendes WMS (SAP, GLOVIA, freee, MoneyForward) integrieren?
Das Extraktionsergebnis – eine Excel- oder CSV-Datei – kann in jedes WMS oder ERP importiert werden, das CSV-Importe für Wareneingangstransaktionen unterstützt. Freee und MoneyForward Cloud akzeptieren CSV-basierte Buchungssatzimporte (仕訳インポート). SAP Japan und Oracle Japan unterstützen CSV-basierte Wareneingangslastimporte. Der Extraktionsschritt ist vom Importschritt getrennt – Sie steuern, wann und wie Daten in Ihr System gelangen. Weitere Informationen zu Workflows für die Extraktion japanischer Lieferscheine finden Sie in unserem Leitfaden zum Extrahieren japanischer Lieferscheindaten in Excel.
Kann es handschriftliche japanische Lieferscheine lesen?
Ja. Das Vision-Modell verarbeitet handschriftlichen Text, einschließlich japanischer Schriftzeichen auf Durchschlag-Lieferscheinen lokaler Spediteure. Die Genauigkeit bei Handschrift ist geringer als bei gedrucktem Text – insbesondere bei hastiger, verschmierter oder kontrastarmer Schrift – daher profitieren handschriftliche Felder von einer kurzen Sichtprüfung während des Überprüfungsschritts. Das Tool erzeugt keine falsche Sicherheit bei minderwertigen Eingaben; es zeigt Unsicherheit an, anstatt zu raten. Bei einer Charge von 30 Lieferscheinen, von denen vielleicht 3–5 handschriftlich sind, konzentriert sich der Überprüfungsschritt auf diese wenigen Dokumente, während die 25+ gedruckten PDFs mit nahezu perfekter Genauigkeit verarbeitet werden.
Erfüllt die Batch-Extraktion die Anforderungen des Gesetzes zur Aufbewahrung elektronischer Bücher (電子帳簿保存法)?
Die Batch-Extraktion erstellt eine strukturierte Tabelle, die die drei Suchkriterien erfüllt: Transaktionsdatum, Transaktionsbetrag und Gegenpartei – mit Bereichsangabe und Kombinationssuche, die nativ durch Tabellenfilter unterstützt wird. Das Gesetz verlangt jedoch weiterhin die Aufbewahrung der ursprünglichen Lieferscheindateien (PDFs, Scans oder Fotos) für den gesetzlichen Zeitraum. Die extrahierte Tabelle ist Ihr durchsuchbares Verzeichnis und Arbeitsdokument; die Originaldateien sind Ihr rechtliches Archiv. Beide müssen aufbewahrt werden. Einzelheiten zu den Suchbarkeitsanforderungen finden Sie in den Richtlinien der NTA zur elektronischen Buchführung.
Was ist mit Lieferscheinen, die mit Rechnungen kombiniert sind (納品書兼請求書)?
Einige japanische Lieferanten – insbesondere im B2B-Fertigungsbereich – stellen kombinierte Lieferschein-/Rechnungsdokumente aus (納品書兼請求書). Diese Dokumente enthalten sowohl Lieferdaten (Artikelbeschreibungen, Mengen) als auch Abrechnungsdaten (Einzelpreise, Steueraufschlüsselungen, Zahlungsbedingungen). Bei der Batch-Verarbeitung kombinierter Dokumente können Sie beide Datensätze in einem Durchgang extrahieren, indem Sie Spalten sowohl für Liefer- als auch für Rechnungsfelder definieren. Die Ausgabetabelle enthält alle Daten in einer Zeile pro Dokument, und Sie können die Spalten nach Bedarf für Ihre nachgelagerten Wareneingangs- und Kreditorenbuchhaltungs-Workflows aufteilen oder filtern.
Jedes japanische Logistikunternehmen hat den Warenverkehr automatisiert. Das Dokument, das beweist, was bewegt wurde – der 納品書 – ist das letzte Stück Papier, das noch manuell verarbeitet wird. Die Batch-Extraktion verwandelt eine 2,5-stündige Tippschicht in eine 5-minütige Tabellenprüfung. Und die dabei erzeugten Daten sparen nicht nur Zeit – sie versorgen den Drei-Wege-Abgleich, erfüllen das Gesetz zur Aufbewahrung elektronischer Bücher und speisen das Wareneingangsprotokoll in jedes nachgelagerte System, das auf strukturierte Eingaben gewartet hat.