Comment traiter par lots les bons de livraison japonais de plusieurs fournisseurs en un seul journal de réception
Traitez par lots une journée de 納品書 (nōsho) provenant de plusieurs fournisseurs japonais en un journal de réception unifié — sans configuration de modèle par fournisseur.
Pourquoi le quai de réception japonais repose sur la saisie manuelle des données
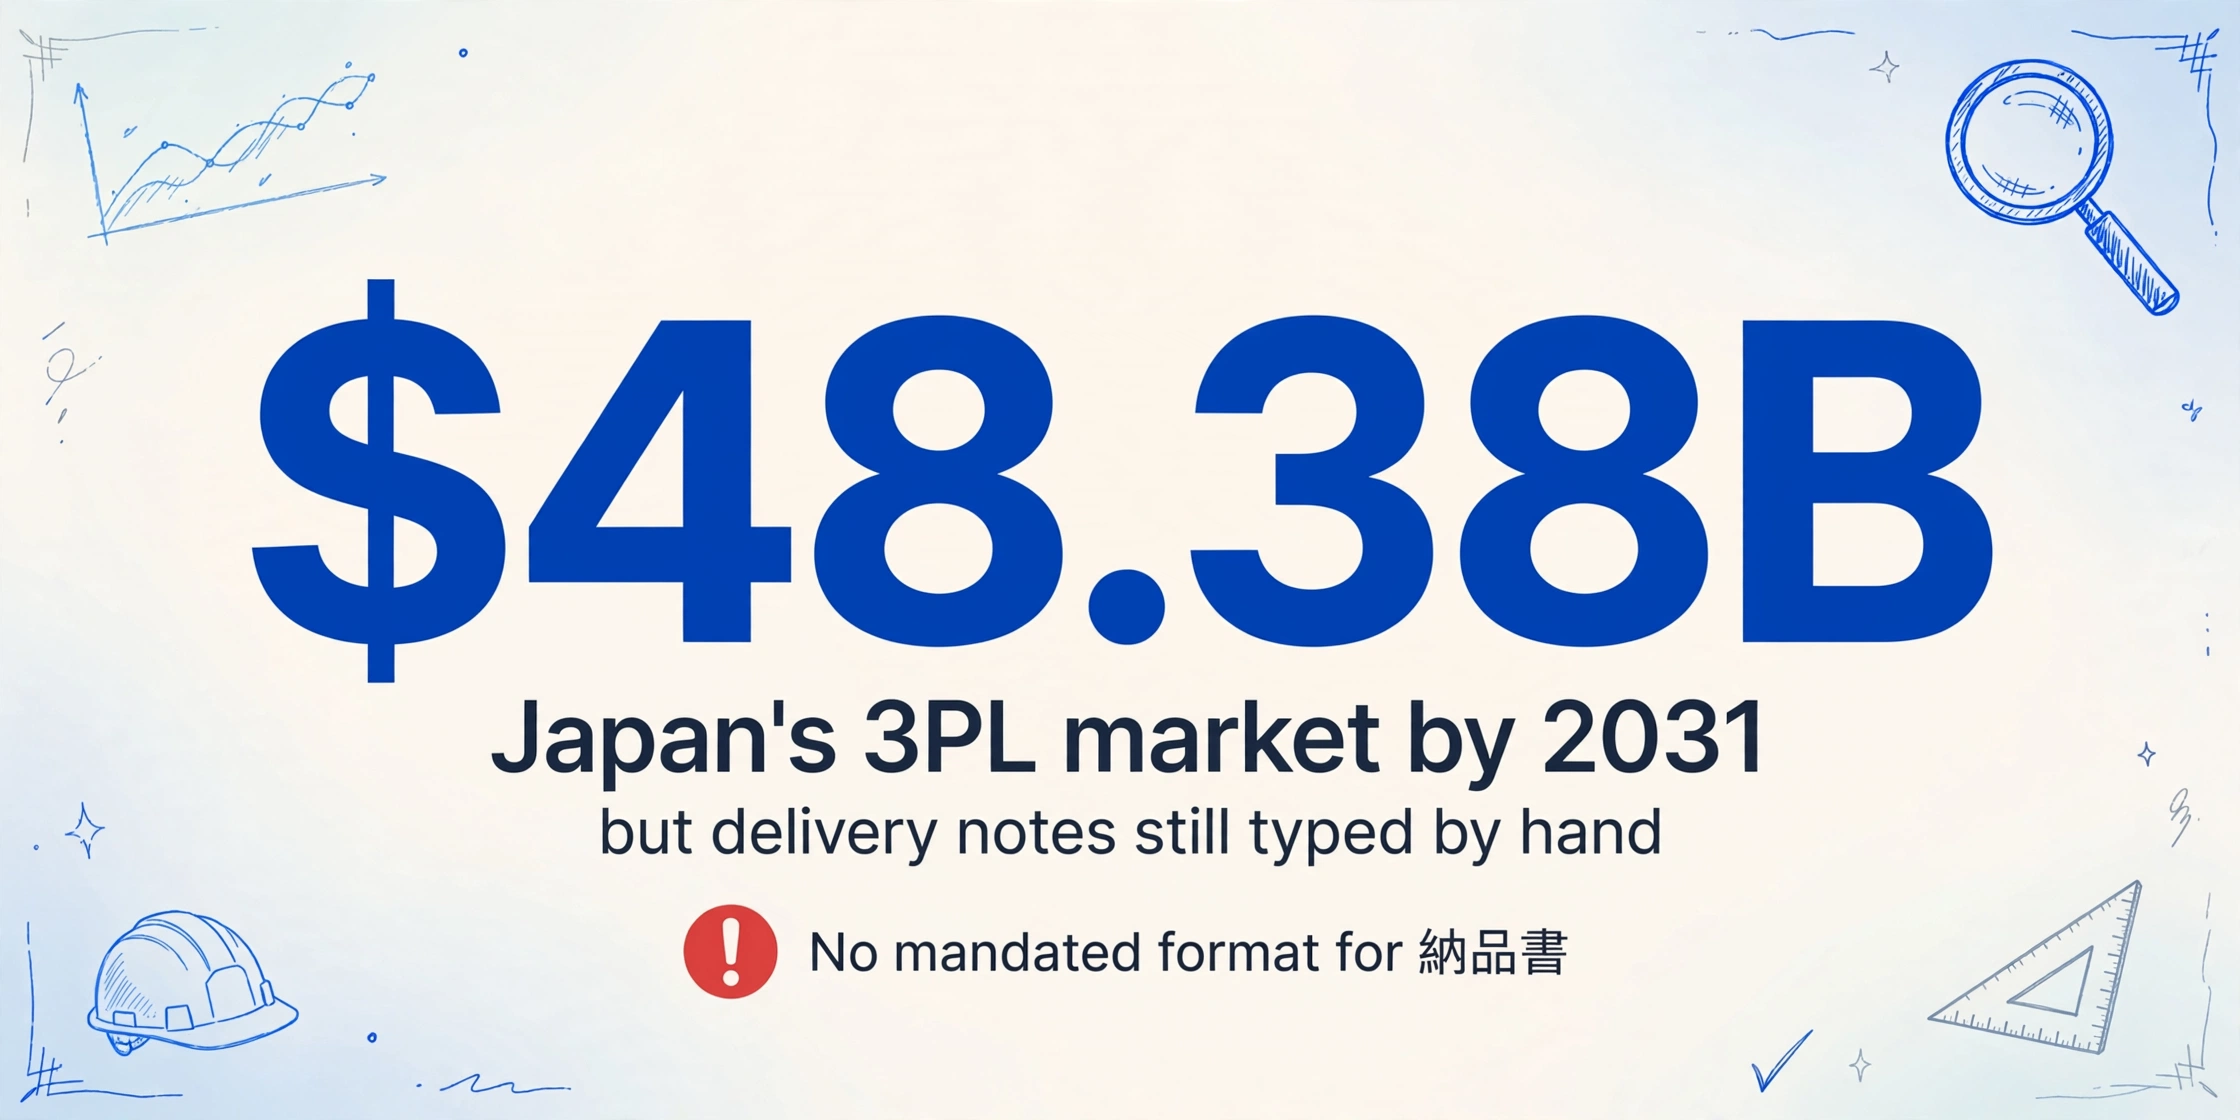
Le marché japonais de la 3PL — qui dessert la logistique de la fabrication, de la vente au détail et du commerce électronique dans tous les secteurs — devrait atteindre 48,38 milliards de dollars US d'ici 2031. Mais le document qui prouve ce qui est arrivé sur le camion est toujours traité de la même manière qu'il y a 30 ans : quelqu'un le lit, saisit les données et espère ne pas avoir inversé un chiffre.
Les systèmes de gestion d'entrepôt au Japon ont automatisé presque tous les processus physiques. Les lecteurs de codes-barres à la porte du quai capturent les identifiants des palettes. Les étiquettes RFID suivent l'emplacement des stocks en temps réel. Les véhicules à guidage automatique déplacent les marchandises entre les zones sans intervention humaine. Nippon Express (NX GROUP), le plus grand prestataire 3PL du pays, exploite des plateformes WMS qui orchestrent la réception, le stockage et la préparation de commandes avec une précision milliseconde. Mais chacun de ces systèmes partage la même dépendance : ils ont besoin de données structurées pour commencer leur travail. Un WMS peut mettre à jour les niveaux de stock lorsqu'il reçoit une transaction numérique — mais cette transaction ne peut être créée qu'après que quelqu'un a lu le bon de livraison et saisi les données.
Ce n'est pas une défaillance de la technologie logistique japonaise. C'est un problème de format de document déguisé en problème de saisie de données. Le bon de livraison (納品書) n'est pas un document légalement requis par le code de commerce japonais — contrairement à la facture (請求書), que le système de factures qualifiées (インボイス制度) normalise depuis octobre 2023. Le bon de livraison n'a ni format imposé, ni champs obligatoires, ni norme numérique équivalente à Peppol ou Factur-X. Chaque fournisseur imprime, tape ou écrit à la main son bon de livraison selon ce que produit son back-office.
La technologie logistique japonaise a automatisé le mouvement des marchandises. Elle n'a pas automatisé la lecture des documents qui identifient ces marchandises. L'écart entre un code-barres sur une palette et les données du bon de livraison qui indiquent au système à quel bon de commande la palette appartient — cet écart est toujours comblé par un humain et un clavier.
Pourquoi votre WMS voit les palettes mais pas les bons de livraison
Pour comprendre pourquoi cet écart persiste, il faut examiner ce qui arrive réellement sur un quai de réception japonais un mardi matin typique.
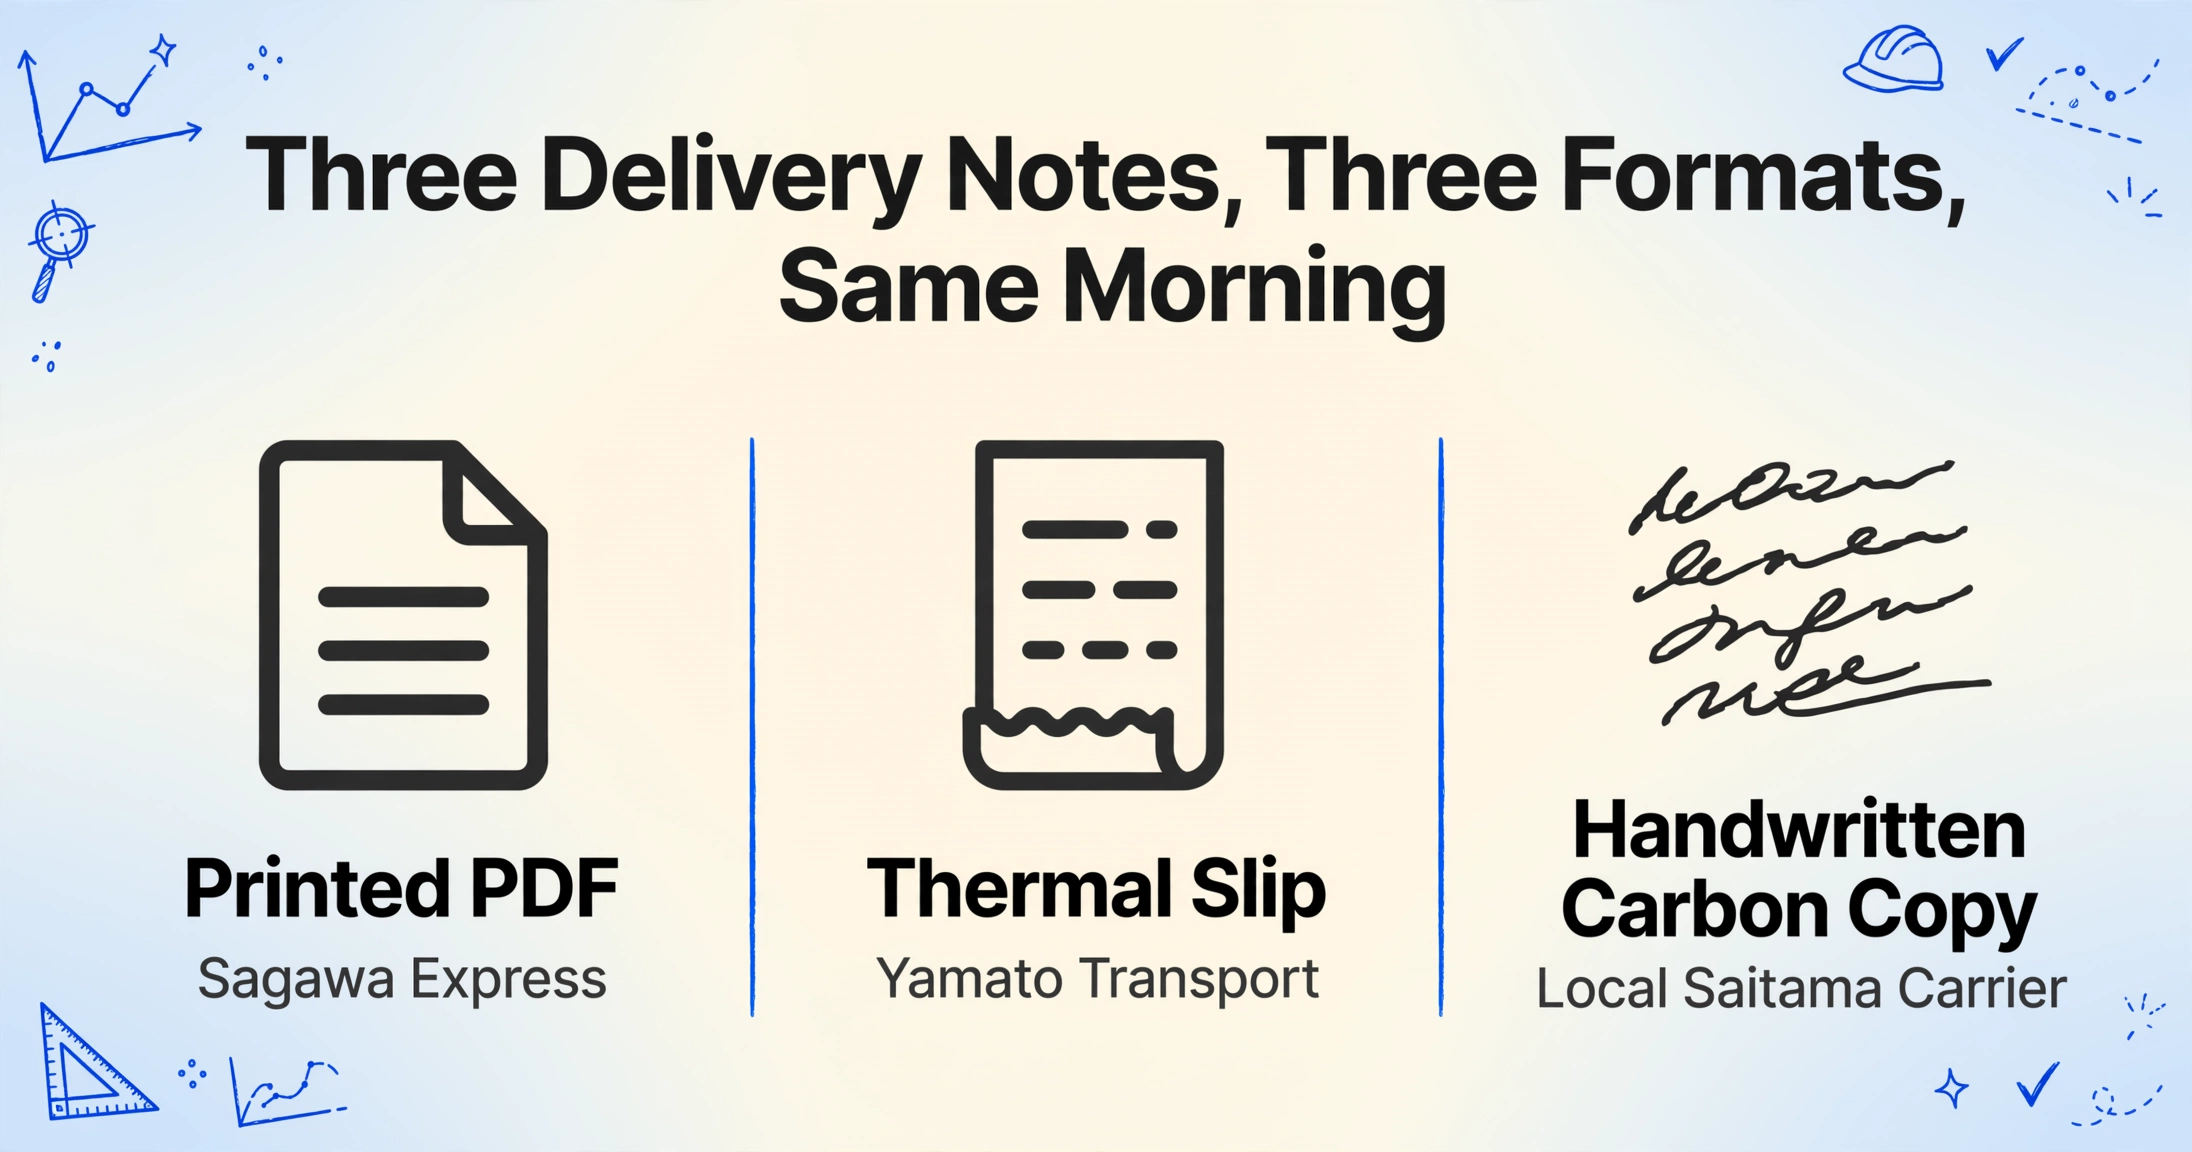
Sagawa Express livre une expédition d'un fabricant basé au Kansai. Le bon de livraison arrive sous forme de PDF imprimé — mise en page propre, tableau multi-colonnes, codes article et quantités clairement indiqués. Mais les noms de champs sont en japonais (品名/数量/単位), la date utilise le format d'ère japonais (令和8年6月16日), et le nom de l'entreprise du fournisseur apparaît dans l'en-tête sans libellé explicite « Fournisseur ».
Yamato Transport livre une expédition d'un fournisseur alimentaire d'Hokkaido. Leur bon de livraison est un ticket imprimé thermiquement généré par un centre logistique Yamato — mise en page différente, libellés de champs différents, ordre des colonnes différent. Un transporteur local desservant les petits fabricants de Saitama dépose trois cartons avec un bon de livraison manuscrit en copie carbone. L'écriture est rapide, les quantités sont en cartons et non en unités, et le nom du fournisseur est un tampon (印鑑) plutôt qu'un texte imprimé.
Ces trois documents — arrivés dans la même fenêtre de 30 minutes — représentent des formats complètement différents. Un outil OCR basé sur des modèles nécessiterait trois modèles distincts entraînés pour trois mises en page différentes. Quand un quatrième fournisseur apparaîtra la semaine prochaine avec un autre format, le système devra être réentraîné. Si Sagawa modifie son modèle de bon de livraison en janvier (ce qui arrive), l'ancien modèle casse. C'est pourquoi la plupart des entreprises logistiques japonaises ne tentent jamais d'automatiser l'extraction des bons de livraison : le coût de maintenance des modèles dépasse le coût de saisie manuelle qu'elles cherchent à éliminer.
Le goulot d'étranglement n'est pas que les données des bons de livraison soient complexes. C'est que les mêmes champs — nom du fournisseur, date de livraison, référence de bon de commande, code article, quantité — apparaissent à des endroits différents avec des libellés différents sur chaque document. La réponse traditionnelle de l'automatisation — un modèle par format — s'effondre face à la diversité des formats.
Les champs de données des bons de livraison japonais sont étonnamment cohérents. Selon le guide easymakedocs sur les bons de livraison japonais, les éléments standard sont : le titre du document (納品書), le numéro de bon de livraison, la date de livraison, les informations client, les informations fournisseur, les détails des articles (nom, quantité, spécifications, prix unitaire optionnel), et un tampon du fournisseur. La variation vient de la mise en page, pas du contenu. Un bon de livraison Yamato contient les mêmes champs conceptuels qu'un ticket manuscrit d'un transporteur local — la différence réside dans l'emplacement de ces champs sur la page et dans leur libellé. Le défi de l'extraction n'est pas que l'information diffère. C'est que la localiser à travers les formats exige de comprendre ce que signifie un champ, pas où il se trouve.
Traitement par lots : de 30 documents à un journal de réception structuré
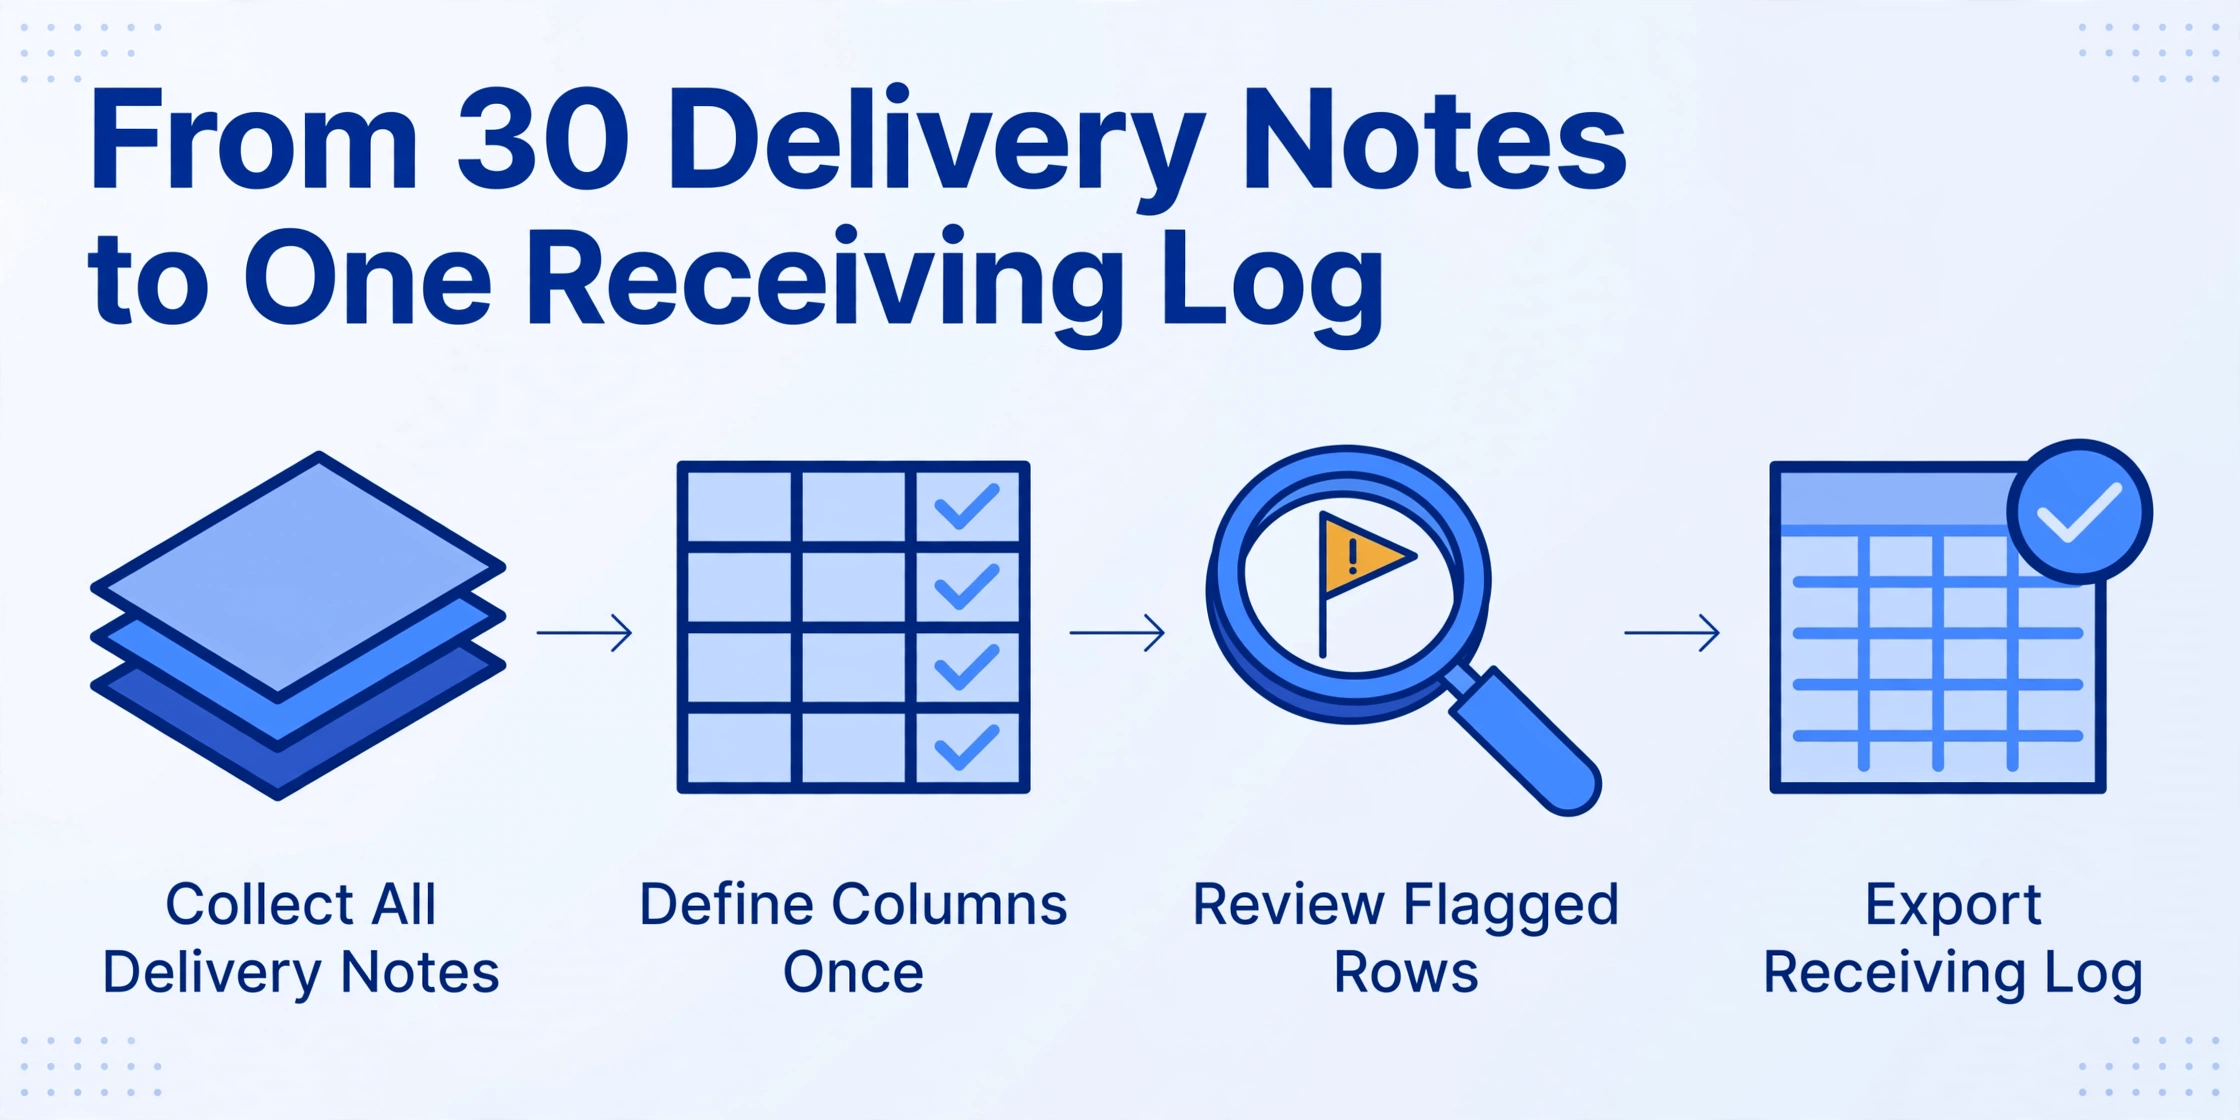
C'est là que l'extraction sémantique basée sur les noms de colonnes se distingue de l'OCR basé sur des modèles. Au lieu d'entraîner un outil à reconnaître l'emplacement d'un champ sur la mise en page du fournisseur A et celle du fournisseur B, vous définissez les champs souhaités une seule fois — selon ce qu'ils représentent — et le moteur d'extraction localise chaque valeur dans chaque document du lot en comprenant sa signification.
ImageToTable.ai utilise l'Extraction de colonnes personnalisées : vous saisissez les en-têtes de colonnes souhaités dans votre journal de réception final — « Nom du fournisseur », « Date de livraison », « N° de commande », « Code article », « Description de l'article », « Quantité livrée », « Unité » — et l'IA lit chaque bon de livraison du lot, localise chaque champ quel que soit son emplacement sur la page et remplit la colonne correspondante. Une colonne nommée « Nom du fournisseur » trouvera le fournisseur qu'il soit imprimé dans l'en-tête sous la forme « 株式会社〇〇 », apposé sous forme de sceau inkan, ou libellé « 納入元 » — car l'extraction est sémantique, et non positionnelle.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le flux de travail pour une équipe de réception logistique japonaise :
Le gain d'efficacité est mesurable. Un bon de livraison d'une page est traité en 5 à 10 secondes via l'extraction — une amélioration de 18× par rapport à la saisie manuelle moyenne de 3 minutes. Mais le gain le plus important est la réduction des erreurs. Avec 30 bons de livraison par jour et une moyenne de 5 lignes chacun, la saisie manuelle produit environ 150 points de données. Même avec un taux d'erreur de transcription conservateur de 1 %, cela représente 1 à 2 erreurs par jour — un chiffre inversé dans un code article, une décimale erronée dans une quantité. Sur un mois, 30 à 60 erreurs se propagent dans le WMS, dans le système de rapprochement à trois voies et dans le flux de travail de la comptabilité fournisseurs. L'extraction par lots ne supprime pas le besoin de vérification — mais elle le transforme d'une tâche de transcription en une tâche de confirmation, ce qui est des ordres de grandeur plus rapide et moins sujet aux erreurs.
Du journal de réception au rapprochement à trois et à la conformité à la loi sur les livres électroniques
Le journal de réception n'est pas une destination finale. C'est l'entrée en amont de deux processus aval critiques qui déterminent si une entreprise de logistique japonaise est payée avec précision et reste prête pour un audit.
En vertu de la loi japonaise sur la conservation des livres électroniques (電子帳簿保存法), tous les documents de transaction stockés électroniquement doivent pouvoir être recherchés selon 3 critères : date de transaction (取引年月日), montant de la transaction (取引金額) et contrepartie (取引先). Pour les entreprises dont le chiffre d'affaires annuel dépasse 50 millions de yens, ces exigences de recherche sont obligatoires.
Un dossier de 30 bons de livraison PDF nommés selon le bon vouloir du fournisseur — « 納品書_20260616.pdf », « delivery_sagawa.pdf », « Scan001.pdf » — échoue au test de recherche. Un tableur structuré où chaque ligne contient le nom du fournisseur, la date de livraison, le numéro de commande, le transporteur, le code article et la quantité livrée — réussit automatiquement. Chaque critère que la loi vous oblige à rechercher est une colonne de votre tableur. Filtrage par plage de dates, filtrage par montant, recherche par contrepartie — tout devient des opérations natives du tableur, pas une chasse manuelle fichier par fichier.
C'est un avantage secondaire de l'extraction par lots que la plupart des discussions sur l'automatisation des documents négligent : l'acte d'extraire des données structurées des bons de livraison satisfait simultanément à la conformité japonaise au stockage électronique. Les PDF originaux doivent toujours être conservés pendant la période légale (7 ans pour les documents de transaction en vertu de la loi sur la taxe à la consommation, 10 ans pour les livres commerciaux en vertu du code de commerce) — mais pour une récupération rapide lors d'un contrôle fiscal, le tableur extrait est l'outil que votre équipe utilise réellement.
Le journal de réception alimente également directement le processus de rapprochement à trois qui autorise le paiement au fournisseur. Selon la pratique standard d'approvisionnement japonaise, aucune facture ne doit être approuvée tant que les quantités et les articles du bon de livraison n'ont pas été confirmés par rapport au bon de commande (発注書) et à la facture (請求書). C'est la chaîne de vérification Commande → Bon de livraison → Facture. Mais le rapprochement à trois ne peut être automatisé que si les trois documents sont des données structurées :
Un journal de réception structuré — exporté depuis l'extraction par lots vers Excel ou CSV — devient le pont qui boucle le rapprochement à trois voies. Les données extraites peuvent être importées directement dans freee, MoneyForward Cloud, Yayoi (弥生) ou le WMS de l'entreprise. Pour les entreprises utilisant SAP Japan, GLOVIA smart (Fujitsu) ou EXPLANNER (NEC), la sortie CSV correspond aux formats d'import standard des transactions de réception. Le rapprochement à trois voies passe d'une réconciliation manuelle document par document à une revue systématique des exceptions : seules les lignes où la quantité du bon de commande ≠ la quantité livrée nécessitent une attention humaine.
Pour les entreprises de logistique qui traitent 30 livraisons fournisseurs par jour avec un mélange de grands transporteurs (NX, Sagawa, Yamato) et de transporteurs locaux, la différence entre un journal de réception structuré et non structuré est la différence entre un poste de saisie de 2,5 heures et une revue de feuille de calcul de 5 minutes. Multiplié par 20 jours ouvrés par mois, cela représente 50 heures récupérées — plus qu'un poste à temps plein — pour l'investigation des exceptions, la communication avec les transporteurs ou toute autre tâche qu'un clavier ne peut pas automatiser.
Questions fréquentes
Peut-il traiter les bordereaux de livraison des grands transporteurs japonais et des petites sociétés de transport locales ?
Oui. L'extraction sémantique lit les bordereaux en comprenant la signification de chaque champ, et non son emplacement sur la page. Une colonne nommée « Nom du fournisseur » localisera le fournisseur, qu'il soit imprimé dans l'en-tête d'un PDF Sagawa, apposé sous forme de sceau inkan sur un bordereau carbone, ou écrit à la main sur un formulaire de transporteur local. C'est la différence fondamentale avec l'OCR basé sur des modèles, qui nécessite un modèle distinct pour chaque mise en page. Vous définissez une fois les colonnes de votre registre de réception, et elles fonctionnent pour tous les formats de fournisseurs, y compris ceux que vous n'avez jamais vus.
Que faire si un bordereau utilise les dates d'ère japonaise (令和) au lieu du calendrier grégorien ?
Le résultat de l'extraction peut conserver le format de date d'ère d'origine ou le convertir automatiquement lors de l'exportation. Si votre système en aval nécessite des dates grégoriennes (par exemple, pour l'importation dans un ERP), la couche de post-traitement de l'outil convertit 令和8年6月16日 en 2026-06-16 lors de l'exportation. Vous définissez la colonne comme « Date de livraison » et contrôlez le format de sortie — aucune conversion manuelle de date requise.
Comment cela s'intègre-t-il à notre WMS existant (SAP, GLOVIA, freee, MoneyForward) ?
Le résultat de l'extraction — un fichier Excel ou CSV — peut être importé dans tout WMS ou ERP prenant en charge les importations CSV pour les transactions de réception. Freee et MoneyForward Cloud acceptent les importations d'écritures de journal basées sur CSV (仕訳インポート). SAP Japan et Oracle Japan prennent en charge les chargements de transactions de réception basés sur CSV. L'étape d'extraction est distincte de l'étape d'importation — vous contrôlez comment et quand les données entrent dans votre système. Pour en savoir plus sur les workflows d'extraction de bordereaux de livraison japonais, consultez notre guide d'extraction de données de bordereaux de livraison japonais vers Excel.
Peut-il lire les bordereaux de livraison japonais manuscrits ?
Oui. Le modèle de vision traite le texte manuscrit, y compris les caractères japonais sur les bordereaux carbone des transporteurs locaux. La précision sur l'écriture manuscrite est inférieure à celle du texte imprimé — en particulier pour les écritures rapides, tachées ou à faible contraste — les champs manuscrits bénéficient donc d'une vérification visuelle rapide lors de l'étape de révision. L'outil ne donne pas une fausse impression de confiance sur les entrées de faible qualité ; il signale l'incertitude plutôt que de deviner. Pour un lot de 30 bordereaux dont 3 à 5 sont manuscrits, l'étape de révision se concentre sur ces quelques documents tandis que les 25+ PDF imprimés sont traités avec une précision quasi parfaite.
L'extraction par lots est-elle conforme à la loi sur la conservation des livres électroniques (電子帳簿保存法) ?
L'extraction par lots produit un tableau structuré qui répond aux trois critères de recherche : date de transaction, montant de transaction et contrepartie — avec possibilité de spécifier une plage et d'effectuer des recherches combinées via le filtrage natif du tableur. Cependant, la loi exige toujours la conservation des fichiers originaux des bordereaux de livraison (PDF, scans ou photos) pendant la durée légale. Le tableau extrait est votre index de recherche et votre registre de travail ; les fichiers originaux constituent vos archives légales. Les deux doivent être conservés. Pour plus de détails sur les exigences de recherche, consultez les directives de l'ANR sur la tenue de registres électroniques.
Qu'en est-il des bordereaux de livraison combinés avec des factures (納品書兼請求書) ?
Certains fournisseurs japonais — notamment dans le secteur manufacturier B2B — émettent des documents combinés bordereau de livraison/facture (納品書兼請求書). Ces documents contiennent à la fois des données de livraison (descriptions des articles, quantités) et des données de facturation (prix unitaires, détails de la taxe, conditions de paiement). Lors du traitement par lots de documents combinés, vous pouvez extraire les deux ensembles de champs en une seule passe en définissant des colonnes pour les champs de livraison et de facturation. Le tableau de sortie contiendra toutes les données sur une ligne par document, et vous pourrez diviser ou filtrer les colonnes selon les besoins de vos flux de réception et de comptabilité fournisseurs en aval.
Toutes les entreprises de logistique japonaises ont automatisé le mouvement des marchandises. Le document qui prouve ce qui a été déplacé — le 納品書 — est le dernier morceau de papier encore traité manuellement. L'extraction par lots le transforme d'un quart de travail de saisie de 2h30 en une revue de tableur de 5 minutes. Et les données qu'elle produit ne font pas que gagner du temps : elles alimentent le rapprochement à trois, satisfont à la loi sur la conservation des livres électroniques et intègrent le journal de réception dans tous les systèmes en aval qui attendaient des données structurées.