複数の仕入先からの日本の納品書を一括処理して1つの受領ログにまとめる方法
複数の日本の仕入先からの1日分の納品書を、仕入先ごとのテンプレート設定なしで統一された受領ログに一括処理します。
なぜ日本の入荷ドックは手入力に依存しているのか
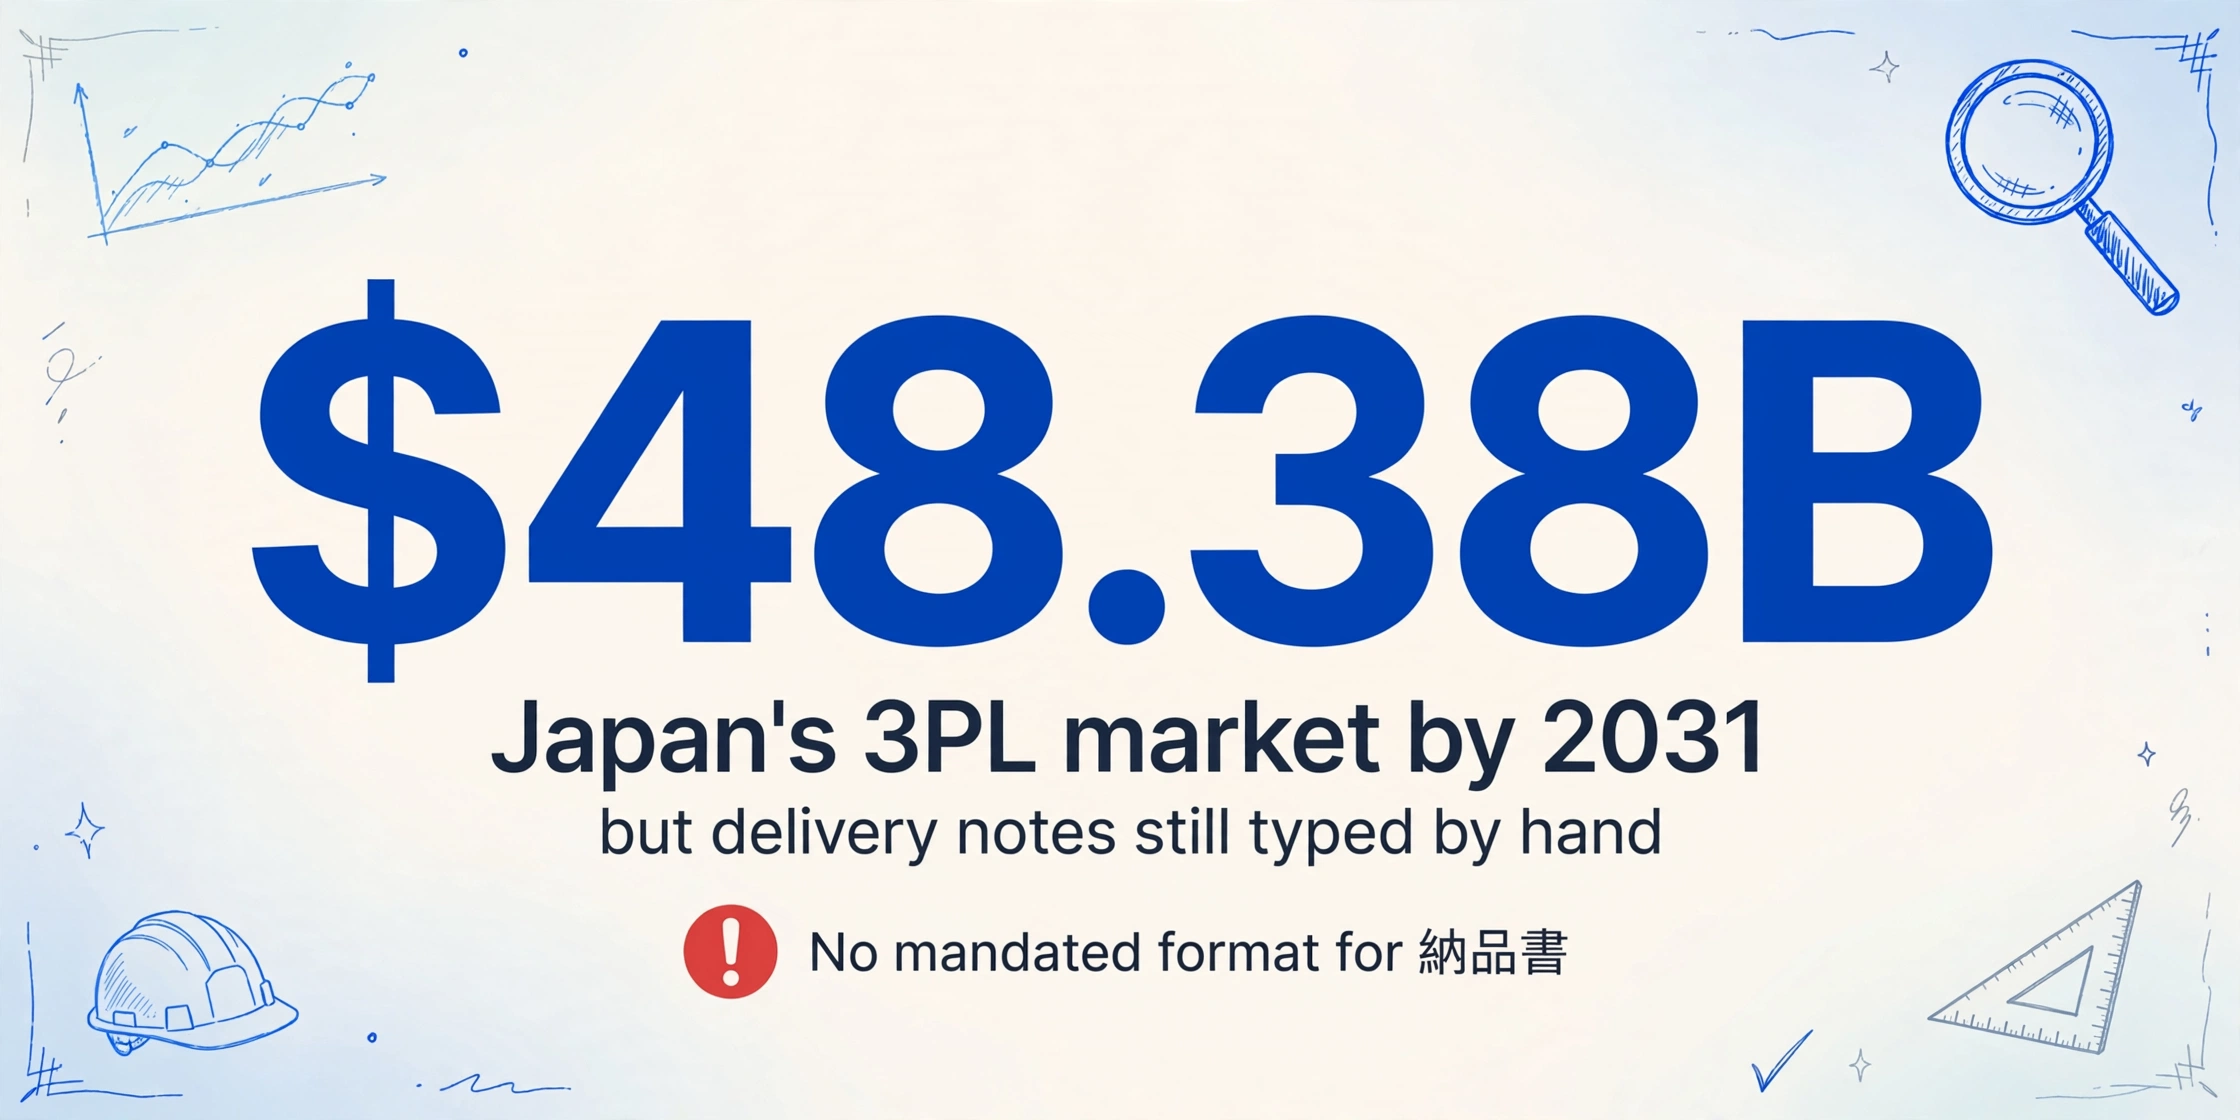
日本の3PL市場は、製造業・小売・ECなど幅広い業界の物流を支え、2031年までに483億8000万ドルに達すると予測されています。しかし、トラックで届いたものを証明する書類は、今も30年前と同じ方法で処理されています。誰かがそれを読み、データを打ち込み、数字を打ち間違えていないことを願う、という方法です。
日本の倉庫管理システムは、物理的なプロセスのほぼすべてを自動化してきました。ドックドアのバーコードスキャナーがパレットIDを読み取り、RFIDタグが在庫位置をリアルタイムで追跡し、無人搬送車が人手を介さずにゾーン間で商品を移動させます。国内最大の3PLであるNX GROUP(日本通運)は、入荷・棚入れ・ピッキングをミリ秒単位の精度で統制するWMSプラットフォームを運用しています。しかし、これらのシステムはすべて同じ依存関係を共有しています。それは、作業を開始するには構造化されたデータが必要だということです。WMSはデジタルトランザクションを受け取れば在庫レベルを更新できますが、そのトランザクションは、誰かが納品書を読み、データを打ち込んだ後にしか作成できません。
これは日本の物流技術の失敗ではありません。データ入力の問題に見せかけた、書類フォーマットの問題なのです。納品書は、日本の商法上、法的に義務付けられた書類ではありません。2023年10月から標準化が進められている請求書(インボイス制度)とは異なります。納品書には、義務付けられた形式も必須項目もなく、PeppolやFactur-Xに相当するデジタル標準もありません。各サプライヤーは、自社のバックオフィスが生成する方法で、納品書を印刷・入力・手書きしています。
日本の物流技術は、モノの移動を自動化しました。しかし、そのモノを特定する書類を読むことは自動化していません。パレット上のバーコードと、そのパレットがどの発注書に属するかをシステムに伝える納品書データとの間のギャップ——そのギャップは今もなお、人間とキーボードによって埋められています。
WMSがパレットを認識しても納品書を認識できない理由
このギャップがなぜ解消されないのかを理解するには、日本の受け入れ現場に典型的な火曜日の朝に何が届くのかを見てみるのが早い。
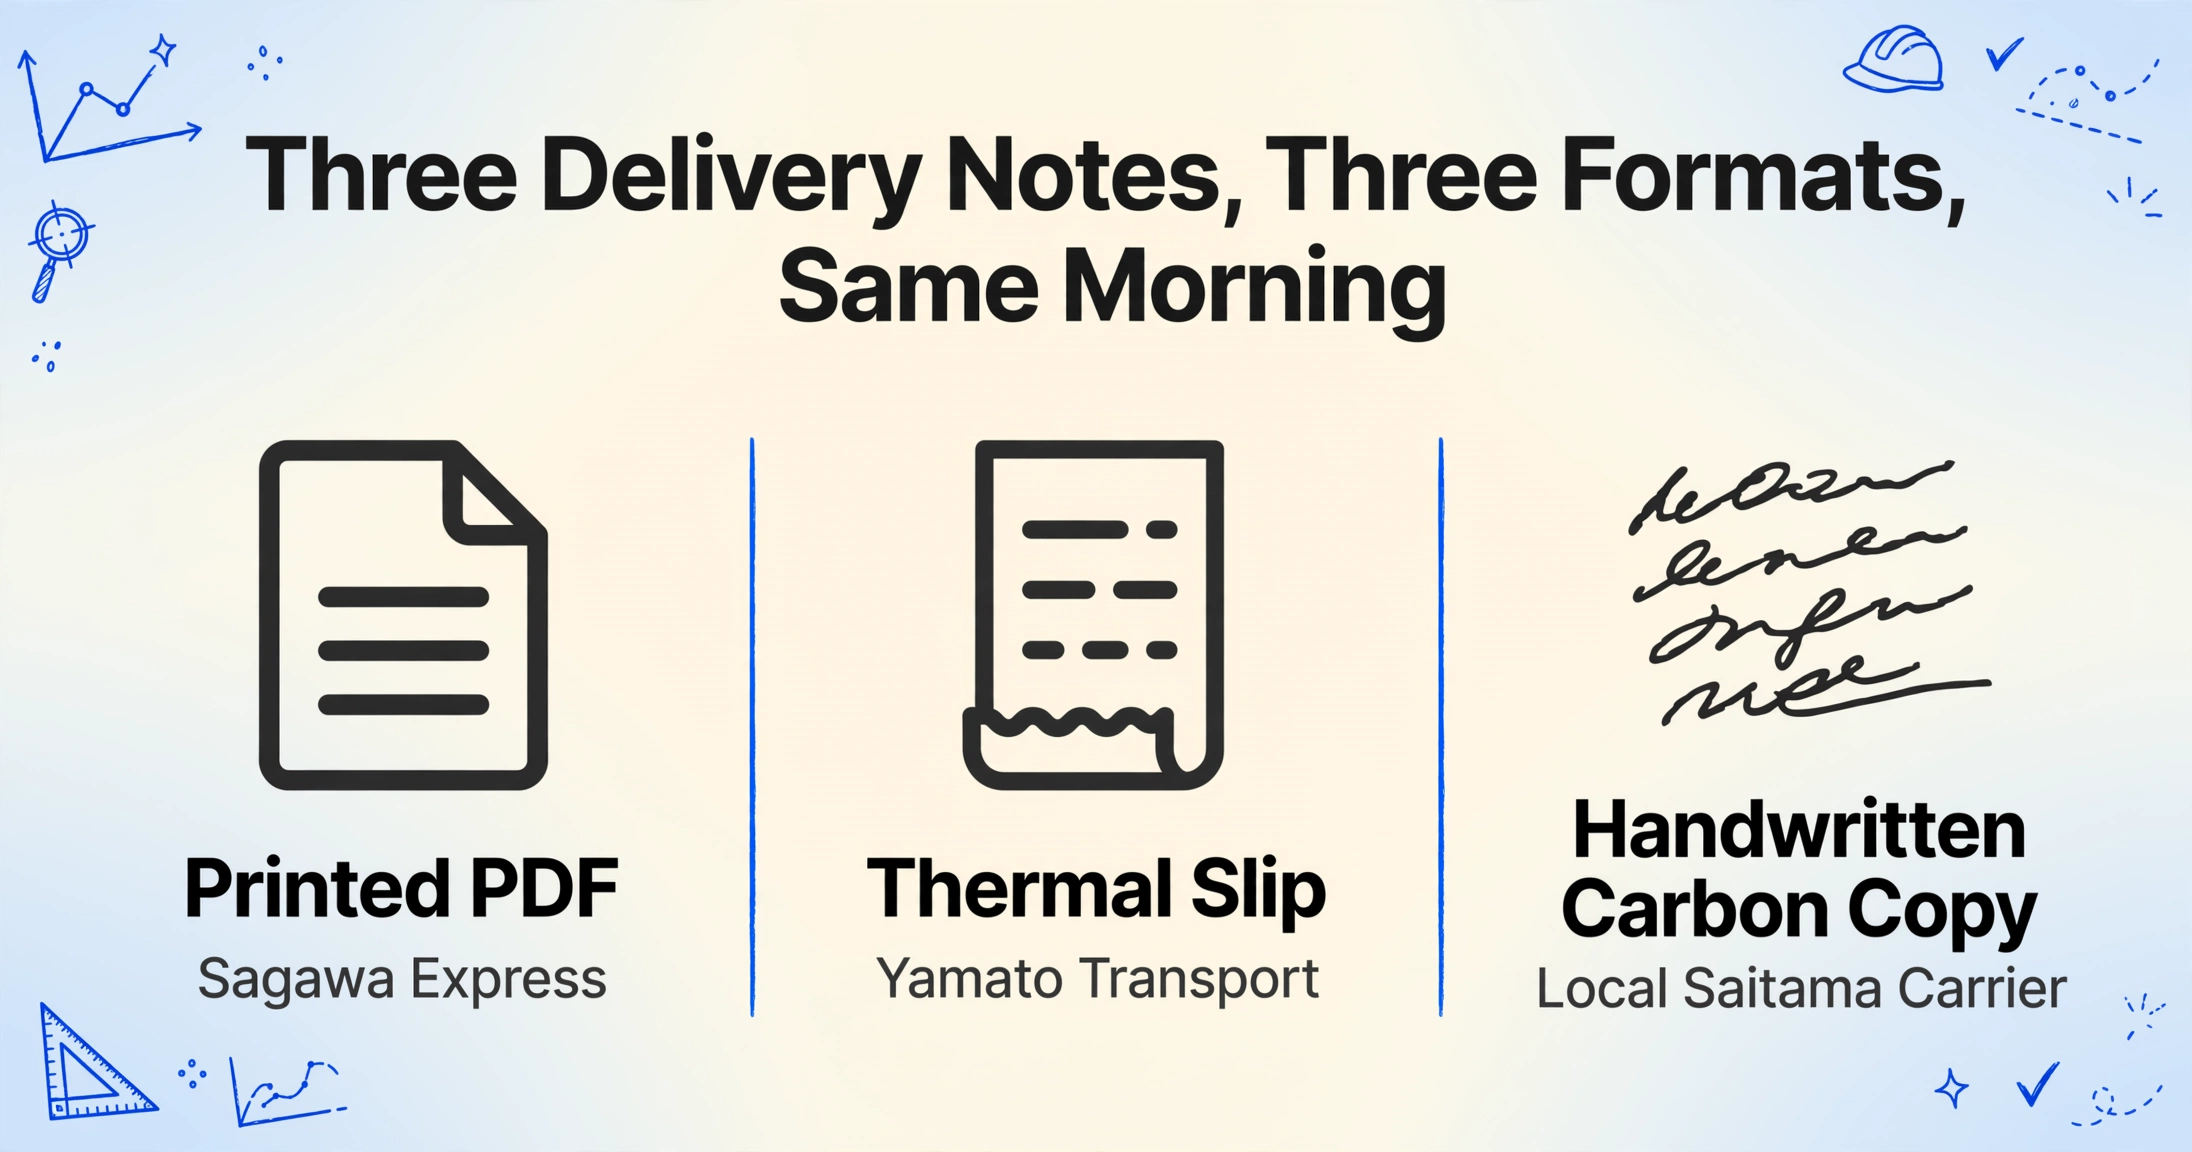
Sagawa Expressが関西のメーカーからの荷物を届ける。納品書は印刷されたPDFで届く——きれいなレイアウト、複数列のテーブル、品目コードと数量が明確にラベル付けされている。ただし、フィールド名は日本語(品名/数量/単位)で、日付は和暦形式(令和8年6月16日)で表記され、仕入先の会社名はヘッダーに「仕入先」という明示的なラベルなしで表示されている。
Yamato Transportが北海道の食品サプライヤーからの荷物を届ける。その納品書はヤマトの物流センターが発行する感熱紙伝票だ——レイアウトもフィールドラベルも列の順序も異なる。埼玉の中小メーカーを担当する地元運送会社は、手書きのカーボンコピー納品書とともに3箱を届ける。筆跡は走り書きで、数量は単位ではなく箱数で記載され、仕入先名は印刷テキストではなく印鑑で押されている。
これら3つの書類——同じ30分の間に届く——は、まったく異なる形式を表している。テンプレートベースのOCRツールでは、3つの異なるレイアウトに対応するために3つの別々のテンプレートを訓練する必要がある。来週、さらに別の形式の4社目のサプライヤーが現れたら、システムは再び訓練が必要になる。Sagawaが1月に納品書テンプレートを変更したら(実際に起こることだ)、古いテンプレートは使えなくなる。これが、ほとんどの日本の物流企業が納品書の自動抽出に着手しない理由だ:テンプレートのメンテナンスコストが、排除しようとしているデータ入力コストを上回ってしまうからだ。
ボトルネックは納品書データが複雑なことではない。同じフィールド——仕入先名、納品日、注文書番号、品目コード、数量——が、書類ごとに異なる場所に異なるラベルで存在することだ。従来の自動化の答え——形式ごとに1つのテンプレート——は、形式の多様性の前で崩壊する。
日本の納品書のデータフィールドは驚くほど一貫している。easymakedocsの日本語納品書ガイドによると、標準的な要素は:書類タイトル(納品書)、納品書番号、納品日、顧客情報、仕入先情報、品目詳細(名称、数量、仕様、任意の単価)、および仕入先の印鑑である。違いは内容ではなくレイアウトから生じる。ヤマトの納品書には、地元運送会社の手書き伝票と同じ概念上のフィールドが含まれている——違いは、それらのフィールドがページ上のどこにあり、どのようにラベル付けされているかだ。抽出の課題は情報が異なることではない。形式をまたいで情報を特定するには、フィールドがどこにあるかではなく、何を意味するかを理解する必要があるのだ。
バッチ処理: 30件のドキュメントから1つの構造化された納品受領ログへ
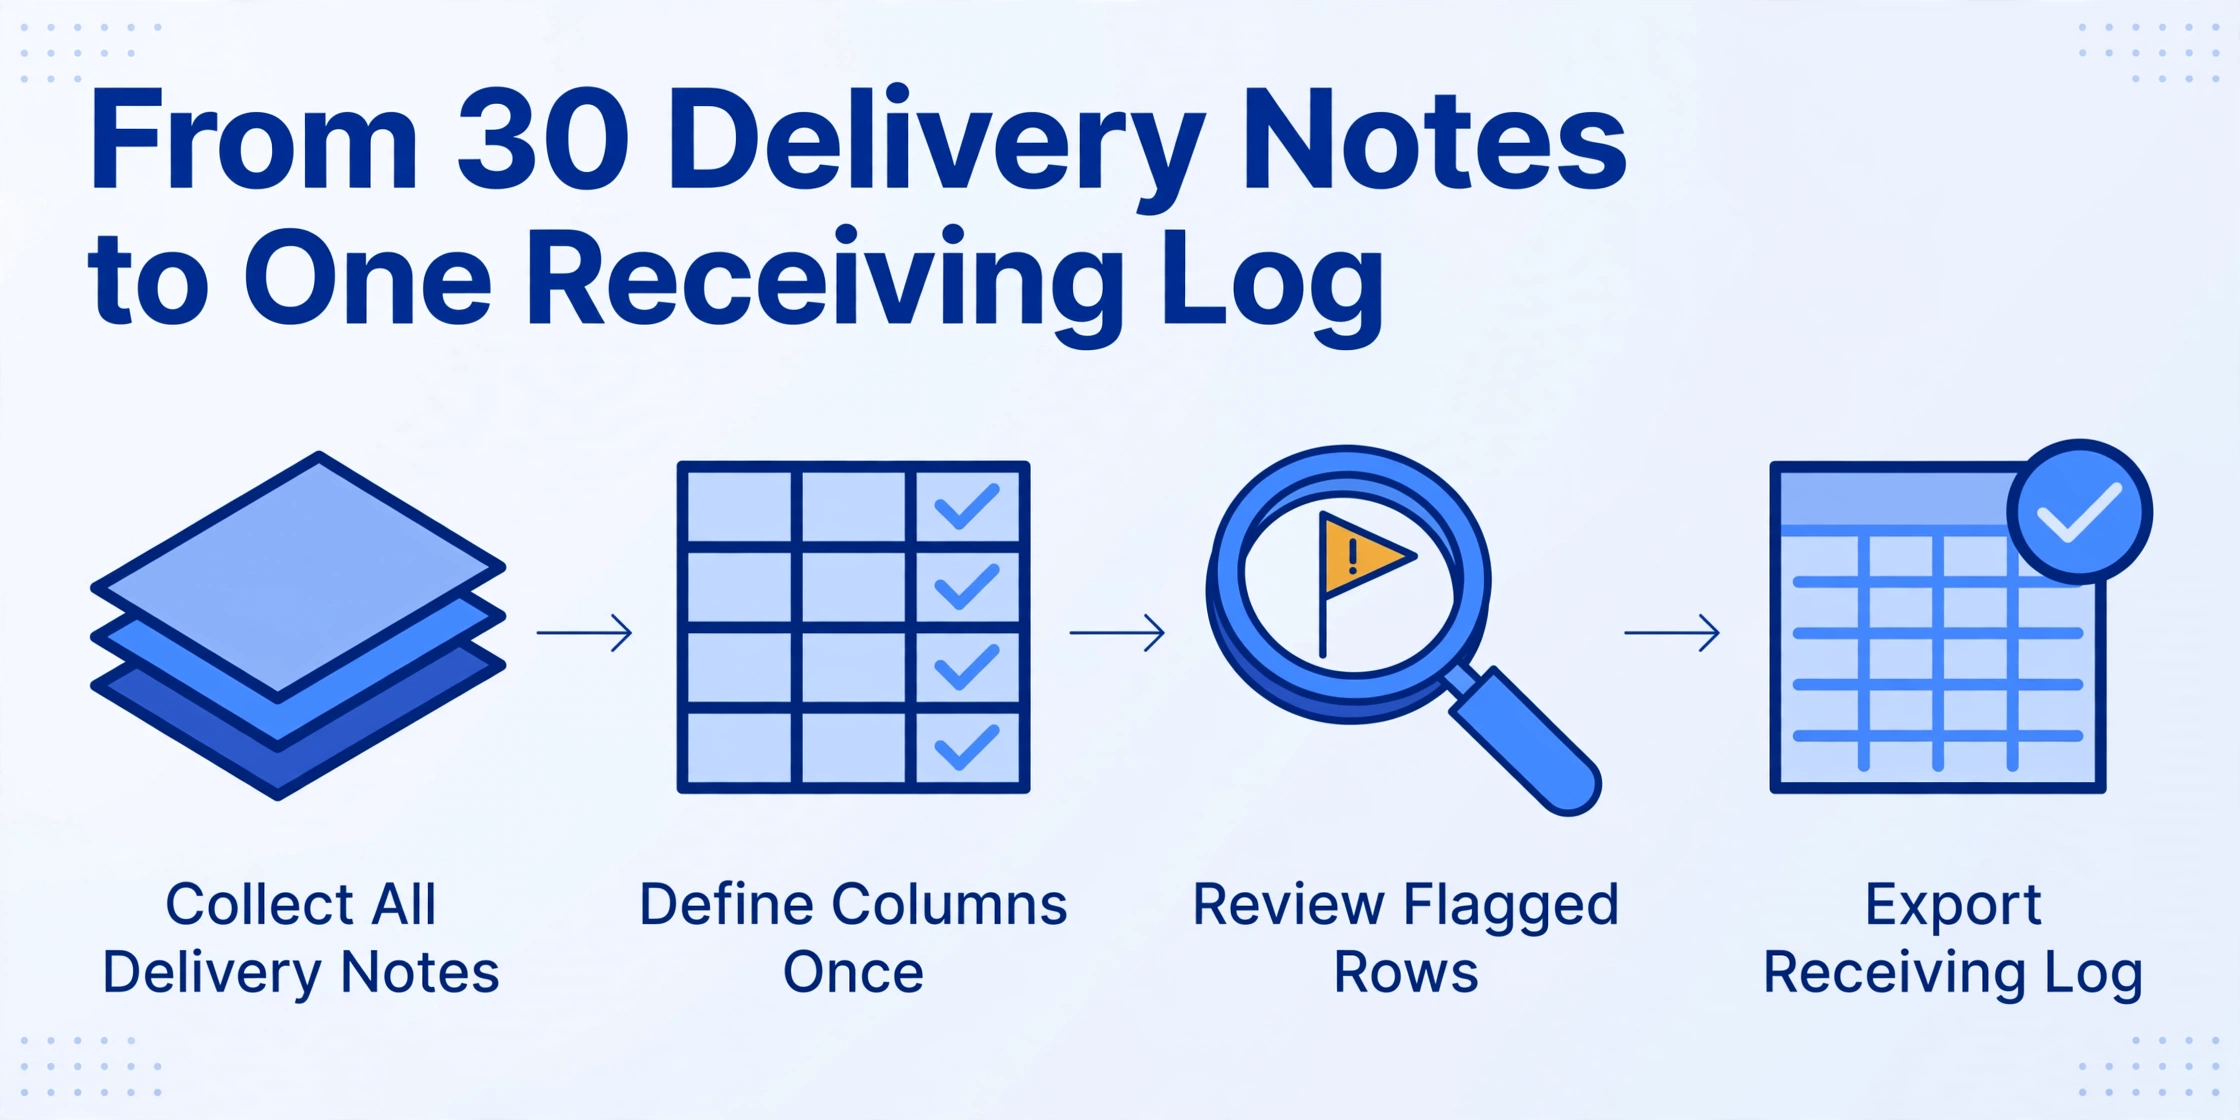
ここで、意味論的・列名ベースの抽出がテンプレートOCRと分かれます。ツールにサプライヤーAのレイアウトとサプライヤーBのレイアウトのどこにフィールドがあるかを認識させる代わりに、必要なフィールドを一度だけ定義します — それが何を表すかによって — そして抽出エンジンはその意味を理解することで、バッチ内のすべてのドキュメントにわたって各値を特定します。
ImageToTable.aiはカスタム列抽出を使用します: 最終的な受領ログに必要な列ヘッダーを入力するだけで — 「仕入先名」「納品日」「PO番号」「品目コード」「品目説明」「納入数量」「単位」 — AIはバッチ内の各納品書を読み取り、ページ上のどこに表示されるかに関係なく各フィールドを特定し、対応する列に入力します。「仕入先名」という名前の列は、ヘッダーに「株式会社〇〇」と印刷されていても、印鑑として押されていても、「納入元」とラベル付けされていても仕入先を見つけ出します — 抽出は位置ベースではなく意味論ベースだからです。
ファイルは安全に処理され、保存されません。
日本の物流受領チームのワークフロー:
効率性の向上は数値で明確です。1ページの納品書は抽出処理に5〜10秒かかり、平均3分の手入力と比較して18倍の改善です。しかし、より重要なのはエラー削減の効果です。1日30件の納品書、各5明細行とすると、手入力では約150のデータポイントが発生します。控えめに見積もっても1%の転記エラー率で、1日あたり1〜2件のエラーが発生します—品番の桁違い、数量の小数点の誤りなどです。1か月では30〜60件のエラーがWMS、三者照合システム、買掛金ワークフローに波及します。バッチ抽出は検証の必要性をなくすわけではありませんが、転記作業から確認作業へと変えることで、桁違いに速く、エラーもはるかに少なくなります。
受領ログから3Wayマッチと電子帳簿保存法対応へ
受領ログは終着点ではありません。それは、日本の物流企業が正確に支払いを受け、監査対応を維持するために不可欠な、2つの重要な下流プロセスへの上流インプットです。
日本の電子帳簿保存法では、電子的に保存されたすべての取引書類は、取引年月日、取引金額、取引先の3つの基準で検索可能でなければなりません。年商5,000万円超の事業者にとって、これらの検索要件は必須です。
サプライヤーが任意に命名した30件のPDF納品書 — 「納品書_20260616.pdf」「delivery_sagawa.pdf」「Scan001.pdf」など — は、検索可能性のテストに不合格です。一方、サプライヤー名、納品日、発注番号、キャリア、品目コード、納品数量を各行に含む構造化されたスプレッドシートは、自動的に合格します。法律で検索が求められるすべての基準が、スプレッドシートの列になります。日付範囲フィルタリング、金額フィルタリング、取引先検索 — すべてがネイティブなスプレッドシート操作となり、手作業でのファイル単位の探索は不要です。
これは、文書自動化の議論で見落とされがちなバッチ抽出の副次的な利点です。納品書から構造化データを抽出する行為は、同時に日本の電子保存コンプライアンスを満たします。元のPDFは法定保存期間(消費税法上の取引書類は7年、会社法上の商業帳簿は10年)保持する必要がありますが、税務調査中の迅速な検索には、抽出されたスプレッドシートがチームが実際に使用するツールです。
受領ログはまた、サプライヤー支払いを承認する3Wayマッチプロセスに直接供給されます。標準的な日本の購買慣行では、納品書の数量と品目が発注書と請求書の両方に対して確認されるまで、請求書は承認されるべきではありません。これが発注書 → 納品書 → 請求書の検証チェーンです。しかし、3Wayマッチは、3つの文書すべてが構造化データである場合にのみ自動化できます。
バッチ抽出からExcelまたはCSVにエクスポートされた構造化された受領ログは、三者照合ループを完了させる橋渡しとなります。抽出されたデータはfreee、MoneyForward Cloud、弥生、または自社のWMSに直接インポートできます。SAP Japan、GLOVIA smart(富士通)、EXPLANNER(NEC)を利用している企業の場合、CSV出力は標準の受領取引インポート形式に対応します。三者照合は、文書ごとの手作業による照合から、体系的な例外レビューへと移行します。発注数量≠納品数量の行のみが人の目を必要とします。
主要キャリア(NX、Sagawa、Yamato)と地場運送会社が混在する中で、1日30件の仕入先納品を処理する物流企業にとって、構造化された受領ログと非構造化された受領ログの違いは、2.5時間の入力作業と5分のスプレッドシートレビューの違いです。月20営業日で換算すると、50時間の削減——フルタイム相当のポジション以上——となり、例外調査、キャリアとの連絡、その他キーボードでは自動化できない業務に充てることができます。
よくある質問
大手キャリアと中小運送会社の両方の配送伝票に対応できますか?
はい。意味理解型の抽出は、各フィールドの意味を理解するため、画面上の位置に依存しません。「仕入先名」という列があれば、佐川急便のPDFのヘッダーに印刷されていても、カーボン複写伝票の印鑑として押されていても、地場運送会社の伝票に手書きされていても、仕入先を特定します。これが、レイアウトごとにテンプレートが必要なテンプレート型OCRとの根本的な違いです。入庫記録の列定義は一度行うだけで、すべての仕入先フォーマット(未見のものも含む)で機能します。
配送伝票が和暦(令和)を使用している場合はどうなりますか?
抽出結果は元の和暦形式を保持することも、エクスポート時に自動変換することも可能です。下流システム(例:ERPインポート)で西暦が必要な場合、ツールの後処理層がエクスポート時に「令和8年6月16日」を「2026-06-16」に変換します。「納品日」として列を定義し、出力形式を制御するだけです。手動での日付変換は不要です。
既存のWMS(SAP、GLOVIA、freee、MoneyForward)との連携は?
抽出結果(ExcelファイルまたはCSV)は、CSVインポートに対応するあらゆるWMSやERPに取り込めます。freeeやMoneyForwardはCSVベースの仕訳インポートに対応しています。SAPジャパンやオラクル・ジャパンもCSVベースの入庫トランザクション読み込みに対応しています。抽出工程とインポート工程は分離されており、データのシステムへの取り込み方法とタイミングを制御できます。日本の配送伝票抽出ワークフローについては、日本の配送伝票データをExcelに抽出するガイドをご参照ください。
手書きの日本語配送伝票は読み取れますか?
はい。ビジョンモデルは手書き文字を処理可能で、地場運送会社のカーボン複写伝票の日本語文字も対象です。手書きの精度は印刷文字より低くなります。特に、乱雑な筆跡、にじみ、コントラストの低い文字は注意が必要です。そのため、手書きフィールドは確認工程での簡易的な目視チェックが推奨されます。本ツールは低品質な入力に対して過度な信頼感を与えず、推測ではなく不確実性を提示します。30枚の配送伝票のうち3~5枚が手書きの場合、確認工程はそれら数枚に集中し、残りの25枚以上の印刷PDFはほぼ完全な精度で処理されます。
バッチ抽出は電子帳簿保存法に対応していますか?
バッチ抽出で作成される構造化されたスプレッドシートは、取引日・取引金額・取引先という3つの検索要件を満たします。スプレッドシートのフィルタ機能により、範囲指定や複合検索もネイティブで実行可能です。ただし、法律では原本の納品書ファイル(PDF、スキャン、写真)を法定保存期間中保管することが依然として義務付けられています。抽出されたスプレッドシートは検索可能な索引兼作業記録であり、原本ファイルが法的な保存資料です。両方の保存が必要です。検索要件の詳細については、国税庁の電子帳簿保存に関するガイドラインをご参照ください。
納品書兼請求書の場合はどうなりますか?
日本の一部の仕入先、特にB2B製造業では、納品書と請求書を兼ねた書類(納品書兼請求書)を発行します。これらの書類には、納品データ(品目説明、数量)と請求データ(単価、税内訳、支払条件)の両方が含まれています。複合書類をバッチ処理する場合、納品フィールドと請求フィールドの両方の列を定義することで、1回の処理で両方のデータセットを抽出できます。出力されるスプレッドシートでは、書類1件につき1行に全データが格納されるため、後続の入庫業務や買掛金業務のワークフローに合わせて列を分割・フィルタリングできます。
日本の物流企業はすべて、モノの移動を自動化しています。しかし、何が動いたかを証明する書類、すなわち納品書は、いまだに手作業で処理されている最後の紙書類です。バッチ抽出により、2.5時間かかっていたタイピング作業が5分のスプレッドシートレビューに変わります。そして生成されるデータは時間節約だけでなく、三者照合への対応、電子帳簿保存法の遵守、そして構造化されたデータ入力を待っていたすべての下流システムへの入庫記録の連携を実現します。