複数のドイツの配送伝票(Lieferschein)を一括処理して1つの受領ログにまとめる方法
異なるドイツのサプライヤーからの複数のLieferschein納品を、1回の実行で1つの統合された受領ログスプレッドシートにバッチ処理します。
1件ずつのリーファーシャイン処理がスケールしない理由
バッチ処理の効率性の議論は明白に思えます。「20件を1件ずつ処理する代わりに、20件を一度に処理する」。しかし、単一ドキュメント処理の本当のコストは、入力にかかる時間ではありません。それは、フォーマット間のコンテキストスイッチングコストです。受入担当者が異なるサプライヤーからの新しいリーファーシャインを開くたびに、再確認が必要になります。このレイアウトではリーファーシャイン番号はどこにある? 納品日はヘッダーかフッターか? 明細数量は3列目か4列目か? 「Pos.」は明細番号か、倉庫内の位置か? この頭の中での再マッピングは、タイピング自体よりも時間がかかり、データ入力エラーの大部分はここで発生します。
リーファーシャインを1件ずつ処理すると、相互参照する能力も失われます。サプライヤーAからの納品書2026-478は、完全納品でしたか、それとも部分納品(Teillieferung)でしたか? その答えは、15分前に処理してすでに閉じた同じサプライヤーからの納品書2026-479にあるかもしれません。バッチ処理ではすべてのドキュメントを同時に表示できるため、単一ドキュメント処理では隠れてしまうパターンや不一致を明らかにできます。
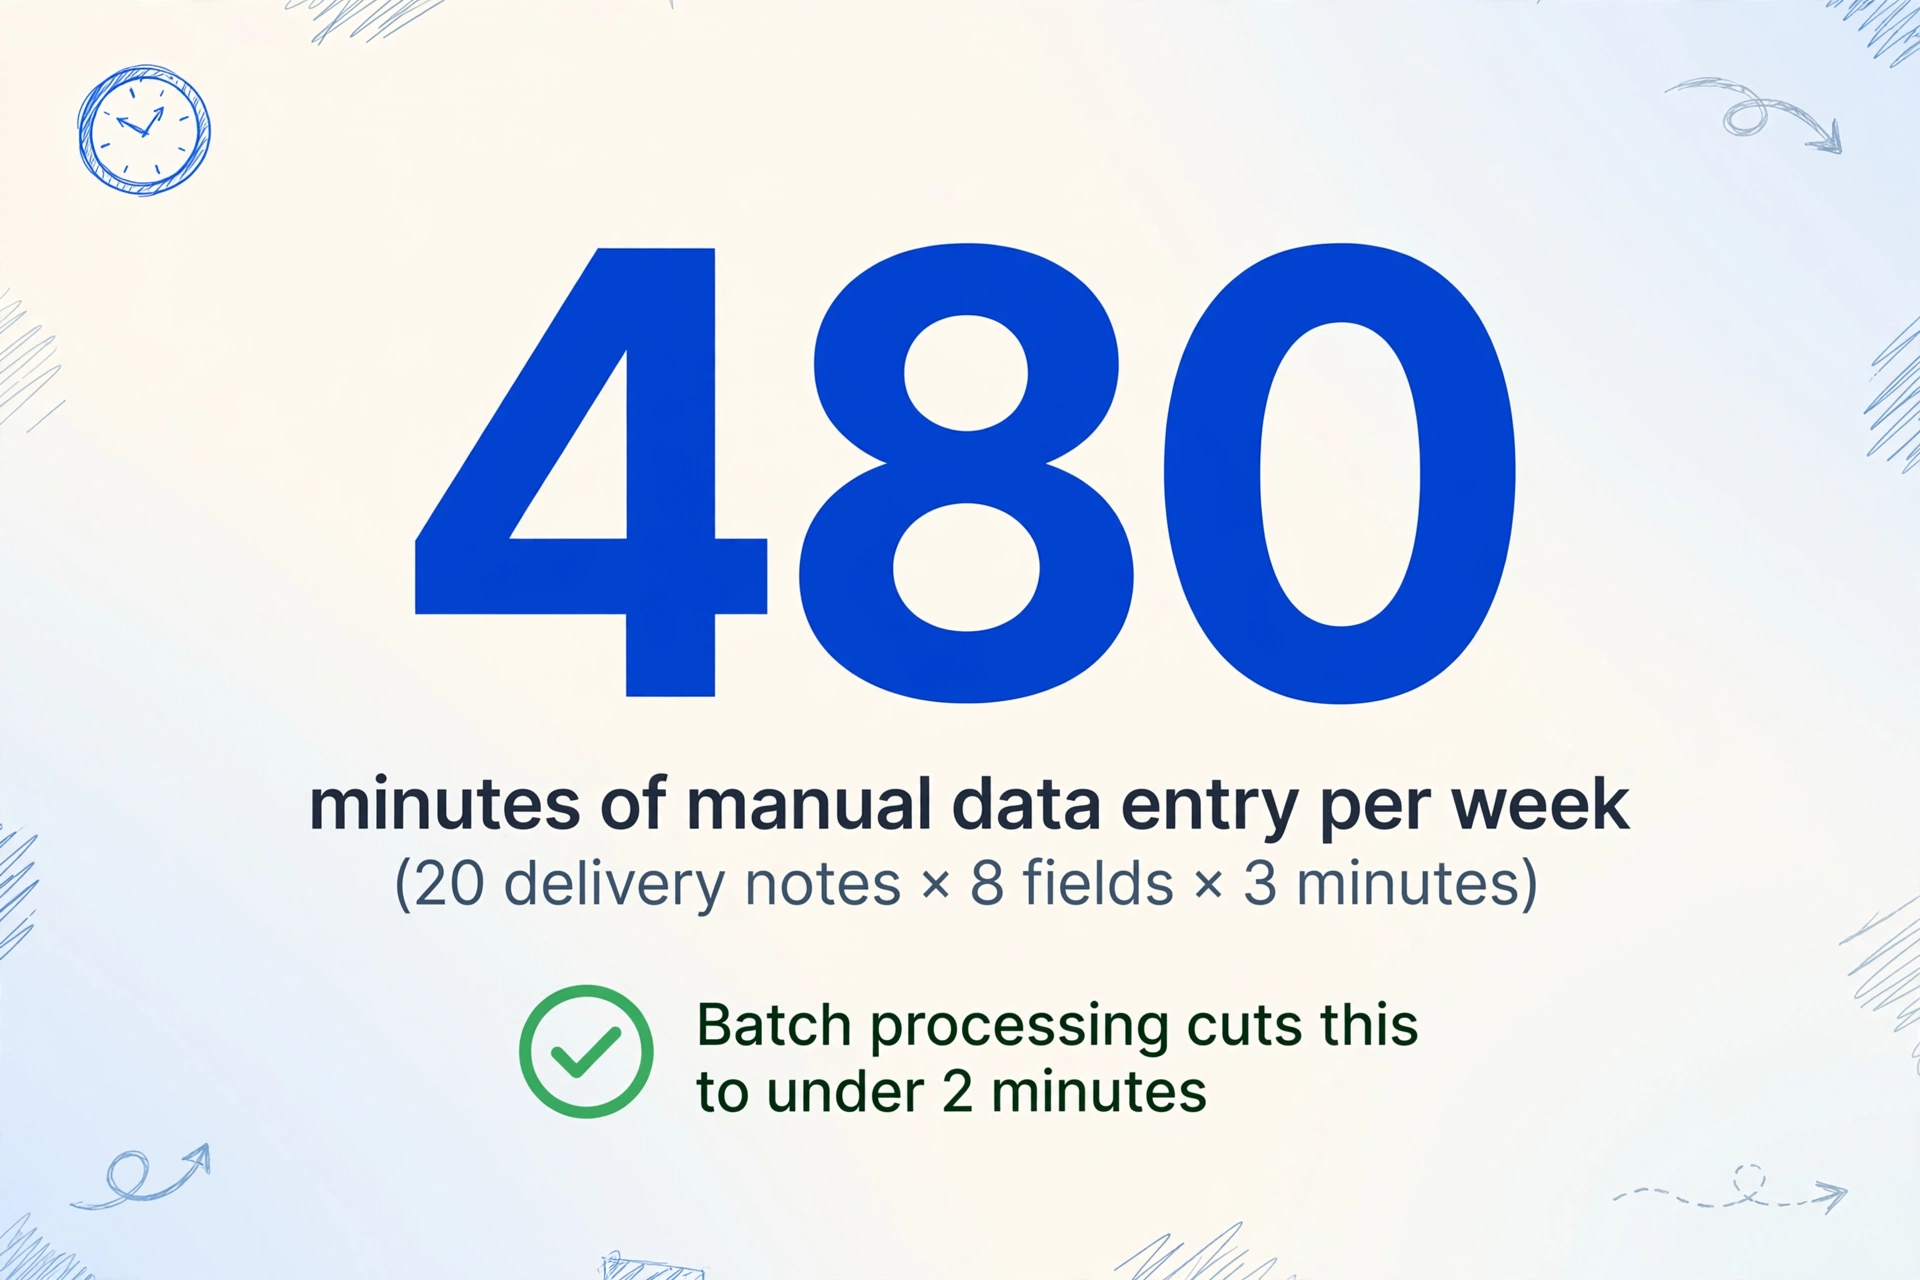
規模に応じた計算:1シフトあたり20件の納品書 × 1件あたり8フィールド × 1件あたり3分 = 週に480分の手動データ入力。これは、倉庫従業員の丸1日分の時間を、すでに紙に存在する数字の入力に費やしていることになります。ドイツの物流賃金水準では、これは週に約€400〜600の純粋な転記コストに相当します。エラー修正、不一致の調査、手直しを考慮する前の数字です。
ドイツの倉庫の現実:複数サプライヤー、複数フォーマット、複数の緊急度
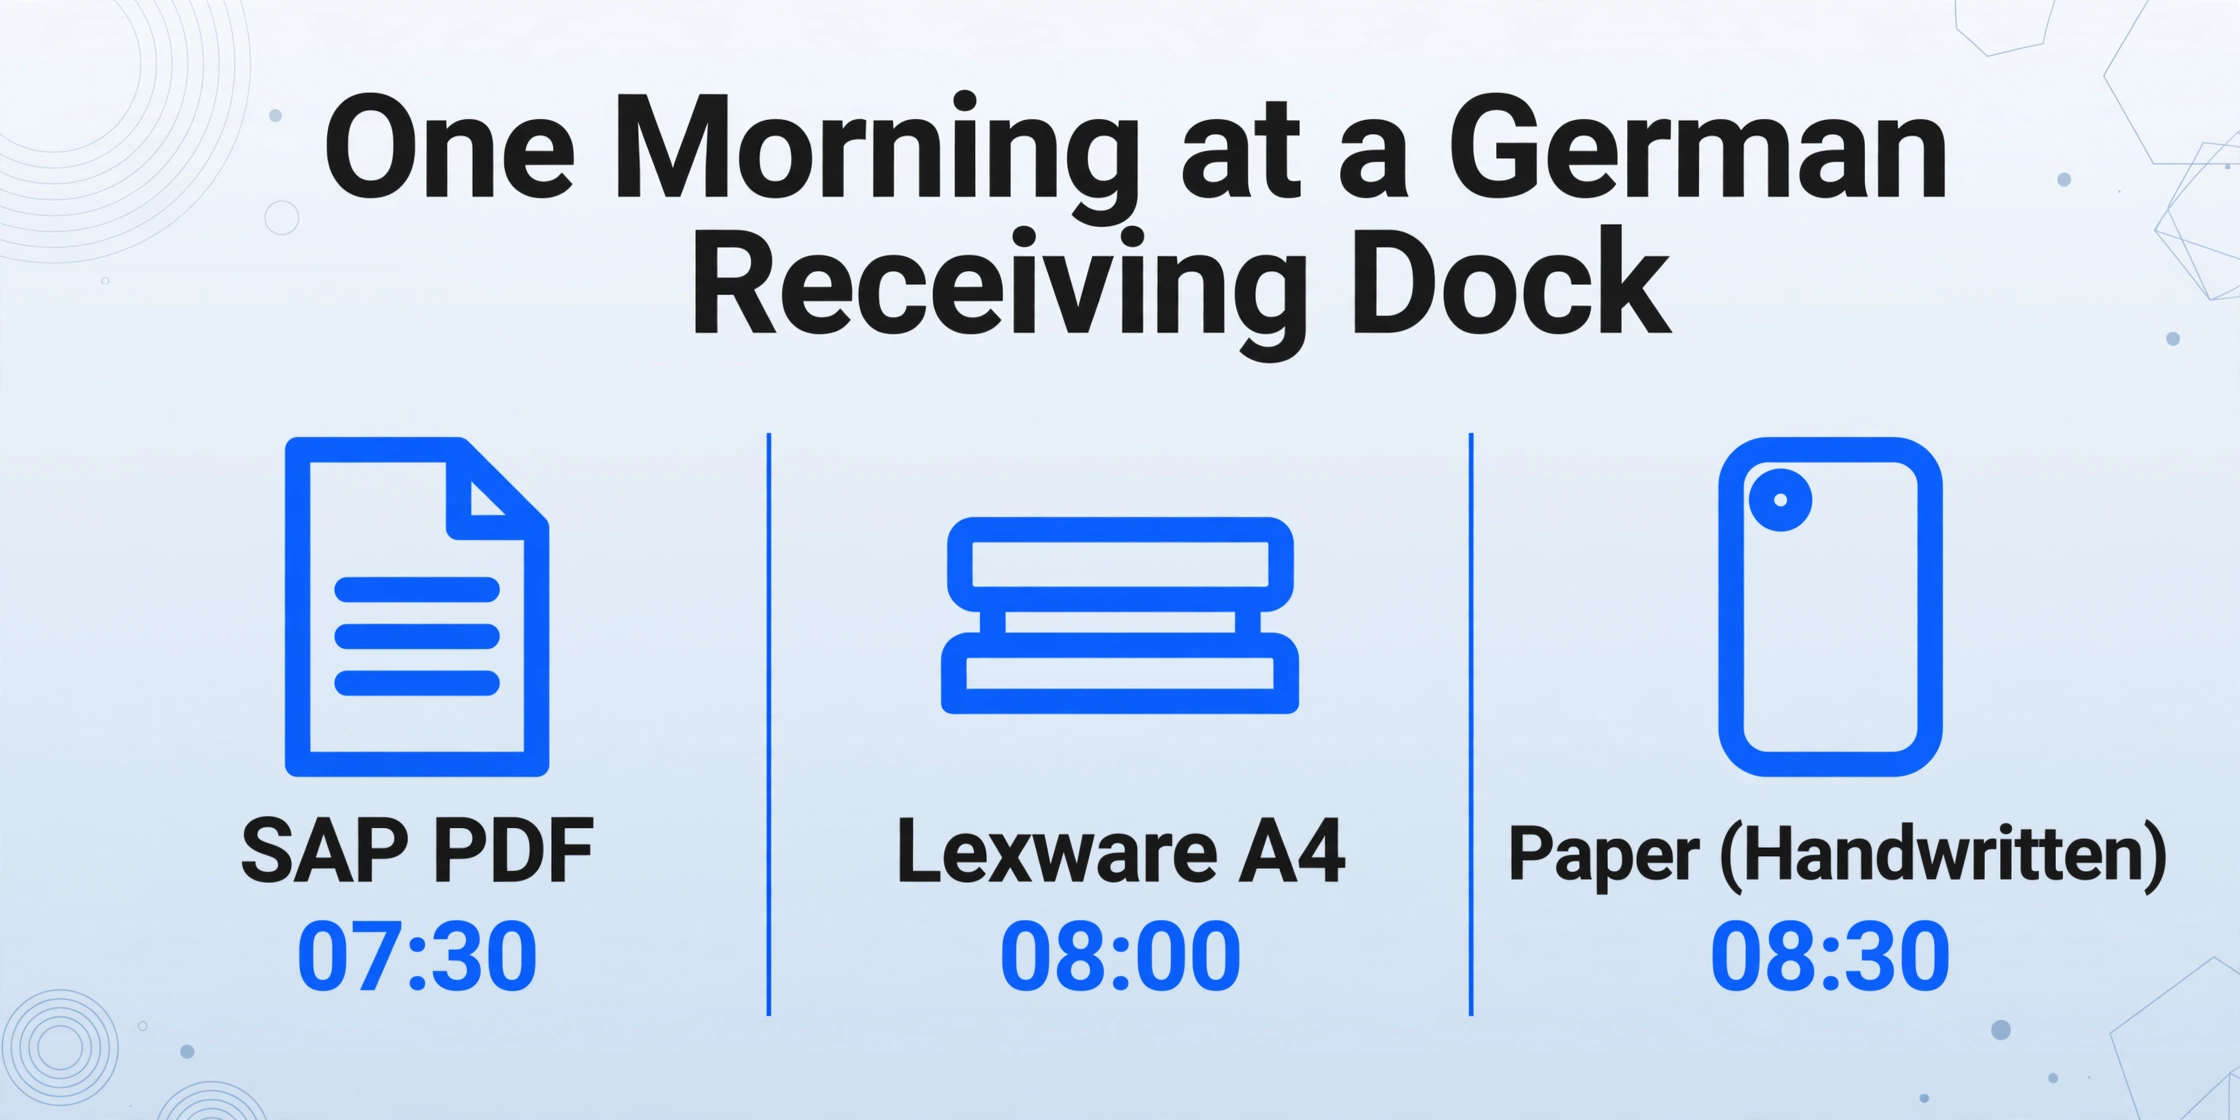
ドイツの製造業や流通業の倉庫の受入ドックでの、典型的なある朝の風景はこんな感じです。
07:30 — SAPで生成されたリーファーシャインが、大手自動車部品サプライヤーのトラックとともに到着します。このPDFは、8列の品目テーブル、12桁の内部コードである品目コード(Materialnummer)、そして別のリーファーシャイン番号と出荷番号(Versandnummer)を含む、ページ数の多い複雑なドキュメントです。受入ドックでは、08:15までにWMSに品目レベルのデータを登録し、入庫作業を開始する必要があります。
08:00 — 2枚のLexwareのリーファーシャインが、地域の手工業者から届きます。これらは、4列のテーブルを持つ、すっきりとした1ページのA4ドキュメントです。SAPのドキュメントと同じカテゴリの情報(リーファーシャイン番号、納品日、品目、数量)を含んでいますが、レイアウトはSAPフォーマットとピクセル座標を一切共有していません。
08:30 — 紙のリーファーシャインが、運転手の手から届きます。小さな運送業者がカーボンコピー式伝票(Durchschreibesatz)で記入したものです。リーファーシャイン番号は右上隅に手書きされています。品目テーブルは手描きのグリッドです。運転手は出発するために署名が必要です。
3つのフォーマット世代 — デジタル構造化(SAP)、デジタル簡易(Lexware)、紙(手書き)— がすべて1時間以内に到着し、すべて朝のシフトが終わるまでに同じWMSに登録される必要があります。これは仮説上のエッジケースではありません。これはドイツの物流における日常の運用現実であり、95,000社以上がGS1標準を使用していますが、中小企業のサプライヤーの大半はDESADVのような構造化EDIメッセージを採用していません。構造化された未来とPDF/紙の現在との間のギャップこそが、バッチ抽出が活躍する場所です。
受入ドックはデータ入力ステーションではありません。検証チェックポイントです。手動転記が検査のための時間を奪うと、受入の品質管理機能全体が「箱を開け、ざっと数え、紙に署名する」に崩壊します。
バッチ抽出がフォーマットの多様性を大規模に処理する仕組み
バッチでのリーファーシャイン処理をフォーマットを問わず実現可能にする中核機能は、セマンティックフィールドマッチングです。列名を一度定義するだけで — 「リーファーシャイン番号」「納品日」「注文番号」「品目」「数量」「単位」— AIはバッチ内のすべての文書に同じ列定義を適用します。これは、テンプレートベースのバッチ処理とは決定的に異なります。テンプレート方式では、同一の文書レイアウト(非現実的)またはサプライヤーごとのテンプレート設定(スケーラブルではない)が必要だからです。
個々のドイツ語リーファーシャインでのセマンティック抽出の詳細 — フィールド定義、差異チェックのための計算列、手書き注釈などのエッジケースの処理を含む — については、ドイツ語の配送伝票データをExcelに抽出するガイドをご覧ください。この記事では、1枚の文書から1シフト分の文書へと規模を拡大したときに何が変わるかに焦点を当てます。
バッチ処理では、単一文書の抽出に加えて、3つの追加要件が生じます。
行レベルの文書トレーサビリティ。バッチ出力では、スプレッドシートの各行がどのリーファーシャインから来たかを特定できなければなりません。リーファーシャイン番号列が主キーとして機能します。これがないと、明細行の山だけが残り、差異を原因となった文書に遡って追跡する方法がありません。
一貫したNULL処理。Lexwareのリーファーシャインにロット番号列が含まれ、紙のリーファーシャインには含まれない場合、出力の「ロット番号」列は紙の行に対して空白セルを表示すべきです — ゼロでも、エラーでも、推測でもなく。空白セルは情報を伝えます(このサプライヤーはロット番号を追跡していない)。ゼロを埋めるのは誤情報になります。
出力行の順序付け。出力は論理的な順序を維持すべきです:リーファーシャインごとにグループ化され、各リーファーシャイン内では明細番号順に並べます。20枚の文書を処理する場合、出力の最初の3行は最初のリーファーシャインの3つの明細項目に対応する必要があり、複数の文書からの明細項目が混在した順序になってはいけません。
バッチ抽出は、単一文書の抽出を20倍速く行うことではありません。それは異なる操作です — 文書間の一貫性、トレーサビリティ、出力の整理が、フィールドごとの精度と同じくらい重要になる操作です。
荷受け場からWMSまで:バッチワークフローをステップごとに解説
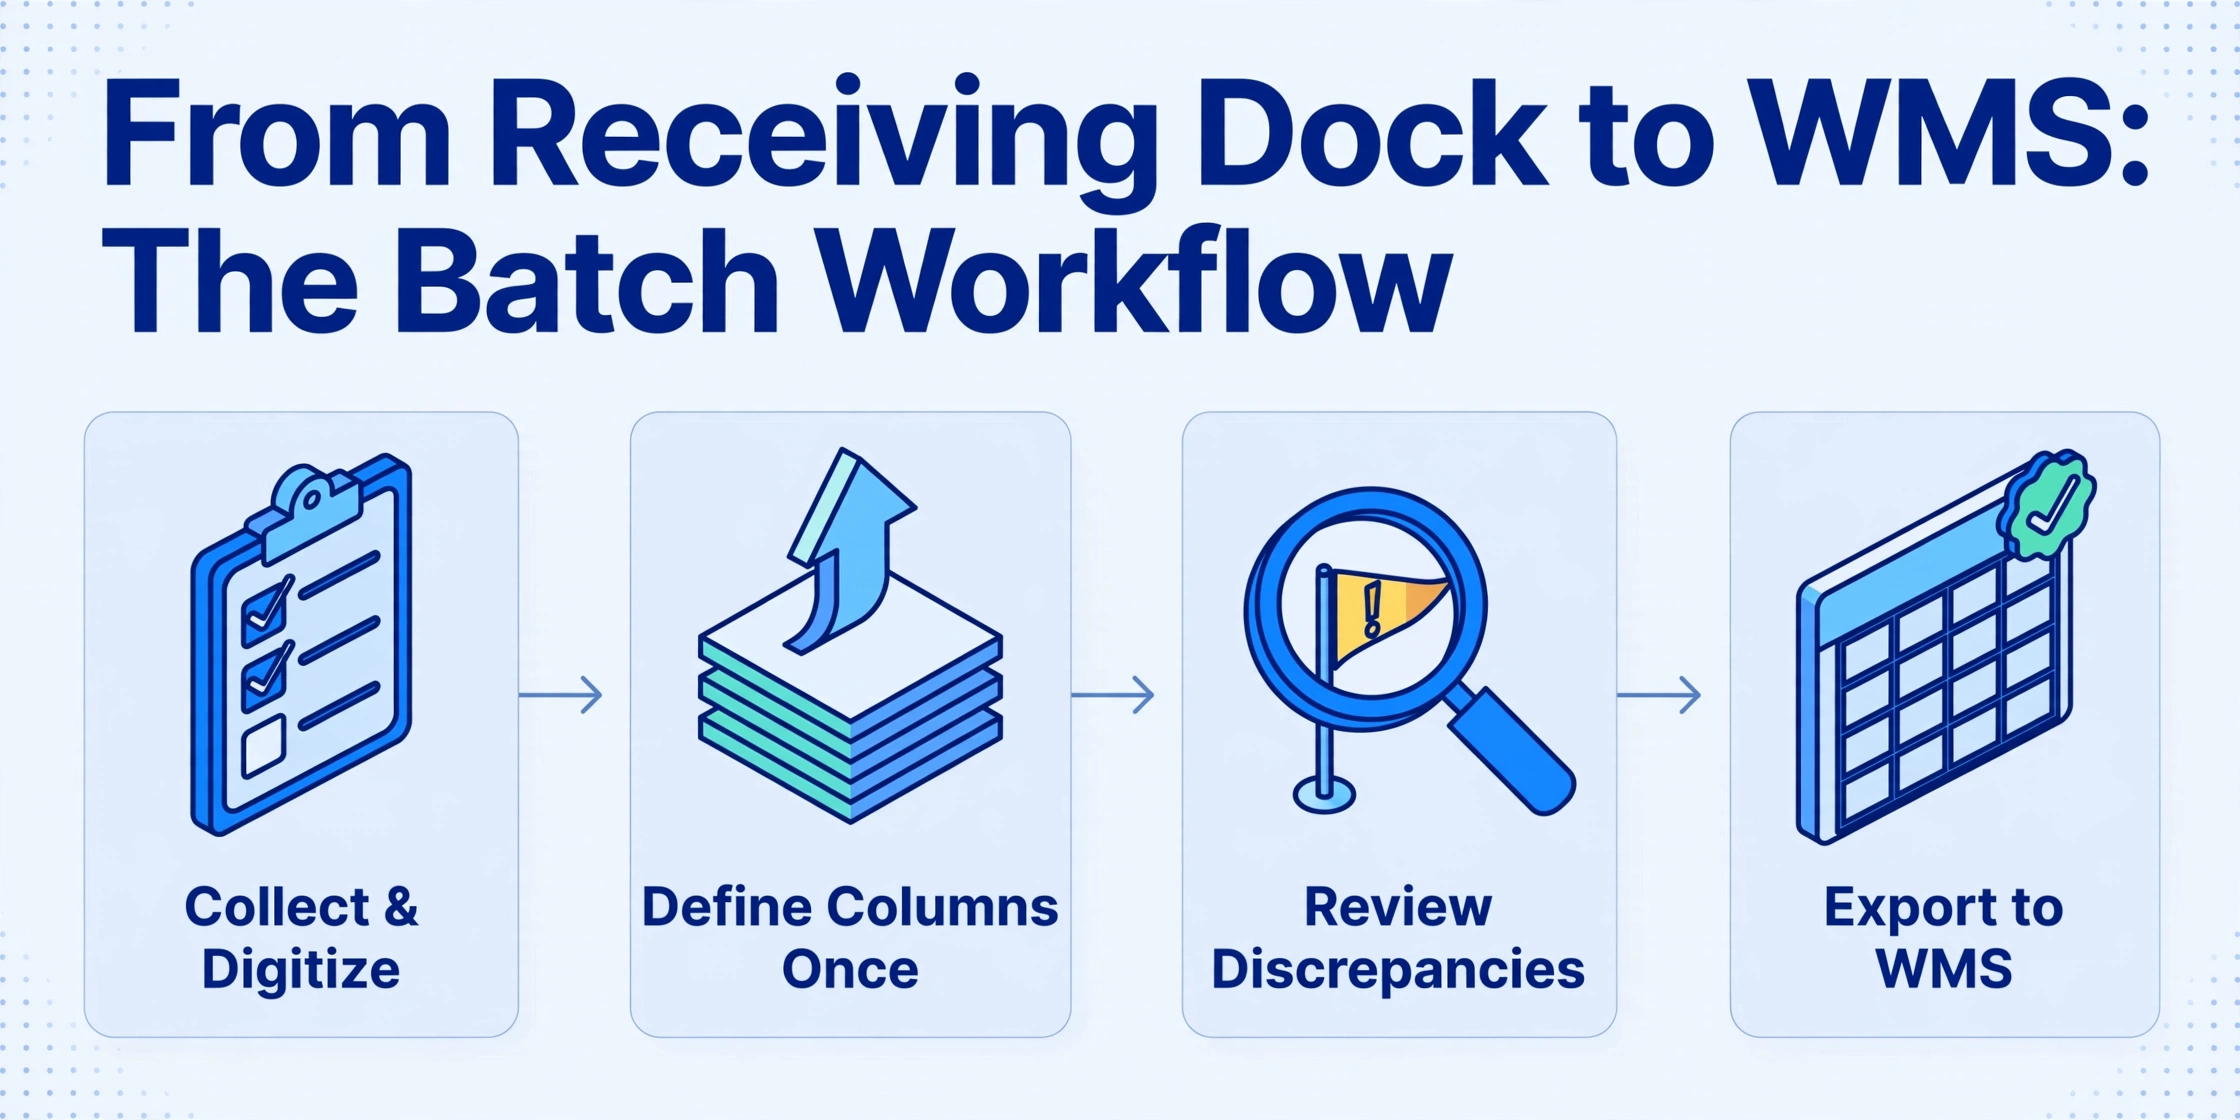
このワークフローでは、荷受け場にある混在フォーマットのリーファーシャインの束を、WMSインポート用の構造化されたスプレッドシートに変換します。下流へのエラー伝播を防ぐ運用上のチェックポイントもすべて含まれています。
すべてのリーファーシャイン(配送伝票)を収集し、デジタル化します。 シフト中のすべての配送伝票を集めます。サプライヤーからのPDF、メールの添付ファイル、ドライバーからの紙のコピーなどです。紙のリーファーシャインは、ドキュメントスキャナーまたはスマートフォンのカメラ(明るい場所で、平らに置き、影がない状態)でスキャンします。それらを1つのフォルダに整理します。AIはJPG、PNG、PDFを同じバッチ内で区別なく処理します。紙のリーファーシャインの写真とSAP生成のPDFが特別な処理なしに並んで処理されます。
すべてのサプライヤーに対して、列を一度だけ定義します。 列名を入力します:リーファーシャイン番号、納品日、注文番号、送り主、明細番号、品目番号、品目名称、数量、単位。必要に応じて計算列を追加します。例えば、数量の差異をフラグする「差異(注文数 − 納品数)」や、各ドキュメントのソースシステムを自動分類する推論列(例:「形式(オプション:SAP、Lexware、sevDesk、紙)」)などです。
バッチ全体をアップロードします。 20以上のファイルをすべてアップロードエリアにドラッグします。バッチは単一のジョブとして処理されます。サプライヤーや形式ごとに新しい抽出を開始する必要はありません。処理速度はドキュメント数とページ数に依存します。20枚の単一ページのリーファーシャインのバッチは、通常2分以内で処理されます。
エクスポートする前に、出力の差異を確認します。 計算列を追加した場合は、「差異」列を確認します。重要なフィールド(リーファーシャイン番号、数量)が欠落している空白行を探します。これらは、劣化が激しい、または認識できないレイアウトのドキュメントを示している可能性があります。各サプライヤー形式の最初のリーファーシャイン番号を元のPDFと照合します。この確認ステップにより、エラーがWMSに入る前に検出されます。
ExcelまたはCSVにエクスポートします。 出力は1つのスプレッドシートです。明細項目ごとに1行、トレーサビリティのために各行にリーファーシャイン番号が繰り返され、すべての日付が正規化され、すべての数量が一貫した数値形式になっています。直接使用する場合はXLSX、WMSインポート用にはCSVとして保存します。
WMSまたはERPにインポートします。 SAP Extended Warehouse Management(EWM)、Lexware Warenwirtschaft、およびほとんどの最新のWMSプラットフォームは、入庫記録のXLSXまたはCSVインポートをサポートしています。スプレッドシートの列をシステムの受領フィールド(リーファーシャイン番号 → 配送伝票参照、注文番号 → 発注書参照、数量 → 受領数量)にマッピングしてインポートします。抽出レイヤーは構造化データを生成し、統合レイヤーがそれを特定のシステムに接続します。WMSがファイル監視ディレクトリまたはAPIエンドポイントをサポートしている場合は、この最後のステップを完全に自動化できます。
ファイルは安全に処理され、保存されることはありません。
命名規則と出力の整理
バッチ処理では生成されるデータ量が増えるため、データの整理がより重要になります。ここでは、200行のスプレッドシートを管理しやすく保つための規則をご紹介します。
リーファーシャイン番号が主キーです。 各明細行には、元の文書の配送伝票番号を必ず含める必要があります。AIがリーファーシャイン番号を読み取れない場合(汚れた紙の伝票、番号が切り取られたPDFなど)、その行は黙ってnullキーを割り当てるのではなく、手動レビュー用にフラグを立てる必要があります。計算列「リーファーシャイン番号あり(オプション:はい、いいえ)」がこれらの行を自動的にフラグ付けします。
フィールド単位ではなく、文書単位で出力をグループ化します。 出力には、リーファーシャインAのすべての明細行、次にリーファーシャインBのすべての明細行、というようにリスト表示する必要があります。このグループ化により、予期しない出力を生成した文書をすばやく確認できます(例:40行のリーファーシャインが3行しか生成しなかった場合、複数ページの明細テーブルで何か問題が発生しています)。インターリーブ出力(Aの行、Bの行、またAの行)は処理アーティファクトの症状であり、バッチのレビューがほぼ不可能になります。
バッチのトレーサビリティ用にメタデータ列を追加します。 次の列の追加を検討してください:「Verarbeitungsdatum」(処理日 — バッチが抽出された日時)、「Dateiname」(元のファイル名 — 出力行をソースファイルにマッピング)、「Quellformat」(ソース形式 — SAP、Lexware、紙など)。これらの列は元のリーファーシャインには表示されません。これらはバッチレベルのメタデータであり、出力を自己文書化します。先月のバッチを再確認して、どのファイルがどの行を生成したかを知る必要がある場合に役立ちます。
バッチでのTeillieferung(部分納品)の処理:サプライヤーAが同じBestellnummerに対して2つのリーファーシャインを送信した場合(部分納品)、両方が異なるリーファーシャイン番号でバッチ出力に表示されますが、Bestellnummerは同じです。Bestellnummerでフィルタリングすると、すべての部分納品をグループ化して表示できます。計算列「Gesamtmenge pro Bestellung」は、同じBestellnummerを持つすべての行の数量を合計できるため、注文全体が完了しているかどうかを一目で確認できます。
FAQ:ドイツ語納品書のバッチ処理に関するよくある質問
1つのバッチに紙のスキャンとデジタルPDFを混在させてもよいですか?
はい。写真に撮った紙のLieferscheine、スキャンした紙のコピー、および任意のERPシステムからのデジタルPDFを、同じバッチにアップロードできます。唯一の要件は、スキャンまたは写真撮影された文書が明るく、焦点が合っていることです。これは、読む予定の文書に適用するのと同じ品質基準です。紙のLieferscheinが折りたたまれていたり、しわがあったり、部分的に隠れている場合、影響を受けた領域の抽出精度は低下しますが、文書の残りの部分は正常に処理されます。
バッチ抽出では、複数ページのLieferscheineと単一ページのものをどのように処理しますか?
AIは、ページ数に関係なく、各ファイルを完全な論理文書として扱います。30行の明細がある3ページのSAP Lieferscheinと、5行の明細がある1ページのLexware Lieferscheinが同じバッチに含まれます。出力は、SAP文書では30行、Lexware文書では5行を正しく生成し、トレーサビリティを維持するためにLieferscheinnummerがすべての行で繰り返されます。複数ページの文書の1ページ目にのみ表示されるヘッダーフィールドは、すべてのページのすべての明細行に正しく関連付けられます。
SAP EWMまたはLexwareへのインポートに対応しているエクスポート形式は何ですか?
抽出では、XLSX(Excel)、CSV、JSONが生成されます。SAP EWMは、標準トランザクションコード(入庫用MIGO、入荷納入用VL31N)を使用した商品受領のためのCSVおよびXLSXインポートをサポートしています。Lexware WarenwirtschaftはCSVインポートをサポートしています。ほとんどのWMSプラットフォームは、最低でも受領記録のためのCSVインポートを受け入れます。システムで特定の列順序やヘッダー形式が必要な場合は、インポート前にExcelで列を並べ替えることができます。抽出出力は標準的なスプレッドシートであり、独自形式ではありません。
バッチサイズに実用的な制限はありますか?
厳格な技術的制限はありませんが、運用上のベストプラクティスとして、シフトまたは日単位でバッチ処理することをお勧めします。通常は1バッチあたり20~50文書です。100文書を超えるような大規模なバッチも技術的には可能ですが、レビューステップ(ワークフローのステップ4)で数百行の異常をスキャンするのは扱いにくくなります。複数のシフトで1日あたり200枚のLieferscheineを処理する場合は、シフトレベルのバッチに分割して、レビューを管理しやすくし、不一致を特定の時間枠に追跡できるようにしてください。
バッチ抽出はGoBDのトレーサビリティ要件を満たしますか?
GoBDでは、抽出されたデータが元の文書まで遡って追跡できることが求められます。リーファーシャイン番号の列がこの目的を果たします。出力の各行には、そのソース文書の一意の識別子が含まれます。元のPDFアーカイブ(GoBDに基づき別途保管する必要があります)と組み合わせることで、完全な監査証跡が作成されます:出力行 → リーファーシャイン番号 → 元のPDF。さらに監査への備えとして、「ファイル名」メタデータ列が出力行をソースファイル名に対応付けます。抽出されたExcelは元のPDFアーカイブを置き換えるものではなく、補完するものである点にご注意ください。
リーファーシャインをバッチではなく個別に処理すべきのはどのような場合ですか?
バッチ処理が最適なのは、以下の場合です:1シフト分のリーファーシャインがまとまっている場合、出力全体で文書間の一貫性を求める場合、同じ注文に対する部分納品を複数の文書にわたって照合する必要がある場合、そして文書ごとの即時出力が不要な場合です。個別処理が適しているのは、以下の場合です:トラックが待っている中で即座にWMS入力が必要な緊急のリーファーシャインが1件ある場合、残りを処理する前に複雑または問題のある文書を1件詳細にレビューする必要がある場合、またはサプライヤーが当日のバッチ処理後にリーファーシャインを送ってきた場合です。バッチ処理と単一文書の抽出は、相互に排他的ではなく補完的なものです。
複数のヨーロッパ言語で納品書を受け取っている場合も、同じバッチワークフローが隣接する文書タイプに適用されます:フランス語の納品書およびスペイン語の納品書。AIは言語やレイアウトではなくフィールドの意味で読み取るため、1つの列定義でこれらすべてを処理できます。