Cómo procesar por lotes notas de entrega japonesas de varios proveedores en un único registro de recepción
Procese por lotes las notas de entrega (納品書, nōsho) de un día de varios proveedores japoneses y consolide los datos en un único registro de recepción, sin necesidad de configurar plantillas por proveedor.
Por qué el muelle de recepción en Japón depende de la captura manual de datos
Se proyecta que el mercado de 3PL en Japón — que ofrece servicios de logística para manufactura, retail y comercio electrónico en diversas industrias — alcanzará los 48.38 mil millones de dólares para 2031. Pero el documento que prueba lo que llegó en el camión aún se procesa de la misma manera que hace 30 años: alguien lo lee, captura los datos y espera no haber invertido un dígito.
Los sistemas de gestión de almacenes en Japón han automatizado casi todos los procesos físicos. Los escáneres de código de barras en la puerta del muelle capturan los identificadores de tarimas. Las etiquetas RFID rastrean la ubicación del inventario en tiempo real. Los vehículos guiados automatizados mueven mercancías entre zonas sin intervención humana. Nippon Express (NX GROUP), el 3PL más grande del país, opera plataformas WMS que orquestan la recepción, el almacenamiento y el picking con precisión de milisegundos. Pero todos estos sistemas comparten la misma dependencia: necesitan datos estructurados para comenzar su trabajo. Un WMS puede actualizar los niveles de stock cuando recibe una transacción digital, pero esa transacción solo puede crearse después de que alguien lea la nota de entrega y capture los datos.
Esto no es una falla de la tecnología logística japonesa. Es un problema de formato de documento disfrazado de problema de captura de datos. La nota de entrega (納品書) no es un documento legalmente requerido según el código comercial japonés, a diferencia de la factura (請求書), que el Sistema de Facturas Calificadas (インボイス制度) ha estado estandarizando desde octubre de 2023. La nota de entrega no tiene formato obligatorio, campos obligatorios ni un estándar digital equivalente a Peppol o Factur-X. Cada proveedor imprime, escribe a máquina o a mano su nota de entrega según como su oficina administrativa la produce.
La tecnología logística de Japón ha automatizado el movimiento de mercancías. No ha automatizado la lectura de los documentos que identifican esas mercancías. La brecha entre un código de barras en una tarima y los datos de la nota de entrega que le indican al sistema a qué orden de compra pertenece la tarima — esa brecha aún se supera con una persona y un teclado.
Por qué su WMS ve palés pero no notas de entrega
Para entender por qué persiste esta brecha, conviene observar lo que realmente llega a un muelle de recepción japonés en un martes típico por la mañana.
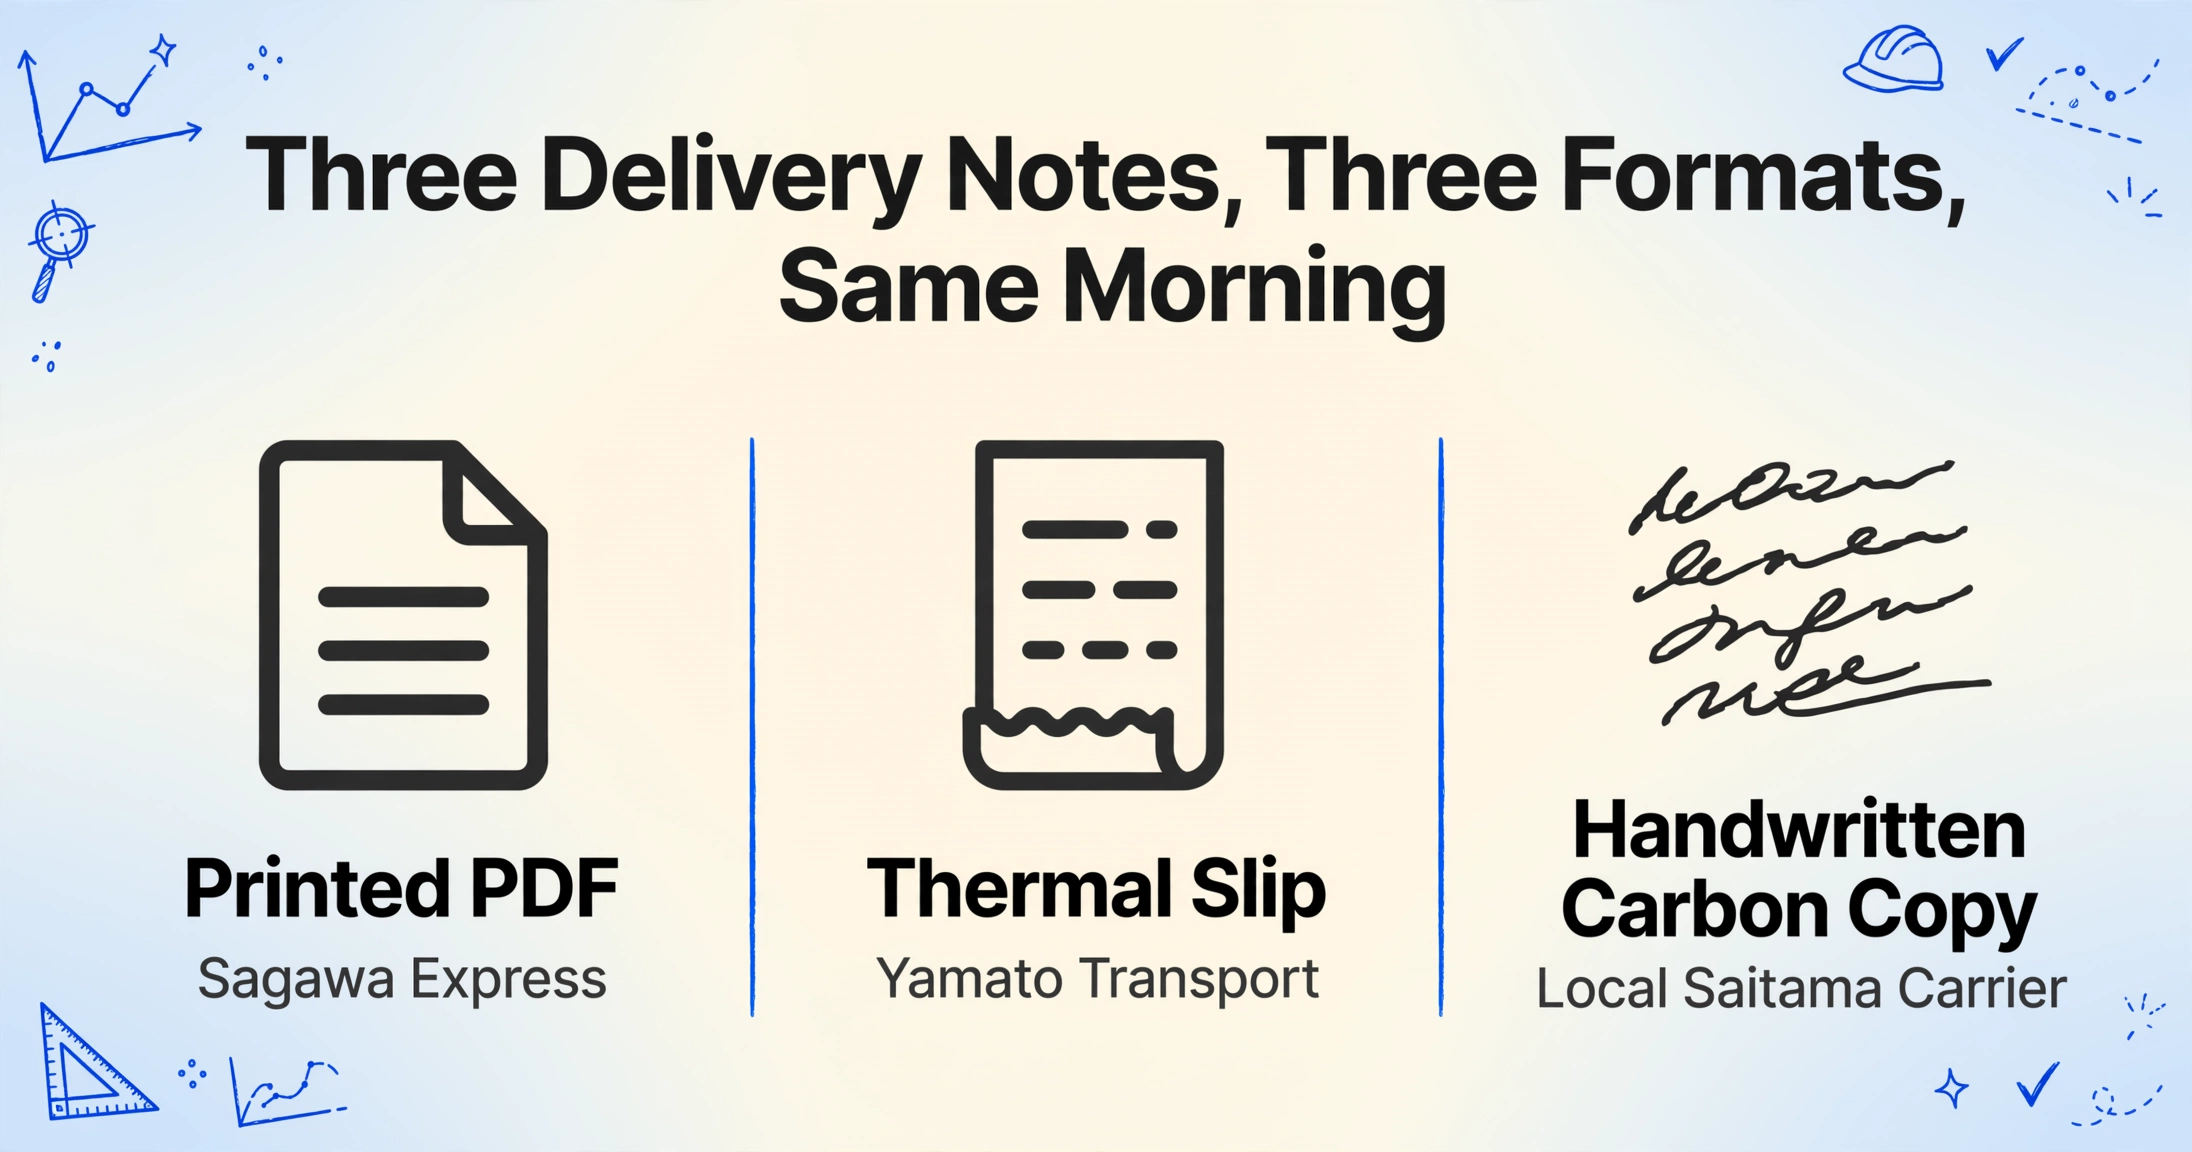
Sagawa Express entrega un envío de un fabricante de la región de Kansai. La nota de entrega llega como un PDF impreso — diseño limpio, tabla de varias columnas, códigos de artículo y cantidades claramente etiquetados. Pero los nombres de los campos están en japonés (品名/数量/単位), la fecha utiliza el formato de era japonés (令和8年6月16日) y el nombre de la empresa del proveedor aparece en el encabezado sin una etiqueta explícita de "Proveedor".
Yamato Transport trae un envío de un proveedor de alimentos de Hokkaido. Su nota de entrega es un recibo impreso térmicamente generado por un centro logístico de Yamato — diseño diferente, etiquetas de campo diferentes, orden de columnas diferente. Un transportista local que atiende a pequeños fabricantes en Saitama deja tres cajas con una nota de entrega manuscrita en copia carbón. La letra es apresurada, las cantidades están en cajas y no en unidades, y el nombre del proveedor es un sello (印鑑) en lugar de texto impreso.
Estos tres documentos — que llegan dentro de la misma ventana de 30 minutos — representan formatos completamente diferentes. Una herramienta de OCR basada en plantillas necesitaría tres plantillas separadas entrenadas para tres diseños diferentes. Cuando la próxima semana aparece un cuarto proveedor con otro formato más, el sistema necesita entrenamiento nuevamente. Si Sagawa cambia su plantilla de nota de entrega en enero (lo cual sucede), la plantilla anterior se rompe. Esta es la razón por la que la mayoría de las empresas de logística japonesas nunca intentan la extracción automatizada de notas de entrega: el costo de mantenimiento de plantillas supera el costo de entrada de datos que intentan eliminar.
El cuello de botella no es que los datos de las notas de entrega sean complejos. Es que los mismos campos — nombre del proveedor, fecha de entrega, referencia de orden de compra, código de artículo, cantidad — aparecen en lugares diferentes con etiquetas diferentes en cada documento. La respuesta tradicional de automatización — una plantilla por formato — colapsa ante la diversidad de formatos.
Los campos de datos en las notas de entrega japonesas son sorprendentemente consistentes. Según la guía de easymakedocs sobre notas de entrega japonesas, los elementos estándar son: título del documento (納品書), número de nota de entrega, fecha de entrega, información del cliente, información del proveedor, detalles del artículo (nombre, cantidad, especificaciones, precio unitario opcional) y un sello del proveedor. La variación proviene del diseño, no del contenido. Una nota de entrega de Yamato contiene los mismos campos conceptuales que el recibo manuscrito de un transportista local — la diferencia es dónde se ubican esos campos en la página y cómo están etiquetados. El desafío de la extracción no es que la información difiera. Es que localizarla entre formatos requiere comprender qué significa un campo, no dónde se sitúa.
Procesamiento por lotes: de 30 documentos a un registro de recepción estructurado
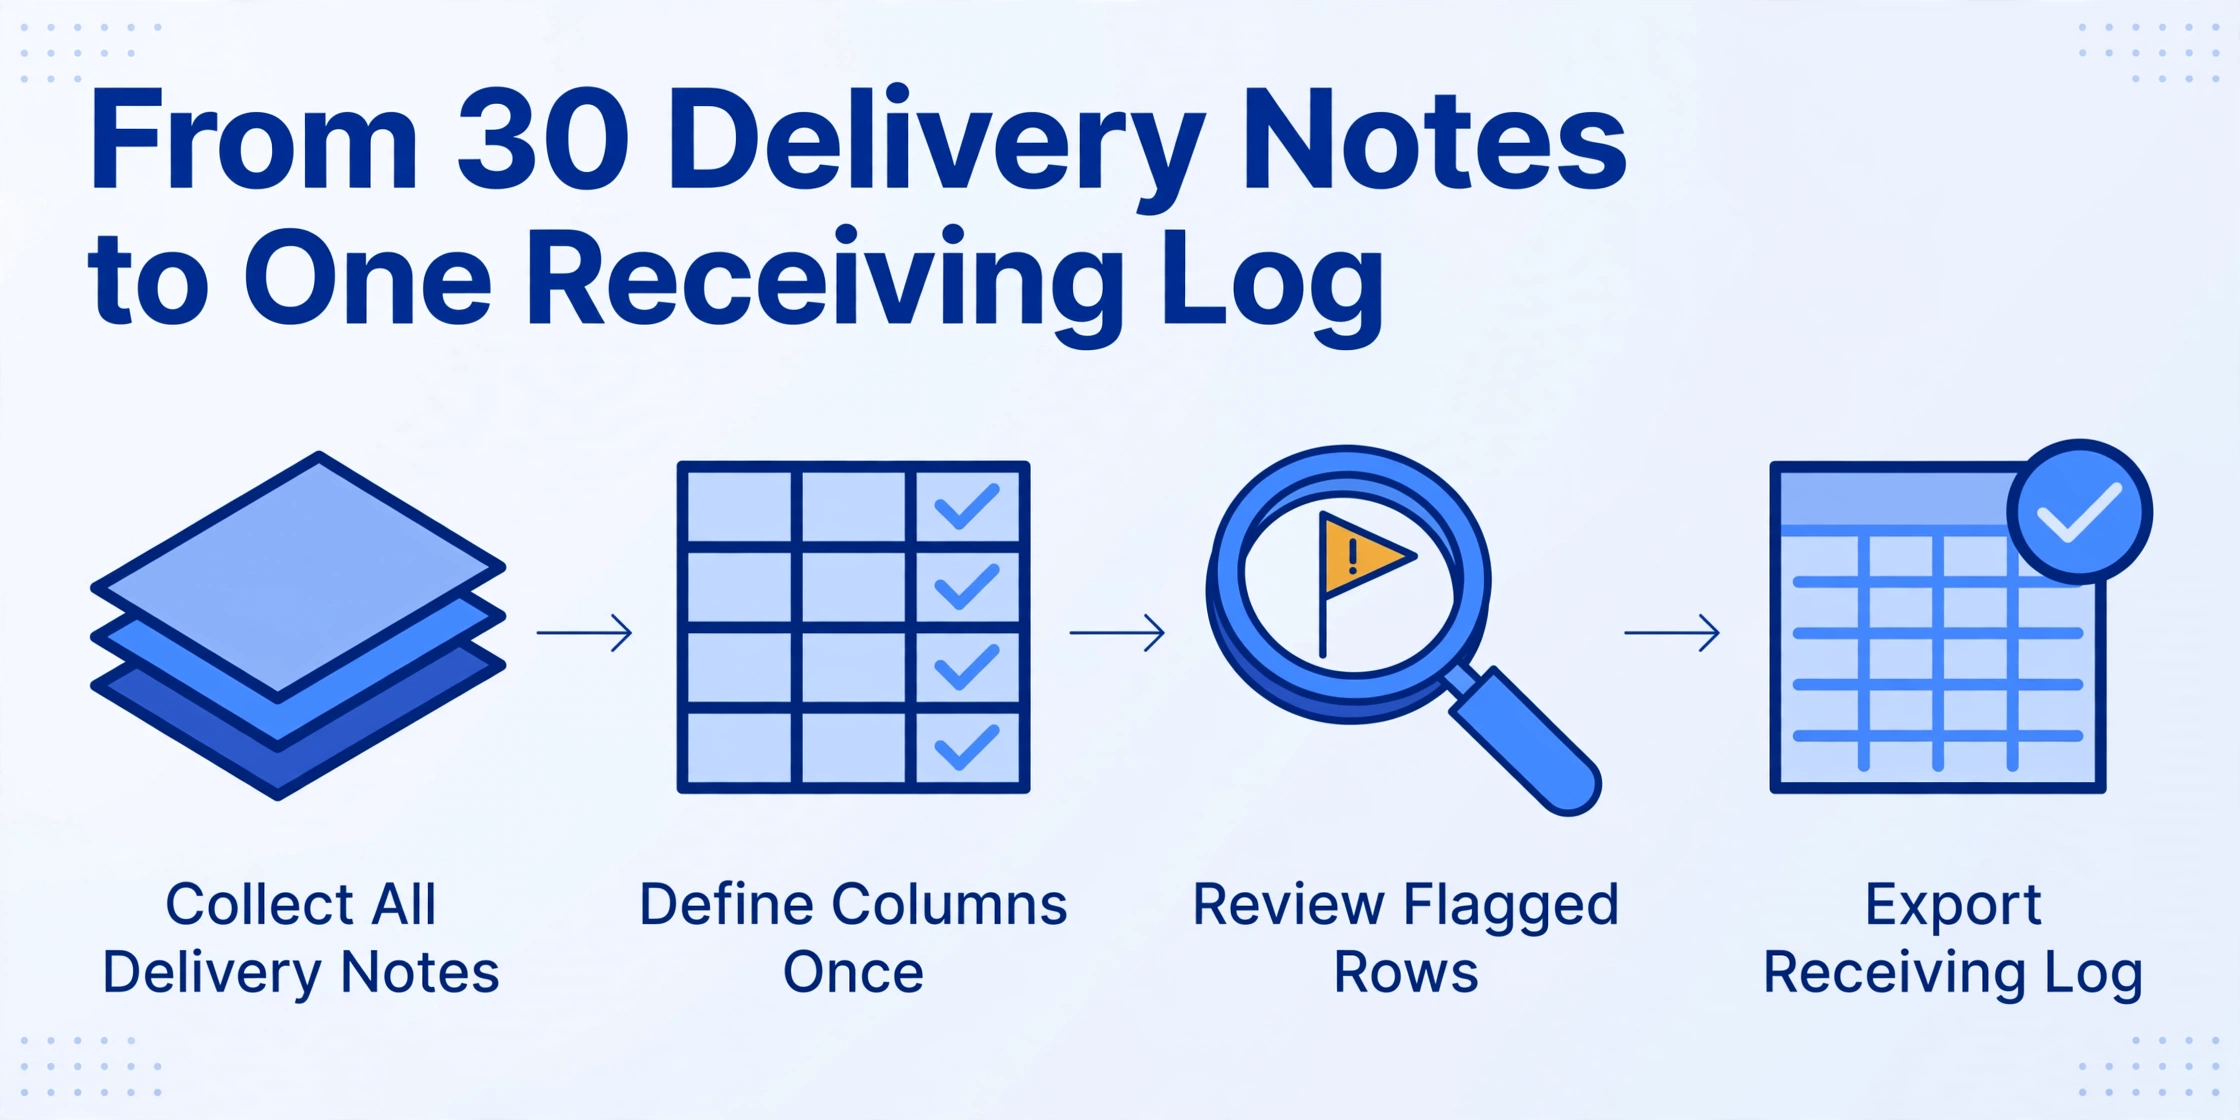
Aquí es donde la extracción semántica basada en nombres de columna se diferencia del OCR basado en plantillas. En lugar de entrenar una herramienta para reconocer dónde se encuentra un campo en el diseño del Proveedor A y en el del Proveedor B, usted define los campos que desea una sola vez, según lo que representan, y el motor de extracción localiza cada valor en todos los documentos del lote comprendiendo su significado.
ImageToTable.ai utiliza Extracción de Columnas Personalizadas: usted escribe los encabezados de columna que desea en su registro de recepción final — "Nombre del proveedor", "Fecha de entrega", "Número de OC", "Código de artículo", "Descripción del artículo", "Cantidad entregada", "Unidad" — y la IA lee cada nota de entrega del lote, localiza cada campo independientemente de dónde aparezca en la página y rellena la columna correspondiente. Una columna llamada "Nombre del proveedor" encontrará el proveedor tanto si está impreso en el encabezado como "株式会社〇〇", estampado con un sello inkan, o etiquetado como "納入元", porque la extracción es semántica, no posicional.
Los archivos se procesan de forma segura y no se almacenan.
El flujo de trabajo para un equipo de recepción logística japonés:
La mejora en eficiencia es medible. Un albarán de entrega de una página se procesa en 5–10 segundos mediante extracción — una mejora de 18× frente al promedio de 3 minutos de entrada manual. Pero la ganancia más significativa es la reducción de errores. Con 30 albaranes de entrega al día con un promedio de 5 líneas de artículo cada uno, la entrada manual produce aproximadamente 150 puntos de datos. Incluso con una tasa de error de transcripción conservadora del 1%, eso equivale a 1–2 errores por día — un dígito transpuesto en un código de artículo, un decimal incorrecto en una cantidad. En un mes, 30–60 errores se propagan al WMS, al sistema de conciliación de tres vías y al flujo de trabajo de cuentas por pagar. La extracción por lotes no elimina la necesidad de verificación — pero la transforma de una tarea de transcripción a una tarea de confirmación, que es órdenes de magnitud más rápida y menos propensa a errores.
Del registro de recepción a la conciliación triple y cumplimiento de la Ley de Libros Electrónicos
El registro de recepción no es el destino final. Es la entrada inicial para dos procesos críticos posteriores que determinan si una empresa de logística japonesa recibe pagos precisos y se mantiene lista para auditorías.
Según la Ley de Preservación de Libros Electrónicos (電子帳簿保存法) de Japón, todos los documentos de transacciones almacenados electrónicamente deben ser buscables por 3 criterios: fecha de transacción (取引年月日), monto de transacción (取引金額) y contraparte (取引先). Para empresas con ingresos anuales superiores a ¥50 millones, estos requisitos de búsqueda son obligatorios.
Una carpeta con 30 notas de entrega en PDF nombradas como el proveedor las tituló — "納品書_20260616.pdf", "delivery_sagawa.pdf", "Scan001.pdf" — no pasa la prueba de búsqueda. Una hoja de cálculo estructurada donde cada fila contiene Nombre del Proveedor, Fecha de Entrega, Número de OC, Transportista, Código de Artículo y Cantidad Entregada — la pasa automáticamente. Cada criterio que la ley exige para buscar es una columna en tu hoja de cálculo. Filtrado por rango de fechas, filtrado por monto, búsqueda por contraparte — todas se convierten en operaciones nativas de la hoja de cálculo, no en una búsqueda manual archivo por archivo.
Este es un beneficio secundario de la extracción por lotes que la mayoría de las discusiones sobre automatización de documentos pasan por alto: el acto de extraer datos estructurados de las notas de entrega satisface simultáneamente el cumplimiento de almacenamiento electrónico japonés. Los PDF originales aún deben conservarse durante el período legal (7 años para documentos de transacciones según la Ley del Impuesto al Consumo, 10 años para libros comerciales según la Ley de Sociedades) — pero para una recuperación rápida durante una auditoría fiscal, la hoja de cálculo extraída es la herramienta que tu equipo realmente usa.
El registro de recepción también alimenta directamente el proceso de conciliación triple que autoriza el pago al proveedor. Según la práctica estándar de adquisiciones japonesa, ninguna factura debe aprobarse hasta que las cantidades y artículos de la nota de entrega se hayan confirmado contra la orden de compra (発注書) y la factura (請求書). Esta es la cadena de verificación OC → Nota de Entrega → Factura. Pero la conciliación triple solo puede automatizarse si los tres documentos son datos estructurados:
Un registro de recepción estructurado —exportado desde la extracción por lotes a Excel o CSV— se convierte en el puente que cierra el ciclo de conciliación a tres bandas. Los datos extraídos pueden importarse directamente en freee, MoneyForward Cloud, Yayoi (弥生) o en el WMS de la empresa. Para empresas que usan SAP Japan, GLOVIA smart (Fujitsu) o EXPLANNER (NEC), la salida CSV se asigna a los formatos estándar de importación de transacciones de recepción. La conciliación a tres bandas pasa de una revisión manual documento por documento a una revisión sistemática de excepciones: solo las filas donde la cantidad de la OC ≠ la cantidad entregada requieren atención humana.
Para empresas de logística que procesan 30 entregas de proveedores al día entre una mezcla de transportistas principales (NX, Sagawa, Yamato) y empresas de transporte locales, la diferencia entre un registro de recepción estructurado y uno sin estructurar es la diferencia entre un turno de 2,5 horas tecleando y una revisión de hoja de cálculo de 5 minutos. Multiplicado por 20 días laborables al mes, eso supone 50 horas recuperadas —más que un puesto a tiempo completo— para investigación de excepciones, comunicación con transportistas o cualquier otra tarea que un teclado no pueda automatizar.
Preguntas Frecuentes
¿Puede manejar notas de entrega tanto de las principales empresas japonesas de mensajería como de pequeñas empresas de transporte locales?
Sí. La extracción semántica lee las notas de entrega comprendiendo el significado de cada campo, no su ubicación en la página. Una columna llamada "Nombre del Proveedor" localizará al proveedor ya sea que esté impreso en el encabezado de un PDF de Sagawa, estampado como un sello inkan en un formulario de copia carbón, o escrito a mano en un formulario de entrega de una empresa de transporte local. Esta es la diferencia fundamental con el OCR basado en plantillas, que requiere una plantilla separada para cada diseño. Usted define las columnas de su registro de recepción una vez, y funcionan en todos los formatos de proveedores, incluidos aquellos nuevos que no haya visto antes.
¿Qué sucede si una nota de entrega utiliza fechas de era japonesa (令和) en lugar del calendario gregoriano?
El resultado de la extracción puede conservar el formato de fecha de era original o convertirlo automáticamente durante la exportación. Si su sistema posterior requiere fechas gregorianas (por ejemplo, para la importación en un ERP), la capa de posprocesamiento de la herramienta convierte 令和8年6月16日 a 2026-06-16 al exportar. Usted define la columna como "Fecha de Entrega" y controla el formato de salida; no se requiere conversión manual de fechas.
¿Cómo se integra esto con nuestro WMS existente (SAP, GLOVIA, freee, MoneyForward)?
El resultado de la extracción (un archivo Excel o CSV) se puede importar en cualquier WMS o ERP que admita importaciones CSV para transacciones de recepción. Freee y MoneyForward Cloud aceptan importaciones de asientos contables basados en CSV (仕訳インポート). SAP Japón y Oracle Japón admiten cargas de transacciones de recepción basadas en CSV. El paso de extracción es independiente del paso de importación: usted controla cómo y cuándo los datos ingresan a su sistema. Para obtener más información sobre los flujos de trabajo de extracción de notas de entrega japonesas, consulte nuestra guía para extraer datos de notas de entrega japonesas a Excel.
¿Puede leer notas de entrega japonesas escritas a mano?
Sí. El modelo de visión procesa texto escrito a mano, incluidos caracteres japoneses en notas de entrega de copia carbón de empresas de transporte locales. La precisión en la escritura a mano es menor que en el texto impreso, particularmente para escritura apresurada, manchada o de bajo contraste, por lo que los campos escritos a mano se benefician de una verificación visual rápida durante el paso de revisión. La herramienta no genera una falsa sensación de confianza en entradas de baja calidad; muestra la incertidumbre en lugar de adivinar. Para un lote de 30 notas de entrega donde quizás 3–5 están escritas a mano, el paso de revisión se centra en esos pocos documentos, mientras que los más de 25 PDF impresos se procesan con una precisión casi perfecta.
¿La extracción por lotes cumple con la Ley de Preservación de Libros Electrónicos (電子帳簿保存法)?
La extracción por lotes genera una hoja de cálculo estructurada que cumple con los tres criterios de búsqueda: fecha de transacción, monto y contraparte, con soporte nativo para especificación de rangos y búsqueda combinada mediante filtros de la hoja de cálculo. Sin embargo, la ley aún exige conservar los archivos originales de los albaranes (PDF, escaneos o fotos) durante el período legal. La hoja de cálculo extraída es su índice de búsqueda y registro de trabajo; los archivos originales son su archivo legal. Ambos deben conservarse. Para más detalles sobre los requisitos de búsqueda, consulte las directrices de la NTA sobre el mantenimiento de registros electrónicos.
¿Qué pasa con los albaranes combinados con facturas (納品書兼請求書)?
Algunos proveedores japoneses —especialmente en la fabricación B2B— emiten documentos combinados de albarán y factura (納品書兼請求書). Estos documentos contienen tanto datos de entrega (descripciones de artículos, cantidades) como datos de facturación (precios unitarios, desglose de impuestos, condiciones de pago). Al procesar por lotes documentos combinados, puede extraer ambos conjuntos de campos en una sola pasada definiendo columnas para los campos de entrega y facturación. La hoja de cálculo de salida tendrá todos los datos en una fila por documento, y podrá dividir o filtrar las columnas según sea necesario para sus flujos de trabajo de recepción y cuentas por pagar.
Toda empresa de logística japonesa ha automatizado el movimiento de mercancías. El documento que prueba lo que se movió — el 納品書 — es el último papel que aún se procesa manualmente. La extracción por lotes lo convierte de un turno de 2.5 horas de escritura a una revisión de hoja de cálculo de 5 minutos. Y los datos que produce no solo ahorran tiempo: alimentan la conciliación a tres bandas, cumplen con la Ley de Preservación de Libros Electrónicos y conectan el registro de recepción con todos los sistemas posteriores que esperaban datos estructurados.