여러 공급업체의 일본 납품서를 일괄 처리하여 하나의 수령 로그로 만드는 방법
여러 일본 공급업체의 하루치 納品書(노쇼)를 공급업체별 템플릿 설정 없이 하나의 수령 로그로 일괄 처리합니다.
일본의 입고장이 수동 데이터 입력에 의존하는 이유
제조, 소매, 전자상거래 등 산업 전반의 물류를 담당하는 일본 3PL 시장은 2031년까지 483억 8천만 달러에 이를 전망입니다. 하지만 트럭에 실려 온 물건을 증명하는 문서는 여전히 30년 전과 같은 방식으로 처리됩니다. 누군가 읽고, 데이터를 입력하고, 숫자를 잘못 옮겨 적지 않기를 바라는 방식입니다.
일본의 창고관리시스템은 물리적 프로세스의 거의 모든 것을 자동화했습니다. 도크 도어의 바코드 스캐너는 팔레트 ID를 포착합니다. RFID 태그는 재고 위치를 실시간으로 추적합니다. 무인 운반차는 사람의 개입 없이 구역 간에 상품을 이동합니다. 일본 최대 3PL 기업인 Nippon Express(NX GROUP)는 입고, 적치, 피킹을 밀리초 단위로 조율하는 WMS 플랫폼을 운영합니다. 그러나 이러한 모든 시스템에는 동일한 전제 조건이 있습니다. 작업을 시작하려면 구조화된 데이터가 필요하다는 것입니다. WMS는 디지털 트랜잭션을 수신하면 재고 수준을 업데이트할 수 있지만, 그 트랜잭션은 누군가 납품서를 읽고 데이터를 입력한 후에만 생성될 수 있습니다.
이것은 일본 물류 기술의 실패가 아닙니다. 데이터 입력 문제로 위장한 문서 형식 문제입니다. 납품서(納品書)는 일본 상법상 법적으로 요구되는 문서가 아닙니다. 2023년 10월부터 적격청구서제도(インボイス制度)로 표준화되고 있는 청구서(請求書)와는 다릅니다. 납품서에는 규정된 형식, 필수 항목, Peppol이나 Factur-X에 해당하는 디지털 표준이 없습니다. 모든 공급업체는 백오피스에서 생성하는 방식대로 납품서를 인쇄하거나, 입력하거나, 손으로 작성합니다.
일본의 물류 기술은 상품의 이동을 자동화했습니다. 그러나 상품을 식별하는 문서를 읽는 일은 자동화하지 못했습니다. 팔레트의 바코드와 팔레트가 속한 구매 주문을 시스템에 알려주는 납품서 데이터 사이의 간극은 여전히 사람과 키보드로 메워지고 있습니다.
WMS가 팔레트는 인식해도 납품서는 인식하지 못하는 이유
이러한 격차가 왜 지속되는지 이해하려면 일본의 입고장에 평범한 화요일 아침에 실제로 도착하는 문서를 살펴볼 필요가 있습니다.
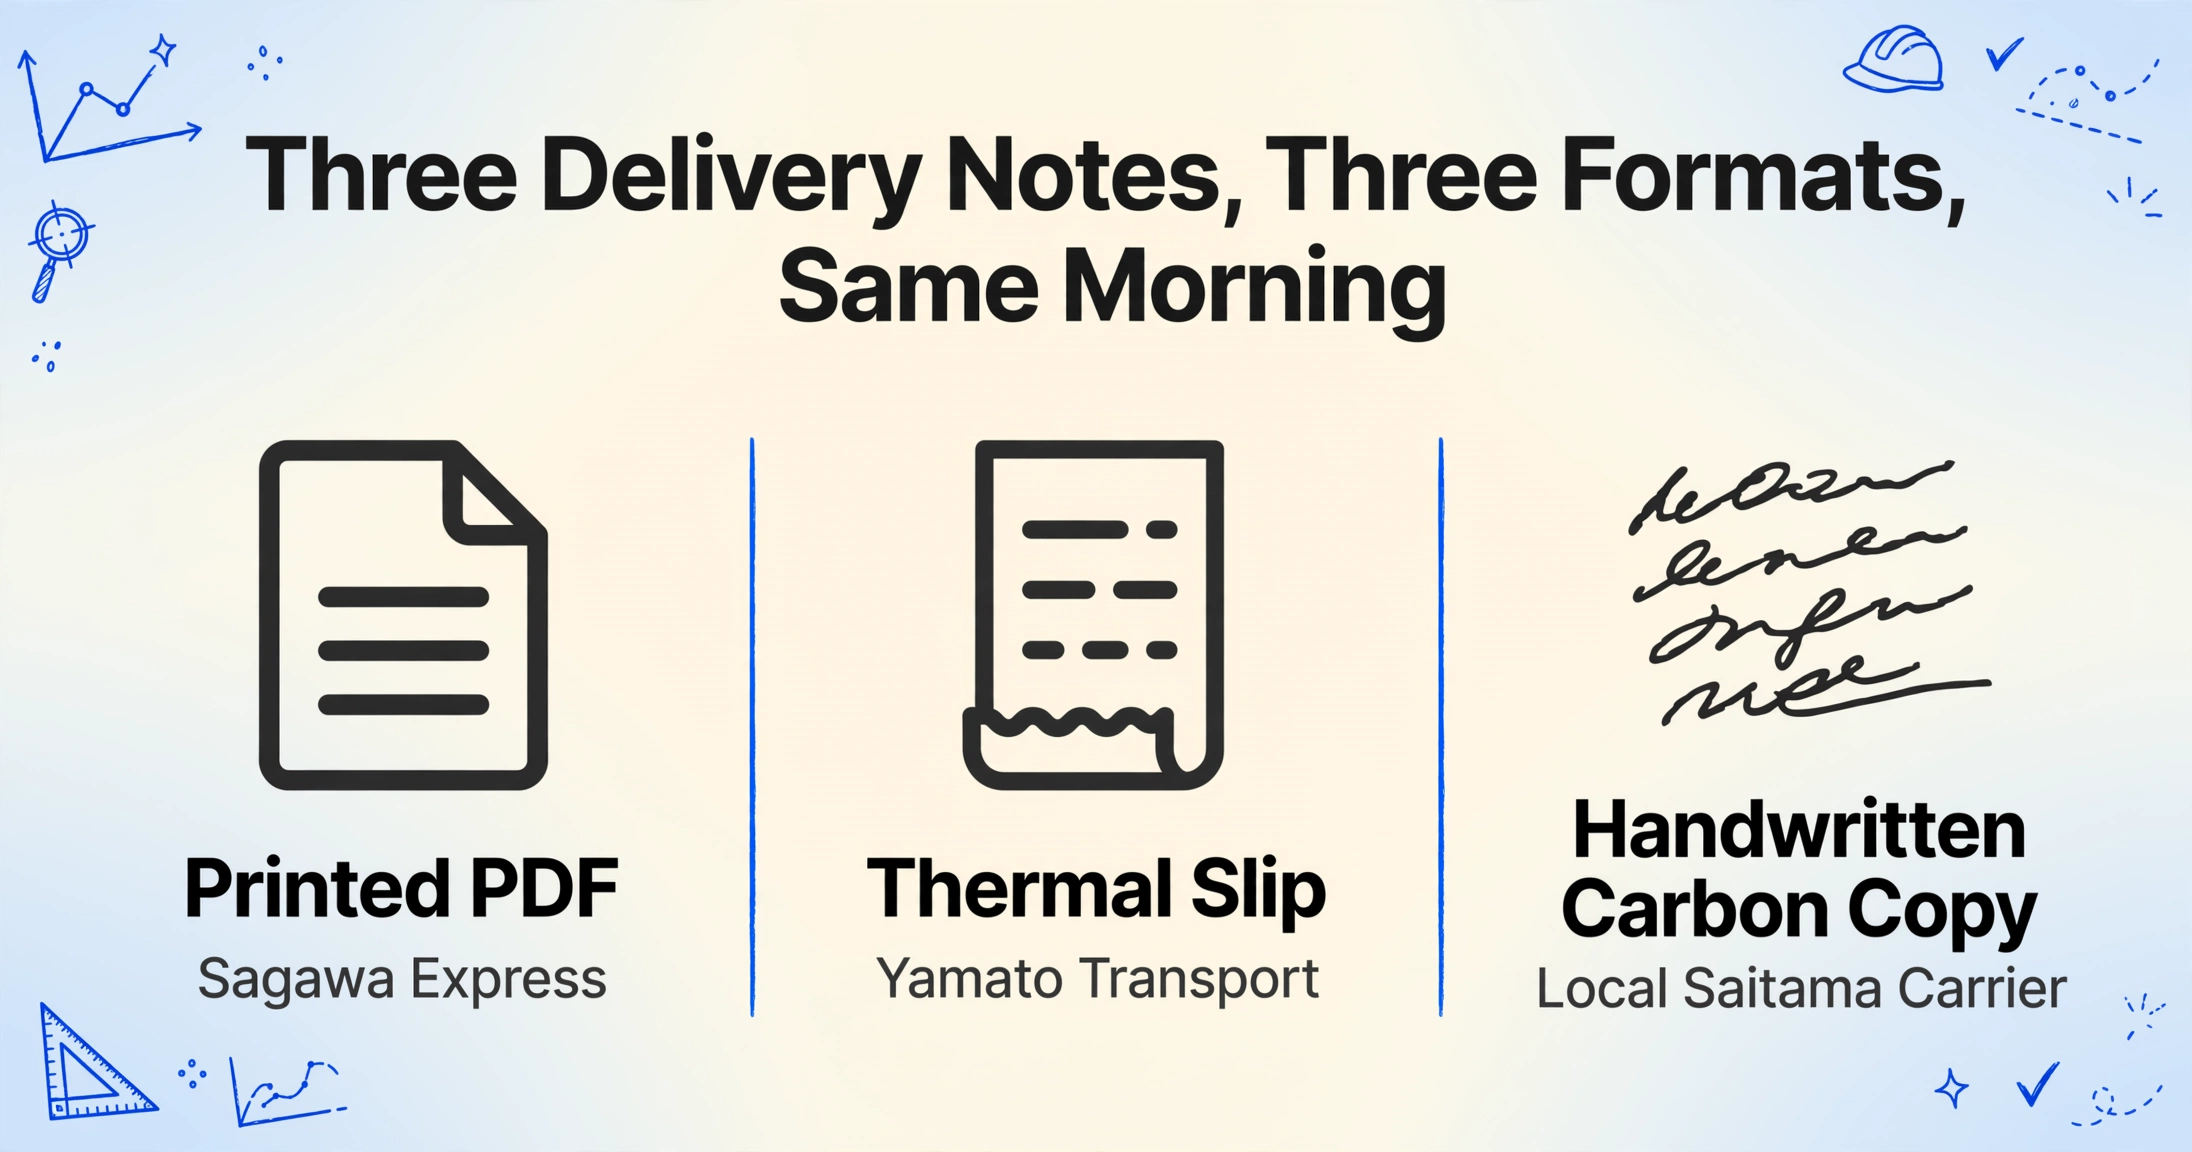
사가와 익스프레스가 간사이 지역 제조업체의 화물을 배송합니다. 납품서는 인쇄된 PDF로 도착합니다. 깔끔한 레이아웃, 다중 열 표, 품목 코드와 수량이 명확하게 표시되어 있습니다. 하지만 필드 이름은 일본어(品名/数量/単位)이고, 날짜는 일본 연호 형식(令和8年6月16日)을 사용하며, 공급업체 회사명은 헤더에 "공급업체"라는 명시적 라벨 없이 표시됩니다.
야마토 운송이 홋카이도 식품 공급업체의 화물을 가져옵니다. 이 납품서는 야마토 물류 센터에서 생성된 감열지 영수증으로, 레이아웃, 필드 라벨, 열 순서가 모두 다릅니다. 사이타마의 소규모 제조업체를 담당하는 지역 운송업체는 손으로 작성한 카본 사본 납품서와 함께 상자 3개를 내려놓습니다. 필체는 성급하게 쓰였고, 수량은 단위가 아닌 상자 수로 표시되어 있으며, 공급업체 이름은 인쇄된 텍스트가 아닌 도장(印鑑)으로 찍혀 있습니다.
이 세 문서는 — 같은 30분 창 안에 도착하는 — 완전히 다른 형식을 나타냅니다. 템플릿 기반 OCR 도구는 세 가지 다른 레이아웃을 위해 세 개의 별도 템플릿을 학습해야 합니다. 다음 주에 네 번째 공급업체가 또 다른 형식으로 나타나면 시스템은 다시 학습해야 합니다. 사가와가 1월에 납품서 템플릿을 변경하면(실제로 발생하는 일), 기존 템플릿은 깨집니다. 이것이 대부분의 일본 물류 기업이 납품서 자동 추출을 시도조차 하지 않는 이유입니다. 템플릿 유지보수 비용이 제거하려는 데이터 입력 비용을 초과하기 때문입니다.
병목 현상은 납품서 데이터가 복잡해서가 아닙니다. 문제는 공급업체 이름, 납품 날짜, 발주 참조 번호, 품목 코드, 수량이라는 동일한 필드가 문서마다 다른 위치에 다른 라벨로 표시된다는 것입니다. 형식당 하나의 템플릿이라는 전통적인 자동화 방식은 형식 다양성 앞에서 무너집니다.
일본 납품서의 데이터 필드는 놀라울 정도로 일관적입니다. easymakedocs의 일본 납품서 가이드에 따르면 표준 요소는 다음과 같습니다: 문서 제목(納品書), 납품서 번호, 납품 날짜, 고객 정보, 공급업체 정보, 품목 세부 정보(이름, 수량, 규격, 선택적 단가), 공급업체 도장. 차이는 내용이 아닌 레이아웃에서 발생합니다. 야마토 납품서에는 지역 운송업체의 손으로 쓴 영수증과 동일한 개념적 필드가 포함되어 있습니다. 차이는 해당 필드가 페이지의 어디에 위치하고 어떻게 라벨이 지정되는지입니다. 추출 과제는 정보가 다르기 때문이 아닙니다. 형식 간에 필드를 찾으려면 필드가 어디에 있는지가 아니라 무엇을 의미하는지 이해해야 하기 때문입니다.
배치 처리: 문서 30건에서 구조화된 입고 대장 1건으로
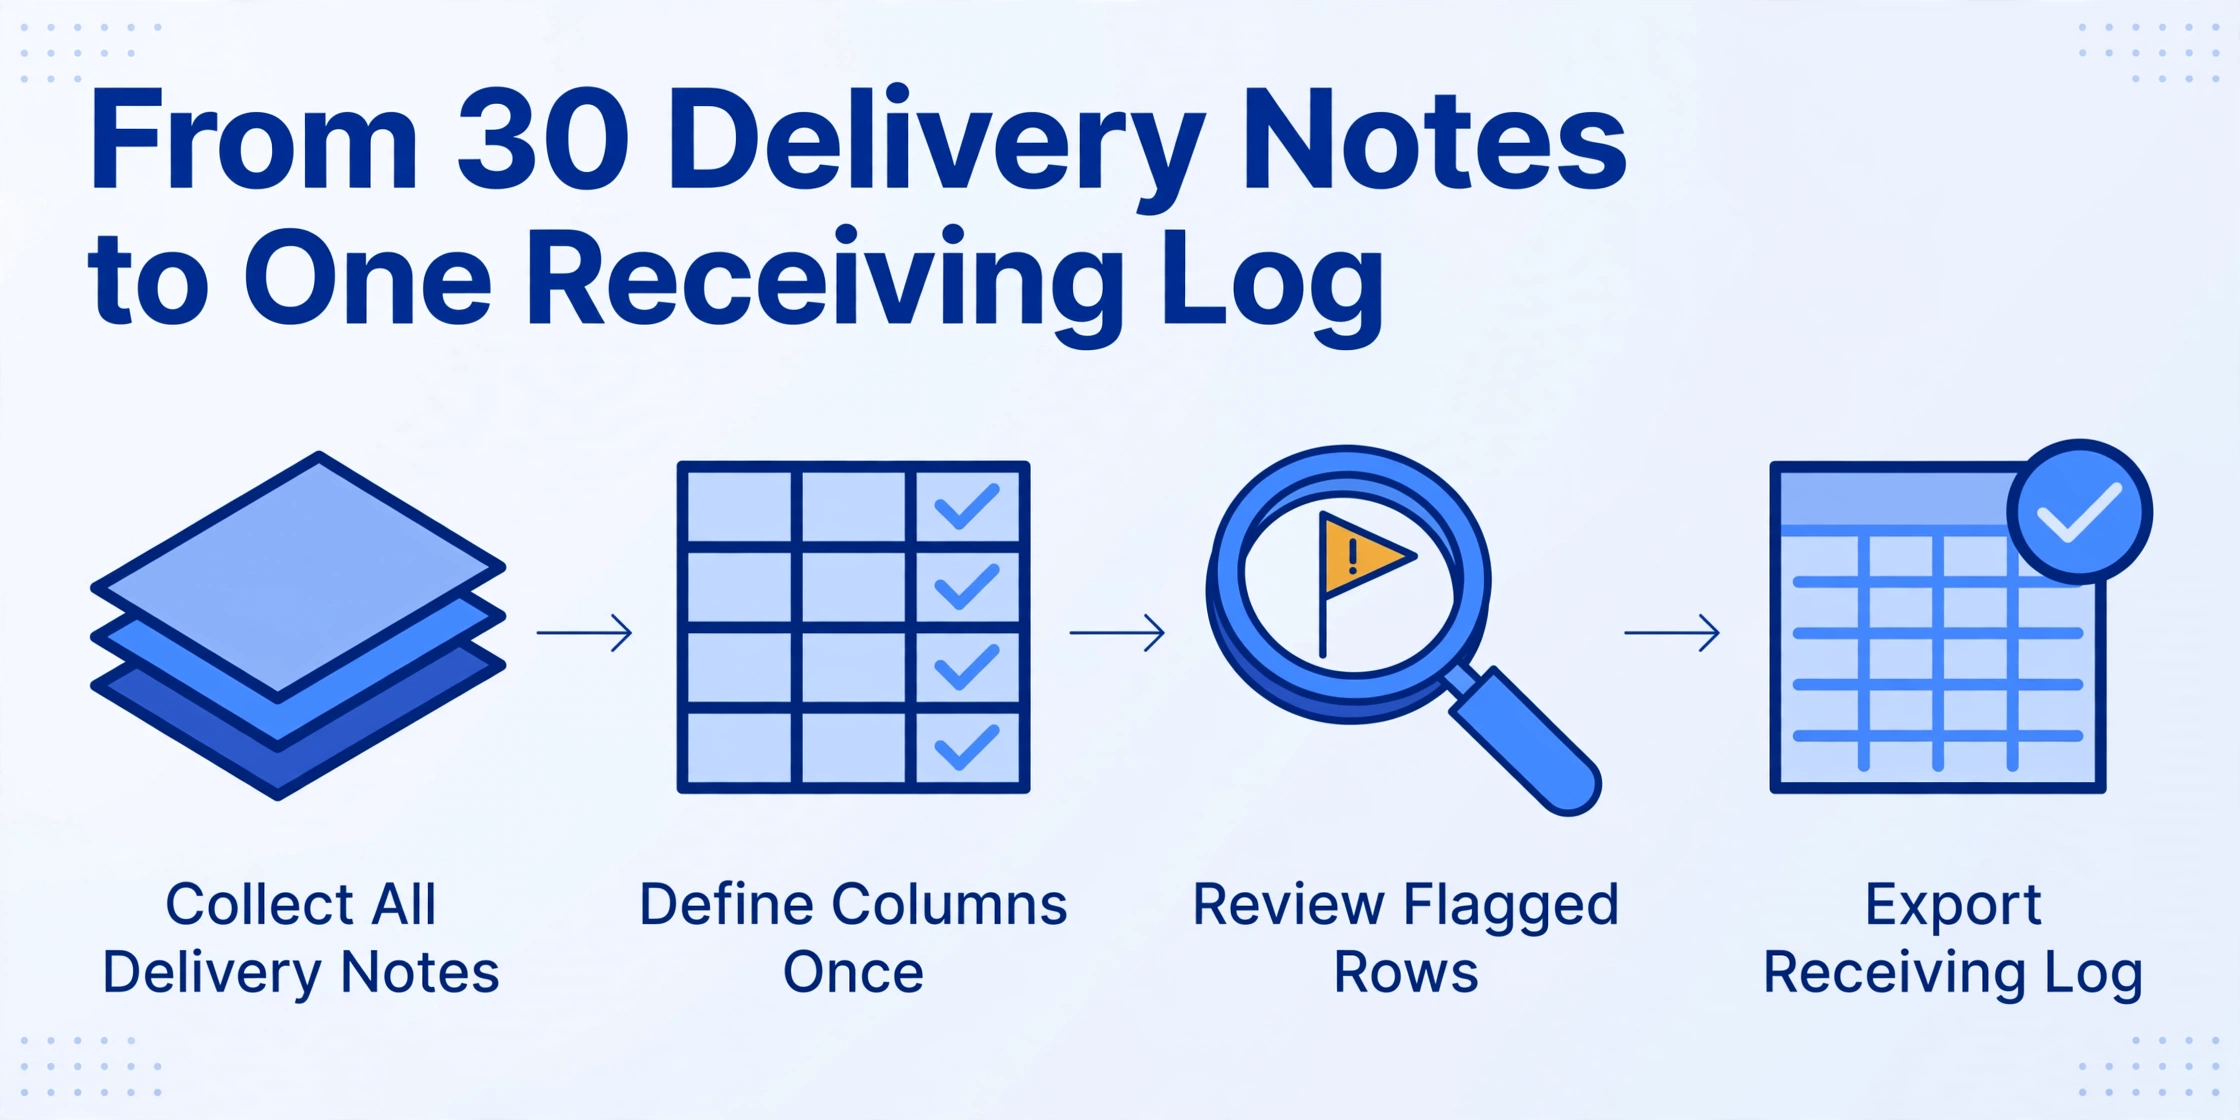
이것이 의미 기반 열 이름 추출이 템플릿 OCR과 차별화되는 지점입니다. 공급업체 A의 레이아웃과 공급업체 B의 레이아웃에서 필드가 어디에 위치하는지 인식하도록 도구를 훈련시키는 대신, 원하는 필드를 한 번만 정의하면 됩니다 — 필드가 나타내는 의미를 기준으로 — 추출 엔진은 의미를 이해하여 배치 내 모든 문서에서 각 값을 찾아냅니다.
ImageToTable.ai는 맞춤 열 추출을 사용합니다: 최종 입고 대장에 원하는 열 헤더를 입력하면 — "공급업체명", "납품일", "발주 번호", "품목 코드", "품목 설명", "납품 수량", "단위" — AI가 배치 내 각 납품서를 읽고, 페이지 내 위치와 관계없이 각 필드를 찾아 해당 열에 값을 채웁니다. "공급업체명"이라는 열은 헤더에 "株式会社〇〇"로 인쇄되어 있든, 인감 도장으로 찍혀 있든, "納入元"으로 표기되어 있든 공급업체를 찾아냅니다 — 추출이 위치 기반이 아닌 의미 기반이기 때문입니다.
파일은 안전하게 처리되며 저장되지 않습니다.
일본 물류 입고 팀을 위한 워크플로:
효율성 향상은 측정 가능합니다. 단일 페이지 납품서는 추출을 통해 5~10초 안에 처리됩니다 — 평균 3분의 수동 입력 대비 18배 개선입니다. 그러나 더 중요한 이점은 오류 감소입니다. 하루 30건의 납품서, 각각 평균 5개의 라인 항목이 있을 때 수동 입력은 대략 150개의 데이터 포인트를 생성합니다. 보수적인 1% 전사 오류율에서도 하루에 1~2개의 오류가 발생합니다 — 품번의 숫자 전위, 수량의 잘못된 소수점 등. 한 달이면 30~60개의 오류가 WMS, 3자 매칭 시스템, 지급 처리 워크플로우로 전파됩니다. 일괄 추출이 검증의 필요성을 없애지는 않지만, 전사 작업에서 확인 작업으로 전환시키며, 이는 훨씬 더 빠르고 오류 가능성이 낮습니다.
입고 기록에서 삼중 대사 및 전자장부법 준수까지
입고 기록은 최종 목적지가 아닙니다. 이는 일본 물류 회사가 정확하게 대금을 받고 감사 대비 상태를 유지하는지 결정하는 두 가지 중요한 다운스트림 프로세스의 상위 입력입니다.
일본의 전자장부보존법에 따라, 전자적으로 보관된 모든 거래 문서는 거래일자, 거래금액, 거래처의 세 가지 기준으로 검색 가능해야 합니다. 연간 매출이 5천만 엔을 초과하는 기업의 경우 이러한 검색 가능 요구 사항은 필수입니다.
공급업체가 임의로 명명한 30개의 PDF 납품서 폴더("納品書_20260616.pdf", "delivery_sagawa.pdf", "Scan001.pdf")는 검색 가능성 테스트를 통과하지 못합니다. 각 행에 공급업체명, 납품일자, 발주번호, 운송사, 품목코드, 납품수량이 포함된 구조화된 스프레드시트는 자동으로 통과합니다. 법에서 검색을 요구하는 모든 기준이 스프레드시트의 열입니다. 날짜 범위 필터링, 금액 필터링, 거래처 검색 모두 기본 스프레드시트 작업이 되며, 수동으로 파일 하나하나를 찾을 필요가 없습니다.
이는 대부분의 문서 자동화 논의에서 간과하는 일괄 추출의 부차적 이점입니다. 납품서에서 구조화된 데이터를 추출하는 행위는 동시에 일본의 전자 저장 규정 준수를 충족시킵니다. 원본 PDF는 법정 보존 기간(소비세법상 거래 문서 7년, 상법상 상업 장부 10년) 동안 계속 보관해야 하지만, 세무 조사 중 신속한 검색을 위해 추출된 스프레드시트가 팀이 실제로 사용하는 도구입니다.
입고 기록은 또한 공급업체 지급을 승인하는 삼중 대사 프로세스에 직접 입력됩니다. 표준 일본 조달 관행에 따라, 납품서의 수량과 품목이 발주서와 청구서 모두에 대해 확인될 때까지 어떤 청구서도 승인되어서는 안 됩니다. 이것이 발주서 → 납품서 → 청구서 검증 체인입니다. 그러나 삼중 대사는 세 문서 모두 구조화된 데이터인 경우에만 자동화될 수 있습니다:
일괄 추출에서 Excel 또는 CSV로 내보낸 구조화된 수령 로그는 3자 매칭 루프를 닫는 다리가 됩니다. 추출된 데이터는 freee, MoneyForward Cloud, Yayoi (弥生) 또는 회사의 WMS에 직접 가져올 수 있습니다. SAP Japan, GLOVIA smart (Fujitsu), EXPLANNER (NEC)을 사용하는 회사의 경우 CSV 출력이 표준 수령 거래 가져오기 형식에 매핑됩니다. 3자 매칭은 문서별 수동 대조에서 체계적인 예외 검토로 전환됩니다: PO 수량 ≠ 납품 수량인 행만 사람의 주의가 필요합니다.
주요 운송사(NX, 사가와, 야마토)와 지역 운송 회사가 혼합된 환경에서 하루 30건의 공급업체 납품을 처리하는 물류 회사의 경우, 구조화된 수령 로그와 비구조화된 수령 로그의 차이는 2.5시간의 입력 작업과 5분의 스프레드시트 검토의 차이입니다. 월 20일 근무일로 계산하면 50시간이 회복됩니다 — 이는 풀타임 직원 한 명의 근무 시간 이상입니다 — 예외 조사, 운송사 커뮤니케이션 또는 키보드로 자동화할 수 없는 다른 작업에 사용할 수 있습니다.
자주 묻는 질문
주요 일본 운송회사와 소규모 지역 운송회사 모두의 배송장을 처리할 수 있나요?
네, 가능합니다. 의미 기반 추출은 각 필드의 의미를 이해하여 배송장을 읽습니다. 즉, 페이지 내 위치가 아닌 필드의 의미를 기준으로 합니다. "공급업체명"이라는 열은 사가와 PDF의 헤더에 인쇄되어 있든, 카본지 전표에 도장으로 찍혀 있든, 지역 운송회사 배송장에 손으로 쓰여 있든 관계없이 공급업체를 찾아냅니다. 이는 각 레이아웃마다 별도의 템플릿이 필요한 템플릿 기반 OCR과의 근본적인 차이점입니다. 입고 로그 열을 한 번만 정의하면 이전에 본 적 없는 새로운 서식까지 모든 공급업체 서식에서 작동합니다.
배송장에 서력 대신 일본 연호(令和)가 사용된 경우는 어떻게 하나요?
추출 결과는 원래 연호 형식을 유지하거나 내보내기 시 자동으로 변환할 수 있습니다. 하위 시스템(예: ERP 가져오기)에서 서력 날짜가 필요한 경우, 도구의 후처리 레이어에서 내보내기 시 令和8年6月16일을 2026-06-16으로 변환합니다. 열을 "배송일"로 정의하고 출력 형식을 제어하면 수동 날짜 변환이 필요하지 않습니다.
기존 WMS(SAP, GLOVIA, freee, MoneyForward)와 어떻게 통합하나요?
추출 결과(Excel 파일 또는 CSV)는 입고 거래에 대한 CSV 가져오기를 지원하는 모든 WMS 또는 ERP로 가져올 수 있습니다. Freee 및 MoneyForward Cloud는 CSV 기반 분개장 가져오기(仕訳インポート)를 지원합니다. SAP Japan 및 Oracle Japan은 CSV 기반 입고 거래 로드를 지원합니다. 추출 단계는 가져오기 단계와 분리되어 있어 데이터가 시스템에 입력되는 시기와 방법을 제어할 수 있습니다. 일본 배송장 추출 워크플로우에 대한 자세한 내용은 일본 배송장 데이터를 Excel로 추출하는 가이드를 참조하십시오.
손으로 쓴 일본어 배송장도 읽을 수 있나요?
네, 가능합니다. 비전 모델은 지역 운송회사의 카본지 배송장에 있는 일본어 문자를 포함한 필기 텍스트를 처리합니다. 필기 인식의 정확도는 인쇄된 텍스트보다 낮습니다. 특히 급하게 쓰거나, 번지거나, 대비가 낮은 필기의 경우 더욱 그렇습니다. 따라서 필기 필드는 검토 단계에서 빠른 육안 확인이 도움이 됩니다. 이 도구는 저품질 입력에 대해 잘못된 확신을 주지 않으며, 추측하기보다는 불확실성을 표면화합니다. 30개의 배송장 중 3~5개가 필기인 배치의 경우, 검토 단계는 해당 소수의 문서에 집중하고 25개 이상의 인쇄된 PDF는 거의 완벽한 정확도로 처리됩니다.
一括抽出は電子帳簿保存法に対応していますか?
一括抽出により、取引日・取引金額・取引先の3つの検索要件を満たす構造化されたスプレッドシートが生成されます。範囲指定や組み合わせ検索は、スプレッドシートのフィルタ機能でネイティブにサポートされます。ただし、法律では原本の納品書ファイル(PDF、スキャン、写真)を法定保存期間中保持することが依然として必要です。抽出されたスプレッドシートは検索可能なインデックス兼作業記録であり、原本ファイルは法的なアーカイブです。両方を保存する必要があります。検索要件の詳細については、国税庁の電子帳簿保存に関するガイドラインをご参照ください。
納品書兼請求書の場合はどうなりますか?
一部の日本のサプライヤー(特にB2B製造業)は、納品書兼請求書を発行します。これらの文書には、納品データ(品目説明、数量)と請求データ(単価、税内訳、支払条件)の両方が含まれます。複合文書を一括処理する場合、納品フィールドと請求フィールドの両方の列を定義することで、1回の処理で両方のデータセットを抽出できます。出力されるスプレッドシートでは、1文書あたり1行にすべてのデータが格納され、後続の入庫業務や買掛金処理ワークフローに応じて列を分割またはフィルタリングできます。
日本の物流企業はすべて、モノの移動を自動化しています。何が動いたかを証明する書類——納品書——は、いまだに手作業で処理されている最後の紙です。一括抽出により、2.5時間のタイピング作業が5分のスプレッドシートレビューに変わります。そして生成されるデータは時間を節約するだけでなく、三者照合に対応し、電子帳簿保存法を満たし、入庫記録を構造化された入力を待っていたすべての下流システムに接続します。