30 Lieferscheine (albaranes) am Tag, ein Protokoll
Batch-Verarbeitung spanischer Lieferscheine
Der spanische Hersteller von Lagerverwaltungssoftware Mecalux – eine in Barcelona ansässige Intralogistik-Gruppe, die in über 70 Ländern tätig ist und im Gartner Magic Quadrant 2026 für WMS (Lagerverwaltungssysteme) genannt wird – berichtet, dass seine Easy-WMS-Plattform für seine Lagerkunden eine 99-prozentige Fehlerbeseitigung und eine Produktivitätssteigerung von 60 % erreicht. Diese Zahlen beschreiben, was passiert, wenn das WMS saubere Daten erhält. Die Lücke zwischen diesem Versprechen und der Realität ist der Stapel an Lieferscheinen (albaranes), der jeden Morgen auf dem Wareneingangsschreibtisch liegt: 30 Seiten von 20 verschiedenen Lieferanten, gedruckt von 20 verschiedenen ERP-Systemen, einige auf Thermopapier, einige als Durchschläge, die meisten mit handschriftlichen Mengenkorrekturen des Empfängers. In diesem Artikel geht es darum, diese Lücke im Batch-Maßstab zu schließen.
Die wichtigsten Erkenntnisse
- Ein morgendlicher Stapel von 30 Lieferscheinen (albaranes) von 20 Lieferanten kostet 2 Stunden Tipparbeit – und das ist noch der günstigste Teil.
- Vertippen Sie sich bei einer Lieferscheinnummer nur um eine Ziffer, bricht der Drei-Wege-Abgleich für sämtliche Monatsrechnungen dieses Lieferanten zusammen – aber das erfahren Sie erst nach drei Wochen.
- ImageToTable.ai liest Lieferscheinnummern, NIF (Steueridentifikationsnummer) und Mengen aus 20 verschiedenen Lieferantenformaten mit einer einzigen Spaltendefinition – weil die KI danach sucht, was das Feld bedeutet, und nicht, wo es auf der Seite steht.
Ein einzelner Lieferschein (albarán) dauert nur Minuten, um ihn einzutippen. Das eigentliche Problem beginnt, wenn jeden Morgen 30 davon von 20 verschiedenen Lieferanten eintreffen.
Die Extraktion einzelner Dokumente löst ein 3-Minuten-Problem. Die Batch-Verarbeitung löst ein strukturelles Workflow-Problem, bei dem 30 Minuten Dateneingabe nicht die Kosten sind – sondern die 30 unabhängigen Entscheidungen über die Feldplatzierung, die 30 Gelegenheiten, eine handschriftliche Menge falsch zu lesen, und die 30 manuellen Tastatureingaben in das WMS (Lagerverwaltungssystem), die jeweils eine Fehlerquote von 1-3 % mit sich bringen.
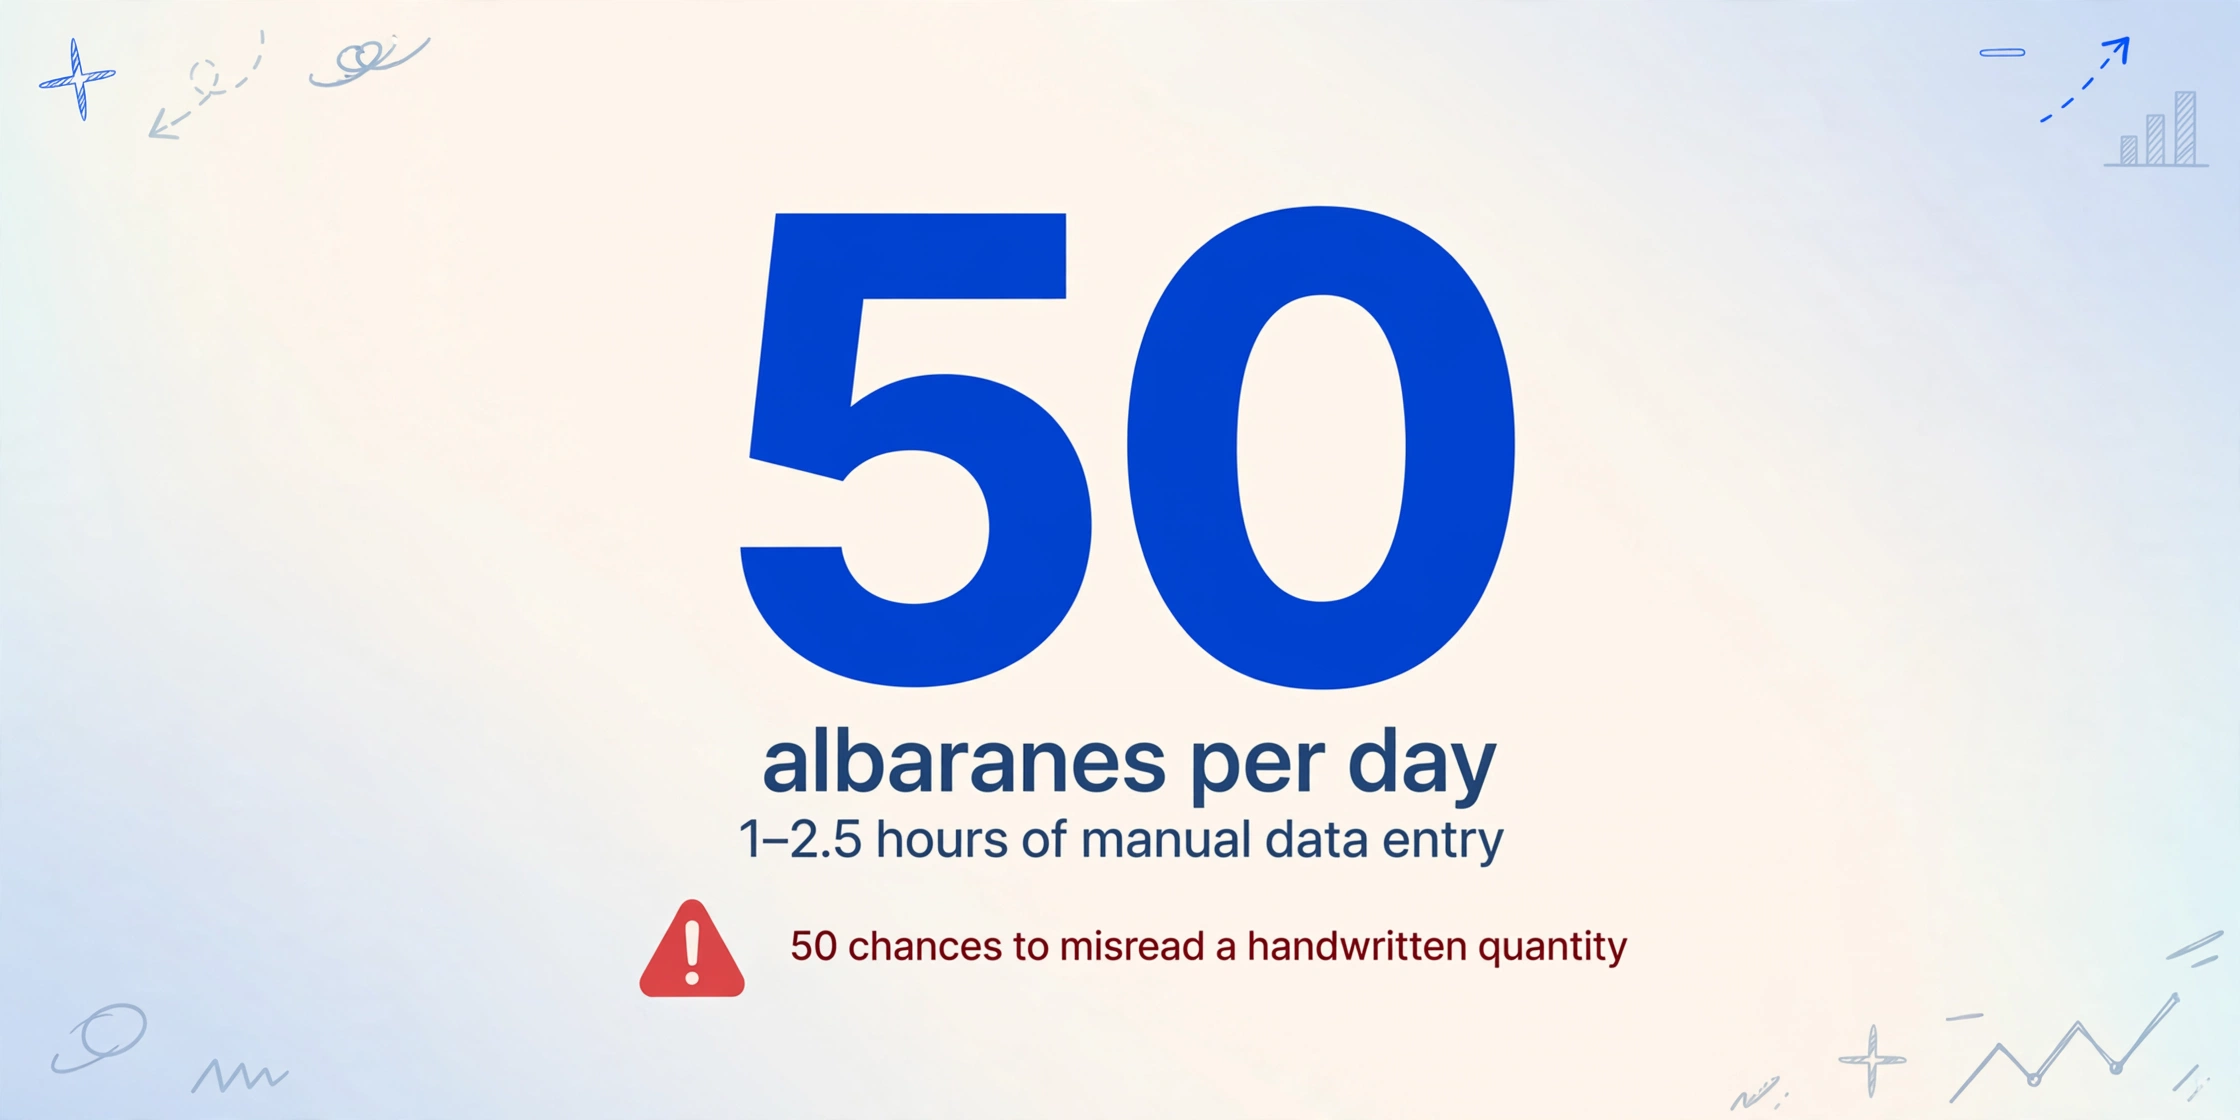
Ein einzelner spanischer Lieferschein (albarán) ist machbar. Der Wareneingangsmitarbeiter liest die gedruckten Felder – Albarán-Nummer, NIF (Steueridentifikationsnummer) des Lieferanten, Produktcodes, gelieferte Mengen – und tippt sie in das WMS (Lagerverwaltungssystem) oder ERP-System. Bei 3 Minuten pro Seite dauert ein Stapel von 5 Dokumenten 15 Minuten. Das ist mühsam, aber machbar. Das Problem ist, dass Lager, die von einer typischen spanischen Lieferantenbasis beliefert werden, nicht nur 5 Albaranes pro Tag sehen. Ein mittelgroßes Distributionszentrum, das den regionalen Einzelhandel beliefert, oder ein Fertigungswerk, das Rohstoffe von einer Mischung aus großen und kleinen spanischen Lieferanten erhält, verarbeitet täglich 20-50 Albaranes. Bei diesem Volumen ergeben 3 Minuten pro Seite 1-2,5 Stunden reine Dateneingabe. Aber die eigentlichen Kosten sind nicht die Tippzeit – sondern das, was passiert, wenn diese 50 manuellen Übertragungen auf den Drei-Wege-Abgleich treffen.
Wenn Sie eine Einführung dazu benötigen, was spanische Albaranes strukturell von generischen Lieferscheinen unterscheidet – einschließlich des NIF-Steueridentifikationsformats, der Durchschlagpapier-Tradition und der rechtlichen Bedeutung, die sie gemäß dem Spanischen Handelsgesetzbuch (Código de Comercio) haben – beginnen Sie mit dem Leitfaden zur Extraktion einzelner Albarán-Dokumente. Dieser Artikel setzt voraus, dass Sie bereits wissen, was ein Albarán ist, und konzentriert sich darauf, was sich ändert, wenn Sie sie dutzendweise statt einzeln verarbeiten.
Die Skalierungsklippe dreht sich nicht um Geschwindigkeit – sondern um Entscheidungsdichte. Die Verarbeitung eines Albarán erfordert einen Satz von Feldplatzierungsentscheidungen. Die Verarbeitung von 30 von verschiedenen Lieferanten erfordert 30 unabhängige Sätze. Das menschliche Gehirn kann 5 ohne Ermüdung bewältigen. Bei 30 potenzieren sich die Fehlerquoten. Bei 50 beginnt der Drei-Wege-Abgleich – Lieferschein → Rechnung (factura) → Bestellung – zu scheitern, nicht weil ein einzelner Eintrag falsch war, sondern weil die kumulative Wahrscheinlichkeit einer Abweichung über 150 Referenznummern (50 Albaranes × 3 Abgleichsschlüssel) nahezu sicher wird.
Batch-Verarbeitung verstärkt die Formatfragmentierung nicht — sie zeigt, dass vorlagenbasierte Extraktion nie eine echte Lösung war.
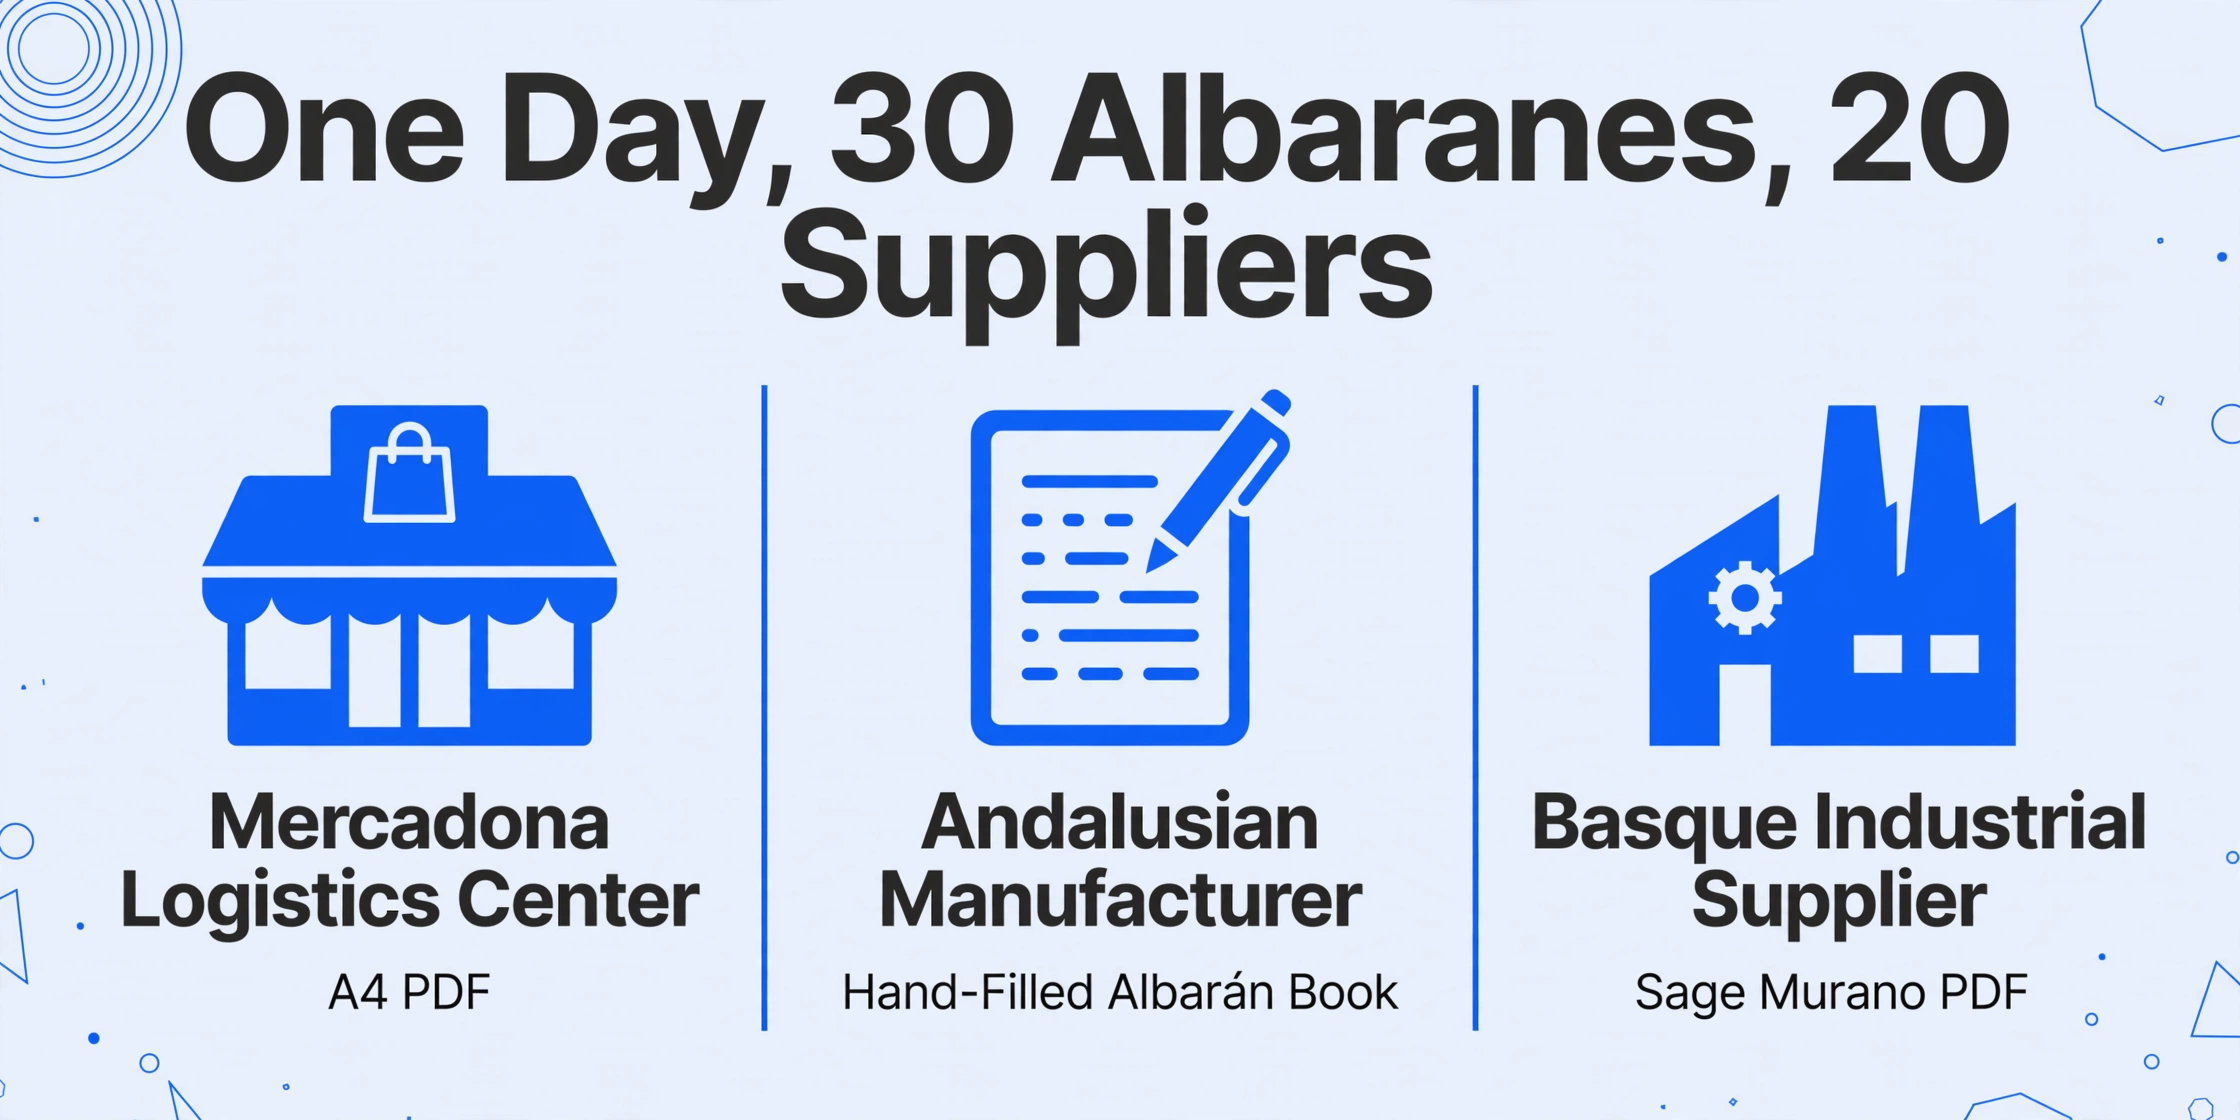
Wenn Sie einen einzelnen Lieferschein (albarán) verarbeiten, können Sie dessen Eigenheiten tolerieren. Wenn Sie 30 von 20 Lieferanten verarbeiten, sind die Formatunterschiede zwischen einem Lieferschein (albarán) vom Mercadona-Logistikzentrum, einem handschriftlich ausgefüllten Lieferscheinbuch (albarán) eines lokalen andalusischen Herstellers und einer Sage Murano-PDF eines baskischen Industrielieferanten keine Eigenheiten — sie sind eine strukturelle Barriere, die vorlagenbasierte Extraktion nicht überwinden kann.
Die spanische Lieferschein-Formatlandschaft (albarán) ist dauerhaft heterogen, weil die Ökonomie der Standardisierung nicht ausgerichtet ist. Die AECOC (spanische GS1-Normungsorganisation) (Asociación de Fabricantes y Distribuidores, Spaniens GS1-Normungsorganisation mit über 35.000 Mitgliedsunternehmen) hat über ihre Plattformen AECOC EDI (elektronischer Datenaustausch) und AECOC TRANSP elektronische Lieferscheinstandards entwickelt. Große Einzelhändler wie Mercadona, Carrefour Spanien und El Corte Inglés schreiben EDI (elektronischer Datenaustausch) für ihre Tier-1-Lieferanten vor. Aber für den Mittelstand — regionale Distributoren, Industrielieferanten, lokale Hersteller — bleiben Papier-Lieferscheine (albaranes), die aus dem jeweiligen ERP-System des Lieferanten gedruckt werden, die Norm.
UNO Logística (spanischer Logistikverband), Spaniens wichtigster Logistikverband mit über 350 Logistik- und Transportunternehmen, identifiziert die Fragmentierung der Dokumentformate als strukturelle Barriere für die Digitalisierung der Lieferkette. Das Spanische Logistikzentrum (CEL), Spaniens größte Logistik-Fachgemeinschaft seit 1978, ist in seinen Digitalisierungs-Arbeitsgruppen zum gleichen Ergebnis gekommen: Die Standardisierung wird zunächst Hochvolumen-Korridore erreichen, aber der lange Schwanz der mittelständischen Lieferanten wird noch Jahre lang heterogene Papier- und PDF-Lieferscheine (albaranes) produzieren.
Im Einzeldokument-Maßstab können Sie eine Vorlage pro Lieferant erstellen. Bei 20 Lieferanten sind das 20 Vorlagen, die Sie erstellen und pflegen müssen — und Vorlagen brechen, wenn ein Lieferant sein ERP-Ausgabeformat ändert, ohne Sie zu informieren. Der Wareneingangsmitarbeiter kontrolliert die Lieferantenformate nicht. Er erhält, was am Dock ankommt. Der einzige praktikable Ansatz im Batch-Maßstab ist die Benutzerdefinierte Spaltenextraktion: eine Methode, bei der Sie die gewünschten Feldnamen definieren — „Albarán-Nummer", „Lieferanten-NIF (Steueridentifikationsnummer)", „Gelieferte Menge" — und die KI jedes Dokument liest, um diese Werte zu finden, indem sie versteht, was der Feldname bedeutet, nicht indem sie eine feste Pixelposition auf dem Layout eines bestimmten Lieferanten abgleicht.
Eine Spaltendefinition funktioniert über 20 verschiedene Lieferantenformate hinweg, weil die KI nach Bedeutung liest, nicht nach Position. Die Spaltennamen, die Sie eingeben, werden zu den Kopfzeilen Ihrer Ausgabetabelle — keine Vorlagenpflege erforderlich.
Der Batch-Workflow für spanische Albarane: Tagesstapel hochladen, Spalten einmal definieren, einheitliches Wareneingangsprotokoll exportieren.
Die gesamten morgendlichen Albarane – PDFs aus dem Lieferantenportal, gescannte Durchschläge vom Wareneingang, bei Anlieferung aufgenommene Fotos – gehen in einen Upload. Eine Spaltendefinition. Eine Ausgabetabelle.
Batch-Verarbeitung bei ImageToTable.ai bedeutet das gleichzeitige Hochladen mehrerer Dateien, das einmalige Definieren Ihrer Extraktionsspalten und den Erhalt einer einzigen konsolidierten Ausgabe, bei der jedes Dokument eine Zeile in der Tabelle wird. Der grundlegende Vorteil ist, dass Sie den Schritt der Spaltendefinition nicht pro Dokument wiederholen – Sie führen ihn einmal für den gesamten Batch durch, und die KI wendet das gleiche semantische Verständnis auf jedes Lieferantenlayout an. Für Google Sheets-Nutzer extrahiert das Add-on in der Seitenleiste die Ergebnisse direkt in das aktive Blatt, ohne die Tabelle verlassen zu müssen.
Lieferscheine (albaranes) des Tages hochladen – alle Formate zusammen
Laden Sie PDF-Lieferscheine (albaranes) von Lieferantenportalen, gescannte Durchschlagseiten vom Wareneingang oder Handyfotos von Lieferkontrollen hoch. Digitale PDFs, gescannte Papierdokumente und Fotos können in derselben Batch-Upload gemischt werden. Wenn Ihre Fahrer oder Remote-Lager Mitarbeiter Lieferscheine (albaranes) direkt einreichen müssen, generiert der Sammellink eine teilbare Upload-Seite – der Absender öffnet den Link, gibt einen Verifizierungscode ein und lädt Dateien hoch. Für den Absender ist keine Anmeldung oder Registrierung erforderlich. Lieferscheine (albaranes) landen direkt in Ihrer Verarbeitungswarteschlange und umgehen E-Mail-Anhänge und WhatsApp-Fotos vollständig.
Definieren Sie Ihre Wareneingangslog-Spalten einmal – sie funktionieren bei jedem Lieferanten
Geben Sie die Feldnamen ein, die Ihr Wareneingangs-Workflow und Ihr ERP-System benötigen: Albarán-Nummer | PO-Referenz | Lieferantenname | Lieferanten-NIF | Lieferdatum | Produktcode | Artikelbeschreibung | Versandmenge | Empfangsmenge | Ausnahmevermerke | Empfängerunterschrift. Die KI findet jeden Wert auf jedem Lieferschein (albarán) des Lieferanten, indem sie versteht, was der Spaltenname bedeutet – nicht durch Abgleich einer gespeicherten Pixelposition. Fügen Sie eine berechnete Spalte wie Mengendifferenz (Versandmenge − Empfangsmenge) hinzu und die KI berechnet die Differenz während der Extraktion und markiert Abweichungen, bevor die Daten Ihr WMS (Lagerverwaltungssystem) erreichen. Fügen Sie eine abgeleitete Spalte wie Lieferzustand (Optionen: Vollständig/Teilweise/Beschädigt) hinzu und die KI bewertet den Lieferschein (albarán)-Inhalt, um den korrekten Status für jedes Dokument im Batch zuzuweisen.
Exportieren Sie das konsolidierte Wareneingangslog
Laden Sie als XLSX, CSV oder JSON herunter. Jeder Lieferschein (albarán) wird zu einer Zeile. Jedes Feld – Albarán-Nummer, Lieferanten-NIF, Produktcodes, versandte und empfangene Mengen, Ausnahmevermerke, Unterschriftsstatus – erscheint in einer eigenen Spalte. Die Tabelle ist bereit für die WMS-Wareneingangsbuchung in SAP Business One, Sage 200 / Sage Murano, Microsoft Dynamics NAV / Business Central, Holded oder Mecalux Easy WMS. Die Albarán-Nummernspalte ist der Schlüssel, der jede Zeile mit der nachfolgenden Rechnung (factura) für den Drei-Wege-Abgleich verknüpft. Die Verarbeitung dauert 5–10 Sekunden pro Seite.
Testen Sie den Extraktionsablauf unten mit einem Beispiel-Lieferschein. Die Demo lädt eine Voreinstellung – einen vorkonfigurierten Satz von Spaltennamen, der der Standardstruktur von Lieferschein und Packliste entspricht – sodass Sie Extraktionsergebnisse sofort sehen können, ohne Spaltennamen eingeben zu müssen.
Dateien werden sicher verarbeitet und nicht gespeichert.
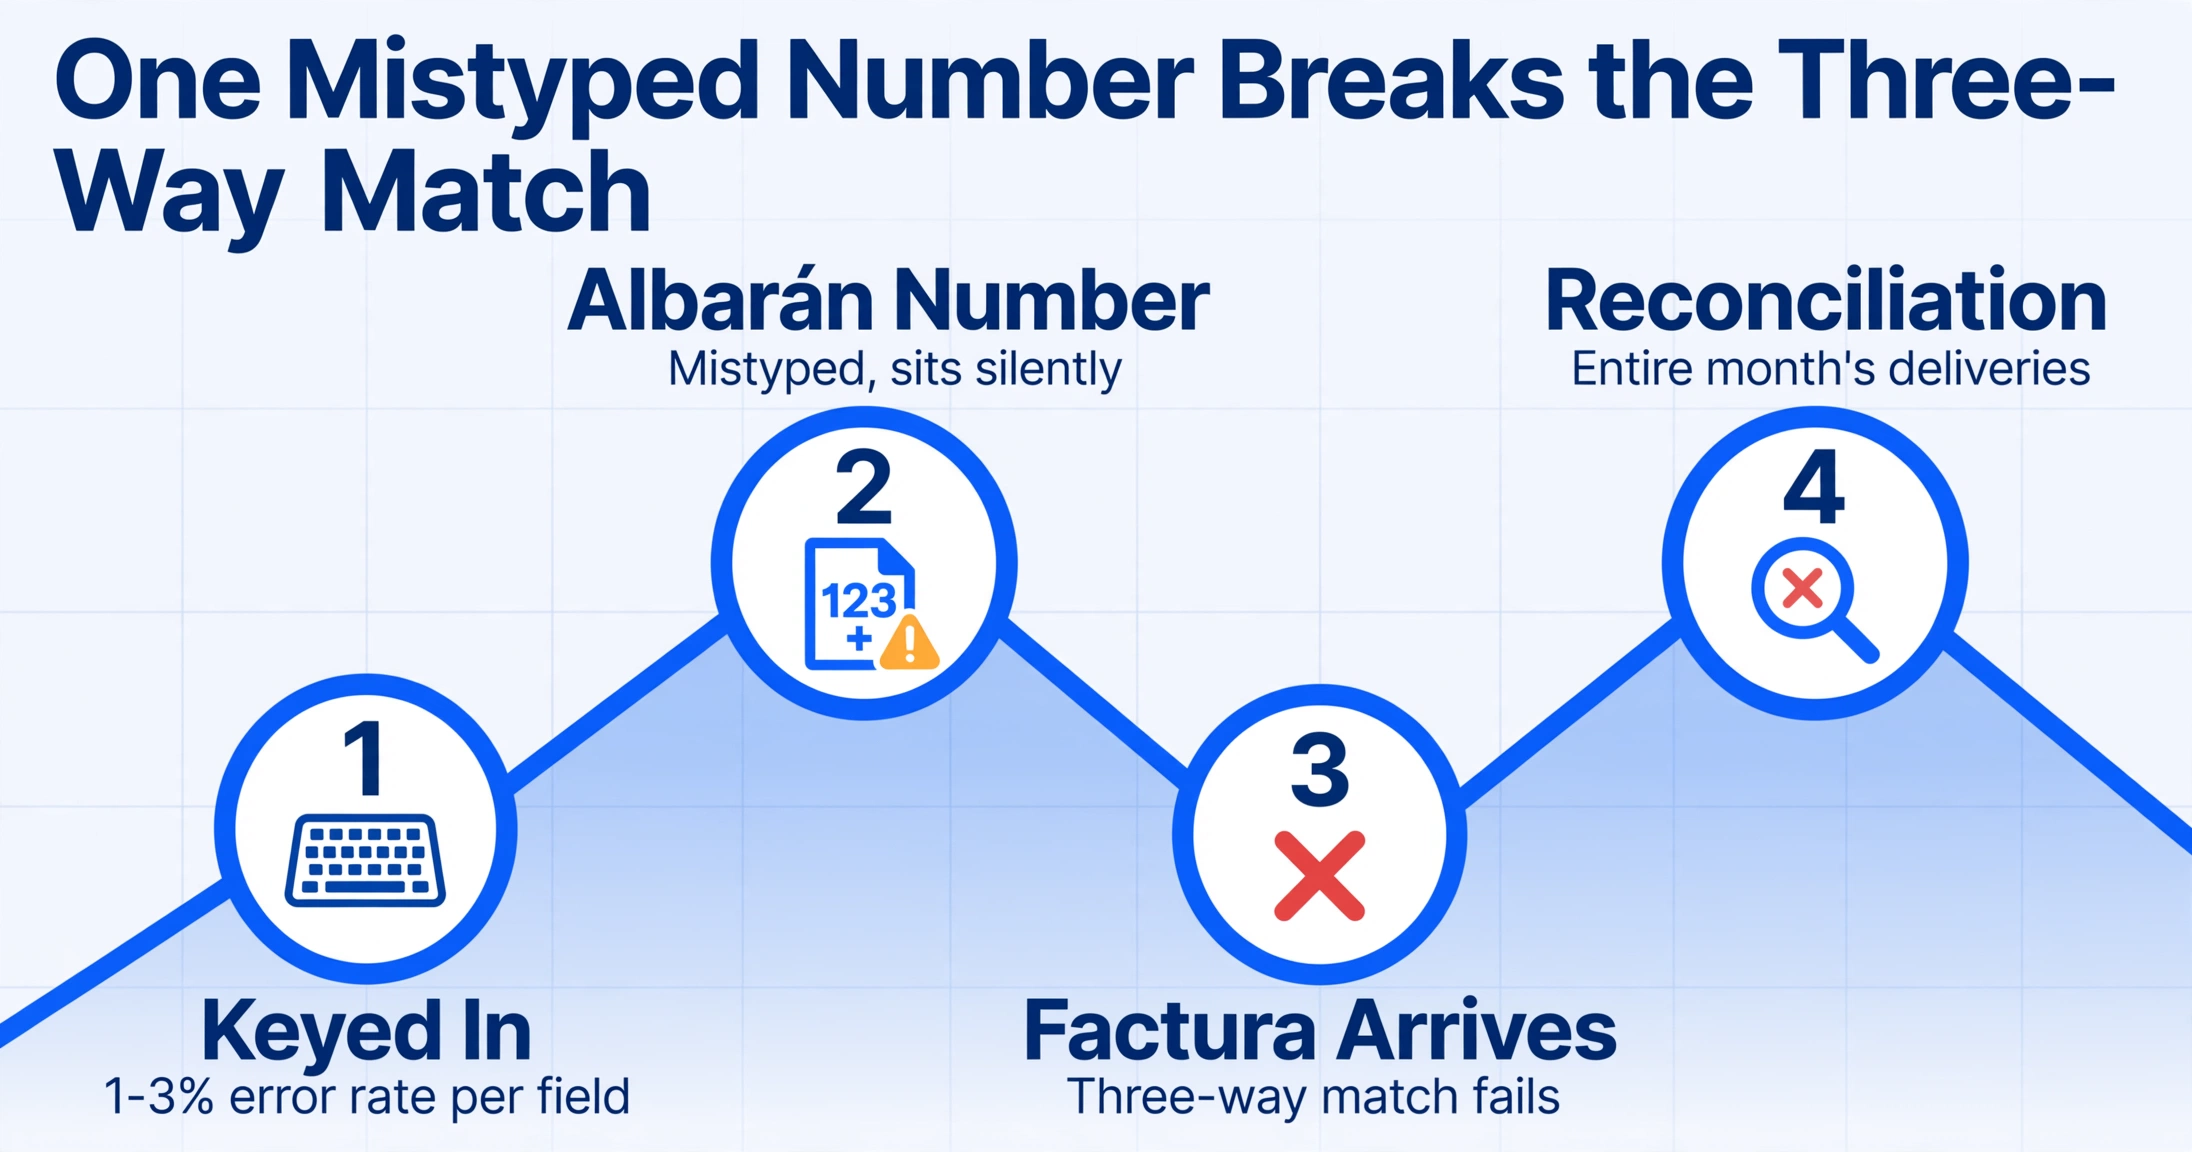
Der Drei-Wege-Abgleich skaliert nicht linear — eine falsch eingegebene Lieferscheinnummer (albarán) in einem Batch von 50 kann den Abgleich für die monatlichen Rechnungen eines gesamten Lieferanten zerstören.
Der spanische Kontenrahmen (PGC) weist jedem Lieferschein (albarán) einen spezifischen Buchungspfad zu: Soll an Kontenklasse 3 Vorräte (Konto 600 für Wareneinkauf oder 601 für Rohstoffeinkauf) und Haben an Konto 400 Verbindlichkeiten aus Lieferungen und Leistungen. Die Lieferscheinnummer (albarán) ist die Referenz, die den physischen Wareneingang mit diesem Buchungssatz verbindet — bevor die Rechnung (factura) eintrifft.
In einem Einzeldokument-Workflow fällt ein Tippfehler bei einer Lieferscheinnummer (albarán) auf, sobald die zugehörige Rechnung (factura) eintrifft und nicht übereinstimmt. Sie verbringen 5 Minuten damit, den Papierweg nachzuverfolgen, und korrigieren den Eintrag. Ärgerlich, aber begrenzt. In einem Batch-Workflow, bei dem Sie 30–50 Lieferscheine (albaranes) in das ERP-System eingeben, bevor Rechnungen (facturas) eintreffen, wirkt der Schaden stillschweigend kumulativ: Falsche Lieferscheinnummern (albarán) bleiben im System, bis der Lieferant seine Rechnung sendet — dann schlägt der Drei-Wege-Abgleich — Bestellung → Lieferschein (Wareneingang) → Rechnung (factura) — nicht nur für ein Dokument fehl, sondern möglicherweise für die gesamten Monatslieferungen dieses Lieferanten. Die Buchhaltung muss nun rückwärts ermitteln, welche Einträge über Dutzende von Transaktionen hinweg falsch sind.
Hier ändert sich das Risikoprofil durch die Extraktion, die die albarán-Nummer direkt aus dem Dokument zieht – statt auf manuelle Übertragung zu setzen. Eine getippte albarán-Nummer hat eine Fehlerquote von 1-3 % pro Feld. Eine maschinell ausgelesene albarán-Nummer aus dem Dokumentbild selbst hat bei gedrucktem Text praktisch keine Übertragungsfehler. Bei gescannten Durchschlägen mit möglicherweise verblasstem Druck kennzeichnet die KI Werte mit niedriger Konfidenz, anstatt stillschweigend ein falsches Ergebnis zu liefern – der Wareneingangsmitarbeiter prüft dann die 2-3 unsicheren Lesungen, anstatt alle 50 Einträge Korrektur zu lesen.
Der Drei-Wege-Abgleich scheitert nicht erst bei der Rechnungsphase, sondern bereits bei der Erfassung des Lieferscheins (albarán) – Wochen bevor es jemandem auffällt. Die Korrektur an der Datenerfassungsstelle kostet Sekunden. Die Korrektur nach Eingang der Rechnungen (facturas) kostet Stunden pro Lieferant.
Ein spanischer Lieferschein (albarán) trägt zwei Datenschichten: was der Lieferant versendet hat und was der Empfänger tatsächlich gezählt hat. Bei Batch-Verarbeitung bedeutet das manuelle Lesen beider Schichten, identische Korrekturen 30-mal zu lesen.
Der Rundlauf des Lieferscheins (albarán) – der Lieferant druckt ihn, die Ware reist mit ihm, der Empfänger ergänzt Anmerkungen, die unterschriebene Kopie geht zurück – erzeugt ein Dokumentproblem mit zwei Schichten, das bei der Einzelverarbeitung beherrschbar ist, aber bei Batch-Skalierung zum dominierenden Engpass wird.
Jeder spanische Lieferschein (albarán), der den Datenerfassungstisch erreicht, trägt drei Arten handschriftlicher Inhalte: Mengenkorrekturen („solo 8 uds recibidas" neben einer gedruckten „10"), Zustandsvermerke („caja dañada", „embalaje roto") und die Unterschrift des Empfängers als Bestätigung des Erhalts. In einem Einzeldokument-Workflow liest der Wareneingangsmitarbeiter diese Anmerkungen und tippt die korrigierte Menge ins WMS (Lagerverwaltungssystem). Bei 30 Lieferscheinen (albaranes) liest der Mitarbeiter 30 handschriftliche Korrekturen – viele mit ähnlicher Formulierung bei verschiedenen Lieferanten – und muss jede Korrektur korrekt der entsprechenden gedruckten Positionszeile zuordnen, ohne Daten zwischen Dokumenten zu vertauschen.
Das ist kein Geschwindigkeitsproblem. Es ist ein Problem der kognitiven Belastung. Nach 10 Lieferscheinen (albaranes) hört das Gehirn auf, zwischen „8 uds recibidas" auf dem Lieferschein (albarán) von Mercadona und dem hingekritzelten „8 uds" auf dem Lieferschein von RS Components España zu unterscheiden. Vorlagenbasierte Extraktionstools verschärfen dies, indem sie entweder die handschriftliche Schicht komplett ignorieren (wodurch Versandmengen entstehen, die nicht den tatsächlich erhaltenen Mengen entsprechen) oder handschriftlichen und gedruckten Text in derselben Ausgabezelle vermischen (wodurch unsinnige Daten entstehen).
Ein semantischer Ansatz löst dies, indem er die gedruckte und die handschriftliche Schicht als separate Extraktionsziele behandelt. Definieren Sie Qty Shipped und die KI liest die gedruckte Versandmenge des Lieferanten aus der Positionstabelle. Definieren Sie Qty Received im selben Spalten-Setup und die KI liest die handschriftliche Korrektur. Diese landen in benachbarten Spalten der Ausgabe – gedruckte Menge und erhaltene Menge nebeneinander, Abweichungen sofort sichtbar. Definieren Sie Exception Notes und handschriftliche Randbemerkungen werden als strukturierter Text extrahiert.
Standardmäßige Blockschrift lässt sich zuverlässig über den gesamten Batch extrahieren. Stark eilige Schreibschrift – typisch für Fahreranmerkungen, die am Ladedock hingekritzelt werden – kann bei der Volltext-Transkription eine punktuelle Überprüfung erfordern, aber die strukturierte Erkennung (Unterschrift vorhanden: ja/nein, Mengenkorrekturen) bleibt auch bei eiliger Handschrift zuverlässig. Das ist die ehrliche Grenze: Das Tool liest, was lesbar ist, kennzeichnet, was mehrdeutig ist, und produziert niemals stillschweigend einen falschen Wert.
Häufig gestellte Fragen
Wie viele Albaranes kann ich in einem Durchgang verarbeiten?
Das Tool verarbeitet Dateien sequenziell innerhalb eines Batches und bewältigt Uploads jeder praktischen Größe – 30, 50 oder mehr Albaranes auf einmal. Jede Seite benötigt etwa 5–10 Sekunden zur Verarbeitung, sodass ein Batch mit 30 Albaranes in etwa 3–5 Minuten abgeschlossen ist. Sie beobachten nicht den Fortschrittsbalken – Sie starten den Batch und kehren zu einer fertigen Tabelle zurück. Die praktische Grenze liegt nicht in der Kapazität des Tools, sondern im Aufnahmerhythmus des Wareneingangs: Die meisten Lager verarbeiten den morgendlichen Albarán-Stapel in einer Sitzung und die Nachmittagslieferungen in einem zweiten Durchlauf.
Was passiert, wenn ein Albarán keine gedruckte, sondern nur eine handschriftliche Nummer hat?
Die KI liest handschriftlichen Text unabhängig von der Sprache. Wenn die Albarán-Nummer handschriftlich ist – was bei manchen kleinen Lieferanten mit generischen Albarán-Blöcken vorkommt – versucht die Extraktion dennoch, sie anhand des von Ihnen definierten Spaltennamens zu lokalisieren. Die Genauigkeit ist geringer als bei gedruckten Nummern (leserliche Blockschrift extrahiert zuverlässig; flüchtige Schreibschrift kann manuelle Überprüfung erfordern). Wenn die KI keinen Wert sicher finden kann, bleibt die Zelle leer, anstatt mit einer Schätzung gefüllt zu werden. Zur Qualitätskontrolle können Sie eine Spalte namens Albarán-Nummer Vertrauensniveau hinzufügen, um Einträge zu kennzeichnen, die manuell überprüft werden müssen.
Kann ich Albaranes verarbeiten, die spanische, katalanische und englische Feldbezeichnungen im selben Batch mischen?
Ja. Die KI liest die Bedeutung der Felder, nicht die Sprache der Bezeichnung. Ob ein Lieferant "Albarán N.º", "Albarà Núm." oder "Delivery Note Ref" druckt, die von Ihnen als Albarán-Nummer definierte Spalte findet den korrekten Wert, weil die KI semantisch versteht, was eine Lieferscheinnummer ist, und nicht, in welcher Sprache sie beschriftet ist. Dies ist besonders nützlich für spanische Lager, die von internationalen Lieferanten erhalten, bei denen Albaranes eine Mischung aus spanischen, englischen und regionalen Sprachbezeichnungen tragen können – sowie von inländischen Lieferanten aus zweisprachigen Regionen (Katalonien, Baskenland, Galicien, Valencia), wo Feldbezeichnungen in der Regionalsprache erscheinen können.
Führt die Batch-Verarbeitung die NIF/CIF-Validierung für Steuer-ID-Felder durch?
Die KI extrahiert den NIF so, wie er auf dem Dokument erscheint, führt aber keine algorithmische NIF-Validierung durch (Prüfziffernverifikation gegen den Modulo-23-Algorithmus). Das Format aus 8 Ziffern plus Prüfziffer hilft der KI, den NIF während der Extraktion von der Albarán-Nummer zu unterscheiden, aber eine formelle Validierung sollte in Ihrem ERP oder über den Online-Verifizierungsdienst der Agencia Tributaria erfolgen. Zur Qualitätskontrolle profitieren NIF-Felder von einer berechneten Spalte wie NIF-Formatprüfung (gültig/ungültig), um Einträge zu markieren, die nicht dem erwarteten Muster entsprechen – dies ist jedoch eine Formatprüfung, keine rechtliche Validierung.
Wie erhalte ich Albaranes von Fahrern oder entfernten Lagern ohne E-Mail?
Die Funktion Sammellink erstellt eine teilbare Upload-Seite. Senden Sie den Link an Lieferfahrer, Mitarbeiter entfernter Lager oder externe Logistikpartner. Diese öffnen den Link, geben einen Bestätigungscode ein und laden Albaranes direkt hoch – entweder als Fotos bei der Lieferung oder als PDF-Scans. Keine Registrierung oder Anmeldung für den Absender erforderlich. Dateien landen automatisch in Ihrer Verarbeitungswarteschlange. Dies ist besonders nützlich für spanische Logistikabläufe mit Lieferungen an mehreren Standorten – eine Zentrale in Madrid, ein Außenlager in Valencia, ein Verteilzentrum in Barcelona – wo eingehende Dokumente ein zentrales AP- oder Inventarteam erreichen müssen, ohne dass Fahrer E-Mail-Anhänge verwalten müssen.
Der Stapel spanischer Lieferscheine, der jeden Morgen auf dem Wareneingangstisch liegt, ist kein Datenerfassungsproblem – es ist ein Formatübersetzungsproblem, multipliziert mit der Anzahl Ihrer Lieferanten. Wenn eine Spaltendefinition für das Layout jedes Lieferanten funktioniert, wird aus dem Stapel ein einziger Upload, ein einziger Verarbeitungslauf und eine einzige Tabelle, die Ihrem WMS (Lagerverwaltungssystem) die sauberen Daten liefert, für die es entwickelt wurde. Das ist der Unterschied zwischen einem WMS, das auf dem Papier eine 99-prozentige Fehlereliminierung meldet, und einem, das sie tatsächlich an Ihrer Rampe erreicht.
Verarbeiten Sie Ihre Lieferscheine (albaranes) im Batch
Verwandte Themen: Daten aus spanischen Lieferscheinen (albaranes) in Excel extrahieren · Lieferscheine und Versandpapiere im Batch nach Excel extrahieren · Lieferscheinfelder aus jedem Format nach Excel extrahieren · Französische Lieferscheine (bons de livraison) im Batch verarbeiten · Deutsche Lieferscheine im Batch verarbeiten · Lieferschein-zu-Excel-Konverter