300 CT-e-Frachtdokumente,
ein monatliches Kostenregister
Ein Frachtanalyst, der 300 CT-e-Dokumente pro Monat verarbeitet – ein typisches Volumen für einen mittelständischen Hersteller, der im Südosten und Mittelwesten versendet – öffnet jeden DACTE-Ausdruck oder jede PDF, sucht die CNPJ des Frachtführers, den Servicewert (Valor do Serviço / vTPrest), das Bruttogewicht, den ICMS-Betrag, die Herkunfts- und Zielgemeinden und tippt diese zwölf Datenpunkte in eine Tabellenzeile. Bei 90 Sekunden pro Dokument für einen erfahrenen Analysten sind das 7,5 Stunden reine Dateneingabe pro Monat. Rechnen Sie die Zeit hinzu, um Tippfehler zu erkennen, Steuersätze zu überprüfen, Anhänge zu finden, die per E-Mail statt über das Abrechnungsportal eingegangen sind, und Frachtkosten mit den entsprechenden Einkaufsrechnungen abzugleichen – und das monatliche Frachtkostenblatt wird zu einer Zwei-bis-Drei-Tage-Aufgabe, die niemand übernehmen möchte. Das muss nicht sein.
Wichtigste Erkenntnisse
- Ein Analyst, der 300 CT-e-Dokumente pro Monat abtippt, erstellt eine Tabelle, die vollständig aussieht, aber versteckte Lücken aufweist – Spalten fallen weg, Felder werden aus dem Gedächtnis geschätzt.
- Die Stapelextraktion garantiert, dass jede Zeile dieselbe Struktur hat, weil der Spaltensatz einmal definiert und auf alle 300 Dokumente angewendet wird – keine Abweichungen.
- Der eigentliche Hebel liegt in berechneten Spalten – Frachtkosten pro kg, effektiver ICMS-Steuersatz – die während der Extraktion berechnet werden, ohne dass im Nachhinein eine einzige Formel eingegeben werden muss.
Die Batch-Lücke bei der brasilianischen Frachtkostenverfolgung
Stapelverarbeitung und manuelle Eingabe unterscheiden sich in einem versteckten Punkt, der nichts mit Geschwindigkeit zu tun hat. Es geht um Konsistenz. Wenn ein Analyst 300 CT-e-Dokumente nacheinander eingibt, ändert sich der Satz an Spalten, die er erfasst, im Laufe der Aufgabe. Die ersten 50 Dokumente erhalten eine Spalte „Notizen“, die bei Dokument 120 wegfällt, weil es zu lange dauert; der ICMS-Satz wird zu Beginn erfasst, aber gegen Ende nur noch aus dem Gedächtnis geschätzt. Das Ergebnis ist eine Tabelle, in der einige Zeilen Daten enthalten, die andere nicht, und der Analyst selbst kann hinterher nicht sagen, welche Zeilen vollständig sind und welche nicht.
Stapelverarbeitung – das Verarbeiten aller 300 DACTE-Ausdrucke mit demselben Satz an Spaltendefinitionen – stellt sicher, dass jede Zeile in der Ausgabe dieselbe Datenstruktur aufweist. Dieselben Felder für Frachtführer-CNPJ, Servicewert, ICMS-Betrag, Bruttogewicht und Route werden aus jedem Dokument im Stapel extrahiert. Der Spaltensatz, den Sie einmal zu Beginn definieren, ist der Spaltensatz, den jedes Dokument erhält. Der Unterschied zwischen manueller und Stapelverarbeitung liegt nicht in den eingesparten Stunden – sondern darin, dass das Ergebnis der manuellen Eingabe auf eine Weise unzuverlässig ist, die Sie nicht messen können, ohne alles noch einmal einzugeben.
Für ein detailliertes Verständnis dessen, was jedes CT-e enthält und warum der DACTE-Ausdruck die Informationsquelle ist, mit der die meisten Logistikteams arbeiten, lesen Sie unseren Leitfaden zur CT-e-Datenextraktion nach Excel, der jedes wichtige Feld des Dokuments abdeckt. Dieser Artikel baut auf diesem grundlegenden Extraktionsworkflow auf, um die spezifischen Herausforderungen der Stapelverarbeitung zu adressieren.
Der Batch-Unterschied: Die manuelle Eingabe erzeugt eine Tabelle, die vollständig aussieht, aber versteckte Lücken aufweist. Die Stapelverarbeitung erzeugt eine Tabelle, in der jede Zeile strukturell identisch ist – und Sie sofort erkennen können, ob ein Feld nicht gefunden wurde.
Was ein ordentliches CT-e-Frachtkostenhauptbuch tatsächlich benötigt
Bevor Sie einen Batch-Workflow aufbauen, muss der Spaltensatz die drei Aufgaben eines Frachtkostenhauptbuchs unterstützen: Verfolgen, was Sie pro Sendung bezahlt haben, Tarife über verschiedene Frachtführer und Routen hinweg vergleichen und die ICMS-Daten bereitstellen, die für die Steuergutschrift bei eingehenden Frachten benötigt werden. Diese drei Zwecke stellen unterschiedliche Anforderungen an die Datenstruktur.
Ein minimal brauchbares CTe-Kostenhauptbuch enthält die folgenden Feldgruppen:
| Feldgruppe | Spalten | Zweck im Kostenhauptbuch |
|---|---|---|
| Belegkennungen | Chave de Acesso (44-stellig), CT-e-Nummer, Serie, Ausstellungsdatum | Primärschlüssel zur Verknüpfung mit NF-e, ERP-Buchung und SEFAZ-Prüfung |
| Parteikennungen | CNPJ und Name des Frachtführers, CNPJ des Versenders, CNPJ des Empfängers | Kostenzuordnung nach Frachtführer, Lieferant oder empfangender Geschäftseinheit |
| Frachtkosten | Valor do Serviço (vTPrest), Valor a Receber (vRec), Aufschlüsselung der Abzüge | Primäre Kostenkennzahl, Nettokosten nach Einbehalten, Prüfung der Frachtführerzahlung |
| Steuerdetails | ICMS-Bemessungsgrundlage, ICMS-Steuersatz (alíquota), ICMS-Betrag | Rückgewinnung der ICMS-Vorsteuer auf Eingangsfrachten, SPED-EFD-Konformität |
| Ladungsdetails | Bruttogewicht (kg), Art der Ladung (natureza da carga), Warenwert (falls verfügbar) | Kosten-pro-kg-Benchmarking, Analyse der Streckenrentabilität |
| Route | Ursprungsgemeinde (IBGE-Code), Zielgemeinde (IBGE-Code), CFOP | Routenbasierter Kostenvergleich, Modalanalyse, steuerliche Klassifizierung |
Diese 15–18 Spalten bilden das Rückgrat eines Frachtkosten-Tracking-Systems, das Leistungsbewertungen von Frachtführern, Routenoptimierung und Steuerkonformität unterstützt. Die konkrete Spaltenauswahl variiert je nach Unternehmen: Ein Hersteller mit Fokus auf Eingangsfrachten legt möglicherweise Wert auf den CNPJ des Versenders und den ICMS-Steuersatz für die Vorsteuerrückgewinnung, während ein Distributionsunternehmen den CNPJ des Empfängers und den CFOP für die Kostenzuordnung nach Geschäftseinheit priorisiert.
Die entscheidende Designentscheidung ist die Aufnahme von berechneten Spalten zum Zeitpunkt der Extraktion, anstatt sie als nachträgliche Excel-Formeln hinzuzufügen. Da die KI die Berechnungen während der Extraktion durchführt – zum Beispiel Frachtkosten pro kg (Valor do Serviço ÷ Bruttogewicht) – landet der berechnete Wert direkt als Spalte in der Ausgabetabelle, wodurch der Schritt entfällt, bei dem ein Analyst eine Formelspalte hinzufügt und sie über 300 Zeilen kopiert. Der Unterschied zwischen direkter Extraktion, berechneten Spalten und abgeleiteten Spalten wird im Leitfaden zu berechneten Spalten beschrieben, der erläutert, wie jeder Modus in einen Batch-Workflow passt.
Aufbau des Batch-Workflows: Von DACTE zur monatlichen Tabelle
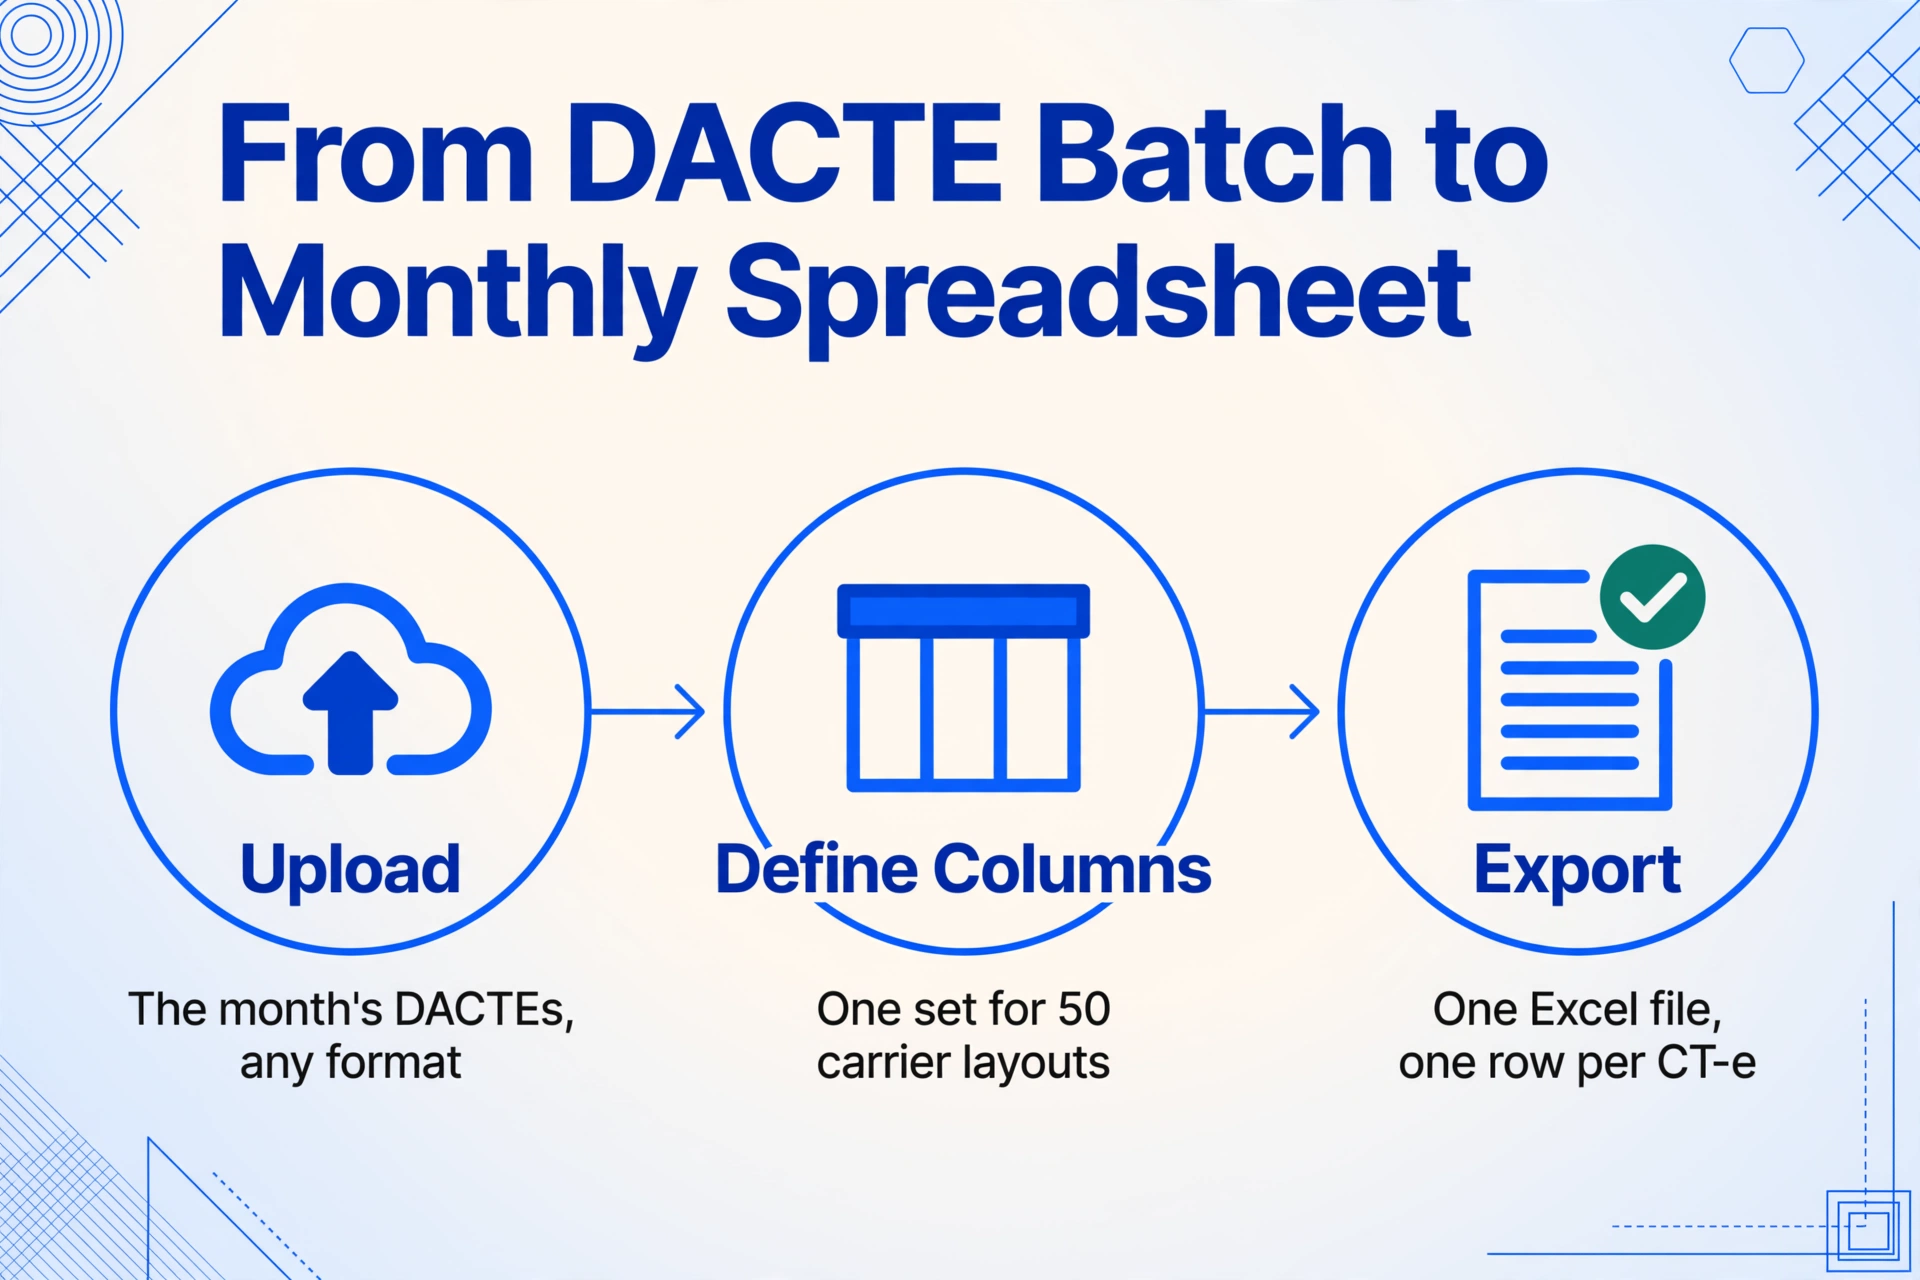
Der Batch-Workflow für CT-e-Frachtdokumente besteht aus drei Phasen, die den manuellen Eingabezyklus pro Dokument durch einen einzigen Prozess pro Batch ersetzen.
Sammeln Sie alle CT-e-DACTE-PDFs für den Monat – aus E-Mails der Frachtführer, vom Abrechnungsportal oder von gescannten Ausdrucken. Laden Sie sie gemeinsam in einem einzigen Batch hoch. Die Oberfläche akzeptiert PDF, JPG, PNG und WebP. Die Dateien eines Monats für einen mittelgroßen Hersteller umfassen in der Regel 200–400 Dokumente, und der Batch-Upload verarbeitet sie alle in einem Durchgang.
Geben Sie die Spaltennamen ein, die den benötigten Frachtkostenfeldern entsprechen. Diese werden zu den Kopfzeilen der Ausgabetabelle. Da die Extraktion ohne Vorlage erfolgt – die KI liest nach semantischer Bedeutung, nicht nach Layout-Position – funktionieren dieselben Spaltendefinitionen für jedes DACTE-Layout jedes Frachtführers. Ein CT-e von JSL und eines von Braspress, die die ICMS-Daten an unterschiedlichen Seitenpositionen platzieren, werden beide mit demselben Spaltensatz gelesen. Speichern Sie den Spaltensatz nach dem ersten Batch als Vorlage; jeder Folgemonat verwendet dieselbe Vorlage ohne Neukonfiguration.
Die KI verarbeitet alle Dokumente im Batch und erzeugt eine einzige Excel-Datei mit einer Zeile pro CT-e. Die Spaltenüberschriften entsprechen exakt Ihren Definitionen. Die heruntergeladene Datei ist bereit für den ERP-Import (die meisten Systeme akzeptieren XLSX als Flatfile), für Pivot-Analysen der Frachtführer-Kosten oder für den Abgleich mit NF-e-Einkaufswerten.
Die drei Schritte ersetzen eine mehrtägige manuelle Dateneingabe durch einen Prozess, der in Minuten abgeschlossen ist. Der Engpass verschiebt sich von „Wie schnell können wir tippen?“ zu „Wie schnell können wir die DACTE-Dateien von den Frachtführern sammeln?“ – was selbst ein Prozess ist, den Batch-Sammel-Workflows adressieren können, der aber außerhalb des Rahmens des Extraktionsschritts liegt.
Berechnete Spalten für die Frachtkostenanalyse im Batch
Der eigentliche Hebel des Batch-Workflows liegt nicht darin, Dokumente schneller zu erfassen, sondern darin, Spalten hinzuzufügen, die Berechnungen oder Ableitungen erfordern – Arbeit, die bei manueller Erfassung nicht skaliert, da jede zusätzliche Berechnung einen Formelschritt pro Zeile erfordert.
Drei berechnete Spalten, die eine einfache CT-e-Erfassung in ein Entscheidungsunterstützungstool verwandeln:
| Name der berechneten Spalte | Logik | Was dadurch ermöglicht wird |
|---|---|---|
Freight Cost per Kg (Valor do Serviço ÷ Peso Bruto) | vTPrest durch Bruttogewicht teilen | Kostenbenchmarking auf Routenebene – welche Spediteure verlangen die höchsten R$/kg auf welchen Routen |
Effective ICMS % (vICMS ÷ Base de Cálculo) | Tatsächlichen ICMS-Betrag durch die Bemessungsgrundlage teilen | Steuersatzvalidierung – kennzeichnet Dokumente, bei denen der angewandte Satz vom erwarteten Zwischenstaatssatz (7 % oder 12 %) abweicht |
Vendor Payment Gap (Valor a Receber - Valor do Serviço) | vRec von vTPrest abziehen | Quellensteueranalyse – zeigt Steuerabzüge (IRRF, PIS, COFINS, CSLL) und kennzeichnet unerwartete Abweichungen |
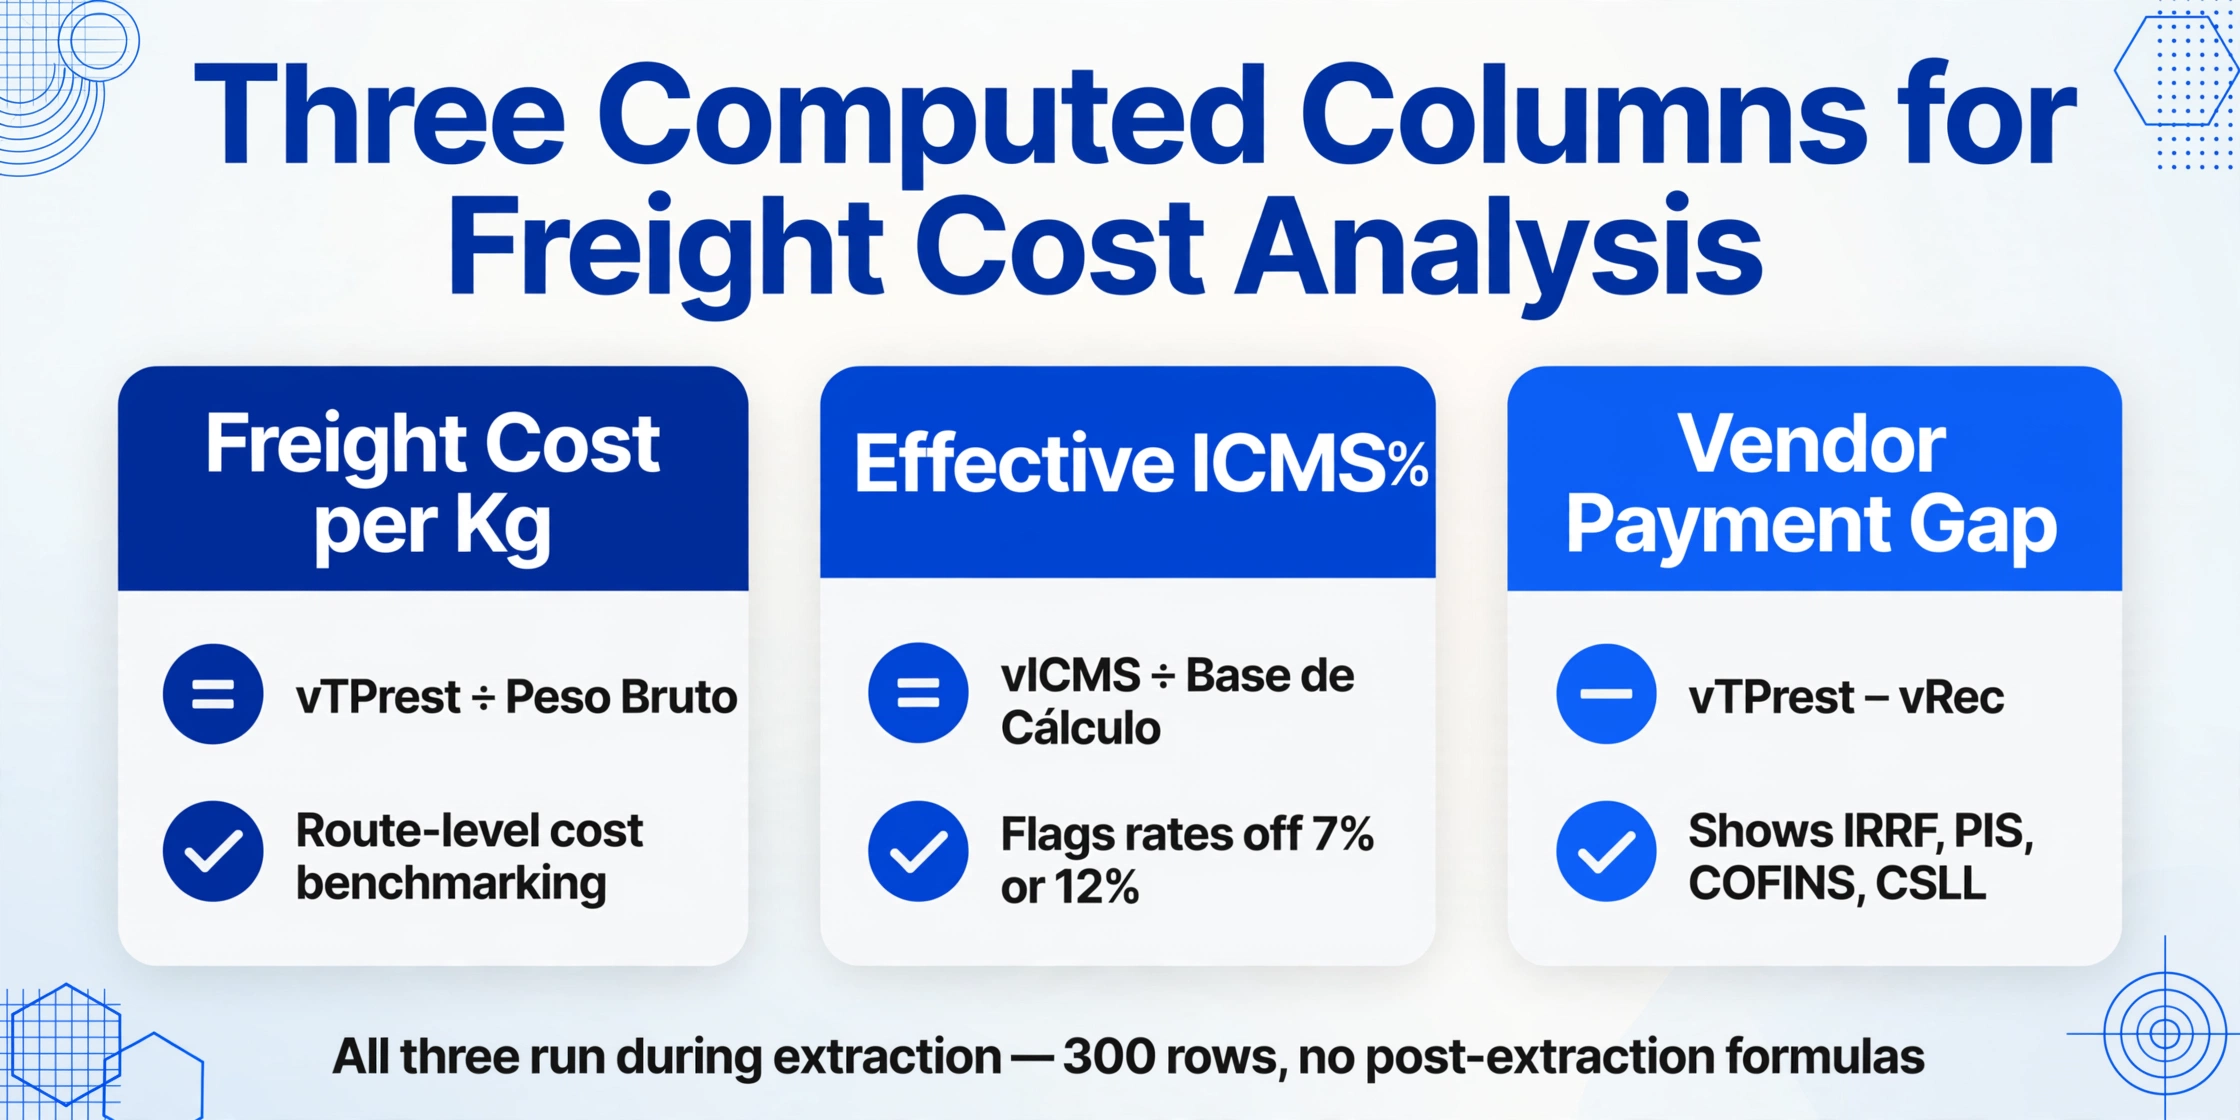
Jede berechnete Spalte wird während der Erfassung ausgeführt – die KI liest die Quellfelder aus dem DACTE, führt die Berechnung durch und schreibt das Ergebnis in die Ausgabetabelle. Der Batch von 300 Dokumenten erzeugt 300 Werte in jeder berechneten Spalte, ohne dass nach der Erfassung Formelarbeit nötig ist. Für Teams, die Spediteursverträge verwalten, kann allein die Spalte Freight Cost per Kg Wochen manueller Datenerfassung ersetzen.
Eine abgeleitete Spalte – der dritte Modus der Benutzerdefinierten Spaltenextraktion – kann die Batch-Ausgabe weiter anreichern. Beispielsweise weist eine Spalte namens Route Type (options: Within-Region / Cross-Region) die KI an, die Herkunfts- und Zielgemeinden zu bewerten und die Route zu klassifizieren, was eine Segmentierungsdimension hinzufügt, die kein manueller Prozess auf jedes Dokument in einem Batch anwenden könnte.
Erkenntnis zur Batch-Extraktion: Der Wert der Batch-Verarbeitung liegt nicht darin, dass sie schneller tippt als ein Mensch. Sie liegt darin, dass sie dieselbe Logik auf jedes Dokument anwendet, jedes Mal – und berechnete Spalten erweitern diese Logik, ohne zusätzlichen Arbeitsaufwand.
Umgang mit Layout-Variationen verschiedener Frachtführer in einem einzigen Batch
Brasiliens Straßengüterverkehrsbranche ist stark fragmentiert. Die ANTT (Agência Nacional de Transportes Terrestres) meldet über 650.000 im RNTRC-System registrierte Frachtführer, von großen börsennotierten Logistikunternehmen wie JSL und Sequoia bis hin zu einzelnen Selbstständigen Frachtführern (transportador autônomo), die einen einzigen Lkw besitzen. Das DACTE-Layout jedes Frachtführers ist eine Variation der SEFAZ-Vorlage, aber die Variation ist bedeutend genug, dass ein vorlagenbasiertes OCR-System eine separate Konfiguration pro Frachtführer erfordern würde.
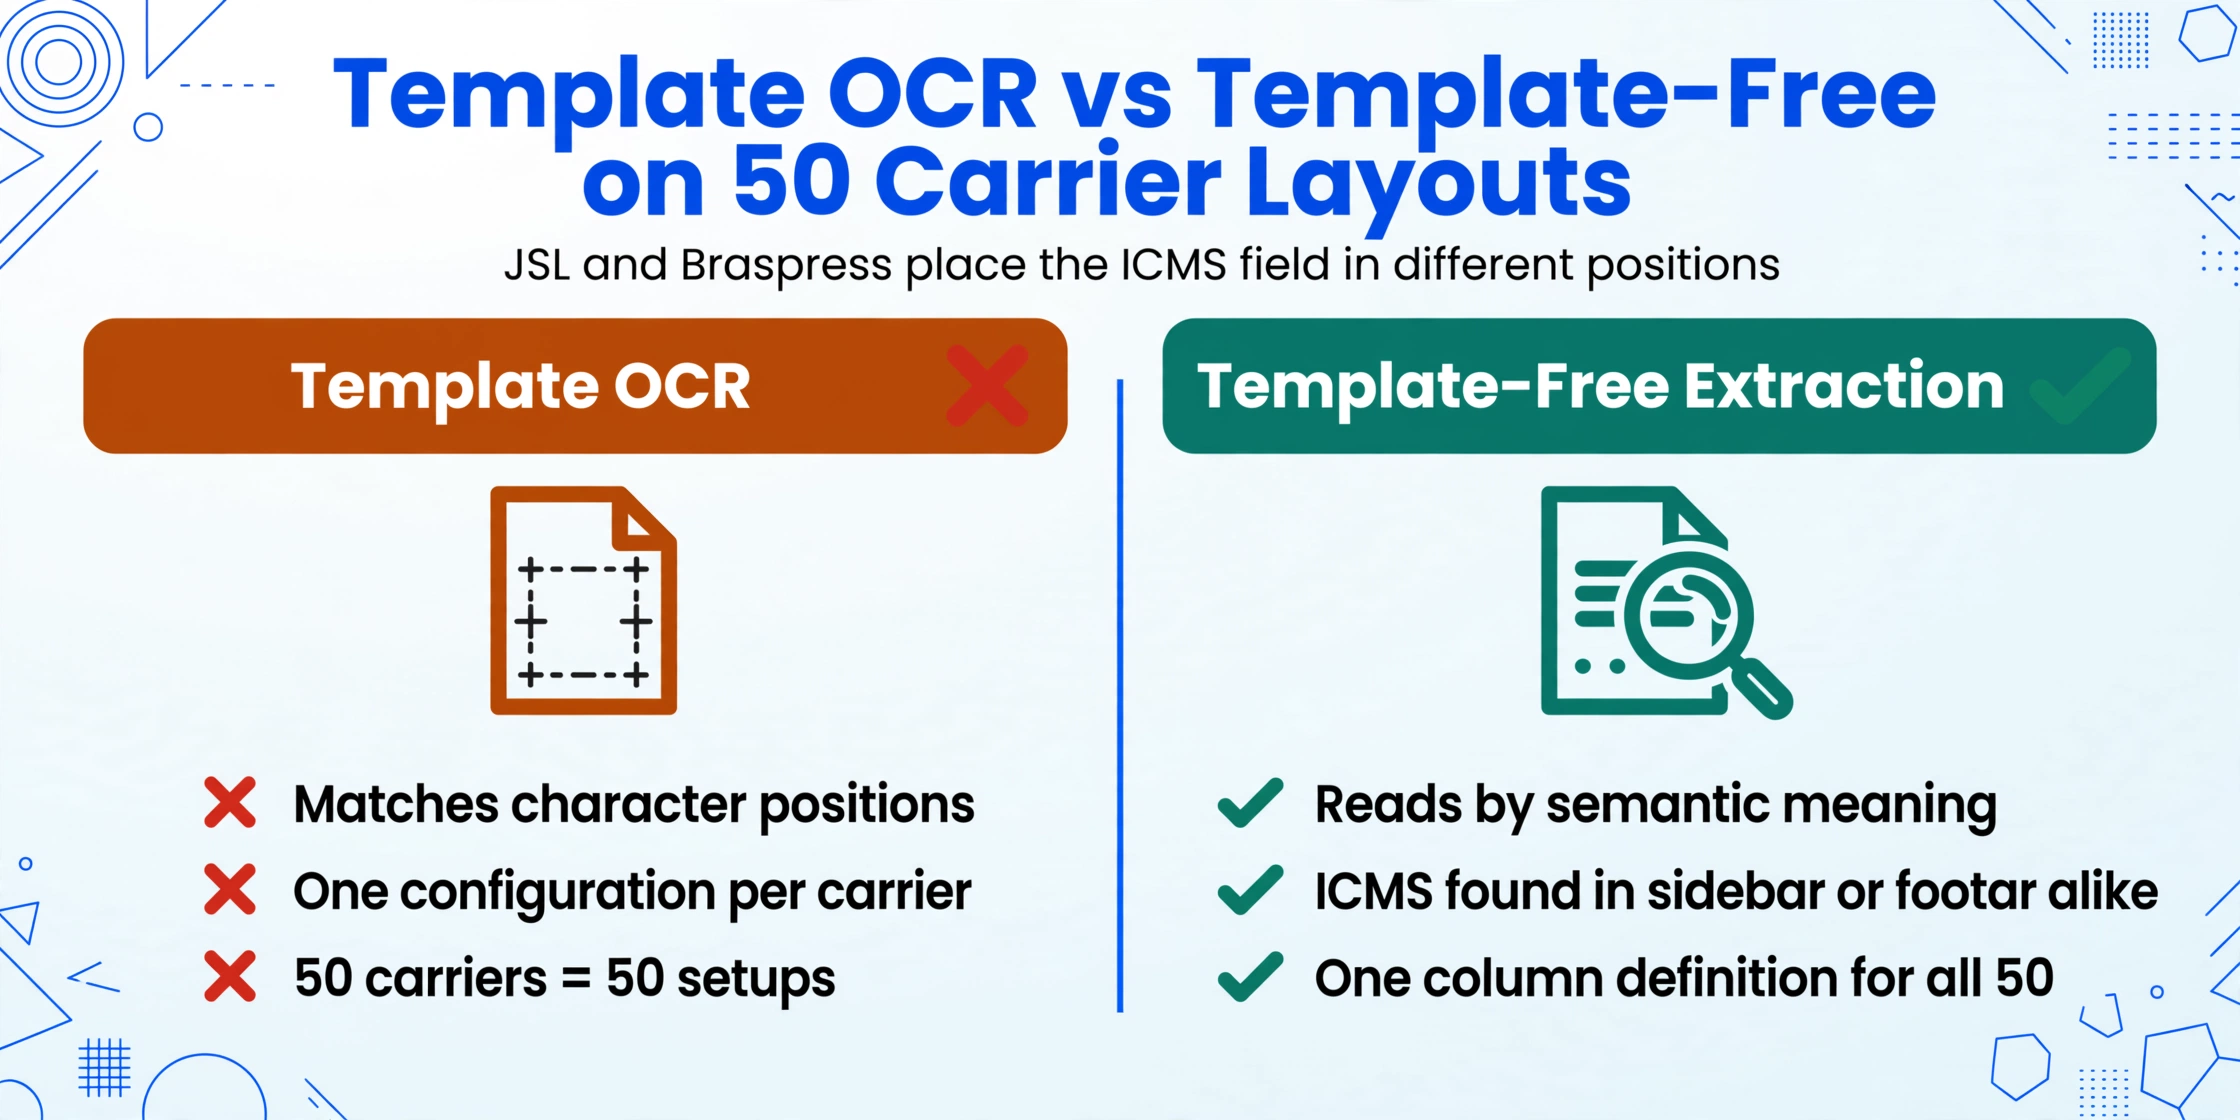
Diese Fragmentierung ist der Hauptgrund, warum die Batch-Extraktion für CT-e-Frachtdokumente historisch gesehen unpraktisch war. Ein Batch von 300 Dokumenten aus dem Eingangsfrachtverkehr eines großen Herstellers kann CT-e-Dokumente von 30–50 verschiedenen Frachtführern enthalten. Traditionelle OCR — die Daten durch Abgleich von Zeichenpositionen extrahiert — versagt, wenn sie auf ein Layout trifft, auf das sie nicht trainiert wurde, und das Training auf 50 Frachtführer-Layouts ist für einen Frachtanalysten kein realistischer Arbeitsablauf.
Die ohne Vorlage arbeitende Extraktion löst dies, weil die KI nach semantischer Bedeutung liest. „Valor do Serviço", gedruckt in einer Seitenleistentabelle auf JSLs DACTE, und „Valor do Serviço", gedruckt in einer Fußzeilenzeile auf Braspress' DACTE, werden beide durch dieselbe Spaltendefinition lokalisiert — das Modell versteht, wie ein „Servicewert" an jeder beliebigen Position in einem brasilianischen Frachtdokument aussieht. Ein einzelner Batch kann CT-e-Dokumente von 50 Frachtführern mit derselben Spaltendefinitionsdatei verarbeiten, und die Ausgabetabelle enthält vollständige Zeilen für jedes Dokument — nicht nur für die von Frachtführern, deren Layout das System bereits gesehen hat.
Die praktische Auswirkung für den Frachtanalysten: Sie sammeln alle DACTE-Dateien für den Monat, unabhängig vom Frachtführer, und laden sie gemeinsam hoch. Der Batch-Workflow erfordert nicht, dass Sie nach Frachtführer sortieren, Unter-Batches erstellen oder Einstellungen zwischen den Durchläufen neu konfigurieren.
Abgleich von Batch-CT-e-Kosten mit NF-e-Einkaufswerten für die Landed-Cost-Berechnung
Ein monatliches Kostenbuch, das Frachtkosten isoliert erfasst, liefert Leistungsdaten zum Spediteur. Ein Buch, das jede CT-e-Frachtgebühr dem entsprechenden NF-e-Warenwert zuordnet, liefert die Landed Cost pro Einheit – die Kennzahl, die Einkaufsteams für die Margenanalyse tatsächlich benötigen.
Der Abgleichsmechanismus ist derselbe wie im Einzelbeleg-Workflow: Jede CT-e verweist auf den Chave de Acesso der NF-e, die sie transportiert (oder bei Sammelladungen auf mehrere NF-e-Zugriffsschlüssel). Durch die Extraktion des referenzierten NF-e-Zugriffsschlüssels aus jeder CT-e im Batch erhält die Frachtkosten-Tabelle eine Spalte, die als Fremdschlüssel in das NF-Einkaufsbuch fungiert. Ein XLOOKUP zwischen den beiden Tabellen erstellt eine kombinierte Ansicht, die für jede Sendung den Warenwert aus der NF-e, die Frachtkosten aus der CT-e und die berechneten Landed Costs anzeigt.
Dieser Abgleich wird noch leistungsfähiger, wenn sowohl der CT-e-Batch als auch der NF-e-Batch mit demselben Extraktions-Workflow verarbeitet werden. Der Leitfaden zur NF-e-Datenextraktion behandelt die Spaltendefinitionen für NF-Einkaufsbelege, und die beiden Ausgabetabellen – eine für Warenwerte, eine für Frachtkosten – werden über die Zugriffsschlüsselspalte zusammengeführt. Eine vierteljährliche Landed-Cost-Analyse, die früher einen ganzen Tag für das Querverweisen benötigte, wird zu einem Tabellen-Merge, der in Minuten abgeschlossen ist.
Für einen umfassenderen Überblick darüber, wie die CT-e in das brasilianische elektronische Belegökosystem neben der NF-e (Warenrechnung) und der MDF-e (Frachtmanifest) passt, siehe den Leitfaden zum brasilianischen elektronischen Beleg-Hub, der den SEFAZ-Autorisierungsworkflow behandelt, der allen brasilianischen Steuerbelegen gemeinsam ist.
Häufig gestellte Fragen
Wie viele CT-e-Dokumente kann ich in einem einzigen Batch verarbeiten?
Es gibt kein Dateilimit pro Batch. Die praktische Einschränkung ist das gesamte Seitenkontingent Ihres Tarifs. Ein einzelnes CT-e-DACTE umfasst 1–2 Seiten. Im Pro-Tarif (1.500 Seiten pro Monat) verbraucht ein Team, das 500 CT-e-Dokumente (à 1 Seite) verarbeitet, ein Drittel seiner monatlichen Kapazität und lässt Platz für andere Dokumenttypen. Die Batch-Ausgabe kombiniert unabhängig vom Volumen alle Dokumente in einer Excel-Datei.
Benötige ich für jedes Speditions-DACTE-Layout eine separate Vorlage?
Nein. Die Extraktion ohne Vorlage erfolgt anhand der semantischen Bedeutung, nicht der Position. Ein ICMS-Feld auf dem DACTE von JSL (das möglicherweise in einer Seitenleiste erscheint) und auf dem DACTE von Braspress (das möglicherweise in einer Fußzeilentabelle erscheint) wird beide Male durch dieselbe Spaltendefinition gefunden, da die KI versteht, was „ICMS“ auf einem Frachtdokument bedeutet. Ein Batch mit 50 verschiedenen Spediteuren verwendet eine einzige Spaltendefinitionsdatei.
Können berechnete Spalten die ICMS-Sätze innerhalb eines Batches validieren?
Ja, und dies ist eine ihrer wertvollsten Anwendungen. Eine berechnete Spalte, die den effektiven ICMS-Satz (vICMS ÷ Base de Cálculo) berechnet, liefert einen Wert, der für jedes Dokument im Batch dem erwarteten zwischenstaatlichen Satz – 7 % oder 12 % – entsprechen sollte. Zeilen, in denen der berechnete Satz vom erwarteten Satz abweicht, werden in der Ausgabe durch eine einfache bedingte Formatierungsregel in Excel markiert, wodurch ein Validierungsproblem mit 300 Zeilen zu einer Stichprobenprüfung der markierten Ausnahmen wird. Der Leitfaden zu CT-e ICMS-Berechnungsfehlern behandelt die spezifischen Satzregeln und die Bedeutung der einzelnen Abweichungsarten.
Was ist, wenn einige DACTE-PDFs seitlich gescannt wurden oder eine niedrige Auflösung haben?
Das KI-Visionsmodell verarbeitet Ausrichtung und moderate Auflösungsschwankungen. Ein gescanntes DACTE mit 200 DPI und einer Schräglage von 15 Grad wird korrekt verarbeitet – das Modell erkennt die Textausrichtung und liest kontextbezogen, anders als herkömmliche OCR, die eine Vorverarbeitung zur Entzerrung erfordert. Bei sehr niedrigen Auflösungen (unter 150 DPI) oder starken Lichtartefakten kann die Feldgenauigkeit abnehmen, aber die Extraktion liefert dennoch Teilergebnisse, die überprüft werden können, anstatt einen erneuten Scan zu erfordern.
Wie vergleiche ich die Frachtkosten Monat für Monat mithilfe der Batch-Extraktion?
Exportieren Sie den Batch jedes Monats in eine separate Excel-Datei und hängen Sie die monatlichen Dateien dann an eine einzige Jahresübersichtstabelle an. Da jeden Monat dieselben Spaltendefinitionen verwendet werden, haben die Dateien identische Spaltenstrukturen und können durch Anhängen von Zeilen gestapelt werden. Mit berechneten Spalten wie „Frachtkosten pro kg“, die in jeden monatlichen Export integriert sind, erfordert die monatliche Trendanalyse der Sätze lediglich eine Pivot-Tabelle auf dem gestapelten Datensatz – keine monatliche Formelanpassung.
Wie stelle ich mein Frachtteam von der manuellen Eingabe auf die Batch-Extraktion um?
Beginnen Sie mit einem parallelen Testmonat: Verarbeiten Sie die CT-e-Dokumente des Monats sowohl manuell (bestehender Workflow) als auch per Batch-Extraktion (neuer Workflow). Vergleichen Sie die beiden Ergebnisse – die Extraktionsergebnisse enthalten weniger Tippfehler, eine konsistentere Spaltenstruktur und eine vollständige Abdeckung des Dokumentensatzes. Der parallele Testlauf liefert die konkreten Belege, die nötig sind, um das Team im Folgemonat auf die reine Extraktion umzustellen. Die meisten Teams stellen fest, dass die Umstellung einen Zyklus erfordert, um Vertrauen in die Ergebnisse aufzubauen, und null zusätzliche Zyklen, um dieses Vertrauen zu erhalten.