ImageToTable.ai vs OCR.space:
Extração de Dados Estruturados vs Saída de Texto Bruto
OCR.space e ImageToTable.ai aceitan a mesma entrada — imagens e PDFs. O que retornam é fundamentalmente diferente. OCR.space fornece o texto que encontrou no documento. ImageToTable.ai fornece os dados que você solicitou, em uma planilha com os nomes de colunas que você definiu. Essa lacuna — entre "texto extraído" e "dados prontos para usar" — é o que esta comparação trata.
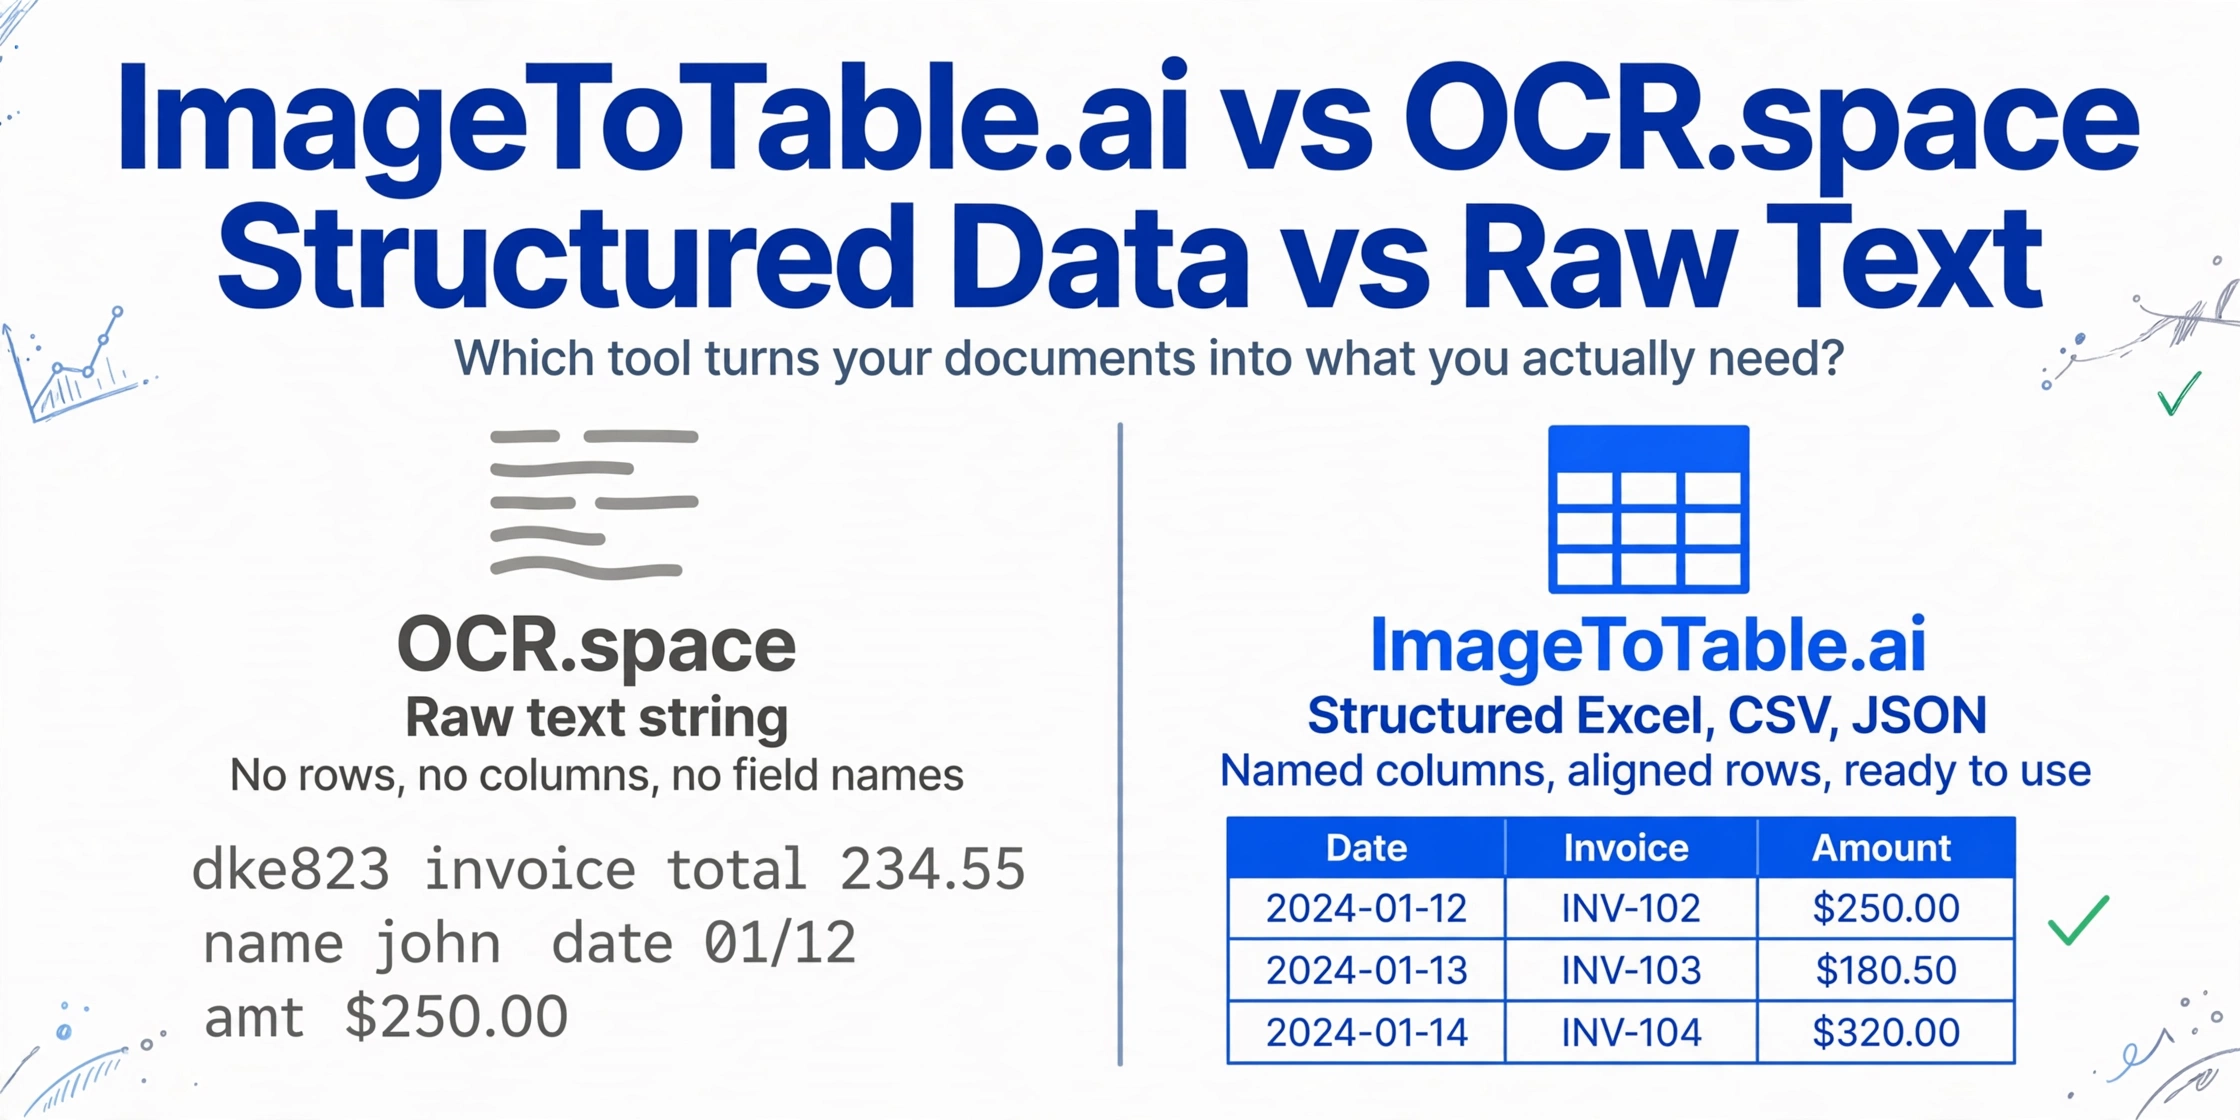
Comparação Rápida
Escolha ImageToTable.ai se…
- Você precisa de dados de documentos em uma planilha — rotulados, alinhados, prontos para usar
- Você não é desenvolvedor e não sabe escrever código de parsing para interpretar a saída do OCR
- Seus documentos têm layouts variáveis entre diferentes fornecedores ou fontes
- Você quer definir nomes de colunas específicos e extrair apenas esses campos
- Você precisa de processamento em lote que mescla vários documentos em uma única tabela
Escolha OCR.space se…
- Você é desenvolvedor criando um app e precisa de uma API de OCR gratuita e de alto volume
- Você precisa de texto bruto de uma imagem e vai lidar com a estrutura você mesmo
- Você está prototipando um pipeline de documentos e quer 25.000 chamadas de API gratuitas por mês
- Seu caso de uso é digitalização de texto, não extração de campos
- Você precisa de OCR em mais de 200 idiomas com configuração mínima
Comparação de Recursos
| Recurso | OCR.space | ImageToTable.ai |
|---|---|---|
| Formato de saída | Texto bruto ou texto alinhado por espaços em JSON; sem linhas/colunas estruturadas | Excel (XLSX), CSV, JSON com colunas nomeadas; Word com layout preservado |
| Extração de tabelas | O sinalizador isTable=true produz texto alinhado por espaços que aproxima o layout — não estruturas reais de linhas/colunas | O Vision LLM identifica a estrutura da tabela a partir da semântica do documento; gera linhas alinhadas e colunas nomeadas |
| Extração de campos personalizados | Não suportado — o OCR.space não tem o conceito de campos nomeados; todo o texto é retornado sem diferenciação | Recurso principal — digite os nomes das colunas que você quer; eles viram os cabeçalhos do seu Excel |
| Processamento em lote | A API suporta chamadas em lote; a saída são blocos de texto separados por arquivo, sem mesclagem entre arquivos | Todos os arquivos de um lote são mesclados automaticamente em uma única planilha alinhada |
| Usuário principal | Desenvolvedores que criam aplicativos ou scripts de automação | Usuários de negócios que precisam de dados de documentos em uma planilha |
| Configuração necessária | Chave de API (sem registro no plano gratuito); chamada REST com alguns parâmetros | Envie os arquivos, digite os nomes das colunas, baixe — sem conta necessária no modo convidado |
| Suporte a idiomas | Mais de 200 idiomas com detecção automática | Todos os idiomas suportados pelo Vision LLM subjacente |
| Suporte a manuscritos | Limitado — a precisão cai significativamente em texto manuscrito ou estilizado | Lida com manuscritos, cursiva, caixas de seleção e carimbos |
| Plano gratuito | 25.000 solicitações de API por mês, sem necessidade de registro | Modo convidado gratuito; cota diária gratuita em contas registradas |
| Preços | Grátis (25.000 req/mês); PRO $30/mês (300.000 req); PRO PDF $60/mês (PDFs grandes) | Nível gratuito para convidados; pago a partir de $9/mês; pagamento por uso a partir de $6/50 páginas |
O Que o OCR.space Realmente Retorna
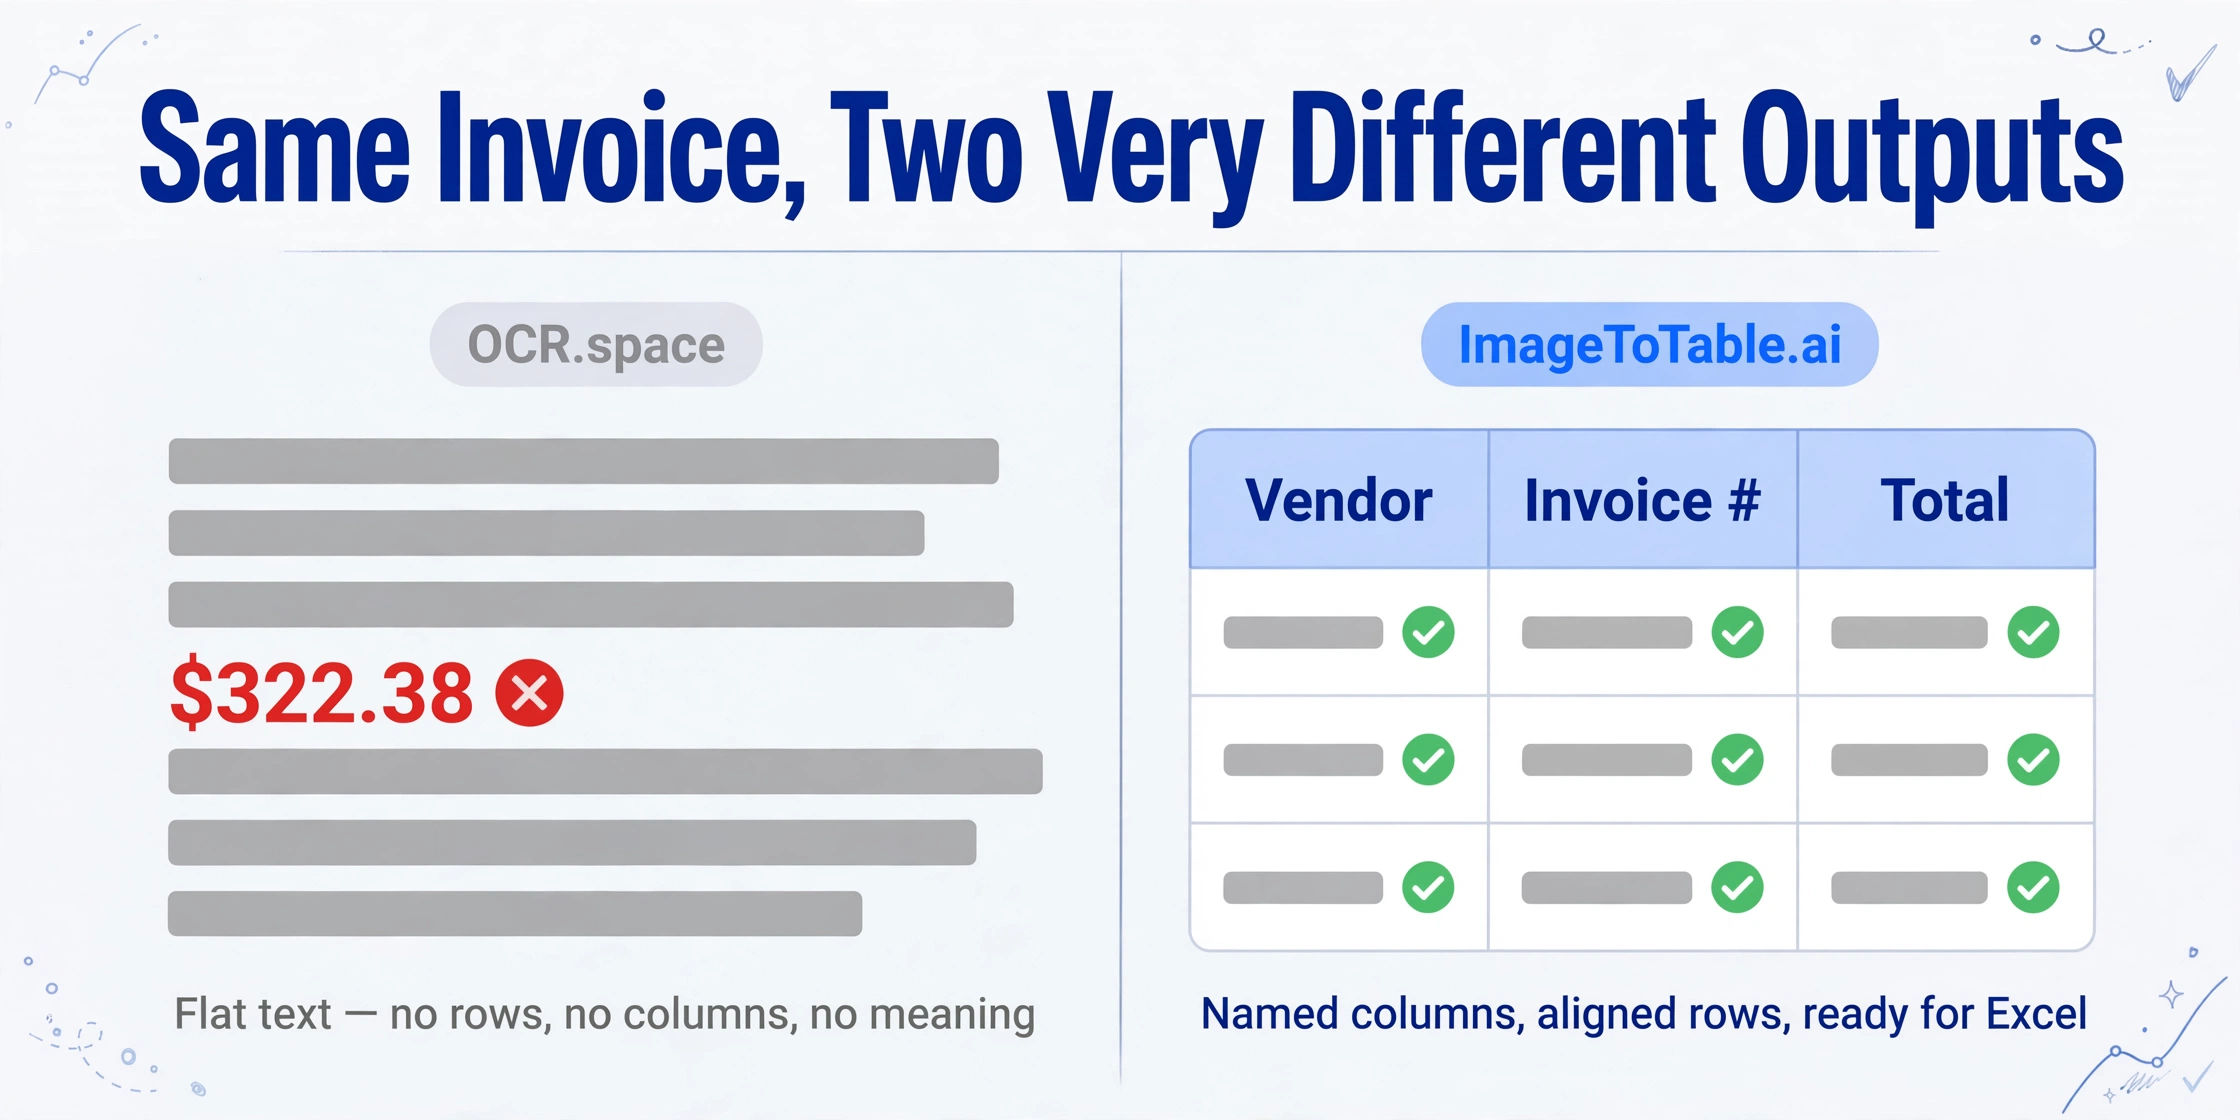
O OCR.space responde a uma pergunta com precisão: qual texto está nesta imagem? Envie uma foto de uma fatura e ele retorna os caracteres encontrados, aproximadamente organizados para corresponder ao layout original. Aqui está o que uma resposta típica da API retorna para uma fatura digitalizada:
INVOICE
Vendor: Acme Supplies Ltd        Invoice #: INV-2024-0892
Date: March 15, 2024             Due Date: April 14, 2024

Description              Qty    Unit Price    Total
Office paper (500 sheets)  10     $12.50      $125.00
Printer cartridges          4     $34.00      $136.00
Desk organizers             2     $18.75       $37.50

                                  Subtotal:   $298.50
                                  Tax (8%):    $23.88
                                  TOTAL:      $322.38
Isso parece utilizável à primeira vista. O problema aparece no momento em que você tenta colocá-lo em uma planilha. O texto é uma string plana — não há linhas, nem colunas, nem nomes de campos, nem tipos de dados. O número $322.38 é indistinguível de qualquer outro número na string. O rótulo "TOTAL" é apenas mais uma palavra. O OCR.space não tem ideia de que $322.38 é um total de fatura, que INV-2024-0892 é um número de fatura, ou que Acme Supplies Ltd é um nome de fornecedor. Esse é o mesmo teto estrutural encontrado no recurso Data from Picture do Excel — nossa comparação Data from Picture do Excel analisa especificamente ferramentas de cópia de grade.
Como a análise prática do Koncile.ai afirma diretamente: "O reconhecimento de tabelas não substitui 100% a extração estruturada (campo por campo): você obtém texto formatado, mas não diretamente uma tabela que possa ser usada na forma de uma planilha."
A saída do ImageToTable.ai para o mesmo documento é diferente em tipo, não apenas em grau. Você digita "Fornecedor, Número da Fatura, Total, Data de Vencimento" como nomes das suas colunas. A ferramenta retorna uma planilha com essas quatro colunas, cada uma preenchida com os valores corretos de cada documento no seu lote — incluindo documentos de fornecedores diferentes com layouts diferentes.
As Quatro Etapas Entre o Texto do OCR e um Excel Utilizável
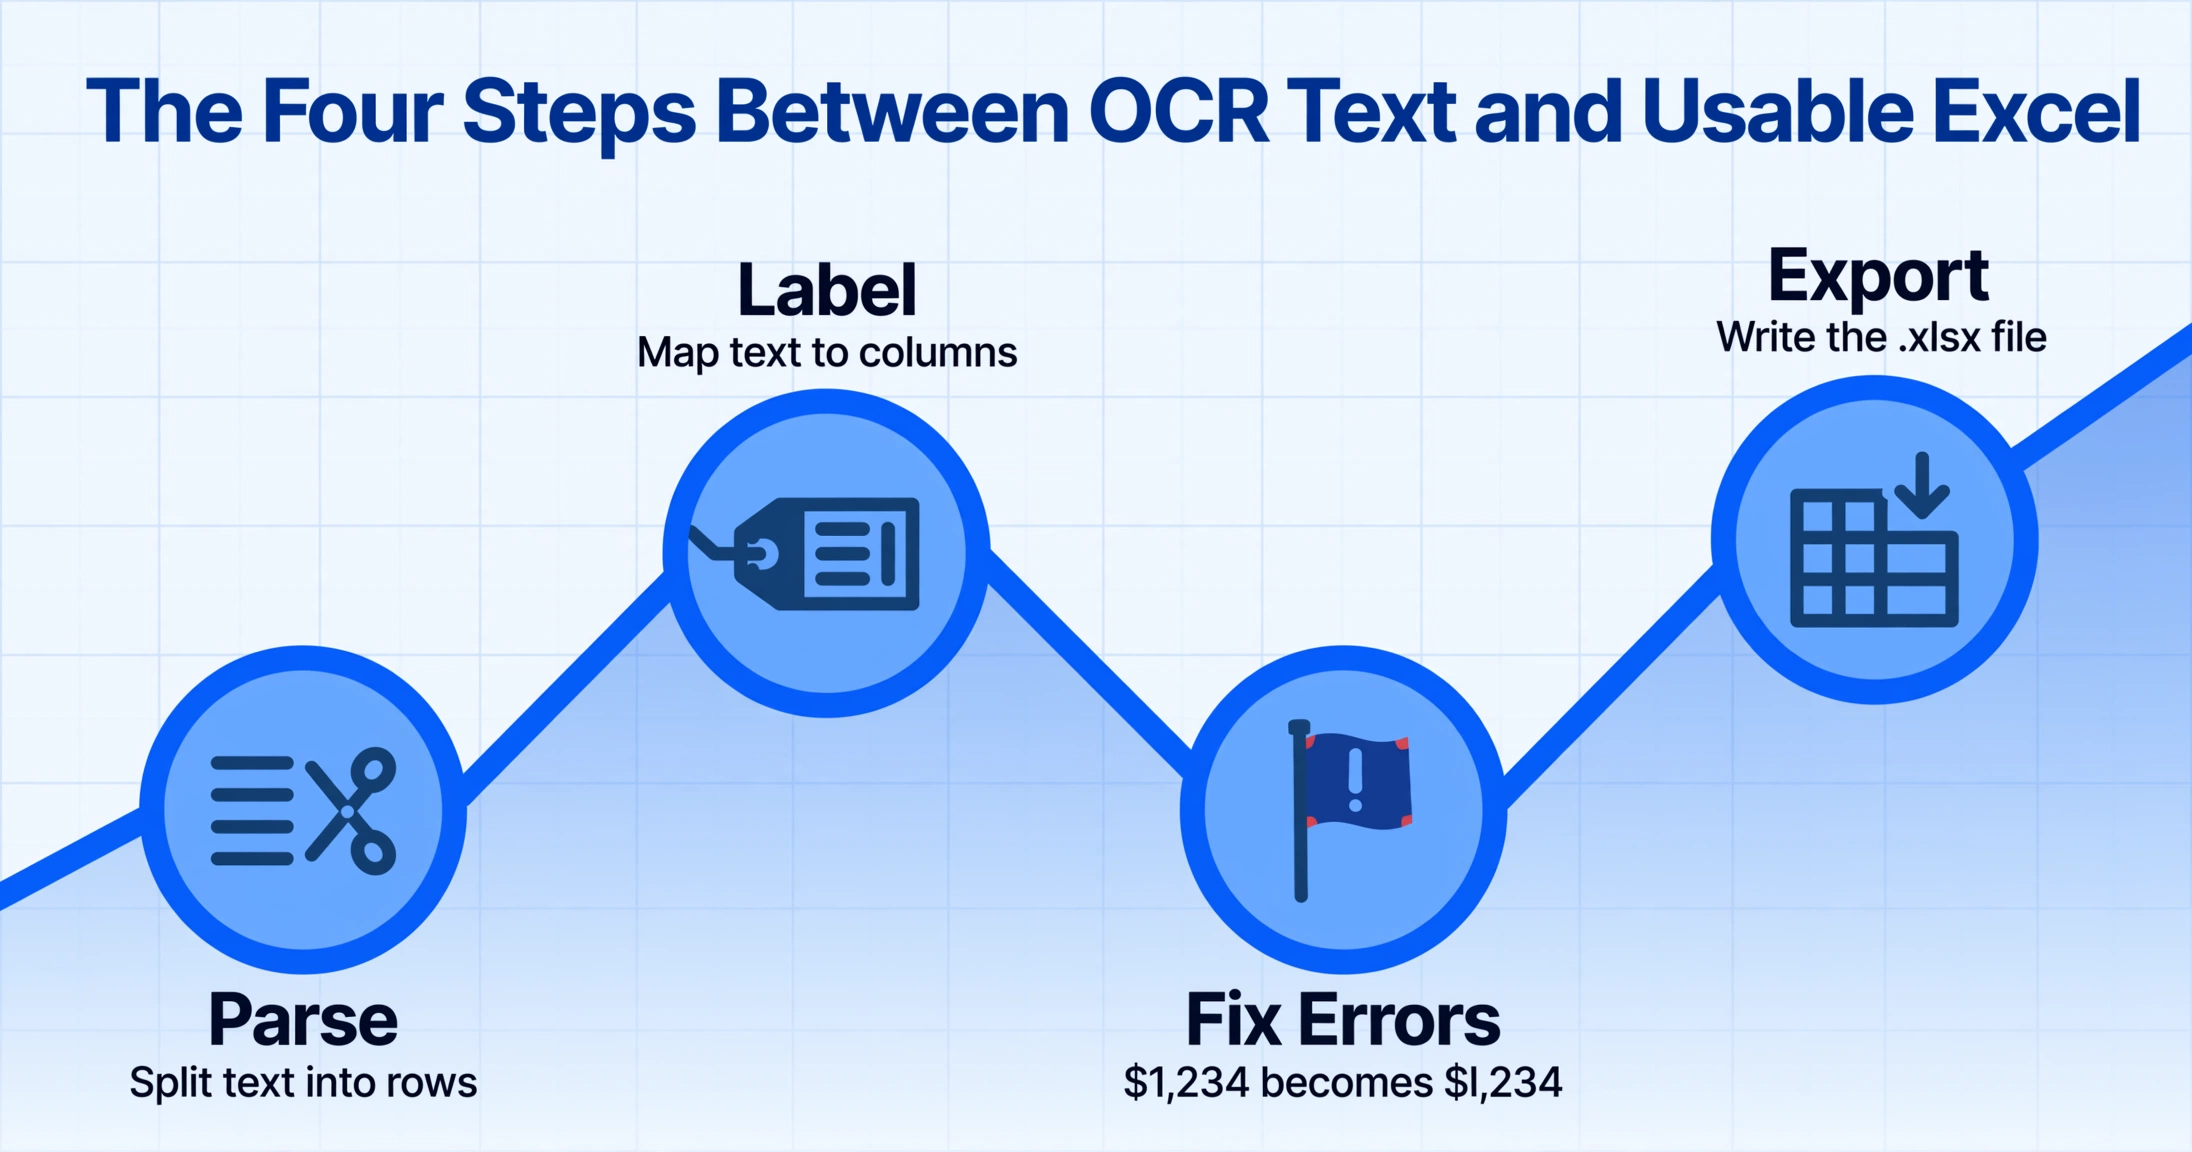
Ir da saída do OCR.space para uma planilha utilizável exige um trabalho de engenharia para o qual a ferramenta não oferece nenhuma ajuda. Para um desenvolvedor, isso significa dias de implementação. Para um não desenvolvedor, simplesmente não é possível sem ferramentas adicionais.
Como a análise da Parseur sobre OCR vs. processamento de documentos coloca: "OCR é como ler texto em uma página; processamento de documentos é como entender esse texto, rotulá-lo e fazer algo útil com ele, automaticamente." O OCR.space faz o primeiro. Tudo depois disso fica por sua conta.
Veja o que "tudo depois disso" realmente envolve:
- Etapa 1 — Analisar o texto em linhas. Escreva regex ou lógica de divisão de strings para identificar onde um item de linha termina e outro começa. Para faturas com formatos consistentes, isso é tedioso, mas viável. Para documentos com layout variável de vários fornecedores, é necessário um mecanismo de regras separado para cada formato.
- Etapa 2 — Identificar e rotular campos. Escreva código que mapeie a posição do texto para os cabeçalhos das colunas — para que a ferramenta saiba que o número após "TOTAL:" é um total de fatura, não o preço de um item de linha. Essa lógica deve ser reescrita para cada novo layout de documento.
- Etapa 3 — Lidar com erros de OCR. Mesmo com 99% de precisão de caracteres, um documento de 500 caracteres contém ~5 caracteres corrompidos. Valores em dólar como
$1,234podem se tornar$l,234ou$1.234, quebrando a análise numérica. A lógica de validação e correção de erros deve ser implementada separadamente. - Etapa 4 — Escrever o arquivo Excel. Use uma biblioteca (openpyxl, xlsxwriter, xlsx.js) para criar o arquivo .xlsx real com cabeçalhos, larguras de coluna e tipos de dados corretos.
A existência de ferramentas secundárias inteiras — sites como ocrtoexcel.com e ocrdataextraction.com — construídos especificamente para fazer a ponte entre a saída do OCR e o Excel é, por si só, uma evidência dessa lacuna. Há um mercado para a camada de conversão que o OCR.space não fornece.
Na comparação da Klippa de 10 APIs de OCR, o OCR.space ficou em 9º lugar entre 10 — com a principal crítica sendo a falta de saída de dados estruturados. Essa classificação reflete a lacuna entre "texto extraído" e "dados prontos para uso".
Quando o OCR.space é a Ferramenta Certa
O OCR.space é genuinamente excelente no que foi projetado para fazer, e vale a pena ser específico sobre quando isso corresponde à sua necessidade real.
Prototipagem para desenvolvedores a custo zero. 25.000 solicitações de API por mês sem registro é uma camada gratuita excepcionalmente generosa. Se você está criando um aplicativo que precisa extrair texto de imagens e quer validar a abordagem antes de se comprometer com um serviço pago, o OCR.space é a maneira mais rápida de começar. Sem conta, sem cartão de crédito, sem aprovação de cota.
Digitalização de texto, não extração de campos. Se o seu objetivo é tornar documentos digitalizados pesquisáveis — convertendo um arquivo de PDF em texto indexável para um mecanismo de busca — o OCR.space faz isso bem. A saída não precisa ser estruturada; você só precisa das palavras.
Integração de OCR em um pipeline personalizado. Se você é um desenvolvedor criando um pipeline de processamento de documentos onde você mesmo cuidará da extração de campos, validação e gravação no banco de dados, o OCR.space fornece a camada de reconhecimento de caracteres de forma confiável e barata. O Engine 1 (velocidade), Engine 2 (precisão em números) e Engine 3 (preservação de layout) oferecem controle significativo sobre o trade-off.
Extração de texto em alto volume e baixo custo. A $30/mês por 300.000 solicitações no plano PRO, o OCR.space tem um dos menores custos por solicitação do mercado para extração de texto bruto. Se o volume importa mais do que a estrutura, nada mais chega perto nesse preço. Dentro de uma stack da AWS com volumes maiores, o AWS Textract assume — nossa comparação com AWS Textract cobre os trade-offs.
A linha honesta entre as duas ferramentas: o OCR.space é infraestrutura para desenvolvedores; o ImageToTable.ai é um produto acabado para usuários de negócios. Se você precisa escrever código para fazer algo útil com a saída, o OCR.space pode ser a base certa. Se você precisa de uma planilha ao final do processo e não quer escrever nenhum código, ele não é.
Perguntas Frequentes
O OCR.space pode exportar dados diretamente para Excel?
Não. O OCR.space retorna texto bruto ou JSON com caracteres extraídos — não gera arquivos Excel. Para converter essa saída em uma planilha estruturada, é preciso escrever código de parsing personalizado para identificar linhas, rotular campos e criar o arquivo .xlsx. O ImageToTable.ai gera diretamente um arquivo Excel pronto para download, com os nomes de colunas que você especifica como cabeçalhos.
O parâmetro isTable=true do OCR.space extrae dados de tabela estruturados?
Não no sentido de planilha. A flag isTable=true (e o modo de layout do Engine 3) gera texto com espaçamento preservado para aproximar visualmente o layout da tabela original. O resultado continua sendo uma string de texto — não uma matriz 2D de linhas e colunas, não JSON com nomes de campos, e não um arquivo Excel. Como a análise de Koncile.ai observa, "você obtiene texto formatado, mas não diretamente uma tabela que possa ser usada na forma de uma planilha."
Não sou desenvolvedor — posso usar OCR.space para processar minhas faturas?
O OCR.space tem uma interface web em ocr.space onde você pode enviar uma imagem e receber texto. Mas passar desse texto a uma planilha utilizável exige copiar, colar e formatar manualmente — não há extração automática de campos nem exportação a Excel. Se você processa mais que um punhado de documentos, o ImageToTable.ai é uma opção mais prática: envie seus arquivos, digite os nomes de colunas que deseja (como "Vendor, Invoice Number, Total") e baixe diretamente um arquivo Excel mesclado.
Quais são os limites do plano gratuito do OCR.space?
O plano gratuito oferece 25.000 solicitudes de API por mês, sem necessidade de registro — a chave demo "helloworld" funciona imediatamente. O tamanho do arquivo é limitado a 1 MB via API (5 MB via interface web), e os PDFs estão limitados a 3 páginas. A velocidade de processamento é mais lenta que nos planos pagos e não há SLA. As saídas do plano gratuito incluyen una marca de agua "OCR.space" nos PDFs pesquisables generados. O plano gratuito é adequado para prototipagem e testes de baixo volume; a própria documentação do OCR.space desaconseja usar la clave demo en producción.
O ImageToTable.ai e o OCR.space podem ser usados juntos?
Técnicamente sí, pero no hay ninguna razón práctica para combinarlos en la extracción de datos de documentos. ImageToTable.ai ejecuta su propio pipeline de visión LLM que produce salida estructurada directamente — no depende de una capa OCR separada. Si eres desarrollador y construyes un pipeline personalizado y quieres usar OCR.space para la extracción de texto y luego alimentar la salida en una capa separada de parsing de campos, esa es una arquitectura válida — pero es un proyecto de ingeniería de múltiples pasos, no una solución lista para usar.
Experimente o ImageToTable.ai Grátis
Envie suas faturas, recibos ou formulários e baixe uma tabela Excel estruturada com os nomes das suas colunas — sem necessidade de conta, sem código de análise. Se quiser testar primeiro o fluxo de trabalho no navegador sem instalação, comece com a ferramenta de OCR online.
Sem cartão de crédito. Créditos grátis incluídos no cadastro.