ImageToTable.ai vs OCR.space:
Extracción de Datos Estructurados vs Salida de Texto Crudo
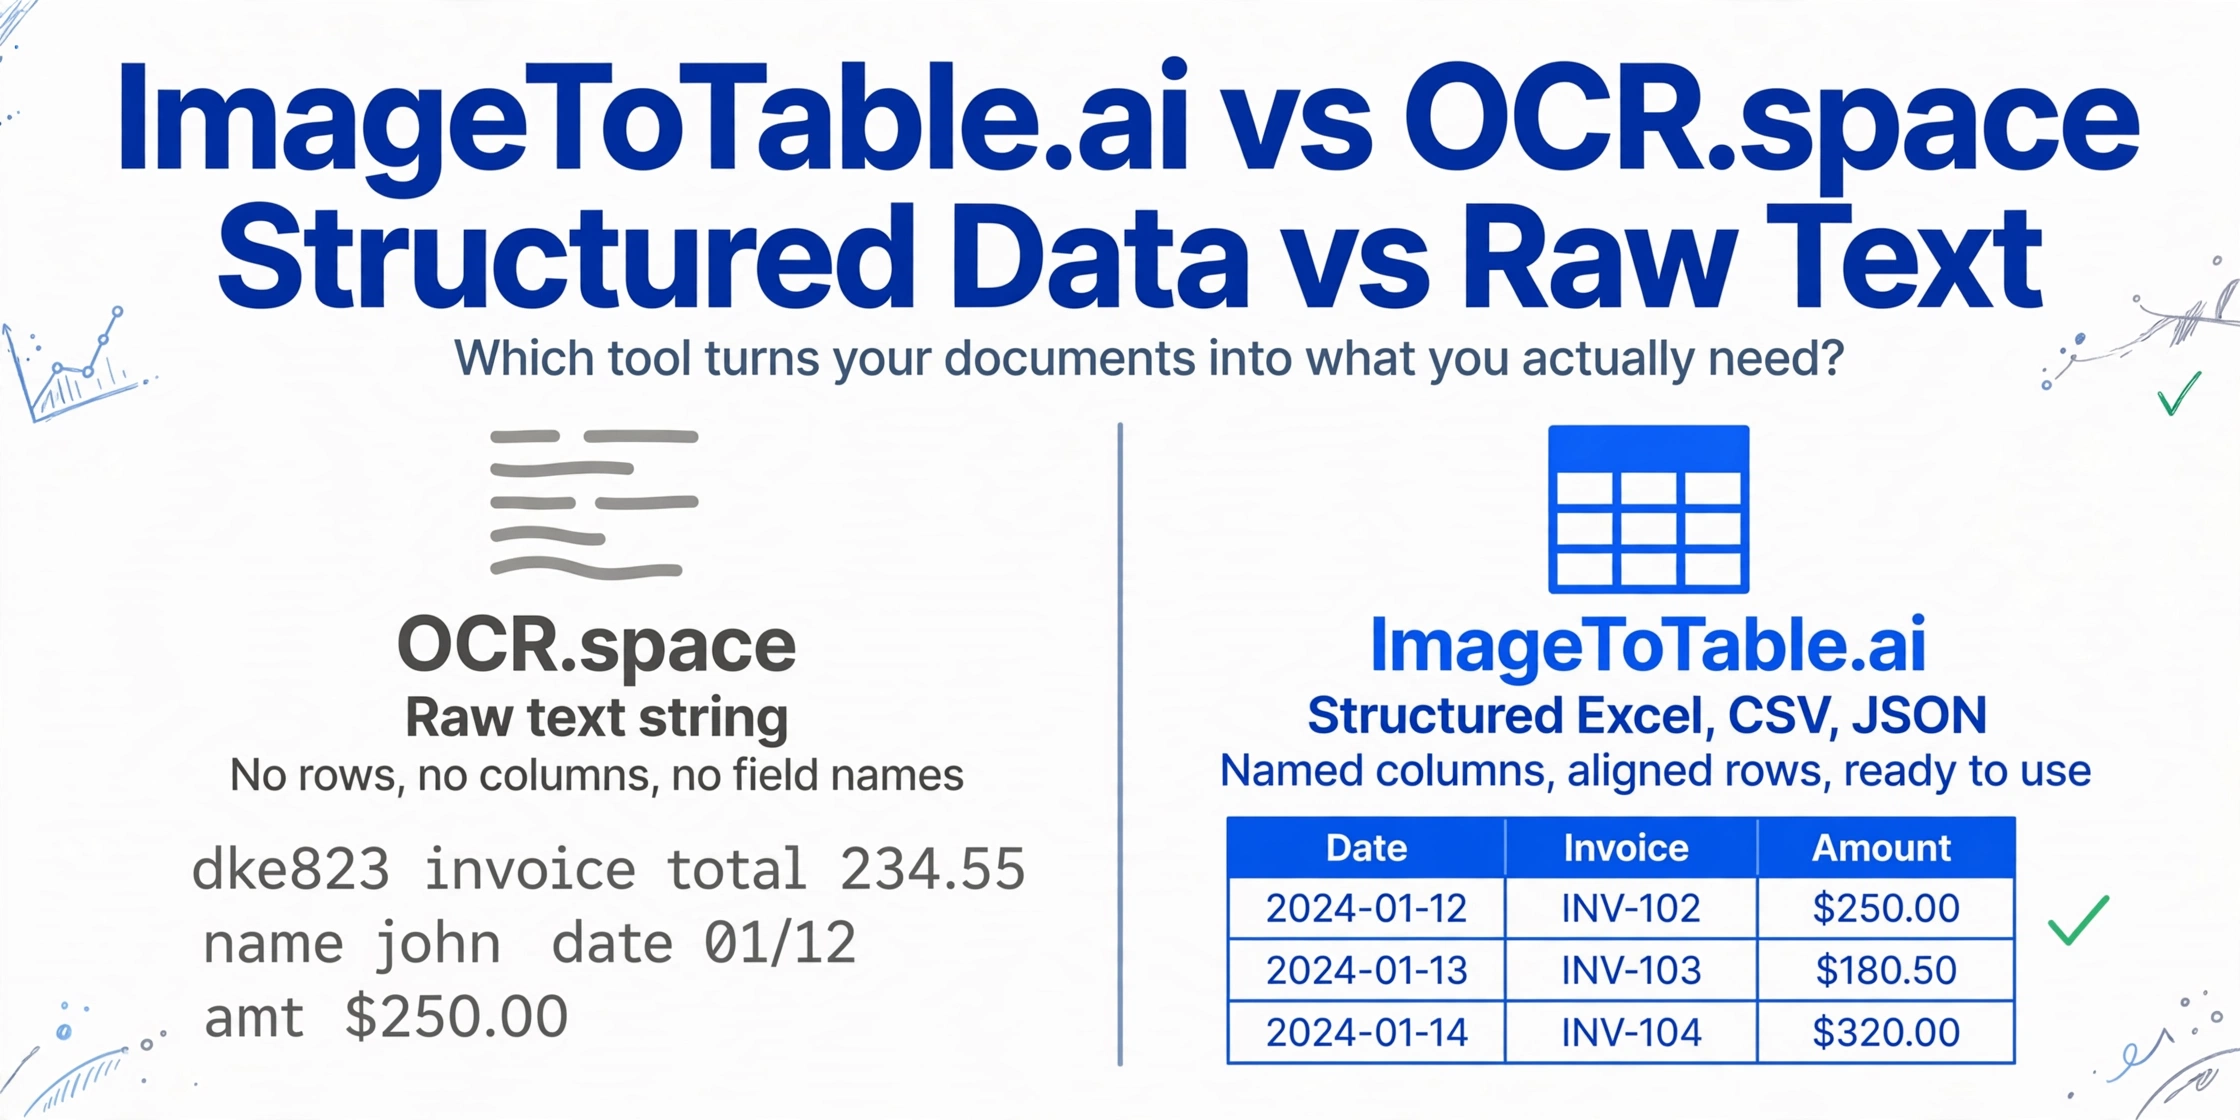
OCR.space e ImageToTable.ai aceptan la misma entrada: imágenes y PDFs. Lo que devuelven es fundamentalmente diferente. OCR.space te da el texto que encontró en el documento. ImageToTable.ai te da los datos que pediste, en una hoja de cálculo con los nombres de columna que definiste. Esa brecha — entre "texto extraído" y "datos listos para usar" — es de lo que trata esta comparación.
Comparación rápida
Elige ImageToTable.ai si…
- Necesitas datos de documentos en una hoja de cálculo — etiquetados, alineados, listos para usar
- No eres desarrollador y no puedes escribir código de análisis para interpretar la salida de OCR
- Tus documentos tienen diseños variables entre diferentes proveedores o fuentes
- Quieres definir nombres de columna específicos y extraer solo esos campos
- Necesitas procesamiento por lotes que combine varios documentos en una sola tabla
Elige OCR.space si…
- Eres desarrollador creando una app y necesitas una API de OCR gratuita y de alto volumen
- Necesitas texto sin procesar de una imagen y te encargarás de la estructura tú mismo
- Estás creando un prototipo de pipeline de documentos y quieres 25,000 llamadas API gratuitas al mes
- Tu caso de uso es digitalización de texto, no extracción de campos
- Necesitas OCR en más de 200 idiomas con configuración mínima
Comparación de funciones
| Característica | OCR.space | ImageToTable.ai |
|---|---|---|
| Formato de salida | Cadena de texto sin formato o texto alineado por espacios en JSON; sin filas/columnas estructuradas | Excel (XLSX), CSV, JSON con columnas con nombre; Word con el diseño preservado |
| Extracción de tablas | El flag isTable=true produce texto alineado por espacios que aproxima el diseño, no estructuras reales de filas/columnas | Vision LLM identifica la estructura de la tabla a partir de la semántica del documento; genera filas alineadas y columnas con nombre |
| Extracción de campos personalizados | No compatible: OCR.space no tiene el concepto de campos con nombre; todo el texto se devuelve sin diferenciar | Función principal: escribe los nombres de las columnas que quieras; esos se convierten en los encabezados de tu Excel |
| Procesamiento por lotes | La API admite llamadas por lotes; la salida son bloques de texto separados por archivo, sin fusión entre archivos | Todos los archivos de un lote se fusionan automáticamente en una sola hoja de cálculo alineada |
| Usuario principal | Desarrolladores que crean aplicaciones o scripts de automatización | Usuarios de negocio que necesitan datos de documentos en una hoja de cálculo |
| Configuración necesaria | Clave de API (sin registro en el plan gratuito); llamada REST con unos pocos parámetros | Sube archivos, escribe los nombres de las columnas, descarga: sin cuenta necesaria en el modo invitado |
| Idiomas compatibles | Más de 200 idiomas con detección automática | Todos los idiomas compatibles con el Vision LLM subyacente |
| Soporte de escritura a mano | Limitado: la precisión disminuye significativamente con texto manuscrito o estilizado | Maneja escritura a mano, cursiva, casillas de verificación y sellos |
| Plan gratuito | 25,000 solicitudes de API al mes, sin necesidad de registro | Modo invitado gratuito; cuota diaria gratuita en cuentas registradas |
| Precios | Gratis (25,000 solicitudes/mes); PRO $30/mes (300,000 solicitudes); PRO PDF $60/mes (PDF grandes) | Nivel invitado gratuito; de pago desde $9/mes; pago por uso desde $6/50 páginas |
Lo que OCR.space realmente devuelve
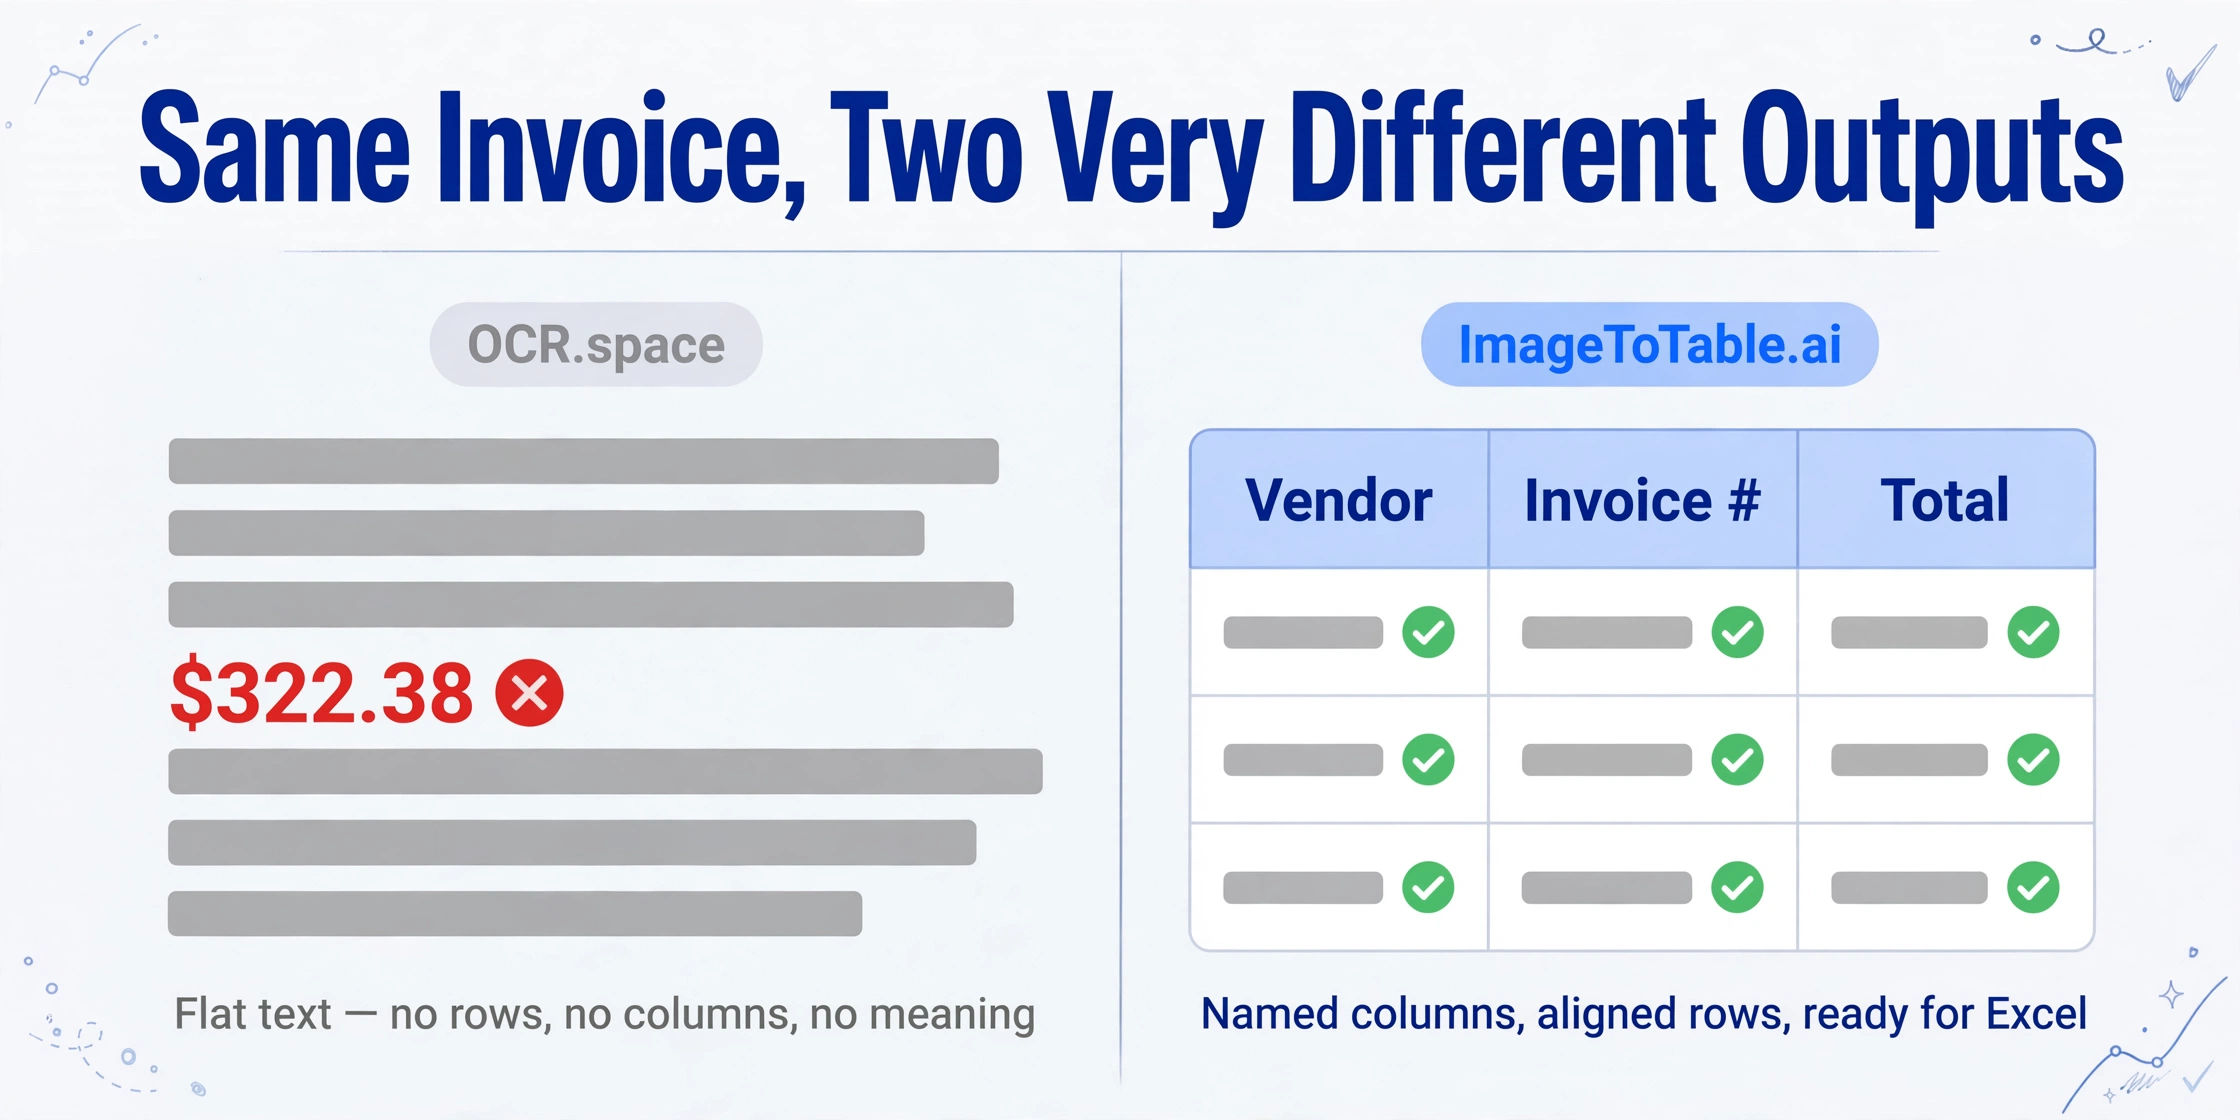
OCR.space responde una pregunta con precisión: ¿qué texto hay en esta imagen? Dale una foto de una factura y devuelve los caracteres que encontró, organizados aproximadamente para coincidir con el diseño original. Así se ve una respuesta típica de la API para una factura escaneada:
INVOICE
Vendor: Acme Supplies Ltd        Invoice #: INV-2024-0892
Date: March 15, 2024             Due Date: April 14, 2024

Description              Qty    Unit Price    Total
Office paper (500 sheets)  10     $12.50      $125.00
Printer cartridges          4     $34.00      $136.00
Desk organizers             2     $18.75       $37.50

                                  Subtotal:   $298.50
                                  Tax (8%):    $23.88
                                  TOTAL:      $322.38
Parece útil a simple vista. El problema aparece en cuanto intentas ponerlo en una hoja de cálculo. El texto es una cadena plana: no hay filas, ni columnas, ni nombres de campos, ni tipos de datos. El número $322.38 es indistinguible de cualquier otro número en la cadena. La etiqueta "TOTAL" es solo otra palabra. OCR.space no tiene idea de que $322.38 es un total de factura, de que INV-2024-0892 es un número de factura, o de que Acme Supplies Ltd es un nombre de proveedor. Ese es el mismo límite estructural que encuentra la función Data from Picture integrada de Excel: nuestra comparación de Excel Data from Picture analiza específicamente las herramientas de copiado de cuadrículas.
Como lo dice directamente la reseña práctica de Koncile.ai: "El reconocimiento de tablas no reemplaza la extracción 100% estructurada (campo por campo): obtienes texto formateado, pero no directamente una tabla que se pueda usar en forma de hoja de cálculo."
La salida de ImageToTable.ai para el mismo documento es diferente en tipo, no solo en grado. Escribes "Vendor, Invoice Number, Total, Due Date" como nombres de tus columnas. La herramienta devuelve una hoja de cálculo con esas cuatro columnas, cada una poblada con los valores correctos de cada documento de tu lote, incluidos documentos de diferentes proveedores con diferentes diseños.
Los cuatro pasos entre el texto de OCR y un Excel utilizable
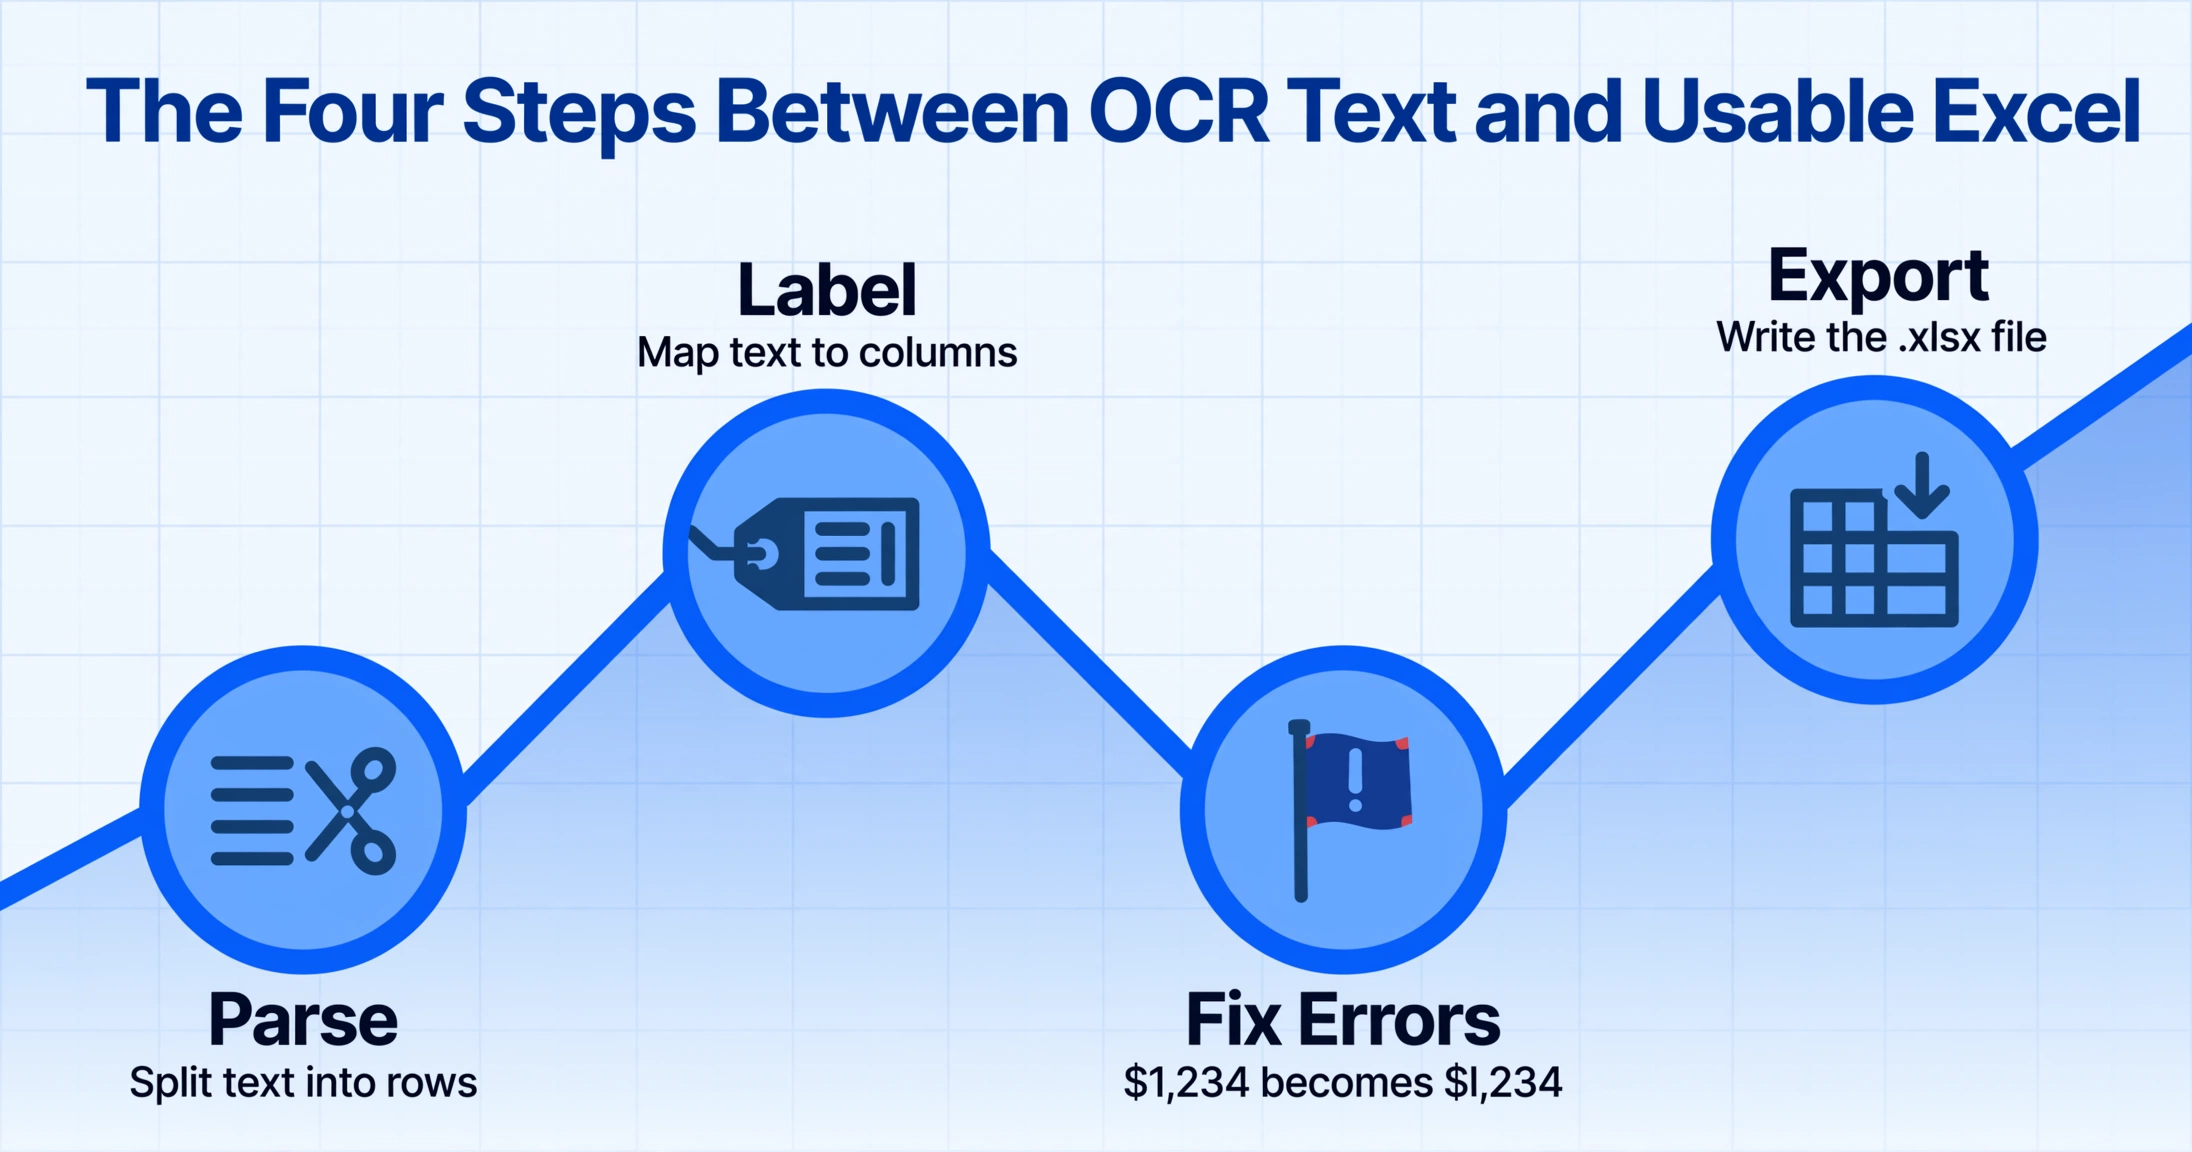
Pasar de la salida de OCR.space a una hoja de cálculo utilizable requiere un trabajo de ingeniería con el que la herramienta no ayuda en nada. Para un desarrollador, esto significa días de implementación. Para alguien que no es desarrollador, simplemente no es posible sin herramientas adicionales.
Como lo plantea el análisis de Parseur sobre OCR vs. procesamiento de documentos: "El OCR es como leer texto en una página; el procesamiento de documentos es entender ese texto, etiquetarlo y hacer algo útil con él, automáticamente." OCR.space hace lo primero. Todo lo demás queda de tu parte.
Esto es lo que implica "todo lo demás" en la práctica:
- Paso 1 — Analizar el texto en filas. Escribe lógica de regex o división de cadenas para identificar dónde termina una partida y comienza otra. Para facturas con formatos consistentes, esto es tedioso pero factible. Para documentos con diseños variables de varios proveedores, requiere un motor de reglas separado por formato.
- Paso 2 — Identificar y etiquetar campos. Escribe código que asigne la posición del texto a los encabezados de columna — para que la herramienta sepa que el número después de "TOTAL:" es un total de factura, no el precio de una partida. Esta lógica debe reescribirse para cada nuevo diseño de documento.
- Paso 3 — Gestionar errores de OCR. Incluso con un 99% de precisión de caracteres, un documento de 500 caracteres contiene ~5 caracteres corruptos. Cantidades en dólares como
$1,234pueden convertirse en$l,234o$1.234, rompiendo el análisis numérico. La lógica de validación y corrección de errores debe implementarse por separado. - Paso 4 — Escribir el archivo Excel. Usa una librería (openpyxl, xlsxwriter, xlsx.js) para crear el archivo .xlsx real con los encabezados, anchos de columna y tipos de datos correctos.
La existencia de herramientas secundarias completas — sitios como ocrtoexcel.com y ocrdataextraction.com — creadas específicamente para cerrar la brecha entre la salida de OCR y Excel es en sí misma evidencia de esta carencia. Hay un mercado para la capa de conversión que OCR.space no proporciona.
En la comparación de Klippa de 10 APIs de OCR, OCR.space ocupó el puesto 9 de 10 — con la principal crítica siendo la falta de salida de datos estructurados. Ese ranking refleja la brecha entre "texto extraído" y "datos listos para usar".
Cuándo OCR.space es la herramienta adecuada
OCR.space es realmente excelente en lo que está diseñado para hacer, y vale la pena ser específico sobre cuándo coincide con tu necesidad real.
Prototipado para desarrolladores a costo cero. 25,000 solicitudes de API al mes sin registro es un nivel gratuito inusualmente generoso. Si estás creando una aplicación que necesita extraer texto de imágenes y quieres validar el enfoque antes de comprometerte con un servicio de pago, OCR.space es la forma más rápida de empezar. Sin cuenta, sin tarjeta de crédito, sin aprobación de cuota.
Digitalización de texto, no extracción de campos. Si tu objetivo es hacer que los documentos escaneados sean buscables — convertir un archivo PDF en texto indexable para un motor de búsqueda — OCR.space lo hace bien. La salida no necesita estar estructurada; solo necesitas las palabras.
Integración de OCR en un pipeline personalizado. Si eres un desarrollador que construye un pipeline de procesamiento de documentos donde tú mismo manejarás la extracción de campos, la validación y la escritura en la base de datos, OCR.space proporciona la capa de reconocimiento de caracteres de forma fiable y económica. Su Engine 1 (velocidad), Engine 2 (precisión en números) y Engine 3 (preservación del diseño) te dan un control significativo sobre el equilibrio.
Extracción de texto de alto volumen y bajo costo. Con $30/mes por 300,000 solicitudes en el plan PRO, OCR.space tiene uno de los costos por solicitud más bajos del mercado para extracción de texto sin procesar. Si el volumen importa más que la estructura, nada más se acerca a ese precio. Dentro de una infraestructura AWS con volúmenes más altos, AWS Textract toma el relevo — nuestra comparación con AWS Textract cubre las ventajas y desventajas.
La línea honesta entre las dos herramientas: OCR.space es infraestructura para desarrolladores; ImageToTable.ai es un producto terminado para usuarios de negocio. Si necesitas escribir código para hacer algo útil con la salida, OCR.space puede ser la base adecuada. Si necesitas una hoja de cálculo al final del proceso y no quieres escribir ningún código, no lo es.
Preguntas Frecuentes
¿Puede OCR.space exportar datos directamente a Excel?
No. OCR.space devuelve texto sin formato o JSON con los caracteres extraídos; no genera archivos de Excel. Convertir esa salida en una hoja de cálculo estructurada requiere escribir código de análisis personalizado para identificar filas, etiquetar campos y crear el archivo .xlsx. ImageToTable.ai produce directamente un archivo de Excel listo para descargar, con los nombres de columna que tú especifiques como encabezados.
¿El parámetro isTable=true de OCR.space extrae datos de tablas estructuradas?
No en el sentido de hoja de cálculo. La marca isTable=true (y el modo de diseño de Engine 3) genera texto con el espaciado conservado para aproximar visualmente el diseño de la tabla original. El resultado sigue siendo una cadena de texto, no una matriz 2D de filas y columnas, ni JSON con nombres de campos, ni un archivo de Excel. Como señala la reseña de Koncile.ai, «obtienes texto formateado, pero no directamente una tabla que pueda usarse en forma de hoja de cálculo».
No soy desarrollador, ¿puedo usar OCR.space para procesar mis facturas?
OCR.space tiene una interfaz web en ocr.space donde puedes subir una imagen y obtener texto. Pero pasar de ese texto a una hoja de cálculo utilizable requiere copiar, pegar y formatear manualmente; no hay extracción automática de campos ni exportación a Excel. Si procesas más de un puñado de documentos, ImageToTable.ai es una opción más práctica: sube tus archivos, escribe los nombres de columna que quieras (como «Proveedor, Número de Factura, Total») y descarga directamente un archivo de Excel combinado.
¿Cuáles son los límites del plan gratuito de OCR.space?
El plan gratuito ofrece 25 000 solicitudes de API al mes sin necesidad de registro: la clave de demostración «helloworld» funciona de inmediato. El tamaño de archivo está limitado a 1 MB a través de la API (5 MB a través de la interfaz web), y los PDF están limitados a 3 páginas. La velocidad de procesamiento es más lenta que en los planes de pago y no hay SLA. Las salidas del plan gratuito incluyen una marca de agua «OCR.space» en los PDF de búsqueda generados. El plan gratuito es adecuado para prototipos y pruebas de bajo volumen; la documentación de OCR.space desaconseja usar la clave de demostración en producción.
¿Se pueden usar ImageToTable.ai y OCR.space juntos?
Técnicamente sí, pero no hay una razón práctica para combinarlos en la extracción de datos de documentos. ImageToTable.ai ejecuta su propio pipeline de Vision LLM que produce salida estructurada directamente; no depende de una capa OCR separada. Si eres desarrollador y estás creando un pipeline personalizado y quieres usar OCR.space para la extracción de texto y luego alimentar la salida en una capa separada de análisis de campos, esa es una arquitectura válida, pero es un proyecto de ingeniería de varios pasos, no una solución lista para usar.
Prueba ImageToTable.ai gratis
Sube tus facturas, recibos o formularios y descarga una tabla de Excel estructurada con los nombres de tus columnas: no necesitas cuenta ni código de análisis. Si quieres probar primero el flujo de trabajo en el navegador sin instalación, empieza con la herramienta OCR en línea.
No se requiere tarjeta de crédito. Créditos gratuitos incluidos al registrarte.