ImageToTable.ai vs. OCR.space:
Strukturierte Datenextraktion vs. Rohtextausgabe
OCR.space und ImageToTable.ai akzeptieren beide dieselbe Eingabe – Bilder und PDFs. Was sie zurückgeben, unterscheidet sich grundlegend. OCR.space liefert den Text, den es im Dokument gefunden hat. ImageToTable.ai liefert die Daten, die Sie angefordert haben, in einer Tabellenkalkulation mit den von Ihnen definierten Spaltennamen. Diese Lücke – zwischen „Text extrahiert“ und „Daten einsatzbereit“ – ist das Thema dieses Vergleichs.
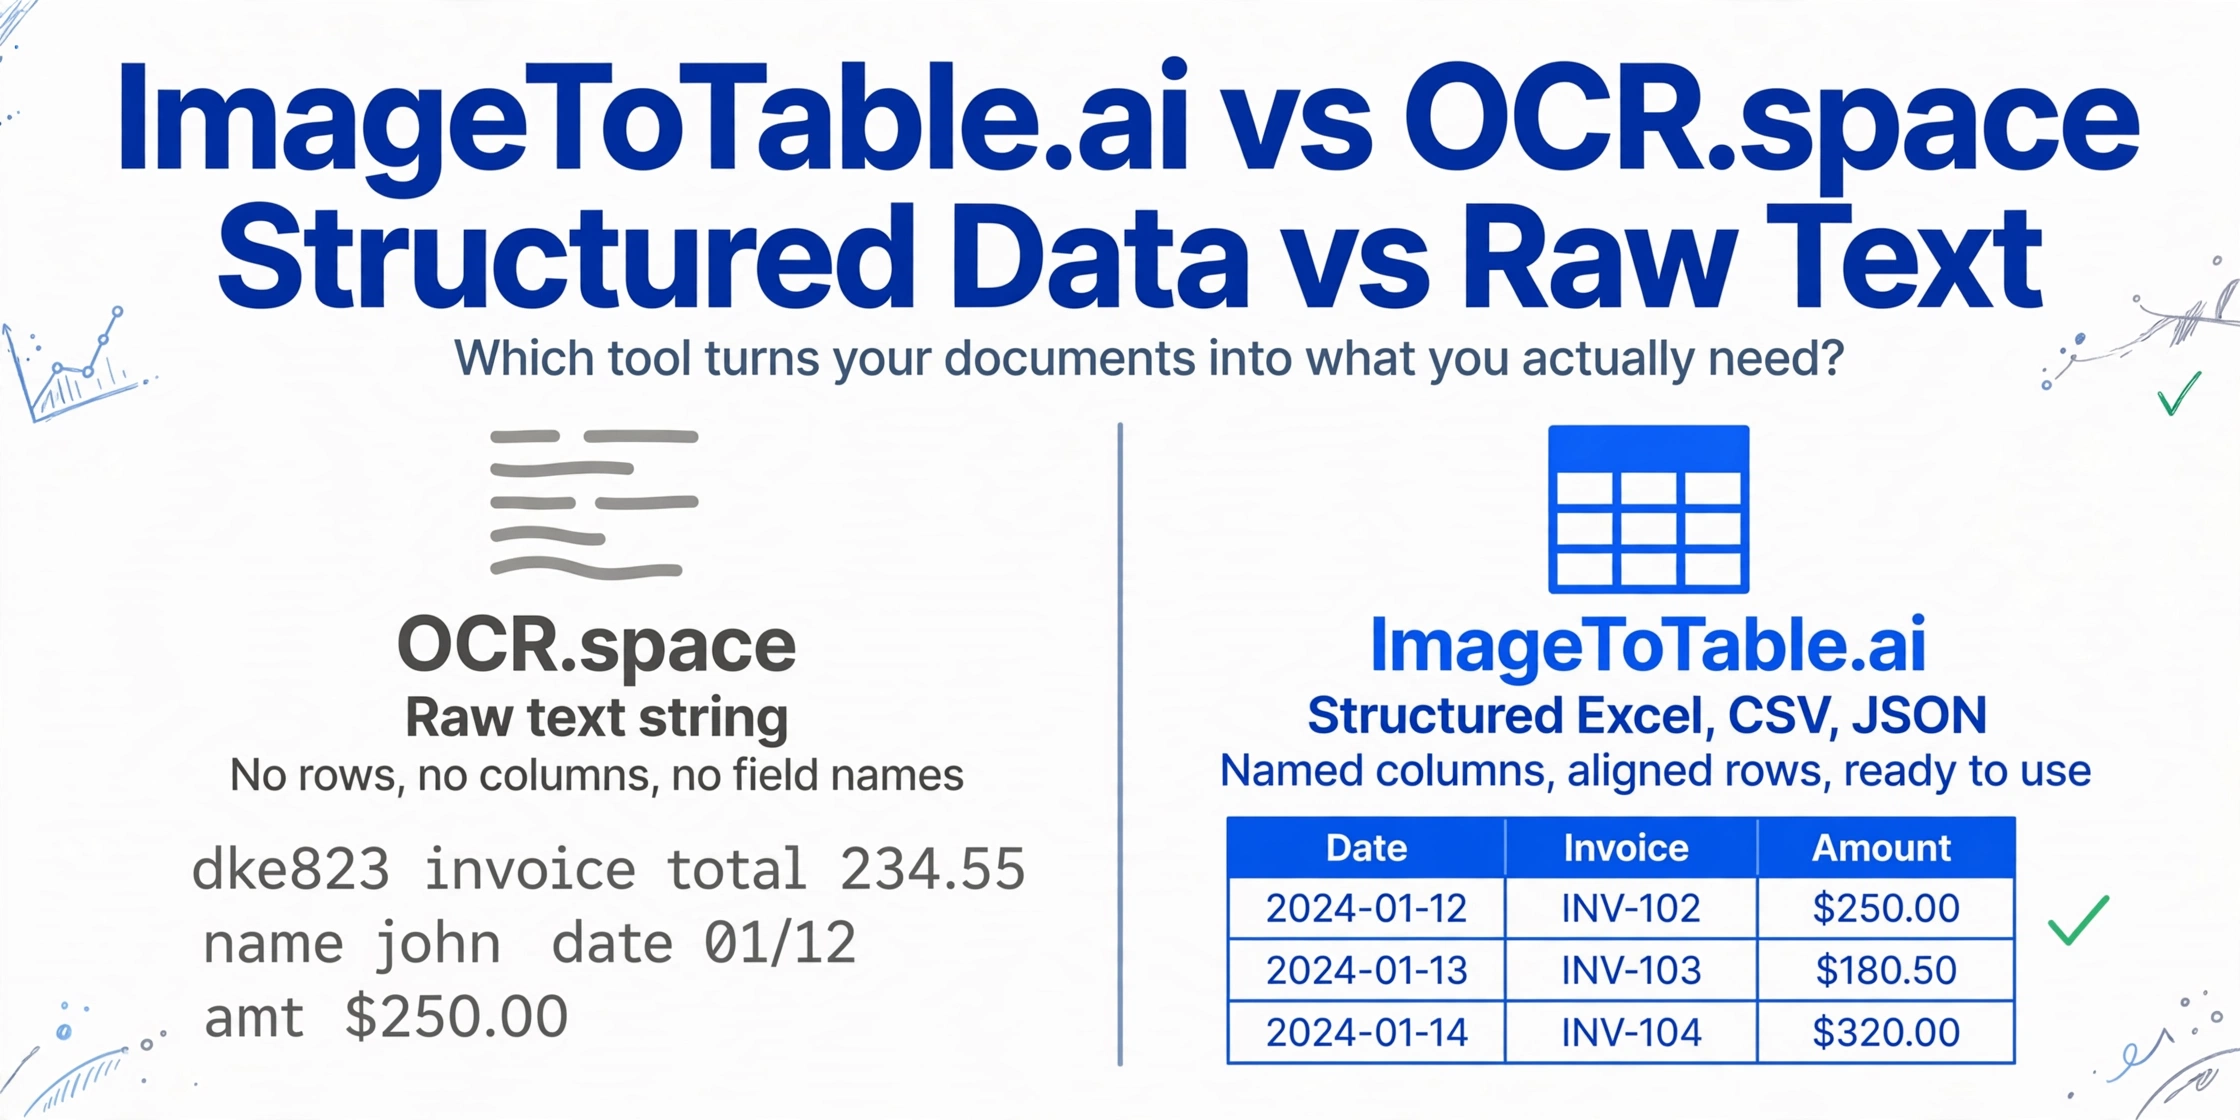
Schnellvergleich
Wählen Sie ImageToTable.ai, wenn…
- Sie Daten aus Dokumenten in einer Tabelle benötigen – beschriftet, ausgerichtet, einsatzbereit
- Sie kein Entwickler sind und keinen Parsing-Code schreiben können, um OCR-Ausgaben zu interpretieren
- Ihre Dokumente variable Layouts von verschiedenen Anbietern oder Quellen haben
- Sie bestimmte Spaltennamen festlegen und nur diese Felder extrahieren möchten
- Sie eine Batch-Verarbeitung benötigen, die mehrere Dokumente in einer Tabelle zusammenführt
Wählen Sie OCR.space, wenn…
- Sie ein Entwickler sind, der eine App baut, und eine kostenlose OCR-API mit hohem Volumen benötigen
- Sie Rohtext aus einem Bild benötigen und die Struktur selbst übernehmen
- Sie eine Dokument-Pipeline prototypisieren und 25.000 kostenlose API-Aufrufe/Monat wünschen
- Ihr Anwendungsfall Textdigitalisierung ist, nicht Feldextraktion
- Sie OCR in über 200 Sprachen mit minimalem Setup benötigen
Funktionsvergleich
| Funktion | OCR.space | ImageToTable.ai |
|---|---|---|
| Ausgabeformat | Roher Textstring oder leerzeichenausgerichteter Text in JSON; keine strukturierten Zeilen/Spalten | Excel (XLSX), CSV, JSON mit benannten Spalten; Word mit erhaltener Formatierung |
| Tabellenextraktion | isTable=true-Flag erzeugt leerzeichenausgerichteten Text, der das Layout annähert — keine echten Zeilen-/Spalten-Datenstrukturen | Vision LLM erkennt die Tabellenstruktur anhand der Dokument-Semantik; gibt ausgerichtete Zeilen und benannte Spalten aus |
| Benutzerdefinierte Feldextraktion | Nicht unterstützt — OCR.space kennt keine benannten Felder; der gesamte Text wird undifferenziert zurückgegeben | Kernfunktion — geben Sie die gewünschten Spaltennamen ein; diese werden zu Ihren Excel-Überschriften |
| Stapelverarbeitung | API unterstützt Stapelaufrufe; die Ausgabe sind separate Textblöcke pro Datei ohne dateiübergreifende Zusammenführung | Alle Dateien eines Stapels werden automatisch in einer ausgerichteten Tabelle zusammengeführt |
| Hauptzielgruppe | Entwickler, die Apps oder Automatisierungsskripte erstellen | Geschäftsanwender, die Daten aus Dokumenten in einer Tabelle benötigen |
| Erforderliche Einrichtung | API-Schlüssel (keine Registrierung für den kostenlosen Tarif); REST-Aufruf mit einigen Parametern | Dateien hochladen, Spaltennamen eingeben, herunterladen — kein Konto für den Gastmodus erforderlich |
| Sprachunterstützung | 200+ Sprachen mit automatischer Erkennung | Alle Sprachen, die vom zugrunde liegenden Vision LLM unterstützt werden |
| Handschriftunterstützung | Begrenzt — die Genauigkeit nimmt bei handschriftlichem oder stilisertem Text deutlich ab | Verarbeitet Handschrift, Schreibschrift, Kontrollkästchen, Stempel |
| Kostenloser Tarif | 25.000 API-Anfragen/Monat, keine Registrierung erforderlich | Kostenloser Gastmodus; tägliches kostenloses Kontingent für registrierte Konten |
| Preise | Kostenlos (25.000 Anfragen/Monat); PRO $30/Monat (300.000 Anfragen); PRO PDF $60/Monat (große PDFs) | Kostenloser Gasttarif; kostenpflichtig ab $9/Monat; nutzungsbasiert ab $6/50 Seiten |
Was OCR.space tatsächlich zurückgibt
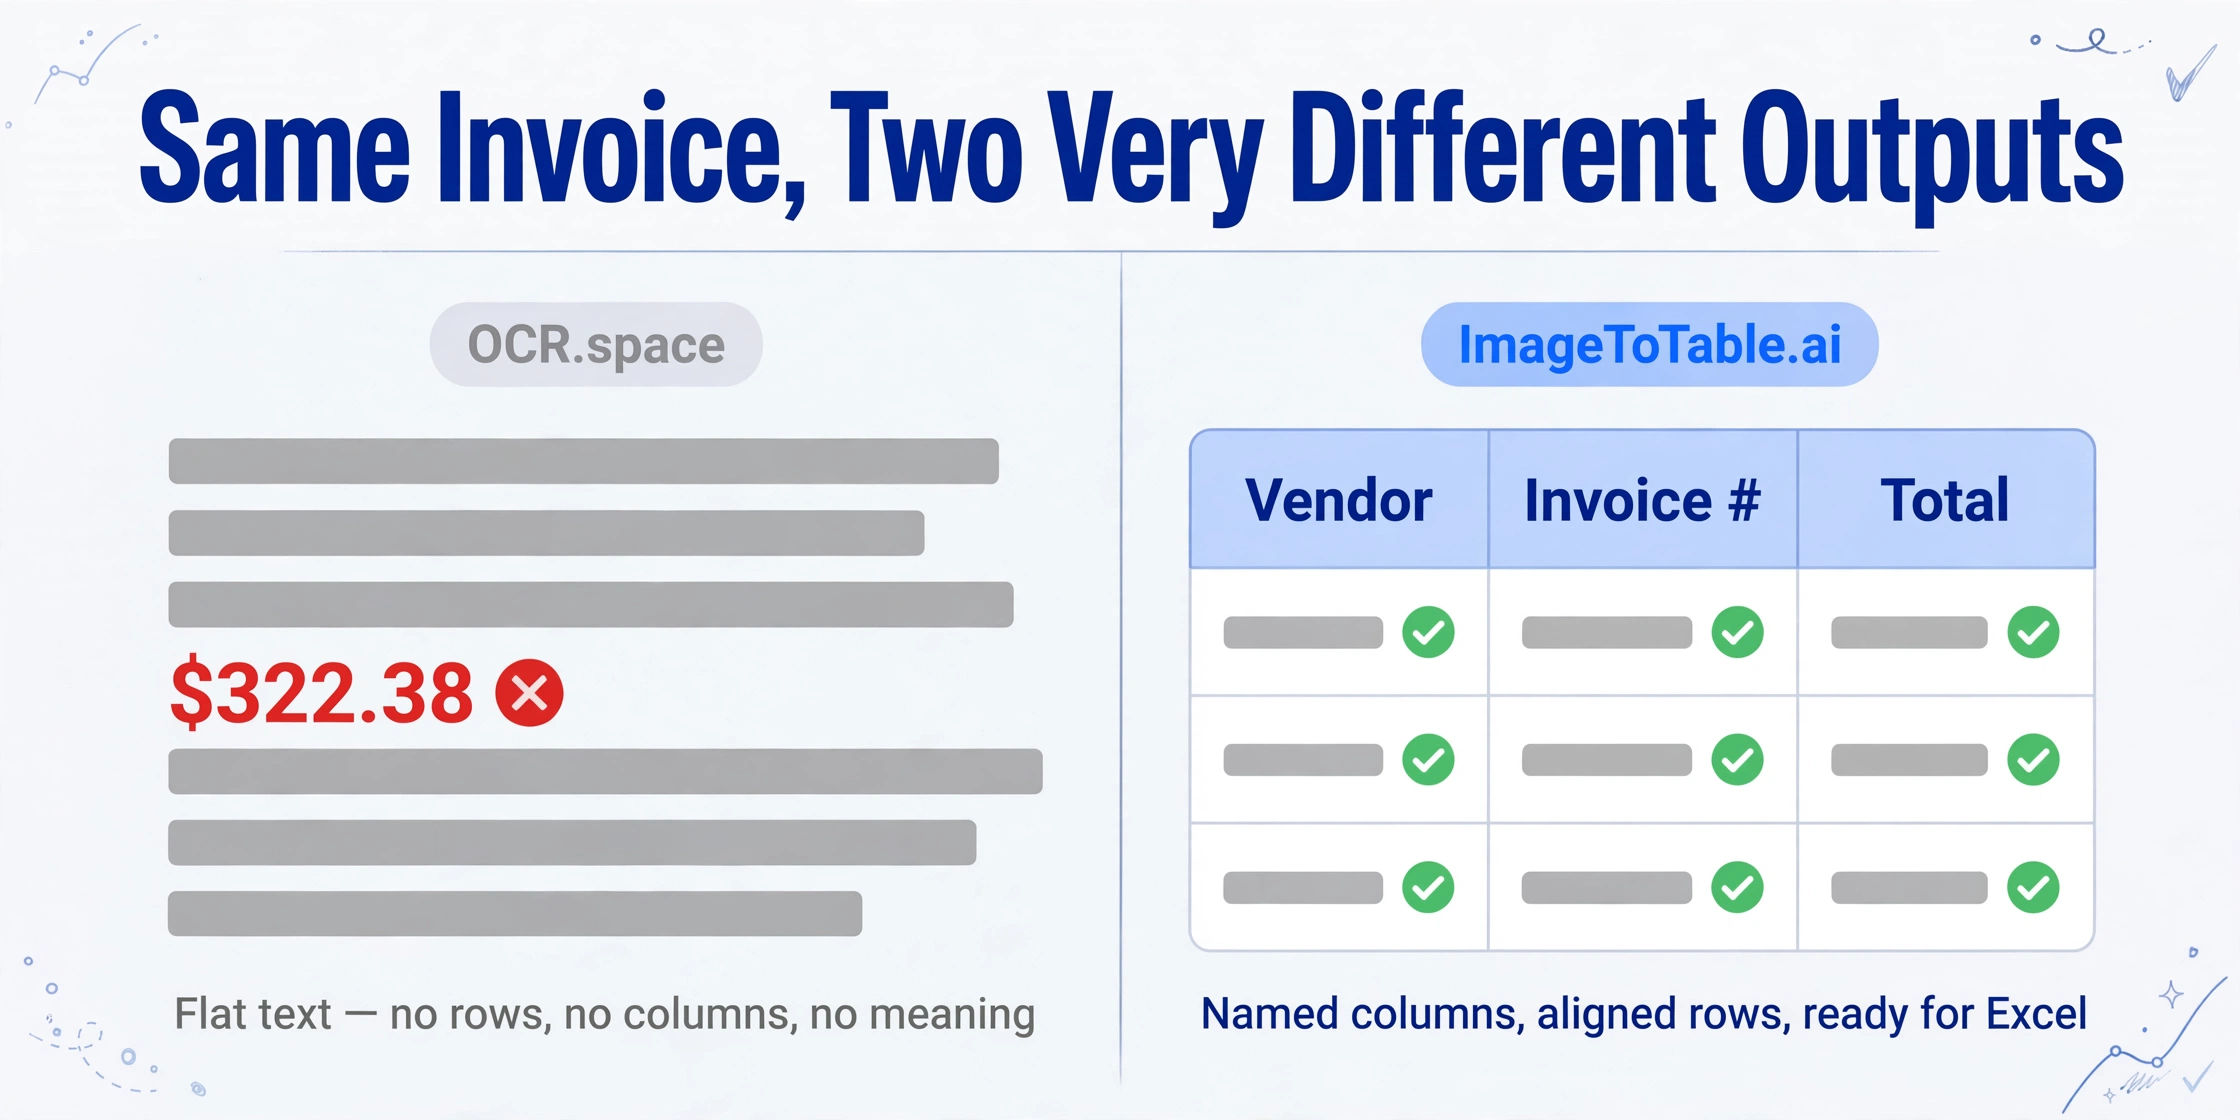
OCR.space beantwortet genau eine Frage: Welcher Text ist in diesem Bild? Geben Sie ein Foto einer Rechnung ein, und es liefert die gefundenen Zeichen zurück, grob angeordnet entsprechend dem ursprünglichen Layout. So sieht eine typische API-Antwort für eine gescannte Rechnung aus:
INVOICE
Vendor: Acme Supplies Ltd        Invoice #: INV-2024-0892
Date: March 15, 2024             Due Date: April 14, 2024

Description              Qty    Unit Price    Total
Office paper (500 sheets)  10     $12.50      $125.00
Printer cartridges          4     $34.00      $136.00
Desk organizers             2     $18.75       $37.50

                                  Subtotal:   $298.50
                                  Tax (8%):    $23.88
                                  TOTAL:      $322.38
Das sieht auf den ersten Blick brauchbar aus. Das Problem zeigt sich, sobald Sie es in eine Tabellenkalkulation übertragen möchten. Der Text ist ein flacher String – es gibt keine Zeilen, keine Spalten, keine Feldnamen, keine Datentypen. Die Zahl $322.38 ist von jeder anderen Zahl im String nicht zu unterscheiden. Die Bezeichnung „TOTAL“ ist nur ein weiteres Wort. OCR.space weiß nicht, dass $322.38 eine Rechnungssumme ist, dass INV-2024-0892 eine Rechnungsnummer ist oder dass Acme Supplies Ltd ein Lieferantenname ist. Das ist dieselbe strukturelle Grenze, an die auch die integrierte Funktion Data from Picture in Excel stößt – unser Vergleich von Excel Data from Picture befasst sich speziell mit Werkzeugen zum Kopieren von Rastern.
Wie Koncile.ais Praxis-Test es direkt formuliert: „Die Tabellenerkennung ersetzt keine 100% strukturierte Extraktion (Feld für Feld): Sie erhalten formatierten Text, aber nicht direkt eine Tabelle, die in Form einer Tabellenkalkulation verwendet werden kann.“
Die Ausgabe von ImageToTable.ai für dasselbe Dokument unterscheidet sich grundlegend, nicht nur graduell. Sie geben „Lieferant, Rechnungsnummer, Gesamtsumme, Fälligkeitsdatum“ als Ihre Spaltennamen ein. Das Tool liefert eine Tabellenkalkulation mit diesen vier Spalten zurück, jeweils befüllt mit den korrekten Werten aus jedem Dokument in Ihrem Batch – einschließlich Dokumenten von verschiedenen Lieferanten mit unterschiedlichen Layouts.
Die vier Schritte zwischen OCR-Text und nutzbarem Excel
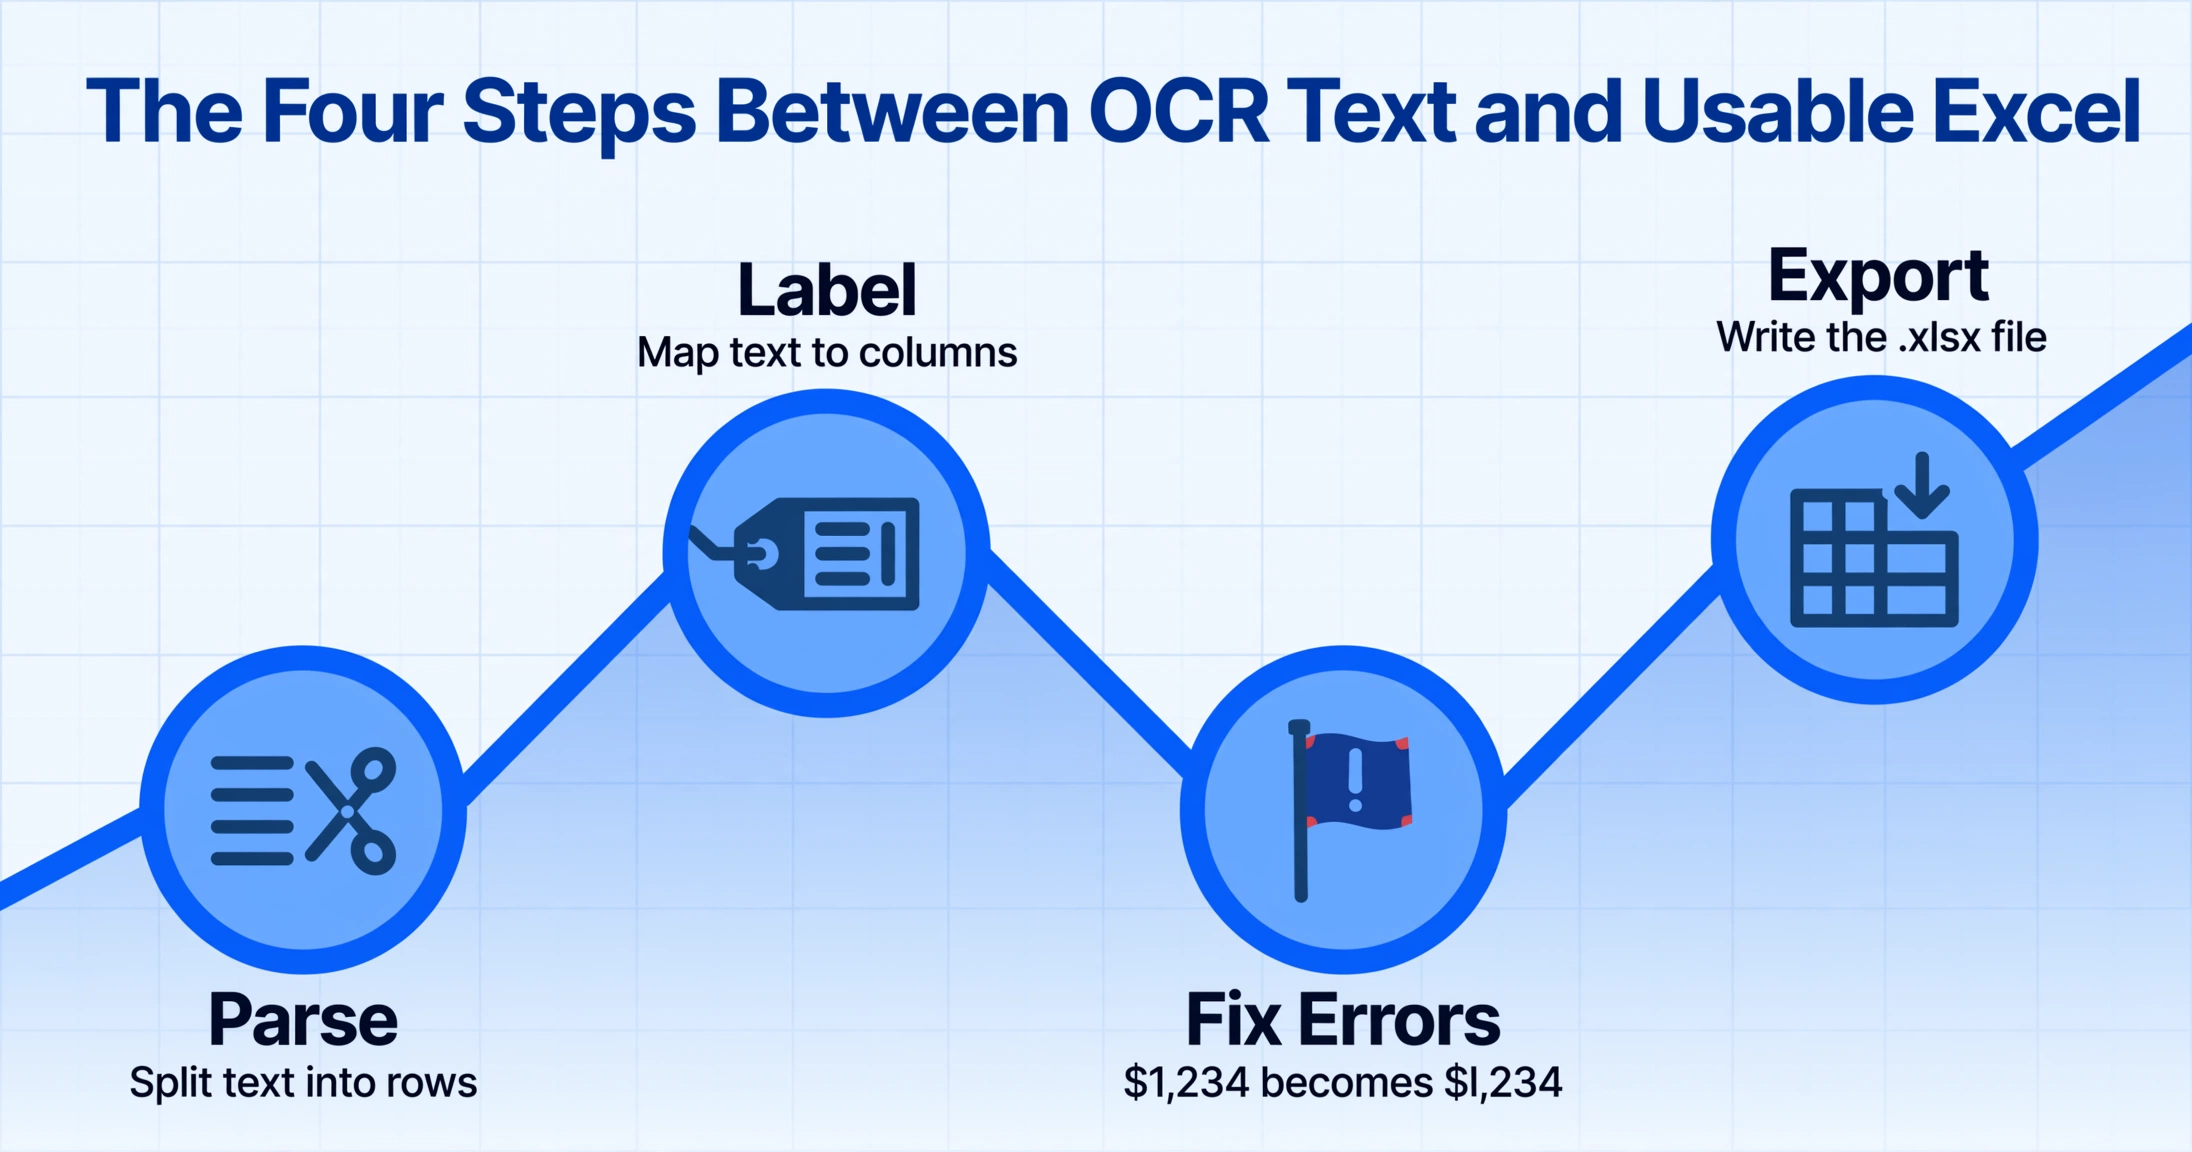
Von der OCR.space-Ausgabe zu einer nutzbaren Tabelle zu gelangen, erfordert technische Arbeit, bei der das Tool keinerlei Hilfe bietet. Für einen Entwickler bedeutet das Tage der Implementierung. Für einen Nicht-Entwickler ist es ohne zusätzliche Tools schlicht nicht möglich.
Wie Parseurs Vergleich von OCR und Dokumentenverarbeitung es formuliert: „OCR ist wie das Lesen von Text auf einer Seite; Dokumentenverarbeitung ist wie das Verstehen dieses Textes, das Beschriften und das automatische Nutzbarmachen." OCR.space erledigt Ersteres. Alles danach liegt bei Ihnen.
Das ist es, was „alles danach" tatsächlich umfasst:
- Schritt 1 — Den Text in Zeilen parsen. Schreiben Sie Regex- oder String-Splitting-Logik, um zu erkennen, wo ein Positionsposten endet und ein anderer beginnt. Bei Rechnungen mit konsistenten Formaten ist das mühsam, aber machbar. Bei Dokumenten mit variablem Layout von mehreren Anbietern ist eine separate Regel-Engine pro Format erforderlich.
- Schritt 2 — Felder identifizieren und beschriften. Schreiben Sie Code, der Textpositionen Spaltenüberschriften zuordnet – damit das Tool weiß, dass die Zahl nach „TOTAL:" eine Rechnungssumme ist und kein Positionspreis. Diese Logik muss für jedes neue Dokumentlayout neu geschrieben werden.
- Schritt 3 — OCR-Fehler behandeln. Selbst bei 99 % Zeichengenauigkeit enthält ein 500-Zeichen-Dokument etwa 5 beschädigte Zeichen. Beträge wie
$1,234können zu$l,234oder$1.234werden und die Zahlenanalyse brechen. Validierungs- und Fehlerkorrekturlogik müssen separat implementiert werden. - Schritt 4 — Die Excel-Datei schreiben. Verwenden Sie eine Bibliothek (openpyxl, xlsxwriter, xlsx.js), um die eigentliche .xlsx-Datei mit korrekten Überschriften, Spaltenbreiten und Datentypen zu erstellen.
Die Existenz ganzer Sekundärtools – Websites wie ocrtoexcel.com und ocrdataextraction.com, die speziell dafür gebaut wurden, die Lücke zwischen OCR-Ausgabe und Excel zu schließen – ist selbst ein Beleg für diese Lücke. Es gibt einen Markt für die Konvertierungsebene, die OCR.space nicht bietet.
In Klippas Vergleich von 10 OCR-APIs belegte OCR.space den 9. von 10 Plätzen – mit dem Hauptkritikpunkt des fehlenden strukturierten Datenoutputs. Diese Platzierung spiegelt die Lücke zwischen „Text extrahiert" und „Daten gebrauchsfertig" wider.
Wann OCR.space das richtige Tool ist
OCR.space ist wirklich hervorragend für das, wofür es entwickelt wurde, und es lohnt sich, genau zu sagen, wann das zu Ihrem tatsächlichen Bedarf passt.
Entwickler-Prototyping ohne Kosten. 25.000 API-Anfragen pro Monat ohne Registrierung ist ein ungewöhnlich großzügiger kostenloser Tarif. Wenn Sie eine App entwickeln, die Text aus Bildern extrahieren muss, und Sie den Ansatz validieren möchten, bevor Sie sich für einen kostenpflichtigen Dienst entscheiden, ist OCR.space der schnellste Weg. Kein Konto, keine Kreditkarte, keine Kontingentfreigabe.
Textdigitalisierung, keine Feldextraktion. Wenn Ihr Ziel darin besteht, gescannte Dokumente durchsuchbar zu machen — einen PDF-Archivbestand in indexierbaren Text für eine Suchmaschine umzuwandeln — macht OCR.space das gut. Die Ausgabe muss nicht strukturiert sein; Sie brauchen nur die Wörter.
Einbettung von OCR in eine eigene Pipeline. Wenn Sie als Entwickler eine Dokumentenverarbeitungspipeline aufbauen, bei der Sie Feldextraktion, Validierung und Datenbankschreiben selbst übernehmen, liefert OCR.space die Zeichenerkennungsschicht zuverlässig und kostengünstig. Seine Engine 1 (Geschwindigkeit), Engine 2 (Genauigkeit bei Zahlen) und Engine 3 (Layout-Erhalt) geben Ihnen sinnvolle Kontrolle über den Kompromiss.
Hochvolumige, kostengünstige Textextraktion. Mit 30 $/Monat für 300.000 Anfragen im PRO-Plan hat OCR.space eine der niedrigsten Kosten pro Anfrage auf dem Markt für rohe Textextraktion. Wenn Volumen wichtiger ist als Struktur, kommt nichts anderes zu diesem Preis in die Nähe. Innerhalb eines AWS-Stacks mit höheren Volumina übernimmt AWS Textract — unser AWS-Textract-Vergleich deckt die Kompromisse ab.
Die ehrliche Trennlinie zwischen den beiden Tools: OCR.space ist Infrastruktur für Entwickler; ImageToTable.ai ist ein fertiges Produkt für Geschäftsanwender. Wenn Sie Code schreiben müssen, um etwas Nützliches mit der Ausgabe zu tun, ist OCR.space möglicherweise die richtige Grundlage. Wenn Sie am Ende des Prozesses eine Tabelle brauchen und keinen Code schreiben möchten, ist es das nicht.
Häufig gestellte Fragen
Kann OCR.space Daten direkt nach Excel exportieren?
Nein. OCR.space liefert Rohtext oder JSON mit extrahierten Zeichen zurück – es erzeugt keine Excel-Dateien. Um diese Ausgabe in eine strukturierte Tabelle umzuwandeln, müssen Sie benutzerdefinierten Parsing-Code schreiben, um Zeilen zu identifizieren, Felder zu beschriften und die .xlsx-Datei zu erstellen. ImageToTable.ai erzeugt direkt eine downloadbereite Excel-Datei mit den von Ihnen angegebenen Spaltennamen als Kopfzeilen.
Extrahiert der Parameter isTable=true von OCR.space strukturierte Tabellendaten?
Nicht im Sinne einer Tabelle. Das Flag isTable=true (und der Layout-Modus von Engine 3) gibt Text mit erhaltenen Abständen aus, um das ursprüngliche Tabellenlayout visuell anzunähern. Das Ergebnis ist immer noch eine Textzeichenfolge – kein 2D-Array aus Zeilen und Spalten, kein JSON mit Feldnamen und keine Excel-Datei. Wie Koncile.ai in seiner Bewertung anmerkt: „Sie erhalten formatierten Text, aber nicht direkt eine Tabelle, die in Form einer Tabellenkalkulation verwendet werden kann.“
Ich bin kein Entwickler – kann ich OCR.space zur Verarbeitung meiner Rechnungen verwenden?
OCR.space hat eine Weboberfläche unter ocr.space, wo Sie ein Bild hochladen und Text zurückerhalten können. Aber von diesem Text zu einer brauchbaren Tabelle zu gelangen, erfordert manuelles Kopieren, Einfügen und Formatieren – es gibt keine automatische Feldextraktion oder Excel-Export. Wenn Sie mehr als eine Handvoll Dokumente verarbeiten, ist ImageToTable.ai die praktischere Wahl: Laden Sie Ihre Dateien hoch, geben Sie die gewünschten Spaltennamen ein (z. B. „Lieferant, Rechnungsnummer, Gesamtbetrag“) und laden Sie direkt eine zusammengeführte Excel-Datei herunter.
Welche Limits gelten für den kostenlosen Tarif von OCR.space?
Der kostenlose Tarif bietet 25.000 API-Anfragen pro Monat ohne Registrierung – der Demo-Schlüssel „helloworld“ funktioniert sofort. Die Dateigröße ist per API auf 1 MB begrenzt (5 MB über die Weboberfläche), und PDFs sind auf 3 Seiten begrenzt. Die Verarbeitungsgeschwindigkeit ist langsamer als bei kostenpflichtigen Tarifen, und es gibt keine SLA. Ausgaben des kostenlosen Tarifs enthalten ein „OCR.space“-Wasserzeichen auf generierten durchsuchbaren PDFs. Der kostenlose Tarif eignet sich für Prototyping und Tests mit geringem Volumen; die Dokumentation von OCR.space rät davon ab, den Demo-Schlüssel in der Produktion zu verwenden.
Können ImageToTable.ai und OCR.space zusammen verwendet werden?
Technisch ja, aber es gibt keinen praktischen Grund, sie für die Datenextraktion aus Dokumenten zu kombinieren. ImageToTable.ai nutzt eine eigene Vision-LLM-Pipeline, die direkt strukturierte Ausgaben erzeugt – es ist nicht auf eine separate OCR-Ebene angewiesen. Wenn Sie als Entwickler eine benutzerdefinierte Pipeline aufbauen und OCR.space für die Textextraktion verwenden und die Ausgabe dann in eine separate Feldparsing-Ebene einspeisen möchten, ist das eine gültige Architektur – aber es ist ein mehrstufiges Engineering-Projekt und keine sofort einsatzbereite Lösung.
ImageToTable.ai kostenlos testen
Laden Sie Ihre Rechnungen, Belege oder Formulare hoch und laden Sie eine strukturierte Excel-Tabelle mit Ihren Spaltennamen herunter – kein Konto erforderlich, kein Parsing-Code nötig. Wenn Sie zuerst den installationsfreien Browser-Workflow testen möchten, starten Sie mit dem Online-OCR-Tool.
Keine Kreditkarte erforderlich. Kostenlose Credits sind bei der Anmeldung enthalten.