ImageToTable.ai vs OCR.space:
구조화된 데이터 추출 vs 원시 텍스트 출력
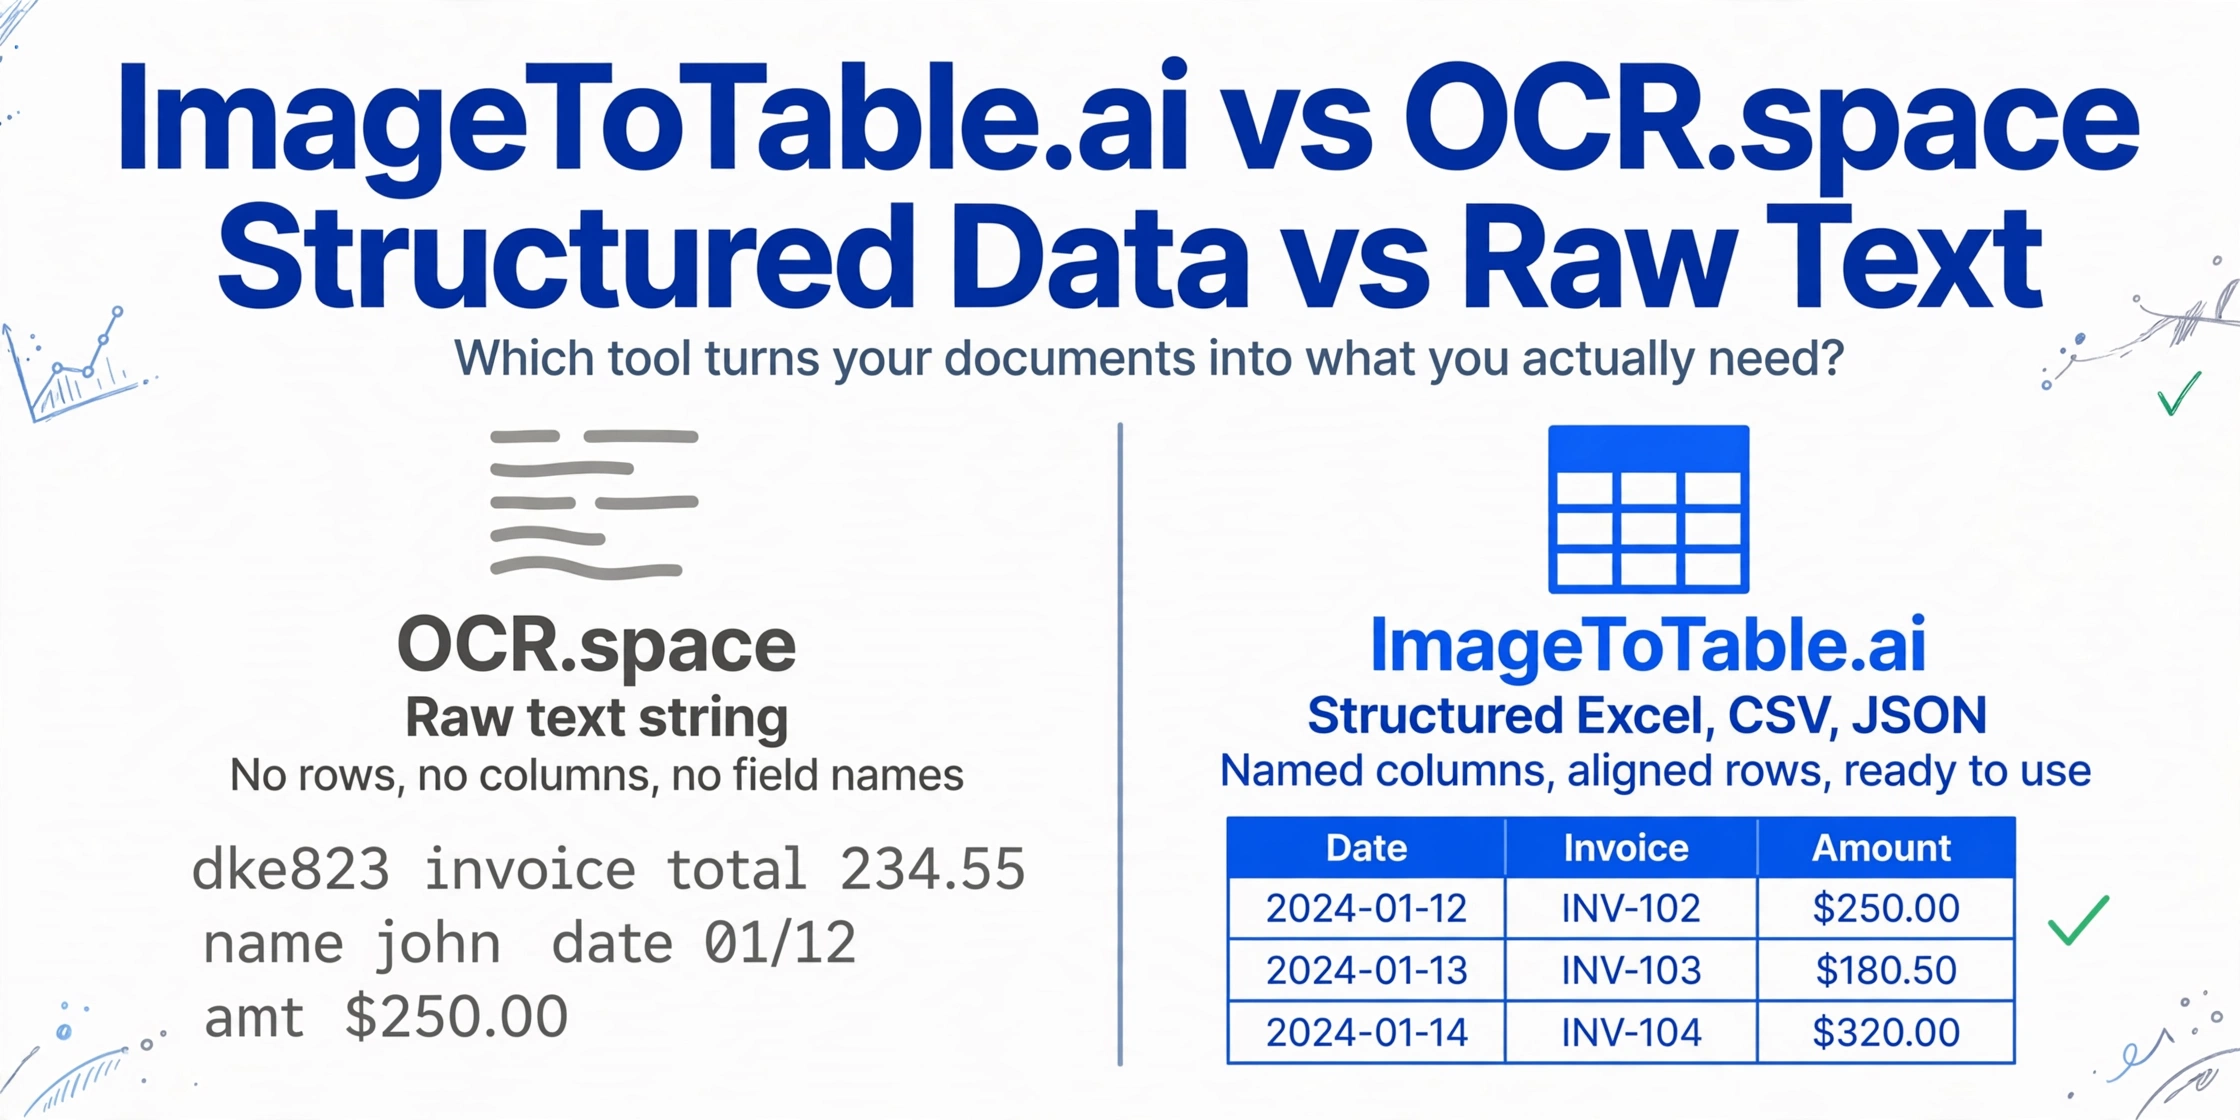
OCR.space와 ImageToTable.ai는 동일한 입력 — 이미지와 PDF — 을 받아들입니다. 하지만 반환하는 결과는 근본적으로 다릅니다. OCR.space는 문서에서 찾은 텍스트를 제공합니다. ImageToTable.ai는 사용자가 정의한 열 이름이 포함된 스프레드시트 형태로 요청한 데이터를 제공합니다. "추출된 텍스트"와 "사용 가능한 데이터" 사이의 이 차이가 바로 이 비교의 핵심입니다.
빠른 비교
ImageToTable.ai를 선택해야 하는 경우…
- 문서의 데이터를 스프레드시트로 — 라벨링되고 정렬되어 바로 사용할 수 있는 형태로 필요할 때
- 개발자가 아니어서 OCR 출력을 해석하는 파싱 코드를 작성할 수 없을 때
- 문서의 레이아웃이 공급업체나 출처에 따라 다양한 경우
- 특정 열 이름을 정의하고 해당 필드만 추출하려는 경우
- 여러 문서를 하나의 테이블로 병합하는 일괄 처리가 필요할 때
OCR.space를 선택해야 하는 경우…
- 앱을 개발 중이고 무료 대용량 OCR API가 필요한 개발자라면
- 이미지에서 원시 텍스트만 필요하고 구조는 직접 처리할 경우
- 문서 파이프라인을 프로토타이핑 중이고 월 25,000회 무료 API 호출이 필요할 때
- 사용 사례가 필드 추출이 아닌 텍스트 디지털화일 때
- 최소한의 설정으로 200개 이상의 언어에서 OCR이 필요할 때
기능 비교
| 기능 | OCR.space | ImageToTable.ai |
|---|---|---|
| 출력 형식 | JSON의 원시 텍스트 문자열 또는 공백 정렬 텍스트; 구조화된 행/열 없음 | Excel(XLSX), CSV, 명명된 열이 있는 JSON; 레이아웃이 유지된 Word |
| 테이블 추출 | isTable=true 플래그는 레이아웃을 근사하는 공백 정렬 텍스트를 생성 — 실제 행/열 데이터 구조가 아님 | Vision LLM이 문서 의미에서 테이블 구조를 식별; 정렬된 행과 명명된 열을 출력 |
| 맞춤 필드 추출 | 지원되지 않음 — OCR.space에는 명명된 필드 개념이 없음; 모든 텍스트가 구분 없이 반환됨 | 핵심 기능 — 원하는 열 이름을 입력하면 Excel 헤더가 됩니다 |
| 일괄 처리 | API는 일괄 호출을 지원; 출력은 파일별로 분리된 텍스트 블록이며 파일 간 병합 없음 | 일괄 처리의 모든 파일이 자동으로 하나의 정렬된 스프레드시트로 병합됩니다 |
| 주요 사용자 | 앱 또는 자동화 스크립트를 구축하는 개발자 | 문서의 데이터를 스프레드시트로 필요로 하는 비즈니스 사용자 |
| 필요한 설정 | API 키(무료 티어는 등록 불필요); 몇 가지 매개변수가 있는 REST 호출 | 파일 업로드, 열 이름 입력, 다운로드 — 게스트 모드는 계정 불필요 |
| 언어 지원 | 자동 감지로 200개 이상의 언어 | 기본 Vision LLM이 지원하는 모든 언어 |
| 필기 지원 | 제한적 — 필기 또는 장식된 텍스트에서 정확도가 크게 저하됨 | 필기, 필기체, 체크박스, 도장 처리 |
| 무료 티어 | 월 25,000회 API 요청, 등록 불필요 | 무료 게스트 모드; 등록 계정에는 일일 무료 할당량 |
| 가격 | 무료(월 25,000회 요청); PRO 월 $30(300,000회 요청); PRO PDF 월 $60(대용량 PDF) | 무료 게스트 티어; 유료는 월 $9부터; 종량제는 50페이지당 $6부터 |
OCR.space가 실제로 반환하는 결과
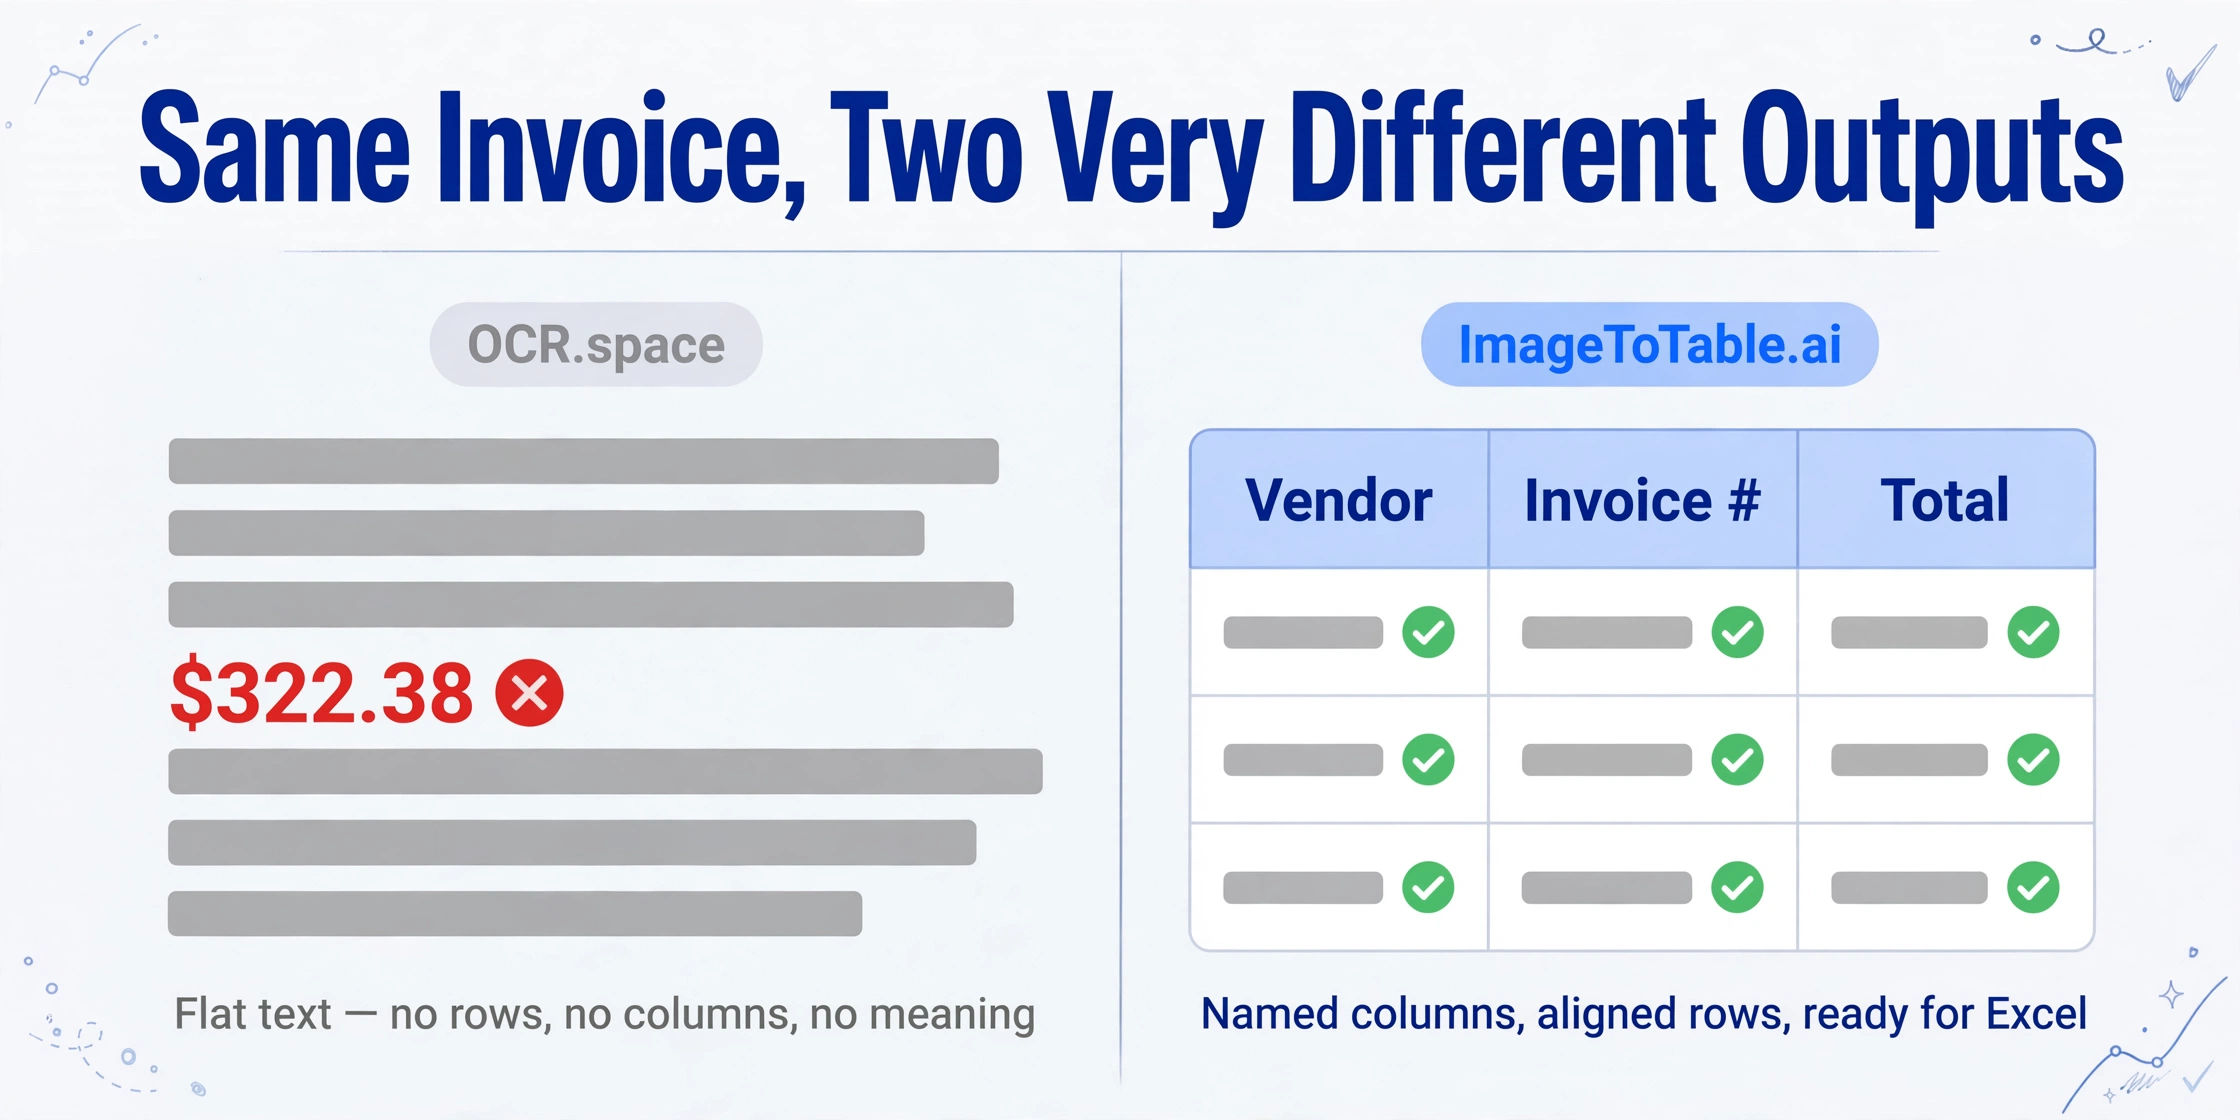
OCR.space는 한 가지 질문에 정확히 답합니다: 이 이미지에 어떤 텍스트가 있는가? 인보이스 사진을 넣으면 원본 레이아웃과 대략 일치하도록 정렬된 문자를 반환합니다. 스캔한 인보이스에 대한 일반적인 API 응답은 다음과 같습니다:
INVOICE
Vendor: Acme Supplies Ltd        Invoice #: INV-2024-0892
Date: March 15, 2024             Due Date: April 14, 2024

Description              Qty    Unit Price    Total
Office paper (500 sheets)  10     $12.50      $125.00
Printer cartridges          4     $34.00      $136.00
Desk organizers             2     $18.75       $37.50

                                  Subtotal:   $298.50
                                  Tax (8%):    $23.88
                                  TOTAL:      $322.38
언뜻 보기에는 사용할 수 있을 것 같습니다. 문제는 스프레드시트에 넣으려는 순간 나타납니다. 텍스트는 평면 문자열입니다. 행도, 열도, 필드 이름도, 데이터 유형도 없습니다. $322.38이라는 숫자는 문자열의 다른 숫자와 구별할 수 없습니다. "TOTAL"이라는 레이블도 그저 단어일 뿐입니다. OCR.space는 $322.38이 인보이스 합계이고, INV-2024-0892이 인보이스 번호이며, Acme Supplies Ltd가 공급업체 이름이라는 것을 전혀 알지 못합니다. 이는 Excel의 기본 제공 데이터에서 그림 가져오기 기능이 부딪히는 것과 동일한 구조적 한계입니다. 저희의 Excel 데이터에서 그림 가져오기 비교는 그리드 복사 도구를 구체적으로 다룹니다.
Koncile.ai의 실사용 리뷰가 직접적으로 말하듯이: "테이블 인식이 100% 구조화된 추출(필드별)을 대체하지는 않습니다. 형식화된 텍스트는 얻을 수 있지만, 스프레드시트 형태로 바로 사용할 수 있는 테이블은 얻을 수 없습니다."
동일한 문서에 대한 ImageToTable.ai의 출력은 정도의 차이가 아니라 종류가 다릅니다. 열 이름으로 "공급업체, 인보이스 번호, 합계, 납기일"을 입력합니다. 도구는 이 네 개의 열이 있는 스프레드시트를 반환하며, 각 열에는 배치의 모든 문서에서 올바른 값이 채워집니다. 서로 다른 공급업체의 서로 다른 레이아웃을 가진 문서도 포함됩니다.
OCR 텍스트에서 사용 가능한 Excel까지의 네 가지 단계
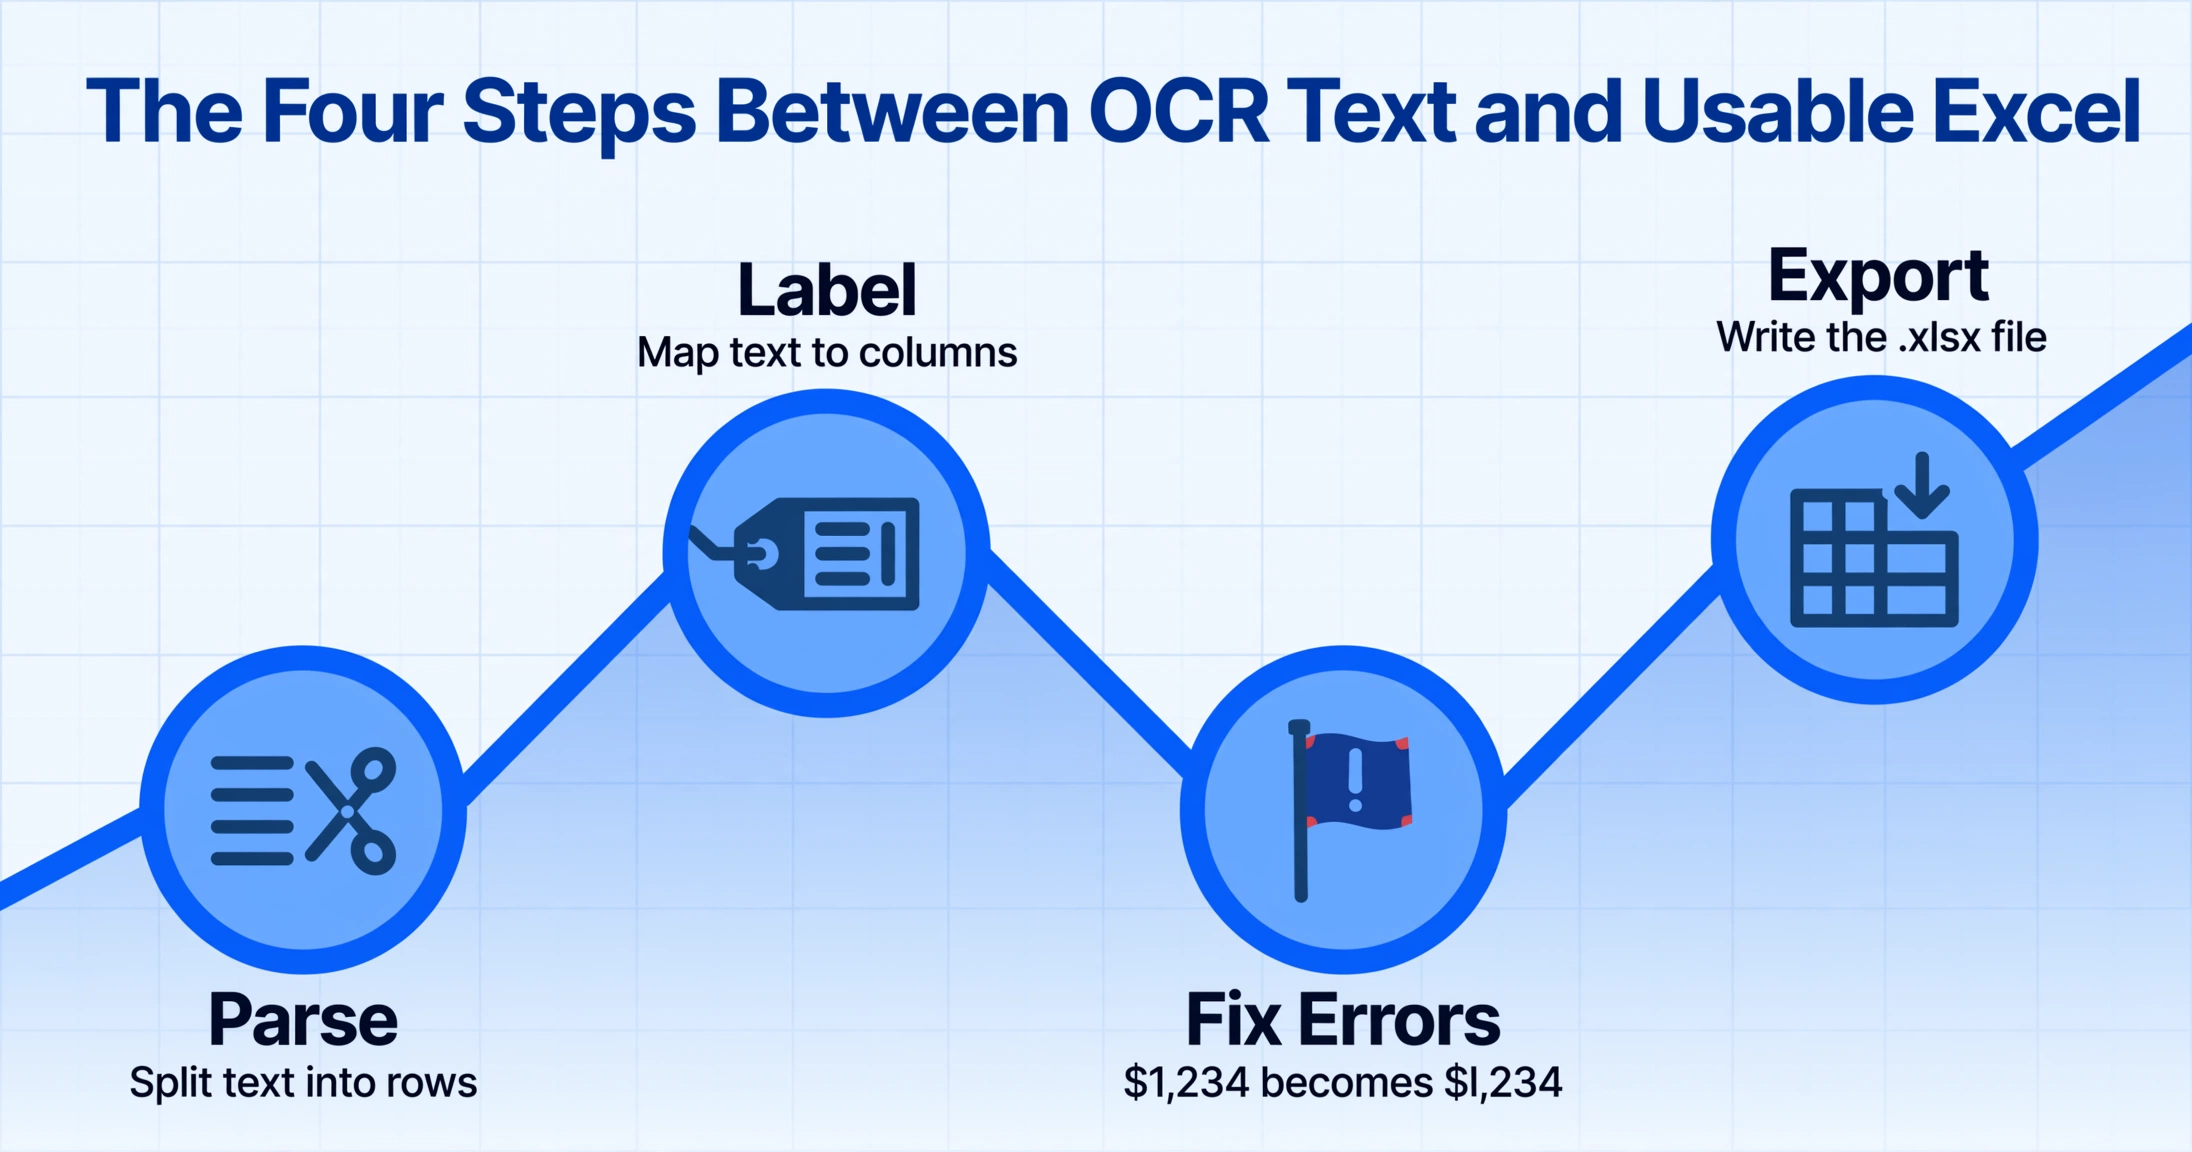
OCR.space 출력에서 사용 가능한 스프레드시트로 가려면 도구가 전혀 지원하지 않는 엔지니어링 작업이 필요합니다. 개발자에게는 며칠간의 구현 작업이 필요하며, 비개발자에게는 추가 도구 없이는 사실상 불가능합니다.
Parseur의 OCR과 문서 처리 비교 분석에서 지적하듯이: "OCR은 페이지의 텍스트를 읽는 것이고, 문서 처리는 그 텍스트를 이해하고 분류한 다음 자동으로 유용한 작업을 수행하는 것입니다." OCR.space는 전자를 처리합니다. 그 이후의 모든 단계는 사용자의 몫입니다.
"그 이후의 모든 것"에는 실제로 다음 작업이 포함됩니다:
- 1단계 — 텍스트를 행으로 구문 분석합니다. 정규식 또는 문자열 분할 논리를 작성하여 한 항목이 끝나고 다른 항목이 시작되는 위치를 식별합니다. 형식이 일관된 인보이스의 경우 지루하지만 가능합니다. 여러 공급업체의 다양한 레이아웃 문서의 경우 형식별로 별도의 규칙 엔진이 필요합니다.
- 2단계 — 필드를 식별하고 레이블을 지정합니다. 텍스트 위치를 열 머리글에 매핑하는 코드를 작성합니다. 즉, "TOTAL:" 뒤의 숫자가 항목 가격이 아니라 인보이스 합계임을 도구가 알 수 있게 합니다. 이 논리는 새 문서 레이아웃마다 다시 작성해야 합니다.
- 3단계 — OCR 오류를 처리합니다. 문자 정확도가 99%라도 500자 문서에는 약 5개의 손상된 문자가 포함됩니다.
$1,234와 같은 금액이$l,234또는$1.234로 변환되어 숫자 구문 분석이 중단될 수 있습니다. 검증 및 오류 수정 논리는 별도로 구현해야 합니다. - 4단계 — Excel 파일을 작성합니다. 라이브러리(openpyxl, xlsxwriter, xlsx.js)를 사용하여 올바른 머리글, 열 너비 및 데이터 유형으로 실제 .xlsx 파일을 생성합니다.
OCR 출력과 Excel을 연결하기 위해 특별히 구축된 ocrtoexcel.com 및 ocrdataextraction.com과 같은 보조 도구 전체가 존재한다는 사실 자체가 이러한 격차를 입증합니다. OCR.space가 제공하지 않는 변환 계층에 대한 시장이 존재합니다.
Klippa의 10가지 OCR API 비교에서 OCR.space는 10개 중 9위를 기록했습니다. 주요 지적 사항은 구조화된 데이터 출력이 부족하다는 것이었습니다. 이 순위는 "추출된 텍스트"와 "사용 가능한 데이터" 사이의 격차를 반영합니다.
OCR.space가 적합한 경우
OCR.space는 설계된 용도에 있어 정말 뛰어나며, 그 용도가 실제 필요와 일치하는 경우를 구체적으로 짚어볼 가치가 있습니다.
무료로 진행하는 개발자 프로토타이핑. 등록 없이 월 25,000회의 API 요청이 가능한 것은 이례적으로 후한 무료 티어입니다. 이미지에서 텍스트를 추출해야 하는 앱을 만들고 있고, 유료 서비스에 투자하기 전에 접근 방식을 검증하고 싶다면 OCR.space가 가장 빠른 시작 방법입니다. 계정도, 신용카드도, 할당량 승인도 필요 없습니다.
필드 추출이 아닌 텍스트 디지털화. 목표가 스캔 문서를 검색 가능하게 만드는 것 — PDF 아카이브를 검색 엔진용 인덱싱 가능한 텍스트로 변환하는 것 — 이라면 OCR.space가 이 작업을 잘 수행합니다. 출력이 구조화될 필요는 없습니다. 단어만 있으면 됩니다.
맞춤 파이프라인에 OCR 통합. 필드 추출, 검증, 데이터베이스 작성을 직접 처리할 문서 처리 파이프라인을 구축하는 개발자라면, OCR.space는 문자 인식 레이어를 안정적이고 저렴하게 제공합니다. Engine 1(속도), Engine 2(숫자 정확도), Engine 3(레이아웃 보존)을 통해 트레이드오프를 의미 있게 제어할 수 있습니다.
대용량·저비용 텍스트 추출. PRO 플랜에서 월 $30에 300,000회 요청이 가능한 OCR.space는 원시 텍스트 추출 분야에서 시장에서 가장 낮은 요청당 비용 중 하나를 제공합니다. 구조보다 볼륨이 더 중요하다면 그 가격에 견줄 만한 서비스는 없습니다. 더 많은 볼륨이 필요한 AWS 스택 내부에서는 AWS Textract가 그 역할을 대신합니다 — 자세한 트레이드오프는 AWS Textract 비교에서 확인하세요.
두 도구 사이의 솔직한 경계선: OCR.space는 개발자를 위한 인프라이고, ImageToTable.ai는 비즈니스 사용자를 위한 완성된 제품입니다. 출력물로 유용한 작업을 하려면 코드를 작성해야 한다면 OCR.space가 올바른 기반이 될 수 있습니다. 프로세스 끝에 스프레드시트가 필요하고 코드를 작성하고 싶지 않다면, OCR.space는 적합하지 않습니다.
자주 묻는 질문
OCR.space에서 데이터를 Excel로 직접 내보낼 수 있나요?
아니요. OCR.space는 추출된 문자를 포함한 원시 텍스트 또는 JSON만 반환하며, Excel 파일을 생성하지 않습니다. 해당 출력을 구조화된 스프레드시트로 변환하려면 행을 식별하고 필드에 레이블을 지정하며 .xlsx 파일을 만드는 맞춤 파싱 코드를 작성해야 합니다. ImageToTable.ai는 지정한 열 이름을 헤더로 사용하여 다운로드 가능한 Excel 파일을 바로 생성합니다.
OCR.space의 isTable=true 매개변수는 구조화된 테이블 데이터를 추출하나요?
스프레드시트 의미에서는 그렇지 않습니다. isTable=true 플래그(및 Engine 3의 레이아웃 모드)는 원본 테이블 레이아웃을 시각적으로 근사하도록 간격을 유지한 텍스트를 출력합니다. 결과는 여전히 텍스트 문자열입니다. 행과 열의 2D 배열도, 필드 이름이 있는 JSON도, Excel 파일도 아닙니다. Koncile.ai의 리뷰에서 지적했듯이, "서식이 지정된 텍스트를 얻을 수 있지만 스프레드시트 형태로 사용할 수 있는 테이블을 직접 얻을 수는 없습니다."
저는 개발자가 아닌데, OCR.space로 송장을 처리할 수 있나요?
OCR.space에는 ocr.space에서 이미지를 업로드하고 텍스트를 받을 수 있는 웹 인터페이스가 있습니다. 그러나 해당 텍스트에서 사용 가능한 스프레드시트를 얻으려면 수동 복사-붙여넣기와 서식 지정이 필요합니다. 자동 필드 추출이나 Excel 내보내기는 없습니다. 소수의 문서 이상을 처리하는 경우 ImageToTable.ai가 더 실용적인 선택입니다. 파일을 업로드하고 원하는 열 이름(예: "공급업체, 송장 번호, 합계")을 입력한 후 병합된 Excel 파일을 바로 다운로드하세요.
OCR.space 무료 티어의 한도는 어떻게 되나요?
무료 티어는 등록 없이 월 25,000회의 API 요청을 제공하며, "helloworld" 데모 키는 즉시 사용할 수 있습니다. 파일 크기는 API를 통해 1MB(웹 인터페이스는 5MB)로 제한되며, PDF는 3페이지로 제한됩니다. 처리 속도는 유료 티어보다 느리고 SLA가 없습니다. 무료 티어 출력에는 생성된 검색 가능한 PDF에 "OCR.space" 워터마크가 포함됩니다. 무료 티어는 프로토타이핑과 소규모 테스트에 적합합니다. OCR.space의 자체 문서에서는 프로덕션 환경에서 데모 키를 사용하지 말 것을 권장합니다.
ImageToTable.ai와 OCR.space를 함께 사용할 수 있나요?
기술적으로는 가능하지만, 문서 데이터 추출을 위해 두 도구를 결합할 실질적인 이유는 없습니다. ImageToTable.ai는 구조화된 출력을 직접 생성하는 자체 Vision LLM 파이프라인을 실행하며, 별도의 OCR 레이어에 의존하지 않습니다. 맞춤 파이프라인을 구축하는 개발자로서 OCR.space를 텍스트 추출에 사용한 다음 출력을 별도의 필드 파싱 레이어에 전달하려는 경우, 이는 유효한 아키텍처입니다. 그러나 바로 사용할 수 있는 솔루션이라기보다는 다단계 엔지니어링 프로젝트에 가깝습니다.
ImageToTable.ai 무료 체험
송장, 영수증 또는 양식을 업로드하고 열 이름이 포함된 구조화된 Excel 테이블을 다운로드하세요 — 계정이 필요 없고, 파싱 코드도 필요 없습니다. 설치 없는 브라우저 워크플로를 먼저 테스트하려면 온라인 OCR 도구로 시작하세요.
신용카드 필요 없음. 가입 시 무료 크레딧 제공.