Processe Ordens de Compra em Lote para Excel:
Uma Configuração, Todos os Formatos de Fornecedores
Um usuário do Reddit em r/smallbusiness descreveu sua rotina diária: baixar anexos de PO em PDF do e-mail, digitar manualmente o nome do fornecedor, número de PO, itens de linha, quantidades e preços no Excel — por fornecedor, por pedido. "O formato varia ligeiramente entre os clientes", escreveram. "Temos mais de 30 fornecedores." Isso não é um problema de ferramentas. É um problema de fragmentação de formatos — e a extração baseada em modelos torna isso peor, não melhor.
Esta página é o guia do fluxo de trabalho de lote para Excel. Se você está decidindo se a entrada automatizada de dados de PO vale a pena para sua equipe — e quanto custa realmente a alternativa manual — comece com nosso guia de automatização de entrada de dados de ordens de compra. Para a referência completa de extração campo por campo em dados de cabeçalho e itens de linha, consulte o guia completo de extração de dados de PO.
Por que ordens de compra são mais difíceis de processar em lote do que faturas
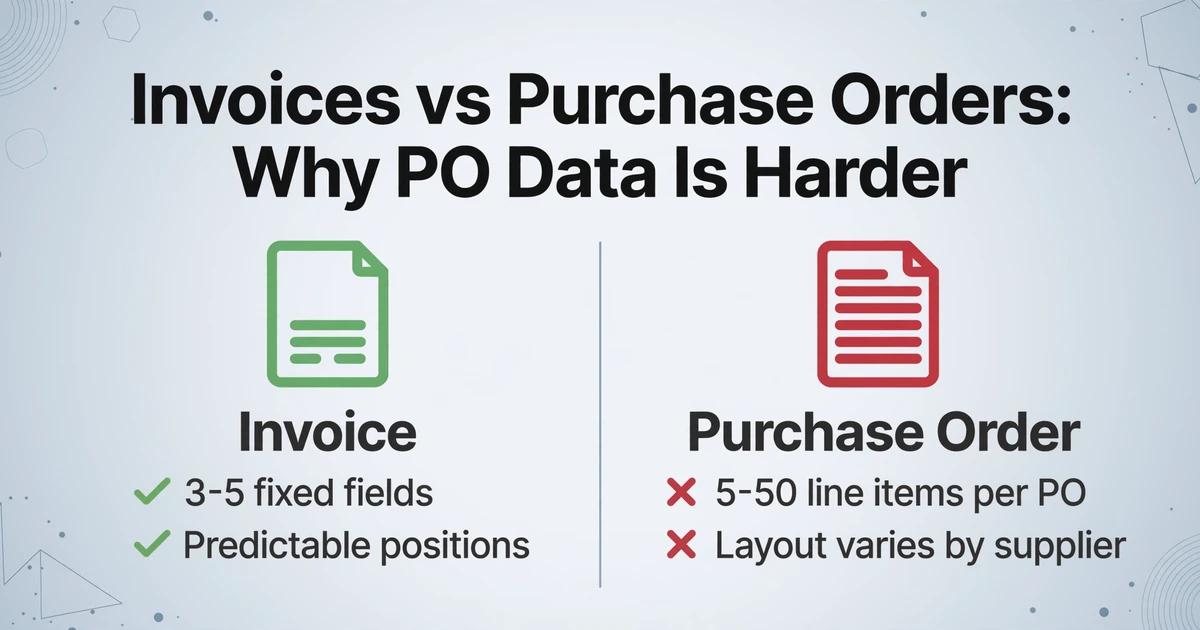
Faturas têm uma vida relativamente fácil. A maioria tem um formato consistente: informações do vendedor no topo, uma tabela de itens de linha no meio, totais na parte inferior. A extração de dados de ordens de compra é mais difícil por dois motivos que se combinam: os itens de linha são o principal conteúdo, e suas estruturas de tabela variam muito entre fornecedores.
Os dados centrais de uma fatura — número da fatura, data, total — geralmente são de três a cinco campos em posições previsíveis. Os dados centrais de uma ordem de compra são uma lista: 5, 15 ou 50 linhas de códigos de item, descrições, quantidades, preços unitários e totais de linha. Cada linha precisa ser extraída individualmente e associada ao cabeçalho correto da OC. Perca uma linha e você pediu menos do que precisava. Duplique uma e você contou duas vezes o gasto comprometido.
Agora multiplique isso pelo número de fornecedores que enviam OCs para você. Um fabricante ou distribuidor de médio porte pode receber OCs de 20 a 80 clientes diferentes, cada um com seu próprio layout. Um cliente coloca a tabela de itens na página 1. Outro a divide em seis páginas com cabeçalhos de coluna repetidos em cada página. Um terceiro coloca quantidades antes das descrições; um quarto as coloca depois. Nenhum deles está "errado" — eles apenas têm sistemas ERP diferentes gerando seus PDFs de OC — mas cada diferença de formato é uma decisão que sua ferramenta de extração precisa lidar.
Insight principal: 57% dos líderes de compras ainda dependem de entrada manual de dados para ordens de compra, de acordo com pesquisas independentes do setor. O gargalo não é a falta de vontade de automatizar — é que as ferramentas de automação disponíveis exigem que você resolva o problema de formato antes de resolver o problema de entrada de dados, e resolver o problema de formato para uma base diversificada de fornecedores é por si só um trabalho de tempo integral.
A Armadilha do Modelo: Por Que Um por Fornecedor Não Escala
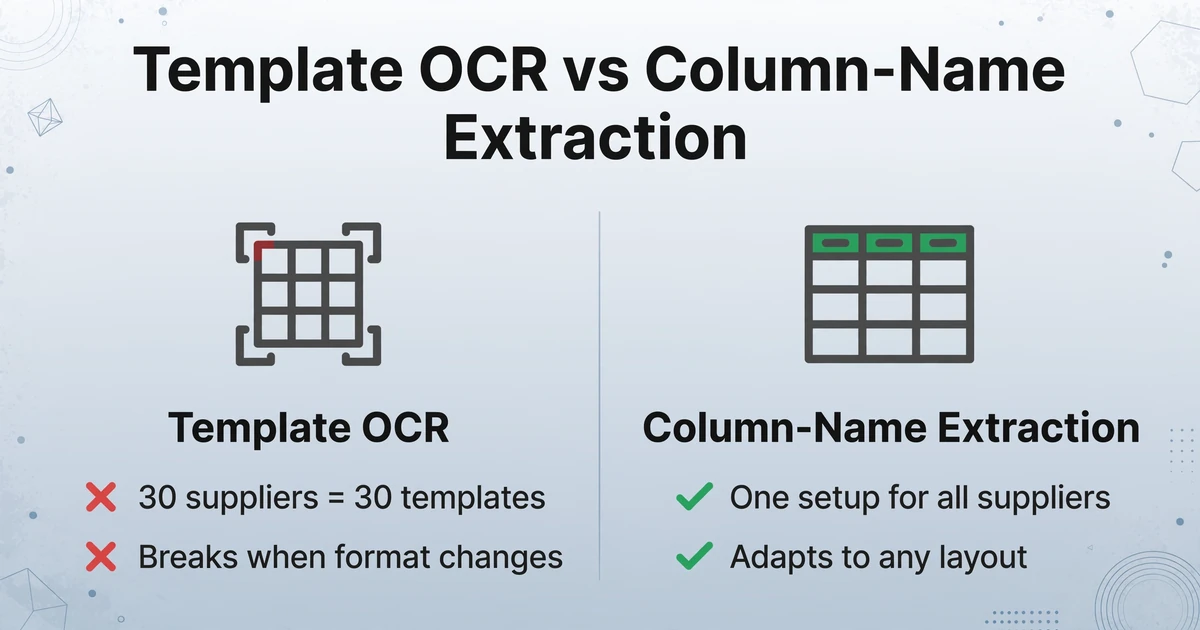
Ferramentas de extração de PO baseadas em modelo — e a maioria dos players estabelecidos neste espaço se enquadra nessa categoria — funcionam assim: você envia um PO de amostra do Fornecedor A, desenha caixas delimitadoras ao redor de cada campo, rotula-os e salva o modelo. Na próxima vez que o Fornecedor A enviar um PO com o mesmo layout, a ferramenta o reconhece e extrai os dados. Funciona bem — até o Fornecedor A atualizar o formato do PO. Então o modelo quebra e você volta à estaca zero.
O verdadeiro modo de falha é a multiplicação de modelos. Se você tem 30 fornecedores, precisa de 30 modelos. Cada novo fornecedor significa uma nova sessão de configuração de modelo — geralmente de 10 a 15 minutos desenhando caixas e rotulando campos. Quando o Fornecedor #31 entra, alguém precisa parar o que está fazendo, abrir a ferramenta de extração e criar o modelo #31. E se qualquer um dos seus 30 fornecedores existentes mudar o ERP ou o formato do PO (o que acontece: atualizações de sistema, novo software de compras, consolidação de formato impulsionada por fusões), você descobre quando a extração falha silenciosamente.
Esta é a armadilha do modelo: a ferramenta que deveria economizar seu tempo criou uma nova classe de trabalho de manutenção. Você substituiu "digitar dados de PO manualmente" por "manter modelos de PO manualmente". Para um usuário do Reddit em r/AI_Agents que descreveu sua rotina diária de "ler POs, OCs e cotações de PDFs de e-mail e inserir dados manualmente", essa troca não é uma solução — é um movimento lateral.
O problema não é que os modelos não funcionam. É que os modelos assumem estabilidade de formato, e a realidade da área de compras é diversidade de formatos. Cada modelo codifica um layout específico. Quando cada fornecedor tem um layout diferente, a quantidade de modelos escala linearmente com o número de fornecedores — e sua biblioteca de modelos se torna o gargalo que você tentava eliminar.
Como a Extração de Nomes de Colunas Lida com Qualquer Layout de PO
Aquí está uma abordagem diferente: em vez de dizer à ferramenta onde cada campo está na página, você diz o que cada campo significa. Isto é extraction de nomes de colunas — você define as colunas desejadas (por exemplo, "Número de PO", "Nome do Fornecedor", "Código do Item", "Quantidade", "Preço Unitário", "Total da Linha"), e a IA localiza cada valor entendendo seu papel semântico no documento, não suas coordenadas de pixels.
Os nomes de colunas que você insere se tornam os cabeçalhos da sua planilha de saída. Se você digita "Número de PO / Fornecedor / SKU / Qty / Preço Unitário / Total da Linha", essas são exatamente as colunas no seu Excel — em todos os fornecedores, todos os formatos. A IA não se importa se o Fornecedor A coloca o número de PO no canto superior direito e o Fornecedor B no canto superior esquerdo. Ele encontra o valor entendendo o que um número de PO é, não onde está.
Esta é a diferença entre OCR de modelo e IA de visão. O OCR de modelo corresponde a padrões por posição; a IA de visão lê documentos como uma pessoa — entendendo contexto e significado. Um motor de extração de nomes de colunas pode processar um PO de 15 páginas com 300 itens de linha em menos de um minuto. Saltos de página, cabeçalhos repetidos, subtotais intercalados — a IA trata o documento como um conjunto de dados contínuo, não como páginas PDF desconectadas que precisam ser remontadas.
Os arquivos são processados de forma segura e não são armazenados.
Fluxo de Trabalho de Processamento em Lote: De 50 PDFs para uma Única Planilha
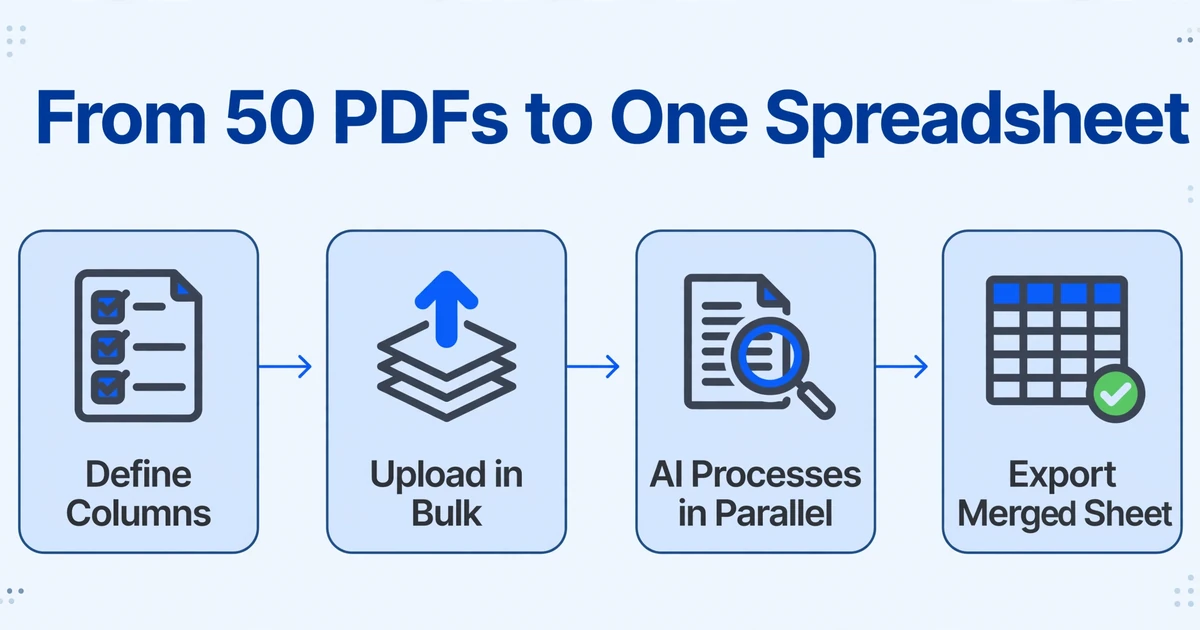
O fluxo de trabalho de PO em lote no ImageToTable.ai é projetado em torno de um princípio: a ferramenta se adapta aos seus documentos, não o contrário. Aqui está o processo de ponta a ponta para converter uma pilha de POs de fornecedores em uma única planilha pronta para análise.
Defina suas colunas de saída. Insira os nomes dos campos que deseja extrair — por exemplo: "Número do Pedido de Compra / Data de Emissão / Nome da Empresa Fornecedora / Código do Item / Descrição do Item / Quantidade Pedida / Preço Unitário / Total da Linha / Valor Total do Pedido." Estes se tornam os cabeçalhos das colunas da sua planilha. Você configura isso uma vez; a mesma lista de colunas funciona para todos os fornecedores.
Envie todos os seus arquivos de PO de uma vez. Arraste 20, 50 ou 100 PDFs de PO (ou JPGs, PNGs, capturas de tela) em um único lote. A ferramenta aceita POs em papel digitalizados, anexos de PDF por e-mail, saída gerada por ERP — qualquer formato que seus fornecedores enviarem.
A IA processa cada documento em paralelo. Cada PO é comparado com suas definições de coluna. A IA lê o documento contextualmente — extraindo o número do PO, o nome do fornecedor e cada linha de item, independentemente de onde aparecem na página.
Revise e exporte a planilha mesclada. Todos os dados extraídos aparecem em uma única tabela. Cada linha representa um item de linha de um PO, com os campos de cabeçalho do PO (número, data, fornecedor) incluídos em cada linha desse PO. Exporte como XLSX — formatado, classificado e pronto para importação em ERP ou análise de gastos.
O tempo de processamento aumenta com o número de documentos, não com a complexidade do formato. Um PO de uma página é processado em segundos. Um lote de 50 POs de uma página é concluído em poucos minutos. A IA não fica mais lenta ao encontrar um layout desconhecido — esse é o objetivo da extração semântica em vez da posicional.
Se sua equipe trabalha no Google Sheets em vez do Excel — ou você quer um painel ao vivo que continue atualizando conforme os lotes são concluídos — o mesmo fluxo de trabalho em lote pode alimentar os resultados diretamente em um painel baseado no Sheets. Veja nosso guia para processar pedidos de compra em lote em um painel do Google Sheets, ou vá direto para a ferramenta de pedido de compra para Google Sheets se você só quiser que os POs cheguem como linhas na sua planilha ativa.
Para um exemplo prático desse fluxo de trabalho na escala de 50-PO-por-mês com convenções de compras japonesas — classificação de imposto sobre consumo, condições de pagamento na data de liquidação e agrupamento por ano fiscal — consulte nosso guia para processamento em lote de ordens de compra japonesas em um painel de compras.
E quanto a POs de várias páginas com cabeçalhos de coluna repetidos? A IA reconhece isso como uma única tabela contínua. Um PO de 15 páginas com 300 itens de linha produz 300 linhas na sua saída, não 15 tabelas separadas que você precisa juntar manualmente.
Pule a Caça a Anexos de E-mail: Deixe os Fornecedores Enviarem Diretamente
Mesmo depois de resolver o problema de extração, há um problema logístico escondido: conseguir os arquivos de PO no sistema. Se o seu fluxo de trabalho atual é "verificar e-mail → baixar anexos PDF → salvar na pasta → enviar para a ferramenta de extração", a extração é automatizada, mas a coleta não é.
Link de Coleta é um recurso que preenche essa lacuna. Você gera uma URL exclusiva (por exemplo, /c/abc123) e a compartilha com seus fornecedores. Eles abrem o link, inserem um código de verificação curto e enviam seus arquivos de PO diretamente. Os arquivos chegam na sua fila de processamento — sem e-mail, sem download, sem pasta. O fornecedor não precisa de conta, não precisa fazer login, não precisa instalar nada.
Para equipes que gerenciam POs de dezenas de fornecedores, isso elimina a parte menos eficiente do processo: a etapa humana de coletar anexos de e-mail espalhados. Em vez de "verificar 30 e-mails de fornecedores → baixar 30 PDFs → organizar → enviar", o fluxo se torna "fornecedor envia → PO aparece na sua fila → processamento em lote → exportação".
Em Quais Formatos de PO Isso Funciona?
A extração de nomes de colunas funciona em qualquer formato de PO porque não depende do layout ou do método de geração:
- PDFs gerados por ERP — SAP, Oracle, NetSuite, Microsoft Dynamics, QuickBooks. Cada ERP gera POs de forma diferente; a IA não se importa.
- POs em papel escaneados — Para fornecedores que ainda enviam papel, uma foto de celular ou PDF de scanner funciona. A IA lê o texto independentemente da qualidade do scan (dentro do razoável — scans de resolução muito baixa reduzem a precisão).
- POs no corpo do e-mail — Alguns fornecedores menores enviam POs como texto simples no corpo do e-mail. Tire um print, envie, a mesma extração de nomes de colunas se aplica.
- POs em japonês — 発注書 de fornecedores japoneses seguem o mesmo padrão de diversidade de formatos, mas com convenções de campos japonesas (発注番号, 納期, 支払条件). Consulte nosso guia para extração de dados de ordens de compra japonesas para o esquema de colunas específico, classificação de imposto sobre consumo e convenções de condições de pagamento.
- Lotes mistos com múltiplos formatos — Um único lote pode incluir PDFs de ERP, scans e prints. A IA processa cada um de forma independente, mas os envia para a mesma planilha unificada.
Limite prático: Para melhores resultados, o documento deve ser razoavelmente legível — 150 DPI ou mais para scans. Fotos muito inclinadas ou documentos com padrões de fundo pesados podem produzir resultados parciais. A precisão da IA em itens de linha normalmente excede 90% para tabelas de PO impressas limpas, caindo para anotações manuscritas ou tabelas densas com texto pequeno.
Perguntas Frequentes
Consegue lidar com POs em que os itens abrangem várias páginas?
Sim. A IA trata POs de várias páginas como um único documento contínuo. Um PO de 15 páginas com 300 itens gera 300 linhas, com os campos de cabeçalho do PO (número, data, fornecedor) incluídos em cada linha. Cabeçalhos de coluna repetidos em cada página são reconhecidos como cabeçalhos e excluídos da saída — sem duplicatas, sem fragmentos.
E se os fornecedores usarem nomes diferentes para o mesmo campo — por exemplo, "Item No." vs. "SKU" vs. "Product Code"?
A IA mapeia termos semanticamente equivalentes. Se você especificar o nome da coluna "Item Code", ela localizará campos rotulados como "Item No.", "SKU", "Product Code" ou "Part Number" no documento e os mapeará para a sua coluna Item Code. Você não precisa listar todos os sinônimos — a IA entende que eles se referem ao mesmo conceito.
Preciso configurar algo por fornecedor?
Não. A lista de colunas que você define uma vez funciona para todos os fornecedores. Não há criação de modelos, configuração por fornecedor ou fase de treinamento. Digite suas colunas, envie seus arquivos, obtenha sua planilha. Essa é a diferença central entre extração por nome de coluna e ferramentas baseadas em modelo — veja nossa comparação de ferramentas de extração de PO se você está avaliando fornecedores baseados em modelo versus extração por nome de coluna para sua combinação de fornecedores.
O que acontece se um PO estiver sem um campo — por exemplo, alguns fornecedores não incluem condições de pagamento?
A célula desse campo fica em branco na saída para esse PO. A estrutura da sua planilha permanece consistente em todas as linhas; campos ausentes aparecem simplesmente como células vazias. Não há erro, correção manual necessária ou alerta de incompatibilidade de modelo.
Posso exportar diretamente para o formato do meu ERP?
Sim — se você configurar os nomes das suas colunas para corresponder ao formato de importação do seu ERP. Use os cabeçalhos de coluna exatos do seu ERP ao configurar a extração, e a saída XLSX estará pronta para importação direta. Formatos de data e número podem ser especificados nas suas instruções de extração para atender aos requisitos do seu ERP.
Qual é a precisão da extração de itens de linha em tabelas de PO densas?
Para tabelas de PO impressas e limpas, a precisão dos itens de linha normalmente excede 90%. As principais quedas de precisão vêm de: fontes muito pequenas (abaixo de 8pt), padrões de fundo pesados atrás da tabela, anotações manuscritas sobre campos impressos e digitalizações severamente inclinadas. A resposta do FAQ não é "99% sempre" — é "90%+ para POs impressos típicos, menos para casos extremos." Esse é um trade-off honesto que vale a pena: 90%+ automatizado com verificações manuais ocasionais vs. 100% manual com erros garantidos de fadiga.
Isso funciona também para confirmações de pedido (OC) e pedidos de venda?
Sim. A mesma abordagem de extração por nomes de colunas funciona para qualquer tipo de documento estruturado. Para confirmações de pedido, especifique colunas como "Número do Pedido / Data de Confirmação / Data de Entrega Confirmada / Quantidade Confirmada / Preço Unitário." Para pedidos de venda, especifique "Número do Pedido de Venda / Número do PO do Cliente / Endereço de Envio / Código do Produto / Quantidade Pedida." O mecanismo é o mesmo — você diz à IA o que quer, e ela encontra no documento.
Para processamento individual de PO, onde você precisa de campos de cabeçalho específicos e itens de linha selecionados em vez de extração em lote, veja como extrair apenas os campos que você precisa de pedidos de compra.
Para processamento em lote de pedidos de compra, nosso conversor dedicado lida com a extração em lote de POs de qualquer formato de fornecedor em uma única planilha consolidada.