発注書をバッチ処理してExcelへ:
単一セットアップで、あらゆるサプライヤーフォーマットに対応
r/smallbusinessのRedditユーザーが日々のルーティンをこう語っていました。メールからPOのPDF添付ファイルをダウンロードし、ベンダー名、PO番号、明細行、数量、価格を手作業でExcelに入力する——サプライヤーごとに、注文ごとに。「クライアントによってフォーマットが少しずつ違うんです」と彼らは書いていました。「サプライヤーは30社以上います」。これはツールの問題ではありません。フォーマットの断片化の問題です。そしてテンプレートベースの抽出は、それを悪化させるだけで改善にはなりません。
このページは、バッチ処理でExcelに変換するワークフローガイドです。自動化されたPOデータ入力が自チームにとって価値があるかどうか——そして手作業の代替手段に実際にどれだけのコストがかかるかを判断したい場合は、発注書データ入力の自動化ガイドから始めてください。ヘッダーと明細行データにわたるフィールド単位の完全な抽出リファレンスについては、POデータ抽出の完全ガイドをご覧ください。
発注書が請求書よりバッチ処理しにくい理由
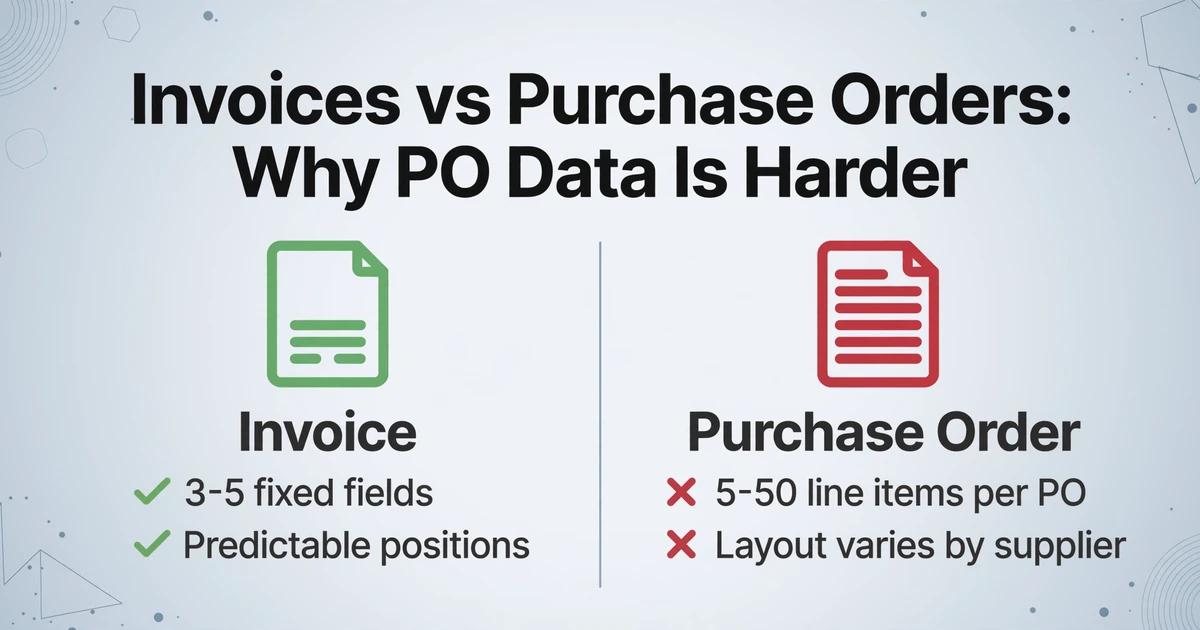
請求書は比較的簡単です。ほとんどの請求書は一貫した形をしています。上部に販売者情報、中央に明細行の表、下部に合計が配置されています。発注書のデータ抽出が難しいのは、互いに影響し合う2つの理由があります。明細行が主要なデータ本体であること、そしてその表の構造がサプライヤーによって大きく異なることです。
請求書の核となるデータポイント(請求書番号、日付、合計)は、通常3〜5個のフィールドで、予測可能な位置にあります。一方、発注書の核となるデータはリストです。品目コード、説明、数量、単価、明細合計の5行、15行、または50行です。各行を個別に抽出し、正しい発注書ヘッダーに照合する必要があります。1行でも見逃せば発注不足になります。1行重複すれば、確定支出を二重にカウントしてしまいます。
さらに、POを送ってくるサプライヤーの数を考えてみてください。中規模のメーカーや販売業者は、20〜80社の異なる顧客からPOを受け取る可能性があり、それぞれ独自のレイアウトを持っています。ある顧客は明細行の表を1ページ目に配置します。別の顧客は6ページに分割し、各ページで列ヘッダーを繰り返します。3番目の顧客は数量を説明の前に置き、4番目の顧客は後に置きます。どれも「間違い」ではありません。それぞれのERPシステムが生成するPO PDFが異なるだけです。しかし、フォーマットの違いはすべて、抽出ツールが処理しなければならない判断ポイントになります。
重要なポイント:独立した業界調査によると、調達リーダーの57%が今も発注書の手動データ入力を利用しています。ボトルネックは自動化への意欲の欠如ではなく、利用可能な自動化ツールが、データ入力の問題を解決する前にフォーマットの問題を解決することを要求し、多様なサプライヤーベースのフォーマット問題を解決すること自体がフルタイムの仕事であることです。
テンプレートの罠:サプライヤーごとの設定では拡張できない理由
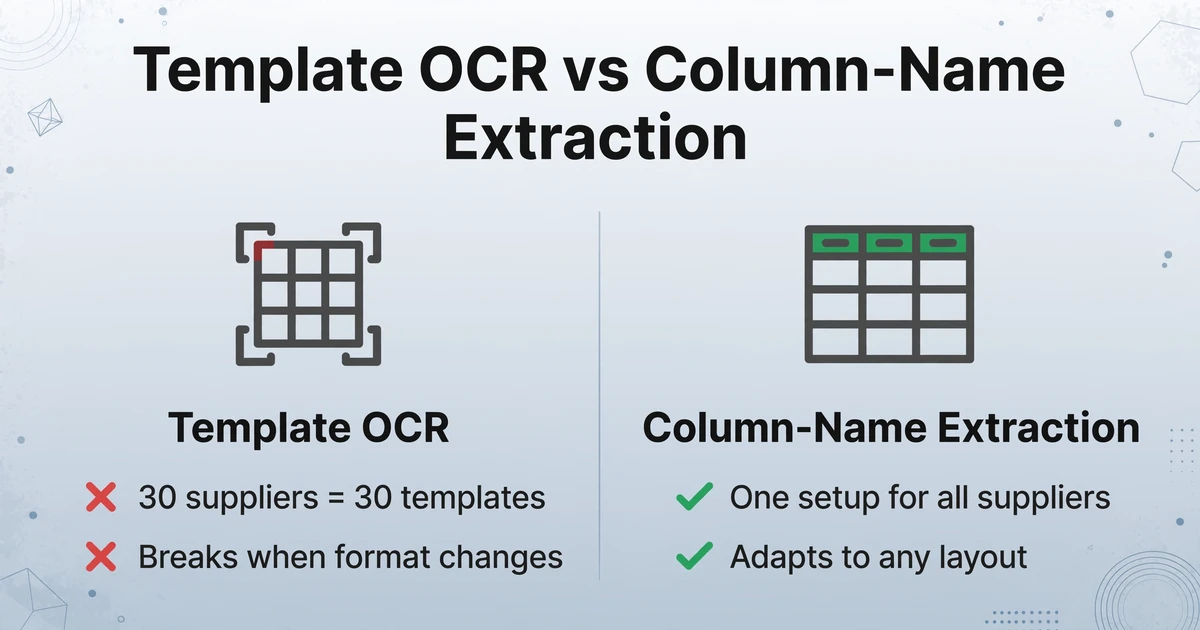
テンプレートベースの発注書抽出ツール(この分野の主要プレイヤーのほとんどが該当します)は、次のように動作します。サプライヤーAのサンプル発注書をアップロードし、各フィールドの周囲にバウンディングボックスを描き、ラベルを付けて、テンプレートを保存します。次回サプライヤーAが同じレイアウトの発注書を送ってきたら、ツールがそれを認識してデータを抽出します。うまく機能します——サプライヤーAが発注書のフォーマットを更新するまでは。そうなるとテンプレートは壊れ、振り出しに戻ってしまいます。
本当の問題はテンプレートの増殖です。サプライヤーが30社あれば、テンプレートも30個必要になります。新しいサプライヤーが増えるたびに、新しいテンプレートの設定作業——通常10〜15分のボックス描画とフィールドのラベル付け——が必要です。31社目が加わったら、誰かが手を止めて抽出ツールを開き、テンプレート31番を作らなければなりません。そして既存の30社のいずれかがERPや発注書フォーマットを変更した場合(システムアップグレード、新しい購買ソフトウェア、合併によるフォーマット統合などで実際に起こります)、抽出が静かに失敗して初めて気づくことになります。
これがテンプレートの罠です。時間を節約してくれるはずのツールが、新たな種類のメンテナンス作業を生み出しているのです。「発注書データの手入力」を「発注書テンプレートの手動メンテナンス」に置き換えただけです。r/AI_Agents のRedditユーザーが「メールのPDFから発注書、注文書、見積書を読んで手動でデータ入力する」という日々の作業を語っていましたが、このトレードオフは解決策ではなく、横滑りにすぎません。
問題はテンプレートが機能しないことではありません。テンプレートがフォーマットの安定性を前提としているのに、調達の現実はフォーマットの多様性だということです。各テンプレートは特定のレイアウトを固定化します。サプライヤーごとにレイアウトが異なる場合、テンプレートの数はサプライヤー数に比例して増えていき、テンプレートライブラリが、あなたが排除しようとしていたボトルネックになってしまうのです。
列名抽出が対応するあらゆる発注書レイアウト
ここでは別のアプローチをご紹介します。ツールに各フィールドがページのどこにあるかを指定する代わりに、各フィールドが何を意味するかを指定します。これが列名抽出です。抽出したい列(例:「PO番号」「サプライヤー名」「品目コード」「数量」「単価」「明細合計」)を定義すると、AIがピクセル座標ではなく文書内での意味的な役割を理解して各値を特定します。
入力した列名が、出力されるスプレッドシートのヘッダーになります。「PO番号 / サプライヤー / SKU / 数量 / 単価 / 明細合計」と入力すれば、それらがそのままExcelの列になります。サプライヤーやフォーマットが異なっても同じです。AIは、サプライヤーAがPO番号を右上に配置し、サプライヤーBが左上に配置しても気にしません。PO番号がどこにあるかではなく、PO番号が何であるかを理解して値を特定します。
これがテンプレートOCRとビジョンAIの違いです。テンプレートOCRは位置でパターンを照合しますが、ビジョンAIは人間と同じように文書を読み取ります。文脈と意味を理解するのです。列名抽出エンジンは、300明細行を含む15ページの発注書を1分以内で処理できます。ページ区切り、繰り返しのヘッダー、散在する小計などがあっても、AIは文書を1つの連続したデータセットとして扱います。バラバラのPDFページをつなぎ合わせる必要はありません。
ファイルは安全に処理され、保存されることはありません。
バッチ処理ワークフロー:50件のPDFから1つのスプレッドシートへ
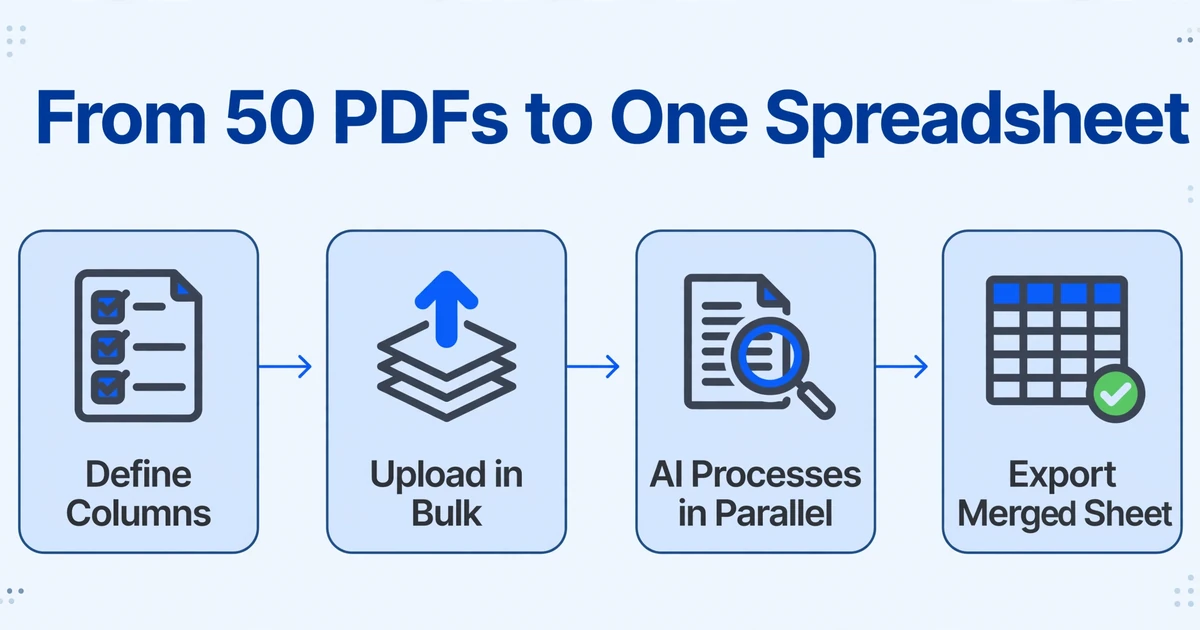
ImageToTable.aiのバッチ発注書ワークフローは、ひとつの原則に基づいて設計されています。それは、ツールがお客様のドキュメントに適応するということです。その逆ではありません。ここでは、サプライヤーからの発注書の束を、分析可能な単一のスプレッドシートに変換するエンドツーエンドのプロセスをご紹介します。
出力する列を定義します。抽出したいフィールド名を入力します。例:「発注書番号 / 発行日 / サプライヤー会社名 / 品目コード / 品目説明 / 注文数量 / 単価 / 明細合計 / 注文合計金額」。これらがスプレッドシートの列ヘッダーになります。設定は一度だけ。同じ列リストがすべてのサプライヤーに適用されます。
すべての発注書ファイルを一度にアップロードします。20件、50件、または100件の発注書PDF(またはJPG、PNG、スクリーンショット)を1つのバッチにドラッグ&ドロップします。このツールは、スキャンした紙の発注書、メール添付のPDF、ERP生成の出力など、サプライヤーから届くあらゆる形式に対応します。
AIが各ドキュメントを並行処理します。各発注書が列定義と照合されます。AIはドキュメントを文脈に沿って読み取り、ページ上のどこに表示されているかに関係なく、発注書番号、サプライヤー名、すべての明細行を抽出します。
マージされたスプレッドシートを確認してエクスポートします。抽出されたすべてのデータが1つのテーブルに表示されます。各行は1つの発注書の1つの明細行を表し、発注書のヘッダーフィールド(番号、日付、サプライヤー)がその発注書のすべての行に引き継がれます。XLSXとしてエクスポートすれば、フォーマット・並べ替え済みで、ERPインポートや支出分析にすぐに使えます。
処理時間は、フォーマットの複雑さではなく、ドキュメント数に応じてスケールします。単一ページの発注書は数秒で処理されます。50件の単一ページ発注書のバッチは数分で完了します。AIは、見慣れないレイアウトに遭遇しても速度が落ちることはありません。それが、位置ベースではなく意味ベースの抽出の要点です。
チームがExcelではなくGoogle Sheetsで作業している場合、またはバッチ完了に合わせて更新され続けるライブダッシュボードが必要な場合も、同じバッチワークフローで結果をSheetsベースのダッシュボードに直接送り込めます。発注書をGoogle Sheetsダッシュボードにバッチ処理するためのガイドをご覧ください。または、アクティブなシートに発注書を行として反映させたいだけなら、発注書をGoogle Sheetsに変換するツールへ直接お進みください。
このワークフローを月50件の発注書規模で、日本の調達慣行(消費税区分、決済日ベースの支払条件、会計年度でのグループ化)に沿って実際に運用する例については、日本の発注書をバッチ処理して調達ダッシュボードにまとめるガイドをご覧ください。
複数ページにわたる発注書で、列ヘッダーが繰り返し出現する場合はどうでしょうか?AIはこれらを1つの連続したテーブルとして認識します。15ページの発注書に300件の明細行があれば、出力には300行が生成されます。15個の別々のテーブルを手作業でつなぎ合わせる必要はありません。
メール添付探しをスキップ:サプライヤーに直接アップロードしてもらう
抽出の問題を解決した後も、その下に物流上の問題が潜んでいます:発注書ファイルをシステムに取り込むことです。現在のワークフローが「メールを確認 → PDF添付をダウンロード → フォルダに保存 → 抽出ツールにアップロード」という流れであれば、抽出は自動化されていても、収集は自動化されていません。
コレクションリンクは、このギャップを埋める機能です。あなたが固有のURL(例:/c/abc123)を生成し、それをサプライヤーと共有します。サプライヤーはリンクを開き、短い確認コードを入力し、発注書ファイルを直接アップロードします。ファイルはあなたの処理キューに届きます。メールも、ダウンロードも、フォルダも不要です。サプライヤーはアカウント登録も、ログインも、ソフトウェアのインストールも必要ありません。
多数のサプライヤーからの発注書を管理するチームにとって、これはプロセスの中で最も非効率な部分、つまり散在するメール添付ファイルを収集する中間工程を排除します。「30社のサプライヤーメールを確認 → 30件のPDFをダウンロード → 整理 → アップロード」という流れが、「サプライヤーがアップロード → 発注書がキューに表示 → バッチ処理 → エクスポート」という流れに変わります。
対応している発注書の形式は?
列名抽出は、レイアウトや生成方法に依存しないため、あらゆる発注書形式に対応します:
- ERP生成PDF — SAP、Oracle、NetSuite、Microsoft Dynamics、QuickBooks。各ERPは発注書を異なる形式で出力しますが、AIはそれを気にしません。
- スキャンした紙の発注書 — まだ紙で送ってくるサプライヤーの場合、スマホの写真やスキャナーPDFで対応できます。AIはスキャン品質に関係なくテキストを読み取ります(ただし、極端に低解像度のスキャンは精度が低下します)。
- メール本文の発注書 — 一部の小規模サプライヤーは、発注書をメール本文にプレーンテキストで送ってきます。スクリーンショットを撮ってアップロードすれば、同じ列名抽出が適用されます。
- 日本語の発注書 — 日本のサプライヤーからの発注書も同じ形式多様性のパターンに従いますが、日本のフィールド慣行(発注番号、納期、支払条件)に従います。具体的な列スキーマ、消費税区分、支払条件の慣行については、日本語の発注書データ抽出ガイドをご覧ください。
- 複数形式の混在バッチ — 1つのバッチにERPのPDF、スキャン、スクリーンショットを含めることができます。AIはそれぞれを個別に処理しますが、同じ統一されたスプレッドシートに出力します。
実用上の制限:最良の結果を得るには、ドキュメントが十分に読みやすい必要があります(スキャンの場合は150 DPI以上)。著しく傾いた写真や、背景パターンが濃いドキュメントでは、部分的な結果になる可能性があります。クリーンな印刷された発注書テーブルに対するAIの明細行の精度は通常90%を超えますが、手書きの注釈や密集した小さな文字のテーブルでは低下します。
よくある質問
明細行が複数ページにまたがる発注書も処理できますか?
はい。AIは複数ページにわたる発注書を1つの連続した文書として扱います。300明細行を含む15ページの発注書は300行として出力され、発注書のヘッダー項目(番号、日付、サプライヤー)はすべての行に引き継がれます。各ページで繰り返される列ヘッダーはヘッダーとして認識され、出力から除外されます。重複も断片も発生しません。
サプライヤーによって同じ項目に異なる名前を使う場合はどうすればいいですか?例:「Item No.」「SKU」「Product Code」など。
AIは意味的に同等な用語をマッピングします。列名に「Item Code」と指定すれば、文書内の「Item No.」「SKU」「Product Code」「Part Number」といったラベルのフィールドを特定し、指定したItem Code列にマッピングします。すべての同義語を列挙する必要はありません。AIがこれらが同じ概念を指していることを理解します。
サプライヤーごとに何か設定する必要がありますか?
いいえ。一度定義した列リストはすべてのサプライヤーで機能します。テンプレート作成も、サプライヤーごとの設定も、トレーニングフェーズも不要です。列を入力し、ファイルをアップロードし、スプレッドシートを取得するだけです。これが列名抽出とテンプレートベースのツールの本質的な違いです。テンプレートベースのベンダーと列名抽出をサプライヤー構成に合わせて比較検討している場合は、発注書抽出ツールの比較をご覧ください。
発注書に項目がない場合はどうなりますか?たとえば、一部のサプライヤーが支払条件を含めない場合など。
その発注書について、該当フィールドのセルは出力で空白のままになります。スプレッドシートの構造はすべての行で一貫しており、欠落したフィールドは単に空のセルとして表示されます。エラーも、手動修正も、テンプレート不一致の警告もありません。
ERP形式に直接エクスポートできますか?
はい。列名をERPのインポート形式に合わせて設定すれば可能です。抽出設定時にERPの正確な列ヘッダーを使用すると、XLSX出力は直接インポートできる状態になります。日付形式や数値形式は、抽出指示でERPの要件に合わせて指定できます。
高密度なPOテーブルにおける明細行抽出の精度はどのくらいですか?
きれいな印刷済みのPOテーブルであれば、明細行の精度は通常90%を超えます。精度が低下する主な要因は、非常に小さいフォント(8pt未満)、テーブル背後にある濃い背景パターン、印刷フィールドの上に手書きされた注釈、そして大きく傾いたスキャン画像です。このFAQの答えは「常に99%」ではなく、「一般的な印刷済みPOでは90%以上、エッジケースではそれ未満」です。これは検討に値する正直なトレードオフです。つまり、90%以上を自動化し、時折手動でスポットチェックするか、100%手動で疲労によるエラーが確実に発生するかの違いです。
注文確認書(OC)や販売注文にも対応していますか?
はい。同じ列名抽出アプローチが、あらゆる構造化文書タイプで機能します。注文確認書の場合は、「注文番号 / 確認日 / 納品確定日 / 確定数量 / 単価」などの列を指定します。販売注文の場合は、「販売注文番号 / 顧客PO番号 / 配送先住所 / 製品コード / 注文数量」を指定します。仕組みは同じです。AIに必要なものを伝えれば、文書内からそれを見つけ出します。
一括バッチ抽出ではなく、特定のヘッダーフィールドと選択した明細行が必要な個別PO処理については、発注書から必要なフィールドだけを抽出する方法をご覧ください。
発注書のバッチ処理については、専用コンバーターがあらゆるサプライヤー形式の一括PO抽出を処理し、1つの統合スプレッドシートにまとめます。