Procesa Órdenes de Compra por Lotes a Excel:
Una Configuración, Cada Formato de Proveedor
Un usuario de Reddit en r/smallbusiness describió su rutina diaria: descargar archivos PDF de PO adjuntos al correo, escribir manualmente el nombre del proveedor, número de PO, partidas, cantidades y precios en Excel — por proveedor, por pedido. "El formato varía ligeramente entre clientes", escribió. "Tenemos más de 30 proveedores". Eso no es un problema de herramientas. Es un problema de fragmentación de formatos — y la extracción basada en plantillas lo empeora, no lo mejora.
Esta página es la guía del flujo de trabajo por lotes a Excel. Si estás decidiendo si la captura automatizada de datos de PO vale la pena para tu equipo — y cuánto cuesta realmente la alternativa manual — comienza con nuestra guía de automatización de captura de datos de órdenes de compra. Para la referencia completa de extracción campo por campo en datos de cabecera y partidas, consulta la guía completa de extracción de datos de PO.
Por qué las órdenes de compra son más difíciles de procesar por lotes que las facturas
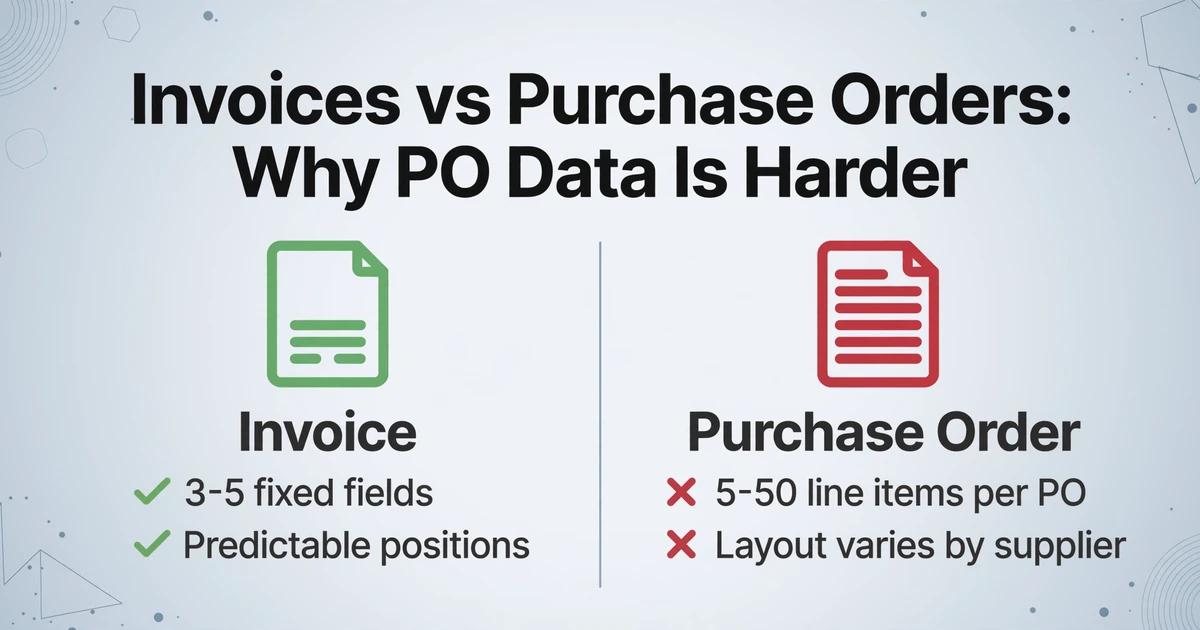
Las facturas lo tienen relativamente fácil. La mayoría tiene una forma consistente: información del vendedor arriba, una tabla de líneas en el medio, totales abajo. La extracción de datos de órdenes de compra es más difícil por dos razones que se combinan: las líneas son la carga principal y sus estructuras de tabla varían enormemente entre proveedores.
Los datos centrales de una factura — número de factura, fecha, total — suelen ser de tres a cinco campos en posiciones predecibles. Los datos centrales de una orden de compra son una lista: 5, 15 o 50 filas de códigos de artículo, descripciones, cantidades, precios unitarios y totales por línea. Cada fila debe extraerse individualmente y vincularse al encabezado correcto de la OC. Si omites una fila, has pedido de menos. Si duplicas una, has contado dos veces tu gasto comprometido.
Ahora multiplica eso por la cantidad de proveedores que te envían OC. Un fabricante o distribuidor mediano podría recibir OC de 20 a 80 clientes diferentes, cada uno con su propio diseño. Un cliente pone la tabla de líneas en la página 1. Otro la divide en seis páginas con encabezados de columna repetidos en cada página. Un tercero pone las cantidades antes de las descripciones; un cuarto las pone después. Ninguno está "mal" — solo tienen diferentes sistemas ERP que generan sus PDF de OC — pero cada diferencia de formato es una decisión que tu herramienta de extracción debe manejar.
Dato clave: el 57% de los líderes de adquisiciones todavía depende de la entrada manual de datos para las órdenes de compra, según encuestas independientes de la industria. El cuello de botella no es la falta de voluntad para automatizar — es que las herramientas de automatización disponibles exigen que resuelvas el problema del formato antes de poder resolver el problema de la entrada de datos, y resolver el problema del formato para una base diversa de proveedores es en sí mismo un trabajo de tiempo completo.
La trampa de las plantillas: por qué una por proveedor no escala
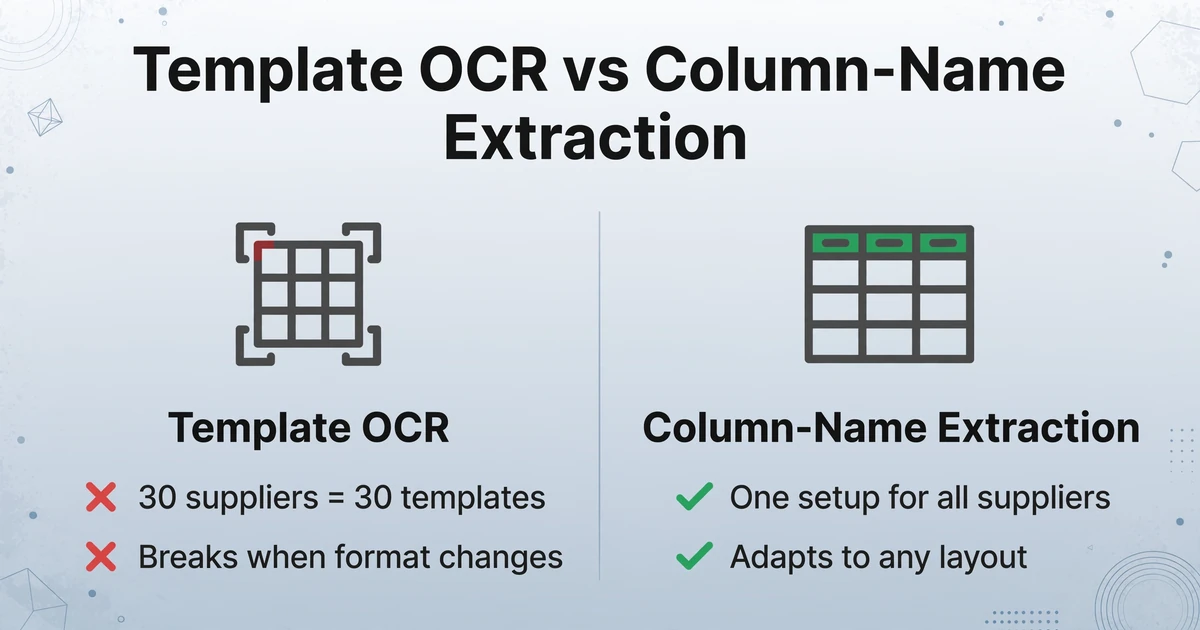
Las herramientas de extracción de PO basadas en plantillas — y la mayoría de los actores establecidos en este espacio entran en esta categoría — funcionan así: subes un PO de muestra del Proveedor A, dibujas cuadros delimitadores alrededor de cada campo, los etiquetas y guardas la plantilla. La próxima vez que el Proveedor A envíe un PO con el mismo diseño, la herramienta lo reconoce y extrae los datos. Funciona bien — hasta que el Proveedor A actualiza su formato de PO. Entonces la plantilla se rompe y vuelves a empezar de cero.
El verdadero modo de fallo es la multiplicación de plantillas. Si tienes 30 proveedores, necesitas 30 plantillas. Cada nuevo proveedor significa una nueva sesión de configuración de plantilla — normalmente de 10 a 15 minutos dibujando cuadros y etiquetando campos. Cuando llega el Proveedor #31, alguien tiene que dejar lo que está haciendo, abrir la herramienta de extracción y crear la plantilla #31. Y si cualquiera de tus 30 proveedores existentes cambia su ERP o formato de PO (lo cual ocurre: actualizaciones de sistemas, nuevo software de compras, consolidación de formatos por fusiones), te enteras cuando la extracción falla silenciosamente.
Esta es la trampa de las plantillas: la herramienta que se suponía que te ahorraría tiempo ha creado una nueva clase de trabajo de mantenimiento. Has reemplazado "ingresar datos de PO manualmente" por "mantener plantillas de PO manualmente". Para un usuario de Reddit en r/AI_Agents que describió su rutina diaria de "leer POs, OCs y cotizaciones de PDFs de correo e ingresar datos manualmente", este intercambio no es una solución — es un movimiento lateral.
El problema no es que las plantillas no funcionen. Es que las plantillas asumen estabilidad de formato, y la realidad de las compras es diversidad de formatos. Cada plantilla codifica un diseño específico. Cuando cada proveedor tiene un diseño diferente, la cantidad de plantillas escala linealmente con el número de proveedores — y tu biblioteca de plantillas se convierte en el cuello de botella que intentabas eliminar.
Cómo la Extracción de Nombres de Columnas Maneja Cada Diseño de PO
Aquí hay un enfoque diferente: en lugar de decirle a la herramienta dónde se encuentra cada campo en la página, le dices qué significa cada campo. Esto es la extracción de nombres de columnas — defines las columnas que deseas (por ejemplo, "Número de PO", "Nombre del Proveedor", "Código de Artículo", "Cantidad", "Precio Unitario", "Total de Línea"), y la IA localiza cada valor al comprender su rol semántico en el documento, no sus coordenadas de píxeles.
Los nombres de columnas que ingresas se convierten en los encabezados de tu hoja de cálculo de salida. Si escribes "Número de PO / Proveedor / SKU / Cantidad / Precio Unitario / Total de Línea", esas son las columnas exactas en tu Excel — en todos los proveedores, en todos los formatos. A la IA no le importa si el Proveedor A coloca el número de PO en la esquina superior derecha y el Proveedor B lo coloca en la esquina superior izquierda. Encuentra el valor al comprender qué es un número de PO, no dónde se encuentra.
Esta es la diferencia entre OCR con plantillas y la IA de visión. El OCR con plantillas coincide patrones por posición; la IA de visión lee documentos como lo haría una persona — comprendiendo contexto y significado. Un motor de extracción de nombres de columnas puede procesar un PO de 15 páginas con 300 líneas de artículos en menos de un minuto. Saltos de página, encabezados repetidos, subtotales intercalados — la IA trata el documento como un conjunto de datos continuo, no como páginas PDF desconectadas que deben unirse nuevamente.
Los archivos se procesan de forma segura y no se almacenan.
Flujo de trabajo de procesamiento por lotes: de 50 PDF a una sola hoja de cálculo
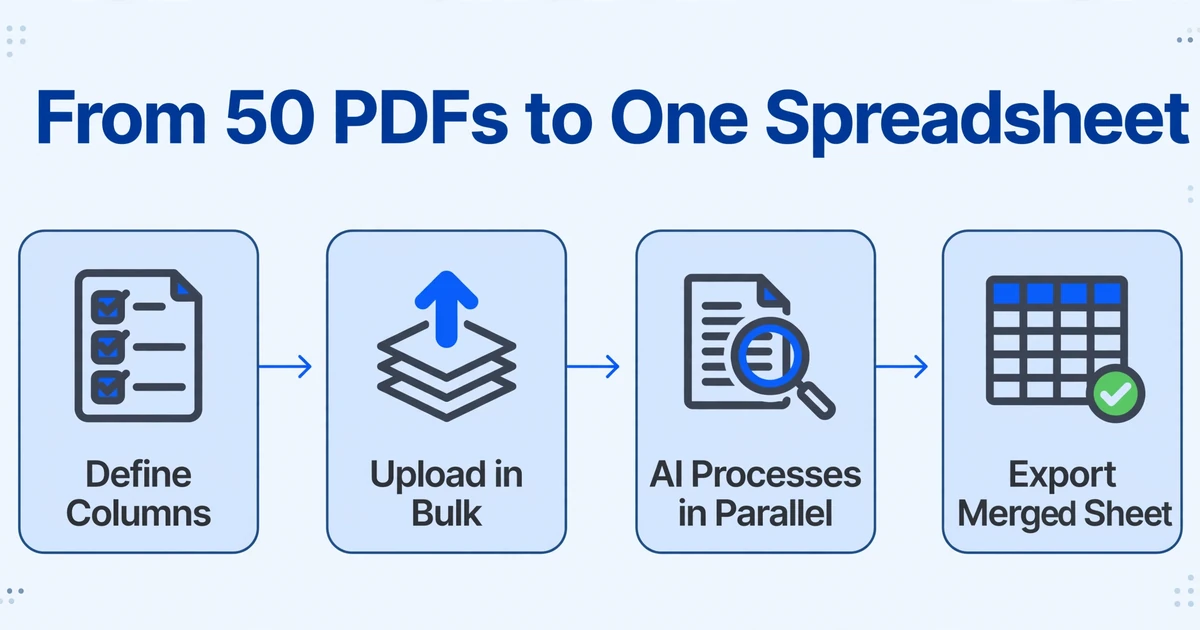
El flujo de trabajo de órdenes de compra por lotes en ImageToTable.ai está diseñado en torno a un principio: la herramienta se adapta a tus documentos, no al revés. Este es el proceso de principio a fin para convertir un montón de OC de proveedores en una sola hoja de cálculo lista para analizar.
Define las columnas de salida. Ingresa los nombres de los campos que deseas extraer, por ejemplo: "Número de orden de compra / Fecha de emisión / Nombre de la empresa proveedora / Código de artículo / Descripción del artículo / Cantidad pedida / Precio unitario / Total por línea / Monto total de la orden". Estos se convierten en los encabezados de columna de tu hoja de cálculo. Lo configuras una sola vez; la misma lista de columnas funciona para cada proveedor.
Sube todos tus archivos de OC a la vez. Arrastra 20, 50 o 100 PDF de OC (o JPG, PNG, capturas de pantalla) en un solo lote. La herramienta acepta OC en papel escaneadas, archivos PDF adjuntos por correo electrónico, resultados generados por ERP — cualquier formato que tus proveedores te envíen.
La IA procesa cada documento en paralelo. Cada OC se compara con tus definiciones de columnas. La IA lee el documento contextualmente — extrayendo el número de OC, el nombre del proveedor y cada fila de artículo, sin importar dónde aparezcan en la página.
Revisa y exporta la hoja de cálculo combinada. Todos los datos extraídos aparecen en una sola tabla. Cada fila representa un artículo de una OC, con los campos de encabezado de la OC (número, fecha, proveedor) incluidos en cada fila de esa OC. Exporta como XLSX — con formato, ordenado y listo para importar a ERP o para análisis de gastos.
El tiempo de procesamiento escala con la cantidad de documentos, no con la complejidad del formato. Una OC de una página se procesa en segundos. Un lote de 50 OC de una página se completa en unos minutos. La IA no se ralentiza al encontrar un diseño desconocido — ese es el punto de la extracción semántica sobre la posicional.
Si tu equipo trabaja en Google Sheets en lugar de Excel — o quieres un panel en vivo que se actualice a medida que se completan los lotes — el mismo flujo de trabajo por lotes puede enviar los resultados directamente a un panel basado en Sheets. Consulta nuestra guía para procesar órdenes de compra por lotes en un panel de Google Sheets, o ve directamente a la herramienta de órdenes de compra a Google Sheets si solo quieres que las OC lleguen como filas a tu hoja activa.
Para ver un ejemplo práctico de este flujo de trabajo a escala de 50 órdenes de compra por mes con convenciones de adquisición japonesas — clasificación del impuesto al consumo, condiciones de pago por día de liquidación y agrupación por año fiscal — consulte nuestra guía para procesar por lotes órdenes de compra japonesas en un panel de adquisiciones.
¿Qué pasa con las órdenes de compra de varias páginas con encabezados de columna repetidos? La IA los reconoce como una sola tabla continua. Una orden de compra de 15 páginas con 300 líneas de artículos produce 300 filas en su salida, no 15 tablas separadas que luego deba unir manualmente.
Evite la Búsqueda de Archivos Adjuntos de Correo: Permita que los Proveedores Suban Directamente
Incluso después de resolver el problema de extracción, hay uno logístico oculto: conseguir los archivos de las órdenes de compra en el sistema. Si su flujo de trabajo actual es "revisar el correo → descargar archivos adjuntos PDF → guardar en carpeta → subir a la herramienta de extracción", la extracción está automatizada, pero la recopilación no.
Enlace de Recopilación es una función que cierra esta brecha. Usted genera una URL única (p. ej., /c/abc123) y la comparte con sus proveedores. Ellos abren el enlace, ingresan un código de verificación corto y suben sus archivos de órdenes de compra directamente. Los archivos llegan a su cola de procesamiento — sin correo, sin descargas, sin carpetas. El proveedor no necesita una cuenta, no necesita iniciar sesión ni instalar nada.
Para equipos que gestionan órdenes de compra de docenas de proveedores, esto elimina la parte menos eficiente del proceso: el paso humano intermediario de recopilar archivos adjuntos dispersos. En lugar de "revisar 30 correos de proveedores → descargar 30 PDF → organizar → subir", el flujo se convierte en "el proveedor sube → la orden de compra aparece en su cola → procesamiento por lotes → exportación".
¿En Qué Formatos de Órdenes de Compra Funciona Esto?
La extracción de nombres de columna funciona en cualquier formato de orden de compra porque no depende del diseño ni del método de generación:
- PDF generados por ERP — SAP, Oracle, NetSuite, Microsoft Dynamics, QuickBooks. Cada ERP genera las órdenes de compra de manera diferente; a la IA no le importa.
- Órdenes de compra en papel escaneadas — Para proveedores que aún envían papel, una foto con el teléfono o un PDF escaneado funciona. La IA lee el texto independientemente de la calidad del escaneo (dentro de lo razonable — los escaneos de muy baja resolución reducirán la precisión).
- Órdenes de compra en el cuerpo del correo — Algunos proveedores más pequeños envían las órdenes de compra como texto plano en el cuerpo del correo. Tome una captura de pantalla, súbala y se aplica la misma extracción de nombres de columna.
- Órdenes de compra en japonés — 発注書 de proveedores japoneses siguen el mismo patrón de diversidad de formatos, pero con convenciones de campos japonesas (発注番号, 納期, 支払条件). Consulte nuestra guía para extraer datos de órdenes de compra japonesas para conocer el esquema de columnas específico, la clasificación del impuesto al consumo y las convenciones de condiciones de pago.
- Lotes mixtos de múltiples formatos — Un solo lote puede incluir PDF de ERP, escaneos y capturas de pantalla. La IA procesa cada uno de forma independiente, pero los exporta a la misma hoja de cálculo unificada.
Límite práctico: Para obtener los mejores resultados, el documento debe ser razonablemente legible — 150 DPI o más para escaneos. Las fotos muy inclinadas o los documentos con patrones de fondo intensos pueden producir resultados parciales. La precisión de la IA en líneas de artículos suele superar el 90% en tablas de órdenes de compra impresas limpias, y disminuye con anotaciones manuscritas o tablas densas con letra pequeña.
Preguntas Frecuentes
¿Puede manejar órdenes de compra donde las líneas de artículos abarcan varias páginas?
Sí. La IA trata las órdenes de compra de varias páginas como un documento continuo. Una orden de compra de 15 páginas con 300 líneas de artículos produce 300 filas, con los campos de encabezado de la orden (número, fecha, proveedor) incluidos en cada fila. Los encabezados de columna repetidos en cada página se reconocen como encabezados y se excluyen del resultado: sin duplicados, sin fragmentos.
¿Qué pasa si los proveedores usan nombres diferentes para el mismo campo — por ejemplo, "Item No." vs. "SKU" vs. "Product Code"?
La IA mapea términos semánticamente equivalentes. Si especificas el nombre de columna "Item Code," localizará campos etiquetados como "Item No.," "SKU," "Product Code," o "Part Number" dentro del documento y los mapeará a tu columna Item Code. No necesitas listar cada sinónimo — la IA entiende que estos se refieren al mismo concepto.
¿Necesito configurar algo por proveedor?
No. La lista de columnas que defines una vez funciona con todos los proveedores. No hay creación de plantillas, ni configuración por proveedor, ni fase de entrenamiento. Escribe tus columnas, sube tus archivos, obtén tu hoja de cálculo. Esta es la diferencia clave entre la extracción por nombre de columna y las herramientas basadas en plantillas — consulta nuestra comparación de herramientas de extracción de órdenes de compra si estás evaluando proveedores basados en plantillas frente a la extracción por nombre de columna para tu combinación de proveedores.
¿Qué sucede si una orden de compra no tiene un campo — por ejemplo, algunos proveedores no incluyen condiciones de pago?
La celda de ese campo queda vacía en el resultado para esa orden. La estructura de tu hoja de cálculo se mantiene consistente en todas las filas; los campos faltantes simplemente aparecen como celdas vacías. No hay error, ni corrección manual necesaria, ni alerta de desajuste de plantilla.
¿Puedo exportar directamente a mi formato ERP?
Sí — si configuras tus nombres de columna para que coincidan con el formato de importación de tu ERP. Usa los encabezados de columna exactos de tu ERP al configurar la extracción, y el archivo XLSX estará listo para importación directa. Los formatos de fecha y número se pueden especificar en tus instrucciones de extracción para que coincidan con los requisitos de tu ERP.
¿Qué tan precisa es la extracción de partidas en tablas de órdenes de compra densas?
Para órdenes de compra impresas y limpias, la precisión de las partidas suele superar el 90%. Las principales caídas de precisión provienen de: fuentes muy pequeñas (menos de 8 pt), patrones de fondo intensos detrás de la tabla, anotaciones manuscritas sobre campos impresos y escaneos muy inclinados. La respuesta de la FAQ no es "99% siempre" — es "más del 90% para órdenes de compra impresas típicas, menos para casos extremos." Es una compensación honesta que vale la pena: más del 90% automatizado con revisiones manuales ocasionales frente a un 100% manual con errores de fatiga garantizados.
¿Funciona también para confirmaciones de pedido (OC) y órdenes de venta?
Sí. El mismo enfoque de extracción por nombres de columnas funciona para cualquier tipo de documento estructurado. Para confirmaciones de pedido, especifica columnas como "Número de pedido / Fecha de confirmación / Fecha de entrega confirmada / Cantidad confirmada / Precio unitario." Para órdenes de venta, especifica "Número de orden de venta / Número de PO del cliente / Dirección de envío / Código de producto / Cantidad solicitada." El mecanismo es el mismo: le dices a la IA lo que necesitas y ella lo encuentra en el documento.
Para el procesamiento individual de órdenes de compra donde necesitas campos de encabezado específicos y partidas seleccionadas en lugar de extracción masiva por lotes, consulta cómo extraer solo los campos que necesitas de las órdenes de compra.
Para procesamiento por lotes de órdenes de compra, nuestro convertidor dedicado maneja la extracción masiva de PO de cualquier formato de proveedor en una sola hoja de cálculo consolidada.