法的契約抽出とは?
手動レビューなしで主要条項を抽出
法的契約データ抽出とは、準拠法、補償、責任制限、譲渡、解除、秘密保持、不可抗力などの主要条項を契約書や合意書から自動的に特定・抽出し、構造化された形式に変換するプロセスです。相手方の名称、発効日、金額を対象とする一般的な契約データ抽出とは異なり、法的抽出は条項レベルで機能します。複数の段落にまたがる複雑な法的条項を読み取り、その範囲と境界を判断し、案件、相手方、リスクプロファイルごとに整理された、並べ替え・フィルタリング可能なデータとして出力します。
重要ポイント
- 1つの条項につき84分 — これは読む速さとは無関係です。
- どの事務所も同じ条項を異なる見出しで作成している場合、手動での検索はデューデリジェンスではありません。法的タスクを装った検索問題なのです。
- 条項の名称ではなく機能に基づいて契約を読むAIは、あなたを条項ハンターからリスクアナリストへと変えます。
リーガル契約データ抽出の実際の意味 — そして条項レベルの重要性
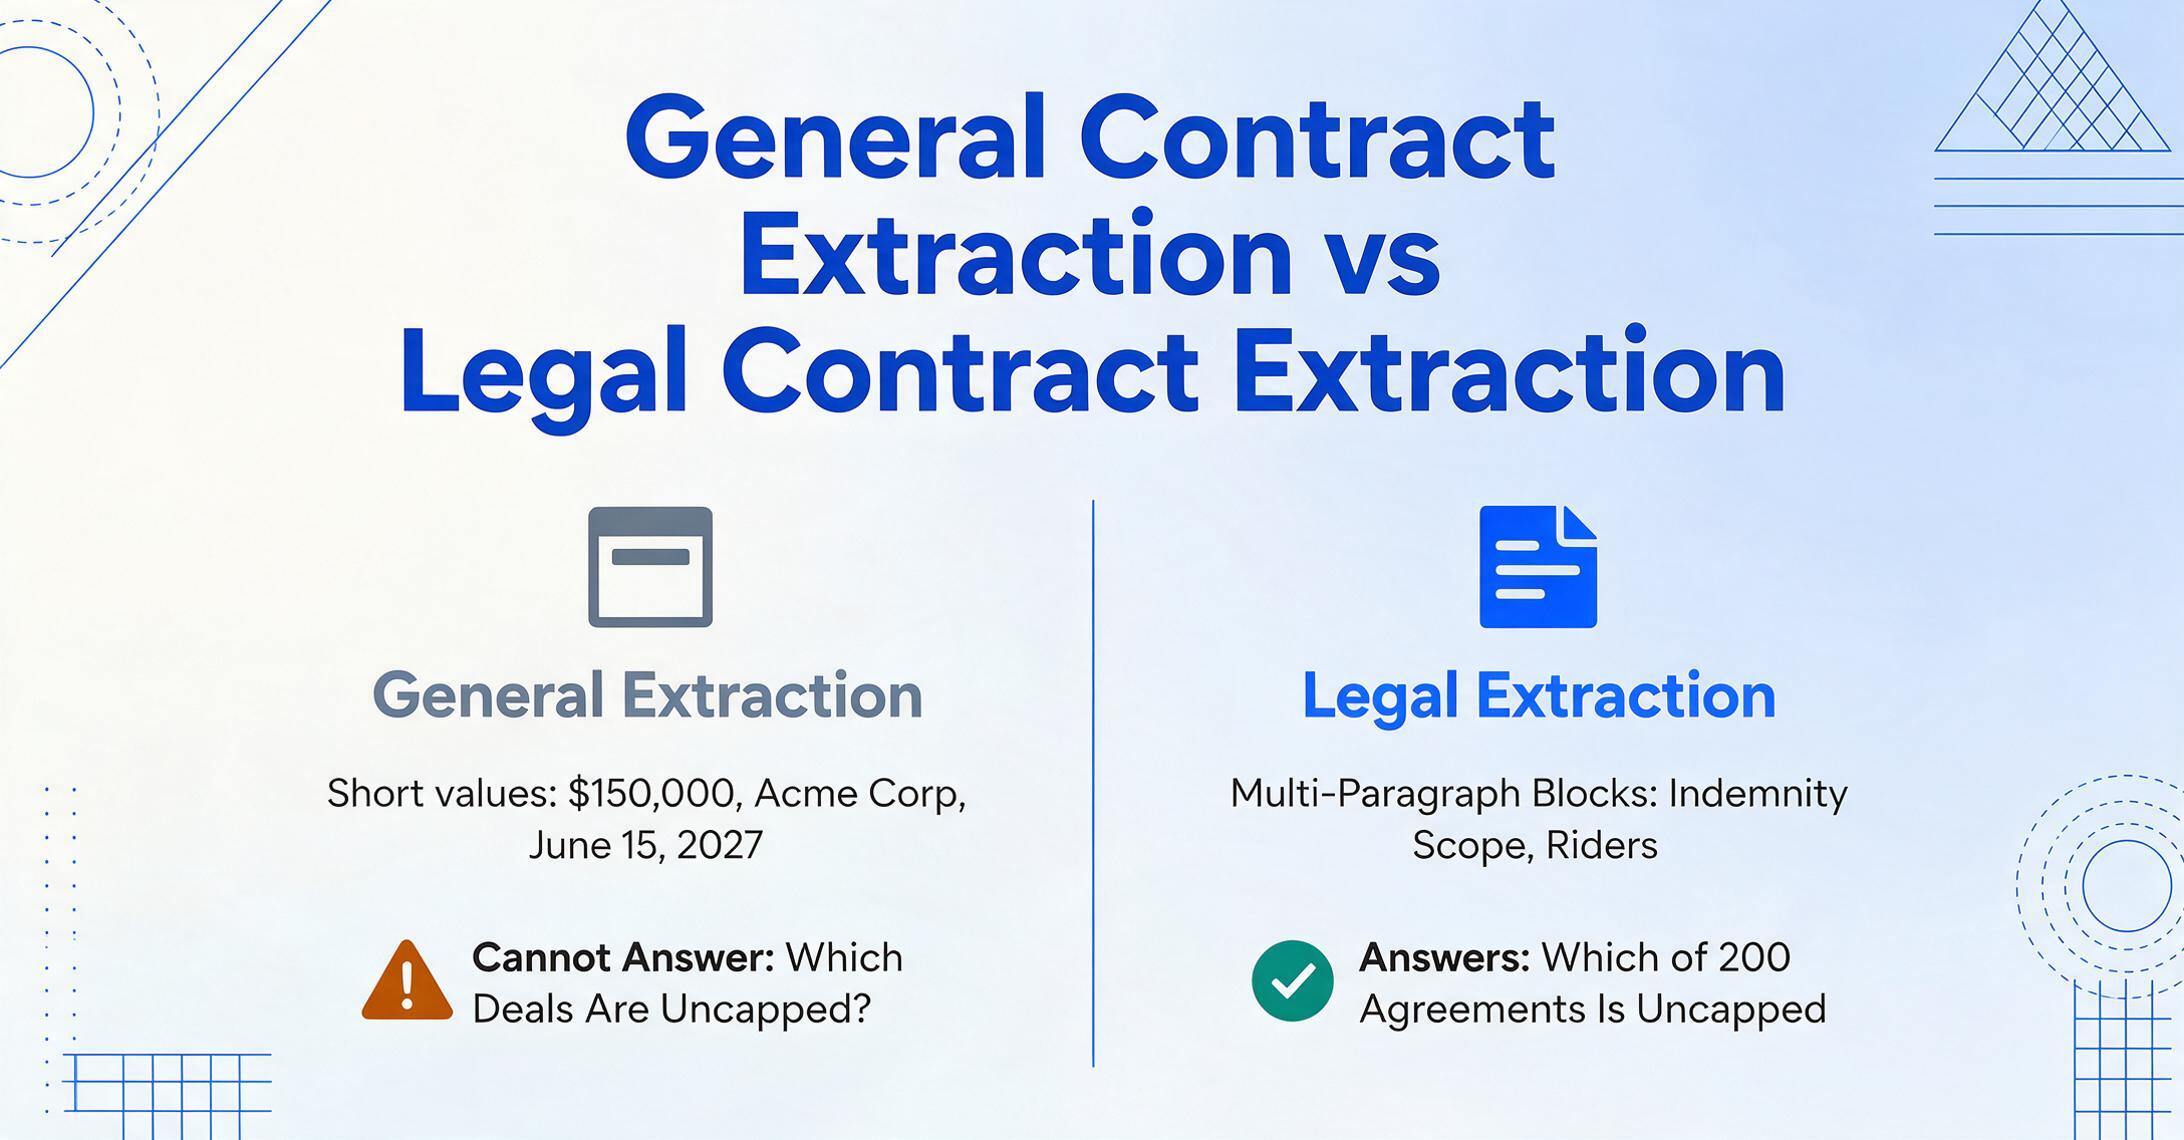
法律事務所にとって、一般的な契約データ抽出とリーガル契約データ抽出の違いは、単なる用語の問題ではありません。それは、どのような質問に答えられるかを決定づけるものです。一般的な抽出はポートフォリオの質問に答えます:「契約額はいくらか?」リーガル抽出はリスクの質問に答えます:「200件の契約のうち、どれに無制限の補償条項が含まれているか?」
抽出対象は、その複雑さにおいて根本的に異なります。一般的な抽出フィールドは、「$150,000」「Acme Corp」「2027年6月15日」といった、スプレッドシートのセルにきれいに収まる短い離散値です。一方、リーガル抽出の対象は、契約書によって境界が変動する複数段落にわたる法的文言です。補償条項は3つのセクションにまたがり、2ページ目の定義語を参照し、別紙Cのライダーによって修正される可能性があります。AIは「この条項が存在するか」だけでなく、「その開始と終了はどこか、また後の修正によって無効化されるか」を判断する必要があります。
一般的な契約抽出
- 契約当事者名
- 発効日と終了日
- 契約額 / 総対価
- 支払条件
出力:ポートフォリオ管理
リーガル契約抽出
- 補償の範囲と上限
- 責任制限条項
- 不可抗力の発生事由と適用除外
- 仲裁・紛争解決
- 競業避止 / 譲渡制限
- 準拠法 + 裁判管轄 + 専属的管轄
出力:リスク分析
CLOCの業界調査によると、契約書内の単一の条項を探すのに平均84分かかり、法務チームは契約レビュー1件あたり平均3時間を費やしています。年間500件の契約を扱う部門の場合、250営業日のうち188日が、法的分析が始まる前の検索に消えていくことになります。
法的契約抽出とは何か、そして何ではないのか
リーガルテクノロジーにおける4つの用語は、関連しながらも異なる活動を指しており、これらを混同することが、法律事務所が誤ったツールを購入する最も一般的な理由です。
電子証拠開示は、コレクション内の文書を発見するものです。「どのファイルが証拠開示請求に対応するものか」という問いに答えます。条項レベルのデータを出力するわけではありません。契約が中心の案件で電子証拠開示を実行する事務所でも、構造化された義務マップを構築するには抽出が必要です。
契約ライフサイクル管理(CLM)プラットフォームは、ドラフト作成、保管、更新を管理します。多くは抽出機能を含みますが、それはCLM自身のデータベースを埋めるためのものであり、スタンドアロンのスプレッドシートを提供するものではありません。ILTA 2025年調査(580事務所)では、31%がテクノロジーコストを最大の懸念事項として挙げており、数ヶ月を要するCLM導入はその圧力の一部です。
AI契約レビュー — Spellbook、LegalOn、LexCheck — はコンテンツを分析し、リスクのある条項をフラグ付けします。レビューは「これに署名すべきか」という問いに答えます。抽出は「これら200件の契約に何が含まれているか」という問いに答えます。まず抽出が必要です。詳細は契約レビューソフトウェアとAI抽出の比較をご覧ください。
法的契約抽出はデータのステップです。契約書を読み、条項レベルのコンテンツを構造化テーブルに出力します。全文書タイプの抽出については、AI文書抽出の概要をご覧ください。
AI条項認識の仕組み — 法的言語のセマンティック抽出
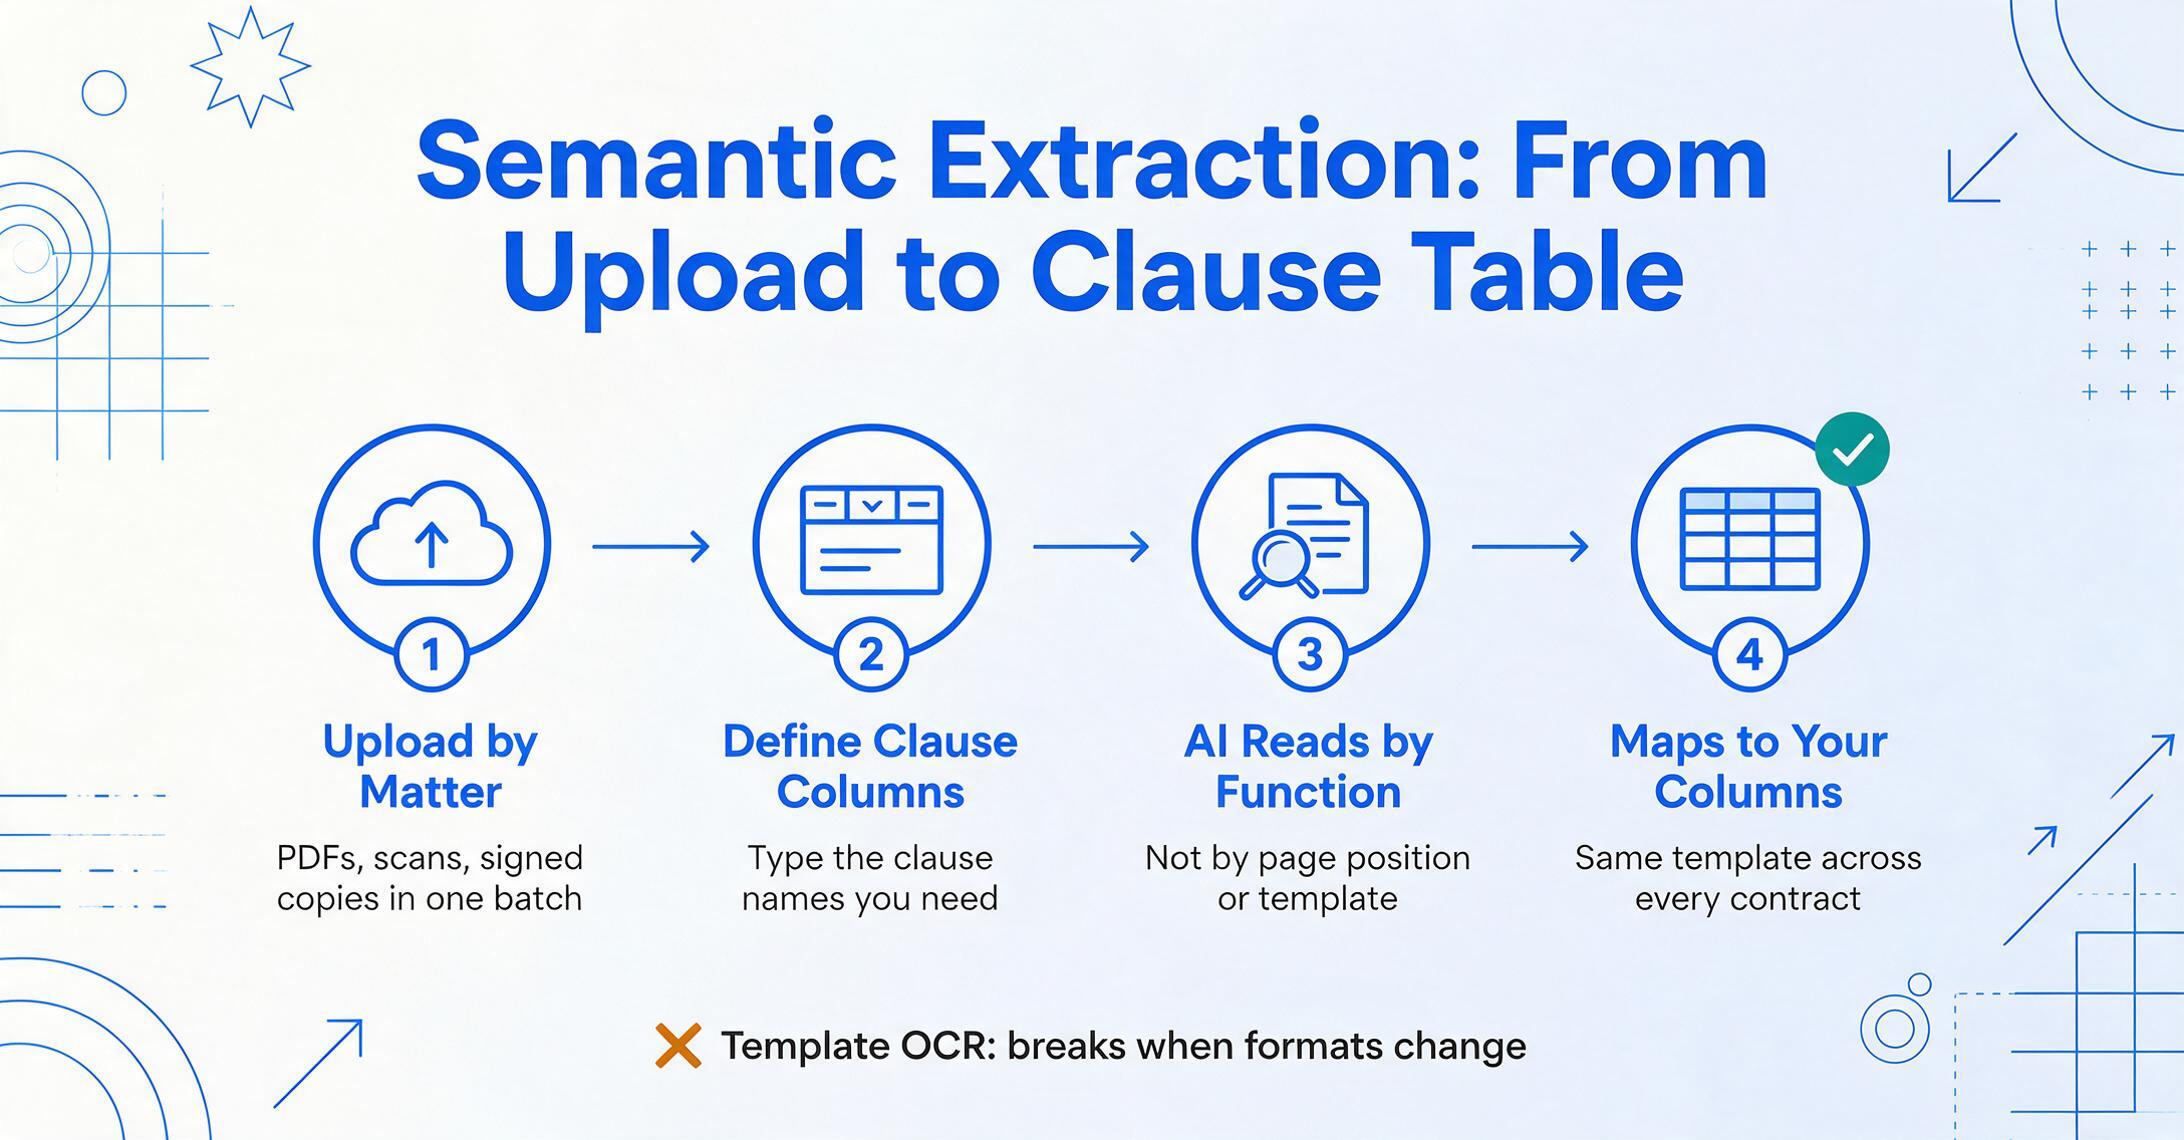
位置ベースからセマンティック抽出への移行こそが、条項レベルの抽出を大規模に可能にするものです。
従来のアプローチ:テンプレートOCR。従来のツールでは、各条項がページ上のどこにあるかを定義する必要があります。「補償条項は『当事者が以下のとおり合意する』の後に始まる」といった具合です。しかし、契約書はそれぞれ異なる文言を使用し、事務所ごとにドラフトのスタイルが異なります。Kirkland & Ellisの合併契約書の補償条項の構成は、ブティック事務所がドラフトしたベンダー契約とは異なります。テンプレートはフォーマットが変わると静かに破綻し、取引先が増えるごとにメンテナンスコストが増大します。
現代のアプローチ:セマンティック抽出。AIベースのツールは、位置ではなく意味によって契約書を読み取ります。出力列を定義します。「補償条項」「準拠法」「不可抗力」などです。AIはすべての契約書の全ページを読み取り、法的機能を理解して各条項を識別し、マッチした内容を正しい列にマッピングします。これがカスタム列抽出です。必要な条項名を入力すると、AIが法的言語をセマンティックに理解して、どの法律事務所がドラフトしたかに関係なく、文書内のどこでも一致するコンテンツを特定します。同じ抽出テンプレートが、案件内のすべての契約書に適用されます。
マターごとに契約書をアップロード
マターごとに整理したPDFをドロップするだけ — 複数ページの契約書、スキャン済み契約書、電子署名済みPDFもすべてまとめて取り込めます。事前の仕分けもファイル名の変更も不要です。
必要な条項を定義
列名を入力するだけ:「補償条項」「責任制限の上限」「準拠法」「不可抗力の発動条件」など。これらが出力スプレッドシートの見出しになります。テンプレート設定も学習サンプルも不要です。
AIが法的機能に基づいて条項を識別
ビジョンモデルが全ページをスキャンし、意味に基づいて条項ブロックを識別し、正しい出力列にマッピングします。15ページ目の補償条項も、42ページ目のライダーに埋め込まれた同じ条項も、同じ列に集約されます。
リスク別にエクスポート・分析
Excel、CSV、JSONでダウンロード — またはGoogle スプレッドシートに書き出し。準拠法で並べ替え、上限なしの補償条項でフィルタリング、取引先別にピボット集計。マター全体が1つの統合スプレッドシートにまとまります。
ファイルは安全に処理され、保存されることはありません。
法律事務所・法務チームが条項抽出を必要とする場面
1. M&Aデューデリジェンス。ミッドマーケットの取引では100〜300件の契約書を扱います。アソシエイトはレビュー期間の80%を、事業変更条項(change-of-control)や譲渡制限条項の特定だけで費やします。抽出により、200件の契約書から条項レベルのデータを数分で出力でき、チームは「検索」から「分析」へと作業を移行できます。ABAの2024年調査では、勤務先で生成AIを利用する弁護士が31%に達し、ACC/Everlawの報告では企業法務におけるAI導入率が23%から52%へ倍増しています。しかし、いまだ手作業でデューデリジェンスを行っている事務所にとって、抽出はROIが最も高い導入ポイントです。
2. リース抽象化とポートフォリオレビュー。商業リースが40件あれば、それぞれ40〜60ページの文書に更新日、エスカレーション計算式、用途制限が埋め込まれています。抽出により、ポートフォリオ全体が1つのスプレッドシートになります。各条項が列になり、ファイルを1つも開かずに並べ替え・比較が可能です。
3. 継続的義務の追跡。署名後の義務(通知期限、報告要件、コンプライアンス認証)は複数の条項に散在しています。手動で追跡するには、期限のたびに各契約書を読み直す必要があります。抽出により、義務台帳を一度で作成できます。バッチワークフローについては、バッチ契約条項抽出をご覧ください。
4. コンプライアンス監査と規制対応。規制当局からの照会では、特定の条項タイプ(GDPR条項、汚職防止表明、輸出規制文言)を含むすべての契約書を特定する必要があります。手動レビューでは全件を読むことになりますが、抽出ではスプレッドシートをフィルタリングするだけです。デジタル化前のスキャン契約書と最新のPDFを併用する場合は、法務文書向けOCRをご覧ください。
法務契約抽出がカバーする主要な条項タイプ
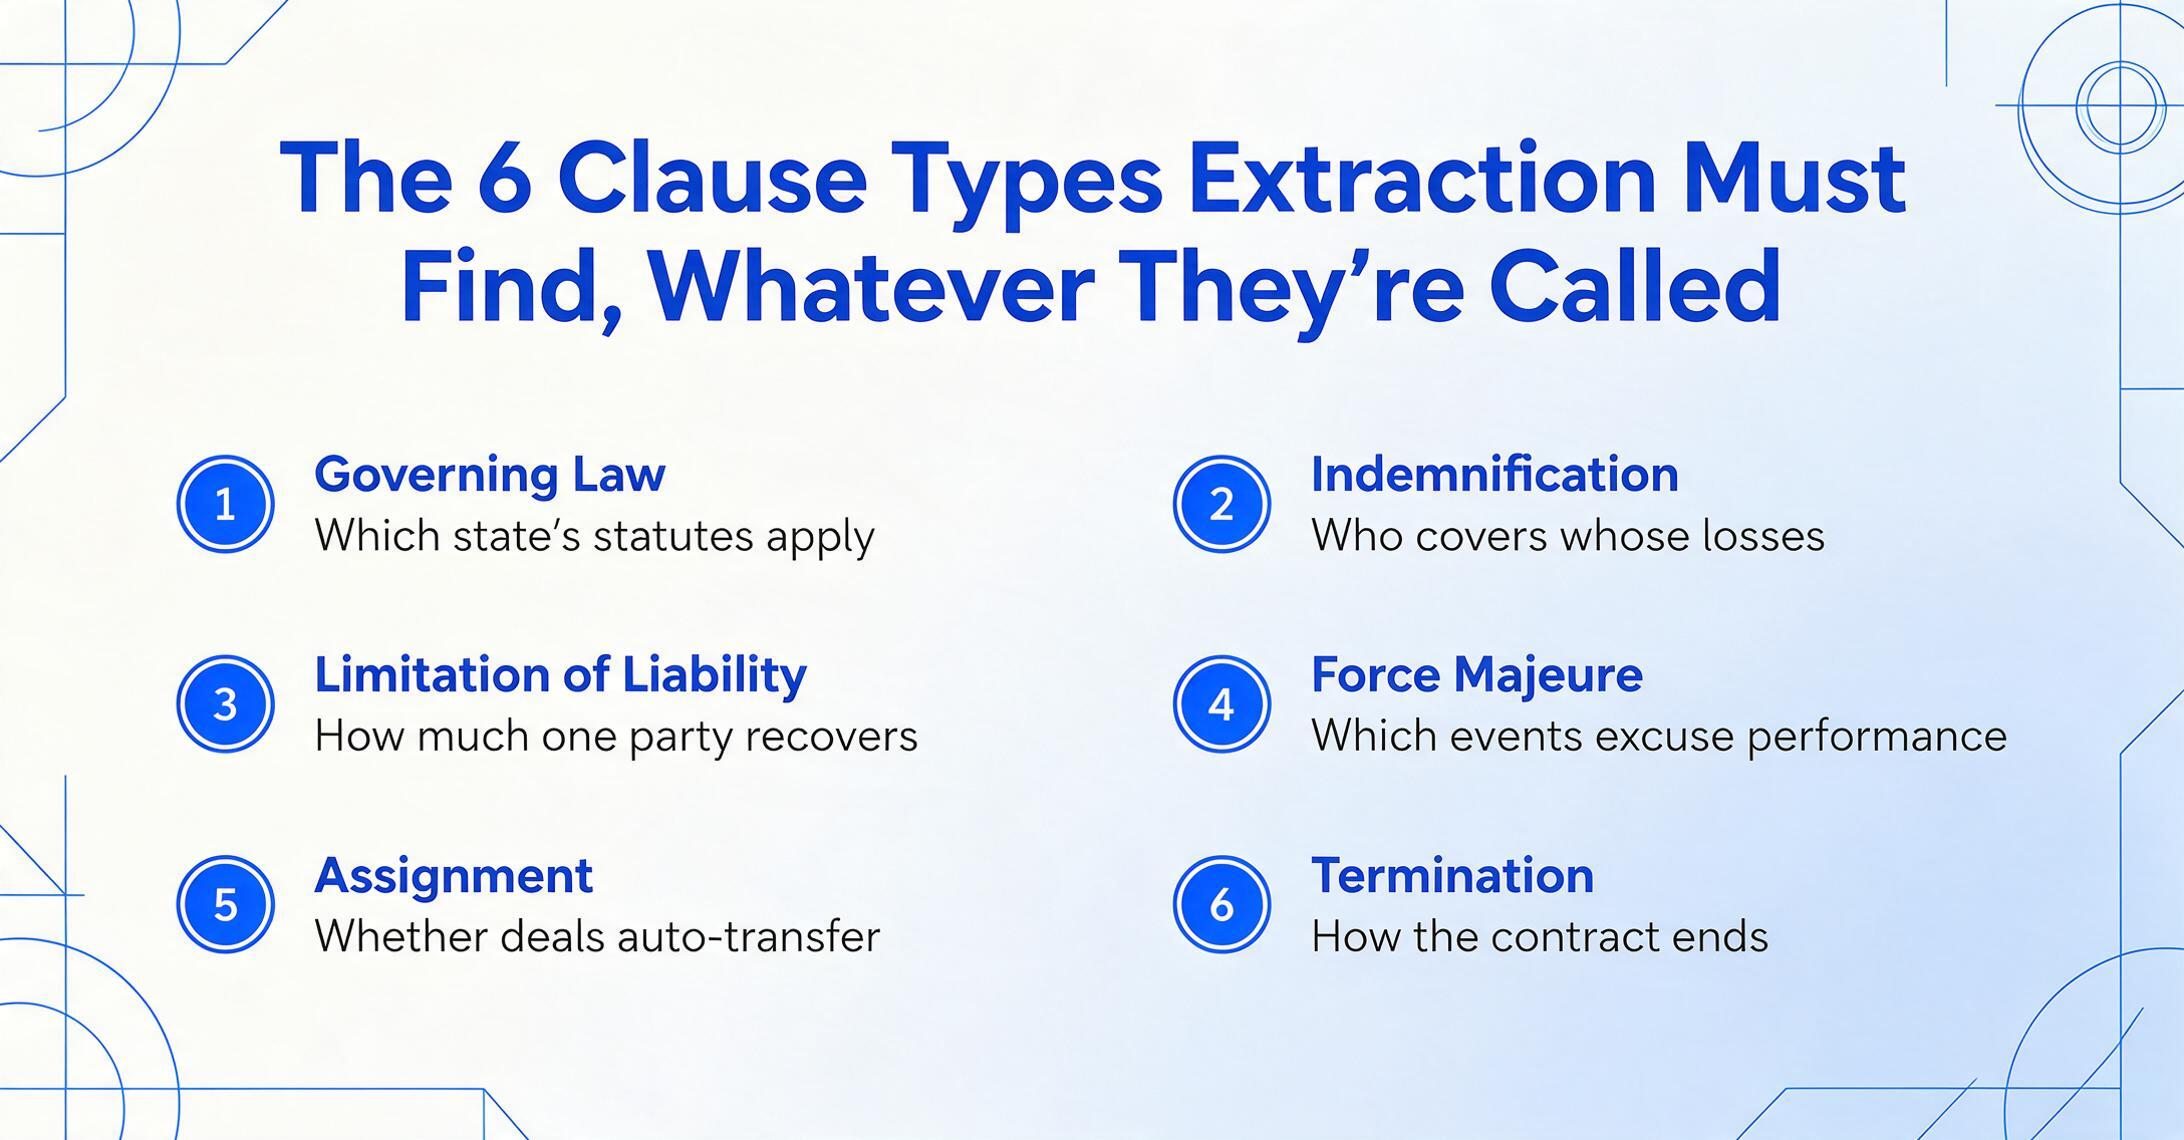
法務契約抽出における課題の1つは、条項名が標準化されていないことです。ある契約書で「Limitation of Liability(責任制限)」と呼ばれる条項が、別の契約書では「Cap on Damages(損害上限)」と記載されている場合があります。抽出ツールは、見出しではなく法的機能によって条項を認識する必要があります。
準拠法
契約の解釈に適用される管轄地の法律を指定します。「本契約はニューヨーク州法に準拠するものとする。」紛争解決方法と適用法令を決定します。
補償
データ漏洩、知的財産権侵害、規制違反など、特定の事象が発生した場合に、一方の当事者が相手方の損失を補填することに同意します。その範囲(上限あり・なし、広範・限定)が取引における財務リスクの主要な決定要因となります。
責任制限
一方が回収できる金額に上限を設け、結果的損害や懲罰的損害賠償を除外することが多いです。この条項と補償条項の相互作用は、契約審査において最も精査される領域です。
不可抗力
自然災害、戦争、パンデミックなど、両当事者の制御を超えた異常な事象が発生した場合に、履行義務を免除します。「パンデミック」や「サプライチェーンの混乱」が明示的に列挙されているかどうかは、COVID-19以降、重要な審査ポイントとなりました。
譲渡
当事者がその権利または義務を他社に移転できるかどうかを制御します。M&Aデューデリジェンスにおいて、譲渡条項は契約が自動的に買収者に移転するか、相手方の同意が必要かを決定します。
契約終了
契約の終了方法を定義します。理由あり、都合による(理由なし)、期間満了、または特定の事象発生時などです。都合による終了条項は、長期契約において重大な取引リスクを生み出します。
秘密保持
どの情報が秘密情報に該当するか、その取扱い方法、および義務の存続期間を定義します。国境を越えた取引では、秘密保持に関する非標準的な例外が重大なリスクを生じさせる可能性があります。
仲裁・紛争解決
紛争を裁判所に持ち込むか仲裁に付託するか、そのフォーラム(AAA、JAMS、ICC)と仲裁地を指定します。集団訴訟の権利放棄を伴う強制仲裁条項は一般的ですが、商業契約においてますます精査されるようになっています。
これら8つの条項タイプは、最も頻繁に抽出される条項を代表しています。それぞれの確実な抽出は、見出しが欠落している場合や標準的でない場合でも、AIが条項の機能に基づいて認識できるかどうかに依存します。実践的なガイドについては、契約から特定のフィールドを抽出する方法をご覧ください。
法務契約抽出ツールに求めるべきポイント
フィールド抽出だけでなく、条項レベルの機能。「契約相手」と「発効日」を抽出できても、補償条項を特定できないツールは、法務向けではなく一般的な抽出ツールです。実際の契約書でテストしてください。10社の法律事務所がそれぞれ異なる番号規則で作成した契約書から、責任制限の上限額を特定できるでしょうか。条項レベルの抽出に対応しているツールと、フィールドデータのみのツールを比較するには、9つの契約抽出ツールの比較をご覧ください。
テンプレート不要・トレーニング不要。ベンダーが「御社の契約書形式に合わせてモデルをトレーニングする必要があります」と言うなら、導入コストがかかるということです。法務グレードのツールは、初めて見る相手方の契約書を、初めて遭遇する形式でも、初回から処理できる必要があります。テンプレート照合ではなく、意味論的に読み取ることで実現します。
複数セクションと別紙への対応。法務契約書は30〜100ページに及び、本文が参照する条項を含む別紙、スケジュール、修正条項が含まれます。最初の10ページだけを読むツールは、別紙Dの補償上限額を見逃します。ツールは文書全体を論理的な単位として読む必要があります。
案件単位のバッチ処理。1つの取引に関する50件の契約書を一括アップロードすると、1つの統合スプレッドシートが生成されるべきです。契約書ごとに1行、各条項に列が設けられ、案件のデューデリジェンスチェックリストやレビュープロトコルに直接取り込めます。
条項タイプ別の正確な精度表示。「精度99%」というのは通常、クリーンなデジタルPDFのヘッダーフィールドを指します。条項レベルの抽出はより難しく、精度は条項タイプと契約書の複雑さによって異なります。意味のあるテストは、導入前に、御社の実際の契約書、特に複雑な法律用語、相互参照されたライダー、スキャンされた署名を含むものをツールで実行することだけです。
よくある質問
法的契約の抽出は弁護士によるレビューの代わりになりますか?
いいえ。抽出は条項データを構造化して出力するものです。レビューはリスクを評価し、契約締結の可否を助言します。抽出は検索の負担(条項あたり84分)を取り除き、弁護士が探すのではなく分析に時間を使えるようにします。67%の法律事務所が依然として時間単位で請求している中、抽出は時間を価値の低い検索から価値の高い法的判断へと移行させます。
法的契約の抽出は電子証拠開示とどう違うのですか?
電子証拠開示はコレクション内の関連文書を特定します。抽出は関連性が確認済みの文書を読み取り、条項レベルのデータを出力します。契約が絡む訴訟では両方が必要です。ファイルを見つけるための電子証拠開示と、構造化された義務マップを構築するための抽出です。
AIは補償条項と責任制限条項を区別できますか?
明確に区別できる条項については、一般的に可能です。両者は異なる法的文言を使用し、目的も異なります。ただし、両方が同じセクションに含まれる場合、複雑な定型文に織り込まれている場合、または前のセクションの定義を相互参照している場合は、精度が低下します。重要度の高い契約では、人間による検証が引き続き適切な慣行です。
法的契約の抽出はスキャンしたPDFを処理できますか?
はい。ビジョンベースのAIモデルは、テキストレイヤーを抽出するのではなく、ページの視覚的な内容を分析してスキャンしたPDFを読み取ります。2010年のスキャンされた合併契約、デジタル署名された業務委託契約書、印刷されたタームシートのスマホ写真もすべて同じように処理されます。限界は画質です。人間のパラリーガルが読むのに苦労する場合、AIも同様に苦労します。
AI抽出が最も難しい条項タイプは何ですか?
最も確実に抽出できる条項は、一貫した起草パターンに従うものです。準拠法、仲裁、不可抗力、責任制限などです。信頼性が低いのは、高度に交渉された特注条項、明確な境界なしに複数のセクションにまたがる条項、別紙や外部文書への相互参照で定義されている条項です。
200件の契約を一度に処理できますか?
はい。バッチ処理は法的デューデリジェンスの標準的なワークフローです。条項の列を一度定義し、50〜200件の契約をアップロードすると、すべての契約のすべての条項が入力された1つのスプレッドシートを受け取れます。各契約は数秒で処理されるため、デューデリジェンスが「アソシエイトの数週間分の作業」から「半日でのレビュー」に変わります。
次のステップ
法的契約の抽出は、定量化可能なボトルネックに対処します。単一の条項を見つけるのに84分、契約レビュー1件につき3時間、年間500件の契約を扱う場合、作業時間の75%を検索に費やしています。時間が在庫である法律事務所にとって、抽出は条項の検索から、それがクライアントにとって何を意味するかの分析へと時間を移行させます。
この技術は今日すでに存在し、エンタープライズCLMや数か月にわたる設定は必要ありません。あなたの事務所が1つの案件で数十件以上の契約を扱い、「無制限の補償を含む契約はどれか」といった質問に定期的に答える必要があるなら、抽出はそれらの質問を数日がかりの調査からスプレッドシートのフィルタリングへと変えます。AI文書抽出の概要から始めるか、サンプル契約をアップロードして、ご自身の文書で条項レベルの抽出をご確認ください。