テキスト正規化とは?
ドキュメントデータに必要な理由
「04/05/2026」は米国では4月5日、その他のほぼすべての国では5月4日を意味します。「($47.99)」は米国人にとってはマイナス金額ですが、それ以外の人にとってはタイプミスです。「AMZ*234KL PRIME」と「Amazon Prime」は人間にとっては同じ業者ですが、コンピューターにとっては無関係な文字列です。テキスト正規化とは、これらの解釈のどれが正しいかを判断するステップであり、スプレッドシートに届くデータが多数のほぼ同一の形式ではなく、1つの正規形式で保持されるようにします。
Gartnerは、データ品質の低下により組織は平均して年間少なくとも$12.9 millionの損失を被ると推定しています1。そのコストの大部分は、誤った値に関するものではありません。同じ値が異なる形式で書かれていることに関するものです。並べ替えができない日付、重複排除ができない業者名、合計が合わない金額などです。この記事では、正規化ステップが実際に何を行うのか、ドキュメントデータで何をカバーするのか、そして失敗をどのように見分けるのかを説明します。
重要ポイント
- 誤っていたわけではなく、単に異なる形式で書かれていただけの値をクリーンアップするために、毎月2〜3時間が費やされています。
- 形式が混在する列は、並べ替えができない、照合ができない、集計ができないという3つの問題を同時に引き起こします。
- 抽出時に各フィールドの形式を決定すれば、スプレッドシートは最初からクリーンな状態で開き、2回目の処理は不要です。
テキスト正規化とは?
テキスト正規化とは、後続のシステムが解釈する前に、テキストを単一の標準形式に変換するプロセスです。標準的なNLP教科書であるSpeech and Language Processingでは、これは不可欠な最初の段階です。テキストを単位にトークン化し、単語形式を正規化し、文を分割することで、「Woodchuck」と「woodchuck」が同じトークンとして扱われ、「USA」と「US」が1つの形式に統合されます2。
同じ用語が2つの異なる作業を指しています。NLPパイプラインでは、正規化は単語に対して機能します。小文字化、語形変化の削減、句読点の除去、Unicodeバリアントの統合などです。ドキュメントデータ処理では、正規化はフィールド値に対して機能します。ドキュメントに含まれる日付、金額、電話番号、ベンダー名などです。目標は同一であるため、両方とも同じ名前で呼ばれます。対象物が異なるため、2番目の作業にはトークナイザーが知らない標準規格が必要です。
ドキュメント処理における実用的な定義:正規化とは、ドキュメントが表現しうるあらゆる概念のバリエーションを、お客様のシステムが保存・比較できる1つの曖昧さのない表現に変換することです。
ドキュメントデータ正規化が実際にカバーする範囲
ドキュメントデータ正規化は、少数のフィールドファミリーを標準化し、それぞれが存在する場合は公開された標準規格に対応付けられます。以下の表は、フィールドファミリー、実際のドキュメントが持つバリエーション、および正規化されたエクスポートに含まれるべき標準形式を示しています。
| フィールドファミリー | 実際の文書で見られるバリエーション | 正規形 | 標準アンカー |
|---|---|---|---|
| 日付 | 04/05/2026、05.04.2026、Apr 5 2026、2026.04.05、「5th of April」 | 2026-04-05(明示的、曖昧さなし) | ISO 8601 3 |
| 金額と数値 | $1,234.56、1.234,56、1234.56、($47.99)、$1.2B | 1234.56、-47.99、1200000000(小数、符号を明示) | ISO 4217 通貨コード、ロケール規則 |
| 電話番号 | (415) 555-0132、+1 415 555 0132、001-415-555-0132 | +14155550132(国番号、15桁以内) | ITU-T E.164 4 |
| 識別子 | INV-00123、#00123、00123、INV 00123 | INV-00123(アルファベット1種、区切り文字1種) | 内部規約 |
| エンティティ名 | ACME Corp、ACME Corporation、A.C.M.E.、acme corp | ACME Corp(1つの正規名に一致) | マスターデータ/エイリアス解決 |
| 文字エンコーディング | café(合成済み)と café(分解済み)、全角ABC | 同じ文字列は同じバイト列 | Unicode UAX #15 NFC/NFKC 5 |
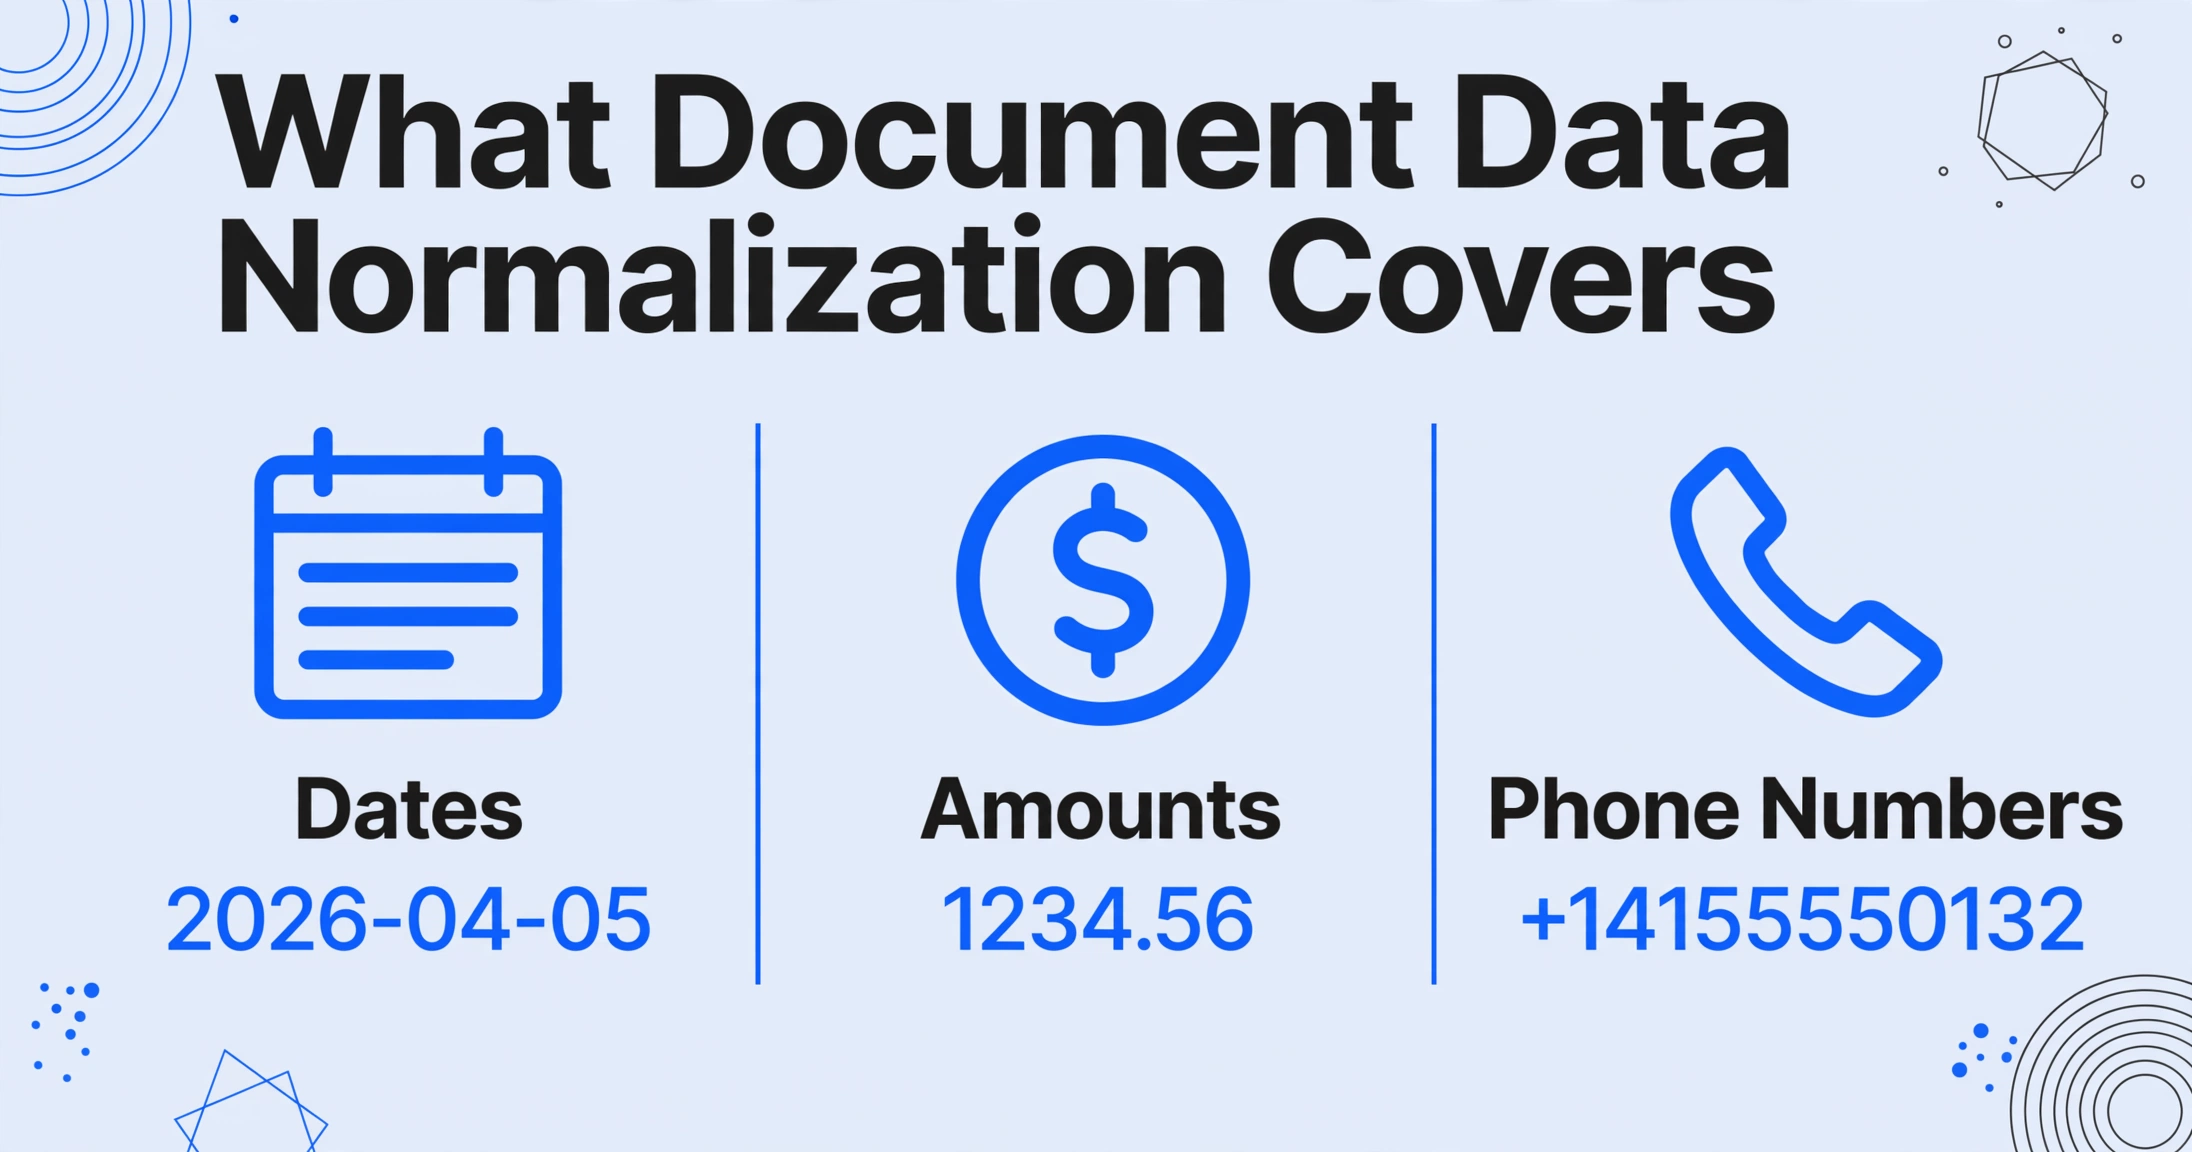
このうち2つのファミリーは、ほぼすべての抽出バッチに登場するため、詳しく見る価値があります。日付は構造上曖昧です。同じ数字の並びがロケールによって異なる日付を意味するため、まさにISO 8601が排除するために作られた問題です。その固定順序(年-月-日)は正しくソートでき、確実に解析でき、ISOと分かれば誤読の心配がありません。エンティティ名はその逆です。会社名に関する国際標準は存在しないため、正規化は接尾辞や大文字小文字を統一し、自社のデータにとって重要な正規名の短いリストを人間が管理するという形になります。
特定のドキュメントタイプを対象とする場合、これらのフィールドルールは具体的な運用手順になります。同じフィールドレベルの標準化を仕入先請求書に適用する場合、仕入先請求書の標準化ガイドでは、APデータにおけるフォーマット差異の4つの側面について説明しています。また、異なる仕入先からの請求書を統合するガイドでは、すべてのベンダーで出力列を一貫して保つ方法を扱っています。運賃見積もりのレート正規化も同じ原則の別のケースであり、RFQレスポンスの比較で説明しています。この記事は、それらが基づくコンセプトレイヤーに留まります。
ドキュメントデータの正規化がテキスト正規化より難しい理由
ドキュメントデータの正規化は、プレーンな散文よりも難しいのは、値の意味がテキストだけでは伝わらないコンテキストに依存するためです。NLPパイプラインは、共有の言語モデルを使用して連続する文内の単語を正規化します。スキャンされた請求書は、一度に4つの軸で異なる問題です。
コンテキストは推測する必要があり、読み取ることはできません。「04/05/2026」は、ドキュメントの出所、言語、場合によってはドキュメントの種類がわかるまで解決できません。フランクフルトの公共料金請求書とヒューストンの銀行明細書では、その日付の解釈が異なり、どちらも「間違い」ではありません。ロケールを推測して黙って処理を進める正規化ステップは、このプロセスの中で最も危険なバージョンです。
テキストレイヤーは、正規化が始まる前からノイズが多いです。 NLPベンチマークコーパスはクリーンな連続テキストです。スキャンされたドキュメントはOCRから生成され、「O」と「0」、「l」と「1」を混同し、全角文字、分割された数字、余分な記号を出力します。Unicode正規化(UAX #15)はエンコーディングのバリエーションを修正しますが、OCRが別の文字として誤読した文字は修正できません。これは認識エラーであり、フォーマットのバリエーションではありません。OCRエンジンの前に実行される別のレイヤーである画像前処理は、OCR前の画像前処理ガイドで説明しているように、ピクセル側から同じノイズの一部に対処します。
値は文ではなく、テーブル構造の中にあります。 トークナイザーは、句読点と空白で文をセグメント化します。ドキュメントのフィールドは、そのラベル、位置、または隣接する要素によって識別され、ラベル自体も同じ正規化問題(「Total」、「TOTAL」、「Amount Due」、「Summe」)の影響を受けます。どの値がどのコンセプトに属するかを知る前に値を正規化すると、列が間違ったクリーンなテーブルが生成されます。
多言語ドキュメントは、複数の慣習体系を混在させます。 1つの請求書に、ドイツ語の金額(「1.250,00」)、英語の日付(「Jun 15, 2026」)、アクセント文字を使用する仕入先の法的名称が含まれる場合があります。それぞれに異なるルールが必要であり、ルールは互換性がありません。そのため、バージョン管理され一貫して適用される正規化パイプラインが、どんな単一の巧妙な正規表現よりも重要です。
正規化の失敗を見分ける方法
正規化の失敗は、出力されたスプレッドシートの3つの症状から検出できることがほとんどです。値が並べ替えられない、値が一致しない、値が合わない、という症状です。
値が並べ替えられない場合は、ほぼ常に日付または数値の形式が混在しています。日付列に「2026-01-03」「Jan 3, 2026」「01/03/2026」が同時に含まれていると、各行が正しくても時系列での並べ替えは失敗します。銀行からエクスポートした日付、仕入先名、金額の修正に毎月2〜3時間費やしていると述べたユーザーは、まさにこの問題を説明していました6。形式が混在した列を並べ替えると、時間ではなく文字列の数字順のリストになります。
値が一致しない場合は、エンティティ名の正規化が失敗しています。VLOOKUPや重複排除は同一の文字列に依存するため、「AMZ*234KL PRIME」と「Amazon Prime」は2つの仕入先に分かれ、ピボットテーブルには1つの供給業者の11種類の表記が表示されます。一致処理では、文字レベルでのクレンジングとエイリアス解決は異なる役割を果たします。Unicode正規化は文字列をバイト単位で同一にしますが、2つの文字列が同じ会社を指していることを認識できるのはエイリアス解決だけです。
値が合わない場合は、コストのかかる失敗です。数値は正しいものの、通貨記号、括弧、ロケール区切り文字付きのテキストとして保存されているため、合計や比較ができません。「($47.99)」をテキストとして解析すると、合計から差し引くことはできず、「1.250,00」と「1,250.00」は異なる大きさとして扱われます。合計列が記載されている請求書の合計と一致しない場合は、通常、数量と単価が異なる区切り文字の規則で解析されたことを示しています。
これら3つを同時に検出する最も簡単な方法は、単一の不変条件、つまりドキュメント自体が宣言している値との照合です。明細項目の合計が印刷された合計と一致しない場合、または明細残高が取引と一致しない場合は、上流のどこかで正規化(または認識)が壊れています。差異フラグは、形式を目視で確認するよりも常に優れています。
正規化は抽出後に行う必要がありますか?
正規化は、Excelでの別途の手動ステップである必要はありません。抽出ステップがフィールドの意味を理解していれば、値を出力すると同時に標準形式を生成できます。ここで、この記事のドキュメント処理の全体像が具体的なツールにつながります。
ImageToTable.aiは、 カスタム列抽出パターンに基づいて構築されたAIドキュメント抽出ツールです。「請求書日付」や「合計金額」などのフィールド名を入力すると、AIがページ上の位置ではなく意味を理解して各値を特定します。その インテリジェントな後処理は、同じ抽出パス中に指定した形式に日付、金額、シリアル番号を正規化できるため、出力はExcel、CSV、JSONに標準形式でそのまま取り込まれ、2回目のクリーンアップ作業は不要です これを使用したドキュメント解析ワークフロー。 根本的なアイデアのより広い枠組みについては、 データキャプチャの概念リファレンスで、非構造化ドキュメントが構造化レコードに変換される仕組みを説明しています。
抽出時の正規化が機能するのは、フィールドが意味によって識別され、形式が指示によって適用されるためです。「請求書日付(YYYY-MM-DD)」という列に名前を付けると、AIはドキュメントで使用されている日付の表記方法を読み取り、指定した形式で日付を出力します。同じパスで、金額の小数点表記を統一し、参照番号の識別子形式を統一することもできます。これらはそれぞれ、上記の表のフィールドレベルの正規化であり、後から修正するのではなく、抽出中に実行されます。
この境界線は明確に述べる価値があります。このツールの後処理は抽出された値の形式を標準化し、抽出中に値を計算または推論できます。単語レベルのNLP正規化パイプラインを実行することは主張しておらず、お客様が管理するマスターデータベースに対するエンティティ解決を実行することもありません。エンティティ名は、特に監査やコンプライアンスの文脈では、人間が管理する標準リストが最終的な役割を果たす領域です。
よくある質問
テキスト正規化はデータクリーニングと同じですか?
いいえ、ただしこの2つは通常一緒に行われます。クリーニングはノイズやエラーを取り除きます。OCRの誤読の修正、不要な句読点の削除、欠損値の処理などです。正規化は、有効なバリエーションを単一の表現に固定します。日付の正しい表記が3つあれば、それを1つにします。実際には、パイプラインは最初にクリーニングを行い、次に正規化を行います。OCRエラーをまだ含む文字列を正規化すると、見た目はきれいでも間違った値が生成されるだけだからです。
04/05/2026のような曖昧な日付はどう解析すればよいですか?
解析する前にドキュメントがどの表記法を使用しているかを判断し、抽出ルールの中で明確に指定してください。米国の銀行明細書は月日順を使用し、欧州の公共料金請求書は日月順を使用します。ドキュメントの言語と国が通常どちらかを示します。まったく文脈がない場合は、黙って推測するのではなく、人間によるレビューのためのフラグを立てるのが安全です。ISO 8601は、出力にこの問題がなくなるようにするために存在します。
Excel Power QueryやOpenRefineではこの正規化はできないのですか?
データがすでに表形式になっていれば、それらでも可能です。ギャップは上流にあります。Power Queryはスキャンされた請求書のPDFを読み取ることができず、OpenRefineは変換する前にどの列がどれかを把握している必要があります。パイプラインの出力がすでに構造化されており、さらにビジネス変換を行う場合には、これらは優れたツールであり続けます。
このツールは完全なNLP正規化パイプラインを実行しますか?
いいえ。この製品は抽出中に抽出されたフィールド値の形式を標準化し、その境界について正直です。トークン化、ステミング、エンティティ解決、マスターデータに対するカスタムマッピングは実行しません。これらは専用のNLPおよびデータ管理ツールに含まれます。ここでの目標は、エクスポートされたテーブル内の日付、金額、シリアル番号がすべて最初のパスで1つの正規形式で読み取られることです。
この記事を有用にするアイデアは小さく、構造的です。形式とは、誰かが一度下した決定であり、正規化とは、ドキュメントが読まれるすべての場所でその決定をやり直す行為です。その決定が毎週のExcelの儀式から抽出ステップ自体に移ると、開くスプレッドシートはすでに望んでいたスプレッドシートになり、並べ替え、照合、締めの3つの失敗症状が月末レビューに現れなくなります。