Was ist Textnormalisierung?
Warum Dokumentdaten sie brauchen
„04/05/2026" ist in den USA der 5. April und fast überall sonst der 4. Mai. „($47.99)" ist ein negativer Betrag, wenn Sie Amerikaner sind, und ein Tippfehler, wenn nicht. „AMZ*234KL PRIME" und „Amazon Prime" sind für einen Menschen derselbe Anbieter und für einen Computer unzusammenhängende Zeichenfolgen. Textnormalisierung ist der Schritt, der entscheidet, welche dieser Interpretationen richtig ist, damit die Daten, die Ihre Tabelle erreichen, eine kanonische Form tragen statt vieler nahezu identischer.
Gartner schätzt, dass schlechte Datenqualität einem Unternehmen im Durchschnitt mindestens 12,9 Mio. $ pro Jahr kostet1. Ein großer Teil dieser Kosten betrifft nicht falsche Werte, sondern denselben Wert in verschiedenen Formaten: Daten, die sich nicht sortieren lassen, Anbieternamen, die sich nicht deduplizieren lassen, und Beträge, die sich nicht summieren lassen. Dieser Artikel erklärt, was der Normalisierungsschritt tatsächlich tut, was er in Dokumentdaten abdeckt und wie Sie erkennen, wann er fehlgeschlagen ist.
Wichtigste Erkenntnisse
- Zwei bis drei Stunden pro Monat verschwinden in der Bereinigung von Werten, die nie falsch waren, nur in einem anderen Format geschrieben.
- Eine Spalte mit gemischten Formaten scheitert an drei Stellen gleichzeitig: Sie lässt sich nicht sortieren, nicht abgleichen und nicht abschließen.
- Legen Sie das Format jedes Felds während der Extraktion fest, und die Tabelle öffnet sich bereits sauber – ohne zweiten Durchlauf.
Was ist Textnormalisierung?
Textnormalisierung ist der Prozess, Text in eine einzige, kanonische Form zu überführen, bevor ein nachgelagertes System ihn interpretieren muss. Im Standard-Lehrbuch der NLP, Speech and Language Processing, ist sie die unverzichtbare erste Stufe: Text in Einheiten tokenisieren, Wortformate normalisieren und Sätze segmentieren, sodass „Woodchuck" und „woodchuck" als dasselbe Token gelten und „USA" und „US" zu einer Form zusammengeführt werden2.
Dasselbe Wort deckt zwei verschiedene Aufgaben ab. In NLP-Pipelines arbeitet die Normalisierung an Wörtern: Kleinschreibung, Reduktion von Flexionsformen, Entfernen von Satzzeichen, Zusammenführen von Unicode-Varianten. In der Dokumentdatenverarbeitung arbeitet sie an Feldwerten: dem Datum, dem Betrag, der Telefonnummer, dem Lieferantennamen, den ein Dokument trägt. Das Ziel ist identisch, weshalb beide denselben Namen tragen. Das Material ist unterschiedlich, weshalb die zweite Aufgabe Standards benötigt, die ein Tokenizer nicht kennt.
Die Arbeitsdefinition für die Dokumentverarbeitung: Normalisierung bedeutet, jede Variation eines Konzepts, die ein Dokument ausdrücken kann, in eine eindeutige Darstellung zu überführen, die Ihre Systeme speichern und vergleichen können.
Was Dokumentdaten-Normalisierung tatsächlich abdeckt
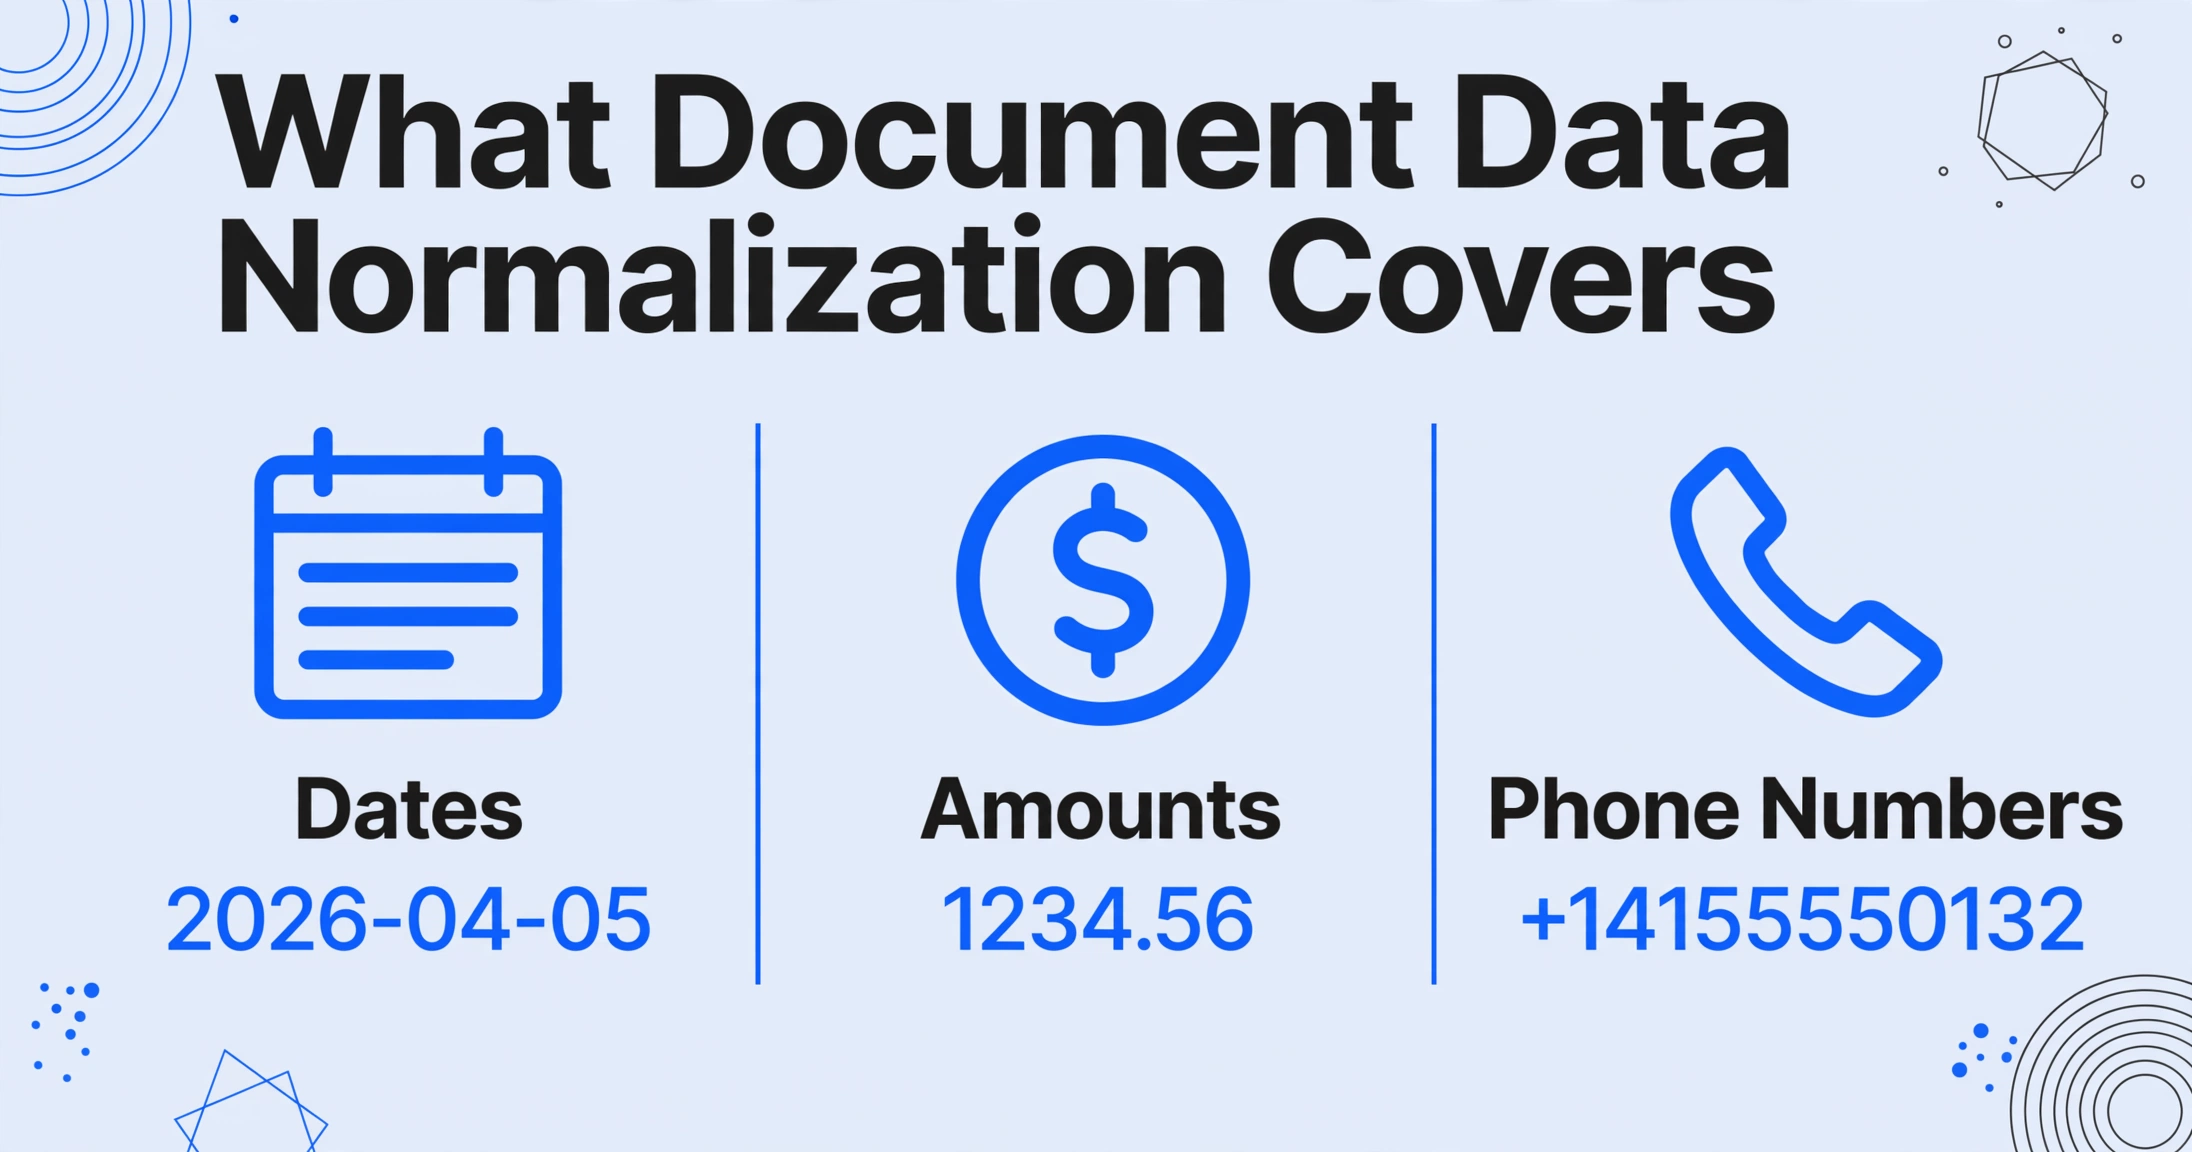
Dokumentdaten-Normalisierung standardisiert eine kleine Anzahl von Feldfamilien, und jede davon ist einem veröffentlichten Standard zugeordnet, sofern einer existiert. Die folgende Tabelle zeigt die Feldfamilien, die Variationen, die ein echtes Dokument tragen kann, und die kanonische Form, die ein normalisierter Export enthalten sollte.
| Feldfamilie | Variationen in echten Dokumenten | Kanonische Form | Standard-Anker |
|---|---|---|---|
| Daten | 04/05/2026, 05.04.2026, Apr 5 2026, 2026.04.05, „5th of April" | 2026-04-05 (eindeutig, keine Mehrdeutigkeit) | ISO 8601 3 |
| Beträge und Zahlen | $1.234,56, 1.234,56, 1234.56, ($47.99), $1,2 Mrd. | 1234.56, -47.99, 1200000000 (dezimal, Vorzeichen explizit) | ISO 4217-Währungscodes; Locale-Regeln |
| Telefonnummern | (415) 555-0132, +1 415 555 0132, 001-415-555-0132 | +14155550132 (Ländercode, ≤15 Ziffern) | ITU-T E.164 4 |
| Kennungen | INV-00123, #00123, 00123, INV 00123 | INV-00123 (ein Alphabet, ein Trennzeichen) | Interne Konvention |
| Entitätsnamen | ACME Corp, ACME Corporation, A.C.M.E., acme corp | ACME Corp (auf einen kanonischen Namen abgeglichen) | Stammdaten / Alias-Auflösung |
| Zeichenkodierung | café (vorkombiniert) vs. café (zerlegt), vollbreite ABC | Gleiche Bytes für denselben String | Unicode UAX #15 NFC/NFKC 5 |
Zwei dieser Familien verdienen einen genaueren Blick, da sie in fast jeder Extraktions-Batch auftauchen. Daten sind von Natur aus mehrdeutig: Dieselbe Ziffernfolge bedeutet in verschiedenen Locales unterschiedliche Tage – genau das Problem, das ISO 8601 beseitigen sollte. Die feste Reihenfolge Jahr-Monat-Tag sortiert korrekt, lässt sich zuverlässig parsen und kann nicht falsch gelesen werden, sobald man weiß, dass es ISO ist. Entitätsnamen sind der gegenteilige Fall: Es gibt keinen internationalen Standard für Firmennamen, daher besteht die Normalisierung darin, Suffixe und Groß-/Kleinschreibung zu vereinheitlichen und eine kurze Liste kanonischer Namen, die für Ihre eigenen Daten relevant sind, von einem Menschen pflegen zu lassen.
Wenn ein bestimmter Dokumenttyp Ihr Ziel ist, werden diese Feldregeln zu konkreten Betriebsabläufen. Für die Anwendung derselben feldbezogenen Standardisierung auf Lieferantenrechnungen führt Sie unser Leitfaden zur Standardisierung von Lieferantenrechnungen durch die vier Dimensionen der Formatabweichung in Kreditorenbuchhaltungsdaten, und der Leitfaden zum Vereinheitlichen von Rechnungen verschiedener Lieferanten behandelt die Konsistenz der Ausgabespalten über alle Lieferanten hinweg. Die Ratennormalisierung bei Frachtangeboten ist ein weiterer Fall derselben Disziplin, in diesem Vergleich von RFQ-Antworten. Dieser Artikel bleibt auf der Konzeptebene, auf der diese aufbauen.
Warum die Normalisierung von Dokumentdaten schwieriger ist als die Normalisierung von Text
Dokumentdaten sind schwieriger zu normalisieren als einfache Prosa, weil die Bedeutung des Werts vom Kontext abhängt, den der Text allein nicht trägt. Eine NLP-Pipeline normalisiert Wörter in laufenden Sätzen mit einem gemeinsamen Sprachmodell. Eine gescannte Rechnung ist ein anderes Problem – auf vier Achsen gleichzeitig.
Der Kontext muss abgeleitet, nicht gelesen werden. „04/05/2026" ist nicht auflösbar, bis Sie wissen, woher das Dokument stammt, in welcher Sprache es verfasst ist und manchmal auch, um welche Art von Dokument es sich handelt. Eine Stromrechnung aus Frankfurt und ein Kontoauszug aus Houston werden sich bei diesem Datum uneinig sein, und keiner von beiden ist „falsch". Ein Normalisierungsschritt, der ein Gebietsschema rät und stillschweigend fortfährt, ist die gefährlichste Variante des Prozesses.
Die Textebene ist verrauscht, bevor die Normalisierung überhaupt beginnt. NLP-Benchmark-Korpora sind sauberer Fließtext. Gescannte Dokumente stammen aus OCR, das „O" mit „0", „l" mit „1" verwechselt und Vollbreitenzeichen, geteilte Ziffern und Streusymbole ausgibt. Die Unicode-Normalisierung (UAX #15) behebt die Kodierungsvarianten, aber sie kann kein Zeichen korrigieren, das OCR als ein anderes Zeichen fehlgelesen hat: Das ist ein Erkennungsfehler, keine Formatvariation. Die Bildvorverarbeitung, eine separate Ebene, die vor der OCR-Engine läuft, bekämpft einen Teil desselben Rauschens von der Pixelseite, wie unser Leitfaden zur Bildvorverarbeitung vor OCR erklärt.
Die Werte sitzen in Tabellenstruktur, nicht in Sätzen. Ein Tokenizer segmentiert Sätze nach Satzzeichen und Leerzeichen. Ein Dokumentfeld wird über seine Beschriftung, seine Position oder seine Nachbarn identifiziert, und die Beschriftung selbst unterliegt demselben Normalisierungsproblem („Total", „TOTAL", „Amount Due", „Summe"). Werte zu normalisieren, bevor man weiß, welcher Wert zu welchem Konzept gehört, erzeugt eine saubere Tabelle mit falschen Spalten.
Mehrsprachige Dokumente mischen Konventionssysteme. Eine Rechnung kann einen deutschen Betrag („1.250,00"), ein englisches Datum („Jun 15, 2026") und einen Lieferanten enthalten, dessen Rechtsname Akzentzeichen verwendet. Jedes davon benötigt eine andere Regel, und die Regeln sind nicht austauschbar – weshalb Normalisierungspipelines, versioniert und konsistent angewendet, wichtiger sind als jeder einzelne clevere Regex.
So erkennen Sie, dass die Normalisierung fehlgeschlagen ist
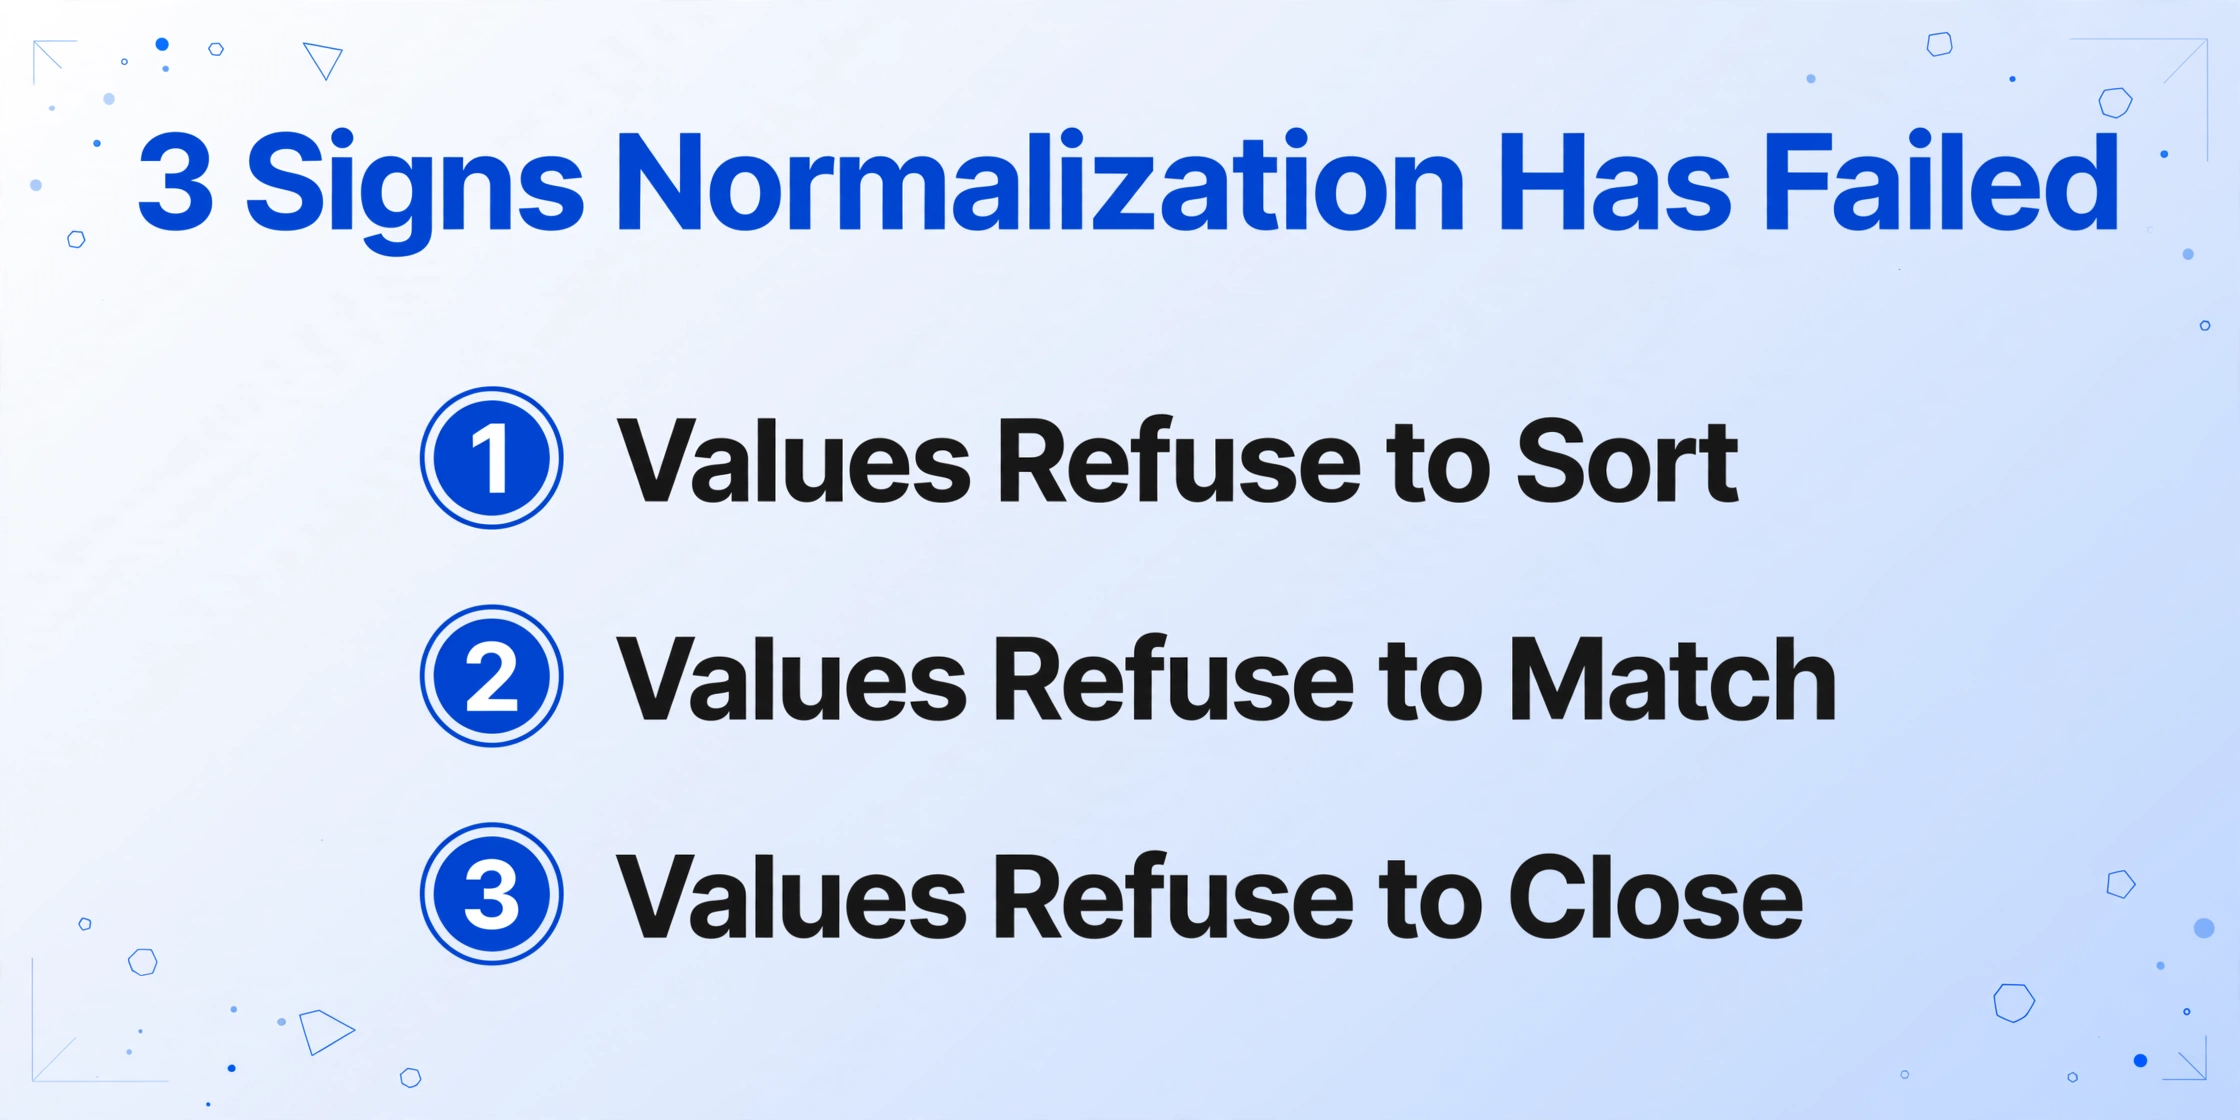
Sie können einen Fehler bei der Normalisierung in der Regel an drei Symptomen in der Ausgabetabelle erkennen: Werte, die sich nicht sortieren lassen, Werte, die sich nicht abgleichen lassen, und Werte, die sich nicht abschließen lassen.
Werte, die sich nicht sortieren lassen, sind fast immer gemischte Datums- oder Zahlenformate. Wenn Ihre Datumsspalte gleichzeitig "2026-01-03", "Jan 3, 2026" und "01/03/2026" enthält, schlägt die chronologische Sortierung fehl, obwohl jede Zeile korrekt ist. Der Nutzer, der beschrieb, dass er zwei bis drei Stunden pro Monat für die Bereinigung von Bankexport-Daten, Lieferantennamen und Beträgen aufwendet, beschrieb genau das6. Das Sortieren einer Spalte mit gemischten Formaten ergibt eine Liste, die nach den Ziffern der Zeichenfolge geordnet ist, nicht nach der Zeit.
Werte, die sich nicht abgleichen lassen, bedeuten, dass die Entitätsnormalisierung fehlgeschlagen ist. VLOOKUP und Deduplizierung basieren auf identischen Zeichenfolgen, sodass "AMZ*234KL PRIME" und "Amazon Prime" als zwei Lieferanten aufgeteilt werden und eine Pivot-Tabelle elf Schreibweisen eines Lieferanten anzeigt. Beim Abgleich leisten die Bereinigung auf Zeichenebene und die Alias-Auflösung unterschiedliche Arbeit: Die Unicode-Normalisierung macht die Zeichenfolgen byte-identisch, aber nur die Alias-Auflösung weiß, dass die beiden Zeichenfolgen dasselbe Unternehmen benennen.
Werte, die sich nicht abschließen lassen, sind der teure Fehler: Die Zahlen stimmen, können aber nicht summiert oder verglichen werden, weil sie als Text mit Währungssymbolen, Klammern oder Gebietsschema-Trennzeichen gespeichert sind. "($47.99)" als Text geparst wird sich nie von einer Summe abziehen lassen, und "1.250,00" und "1,250.00" werden als zwei verschiedene Größen behandelt. Eine Summenspalte, die nicht dem angegebenen Rechnungsbetrag entspricht, ist in der Regel ein Zeichen dafür, dass Menge und Stückpreis mit unterschiedlichen Trennzeichen-Konventionen geparst wurden.
Der günstigste Weg, alle drei auf einmal zu erkennen, ist eine einzige Invariante: eine Gegenprüfung gegen einen Wert, den das Dokument selbst angibt. Wenn die Positionen nicht zur gedruckten Summe aufsummieren oder der Kontoauszugssaldo nicht mit den Transaktionen übereinstimmt, ist die Normalisierung (oder Erkennung) irgendwo vorgelagert fehlgeschlagen. Abweichungsflags schlagen das Prüfen von Formaten jedes Mal.
Muss die Normalisierung nach der Extraktion erfolgen?
Die Normalisierung muss in Excel kein separater manueller Schritt sein. Wenn der Extraktionsschritt versteht, was ein Feld bedeutet, kann er die kanonische Form gleichzeitig mit dem Wert ausgeben. Hier verbindet sich das Bild der Dokumentverarbeitung in diesem Artikel mit einem konkreten Tool.
ImageToTable.ai ist ein KI-Dokumentextraktionstool, das auf dem Benutzerdefinierte Spaltenextraktion-Muster basiert: Sie geben die gewünschten Feldnamen ein, z. B. „Invoice Date" oder „Total Amount", und die KI findet jeden Wert, indem sie versteht, was er bedeutet, statt wo er auf der Seite steht. Die intelligente Nachbearbeitung kann Daten, Beträge und Seriennummern während desselben Extraktionsdurchgangs in das von Ihnen angegebene Format normalisieren, sodass die Ausgabe in Excel, CSV oder JSON bereits in kanonischer Form landet, statt eine zweite Bereinigungsrunde zu benötigen Dokument-Parsing-Workflows, die es verwenden. Für einen breiteren Rahmen der zugrunde liegenden Idee Referenz zum Konzept der Datenerfassung behandelt, wie unstrukturierte Dokumente zu strukturierten Datensätzen werden.
Die Normalisierung zum Zeitpunkt der Extraktion funktioniert, weil das Feld durch Semantik identifiziert und das Format durch Anweisung angewendet wird. Sie benennen die Spalte „Invoice Date (YYYY-MM-DD)" und die KI liest die jeweilige Datumskonvention des Dokuments und gibt das Datum dann im gewünschten Format aus. Derselbe Durchgang kann eine einheitliche Dezimalkonvention für Beträge und ein einheitliches Kennungsformat für Referenznummern durchsetzen. Jede davon ist die feldebene Normalisierung aus der obigen Tabelle, die während der Extraktion ausgeführt statt danach korrigiert wird.
Diese Grenze sollte klar benannt werden: Die Nachbearbeitung des Tools standardisiert das Format extrahierter Werte, und es kann Werte während der Extraktion berechnen oder ableiten. Es beansprucht nicht, eine Wort-für-Wort-NLP-Normalisierungspipeline auszuführen, und es führt keine Entitätsauflösung gegen eine von Ihnen gepflegte Master-Datenbank durch. Entitätsnamen sind die Familie, in der menschlich gepflegte kanonische Listen die letzte Arbeit übernehmen, insbesondere in Prüfungs- oder Compliance-Kontexten.
Häufig gestellte Fragen
Ist Textnormalisierung dasselbe wie Datenbereinigung?
Nein, auch wenn beides meist zusammenläuft. Bereinigung entfernt Rauschen und Fehler: OCR-Lesefehler korrigieren, überflüssige Satzzeichen entfernen, fehlende Werte behandeln. Normalisierung nimmt gültige Variationen und legt sie auf eine einzige Darstellung fest: Drei korrekte Schreibweisen eines Datums werden zu einer. In der Praxis bereinigt eine Pipeline zuerst und normalisiert danach, denn die Normalisierung einer Zeichenkette, die noch OCR-Fehler enthält, erzeugt nur einen ordentlich aussehenden falschen Wert.
Wie parse ich ein mehrdeutiges Datum wie 04/05/2026?
Entscheiden Sie, welche Konvention das Dokument verwendet, bevor Sie parsen, und legen Sie dies in der Extraktionsregel klar fest. Ein Kontoauszug aus den USA verwendet Monat-zuerst; eine europäische Stromrechnung verwendet Tag-zuerst; Sprache und Land des Dokuments verraten Ihnen meist, welche Variante gilt. Ganz ohne Kontext ist ein Flag für die manuelle Prüfung der sichere Weg statt einer stillen Annahme. ISO 8601 existiert genau dafür, damit das Ergebnis dieses Problem nicht mehr hat.
Können Excel Power Query oder OpenRefine diese Normalisierung nicht übernehmen?
Das können sie, sobald die Daten bereits in Tabellenform vorliegen. Die Lücke liegt vorgelagert: Power Query kann kein PDF einer gescannten Rechnung lesen, und OpenRefine erfordert, dass Sie wissen, welche Spalte welche ist, bevor es sie transformieren kann. Sie bleiben hervorragende Werkzeuge für den Fall, dass Ihre Pipeline-Ausgabe bereits strukturiert ist und Sie weitere geschäftliche Transformationen durchführen.
Führt das Tool eine vollständige NLP-Normalisierungspipeline aus?
Nein. Das Produkt standardisiert das Format extrahierter Feldwerte während der Extraktion und benennt die Grenze ehrlich: Es führt keine Tokenisierung, Stemming, Entitätsauflösung oder benutzerdefinierte Zuordnung zu Ihren Stammdaten durch. Das gehört in spezielle NLP- und Datenmanagement-Tools. Hier ist das Ziel, dass die Daten, Beträge und Seriennummern in Ihrer exportierten Tabelle bereits im ersten Durchlauf ein einheitliches kanonisches Format aufweisen.
Die Idee, die diesen Artikel nützlich macht, ist klein und strukturell. Ein Format ist eine Entscheidung, die jemand einmal getroffen hat, und Normalisierung ist der Akt, sie überall dort neu zu treffen, wo ein Dokument gelesen wird. Wenn die Entscheidung von einem wöchentlichen Excel-Ritual in den Extraktionsschritt selbst wandert, ist die Tabelle, die Sie öffnen, bereits die Tabelle, die Sie wollten, und die drei Fehlersymptome – Sortieren, Abgleichen und Abschließen – tauchen in Ihrem Monatsabschluss nicht mehr auf.