返品はデジタルだが
そうでなくなる瞬間がある
顧客がブランドのポータルで「返品を開始」をクリックする。システムは注文を検証し、ポリシーを確認し、配送ラベルを生成し、RMA番号を発行する—すべて5秒以内に完了する。返品は在庫を更新し、顧客に通知し、倉庫に到着準備をさせる追跡パイプラインに入る。すべてのステップがデジタルで、自動化され、リアルタイムだ。そして荷物がドックに到着し、誰かが開封し、紙のRMA伝票—またはポータル出力のPDFプリントアウト—を取り出して、タイピングを始める。その瞬間が返品のデータの事象の地平面だ:それ以前はすべてデジタル、それ以降はすべて手入力、断絶したスプレッドシート、そして静かなデータ損失の深淵に落ちていく。そして誰もその深淵がいくらかかっているかを測定していない。
重要なポイント
- 返品ポータルはRMAを自動生成し、在庫を検証し、6秒でWMSにウェブフックを送信する—その後、荷物がドックに到着し、誰かが紙の伝票からそれらのフィールドをすべて手で再入力する。時給$25.83で。
- 1日500件の返品で、手動のRMA再入力はどのシステムにも新しい情報を一切追加しない10時間の労働を消費し、2%の入力ミス率が静かに在庫を誤ルーティングし、返金を遅らせ、サプライヤーのチャージバックを失わせる。
- 解決策は別のポータルやWMSアップグレードではない—フォーム自体からRMAデータを構造化スプレッドシートに抽出し、データ入力ステップを10時間の再入力から、すべての下流システムに自動的に供給する1回のバッチアップロードに削減することだ。
クリップボードに載る8500億ドルの問題
米国の小売返品は2025年に8499億ドルに達しました。これは全米小売業協会の2025年リテール返品情勢レポート(Happy Returnsとの共同発行)によるものです。Eコマースの返品だけでオンライン売上の19.3%を占め、およそ5件に1件の注文が戻ってきます。アパレルは25%、フットウェアは31%に迫り、ホリデー後のピーク期には返品量が通常の1日の平均の3〜5倍に急増します。NRFが売上5億ドル超の事業者で働く358人のEコマース専門家を対象に行った調査では、64%が今後6か月以内に返品プロセスの更新を優先すると回答しています。
しかし、これらの調査回答者が主に話しているのは顧客向けのレイヤー、つまり返品ポータル、ラベル生成、ドロップオフネットワーク、不正検出です。倉庫向けのレイヤー、つまり物理的な返品が在庫・会計システムのデータレコードになる瞬間は、この議論から明らかに欠落しています。パッケージがドックに到着した瞬間、ポータルからのデジタルな痕跡は途絶えてしまうのです。
標準的な返品処理ステーションでは、担当者がパッケージを受け取り、開封し、RMA書類を探します。顧客のポータル提出から印刷されたページ、出荷に添付されたPDF、または一部のB2B・製造業の文脈では手書きの承認フォームです。その後、担当者はRMA番号、注文番号、SKU、理由コード、状態、処分区分の指示を読み取り、各フィールドをWMS(倉庫管理システム)、追跡用スプレッドシート、またはその両方に打ち直します。業界の見積もりでは、この手動入力ステップは返品1件あたり60〜90秒かかります。1日500件の返品、つまり1月の中小規模の3PLの処理量では、システムに新しい情報を一切追加しない純粋なデータ再入力に8〜12時間かかることになります。これは転記であり、処理ではありません。
ドックで行き止まりになる6秒のデジタルプロセス
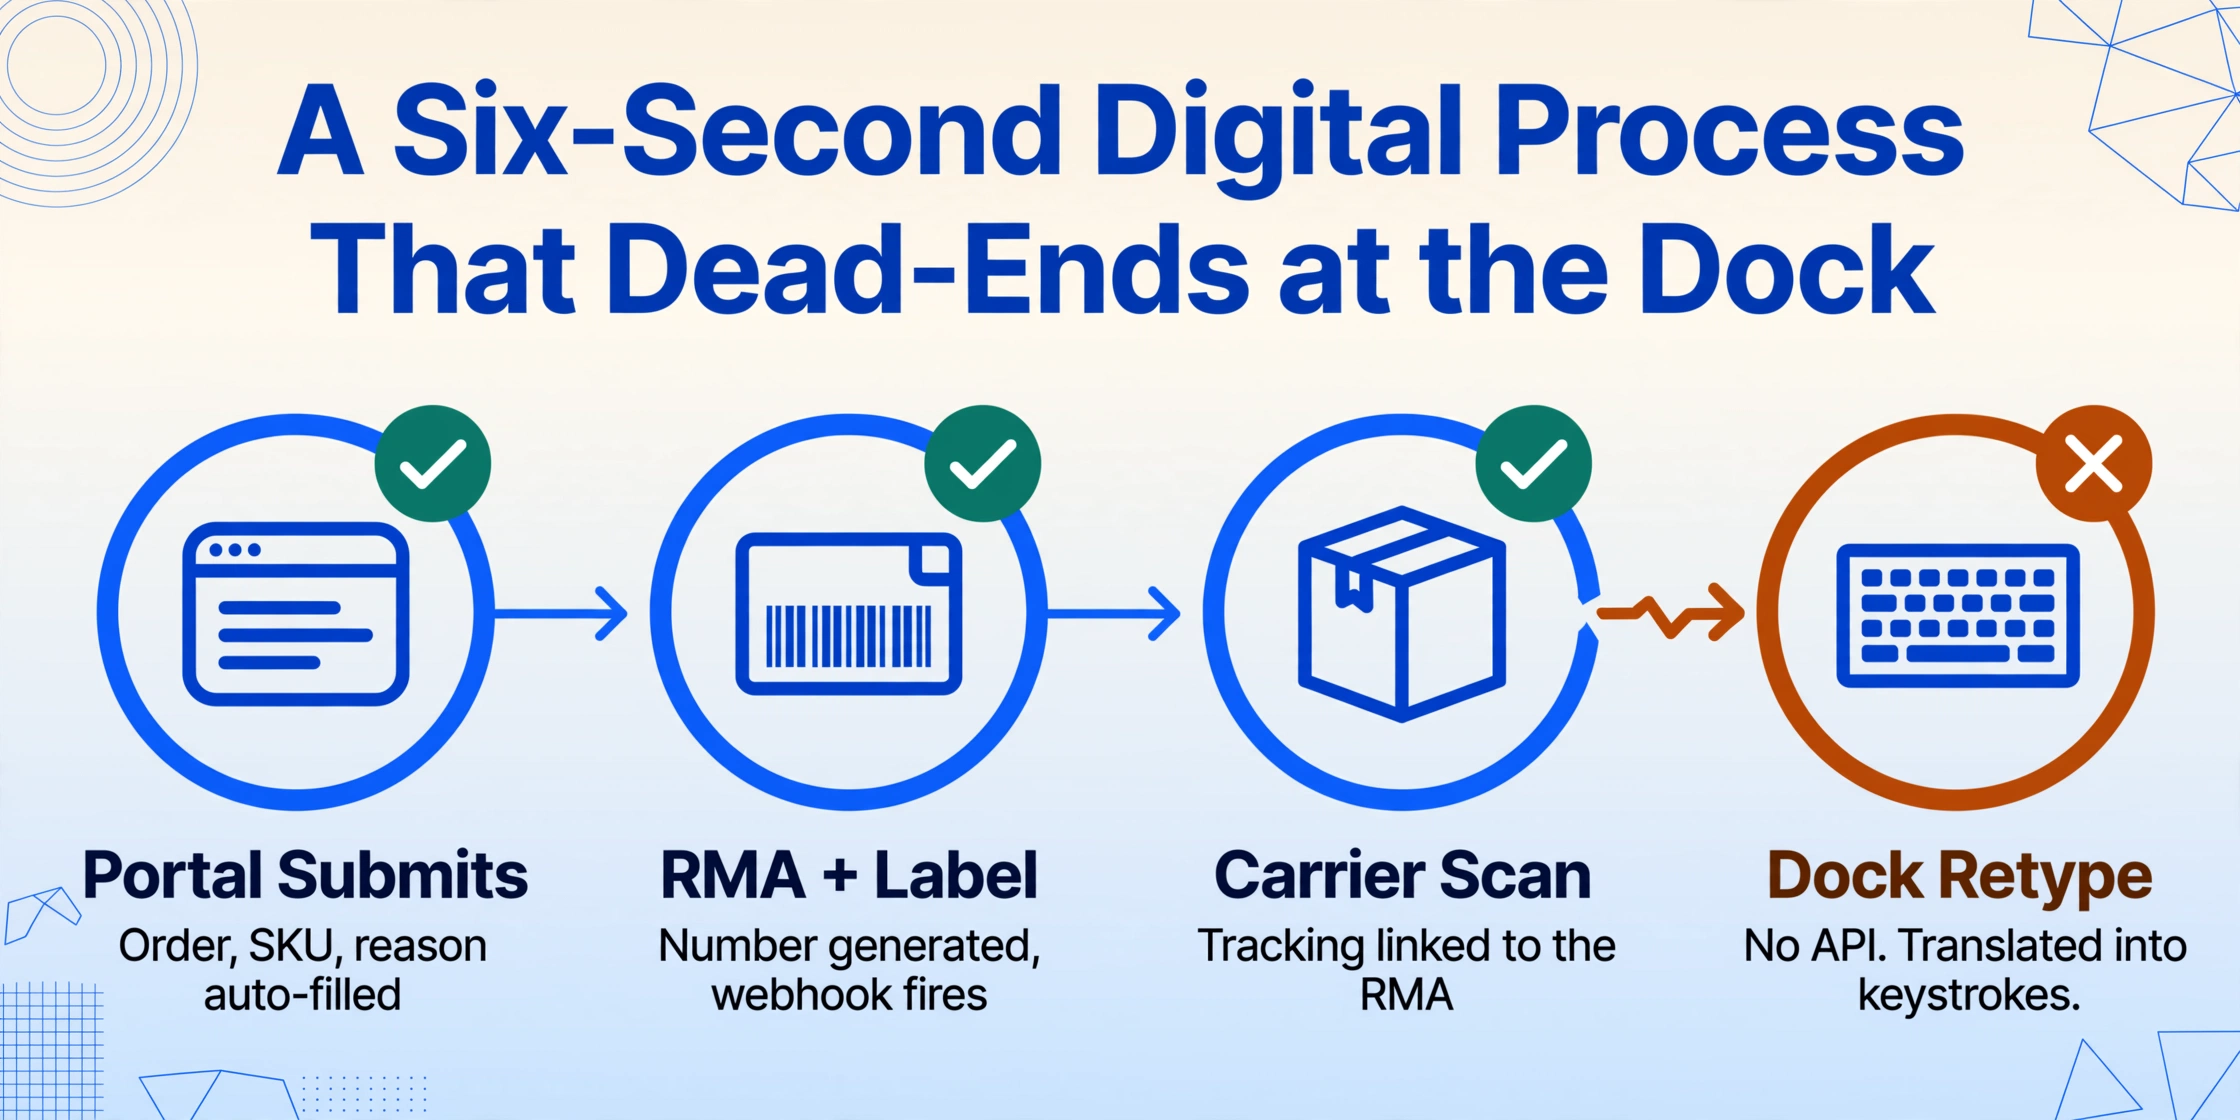
この断絶がなぜ存在するのかを理解するには、1件の返品をチェーン全体を通して追跡し、データの移動が止まる正確な瞬間を確認する必要があります。
返品のライフサイクルの最初の15分間、データフローはシームレスです。顧客はポータル(Loop Returns、ReturnGO、AfterShip、またはShopify標準のフォーム)を通じて返品リクエストを送信し、システムはEコマースプラットフォームから注文番号、顧客名、SKU、元の購入日を自動入力します。ドロップダウンから返品理由コードを追加します。RMA番号と配送ラベルを生成します。ウェブフックがWMSまたは注文管理システムに発火し、保留中のRMAレコードを作成します。パッケージはRMAにリンクされた追跡番号とともにキャリアネットワークに入ります。
その後、箱が倉庫に到着し、データフローが断絶します。この自動生成されたRMAレコードには、検査結果を追加する必要があります。つまり、商品の実際の状態、顧客が申告した理由との一致、付属品の有無、再販可能か修理が必要かといった情報です。これらの観察結果はRMAフォーム自体に存在します。検査員が走り書きしたメモ、印刷された伝票に付けられたチェックマーク、隅にある「REFURB」スタンプなどです。そして、そのフォームは、物理的な紙であれタブレット画面のPDFであれ、WMSとは異なる言語を話します。APIはなく、その内容をキーストロークに変換するには人間が必要です。
r/Netsuiteのある投稿がこの状況を的確に捉えています。「RMAプロセスが2人分のフルタイムの仕事になっている。返品が発生するたびに、顧客がメールを送り、誰かが手動で承認し、さらに手動でラベルを生成している」。一方、r/supplychainでは、成長中の流通業者がより率直に表現しています。彼らの返品プロセスは「会社を蝕んでいた」と——手作業のRMAワークフロー、ベンダー与信調整の悪夢、そして倉庫のボトルネックが規模拡大とともに集中していたのです。これは、悪いソフトウェアに対する不満ではありません。彼らが説明しているのは構造的なギャップです。つまり、フロントエンドのRMAシステムが生成するデータを、バックエンドの倉庫システムが、人間の仲介者がすべてのフィールドを打ち直さなければ取り込めない、というギャップです。
返品ポータルと倉庫の現場は、たった一人の頼りない翻訳者——紙のフォームを手にした人間——を通じてのみ、互いに会話しているのです。
なぜデジタルチェーンは完成しなかったのか
これは怠慢の話ではありません。システムの二つの半分が異なる速度で進化し、その継ぎ目が両側から見えなくなってしまった話です。顧客向けの返品の半分は、過去10年間で3つのデジタル化の波を経験してきました。第一に、メールと電話によるRMAからセルフサービスポータルへの移行。第二に、それらのポータルと配送キャリアを統合し、自動ラベル生成を実現したこと。第三に、不正検出や交換促進のためのAIのレイヤー化です。Loop Returns、ReturnGO、Happy Returnsは、それぞれこの進化のスタックの一部です。
倉庫向けの半分は、異なるリズムで進みました。倉庫管理システム(WMS)——Cin7、Fishbowl、ShipBob、SkuVault——は、ピッキング、梱包、出荷を最適化するために構築され、返品処理は二次的なモジュールとして追加されました。ほとんどのWMSプラットフォームにおける返品ワークフローは、誰かがデータをキー入力するか、すでに入力された情報を持つバーコードをスキャンすることを前提としています。箱から取り出したRMA伝票に対しては、どちらの前提も成り立ちません。
構造的なミスマッチはこれです。返品ポータルは、顧客体験のために構築された形式——ブランド化されたメール、ポータルのダッシュボード、キャリアの追跡API——でデータを出力します。WMSプラットフォームは、在庫運用のために構築された形式——SKUレベルのトランザクション、保管場所の更新、会計仕訳——でデータを消費します。この二つの世界を結ぶ標準的なアダプターは存在しないため、すべての倉庫が独自のアダプターを構築することになります。つまり、キーボードを持った人間です。
NRFの返品レポートは、64%の販売業者が返品プロセスの更新を優先事項としていると指摘しています。しかし、このレポートはほぼ専ら顧客側——返品手数料、返却場所の利便性、不正検出——に焦点を当てています。倉庫へのデータ引き継ぎは、顧客向けの調査には現れない返品問題であり、そのためロードマップにも現れません。それは損益計算書に、人件費と在庫評価損の中に埋もれて初めて姿を現すのです。
手入力の実際のコスト
1日500件の返品を処理し、1件あたり75秒の手動データ入力を行う場合、1日あたり10.4時間の労働が、新しい情報を生み出さないタスクに費やされることになります。米国労働統計局の2026年3月時点の倉庫業の平均時給25.83ドルで計算すると、1日あたり約269ドル、年間7万ドルに相当します——たった1シフト分でです。2シフト体制で週7日稼働する3PL(サードパーティロジスティクス)の場合、ピークシーズンの残業代を考慮する前で、年間約20万ドルに達します。
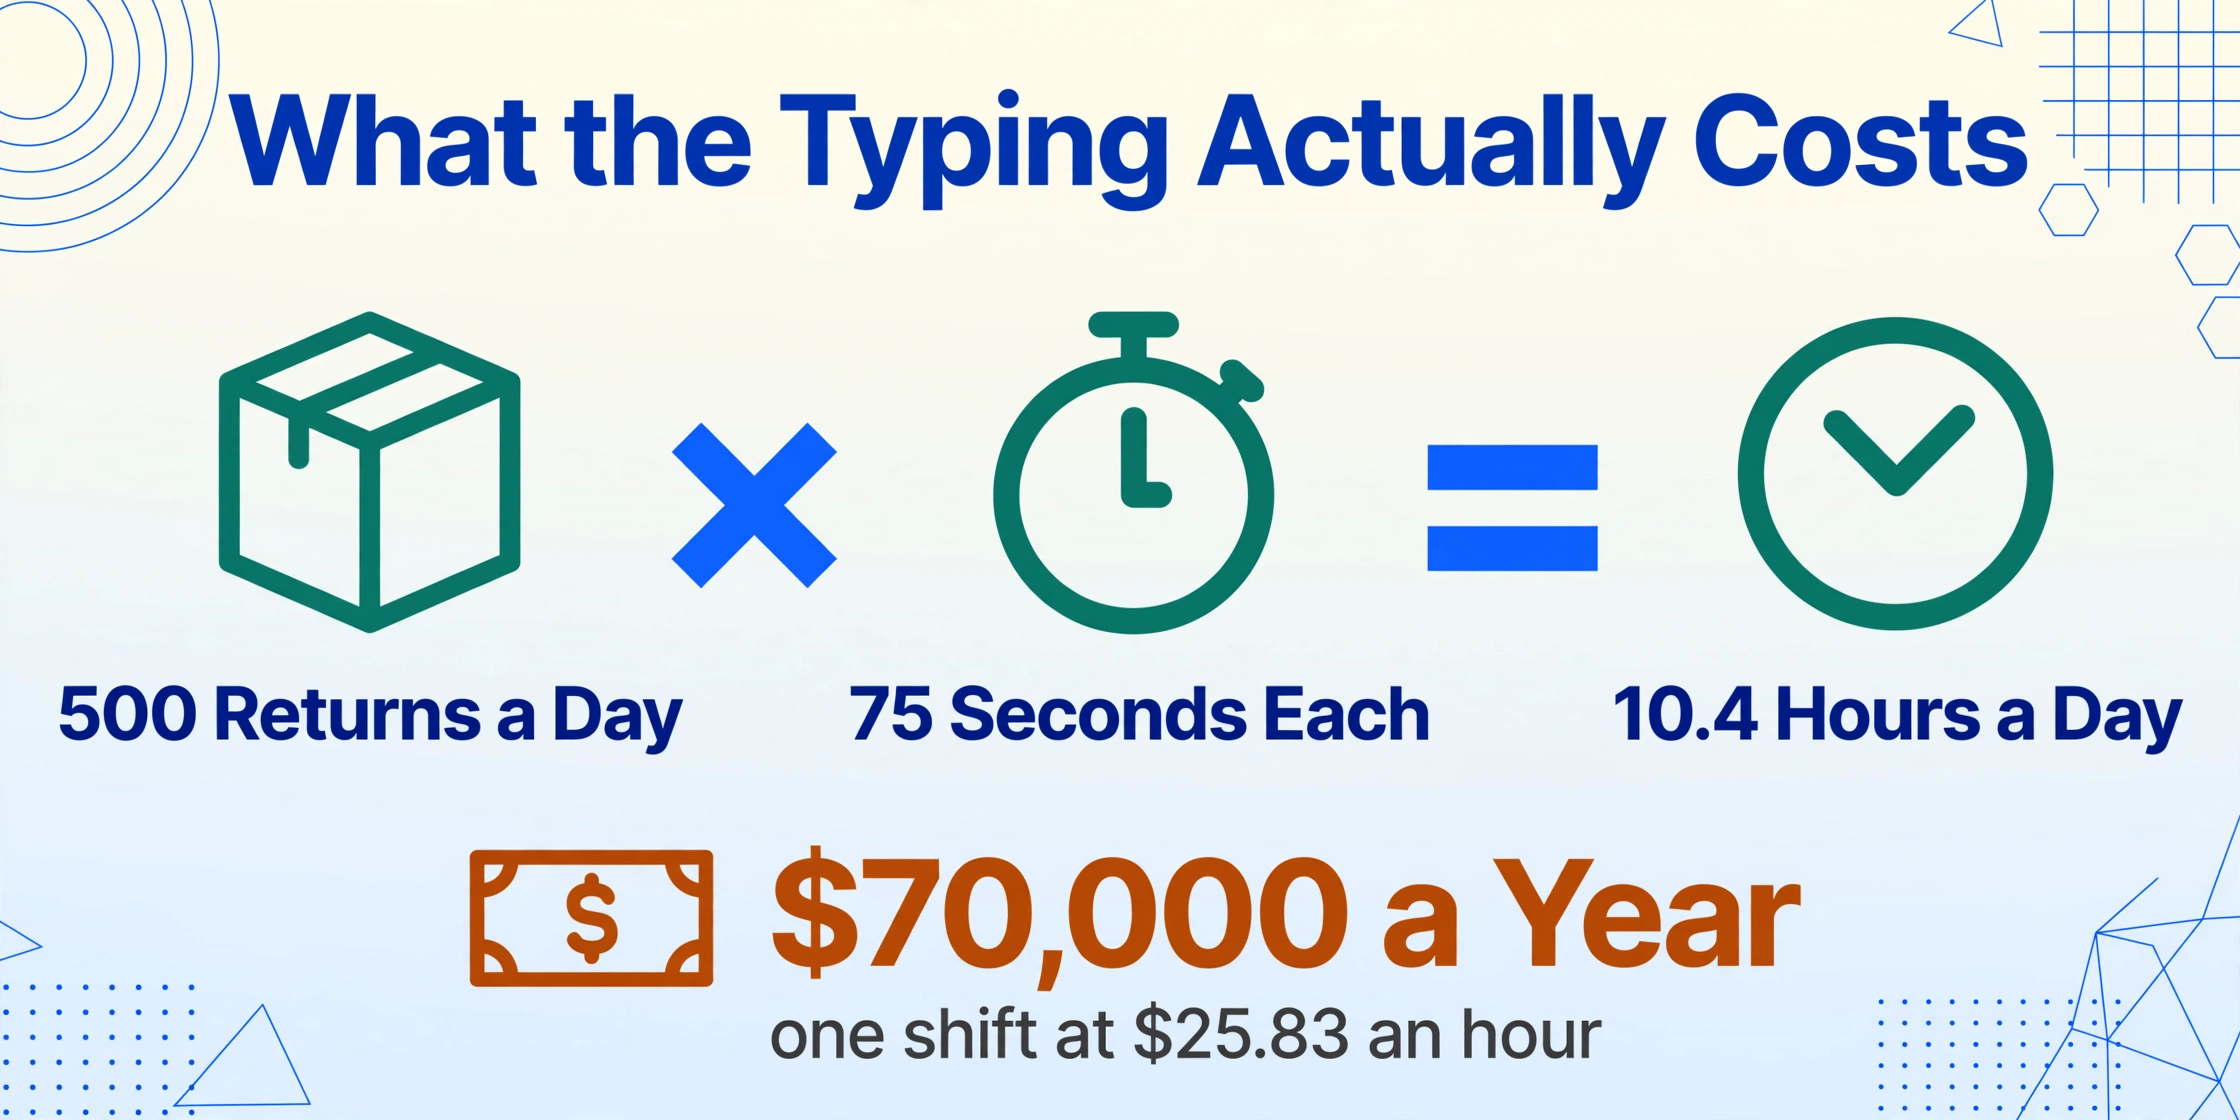
しかし、人件費は目に見えるコストにすぎません。目に見えないコストは静かに積み重なっていきます:
入力ミスは下流に連鎖します。 理由コードの入力ミス——「サイズが合わない」ではなく「不良品」と入力——により、商品は在庫に戻る代わりにベンダー返品レーンに送られ、不要な輸送費が発生し、再入庫が数日遅れます。SKUの数字の桁違いは、誤った商品を誤った棚にルーティングします。業界データによると、手動データ入力のエラー率は、フォームの複雑さにもよりますが、おおよそ1〜4%です。8〜12項目(RMA番号、注文番号、顧客名、SKU、数量、理由コード、状態、処分区分)のRMAフォームの場合、2%のエラー率は500件の返品につき10件のミスを意味し、それぞれが元の入力よりも時間がかかる例外処理ループを必要とします。
データの遅延により返金が遅れます。 顧客は、キャリアのスキャンで「配達済み」と表示されてから数日以内に返金を期待します。しかし、RMAデータがシステムに入力されていなければ、財務チームは返金を開始するきっかけを得られません。返品は処理の途中で滞留します——物理的には受け取られ、デジタル上では見えない状態です。NRFとHappy Returnsのデータによると、消費者の82%が無料返品を重要視しており、57%が返品体験が悪い小売業者を離れています。悪い返品体験とは、荷物がブラックホールに消えてしまうような体験です。そのブラックホールは、多くの場合、データ入力を待って受信箱トレイに置かれた紙のフォームにすぎません。
サプライヤーへのチャージバックは、デジタル化されなかったRMAデータに依存しています。 多くの返品はメーカーの欠陥に遡ります。製品が保証期間内に故障した場合、RMAフォームの検査メモ——理由コード、状態、写真——がサプライヤーへのデビットメモの裏付け書類になります。これらのメモが紙のまま残っているか、誰もERPに抽出しないPDFに埋もれている場合、チャージバックは申請されません。Appriss Retailの2026年小売損失総額ベンチマークによると、2025年には約1,000億ドルの予防可能な詐欺・悪用損失が発生し、返品悪用だけで860億ドルを占めています。不審な返品パターンをリアルタイムでフラグできない紙ベースのRMAプロセスは、詐欺が悪用する隙間なのです。
在庫精度が低下します。 Eightx 2026年のデータによると、返品された商品のうち定価で再販されるのはわずか約48%です。残りの52%は、リファービッシュ、転売、返品、寄付、廃棄といったルーティング判断が必要で、これらはRMAフォームに記録された検査データに依存します。そのデータがシステムにない場合、ルーティング判断は最も遅く安全な経路である「レビュー保留」にデフォルト設定され、実際には商品は返品ステージングエリアに置かれ、日々価値を失います。1億件以上の返品を処理してきたリバースロジスティクスプラットフォームであるOptoroは、処理コストが商品の元の価格の20〜39%を消費すると推定しており、そのコストのかなりの部分は、手動データ処理によって生じる労力と遅延です。
修正は別のポータルではない
RMAデータフロー全体(顧客ポータル→キャリアスキャン→倉庫受領→検査→WMS更新→会計仕訳→返金トリガー→在庫調整)を追跡すると、1つのステップを除いてすべてがデジタル化され、API接続されています。手動のまま残っている唯一のステップは、RMAフォーム自体から倉庫または会計システムへのデータ抽出です。フォームは、その起源(ポータルPDF、スキャンされた紙の伝票、手書きの承認)に関係なく、デジタル返品とデジタル倉庫の間に位置します。そのギャップを埋めれば、チェーン全体が自動化されます。
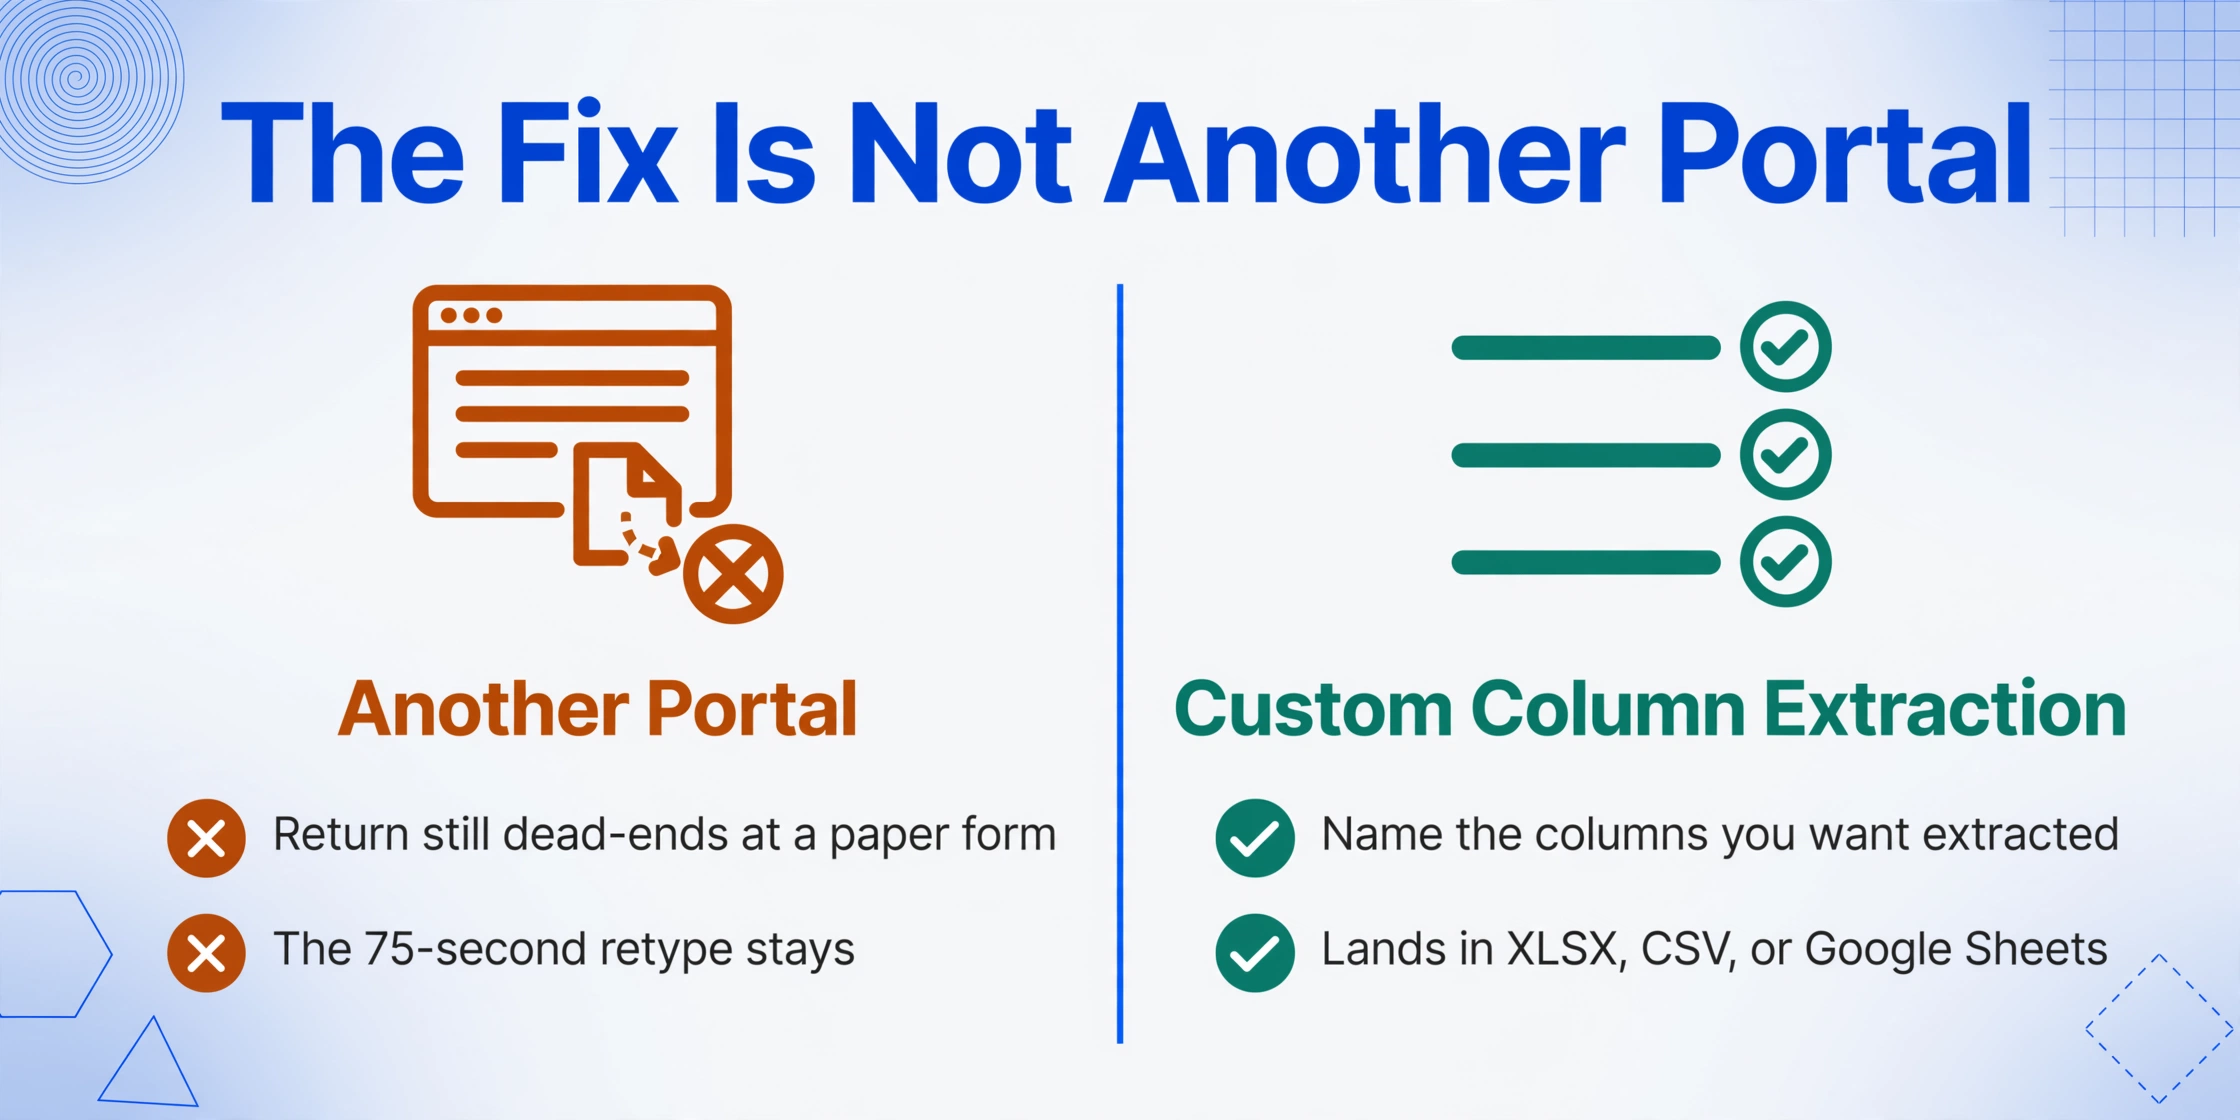
これは統合の問題ではありません。統合は、両側が共通のプロトコルを話すことを前提としています。RMAフォームはプロトコルを話しません。それは視覚的な成果物です。解決策は、フォームとシステムの間の抽出レイヤーです。つまり、人間が読むようにフォームの内容を読み取り、WMS、ERP、またはスプレッドシートが直接消費できる構造化データとして出力するものです。
ここでカスタム列抽出が状況を変えます。フォームフィールドの周りにボックスを描いたり、サンプルRMAレイアウトでモデルをトレーニングしたりするアプローチ(サプライヤーがフォーム形式を変更するとすぐに壊れる)の代わりに、列に名前を付けて抽出したいものを定義します:「RMA番号」、「注文番号」、「SKU」、「理由コード」、「状態」、「処分区分」。AIはフォームを意味的に読み取ります。「RMA #」と「承認番号」が同じ意味であることを理解し、各項目がページのどこに表示されるかは関係ありません。Shopify生成のPDF、スキャンされた手書きの伝票、完全に異なるレイアウトのベンダー独自の返品承認のいずれであっても関係ありません。出力は、あなたの命名規則に一致する列ヘッダーを持つ構造化スプレッドシートであり、任意のWMSまたは会計システムにインポートする準備ができています。このワークフローは、RMAからExcelへの変換ツールページで実際に確認できます。
1日500件の返品を処理する倉庫の場合、データ入力ステップが10時間から、スキャンまたは撮影されたRMAフォームのバッチをアップロードして「処理」をクリックする時間に短縮されます。抽出されたデータは再入力の必要がなく、転記エラーも蓄積されず、チームがすでに使用している同じ追跡スプレッドシートまたはWMSに流れ込みます。返金照合ワークフローへの適合について詳しくは、RMAフォームを1つの照合シートにバッチ処理するの内訳を参照してください。
そして、抽出されたRMAデータはすでに構造化されているため(標準化されたSKU、理由コード、処分区分フィールド)、在庫システムへの供給は直接インポートであり、再入力作業ではありません。RMAフォームから在庫システムへのパイプラインは、漏斗ではなくフィードになります。
より広い視点で言えば、RMAの紙問題は、より良いポータルを導入したりWMSをアップグレードしたりするだけでは解決しません。「フォームを読む」ことと「データに基づいて行動する」ことを切り離すことで解決するのです。この2つのステップが分離されれば、フォームはPDF、スキャン、写真、手書きなど何でもよく、下流のシステムはフォームを見ることがないため、その形式を気にする必要がありません。彼らが見るのはスプレッドシートです。
抽出データの格納先
RMA抽出の出力は、特定のシステムに縛られるものではありません。XLSX、CSV、またはGoogle Sheetsへの直接出力といったスプレッドシート形式です。次にどこへ送るかは、お客様のシステム構成によって異なります:
一貫したパターン:抽出レイヤーが「フォームを読む」ことと「データに基づいて行動する」ことを切り離します。データが最終的にNetSuite、ShipStation、共有Google Sheetsのどこに格納されるかは下流の決定事項であり、抽出のセットアップ方法は変わりません。1つの抽出設定がすべての宛先で機能します。同じワークフローでRMAデータを仕入先請求書処理で補完するには、eコマース在庫元帳への仕入先請求書のバッチ処理を参照して、単一の抽出パイプラインが同じ在庫システムに供給される複数のドキュメントタイプをどのように処理できるかを理解してください。
よくある質問
手書きのRMA伝票でも機能しますか?
はい。AIは文字を認識するだけでなく、書かれた内容を理解することで、筆記体や混在する手書き文字を含む手書きを読み取ります。紙の伝票に手書きされたRMA番号や理由コードも、印刷されたものと同じように読み取られます。とはいえ、人間にも判読できないような極端に読みにくい手書きは、どんな読み手にとっても難しいのと同様に、AIにとっても課題となります。倉庫スタッフが読んで打ち直せる程度の判読可能な手書きであれば、十分に対応できます。
抽出したデータをNetSuite / Shopify / 自社のWMSに直接インポートできますか?
はい、各プラットフォームの標準インポート機能を通じて可能です。抽出結果は構造化されたスプレッドシート(XLSXまたはCSV)で、主要なWMS(倉庫管理システム)やERPはすべてインポート形式としてサポートしています。カスタムAPI連携は不要です。列のマッピングを一度設定するだけです — RMA番号をNetSuiteのRMAフィールドに、SKUを在庫レコードに、処分区分をルーティングキューに — 同じマッピングをすべてのバッチで再利用できます。
サプライヤーごとにRMAフォームの形式が異なる場合はどうなりますか?
それがセマンティック抽出の核となる価値です。AIは位置やテンプレートではなく意味で読み取るため、フォームの形式は問いません。ベンダーAがRMA番号を右上に配置し、ベンダーBがテーブルのヘッダー行に配置していても、抽出ロジックは同じです。「RMA番号」という概念に一致するデータを見つけるだけです。同じ原則がサプライヤー請求書処理にも適用されます。そこではベンダー間の形式のばらつきが当たり前です。
倉庫のタブレットやスマートフォンで撮影したRMA写真はどうですか?
スキャンやPDFと同様に、写真もサポートされています。倉庫スタッフはタブレットやスマートフォンでRMA伝票を撮影し、その画像を直接アップロードできます — 高解像度スキャンだけでなく、写真からも抽出が機能します。つまり、データ入力のステップを受入ドックでその場で完了でき、紙のフォームを中央のデータ入力デスクに回送する必要がありません。
手動入力と比較して、抽出精度はどのくらいですか?
クリーンなフォームレイアウトの印字テキストでは、最大99%の認識精度に達します。手書きのフォームや低品質の写真では精度が低下しますが、重要な比較対象は手動入力です。手動入力自体にも推定1~4%のエラー率があります。違いは、抽出エラーが一貫しており、確認可能であることです。つまり、何がフィールドごとに抽出されたかを正確に確認でき、修正が必要な場合は、誤入力された数字のようにシステム内で静かに伝播するのではなく、人間によるレビューのためにフラグが立てられます。