Retouren sind digital – bis
sie es nicht mehr sind
Ein Kunde klickt in einem Markenportal auf „Retoure starten“. Das System validiert die Bestellung, prüft die Richtlinie, erstellt ein Versandlabel und vergibt eine RMA-Nummer – alles in unter fünf Sekunden. Die Retoure gelangt in eine Tracking-Pipeline, die den Bestand aktualisiert, den Kunden benachrichtigt und das Lager auf die Ankunft vorbereitet. Jeder Schritt ist digital, automatisiert und in Echtzeit. Dann erreicht das Paket das Dock, jemand öffnet es, zieht einen Papier-RMA-Schein – oder einen PDF-Ausdruck eines Portal-Exports – heraus und beginnt zu tippen. Dieser Moment ist der Daten-Ereignishorizont der Retoure: Alles davor ist digital, alles danach fällt in einen Abgrund aus manueller Eingabe, getrennten Tabellenkalkulationen und stillem Datenverlust. Und niemand misst, was dieser Abgrund kostet.
Wichtigste Erkenntnisse
- Ihr Retourenportal generiert die RMA automatisch, validiert den Bestand und sendet in sechs Sekunden einen Webhook an das WMS (Warehouse Management System) – dann landet das Paket am Dock und jemand tippt jedes dieser Felder manuell von einem Papierschein ab, zu 25,83 $ pro Stunde.
- Bei 500 Retouren pro Tag verbraucht die manuelle RMA-Neueingabe 10 Stunden Arbeit, die keinerlei neue Informationen zu irgendeinem System hinzufügt, während die 2%ige Tippfehlerquote stillschweigend den Bestand falsch leitet, Rückerstattungen verzögert und Lieferanten-Rückbelastungen verfallen lässt.
- Die Lösung ist kein weiteres Portal oder WMS-Upgrade – sondern die Extraktion der RMA-Daten aus dem Formular selbst in eine strukturierte Tabelle, wodurch der Dateneingabeschritt von 10 Stunden Abtippen auf einen einzigen Batch-Upload reduziert wird, der automatisch jedes nachgelagerte System speist.
Das 850-Milliarden-Dollar-Problem, das auf einem Klemmbrett landet
Die US-Einzelhandelsretouren beliefen sich 2025 auf 849,9 Milliarden Dollar, so der Bericht „2025 Retail Returns Landscape“ der National Retail Federation, der gemeinsam mit Happy Returns veröffentlicht wurde. E-Commerce-Retouren machen allein 19,3 % des Online-Umsatzes aus – etwa jede fünfte Bestellung kommt zurück. Bekleidung liegt bei 25 %, Schuhe nähern sich 31 %, und in der Zeit nach den Feiertagen steigt das Retourenvolumen auf das Drei- bis Fünffache des Tagesdurchschnitts. Die NRF-Umfrage unter 358 E-Commerce-Profis bei Händlern mit einem Umsatz von über 500 Millionen Dollar ergab, dass 64 % in den nächsten sechs Monaten Prozessverbesserungen bei Retouren priorisieren.
Aber diese Umfrageteilnehmer sprechen größtenteils über die kundenseitige Ebene: Retourenportale, Label-Erstellung, Abgabestellen-Netzwerke, Betrugserkennung. Die lagerseitige Ebene – der Moment, in dem eine physische Retoure zu einem Datensatz in Inventar- und Buchhaltungssystemen wird – fehlt in der Diskussion auffällig. Sobald das Paket am Wareneingang landet, wird die digitale Datenspur des Portals kalt.
An einer Standard-Retourenverarbeitungsstation nimmt ein Mitarbeiter ein Paket an, öffnet es und findet die RMA-Unterlagen: eine ausgedruckte Seite aus der Portal-Einreichung des Kunden, ein PDF, das dem Versand beiliegt, oder in manchen B2B- und Fertigungskontexten ein handschriftlich ausgefülltes Genehmigungsformular. Dann lesen sie die RMA-Nummer, Bestellnummer, SKU, den Grundcode, den Zustand und die Dispositionsanweisungen – und tippen jedes Feld erneut in ein WMS (Warehouse Management System), eine Tracking-Tabelle oder beides. Branchenschätzungen beziffern diesen manuellen Eingabeschritt auf 60 bis 90 Sekunden pro Retoure. Bei 500 Retouren pro Tag – dem Volumen eines mittelgroßen 3PL im Januar – sind das 8 bis 12 Stunden reine Datenerfassung, die dem System keine neuen Informationen hinzufügt. Es ist Transkription, keine Verarbeitung.
Ein sechssekündiger digitaler Prozess, der am Wareneingang endet
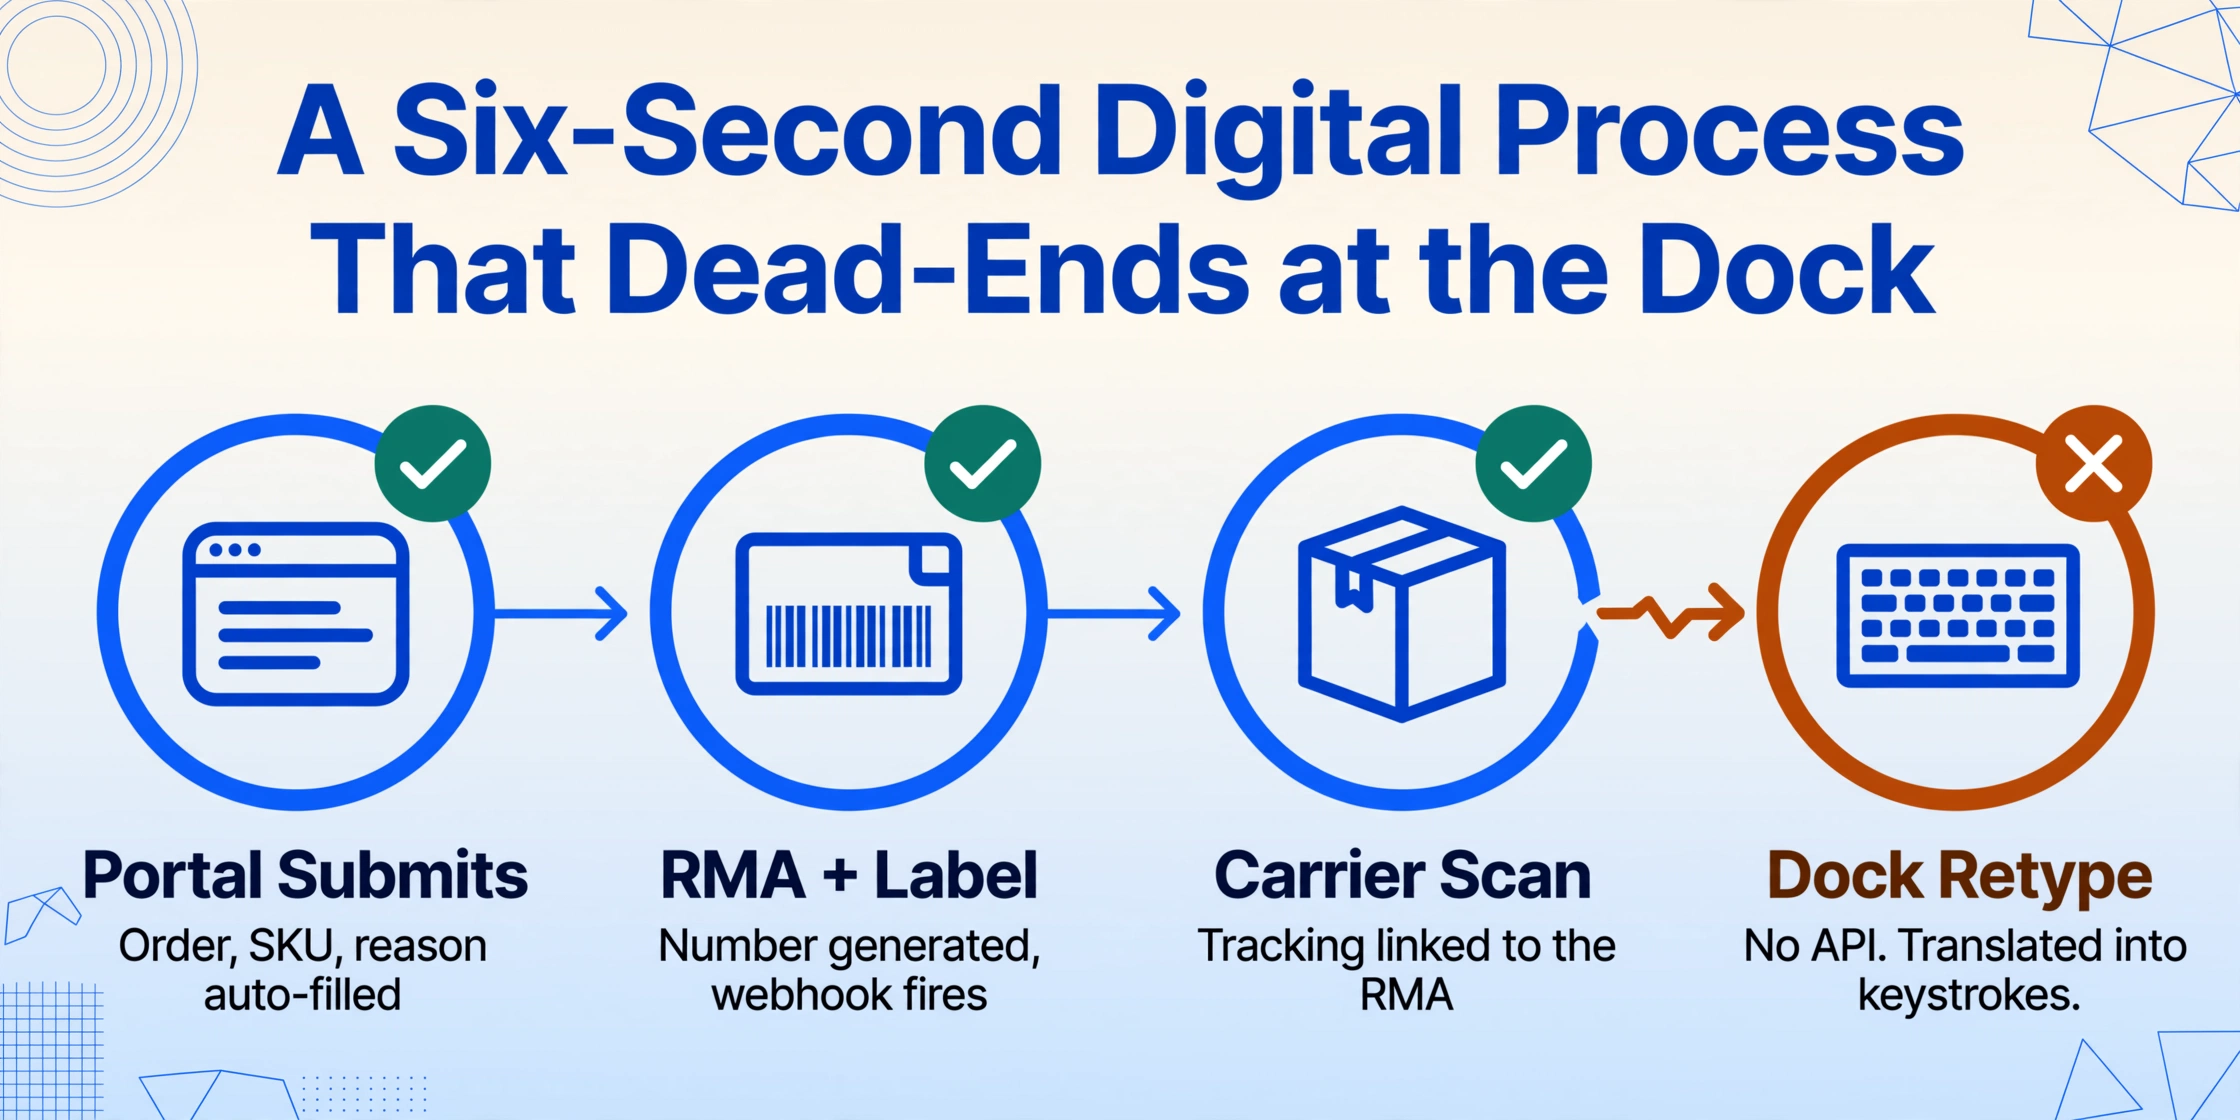
Um zu verstehen, warum diese Unterbrechung existiert, muss man eine Retoure durch die gesamte Kette verfolgen – und den genauen Moment markieren, in dem die Daten aufhören, sich zu bewegen.
In den ersten 15 Minuten im Leben einer Retoure ist der Datenfluss nahtlos. Der Kunde reicht über ein Portal – Loop Returns, ReturnGO, AfterShip oder ein Shopify-eigenes Formular – eine Retoure ein, und das System übernimmt automatisch Bestellnummer, Kundennamen, SKU und ursprüngliches Kaufdatum aus der E-Commerce-Plattform. Es fügt einen Retourengrundcode aus einem Dropdown hinzu. Es generiert eine RMA-Nummer und ein Versandlabel. Ein Webhook wird an das WMS oder Order-Management-System gesendet und erstellt einen ausstehenden RMA-Datensatz. Das Paket gelangt mit einer Tracking-Nummer, die mit der RMA verknüpft ist, in das Netzwerk des Transportdienstleisters.
Dann kommt der Karton im Lager an – und der Datenfluss bricht. Dieser automatisch generierte RMA-Datensatz muss nun mit Inspektionsergebnissen angereichert werden: der tatsächliche Zustand des Artikels, ob er mit dem vom Kunden angegebenen Grund übereinstimmt, ob Zubehör vorhanden ist, ob er wiederverkauft werden kann oder eine Aufarbeitung benötigt. Diese Beobachtungen leben auf dem RMA-Formular selbst – Notizen, die ein Prüfer gekritzelt hat, angekreuzte Kästchen auf einem ausgedruckten Zettel, ein „REFURB“-Stempel in der Ecke. Und dieses Formular, ob physisches Papier oder ein PDF auf einem Tablet-Bildschirm, spricht eine andere Sprache als das WMS. Es hat keine API. Es erfordert einen Menschen, der seinen Inhalt in Tastatureingaben übersetzt.
Ein Beitrag auf r/Netsuite hat es genau auf den Punkt gebracht: „Der RMA-Prozess ist für zwei Personen zu einem Vollzeitjob geworden. Jede Retoure beginnt damit, dass ein Kunde uns eine E-Mail schreibt, jemand sie manuell genehmigt und dann manuell ein Etikett erstellt.“ Auf r/supplychain drückte es ein wachsender Distributor noch deutlicher aus: Ihr Retourenprozess habe sie „aufgefressen“ – manuelle RMA-Workflows, der Albtraum der Kreditorenabstimmung und Engpässe im Lager, die im großen Stil zusammenliefen. Das sind keine Beschwerden über schlechte Software. Sie beschreiben eine strukturelle Lücke: Das Front-End-RMA-System generiert Daten, die das Back-End-Lagersystem nicht aufnehmen kann, ohne dass ein menschlicher Mittelsmann jedes Feld neu eingibt.
Das Retourenportal und das Lager kommunizieren miteinander durch einen einzigen, unzuverlässigen Übersetzer: die Person, die das Papierformular in der Hand hält.
Warum die digitale Kette nie vollendet wurde
Dies ist keine Geschichte von Nachlässigkeit. Es ist die Geschichte zweier Hälften eines Systems, die sich mit unterschiedlicher Geschwindigkeit entwickeln, und der Nahtstelle zwischen ihnen, die von beiden Seiten unsichtbar wird. Die kundenorientierte Hälfte der Retouren hat im letzten Jahrzehnt drei Digitalisierungswellen durchlaufen: erstens die Migration von E-Mail-und-Telefon-RMA zu Self-Service-Portalen; zweitens die Integration dieser Portale mit Versanddienstleistern zur automatischen Etikettenerstellung; drittens die Einbindung von KI zur Betrugserkennung und Umtauschanreizen. Loop Returns, ReturnGO und Happy Returns sind jeweils Teil dieses evolutionären Stapels.
Die lagerorientierte Hälfte folgte einem anderen Rhythmus. WMS (Warehouse Management Systeme) – Cin7, Fishbowl, ShipBob, SkuVault – wurden entwickelt, um Kommissionierung, Verpackung und Versand zu optimieren, wobei die Retourenabwicklung als sekundäres Modul hinzugefügt wurde. Der Retouren-Workflow in den meisten WMS-Plattformen geht davon aus, dass jemand die Daten eingibt oder einen Barcode scannt, dessen Informationen bereits erfasst wurden. Keine dieser Annahmen trifft auf einen RMA-Schein zu, der aus einer Schachtel gezogen wird.
Der strukturelle Missstand ist folgender: Retourenportale geben Daten in Formaten aus, die für das Kundenerlebnis entwickelt wurden – gebrandete E-Mails, Portal-Dashboards, Carrier-Tracking-APIs. WMS-Plattformen konsumieren Daten in Formaten, die für den Lagerbetrieb entwickelt wurden – SKU-Transaktionen, Behälterort-Updates, Buchhaltungsjournale. Es gibt keinen Standardadapter zwischen diesen beiden Welten, also baut jedes Lager seinen eigenen: eine Person mit einer Tastatur.
Der NRF-Retourenbericht stellt fest, dass 64 % der Händler die Aktualisierung ihres Retourenprozesses als Priorität ansehen. Der Bericht konzentriert sich jedoch fast ausschließlich auf die Kundenseite – Retourengebühren, Abgabekomfort, Betrugserkennung. Die Datenübergabe an das Lager ist das Retourenproblem, das in kundenorientierten Umfragen nicht auftaucht und daher nicht auf den Fahrplänen erscheint. Es taucht nur in der Gewinn- und Verlustrechnung auf, vergraben in Arbeitskosten und Wertberichtigungen auf Lagerbestände.
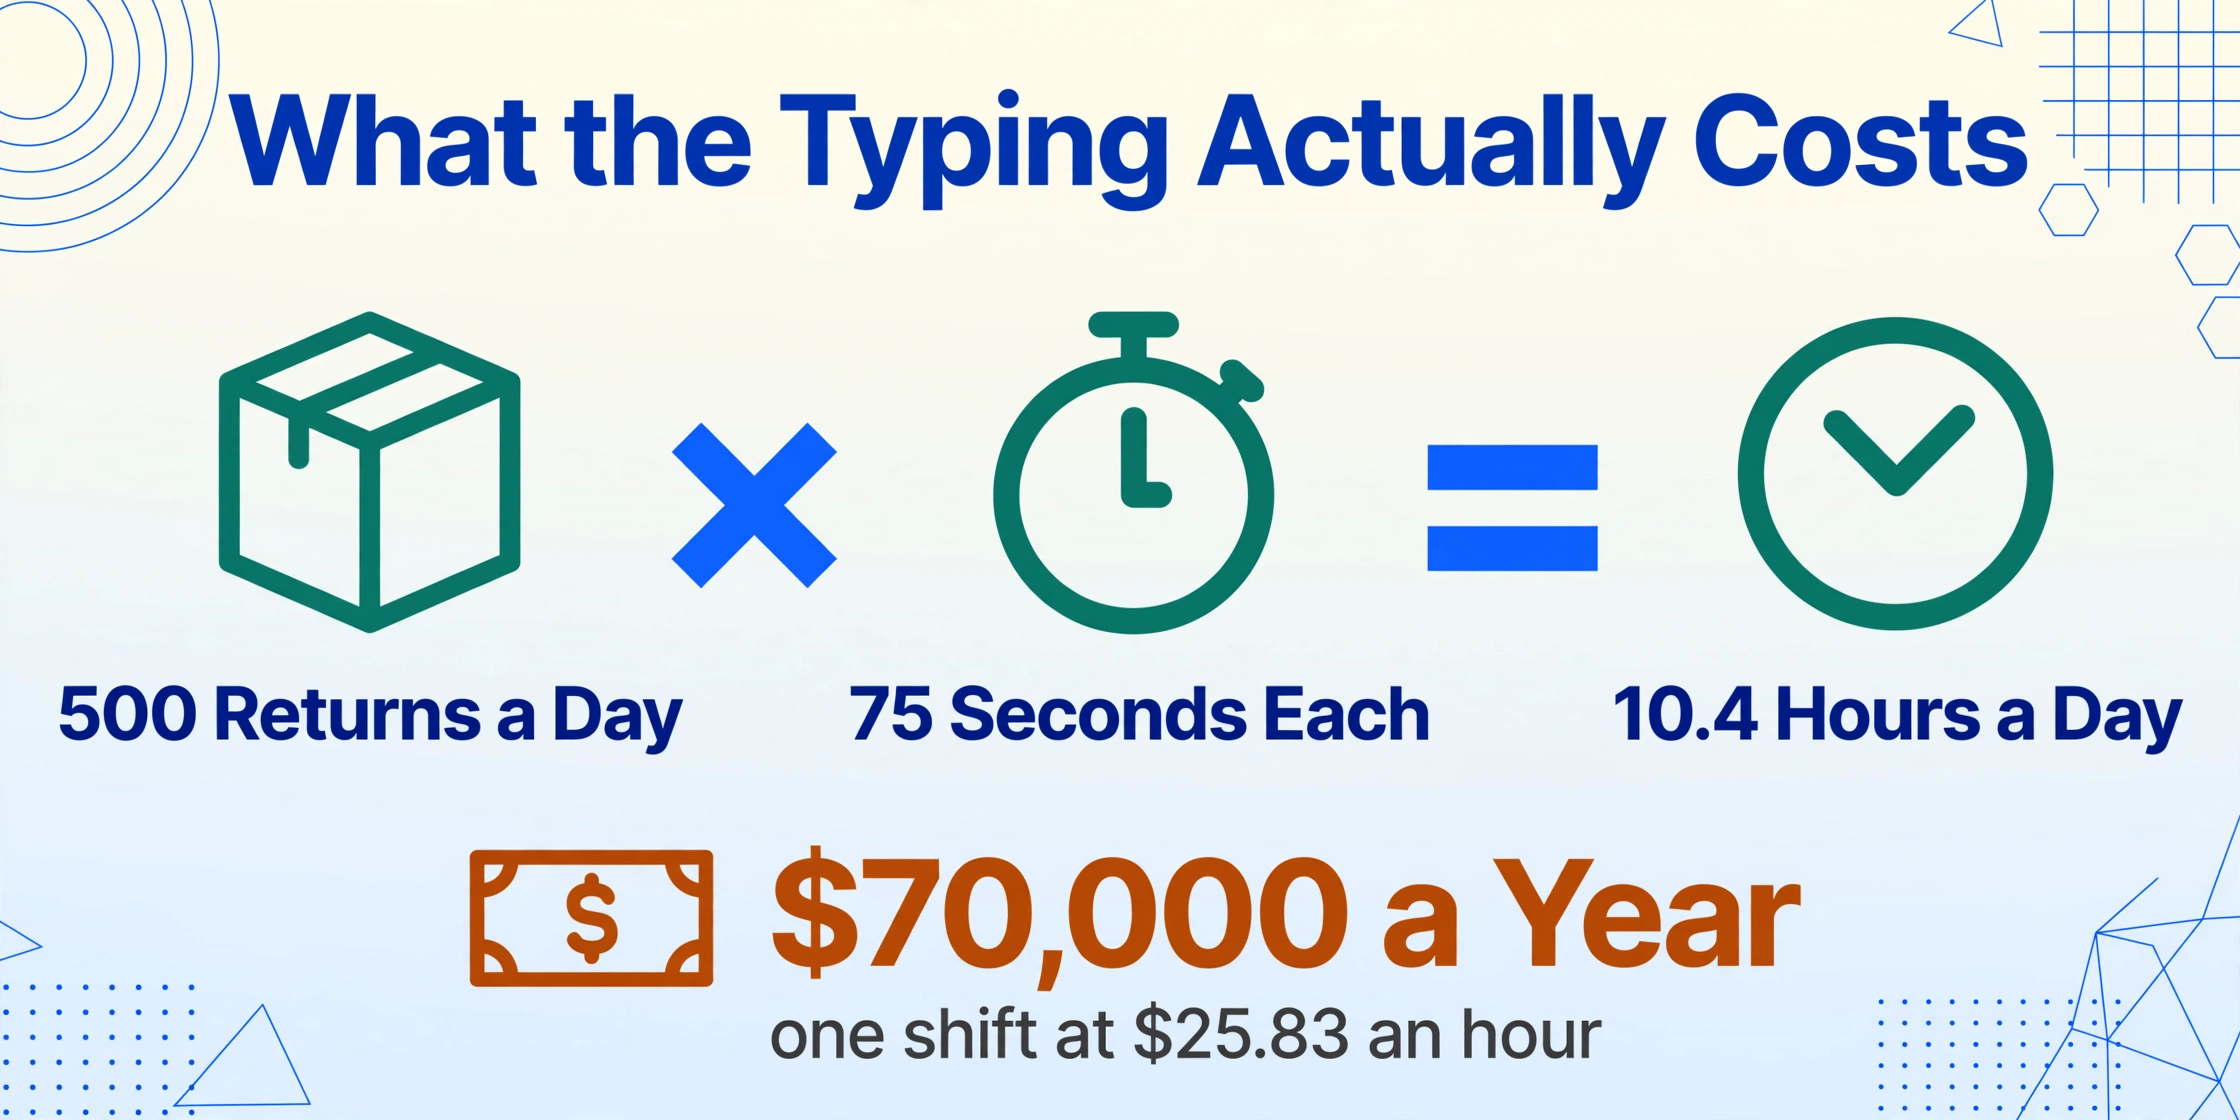
Was die Tipparbeit tatsächlich kostet
Wenn Sie 500 Retouren pro Tag verarbeiten und jede 75 Sekunden manuelle Dateneingabe erfordert, sind das 10,4 Stunden Arbeitszeit für eine Aufgabe, die keine neuen Informationen hervorbringt. Beim durchschnittlichen Lagerlohn des U.S. Bureau of Labor Statistics von $25,83 pro Stunde im März 2026 entspricht das etwa $269 pro Tag, $70.000 pro Jahr – für eine einzige Schicht. Für einen 3PL, der sieben Tage die Woche in zwei Schichten arbeitet, nähert sich die Zahl $200.000 jährlich, noch bevor Überstunden in der Hochsaison berücksichtigt werden.
Aber Arbeit ist nur die sichtbare Kosten. Die unsichtbaren summieren sich still:
Eingabefehler wirken sich nachgelagert aus. Ein falsch getippter Grundcode – „defekt“ statt „passte nicht“ – schickt den Artikel in die Retouren-an-Hersteller-Spur statt zurück ins Lager, was unnötige Frachtkosten verursacht und die Wiedereinlagerung um Tage verzögert. Eine vertauschte SKU-Ziffer leitet das falsche Produkt ins falsche Regal. Branchendaten deuten darauf hin, dass die Fehlerquote bei manueller Dateneingabe je nach Formularkomplexität bei etwa 1–4 % liegt. Bei einem RMA-Formular mit 8–12 Feldern (RMA-Nummer, Bestellnummer, Kundenname, SKU, Menge, Grundcode, Zustand, Disposition) bedeutet eine Fehlerquote von 2 % zehn Fehler pro 500 Retouren – jeder einzelne erfordert eine Ausnahmebehandlung, die länger dauert als die ursprüngliche Eingabe.
Erstattungen verzögern sich durch Datenlatenz. Der Kunde erwartet eine Erstattung innerhalb weniger Tage nach dem Carrier-Scan mit Status „zugestellt“. Wenn die RMA-Daten jedoch nicht ins System eingegeben wurden, hat die Finanzabteilung keinen Auslöser, um die Erstattung zu veranlassen. Die Retoure hängt in der Verarbeitung fest – physisch eingegangen, digital unsichtbar. Laut NRF- und Happy-Returns-Daten sagen 82 % der Verbraucher, dass kostenlose Retouren wichtig sind; 57 % haben einen Händler nach einer schlechten Retoure-Erfahrung verlassen. Eine schlechte Retoure-Erfahrung ist eine, bei der das Paket in einem schwarzen Loch verschwand. Dieses schwarze Loch ist oft nur ein Papierformular, das im Eingangskorb auf die Dateneingabe wartet.
Lieferanten-Rückbelastungen stützen sich auf RMA-Daten, die nie digitalisiert wurden. Viele Retouren gehen auf Herstellerfehler zurück. Wenn ein Produkt innerhalb der Garantie ausfällt, werden die Inspektionsnotizen des RMA-Formulars – Grundcode, Zustand, Fotos – zur unterstützenden Dokumentation für eine Belastungsanzeige an den Lieferanten. Wenn diese Notizen auf Papier bleiben oder in einer PDF-Datei liegen, die niemand ins ERP extrahiert, wird die Rückbelastung nicht eingereicht. Laut Appriss Retails 2026 Total Retail Loss Benchmark entstanden 2025 Verluste von rund $100 Milliarden durch vermeidbaren Betrug und Missbrauch, wobei allein Retourenmissbrauch $86 Milliarden ausmachte. Ein papierbasiertes RMA-Verfahren, das verdächtige Retourenmuster nicht in Echtzeit erkennen kann, ist eine Lücke, die Betrug ausnutzt.
Die Lagerbestandsgenauigkeit nimmt ab. Nur etwa 48 % der retournierten Artikel werden laut Eightx-Daten von 2026 zum vollen Preis weiterverkauft. Die anderen 52 % erfordern Routing-Entscheidungen – Aufarbeitung, Liquidation, Rücksendung an den Lieferanten, Spende, Vernichtung –, die von den im RMA-Formular erfassten Inspektionsdaten abhängen. Wenn diese Daten nicht im System sind, greifen Routing-Entscheidungen standardmäßig auf den langsamsten, sichersten Weg zurück: „Zur Prüfung zurückstellen“, was in der Praxis bedeutet, dass der Artikel in einem Retouren-Zwischenlager liegt und täglich an Wert verliert. Optoro, eine Reverse-Logistics-Plattform, die über 100 Millionen Retouren verarbeitet hat, schätzt, dass die Bearbeitungskosten 20–39 % des ursprünglichen Verkaufspreises eines Artikels ausmachen – und ein erheblicher Teil dieser Kosten entfällt auf Arbeitsaufwand und Verzögerungen durch manuelle Datenerfassung.
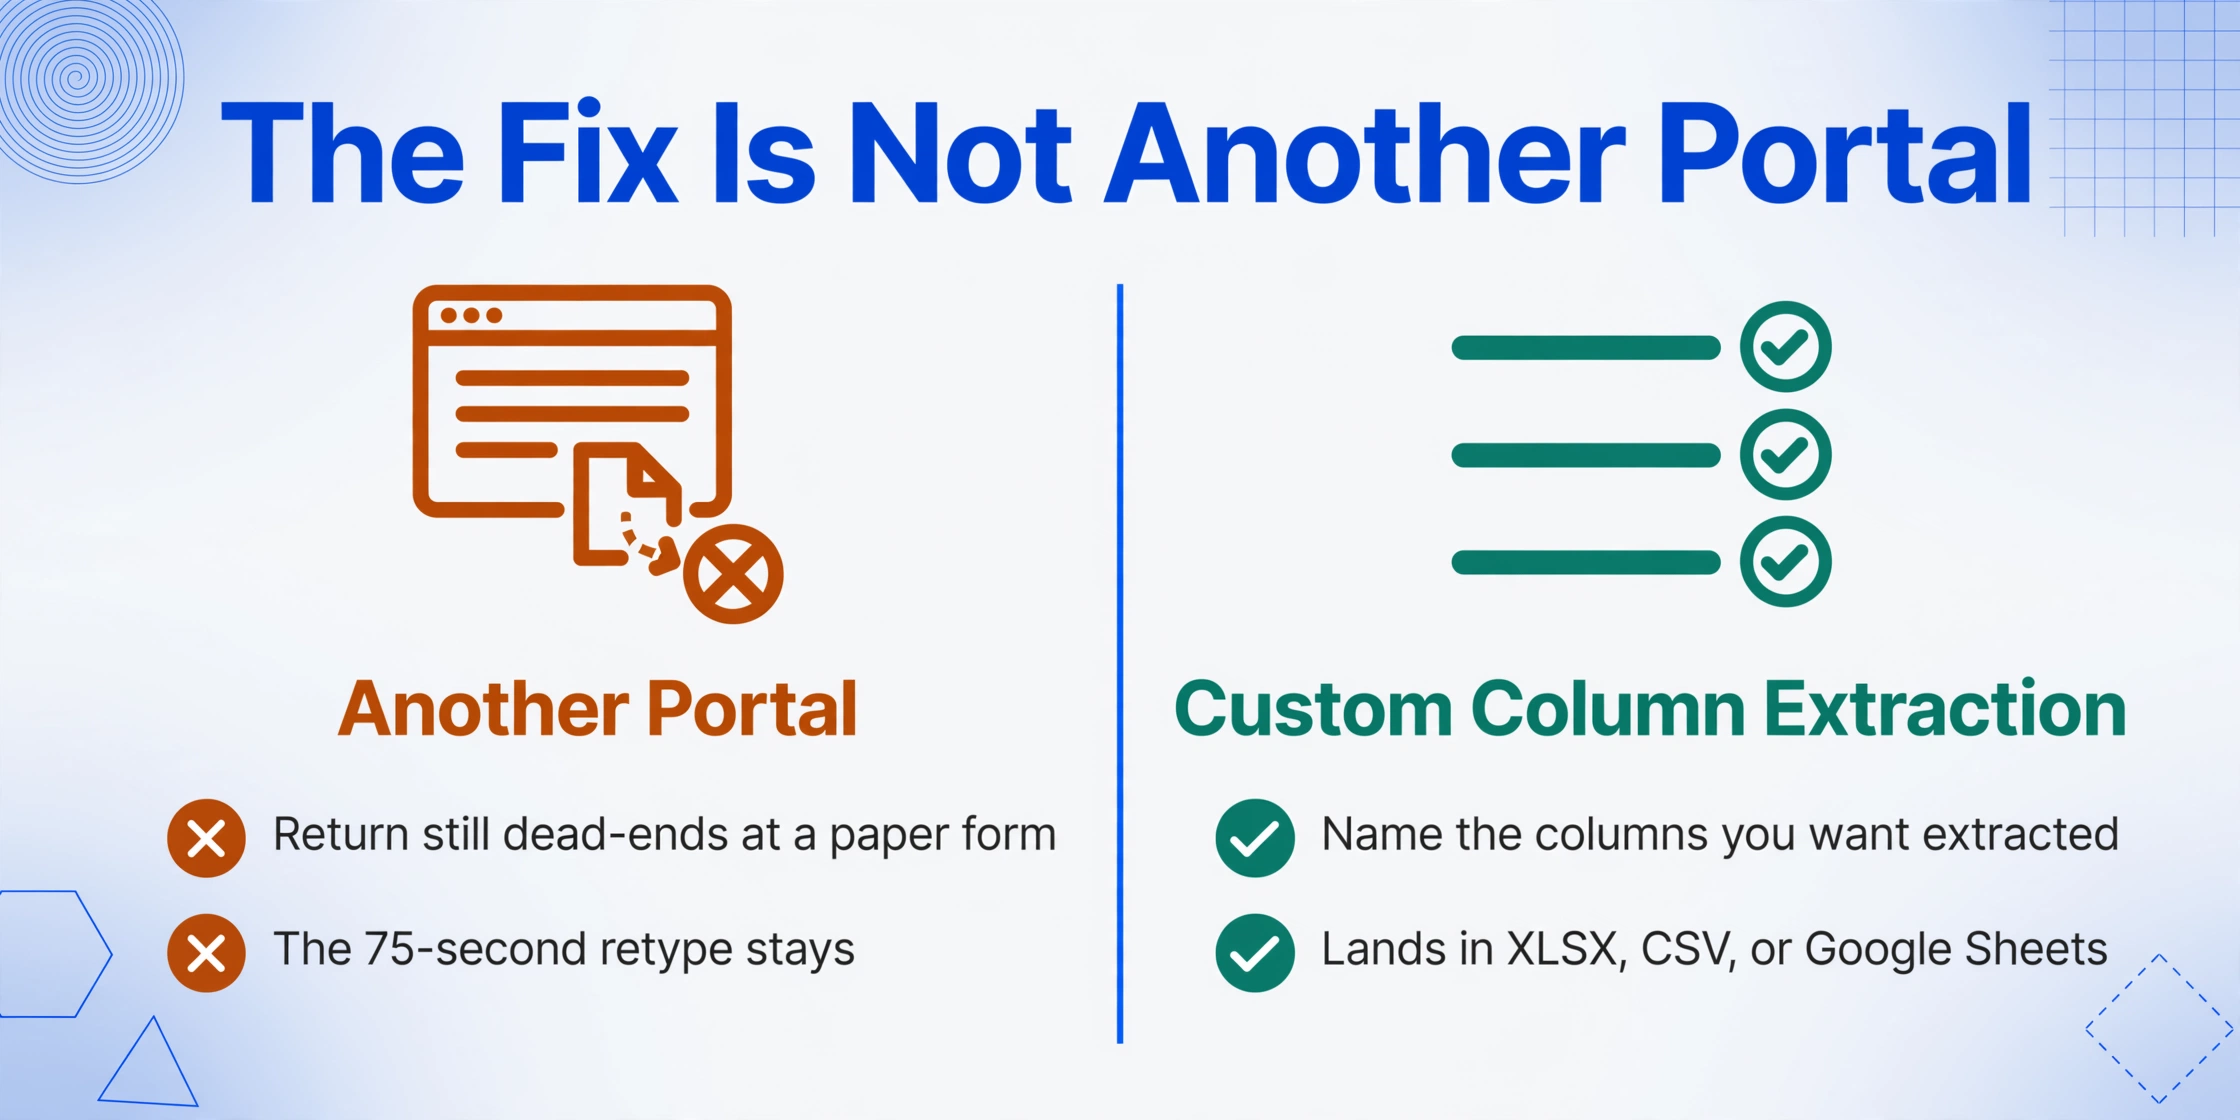
Die Lösung ist kein weiteres Portal
Wenn Sie den gesamten RMA-Datenfluss nachverfolgen – Kundenportal → Spediteur-Scan → Wareneingang → Inspektion → WMS-Update → Buchhaltungseintrag → Erstattungsauslöser → Bestandsanpassung –, ist bis auf einen Schritt alles digitalisiert und per API angebunden. Der einzige Schritt, der manuell bleibt, ist die Extraktion der Daten aus dem RMA-Formular selbst in das Lager- oder Buchhaltungssystem. Das Formular, unabhängig von seiner Herkunft (Portal-PDF, gescannter Papierbeleg, handschriftliche Genehmigung), ist das, was zwischen der digitalen Retoure und dem digitalen Lager steht. Schließen Sie diese Lücke, und die gesamte Kette wird automatisch.
Das ist kein Integrationsproblem. Integration setzt voraus, dass beide Seiten ein gemeinsames Protokoll sprechen. Das RMA-Formular spricht kein Protokoll – es ist ein visuelles Artefakt. Die Lösung ist eine Extraktionsebene zwischen Formular und System: etwas, das den Inhalt des Formulars so liest, wie es ein Mensch tun würde, aber als strukturierte Daten ausgibt, die das WMS, ERP oder die Tabellenkalkulation direkt übernehmen kann.
Genau hier verändert Benutzerdefinierte Spaltenextraktion die Gleichung. Statt Felder auf dem Formular zu umranden oder ein Modell mit Beispiel-RMA-Layouts zu trainieren – Ansätze, die scheitern, sobald ein Lieferant sein Formularformat ändert –, definieren Sie, was extrahiert werden soll, indem Sie die Spalten benennen: „RMA-Nummer“, „Bestellnummer“, „SKU“, „Grundcode“, „Zustand“, „Disposition“. Die KI liest das Formular semantisch – sie versteht, dass „RMA-Nr.“ und „Genehmigungsnummer“ dasselbe bedeuten, unabhängig davon, wo auf der Seite die Begriffe erscheinen. Es ist ihr egal, ob das Formular ein von Shopify generiertes PDF, ein gescannter handschriftlicher Beleg oder eine proprietäre Retourengenehmigung eines Anbieters mit völlig anderem Layout ist. Die Ausgabe ist eine strukturierte Tabellenkalkulation, deren Spaltenüberschriften Ihren Namenskonventionen entsprechen und bereit für den Import in jedes WMS oder Buchhaltungssystem ist. Sie können diesen Workflow in Aktion auf der Seite RMA-zu-Excel-Konverter sehen.
Für ein Lager mit 500 Retouren pro Tag reduziert dies den Datenerfassungsschritt von 10 Stunden auf die Zeit, die zum Hochladen eines Stapels gescannter oder fotografierter RMA-Formulare und zum Klicken auf „Verarbeiten“ benötigt wird. Die extrahierten Daten müssen nicht neu erfasst werden, sammeln keine Übertragungsfehler an und fließen in dieselbe Tracking-Tabelle oder dasselbe WMS, das das Team bereits nutzt. Für einen tieferen Einblick, wie dies in einen Erstattungsabgleich-Workflow passt, finden Sie die Aufschlüsselung unter Stapelverarbeitung von RMA-Formularen in ein einziges Abgleichblatt.
Und da die extrahierten RMA-Daten bereits strukturiert sind – mit standardisierten SKUs, Grundcodes und Dispositionsfeldern – ist die Einspeisung in ein Bestandssystem ein direkter Import und keine Abtippübung. Die Pipeline vom RMA-Formular zum Bestandssystem wird zu einem Feed, nicht zu einem Trichter.
Der Kernpunkt: Das RMA-Papierproblem wird nicht gelöst, indem man ein besseres Portal kauft oder sein WMS aufrüstet. Es wird gelöst, indem man „das Formular lesen“ von „mit den Daten arbeiten“ entkoppelt. Sobald diese beiden Schritte getrennt sind, kann das Formular alles sein – PDF, Scan, Foto, Handschrift – und die nachgelagerten Systeme kümmern sich nicht darum, weil sie das Formular nie sehen. Sie sehen eine Tabelle.
Wo die extrahierten Daten landen
Die Ausgabe einer RMA-Extraktion ist nicht an ein bestimmtes System gebunden. Es ist eine Tabelle – XLSX, CSV oder direkt in Google Sheets. Wohin sie als Nächstes geht, hängt von Ihrem Stack ab:
Das durchgängige Muster: Die Extraktionsebene entkoppelt „das Formular lesen“ von „mit den Daten arbeiten“. Ob die Daten letztlich in NetSuite, ShipStation oder einem gemeinsamen Google Sheet landen, ist eine nachgelagerte Entscheidung, die nichts daran ändert, wie die Extraktion eingerichtet ist. Eine Extraktionskonfiguration funktioniert für alle Ziele. Um RMA-Daten im selben Workflow um die Verarbeitung von Lieferantenrechnungen zu ergänzen, lesen Sie die Stapelverarbeitung von Lieferantenrechnungen in ein E-Commerce-Inventarhauptbuch, um zu verstehen, wie eine einzige Extraktionspipeline mehrere Dokumenttypen verarbeiten kann, die dasselbe Inventarsystem speisen.
Häufig gestellte Fragen
Funktioniert das auch mit handschriftlichen RMA-Formularen?
Ja. Die KI liest Handschrift – einschließlich Schreibschrift und gemischter Druckschrift –, indem sie den Inhalt des Geschriebenen versteht, nicht nur Zeichen erkennt. Eine handschriftliche RMA-Nummer oder ein handschriftlicher Grundcode auf einem Papierformular wird genauso gelesen wie ein gedruckter. Allerdings wird eine extrem schlechte Handschrift (für Menschen unleserlich) die KI ebenso herausfordern wie jeden anderen Leser. Leserliche Handschrift – die Art, die ein Lagerarbeiter lesen und abtippen kann – liegt problemlos im Bereich des Möglichen.
Kann ich die extrahierten Daten direkt in NetSuite / Shopify / mein WMS importieren?
Ja, über den Standard-Importpfad jeder Plattform. Die Extraktionsausgabe ist eine strukturierte Tabelle (XLSX oder CSV), die jedes gängige WMS und ERP als Importformat unterstützt. Eine individuelle API-Integration ist nicht erforderlich. Ordnen Sie Ihre Spalten einmal zu – RMA-Nummer → NetSuite-RMA-Feld, SKU → Inventardatensatz, Disposition → Routing-Warteschlange – und verwenden Sie dieselbe Zuordnung für jede Charge.
Was ist, wenn jeder Lieferant ein anderes RMA-Formularformat verwendet?
Das ist der Kernwert der semantischen Extraktion. Da die KI nach Bedeutung liest – nicht nach Position oder Vorlage –, spielt das Format des Formulars keine Rolle. Ob Lieferant A die RMA-Nummer oben rechts platziert und Lieferant B sie in einer Tabellenkopfzeile führt, die Extraktionslogik ist dieselbe: Finden Sie die Daten, die dem Konzept „RMA-Nummer“ entsprechen. Das gleiche Prinzip gilt für die Verarbeitung von Lieferantenrechnungen, wo Formatunterschiede zwischen Lieferanten die Norm sind.
Was ist mit RMA-Fotos, die mit einem Tablet oder Telefon im Lager aufgenommen wurden?
Fotos werden ebenso unterstützt wie Scans und PDFs. Ein Lagerarbeiter kann das RMA-Formular mit einem Tablet oder Telefon fotografieren und das Bild direkt hochladen – die Extraktion funktioniert mit Fotos, nicht nur mit hochauflösenden Scans. Das bedeutet, dass der Datenerfassungsschritt direkt am Wareneingang stattfinden kann, ohne Papierformulare an eine zentrale Datenerfassungsstelle weiterleiten zu müssen.
Wie genau ist die Extraktion im Vergleich zur manuellen Eingabe?
Gedruckter Text auf sauberen Formularlayouts erreicht eine Erkennungsgenauigkeit von bis zu 99 %. Handschriftliche Formulare und Fotos von geringer Qualität weisen eine geringere Genauigkeit auf, der entscheidende Vergleich ist jedoch der zur manuellen Eingabe – die selbst eine geschätzte Fehlerrate von 1–4 % aufweist. Der Unterschied besteht darin, dass Extraktionsfehler konsistent und überprüfbar sind: Sie sehen genau, was Feld für Feld extrahiert wurde, und Korrekturen werden zur manuellen Prüfung markiert, anstatt wie ein falsch eingegebener Buchstabe stillschweigend durch das System zu wandern.