Les retours sont numériques jusqu'à ce
qu'ils ne le soient plus
Un client clique sur « Démarrer un retour » dans un portail de marque. Le système valide la commande, vérifie la politique, génère une étiquette d'expédition et émet un numéro RMA — tout cela en moins de cinq secondes. Le retour entre dans un pipeline de suivi qui met à jour l'inventaire, notifie le client et prépare l'entrepôt à la réception. Chaque étape est numérique, automatisée et en temps réel. Puis le colis arrive sur le quai, quelqu'un l'ouvre, en sort un bordereau RMA papier — ou un PDF imprimé d'un export du portail — et commence à taper. Ce moment est l'horizon des événements de données du retour : tout ce qui précède est numérique, tout ce qui suit tombe dans un gouffre de saisie manuelle, de feuilles de calcul déconnectées et de perte de données silencieuse. Et personne ne mesure ce que ce gouffre coûte.
Points clés à retenir
- Votre portail de retour génère automatiquement le RMA, valide l'inventaire et déclenche un webhook vers le WMS en six secondes — puis le colis arrive sur le quai et quelqu'un retape manuellement chacun de ces champs à partir d'un bordereau papier, à 25,83 $ de l'heure.
- Avec 500 retours par jour, la ressaisie manuelle du RMA consomme 10 heures de travail qui n'ajoutent aucune nouvelle information à aucun système, tandis que le taux d'erreur de frappe de 2 % achemine silencieusement mal l'inventaire, retarde les remboursements et fait perdre les contre-passations fournisseurs.
- La solution n'est pas un autre portail ou une mise à niveau du WMS — c'est extraire les données RMA du formulaire lui-même dans une feuille de calcul structurée, réduisant l'étape de saisie de données de 10 heures de retape à un seul téléversement par lots qui alimente automatiquement tous les systèmes en aval.
Le problème de 850 milliards de dollars qui atterrit sur un presse-papiers
Les retours au détail aux États-Unis ont totalisé 849,9 milliards de dollars en 2025, selon le rapport 2025 Retail Returns Landscape de la National Retail Federation, co-publié avec Happy Returns. Les retours du commerce électronique représentent à eux seuls 19,3 % des ventes en ligne — environ une commande sur cinq revient. L'habillement atteint 25 %, les chaussures approchent 31 %, et pendant le pic post-fêtes, les volumes de retours grimpent à trois à cinq fois les moyennes quotidiennes. L'enquête de la NRF auprès de 358 professionnels du e-commerce chez des marchands dépassant 500 millions de dollars de revenus a révélé que 64 % d'entre eux priorisent la mise à jour de leurs processus de retours dans les six prochains mois.
Mais ces répondants parlent en grande partie de la couche orientée client : portails de retour, génération d'étiquettes, réseaux de dépôt, détection de fraude. La couche orientée entrepôt — le moment où un retour physique devient un enregistrement de données dans les systèmes d'inventaire et de comptabilité — est remarquablement absente de la conversation. Une fois le colis arrivé sur le quai, la traînée numérique du portail s'éteint.
À un poste de traitement de retours standard, un associé reçoit un colis, l'ouvre et localise les documents RMA : une page imprimée issue de la soumission du client sur le portail, un PDF joint à l'expédition, ou, dans certains contextes B2B et manufacturiers, un formulaire d'autorisation rempli à la main. Il lit ensuite le numéro RMA, le numéro de commande, le SKU, le code motif, l'état et les instructions de tri — et ressaisit chaque champ dans un WMS (système de gestion d'entrepôt), une feuille de calcul de suivi, ou les deux. Les estimations du secteur placent cette étape de saisie manuelle entre 60 et 90 secondes par retour. À 500 retours par jour — le volume d'un 3PL de taille moyenne en janvier — cela représente 8 à 12 heures de pure ressaisie de données qui n'ajoute aucune information nouvelle au système. C'est de la transcription, pas du traitement.
Un processus numérique de six secondes qui s'arrête net au quai
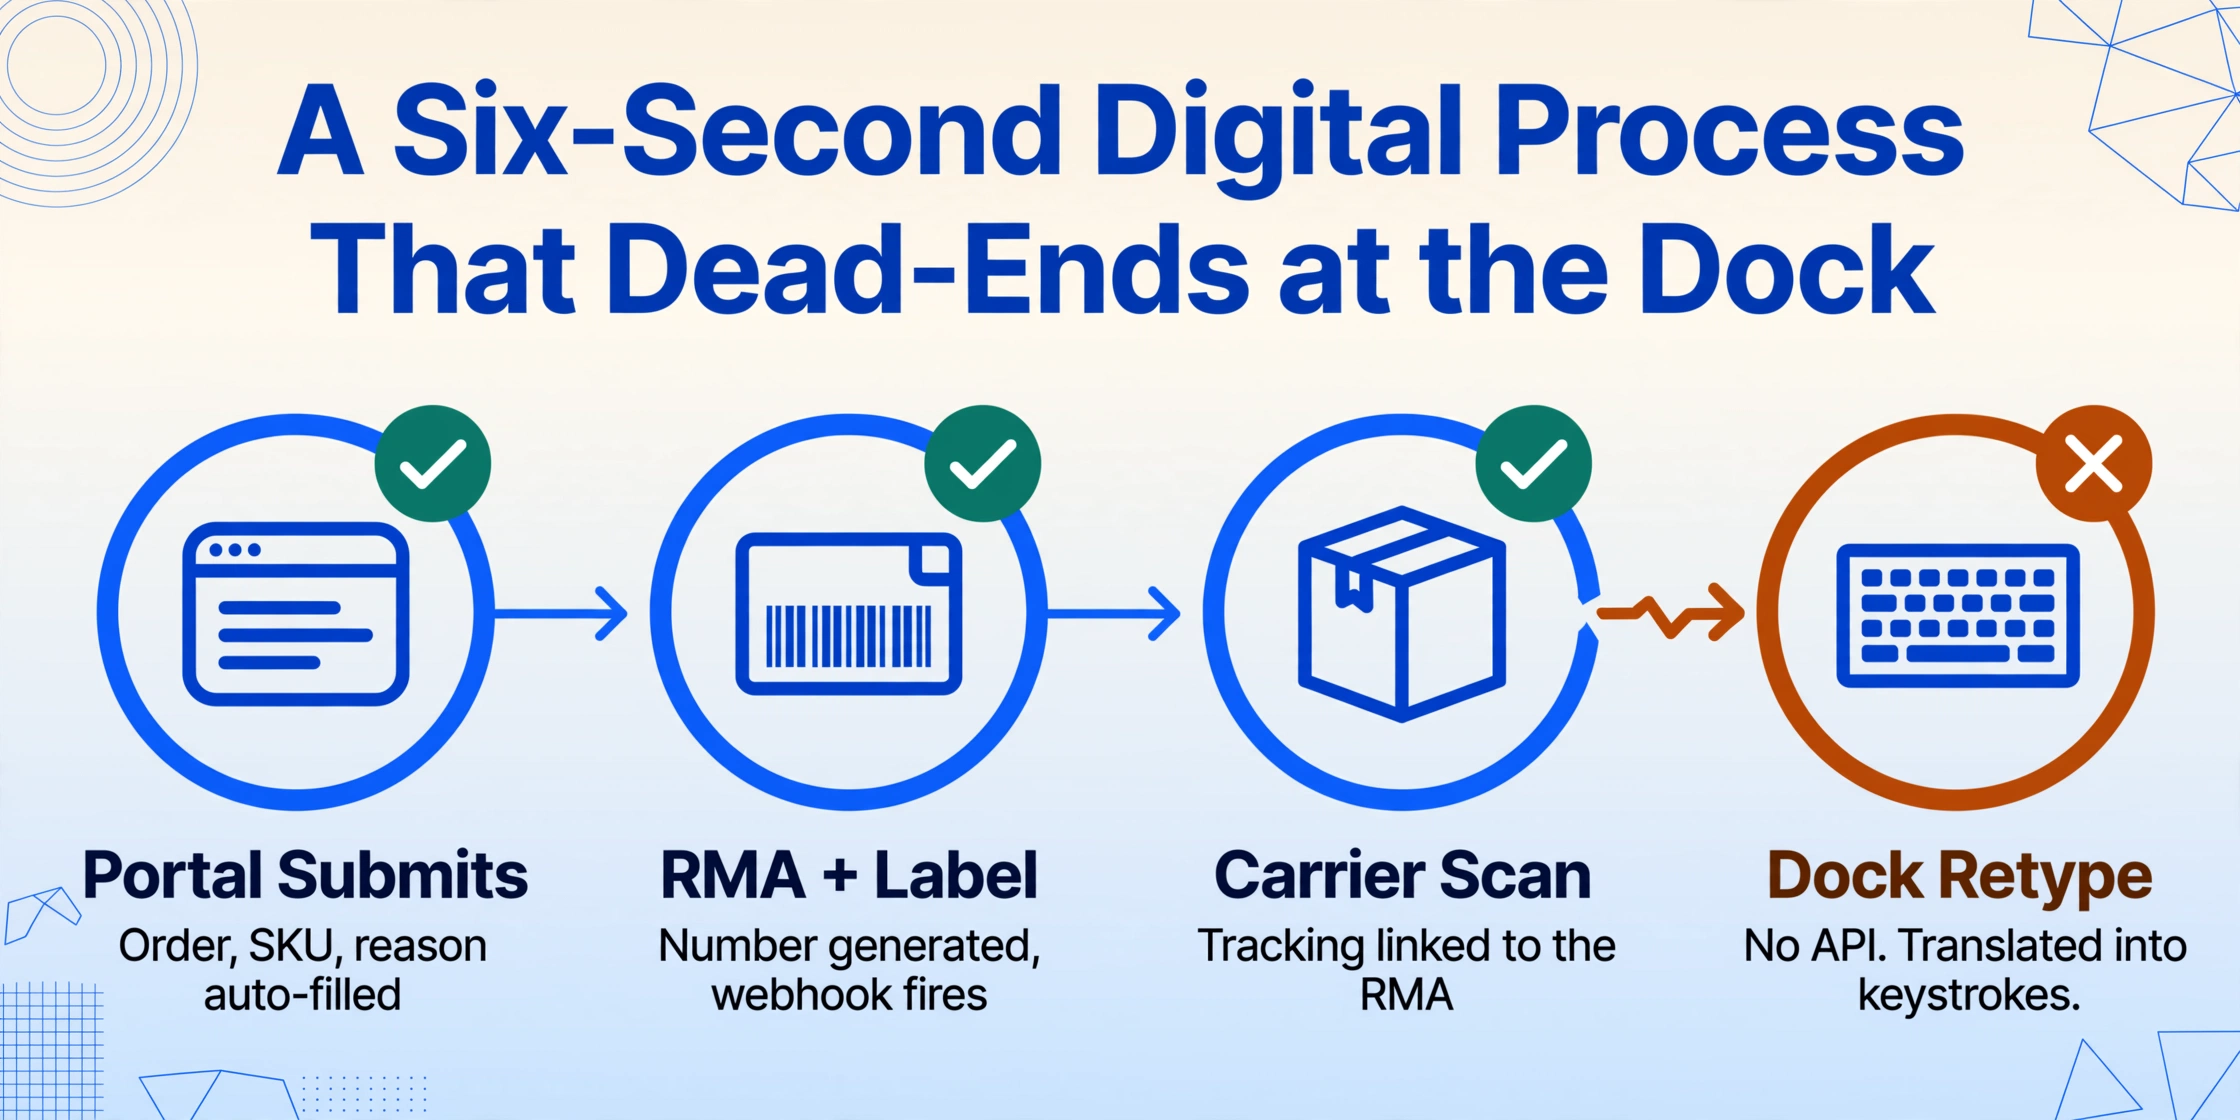
Pour comprendre pourquoi cette rupture existe, il faut suivre un retour sur toute la chaîne — et marquer le moment précis où les données cessent de circuler.
Dans les 15 premières minutes de la vie d'un retour, le flux de données est fluide. Le client soumet une demande de retour via un portail — Loop Returns, ReturnGO, AfterShip, ou un formulaire natif Shopify — et le système pré-remplit automatiquement le numéro de commande, le nom du client, le SKU et la date d'achat d'origine depuis la plateforme e-commerce. Il ajoute un code motif de retour depuis une liste déroulante. Il génère un numéro RMA et une étiquette d'expédition. Un webhook est déclenché vers le WMS ou le système de gestion des commandes, créant un enregistrement RMA en attente. Le colis entre dans le réseau du transporteur avec un numéro de suivi lié au RMA.
Puis le carton arrive à l'entrepôt — et le flux de données se fragmente. Cet enregistrement RMA auto-généré doit désormais être enrichi avec les résultats d'inspection : l'état réel de l'article, sa conformité avec le motif déclaré par le client, la présence des accessoires, sa reventabilité ou son besoin de remise à neuf. Ces observations figurent sur le formulaire RMA lui-même — notes griffonnées par un inspecteur, cases cochées sur un bordereau imprimé, tampon « REFURB » dans le coin. Et ce formulaire, qu'il soit en papier physique ou en PDF sur un écran de tablette, parle une langue différente de celle du WMS. Il n'a pas d'API. Il exige qu'un humain traduise son contenu en frappes clavier.
Un post sur r/Netsuite résumait parfaitement la situation : « Le processus RMA est devenu un emploi à temps plein pour deux personnes. Chaque retour commence par un e-mail client, une approbation manuelle, puis la génération manuelle d'une étiquette. » Sur r/supplychain, un distributeur en pleine croissance était plus direct : leur processus de retour les « dévorait tout crus » — flux RMA manuels, cauchemars de rapprochement de crédits fournisseurs et goulots d'étranglement en entrepôt convergeant à grande échelle. Ce ne sont pas des plaintes contre un mauvais logiciel. Ils décrivent un fossé structurel : le système RMA frontal génère des données que le système d'entrepôt ne peut pas ingérer sans qu'un intermédiaire humain ne retape chaque champ.
Le portail de retour et le sol de l'entrepôt communiquent via un seul traducteur peu fiable : la personne qui tient le formulaire papier.
Pourquoi la chaîne numérique n'a jamais été achevée
Ce n'est pas une histoire de négligence. C'est l'histoire de deux moitiés d'un système évoluant à des vitesses différentes, la jointure entre elles devenant invisible des deux côtés. La moitié orientée client des retours a connu trois vagues de numérisation au cours de la dernière décennie : d'abord, la migration du RMA par e-mail et téléphone vers des portails en libre-service ; ensuite, l'intégration de ces portails avec les transporteurs pour la génération automatique d'étiquettes ; enfin, l'ajout de l'IA pour la détection des fraudes et les incitations aux échanges. Loop Returns, ReturnGO et Happy Returns font tous partie de cette pile évolutive.
La moitié orientée entrepôt a suivi un rythme différent. Les systèmes de gestion d'entrepôt — Cin7, Fishbowl, ShipBob, SkuVault — ont été conçus pour optimiser la préparation, le conditionnement et l'expédition, le traitement des retours étant ajouté comme un module secondaire. Le flux de travail des retours dans la plupart des plateformes WMS suppose que quelqu'un va saisir les données ou scanner un code-barres dont les informations ont déjà été entrées. Aucune de ces hypothèses ne tient pour un bordereau RMA sorti d'un carton.
Le décalage structurel est le suivant : les portails de retour produisent des données dans des formats conçus pour l'expérience client — e-mails de marque, tableaux de bord du portail, API de suivi des transporteurs. Les plateformes WMS consomment des données dans des formats conçus pour les opérations d'inventaire — transactions au niveau SKU, mises à jour d'emplacements, écritures comptables. Il n'existe pas d'adaptateur standard entre ces deux mondes, donc chaque entrepôt construit le sien : une personne avec un clavier.
Le rapport sur les retours de la NRF note que 64 % des commerçants déclarent que la mise à jour de leur processus de retour est une priorité. Mais le rapport se concentre presque exclusivement sur le côté client — frais de retour, commodité du dépôt, détection des fraudes. La transmission des données à l'entrepôt est le problème des retours qui n'apparaît pas dans les enquêtes clients, donc il n'apparaît pas sur les feuilles de route. Il n'apparaît que sur un compte de résultat, enfoui dans les coûts de main-d'œuvre et les dépréciations de stock.
Ce que la saisie coûte réellement
Si vous traitez 500 retours par jour à 75 secondes de saisie manuelle chacun, cela représente 10,4 heures de travail consacrées à une tâche qui ne produit aucune nouvelle information. Au salaire moyen de l'entrepôt de mars 2026 du Bureau of Labor Statistics des États-Unis, soit 25,83 $ de l'heure, cela représente environ 269 $ par jour, 70 000 $ par an — pour un seul quart de travail. Pour un 3PL fonctionnant en deux équipes sept jours sur sept, le chiffre approche 200 000 $ par an, avant même de tenir compte des heures supplémentaires en haute saison.
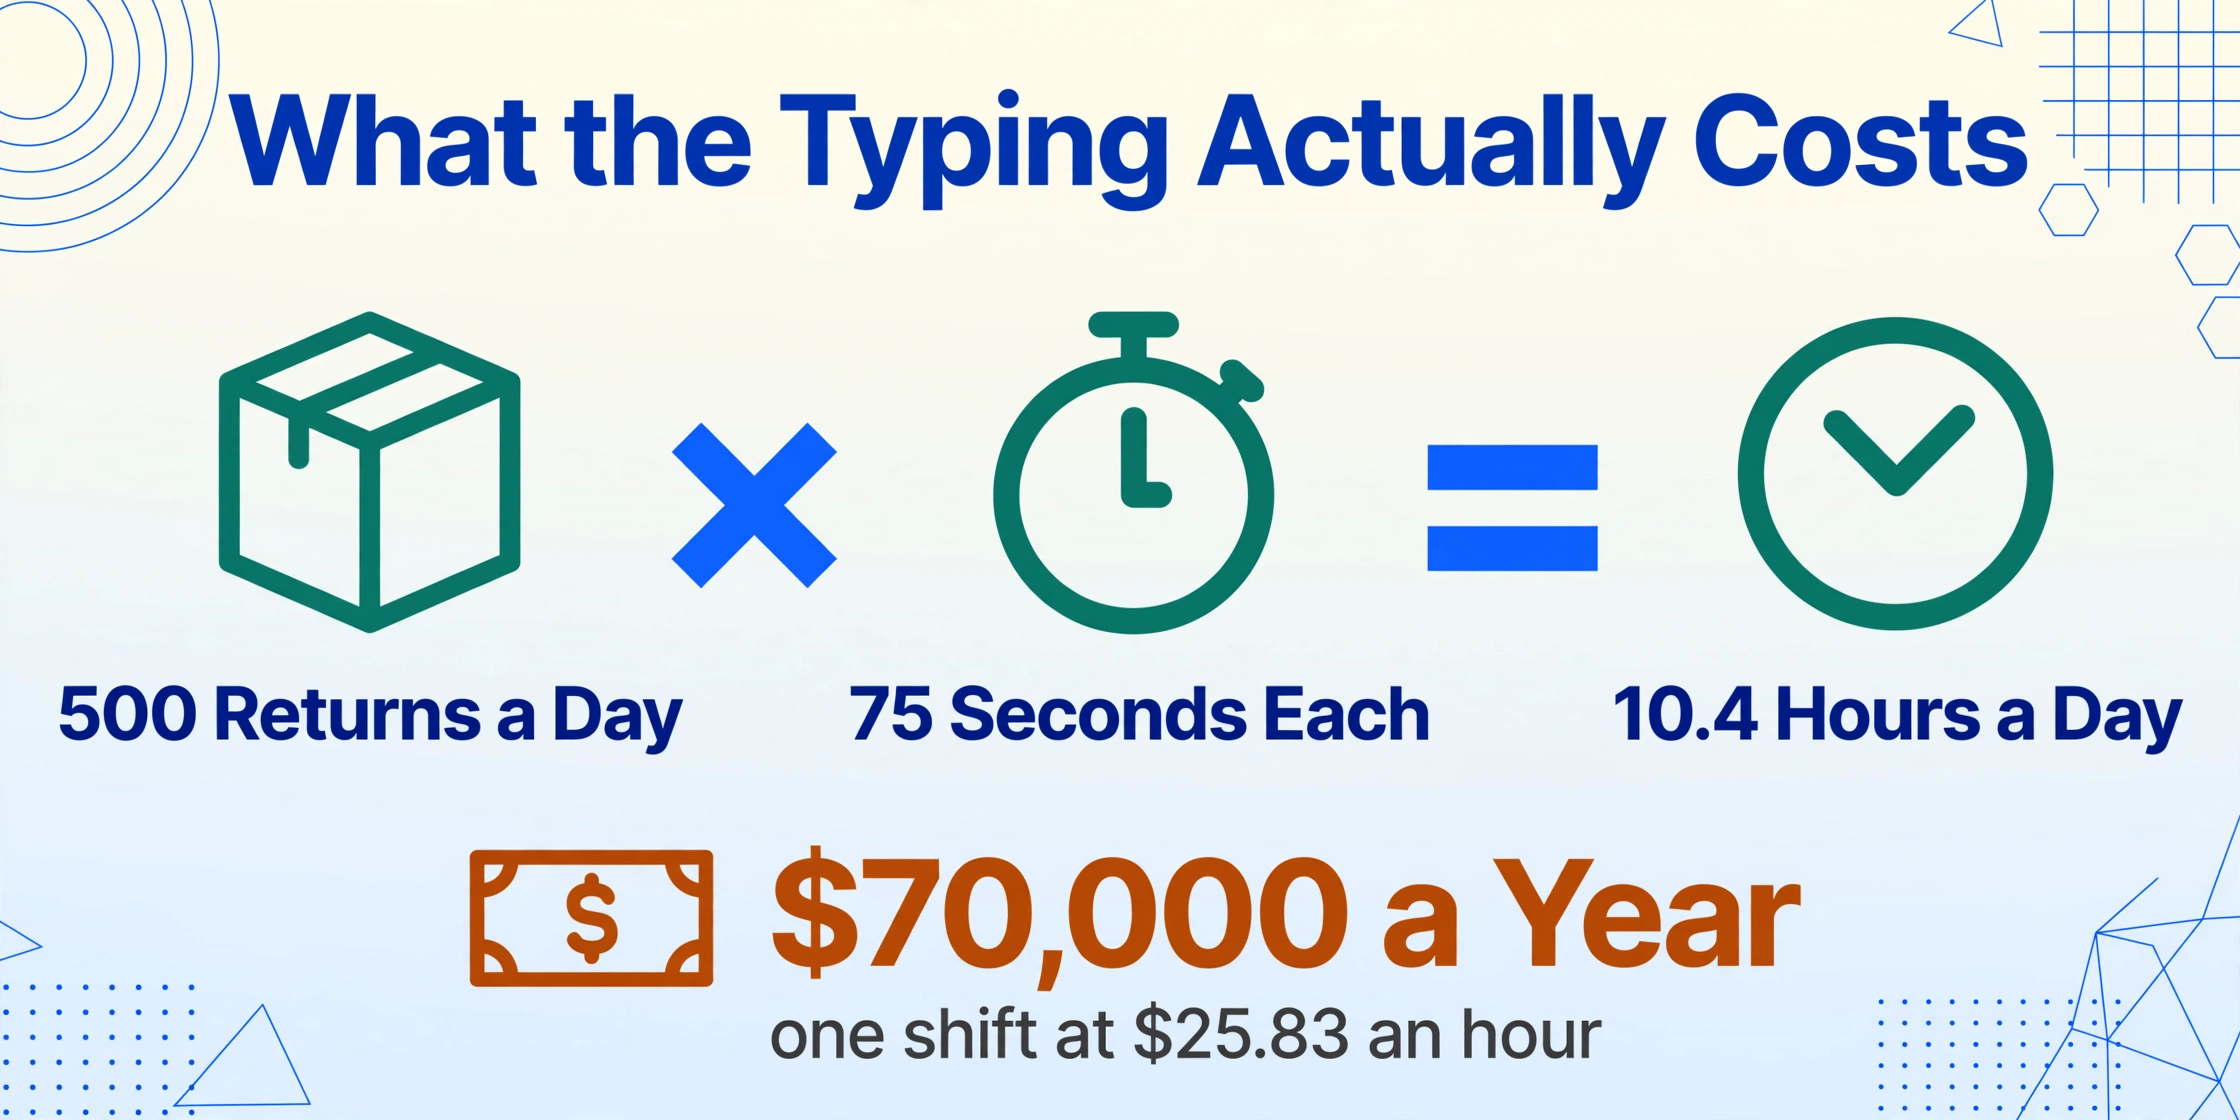
Mais la main-d'œuvre n'est que le coût visible. Les coûts invisibles s'accumulent en silence :
Les erreurs de saisie se répercutent en aval. Un code motif mal saisi — « défectueux » au lieu de « ne convenait pas » — envoie l'article vers une voie de retour au fournisseur au lieu du réassort, entraînant des frais de transport inutiles et retardant le réassort de plusieurs jours. Un chiffre de SKU inversé achemine le mauvais produit vers le mauvais rayon. Les données du secteur suggèrent que les taux d'erreur de saisie manuelle oscillent autour de 1 à 4 %, selon la complexité du formulaire. Pour un formulaire RMA de 8 à 12 champs (numéro RMA, numéro de commande, nom du client, SKU, quantité, code motif, état, instruction de tri), un taux d'erreur de 2 % signifie dix erreurs pour 500 retours — chacune nécessitant une boucle de gestion d'exception qui prend plus de temps que la saisie initiale.
Les remboursements sont retardés par la latence des données. Le client s'attend à un remboursement sous quelques jours après le scan du transporteur indiquant « livré ». Mais si les données RMA n'ont pas été saisies dans le système, l'équipe financière n'a aucun déclencheur pour initier le remboursement. Le retour reste dans les limbes du traitement — physiquement reçu, numériquement invisible. Selon les données de la NRF et de Happy Returns, 82 % des consommateurs déclarent que les retours gratuits sont importants ; 57 % ont abandonné un détaillant après une mauvaise expérience de retour. Une mauvaise expérience de retour, c'est quand le colis disparaît dans un trou noir. Ce trou noir est souvent simplement un formulaire papier qui attend dans une boîte de réception d'être saisi.
Les contre-passations fournisseurs reposent sur des données RMA jamais numérisées. De nombreux retours remontent à des défauts de fabrication. Lorsqu'un produit tombe en panne sous garantie, les notes d'inspection du formulaire RMA — code motif, état, photos — deviennent la documentation justificative d'un avoir au fournisseur. Si ces notes restent sur papier, ou dans un PDF que personne n'extrait dans l'ERP, la contre-passation n'est pas déposée. Selon l'étude Total Retail Loss Benchmark 2026 d'Appriss Retail, environ 100 milliards de dollars de pertes évitables liées à la fraude et aux abus ont été enregistrés en 2025, les abus de retours représentant à eux seuls 86 milliards de dollars. Un processus RMA papier qui ne peut pas signaler les schémas de retours suspects en temps réel est une faille que la fraude exploite.
La précision des stocks se dégrade. Seulement environ 48 % des articles retournés sont revendus au prix fort, selon les données Eightx 2026. Les 52 % restants nécessitent des décisions d'acheminement — remise à neuf, liquidation, retour au fournisseur, don, destruction — qui dépendent des données d'inspection consignées sur le formulaire RMA. Si ces données ne sont pas dans le système, les décisions d'acheminement se rabattent sur la voie la plus lente et la plus sûre : « en attente d'examen », ce qui signifie en pratique que l'article reste dans une zone de stockage des retours, perdant de la valeur chaque jour. Optoro, une plateforme de logistique inverse qui a traité plus de 100 millions de retours, estime que les coûts de traitement consomment 20 à 39 % du prix d'origine d'un article — et une part importante de ce coût provient de la main-d'œuvre et des délais introduits par la saisie manuelle des données.
La solution n'est pas un autre portail
Si vous retracez tout le flux de données RMA — portail client → scan transporteur → réception en entrepôt → inspection → mise à jour WMS → écriture comptable → déclenchement du remboursement → ajustement des stocks — chaque étape, sauf une, a été numérisée et connectée par API. La seule étape qui reste manuelle est l'extraction des données du formulaire RMA lui-même vers le système d'entrepôt ou de comptabilité. Le formulaire, quelle que soit son origine (PDF du portail, bordereau papier scanné, autorisation manuscrite), est ce qui se situe entre le retour numérique et l'entrepôt numérique. Comblez cet écart, et toute la chaîne devient automatique.
Ce n'est pas un problème d'intégration. L'intégration suppose que les deux parties parlent un protocole commun. Le formulaire RMA ne parle aucun protocole — c'est un artefact visuel. La solution est une couche d'extraction entre le formulaire et le système : quelque chose qui lit le contenu du formulaire comme le ferait un humain, mais qui le restitue sous forme de données structurées que le WMS, l'ERP ou le tableur peuvent consommer directement.
C'est là que l'extraction de colonnes personnalisées change la donne. Au lieu de dessiner des cadres autour des champs du formulaire ou d'entraîner un modèle sur des exemples de mises en page RMA — des approches qui échouent dès qu'un fournisseur modifie son format de formulaire — vous définissez ce que vous voulez extraire en nommant les colonnes : « numéro RMA », « numéro de commande », « SKU », « code motif », « état », « instruction de tri ». L'IA lit le formulaire de manière sémantique — elle comprend que « RMA # » et « numéro d'autorisation » signifient la même chose, quel que soit l'endroit où chacun apparaît sur la page. Peu importe que le formulaire soit un PDF généré par Shopify, un bordereau manuscrit scanné ou une autorisation de retour propriétaire d'un fournisseur avec une mise en page complètement différente. Le résultat est un tableur structuré dont les en-têtes de colonnes correspondent à vos conventions de nommage, prêt à être importé dans n'importe quel WMS ou système comptable. Vous pouvez voir ce flux de travail en action sur la page du convertisseur RMA vers Excel.
Pour un entrepôt qui traite 500 retours par jour, cela réduit l'étape de saisie des données de 10 heures au temps nécessaire pour télécharger un lot de formulaires RMA scannés ou photographiés et cliquer sur « traiter ». Les données extraites n'ont pas besoin d'être ressaisies, n'accumulent pas d'erreurs de transcription et circulent dans le même tableur de suivi ou WMS que l'équipe utilise déjà. Pour un aperçu plus approfondi de la façon dont cela s'intègre dans un flux de rapprochement des remboursements, consultez la répartition sur le traitement par lots des formulaires RMA dans une feuille de rapprochement unique.
Et parce que les données RMA extraites sont déjà structurées — avec des SKU, des codes motif et des champs d'instruction de tri standardisés — les alimenter dans un système d'inventaire est une importation directe, et non un exercice de ressaisie. Le flux du formulaire RMA vers le système d'inventaire devient un flux continu, et non un entonnoir.
Le point essentiel : le problème du papier RMA ne se résout pas en achetant un meilleur portail ou en mettant à niveau votre WMS. Il se résout en découplant « la lecture du formulaire » de « l'action sur les données ». Une fois ces deux étapes séparées, le formulaire peut être n'importe quoi — PDF, scan, photo, écriture manuscrite — et les systèmes en aval s'en moquent, car ils ne voient jamais le formulaire. Ils voient un tableur.
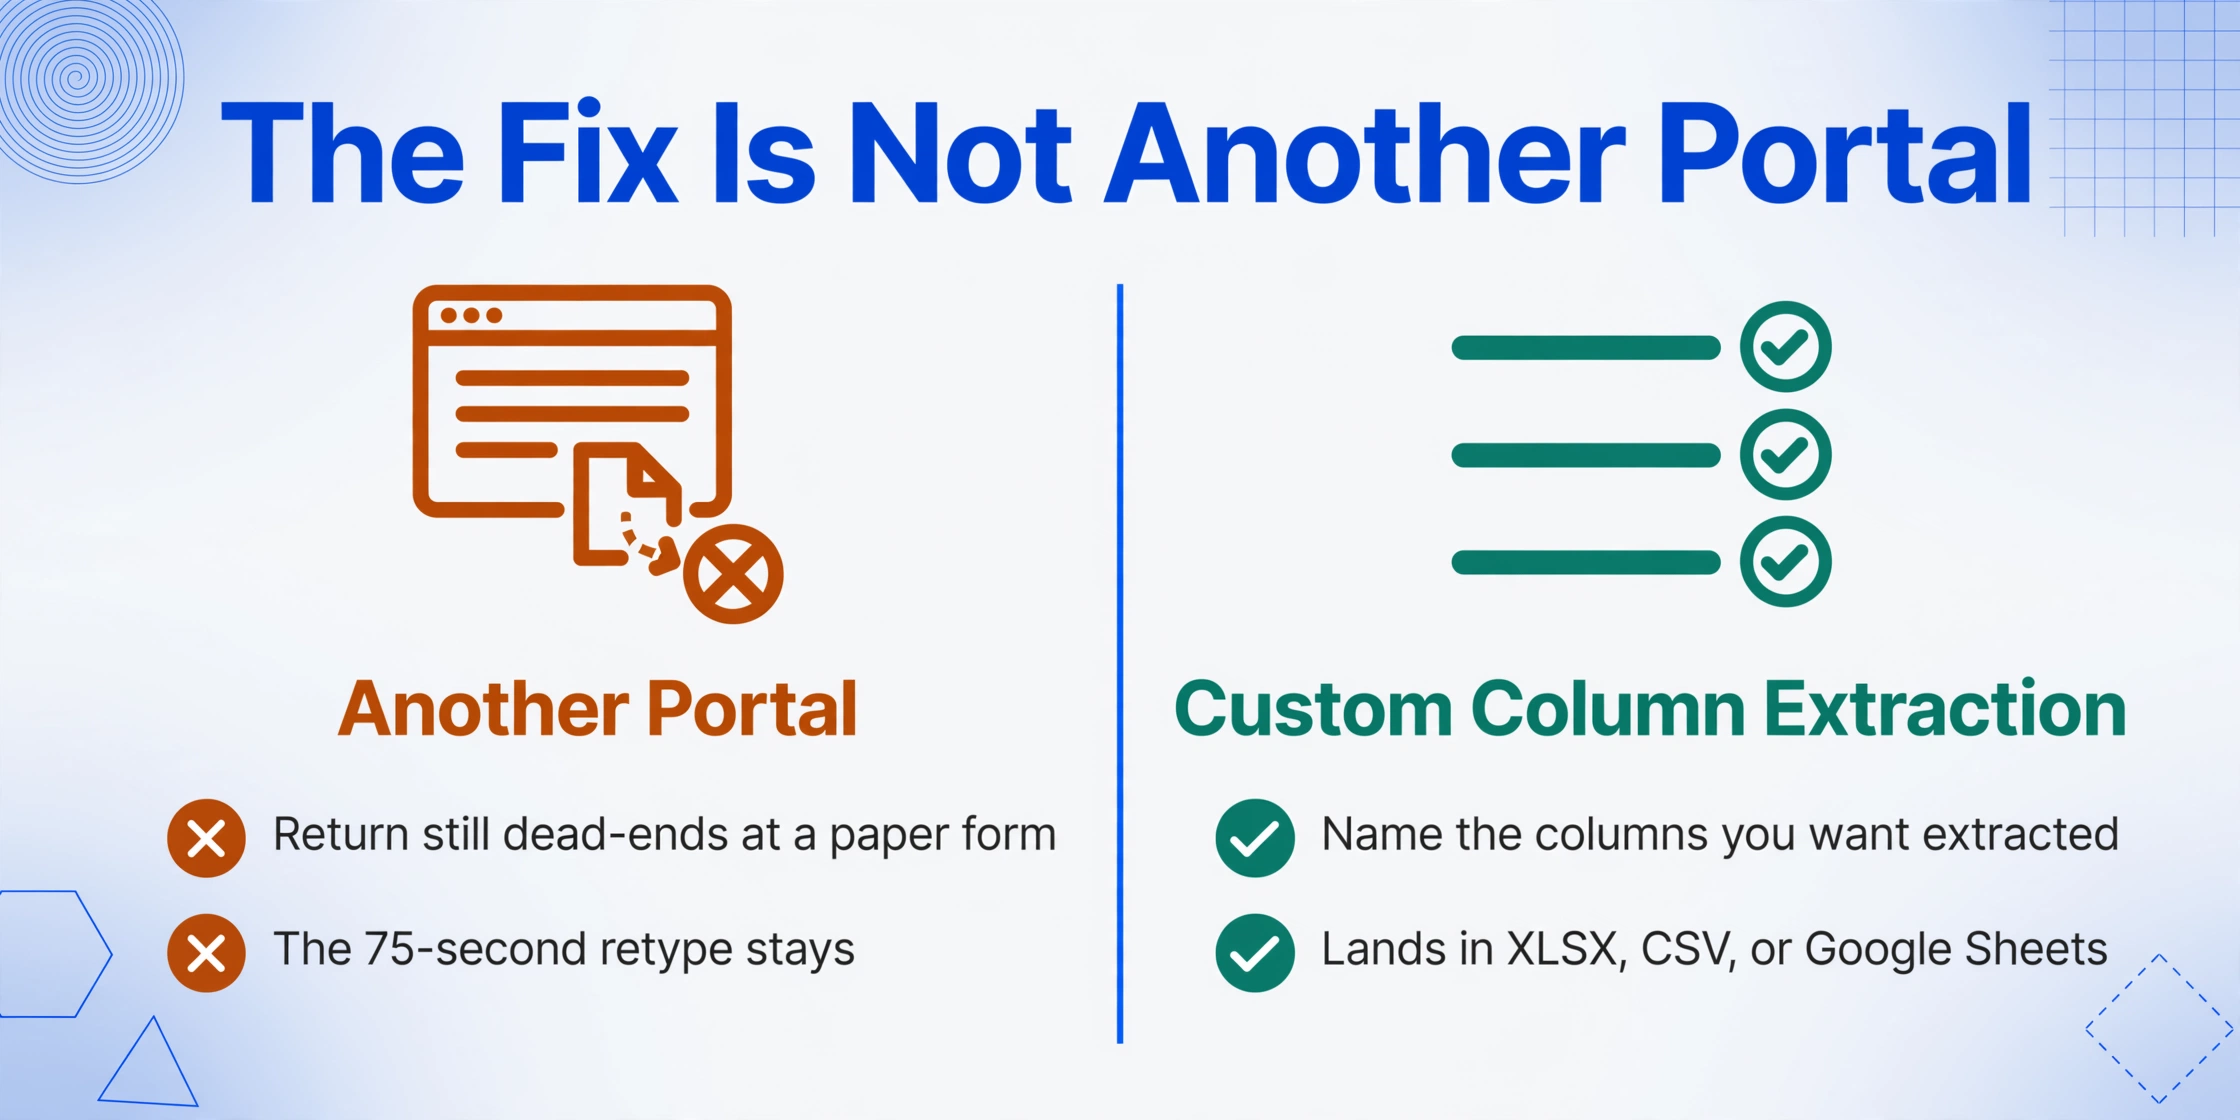
Où aboutissent les données extraites
Le résultat d'une extraction RMA n'est lié à aucun système en particulier. C'est un tableur — XLSX, CSV, ou directement vers Google Sheets. La suite dépend de votre pile technologique :
Le schéma constant : la couche d'extraction découple « la lecture du formulaire » de « l'action sur les données ». Que les données aboutissent finalement dans NetSuite, ShipStation ou une feuille Google partagée est une décision en aval qui ne change pas la configuration de l'extraction. Une seule configuration d'extraction fonctionne pour toutes les destinations. Pour compléter les données RMA avec le traitement des factures fournisseurs dans le même flux de travail, consultez le traitement par lots des factures fournisseurs dans un grand livre d'inventaire e-commerce pour comprendre comment un pipeline d'extraction unique peut gérer plusieurs types de documents alimentant le même système d'inventaire.
Questions fréquentes
Est-ce que cela fonctionne sur les bons RMA manuscrits ?
Oui. L'IA lit l'écriture manuscrite — y compris l'écriture cursive et l'écriture mixte — en comprenant le contenu de ce qui est écrit, et pas seulement en reconnaissant des caractères. Un numéro RMA ou un code motif manuscrit sur un bon papier est lu de la même manière qu'un numéro imprimé. Cela dit, une écriture extrêmement mauvaise (illisible pour un humain) posera un défi à l'IA, comme elle en poserait à n'importe quel lecteur. Une écriture lisible — le genre qu'un associé d'entrepôt peut lire et ressaisir — est tout à fait dans les capacités de l'IA.
Puis-je importer les données extraites directement dans NetSuite / Shopify / mon WMS ?
Oui, via le chemin d'importation standard de chaque plateforme. Le résultat de l'extraction est une feuille de calcul structurée (XLSX ou CSV), que chaque WMS (système de gestion d'entrepôt) et ERP majeur prend en charge comme format d'importation. Aucune intégration API personnalisée n'est requise. Mappez vos colonnes une fois — numéro RMA → champ RMA NetSuite, SKU → enregistrement d'inventaire, instruction de tri → file d'attente de routage — et réutilisez le même mappage pour chaque lot.
Et si chaque fournisseur utilise un format de formulaire RMA différent ?
C'est la valeur fondamentale de l'extraction sémantique. Parce que l'IA lit par le sens — et non par la position ou le modèle — le format du formulaire n'a pas d'importance. Que le fournisseur A place le numéro RMA dans le coin supérieur droit et que le fournisseur B le place dans une ligne d'en-tête de tableau, la logique d'extraction est la même : trouver les données qui correspondent au concept de « numéro RMA ». Le même principe s'applique au traitement des factures fournisseurs, où la variation de format entre fournisseurs est la norme.
Qu'en est-il des photos RMA prises sur une tablette ou un téléphone d'entrepôt ?
Les photos sont prises en charge tout comme les scans et les PDF. Un associé d'entrepôt peut photographier le bon RMA avec une tablette ou un téléphone et téléverser l'image directement — l'extraction fonctionne à partir de photographies, pas seulement de scans haute résolution. Cela signifie que l'étape de saisie des données peut avoir lieu au quai de réception, sur place, sans acheminer les formulaires papier vers un bureau centralisé de saisie des données.
Quelle est la précision de l'extraction par rapport à la saisie manuelle ?
Le texte imprimé sur des formulaires à la mise en page nette atteint jusqu'à 99 % de précision de reconnaissance. Les formulaires manuscrits et les photographies de mauvaise qualité auront une précision moindre, mais la comparaison clé est avec la saisie manuelle — qui a elle-même un taux d'erreur estimé entre 1 et 4 %. La différence est que les erreurs d'extraction sont cohérentes et vérifiables : vous voyez exactement ce qui a été extrait champ par champ, et les corrections sont signalées pour révision humaine plutôt que de se propager silencieusement dans le système comme le ferait un chiffre mal saisi.