Devoluções são digitais até
deixarem de ser
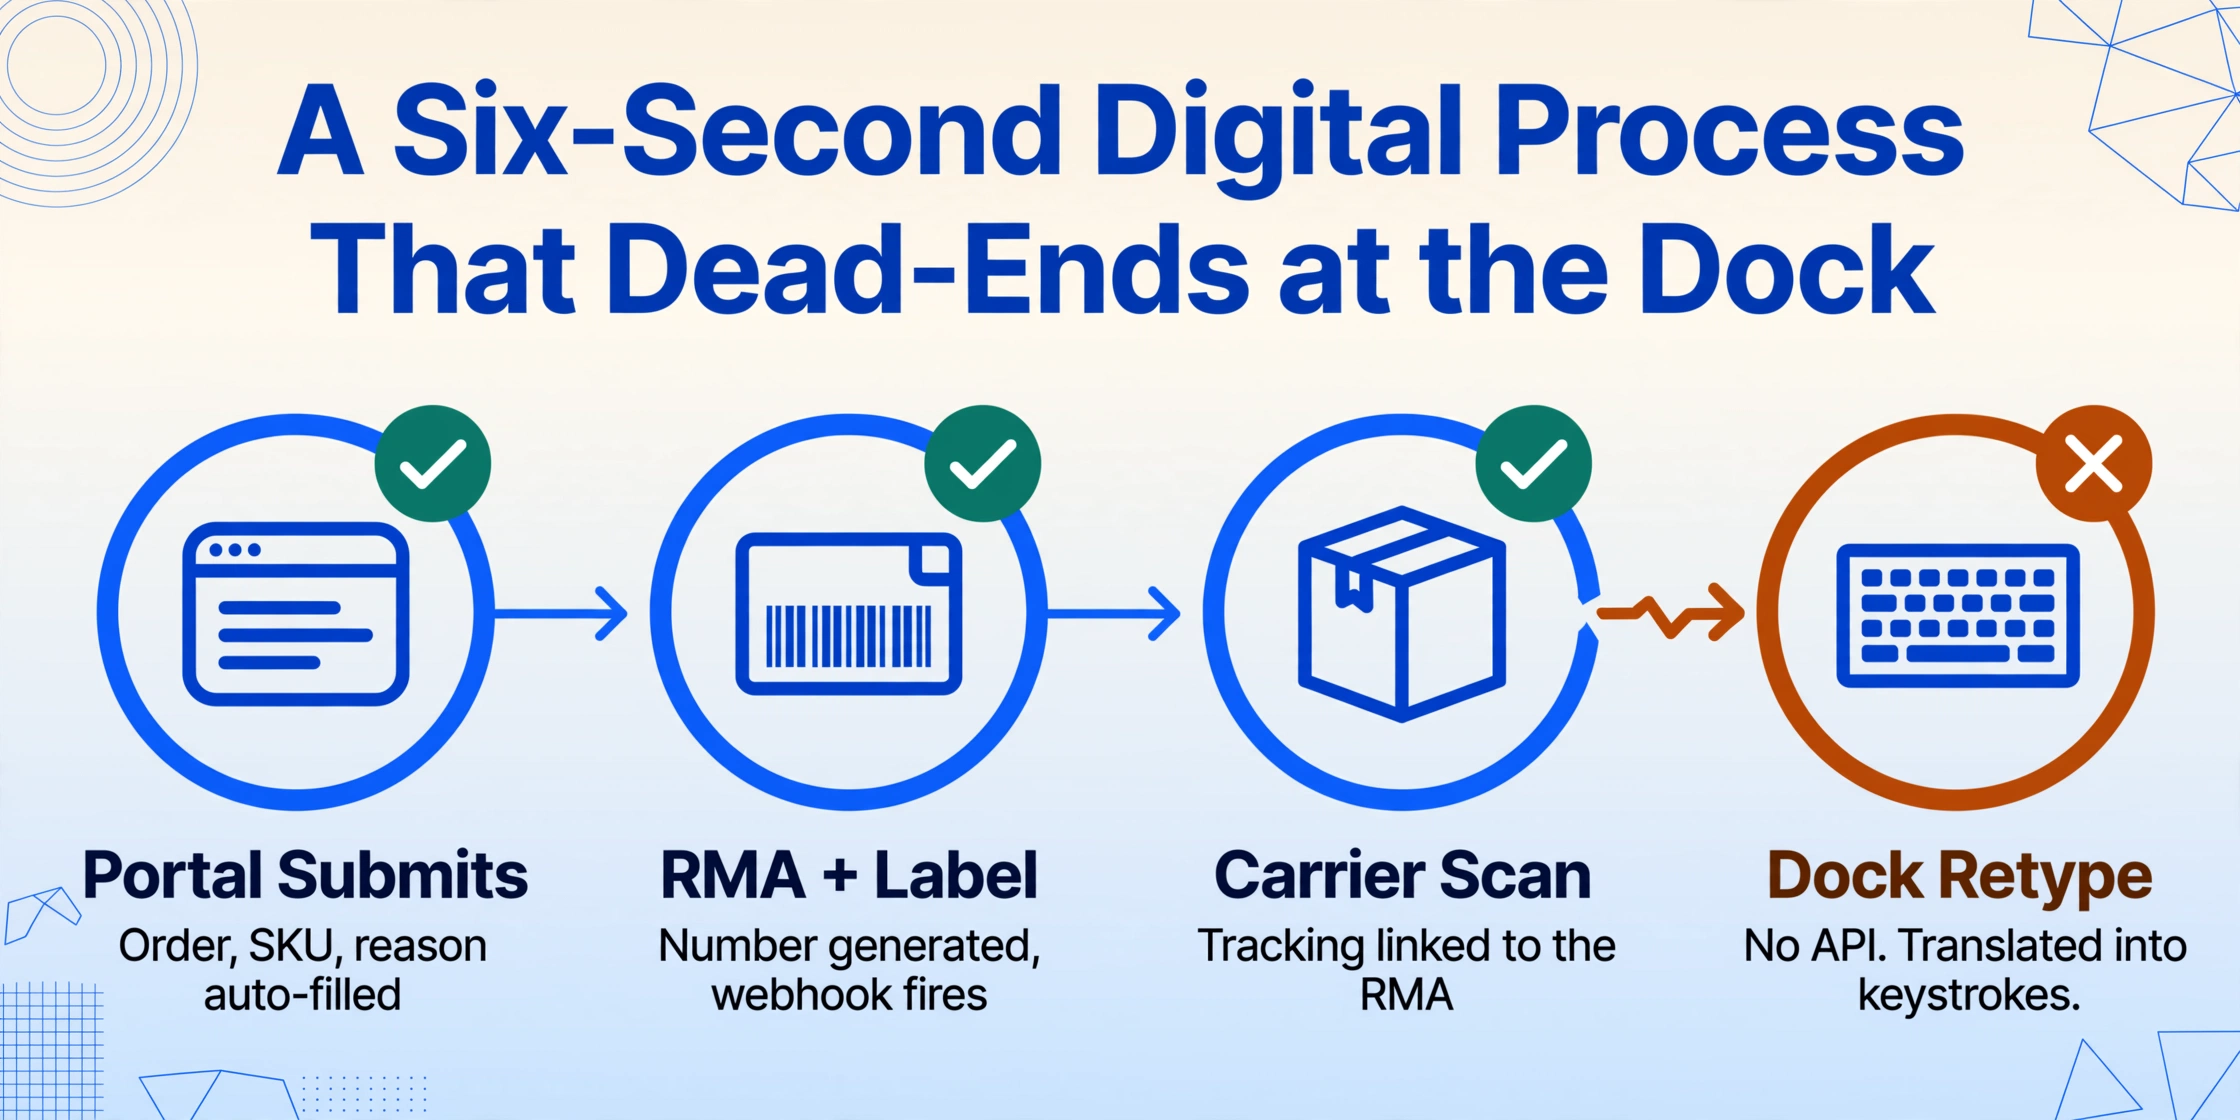
Um cliente clica em "Iniciar uma devolução" em um portal de marca. O sistema valida o pedido, verifica a política, gera uma etiqueta de envio e emite um número de RMA — tudo em menos de cinco segundos. A devolução entra em um pipeline de rastreamento que atualiza o inventário, notifica o cliente e prepara o armazém para a chegada. Cada etapa é digital, automatizada e em tempo real. Então o pacote chega à doca, alguém o abre, retira um formulário de RMA em papel — ou um PDF impresso de uma exportação do portal — e começa a digitar. Esse momento é o horizonte de eventos de dados da devolução: tudo antes dele é digital, tudo depois cai em um abismo de entrada manual, planilhas desconectadas e perda silenciosa de dados. E ninguém está medindo o que esse abismo custa.
Principais conclusões
- Seu portal de devoluções gera automaticamente o RMA, valida o inventário e dispara um webhook para o WMS em seis segundos — então o pacote chega à doca e alguém redigita cada um desses campos manualmente a partir de um formulário em papel, a US$ 25,83 por hora.
- Com 500 devoluções por dia, a redigitação manual do RMA consome 10 horas de trabalho que não adiciona nenhuma informação nova a nenhum sistema, enquanto a taxa de erro de digitação de 2% desvia silenciosamente o inventário, atrasa reembolsos e perde estornos de fornecedores.
- A solução não é outro portal ou upgrade de WMS — é extrair os dados do RMA do próprio formulário para uma planilha estruturada, reduzindo a etapa de entrada de dados de 10 horas de redigitação para um upload em lote que alimenta todos os sistemas downstream automaticamente.
Um post no r/Netsuite capturou isso perfeitamente: "O processo de RMA se tornou um trabalho em tempo integral para duas pessoas. Toda devolução começa com um cliente nos enviando um e-mail, alguém aprovando manualmente e, em seguida, gerando uma etiqueta manualmente." No r/supplychain, um distribuidor em crescimento foi mais direto: o processo de devoluções estava "devorando eles" — fluxos de trabalho manuais de RMA, pesadelos de reconciliação de créditos com fornecedores e gargalos no armazém convergindo em escala. Estas não são reclamações sobre software ruim. Elas descrevem uma lacuna estrutural: o sistema de RMA de front-end gera dados que o sistema de back-end do armazém não consegue ingerir sem um intermediário humano redigitando cada campo.
O portal de devoluções e o chão de fábrica do armazém se comunicam através de um único tradutor não confiável: a pessoa segurando o formulário de papel.
Por que a Cadeia Digital Nunca Foi Completada
Esta não é uma história de negligência. É uma história de duas metades de um sistema evoluindo em velocidades diferentes, e a costura entre elas se tornando invisível de ambos os lados. A metade voltada para o cliente das devoluções passou por três ondas de digitalização na última década: primeiro, a migração de RMA por e-mail e telefone para portais de autoatendimento; segundo, a integração desses portais com transportadoras para geração automática de etiquetas; terceiro, a camada de IA para detecção de fraudes e incentivo a trocas. Loop Returns, ReturnGO e Happy Returns fazem parte dessa pilha evolutiva.
A metade voltada para o armazém seguiu um ritmo diferente. Os sistemas de gerenciamento de armazém — Cin7, Fishbowl, ShipBob, SkuVault — foram construídos para otimizar a separação, embalagem e expedição, com o tratamento de devoluções adicionado como um módulo secundário. O fluxo de trabalho de devoluções na maioria das plataformas WMS pressupõe que alguém vai digitar os dados ou escanear um código de barras cujas informações já foram inseridas. Nenhuma das suposições se sustenta para um comprovante de RMA retirado de uma caixa.
A incompatibilidade estrutural é esta: os portais de devoluções geram dados em formatos criados para a experiência do cliente — e-mails personalizados, painéis do portal, APIs de rastreamento de transportadoras. Os sistemas WMS consomem dados em formatos criados para operações de inventário — transações em nível de SKU, atualizações de localização de bins, lançamentos contábeis. Não existe um adaptador padrão entre esses dois mundos, então cada armazém constrói o seu próprio: uma pessoa com um teclado.
O relatório de devoluções da NRF observa que 64% dos comerciantes dizem que atualizar seu processo de devoluções é uma prioridade. Mas o relatório foca quase exclusivamente no lado do cliente — taxas de devolução, conveniência de entrega, detecção de fraudes. A transferência de dados para o armazém é o problema das devoluções que não aparece nas pesquisas voltadas para o cliente, então não aparece nos roadmaps. Ele só aparece no P&L, enterrado nos custos de mão de obra e nas baixas de estoque.
O Que a Digitação Realmente Custa
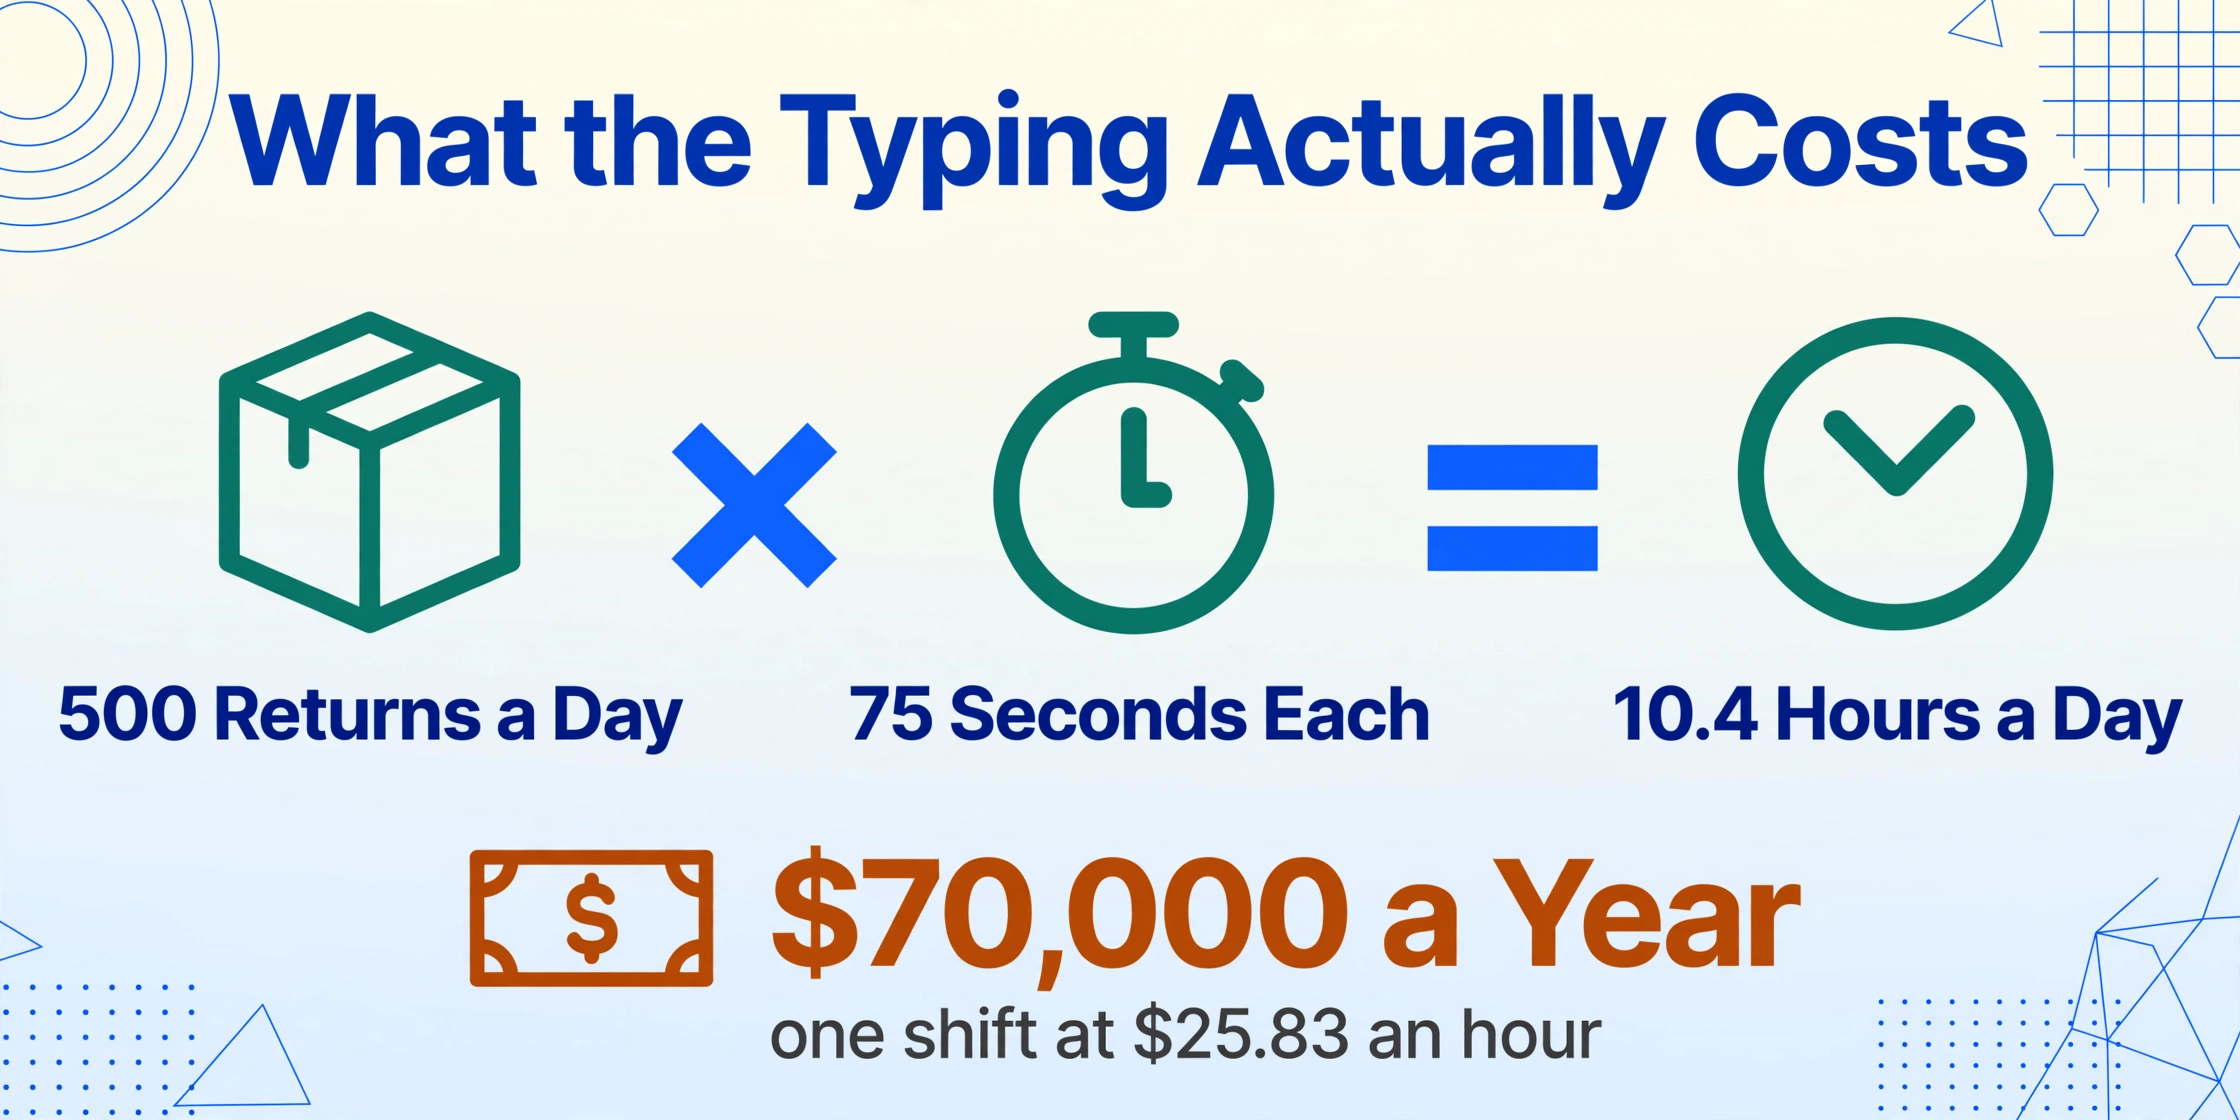
Se você processa 500 devoluções por dia com 75 segundos de entrada manual de dados em cada uma, isso representa 10,4 horas de trabalho dedicadas a uma tarefa que não produz nenhuma informação nova. Com o salário médio de armazenagem de $25,83 por hora do U.S. Bureau of Labor Statistics de março de 2026, isso equivale a cerca de $269 por dia, $70.000 por ano — para um único turno. Para um 3PL (logística terceirizada) operando dois turnos sete dias por semana, o número se aproxima de $200.000 anuais, antes de contabilizar as horas extras durante a alta temporada.
Mas a mão de obra é apenas o custo visível. Os invisíveis se acumulam silenciosamente:
Erros de entrada se propagam para as etapas seguintes. Um código do motivo digitado incorretamente — "defeituoso" em vez de "não serviu" — envia o item para o fluxo de devolução ao fornecedor em vez de devolvê-lo ao estoque, gerando custos de frete desnecessários e atrasando a reposição em dias. Um dígito de SKU transposto encaminha o produto errado para a prateleira errada. Dados do setor sugerem que as taxas de erro de entrada manual de dados giram em torno de 1-4%, dependendo da complexidade do formulário. Para um formulário de RMA com 8 a 12 campos (número de RMA, número do pedido, nome do cliente, SKU, quantidade, código do motivo, condição, destinação), uma taxa de erro de 2% significa dez erros a cada 500 devoluções — cada um exigindo um ciclo de tratamento de exceção que leva mais tempo do que a entrada original.
Os reembolsos são atrasados pela latência dos dados. O cliente espera um reembolso em poucos dias após a leitura da transportadora mostrar "entregue". Mas se os dados do RMA não foram inseridos no sistema, o time financeiro não tem nenhum gatilho para iniciar o reembolso. A devolução fica em um limbo de processamento — fisicamente recebida, digitalmente invisível. De acordo com dados da NRF e da Happy Returns, 82% dos consumidores dizem que devoluções gratuitas são importantes; 57% já abandonaram um varejista após uma experiência ruim de devolução. Uma experiência ruim de devolução é aquela em que o pacote desapareceu em um buraco negro. Esse buraco negro geralmente é apenas um formulário de papel sentado em uma bandeja de entrada esperando pela entrada de dados.
Os estornos de fornecedores dependem de dados de RMA que nunca foram digitalizados. Muitas devoluções são rastreadas até defeitos do fabricante. Quando um produto falha sob garantia, as notas de inspeção do formulário de RMA — código do motivo, condição, fotos — tornam-se a documentação de suporte para uma nota de débito ao fornecedor. Se essas notas permanecerem em papel, ou estiverem em um PDF que ninguém extrai para o ERP, o estorno não é registrado. De acordo com o Appriss Retail's 2026 Total Retail Loss Benchmark, cerca de $100 bilhões em perdas evitáveis por fraude e abuso ocorreram em 2025, com o abuso de devoluções respondendo sozinho por $86 bilhões. Um processo de RMA baseado em papel que não consegue sinalizar padrões suspeitos de devolução em tempo real é uma lacuna que a fraude explora.
A precisão do inventário se degrada. Apenas cerca de 48% dos artículos devolutos são revendidos a preço integral, de acordo com dados de Eightx 2026. Os outros 52% precisam de decisões de roteamento — reacondicionar, liquidar, devolver ao fornecedor, doar, destruir — que dependem dos dados de inspeção registrados no formulário de RMA. Se esses dados não estão no sistema, as decisões de roteamento seguem por padrão o caminho mais lento e seguro: "segurar para revisão", o que na prática significa que o artigo fica na área de espera de devoluções, perdendo valor dia a dia. Optoro, uma plataforma de logística reversa que processou mais de 100 milhões de devoluções, estima que os custos de processamento consomem 20-39% do preço original de um artigo — e uma parte significativa desse custo é o trabalho e o atraso introducidos pelo manuseo manual de dados.
A Solução Não É Outro Portal
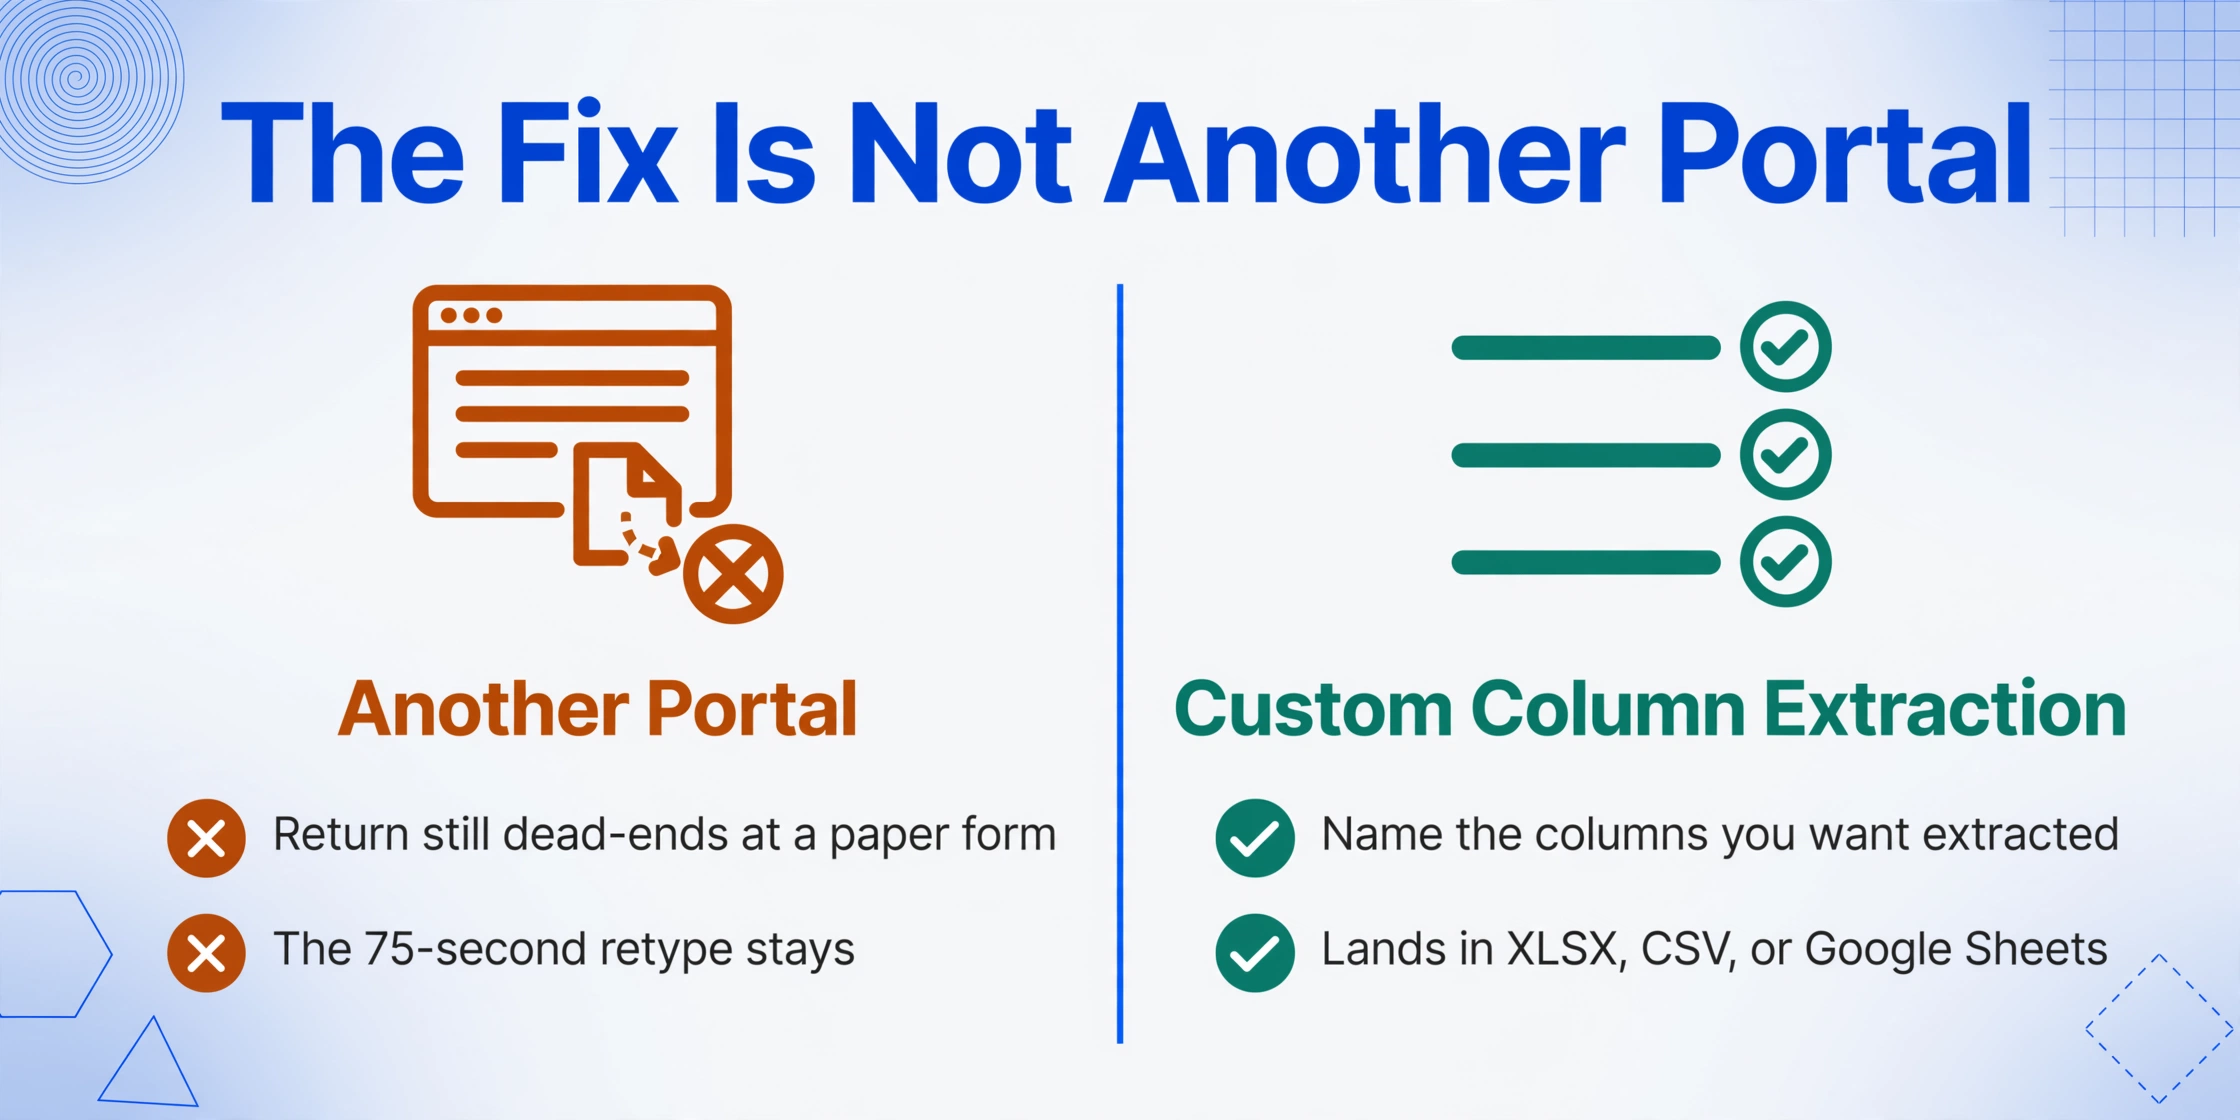
Se você rastrear todo o fluxo de dados de RMA — portal do cliente → scan da transportadora → recepção no armazém → inspeção → atualização do WMS → entrada contable → gatillo de reembolso → ajuste de inventário — cada passo, menos um, foi digitalizado e conectado via API. O único passo que permanece manual é a extração de dados do próprio formulário de RMA para o sistema de armazém ou contable. O formulário, independentemente de sua origem (PDF do portal, papel escaneado, autorização manuscrita), é o que fica entre a devolução digital e o armazém digital. Feche essa lacuna, e toda a cadeia se torna automática.
Este não é um problema de integração. A integração assume que ambos os lados falam um protocolo comum. O formulário de RMA não fala nenhum protocolo — é um artefacto visual. A solução é uma capa de extração entre o formulário e o sistema: algo que lê o conteúdo do formulário como faría um humano, mas o emite como dados estruturados que o WMS, ERP ou planilha podem consumir diretamente.
É aqui que a Extraction de Colunas Personalizadas muda a equação. Em vez de desenhar caixas ao redor dos campos do formulário ou treinar um modelo em layouts de RMA de exemplo — abordagens que se rompen no momento em que um fornecedor cambia o formato de seu formulário — você define o que deseja extrair nomeando as colunas: "Número de RMA", "Número de Pedido", "SKU", "Código do Motivo", "Condição", "Destinação". A IA lê o formulário semanticamente — entende que "RMA #" e "Número de Autorização" significam a mesma coisa, independentemente de onde cada um aparece na página. Não importa se o formulário é um PDF gerado por Shopify, um papel manuscrito escaneado ou uma autorização de devolução proprietária do fornecedor com um layout completamente diferente. A saída é uma planilha estruturada cujos cabeçalhos de columna coinciden com suas convenções de nomenclatura, pronta para importar em qualquer WMS ou sistema contable. Você pode ver este fluxo de trabalho em ação na página conversor de RMA a Excel.
Para um armazém que processa 500 devoluções por dia, isso reduz a etapa de entrada de dados de 10 horas ao tempo que leva cargar um lote de formulários de RMA escaneados ou fotografados e clicar em "processar". Os dados extraídos não precisam ser reescritos, não acumulan erros de transcrição e fluem na mesma planilha de rastreo ou WMS que a equipe já usa. Para uma visão mais profunda de como isso se integra em um fluxo de trabalho de conciliación de reembolsos, vea o desglose em processamento em lote de formulários de RMA em uma única planilha de conciliación.
E como os dados de RMA extraídos já estão estruturados — com SKUs, códigos de motivo e campos de destinação estandarizados — alimentar um sistema de inventário é uma importação direta, não um exercício de reescritura. O pipeline do formulário de RMA ao sistema de inventário se torna um feed, não um funil.
O ponto central: o problema do papel no RMA não se resolve comprando um portal melhor ou atualizando seu WMS. Se resolve separando "leer el formulario" de "actuar sobre los datos". Uma vez que essas duas etapas são separadas, o formulário pode ser qualquer coisa — PDF, digitalização, foto, manuscrito — e os sistemas downstream não se importam, porque nunca veem o formulário. Veem uma planilha.
Onde os Dados Extraídos Chegam
A saída de uma extração de RMA não está vinculada a um único sistema. É uma planilha — XLSX, CSV ou direto ao Google Sheets. Para onde vai depois depende da sua stack:
O padrão consistente: a camada de extração separa "leer el formulario" de "actuar sobre los datos". Se os dados chegam finalmente ao NetSuite, ShipStation ou a uma Google Sheet compartilhada é uma decisão downstream que não altera como a extração é configurada. Uma única configuração de extração funciona em todos os destinos. Para complementar os dados de RMA com o processamento de faturas de fornecedores no mesmo fluxo de trabalho, veja processamento em lote de faturas de fornecedores em um livro de inventário de e-commerce para entender como um único pipeline de extração pode manejar múltiples tipos de documentos alimentando o mesmo sistema de inventário.
Perguntas Frequentes
Funciona com formulários de RMA manuscritos?
Sim. A IA lê escrita à mão — incluindo cursiva e letra de forma mista — entendendo o conteúdo do que está escrito, não apenas reconhecendo caracteres. Um número de RMA ou código do motivo manuscrito em um formulário de papel é lido da mesma forma que um impresso. Dito isso, escrita extremamente ilegível (ilegível para um humano) desafiará a IA, assim como desafiaria qualquer leitor. Escrita legível — o tipo que um funcionário de armazém consegue ler e digitar — está bem dentro do alcance.
Posso importar os dados extraídos diretamente para NetSuite / Shopify / meu WMS?
Sim, pelo caminho de importação padrão de cada plataforma. A saída da extração é uma planilha estruturada (XLSX ou CSV), que todo WMS e ERP importante suporta como formato de importação. Não é necessária integração de API personalizada. Mapeie suas colunas uma vez — Número de RMA → campo RMA do NetSuite, SKU → registro de inventário, Destinação → fila de roteamento — e reutilize o mesmo mapeamento para cada lote.
E se cada fornecedor usar um formato de formulário de RMA diferente?
Esse é o valor central da extração semântica. Como a IA lê pelo significado — não pela posição ou modelo — o formato do formulário não importa. Se o Fornecedor A coloca o número de RMA no canto superior direito e o Fornecedor B o coloca em uma linha de cabeçalho de tabela, a lógica de extração é a mesma: encontrar os dados que correspondem ao conceito de "Número de RMA". O mesmo princípio se aplica ao processamento de faturas de fornecedores, onde a variação de formato entre fornecedores é a norma.
E fotos de RMA tiradas em tablet ou celular no armazém?
Fotos são suportadas, assim como digitalizações e PDFs. Um funcionário do armazém pode fotografar o formulário de RMA com um tablet ou celular e enviar a imagem diretamente — a extração funciona a partir de fotografias, não apenas digitalizações de alta resolução. Isso significa que a etapa de entrada de dados pode acontecer no cais de recebimento, na hora, sem encaminhar formulários de papel para uma central de entrada de dados.
Qual a precisão da extração em comparação com a entrada manual?
Textos impressos em layouts de formulários limpos atingem até 99% de precisão de reconhecimento. Formulários manuscritos e fotografias de baixa qualidade terão menor precisão, mas a comparação principal é com a entrada manual — que por si só tem uma taxa de erro estimada de 1 a 4%. A diferença é que os erros de extração são consistentes e revisáveis: você vê exatamente o que foi extraído campo por campo, e as correções são sinalizadas para revisão humana, em vez de se propagarem silenciosamente pelo sistema como um dígito digitado incorretamente faria.