処方箋抽出の精度はどのくらい?
項目別分析
薬局ソフトウェアベンダーが自社のAI抽出は「97%の精度」だと主張するとき、実際には何を期待すべきでしょうか。問題はその数字が真実かどうかではなく、どの3%が失敗するか、そしてその失敗が患者の転帰に影響する項目に及ぶかどうかです。処方箋データでは、項目によってエラーリスクは大きく異なります。メトホルミンとメトロニダゾールを混同するのは、補充回数の打ち間違いより重大です。また、抽出精度自体はAIモデルよりも、入力されるドキュメントの状態に左右されます。鮮明な電子処方箋を99%で読み取る同じシステムでも、2007年製の感熱ファックス機を使うクリニックから送られてくるFAX処方箋では85%に落ち込むことがあります。本記事では処方箋抽出の精度を項目別に分解し、御社の薬局にとって実際に重要なエラープロファイルに照らしてツールを評価できるようにします。
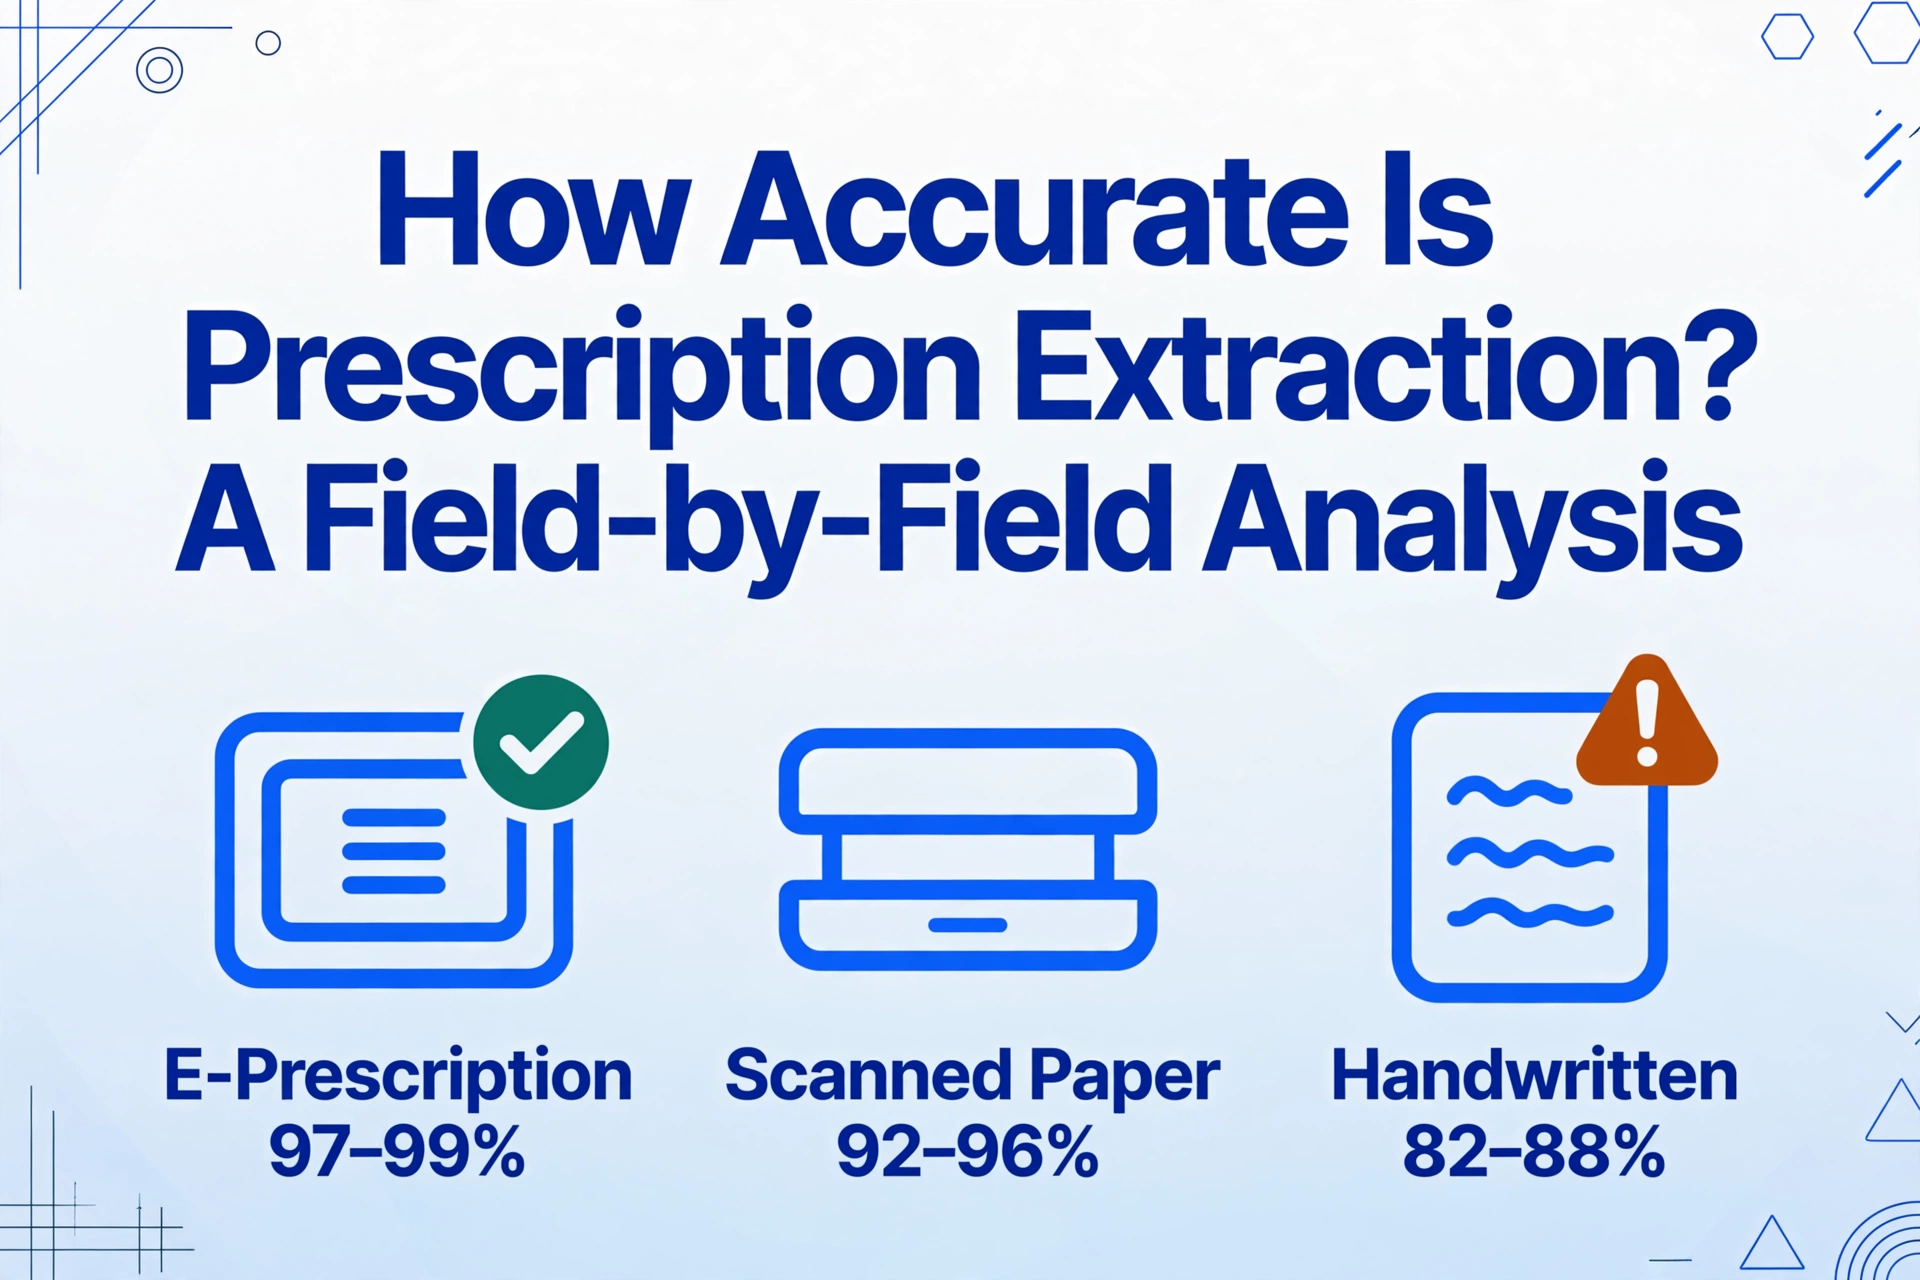
重要ポイント
- 薬局向けAIベンダーは単一の精度数値を提示しますが、「97%」は薬剤名(誤抽出が患者に害を及ぼす可能性がある項目)と補充回数(間違えても単に煩わしいだけの項目)を平均した数字です。
- 抽出エラーが最も大きな損害をもたらす項目(NDC番号やDEA番号)は、既存のワークフローでは見落とされがちです。データ入力後にNDCを元の処方箋と照合し直す人はいないからです。
- 項目別の精度フレームワークは、ベンダーの主張を運用上のパラメータに変換します。どの項目に二重チェックが必要か、どのくらいの頻度で行うか——マーケティング資料ではなく、御社の薬局の実際の入力構成に基づいて判断できます。
取り戻せない5秒
毎分50ワード入力できる薬局テクニシャンでも、1枚の処方箋を薬局管理システムに転記するには約50秒かかります。そして、その入力のうち25件に1件は、少なくとも1つのエラーを含んでいます。
AIによる処方箋抽出に関する標準的な効率性の論調は、次のようなものです。手動データ入力は遅い、AIは速い、だからAIを導入すべきだ。これは明快な方程式であり、間違ってはいません。時間の節約は確かに現実のものです。しかし、その議論の後半部分——精度に何が起こるか——については、ほとんどのベンダーは単一のパーセンテージポイントで議論を止め、先に進んでしまいます。
Research in Social and Administrative Pharmacyに掲載された2024年の62件の研究の系統的レビューでは、薬局調剤エラーの世界的なプール有病率は1.6%であり、個々の研究では検出方法に応じて11.53%もの割合が報告されています(Umら、2024年)。画期的な全国観察研究において、Flynnらは、米国で年間に調剤される30億件の処方箋のうち、5,150万件の調剤エラーが発生していると推定しています。これは、標準的な薬局では1日あたり約4件のエラーに相当します(Flynnら、2003年)。世界保健機関(WHO)のMedication Without Harmイニシアチブは、薬剤関連の害が世界の患者の約20人に1人に影響を及ぼしていると報告しています。そして、薬剤師やテクニシャンが処方箋を読み取り、PMSに入力するデータ入力画面は、薬がボトルから出る前に、これらのエラーのかなりの割合が発生する場所です。
本当の疑問は「AIはどれだけ速く処方箋を抽出できるか?」ではなく、「どのフィールドで抽出が失敗し、それが起こったらどうなるのか?」です。 フィールドごとの分析により、精度は均等に分布しているわけではないことが明らかになります。一部のフィールドには、患者に届く前に誤りをキャッチする組み込みの検証レイヤーがありますが、他のフィールドにはそれがありません。
入力品質が精度の下限を決める
AIモデルが処方箋に触れる前に、文書の物理的な状態によって達成可能な精度の上限はすでに決まっています。画像に写っていない情報を、いかなるモデルも復元することはできません。
処方箋は主に3つの経路で薬局に届き、それぞれに特有の劣化パターンがあります。
| 入力経路 | 一般的な画質 | 期待される抽出精度 | 主な失敗モード |
|---|---|---|---|
| 電子処方箋(SureScripts、EPCS) | デジタルネイティブ、鮮明なテキスト | フィールドレベルで97~99% | 稀;SIGコードの正規化の不一致 |
| スキャンされた紙の処方箋 | 300 DPIフラットベッドスキャン、良好なコントラスト | 印字:92~96%;手書き:82~88% | 複数行のSIG指示における手書き文字 |
| FAX処方箋(感熱紙) | 低解像度、かすれ、傾き | 平均フィールドレベルで85~92% | 文字の断片化;NDC/用量の数字がにじむ |
実際の処方箋にPaddleOCRを使用した2024年の研究では、印字された処方箋では約95%のテキスト抽出精度が達成された一方、手書きの処方箋では約85%に低下し、ノイズ除去や二値化などの前処理を行っても10ポイントの差が残ることが示されました。ANN(人工ニューラルネットワーク)を強化した処方箋OCRに関する別の研究では、改善されたシステムのPAR(Prescription Accuracy Rate:すべての重要フィールドが正しく認識された処方箋の割合)は85.7%で、ベースラインOCRの78.0%から向上しました(Gudi, 2025)。これが精度の下限問題です。FAXの受信件数が多い場合、最高のモデルでも低いベースラインからスタートすることになります。
実用的な教訓は、FAX処方箋にAI抽出を使うのを避けることではなく、最良のシナリオではなく、実際に受け取る入力品質に合わせて検証ワークフローを設計することです。 電子処方箋が80%、FAX処方箋が20%の薬局と、その比率が逆の薬局とでは、異なる検証チェックポイントの設計が必要です。
薬剤名問題:似ているだけでは不十分な理由
1975年以来、ISMP(米国安全な医薬品使用研究所)は「紛らわしい薬剤名リスト」を維持しています。これは、外観や発音が十分に似ているために実際の調剤ミスを引き起こす薬剤ペアのカタログです。抽出システムにとって、このリストは「近似一致」と「誤った薬剤」の違いを分けるものです。
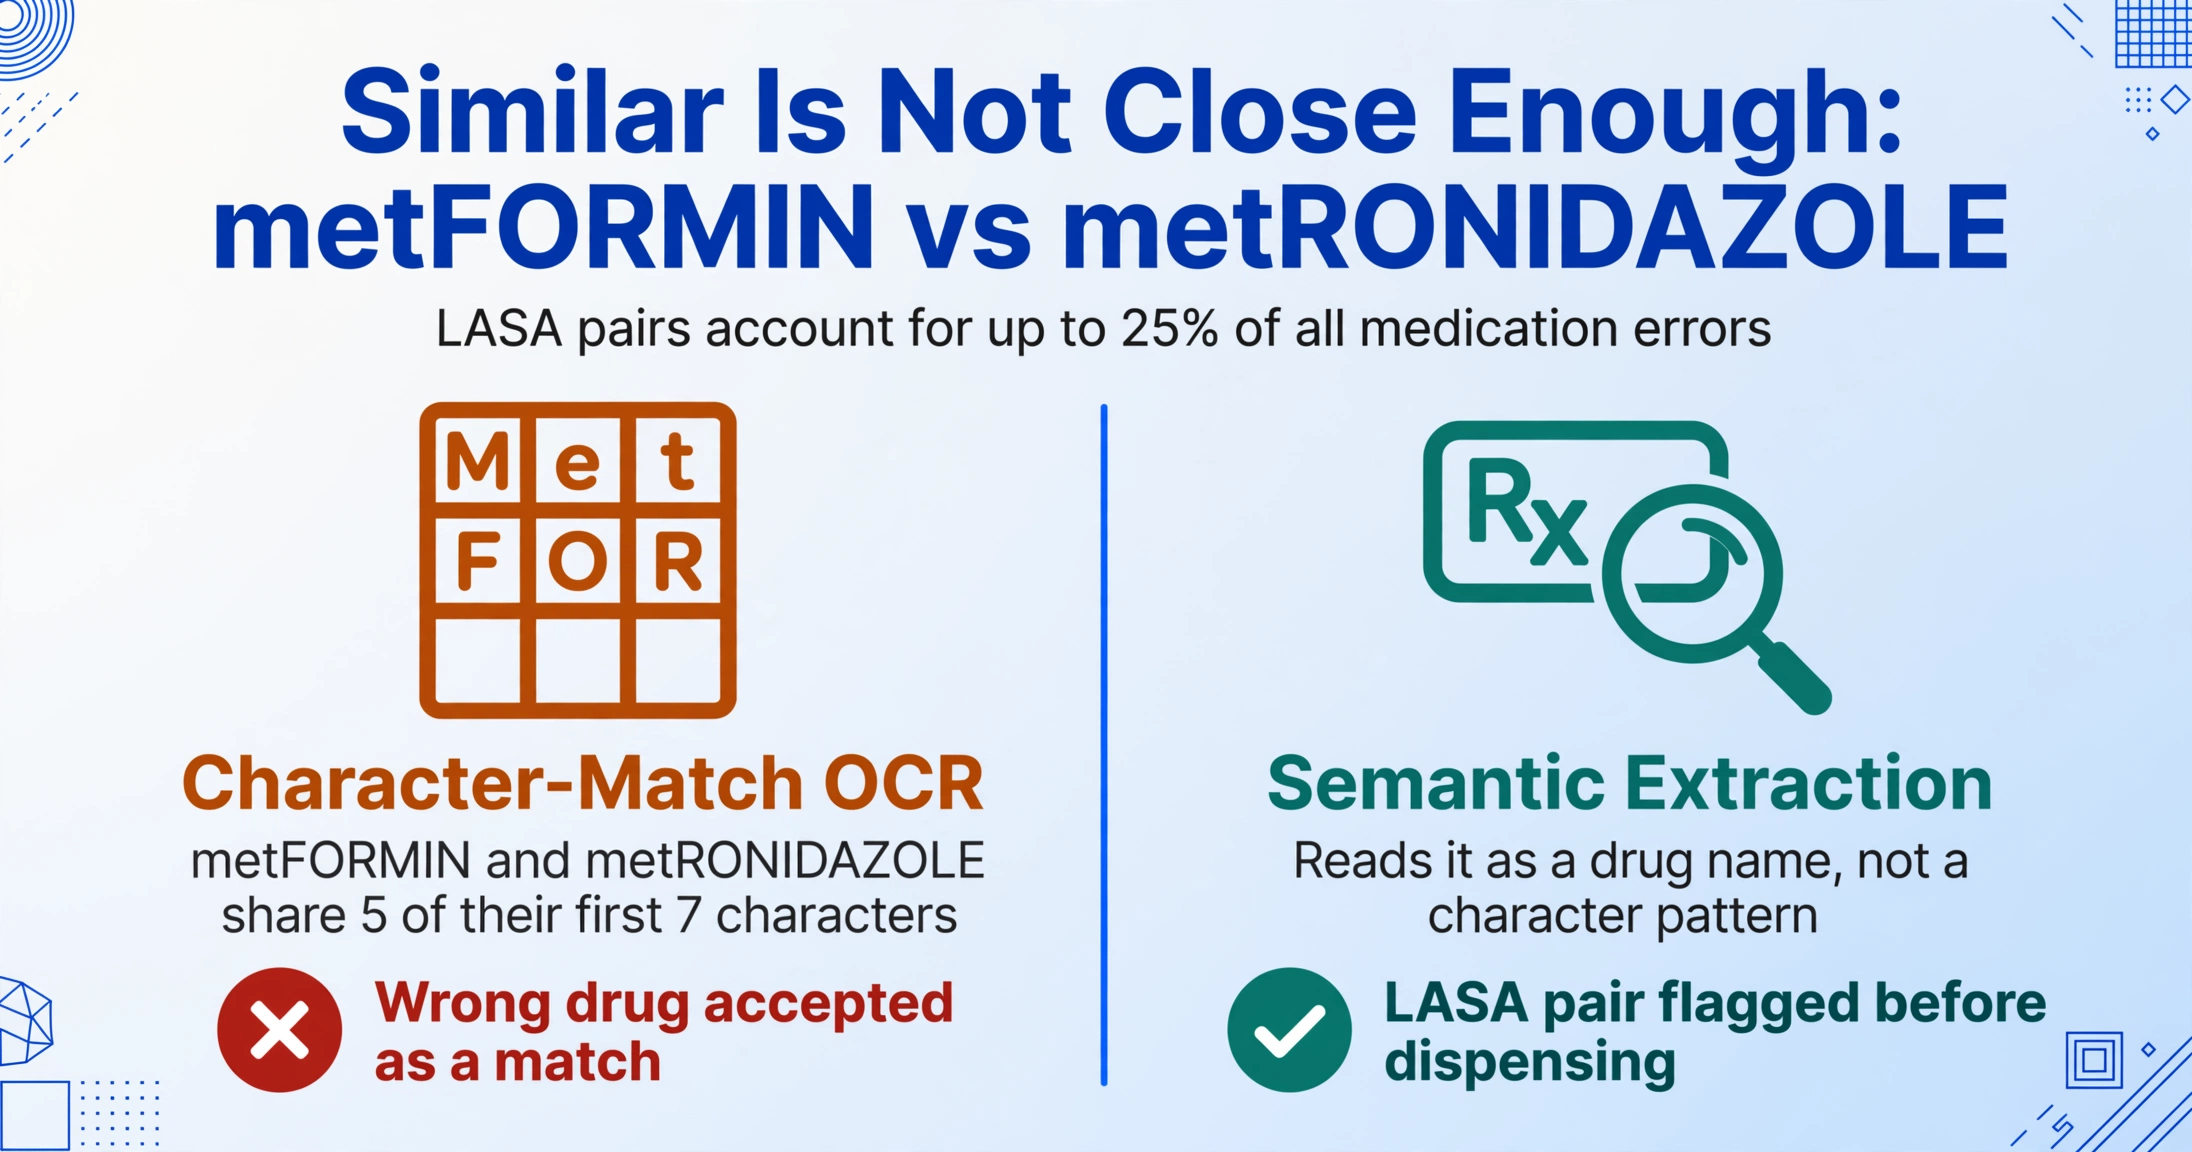
LASA(外観・発音類似)薬剤名ペアは、全投薬ミスの最大25%を占めると推定されており、そのリストは決して小さくありません。ISMPの現在のカタログには、ブランド間・ブランドとジェネリック間・ジェネリック間のペアが数百件登録されています(ISMP紛らわしい薬剤名リスト)。その影響は具体的で、混乱を防ぐために薬剤名が変更された例もあります。LosecはLasixとの混同が繰り返された後、Prilosecに変更されました。BrintellixはBrilintaとの混乱を避けるためTrintellixに改名されました。Celebrexは当初Celebraとして発売されましたが、Celexaとの混同が懸念されました。
人間の薬局テクニシャンにとって、LASAエラーへの防御はトレーニング、タルマンレタリング(ヒドロキシジンとヒドララジンを大文字小文字を混在させて視覚的に区別する方法)、そして独立したダブルチェックです。AI抽出システムにとって、課題は異なりますが、その深刻さは変わりません。OCRベースのシステムは文字パターンを見ており、薬剤名を見ているわけではありません。OCRエンジンにとって、「メトホルミン」と「メトロニダゾール」は最初の7文字のうち5文字が一致します。これは、単純なシステムなら受け入れてしまう可能性のある高信頼度の部分一致です。一方、意味的抽出エンジンは、糖尿病患者的なプライマリケア受診の処方箋を読んでいることを理解し、メトホルミンである確率を高く重み付けします。文字認識の問題に文脈をもたらすのです。
あまり注目されていない関連リスクがあります。NDCと薬剤名の相互検証は、ほとんどの抽出ツールが提供していない第二の防御線です。システムが「リシノプリル10mg」を抽出したのに、同じ行のNDCがアトルバスタチンを示している場合、適切に設計された抽出パイプラインは、データがPMSに到達する前にその不整合を検出します。このような文書内検証(抽出されたフィールドが内部的に整合しているかを確認すること)は、抽出を一回限りのOCRタスクから、多層的な精度チェックへと変革します。
NDC:10桁の落とし穴
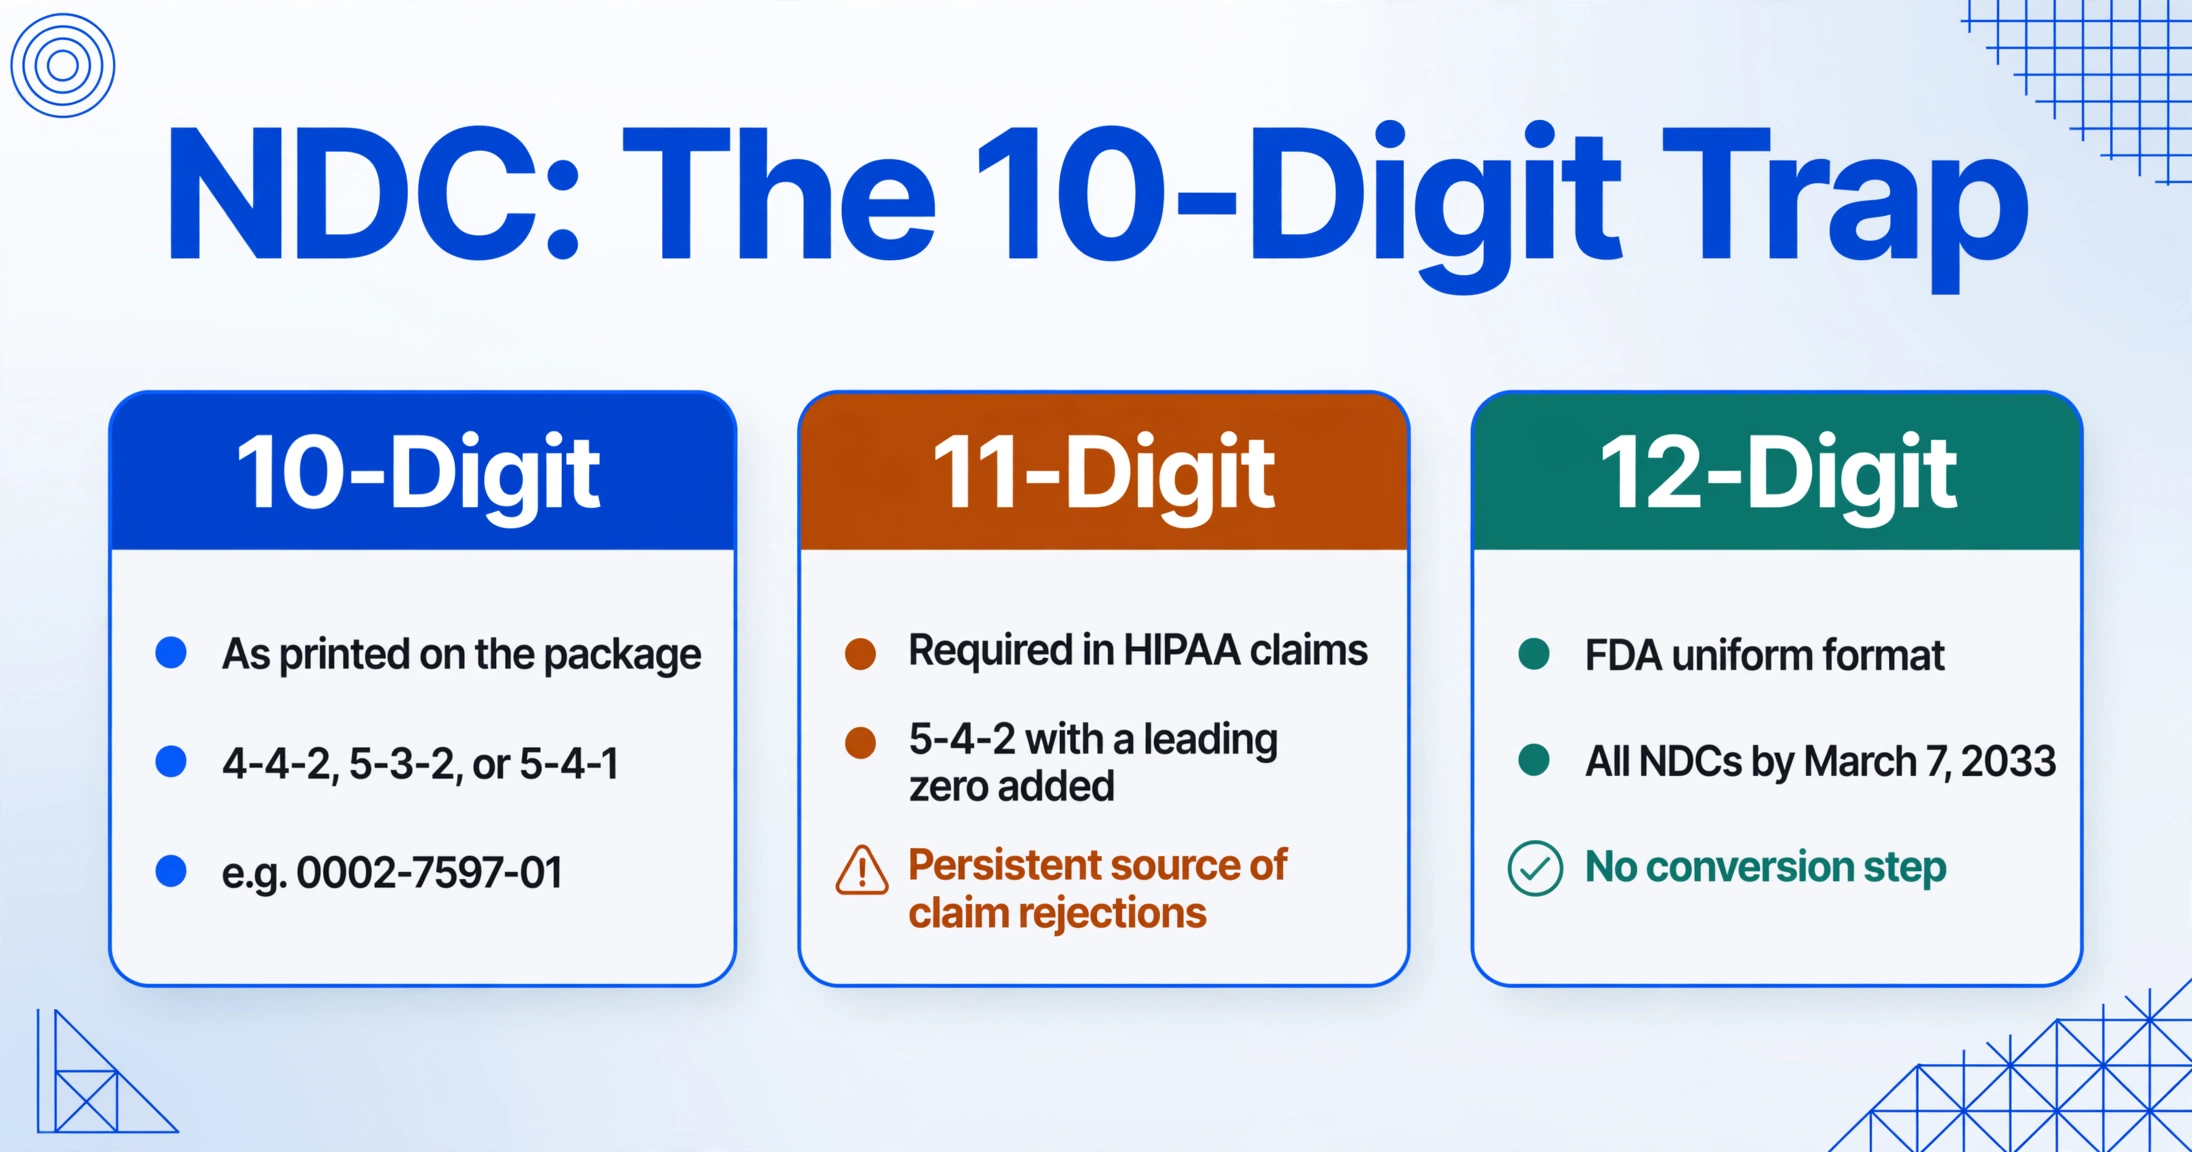
1つのNDCは、使用される場面に応じて最大3つの有効な表記を持ちます。そして、その間の変換は、人間が一貫して間違え、AIが予測不能に間違える種類の機械的な作業です。
NDC(National Drug Code)は、10桁・3セグメントの識別子です:ラベラーコード(4桁または5桁)、製品コード(3桁または4桁)、パッケージコード(1桁または2桁)。FDAはNDCを3つの形式(4-4-2、5-3-2、5-4-1)で割り当てるため、同じ薬のNDCがパッケージに0002-7597-01(4-4-2)や60574-4114-1(5-4-1)と表示されることがあります。しかし、HIPAA対象取引では固定の5-4-2形式の11桁NDCが必要であり、短いセグメントに先頭ゼロを追加することで実現されます。そのゼロの位置は、NDCが3つの元の形式のどれを使用しているかによって異なります(FDA NDC形式ガイダンス)。
この変換(10桁から11桁へ)は、請求拒否の持続的な原因となっています。FDA自身も2023年のNDC形式改定に関する規則案で、「医療システムと支払者は現在、10桁のNDCを11桁のNDCに変換しており、これが医療費を増加させ、投薬ミスの要因となる可能性がある」と認めています(FDA、2023年)。問題はさらに複雑化します:2026年3月、FDAはすべてのNDCを2033年3月7日までに統一の12桁形式(6-4-2)に移行する規則を最終決定し、2036年3月までの3年間の移行期間を設けました。この期間中、薬局のPMSは10桁、11桁、12桁のNDCを同時に受け取る可能性があります。同じ製品識別子に対して3つの異なる形式です。
抽出システムにとって、NDC精度の課題には2つの層があります:画像から正しい数字を抽出すること、そして抽出された数字がどの形式を表すかを把握することです。最初の層はOCRの問題です(これは0か8か?ハイフンは存在するか、それとも汚れか?)。2番目の層はドメイン知識の問題です:システムが「NDC」とラベル付けされたフィールドから9桁を抽出した場合、それは先頭ゼロが欠落した5-3-1形式なのか、末尾ゼロが欠落した5-4-0形式なのか?その答えによって、データが有効な識別子としてPMSに流れるか、拒否された請求になるかが決まります。
用法用量、DEA、および規制データチェーン
薬剤名とNDCの誤りはデータ品質の問題ですが、用法用量とDEA番号の誤りは規制コンプライアンスの問題です。この違いは、ワークフローでどの程度の抽出エラーを許容できるかを評価する際に重要になります。
用法用量の抽出エラーは、一般的に3つのカテゴリに分類されます。単位の混同(mcgをmgとして抽出 — 1,000倍の投与量エラー)、小数点のずれ(0.5mg → 5mg)、および用量と数量の混同(10mg錠と10錠の数量)。ISMPは、手動入力におけるこれらの障害モードに特化して対応するため、エラーを起こしやすい略語や用量指定のリストを管理しています。しかし、AI抽出の場合、問題はより微妙です。「Levothyroxine 0.025 mg」を読み取ったビジョンモデルは、文字自体は正しく転記しても、それらを誤った出力列に配置し、用量を数量フィールドに割り当ててしまう可能性があります。エラーは「読み取り」にあるのではなく、テキストが「何を言っているか」だけでなく「何を意味するか」の理解を必要とするフィールド割り当てにあります。
DEA番号には、フォーマットに組み込まれた構造的な検証機能があります。有効なDEA番号は、2文字のアルファベットとそれに続く7桁の数字で構成され、2文字目は処方者の姓の頭文字、7桁目は最初の6桁から計算されるチェックサムです。つまり、抽出システムは即座にフォーマット検証を実行できます。抽出された文字列がDEAチェックサムアルゴリズムと一致しない場合、それは誤読または無効な番号です。実用的な意味合いとして、DEA番号の抽出には検証可能な正確性率があります。システムがチェックサムを通過する文字列を生成する頻度を正確に測定し、通過しなかったものはすべて手動レビュー用にフラグを立てることができます。このレベルの組み込み検証を備えた処方箋フィールドは他にありません。
州のPMPデータ要件はさらに別の層を追加します。37の州の処方薬モニタリングプログラムでは、規制物質(スケジュールII~IV)の処方箋を発行する前に、処方者がPMPレジストリを参照することを義務付けており、PMPデータの正確性は完全に薬局や調剤事業者が報告する内容に依存します(NASCSA、2024年PMPリソース)。各調剤事業者は、提出するデータの完全性に責任を負います。「PMPデータが正確かつ完全であることの保証は」、すべての調剤薬局の責任です(ワシントン州保健局)。PMPレジストリに到達した抽出エラーは、患者の規制物質履歴に恒久的な不一致を生み出し、将来のPMP照会で誤ったフラグを引き起こす可能性があります。
| フィールド | エラーの影響 | 組み込みバリデーション | 検証時に人が検出可能か |
|---|---|---|---|
| 薬剤名 | 誤った薬剤の調剤 | DUR相互作用チェック(部分的) | はい — 薬剤師がラベルと原本の処方箋を照合すれば可能 |
| NDC | 請求拒否、在庫不一致 | 形式バリデーションは可能、意味チェックはなし | いいえ — NDCはラベル上で患者からは見えません |
| 用量/強度 | 過量投与または過少投与 | DUR投与量範囲チェック(部分的) | 部分的に可能 — ラベル上で確認できますが、mcg/mgの混同は見分けにくい |
| DEA番号 | PMPデータの破損、規制薬物追跡の失敗 | チェックサムバリデーション(完全) | いいえ — 処方者IDは患者からは見えません |
| 数量 | 不正確な日数供給、早期の再調剤 | DUR利用状況チェック | はい — ラベル上で確認可能 |
| SIG / 服用方法 | 患者が誤った方法で服薬 | 自動化されたものはなし | はい — 患者は服薬指導時に確認可能 |
この表から非対称性が明らかになります。NDCとDEAのエラーは、後工程で発見するのが最も難しく、抽出時点で防止するのが最も容易です。なぜなら、両方とも構造的なバリデーションルールを持っており、適切に設計された抽出システムがデータがPMSに入る前に適用できるからです。組み込みバリデーションがないフィールド(薬剤名、SIG指示)には、別の戦略が必要です。データが伝播する前に、抽出ポイントにできるだけ近い段階で人間による検証を行うことです。
精度重視の抽出ワークフロー設計
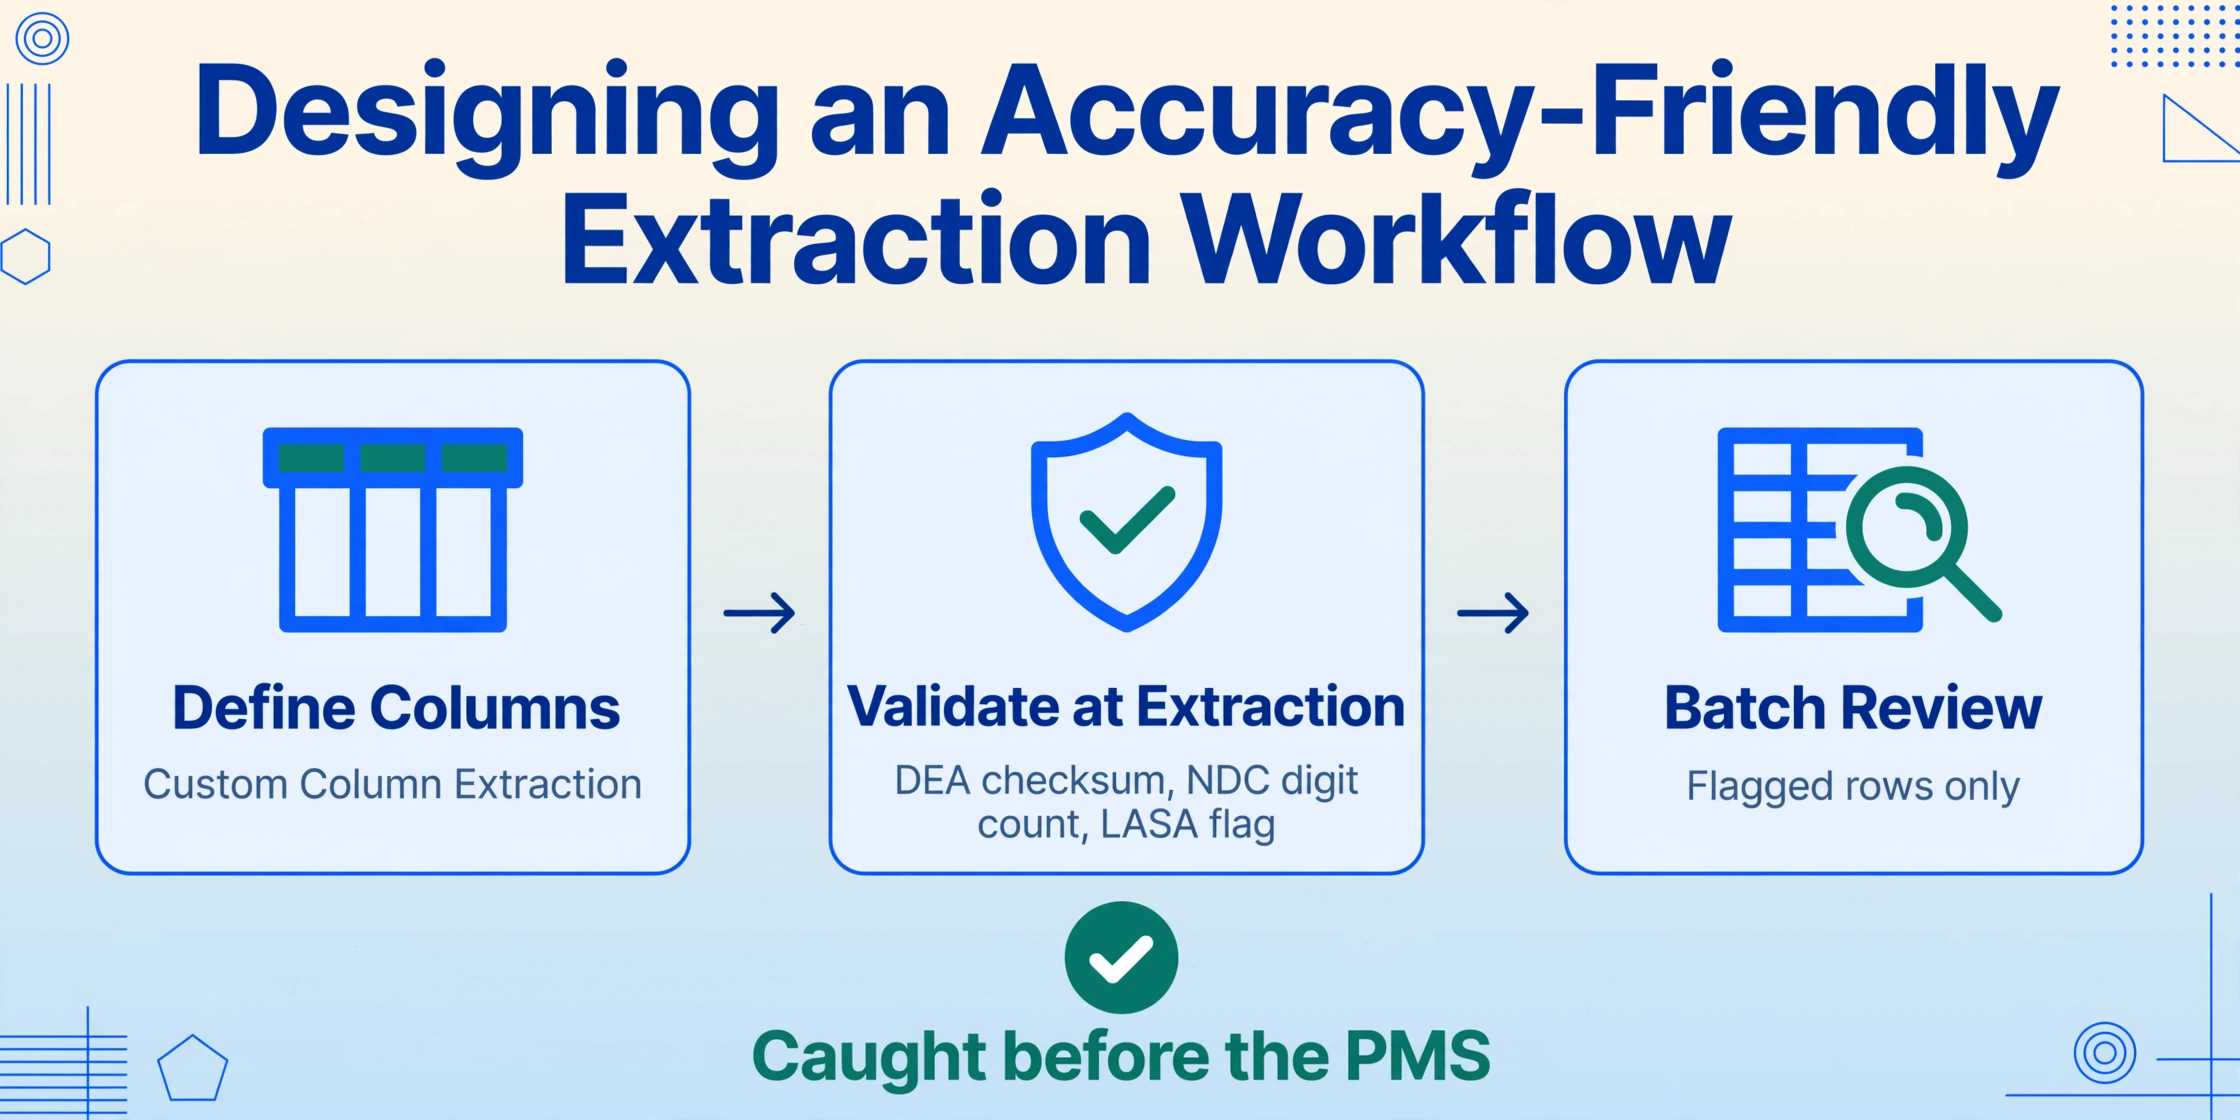
薬局で最も精度の高い抽出システムとは、見出しのパーセンテージが最も高いものではありません。エラーのパターンが、御社の検証ワークフローで検出できる能力と一致しているものです。
処方箋抽出における実用的な精度ワークフローは、抽出段階でエラーゼロを目指すものではありません。目指すのは、予測可能で検証可能、かつ伝播する前に検出されるエラーパターンです。フィールドごとに見ると、次のようになります:
ファイルは安全に処理され、保存されることはありません。
このワークフローは、精度をベンダーが示す単一のパーセンテージから、御社が管理できる運用パラメータへと変えます。「このツールの精度はどのくらいか?」と問う代わりに、「検証ワークフローでどのフィールドを、どの頻度で再確認する必要があるか?」と問うことになります。— その答えは、入力データの構成、薬局管理システム(PMS)に組み込まれた検証レイヤー、そして御社の州でコンプライアンス上の影響を持つフィールドによって異なります。
よくある質問
手書き処方箋の読み取り精度はAIでどのくらいですか?
手書き処方箋の抽出精度は、フィールドレベルの抽出で通常82%~88%程度であり、印字または電子処方箋の95~99%と比較して低くなります。そのばらつきは、手書きの読みやすさ、画像解像度、処方箋に複数行のSIG指示が含まれているかどうかに大きく依存します。薬剤名が明確にブロック体で記載され、NDCが丁寧に書かれた処方箋は、4行にわたる筆記体のSIG指示が含まれるものよりもはるかに高い信頼性で抽出できます。これは実際の限界です。現在の抽出システムで、実際の診療で見られる医師の手書きの全範囲に対して90%以上の精度を達成しているものはありません。
AI抽出は手動データ入力と比較して投薬ミスを減らせますか?
はい — ただし、完全に正確だからではありません。その利点は、AI抽出のエラーが予測可能なパターン(低解像度フィールドでの文字混同、複雑なレイアウトでのフィールド割り当てミス)に従うのに対し、人間のデータ入力エラーはランダムであり、系統的に発見するのが難しい点にあります。AIの既知の障害モード(NDC桁数チェック、DEA番号チェックサム検証、LASA薬剤名フラグ付け)を特にターゲットとした検証ワークフローを設計する薬局は、一部のフィールドでのAIの生の精度が80%台後半であっても、人間のみの入力よりも低い正味エラー率を達成できます。
AI抽出はNDC形式の変換を自動的に処理できますか?
抽出システムは読み取った桁数を検出し、期待される形式と一致しないNDCにフラグを付けることはできますが、完全な10桁→11桁の変換には、元のFDA割り当て形式(4-4-2、5-3-2、または5-4-1)を知る必要があります。この情報は処方箋ラベルには表示されていません。最も安全なアプローチは、抽出を桁のキャプチャに使用し、各NDCの元の形式を把握している薬局管理システム(PMS)または医薬品データ便覧に変換を任せることです。抽出システムの役割は、「10桁または11桁を期待していたところ、9桁を読み取りました」と通知することであり、ゼロをどこに挿入するかを推測することではありません。
抽出後、どの処方箋フィールドを最も重視して検証すべきですか?
NDCと薬剤名を最優先の検証対象にすべきです。NDCエラーは患者や下流の検証プロセスからは見えず、薬剤名エラーは患者の安全性に対するリスクが最も高いためです。DEA番号は次に重要です。チェックサムで検証可能ですが、州のPMPデータベースに伝播し、そこでエラーを修正するのが困難になります。投与量の検証は、治療指数の狭い薬剤(ワルファリン、レボチロキシン、ジゴキシン)で最も重要です。これらの薬剤では、わずかな投与量エラーが臨床的に過大な結果をもたらす可能性があります。数量と補充回数は重要ですが、DURや患者へのカウンセリングなど、既存の薬局ワークフローのステップで発見される可能性が最も高い項目です。
このアプローチは薬局管理システムや電子処方箋ネットワークと互換性がありますか?
ほとんどのAI抽出ツールは、最初にCSVまたはExcelに出力します。PMSに直接出力するわけではありません。つまり、抽出出力は事前検証のステップとして機能します。スプレッドシートで構造化データを確認し、フラグが付いた箇所を修正してから、検証済みデータをPMSにインポートまたは手動入力します。PMSへの直接統合は、エンタープライズ薬局自動化プラットフォーム(Asepha、Nodens Health)に存在しますが、ほとんどの独立系およびチェーン薬局では、抽出→スプレッドシート→PMSというワークフローが現実的な道であり、スプレッドシートの段階がバッチ検証のチェックポイントとして機能します。
処方箋抽出の精度は、導入後に判明する数値ではありません。それは、入力チャネル、フィールドタイプ、そして抽出と調剤の間にある検証ワークフローによって、事前に調整する一連の期待値です。最も役立つツールは、全体で99%の精度を約束するものではありません。どこが最も弱いかを教えてくれるツールこそ、どこに第二の目のチェックを置くべきかを正確に把握させてくれるのです。
サンプルファイルで処方箋抽出をテストする — どのフィールドがきれいに抽出され、どのフィールドをワークフローで検証する必要があるかを確認できます。