Qual é a precisão da extração de prescrições?
Uma análise campo a campo
Quando um fornecedor de software de farmácia diz que sua extração por IA atinge "97% de precisão", o que você deve realmente esperar? A questão não é se o número é verdadeiro — é quais 3% falham, e se as falhas recaem em campos onde a margem de erro é medida em desfechos para o paciente. Em dados de prescrição, diferentes campos apresentam riscos de erro muito distintos: confundir metformina com metronidazol custa mais do que um número de renovação digitado errado. E a precisão da extração em si depende menos do modelo de IA do que da aparência dos seus documentos recebidos — o mesmo sistema que lê uma prescrição eletrônica nítida com 99% de precisão pode cair para 85% em uma receita enviada por fax de uma clínica que ainda usa uma máquina de fax térmica de 2007. Este artigo detalha a precisão da extração de prescrições campo a campo, para que você possa avaliar ferramentas com base no perfil de erro que realmente importa para sua farmácia.
Principais Conclusões
- Todo fornecedor de IA para farmácias cita um único número de precisão — mas "97%" é uma média entre nomes de medicamentos (onde uma extração errada pode prejudicar o paciente) e contagens de renovação (onde apenas incomoda).
- Os campos onde os erros de extração causam mais dano — números NDC e identificadores DEA — são aqueles que seu fluxo de trabalho atual não enxerga, porque ninguém verifica novamente um NDC contra a receita original após a entrada de dados.
- Um framework de precisão campo a campo transforma as alegações do fornecedor em um parâmetro operacional: quais campos precisam da sua segunda verificação, e com que frequência — com base na combinação real de entradas da sua farmácia, não em um slide de marketing.
Os 5 Segundos Que Você Não Recupera
Um técnico de farmácia digitando a 50 PPM ainda precisa de cerca de 50 segundos para transcrever uma única prescrição em um sistema de gestão de farmácia — e 1 em cada 25 dessas entradas conterá pelo menos um erro.
A narrativa padrão de eficiência em torno da extração de prescrições por IA é mais ou menos assim: a entrada manual de dados é lenta, a IA é rápida, portanto, adote a IA. É uma equação limpa, e não está errada — a economia de tempo é real. Mas a segunda metade desse argumento — o que acontece com a precisão — é onde a maioria das discussões com fornecedores para em um único ponto percentual e segue em frente.
Uma revisão sistemática de 2024, abrangendo 62 estudos publicada no Research in Social and Administrative Pharmacy, encontrou uma prevalência global agrupada de erros de dispensação em farmácias de 1,6%, com estudos individuais relatando taxas de até 11,53%, dependendo da metodologia de detecção (Um et al., 2024). Em um estudo observacional nacional de referência, Flynn et al. estimaram que 51,5 milhões de erros de dispensação ocorrem entre os 3 bilhões de prescrições dispensadas anualmente nos Estados Unidos — aproximadamente quatro erros por dia em uma farmácia típica (Flynn et al., 2003). A iniciativa Medication Without Harm da Organização Mundial da Saúde (OMS) relata que danos relacionados a medicamentos afetam cerca de 1 em cada 20 pacientes globalmente. E a tela de entrada de dados — onde um técnico ou farmacêutico lê uma prescrição e a digita no PMS — é onde uma parcela significativa desses erros se origina, antes mesmo de um comprimido sair do frasco.
A verdadeira questão não é "quão rápido a IA consegue extrair uma prescrição?" É "em quais campos a extração falha e o que acontece quando isso ocorre?" Uma análise campo a campo revela que a precisão não é distribuída uniformemente — alguns campos possuem camadas de validação integradas que capturam erros antes que eles cheguem ao paciente; outros não têm nenhuma.
A Qualidade da Entrada Define o Piso de Precisão
Antes que qualquer modelo de IA toque em uma prescrição, a condição física do documento já determinou o limite superior da precisão alcançável — e nenhum modelo consegue recuperar informações que não foram capturadas na imagem.
As prescrições chegam às farmácias por três canais principais, cada um com seu próprio perfil de degradação:
| Canal de Entrada | Qualidade Típica da Imagem | Precisão Esperada da Extração | Modo de Falha Principal |
|---|---|---|---|
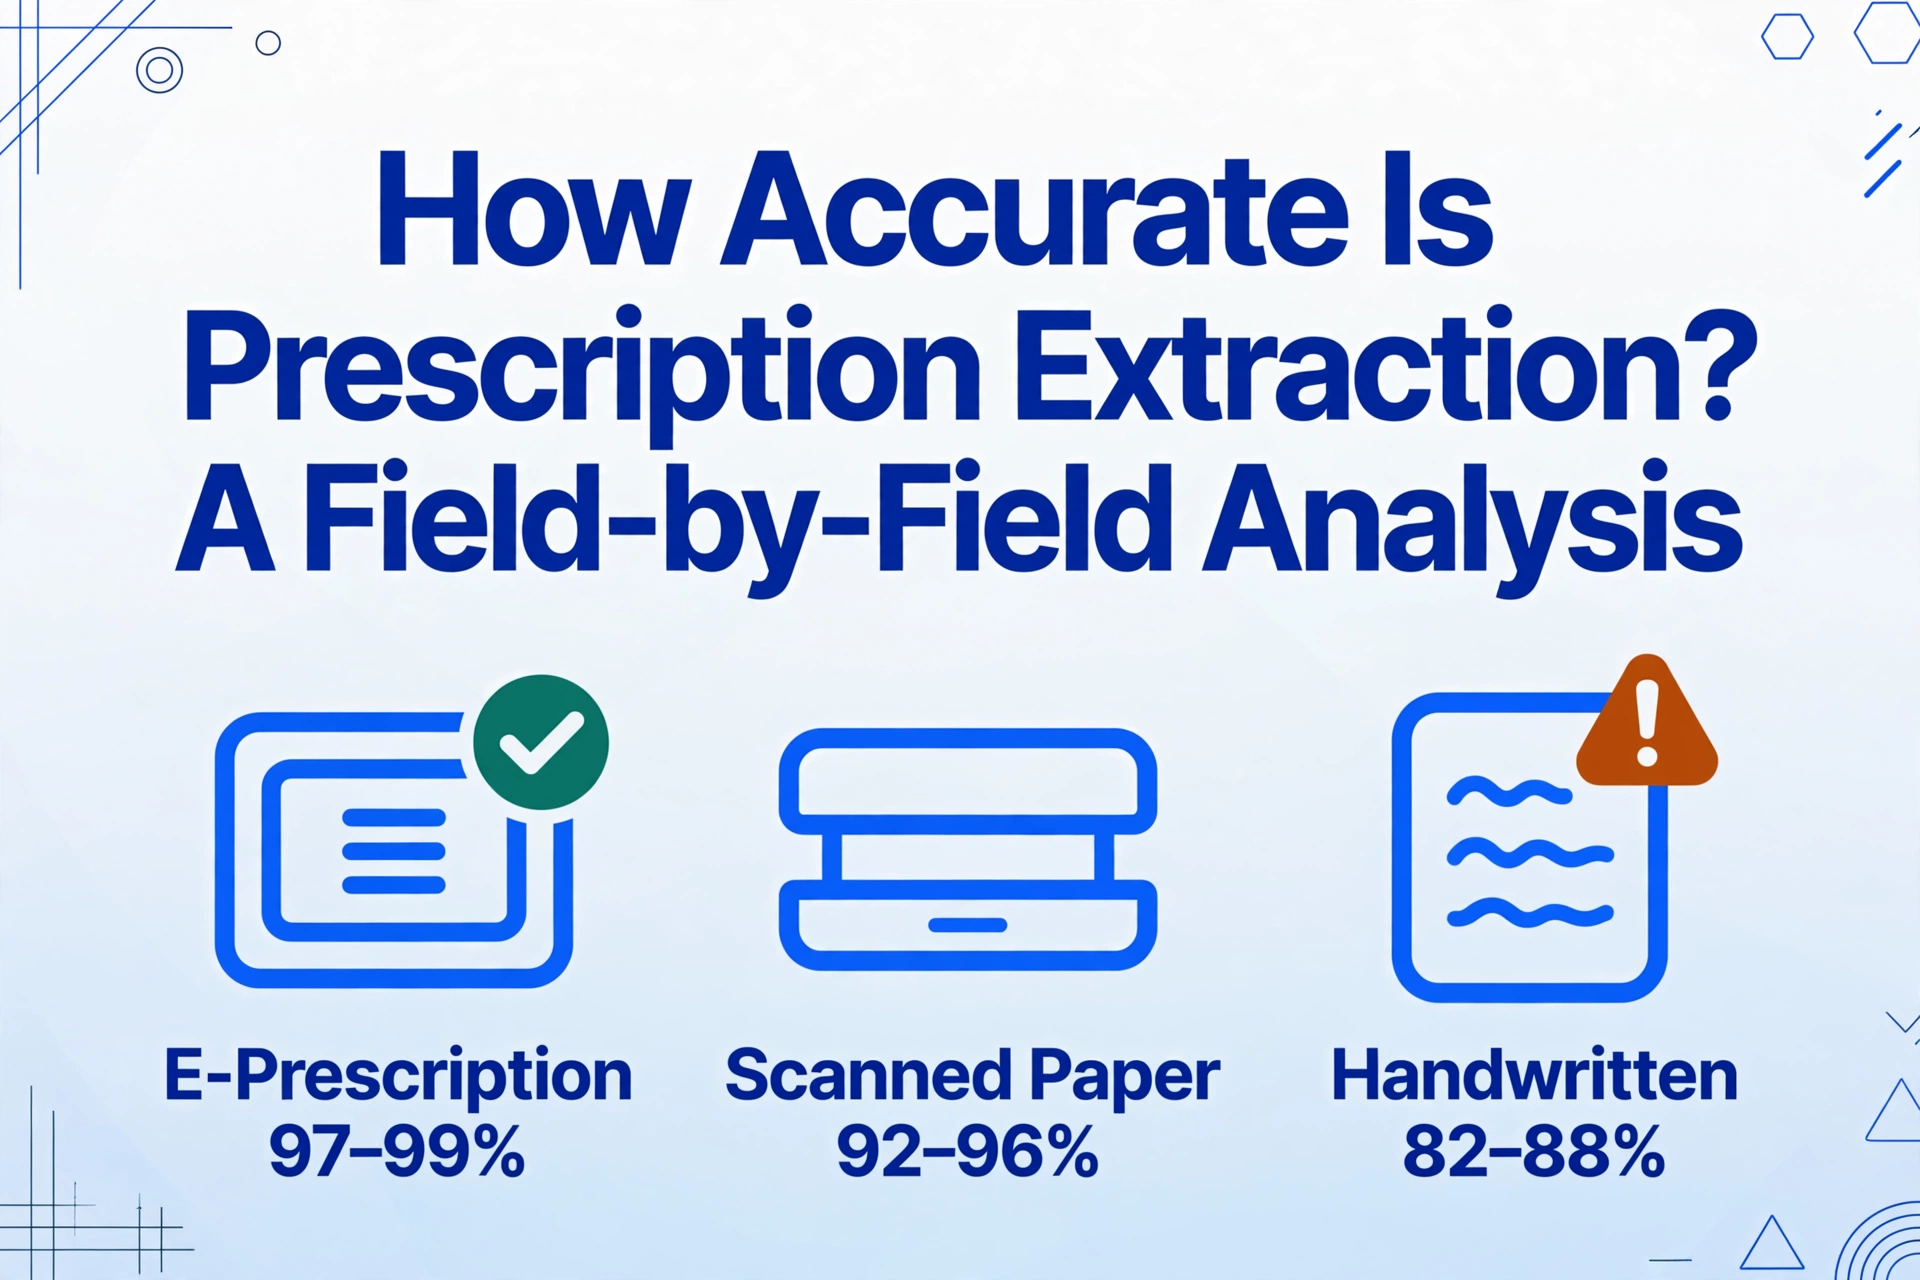
| Prescrição Eletrônica (SureScripts, EPCS) | Nativa digital, texto nítido | 97–99% por campo | Raro; inconsistências na normalização do código SIG |
| Prescrição em papel digitalizada | Scanner de mesa a 300 DPI, bom contraste | 92–96% impresso; 82–88% manuscrito | Caligrafia em instruções SIG de múltiplas linhas |
| Prescrição por fax (papel térmico) | Baixa resolução, desbotada, distorcida | 85–92% por campo em média | Fragmentação de caracteres; números borrados no NDC/dosagem |
Um estudo de 2024 usando PaddleOCR em prescrições reais descobriu que, enquanto prescrições impressas alcançavam ~95% de precisão na extração de texto, as manuscritas caíam para ~85% — uma diferença de 10 pontos que persiste mesmo com etapas de pré-processamento como redução de ruído e binarização. Um estudo separado sobre OCR de prescrições aprimorado por RNA relatou uma Taxa de Precisão de Prescrições (PAR — a porcentagem de prescrições em que todos os campos críticos foram reconhecidos corretamente) de 85,7% para um sistema melhorado, ante 78,0% para o OCR de base (Gudi, 2025). Este é o problema do piso de precisão: se seu volume de fax recebido é alto, mesmo o melhor modelo parte de uma linha de base mais baixa.
A conclusão prática não é evitar a extração por IA para prescrições recebidas por fax — é projetar seu fluxo de verificação com base na qualidade de entrada que você realmente recebe, e não no cenário ideal. Uma farmácia que processa 80% de prescrições eletrônicas e 20% de prescrições por fax precisa de um design de ponto de verificação diferente daquela que processa a proporção inversa.
O Problema dos Nomes de Medicamentos: Quando Semelhante Não Basta
Desde 1975, o ISMP (Institute for Safe Medication Practices) mantiene uma Lista de Nomes de Medicamentos Confusos — um catálogo de pares de medicamentos cujos nomes são suficientemente semelhantes na apariência ou pronúncia para causar erros reais de dispensação. Para sistemas de extração, esta lista é a diferença entre "correspondência próxima" e "medicamento errado".
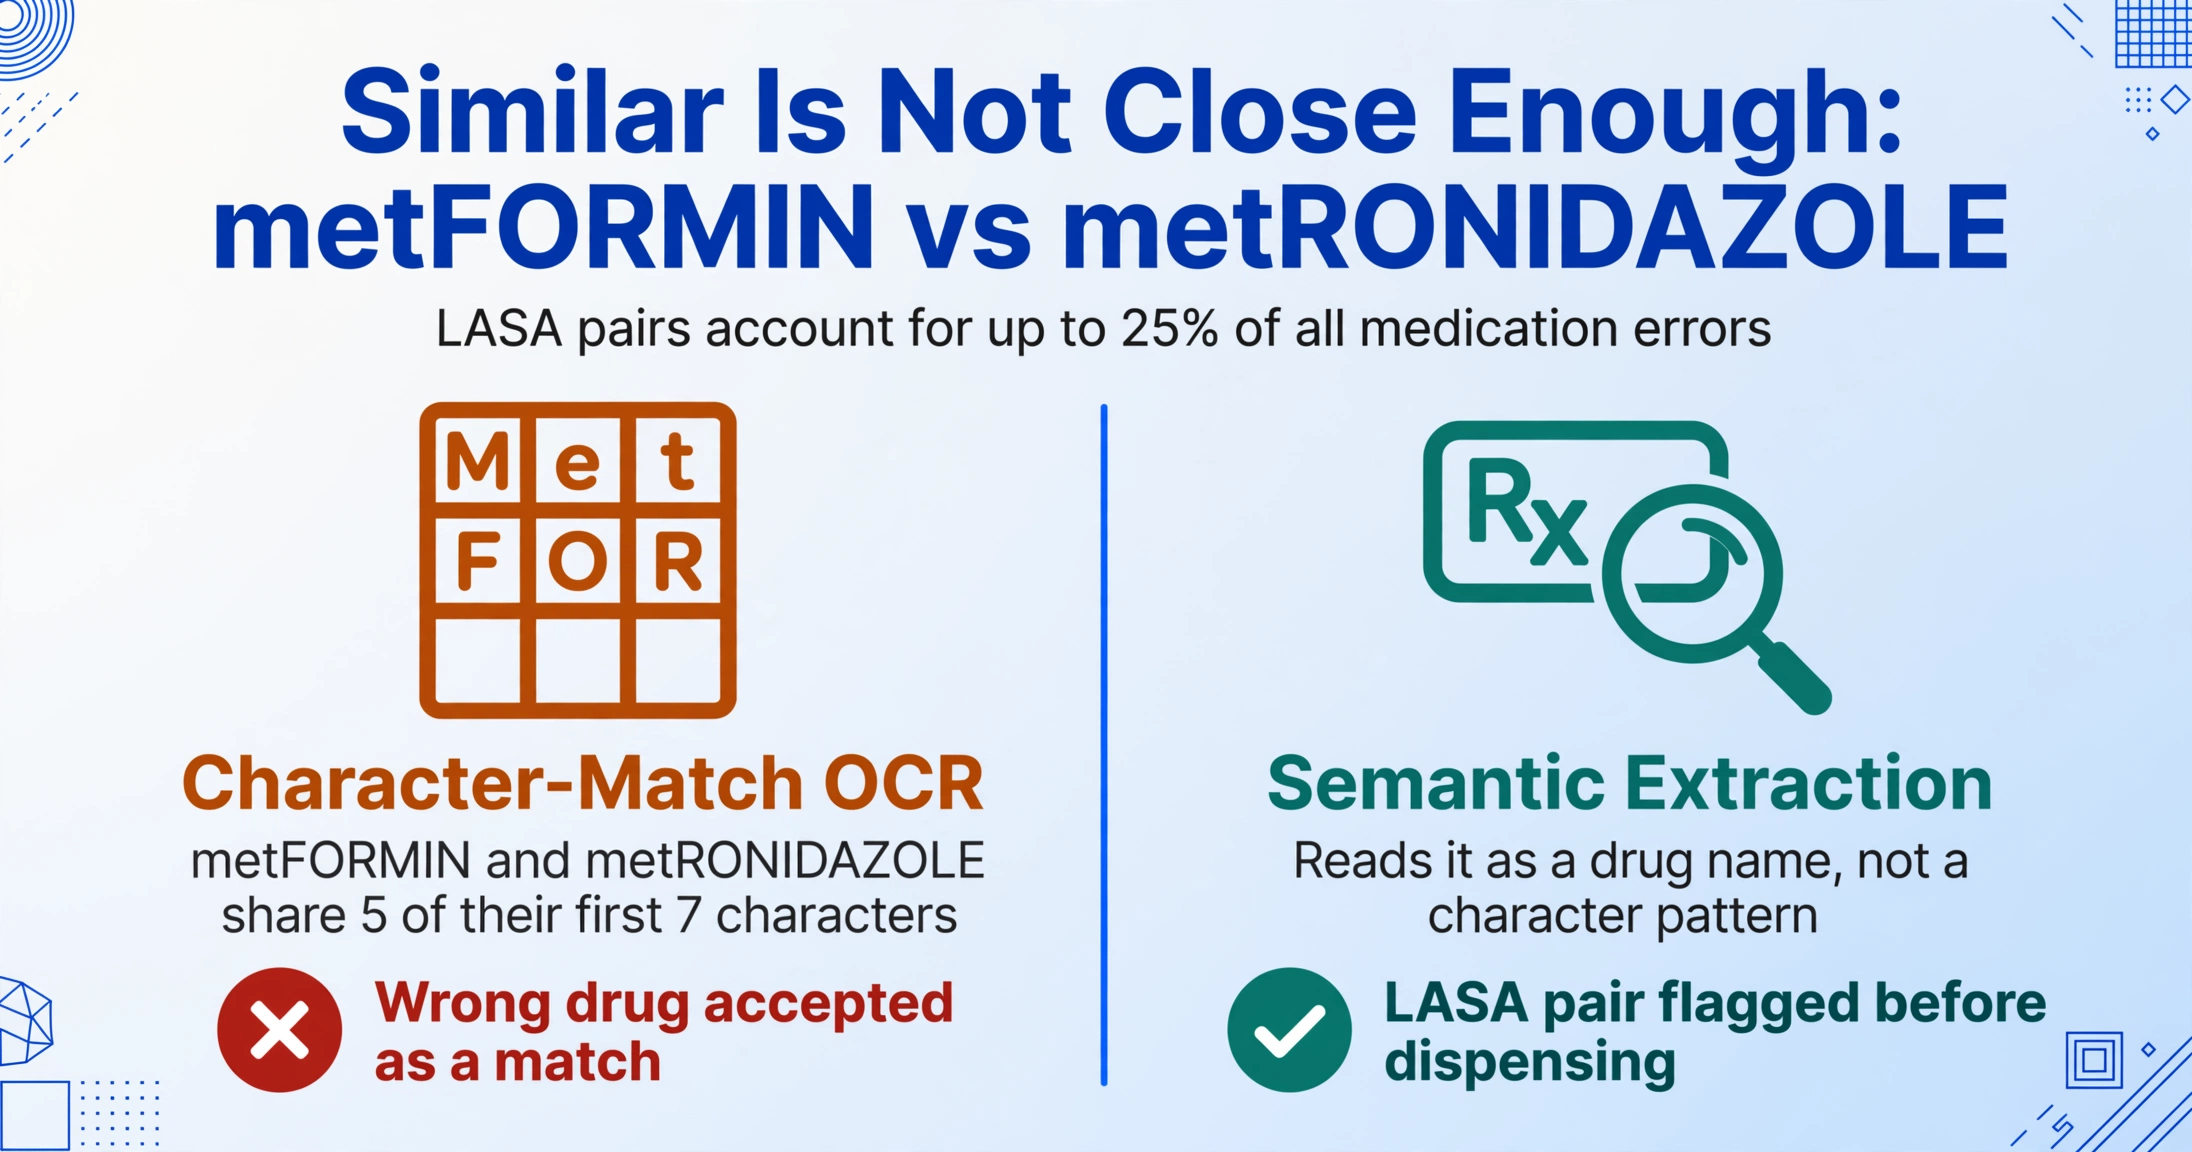
Estima-se que os pares de nomes de medicamentos LASA (look-alike, sound-alike) sejam responsáveis por até 25% de todos os erros de medicação, e a lista não é pequena — o catálogo atual do ISMP conta com centenas de entradas entre pares marca-marca, marca-genérico e genérico-genérico (Lista de Nomes de Medicamentos Confusos do ISMP). As consequências são concretas o suficiente para que nomes de medicamentos tenham sido cambiados para evitar confusão: Losec se tornou Prilosec após repetidas confusões com Lasix; Brintellix foi renomeado Trintellix para evitar confusão com Brilinta; Celebrex foi originalmente lançado como Celebra antes de que surgissem preocupações sobre confusão com Celexa.
Para um técnico de farmacia humano, a defesa contra erros LASA é o treinamento, as letras maiúsculas diferenciadoras (escribir hidrOXYzina e hidrALAZINA com maiúsculas mistas para distinguirlas visualmente) e verificações duplas independentes. Para um sistema de extração por IA, o desafio é diferente mas não menos grave: um sistema baseado em OCR ve padrões de caracteres, não nomes de medicamentos. Para um motor de OCR, "metFORMIN" e "metRONIDAZOLE" compartilham 5 dos seus 7 primeiros caracteres — uma correspondência parcial de alta confianza que um sistema ingênuo poderia aceitar. Um motor de extração semântica, por contraste, entende que está lendo uma prescrição de uma visita de atenção primária para um paciente diabético e pondera a probabilidade a favor de metformina. Trae contexto ao problema de reconhecimento de caracteres.
Un risco relacionado que recebe menos atenção: a validação cruzada NDC-nome de medicamento é uma segunda linha de defesa que a maioria das ferramentas de extração não oferece. Se um sistema extrae "lisinopril 10mg" mas o NDC na mesma linha decodifica a atorvastatina, um pipeline de extração bem desenhado sinaliza a inconsistência antes de que os dados cheguem ao PMS. Este tipo de validação intra-documento — verificar se os campos extraídos são internamente consistentes — transforma a extração de uma tarefa de OCR de uma sola passada em uma verificação de precisão em capas.
NDC: A Armadilha dos 10 Dígitos
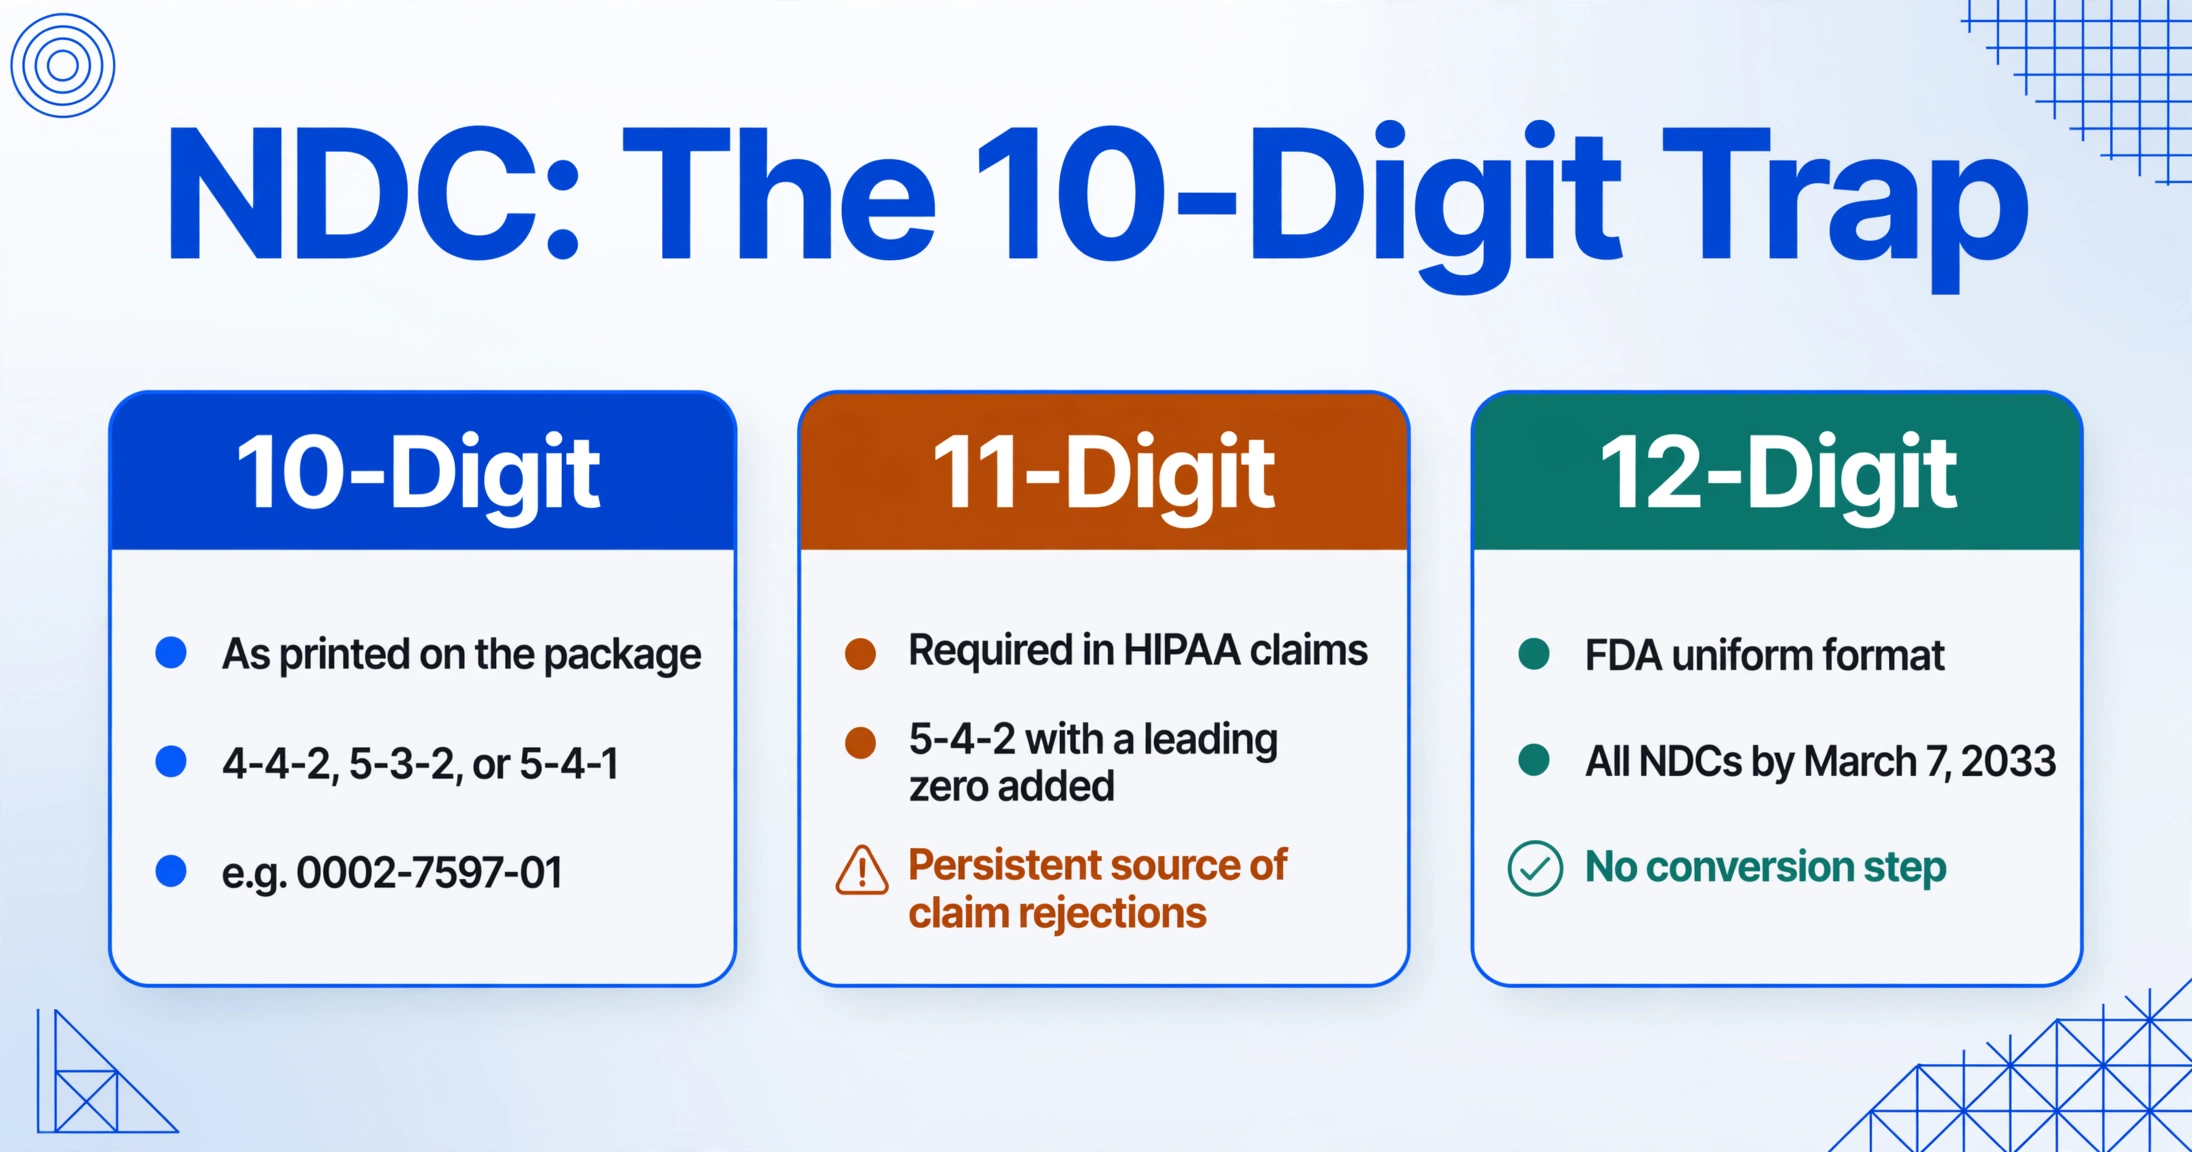
Um único NDC pode ter até três representações válidas, dependendo de onde é usado — e a conversão entre elas é o tipo de tarefa mecânica em que humanos erram consistentemente e a IA erra de forma imprevisível.
O National Drug Code é um identificador de 10 dígitos em três segmentos: Código do Rotulador (4 ou 5 dígitos), Código do Produto (3 ou 4 dígitos) e Código da Embalagem (1 ou 2 dígitos). A FDA atribui NDCs em três formatos possíveis — 4-4-2, 5-3-2 ou 5-4-1 — o que significa que o NDC do mesmo medicamento pode aparecer na embalagem como 0002-7597-01 (4-4-2) ou 60574-4114-1 (5-4-1). Mas transações cobertas pela HIPAA exigem um NDC de 11 dígitos em formato fixo 5-4-2, obtido adicionando um zero à esquerda no segmento curto — e o zero vai em uma posição diferente dependendo de qual dos três formatos originais o NDC usa (Orientação de Formato NDC da FDA).
Essa conversão — de 10 para 11 dígitos — é uma fonte persistente de rejeições de reivindicações. A própria FDA reconheceu em sua regra proposta de 2023 sobre revisão do formato NDC que "o sistema de saúde e os pagadores atualmente convertem NDCs de 10 dígitos para NDCs de 11 dígitos, o que aumenta os custos de saúde e pode ser um fator em erros de medicação" (FDA, 2023). O problema se agrava: em março de 2026, a FDA finalizou uma regra que transiciona todos os NDCs para um formato uniforme de 12 dígitos (6-4-2) até 7 de março de 2033, com um período de transição de três anos até março de 2036. Durante essa janela, o PMS de uma farmácia pode receber NDCs de 10, 11 e 12 dígitos simultaneamente — três formatos diferentes para o mesmo identificador de produto.
Para um sistema de extração, o desafio de precisão do NDC tem duas camadas: extrair os dígitos corretos da imagem e saber qual formato os dígitos extraídos representam. A primeira camada é um problema de OCR (é um 0 ou um 8? O hífen está presente ou é um borrão?). A segunda camada é um problema de conhecimento de domínio: se o sistema extrai 9 dígitos de um campo rotulado como "NDC", isso é um formato 5-3-1 com um zero inicial ausente, ou um formato 5-4-0 com um zero final ausente? A resposta determina se os dados fluem para o seu PMS como um identificador válido ou uma reivindicação rejeitada.
Dosagem, DEA e a Cadeia de Dados Regulatórios
Erros no nome do medicamento e no NDC são problemas de qualidade de dados; erros de dosagem e número DEA são problemas de conformidade regulatória. Essa diferença é importante ao avaliar quais erros de extração seu fluxo de trabalho pode tolerar.
Erros de dosagem na extração geralmente se enquadram em três categorias: confusão de unidades (mcg extraído como mg — um erro de dosagem de 1.000×), deslocamento de ponto decimal (0,5mg → 5mg) e confusão entre concentração e quantidade (comprimido de 10mg vs. quantidade de 10 comprimidos). O ISMP mantém uma lista de abreviações e designações de dose propensas a erros, especificamente para lidar com esses modos de falha na entrada manual — mas, para a extração por IA, o problema é mais sutil. Um modelo de visão que lê "Levotiroxina 0,025 mg" pode transcrever corretamente os caracteres, mas colocá-los na coluna de saída errada, atribuindo a concentração ao campo de quantidade. O erro não está na leitura — está na atribuição do campo, que exige entender o que cada parte do texto significa, e não apenas o que diz.
Números DEA possuem uma validação estrutural incorporada ao formato: um número DEA válido consiste em duas letras seguidas de sete dígitos, onde a segunda letra é a primeira letra do sobrenome do prescritor e o sétimo dígito é um dígito verificador calculado a partir dos seis primeiros. Isso significa que um sistema de extração pode executar uma validação de formato imediatamente — se a string extraída não corresponder ao algoritmo de verificação DEA, ela foi lida incorretamente ou é inválida. A implicação prática: a extração do número DEA tem uma taxa de precisão verificável — você pode medir exatamente com que frequência o sistema produz uma string que passa no dígito verificador e sinalizar tudo o que não passa para revisão manual. Nenhum outro campo de prescrição oferece esse nível de verificação integrada.
Requisitos de dados do PMP estadual adicionam outra camada: programas de monitoramento de prescrições em 37 estados exigem que os prescritores consultem o registro do PMP antes de prescrever substâncias controladas (Lista II–IV), e a precisão dos dados do PMP depende inteiramente do que as farmácias e dispensadores relatam (NASCSA, 2024, recursos PMP). Cada dispensador é responsável pela integridade dos dados submetidos — "a garantia de que os dados do PMP são precisos e completos é responsabilidade de" cada farmácia dispensadora (Departamento de Saúde do Estado de Washington). Um erro de extração que chega ao registro do PMP cria uma discrepância permanente no histórico de substâncias controladas de um paciente, potencialmente gerando falsos alertas em consultas futuras ao PMP.
| Campo | Consequência do Erro | Validação Integrada? | Detectável por Humano na Verificação? |
|---|---|---|---|
| Nome do Medicamento | Medicamento errado dispensado | Verificação de interação DUR (parcial) | Sim — se o farmacêutico conferir o rótulo com a prescrição original |
| NDC | Rejeição da cobrança; divergência no inventário | Validação de formato possível; sem verificação semântica | Não — NDC é invisível ao paciente no rótulo |
| Dosagem/Concentração | Sobredosagem ou subdosagem | Verificação de faixa de dose DUR (parcial) | Parcialmente — visível no rótulo, mas confusão entre mcg/mg é sutil |
| Número DEA | Corrupção de dados do PMP; falha no rastreamento de substâncias controladas | Validação de dígito verificador (completa) | Não — identificação do prescritor é invisível ao paciente |
| Quantidade | Dias de tratamento incorretos; renovação antecipada | Verificação de utilização DUR | Sim — visível no rótulo |
| SIG / Instruções de Uso | Paciente toma o medicamento incorretamente | Nenhuma automatizada | Sim — o paciente pode verificar no aconselhamento |
A tabela revela uma assimetria: erros de NDC e DEA são os mais difíceis de detectar a jusante e os mais fáceis de prevenir no momento da extração — pois ambos possuem regras estruturais de validação que um sistema de extração bem projetado pode aplicar antes que os dados entrem no seu PMS. Campos sem validação integrada (nome do medicamento, instruções SIG) exigem uma estratégia diferente: verificação humana o mais próximo possível do ponto de extração, antes que os dados se propaguem.
Projetando um Fluxo de Extração Favorável à Precisão
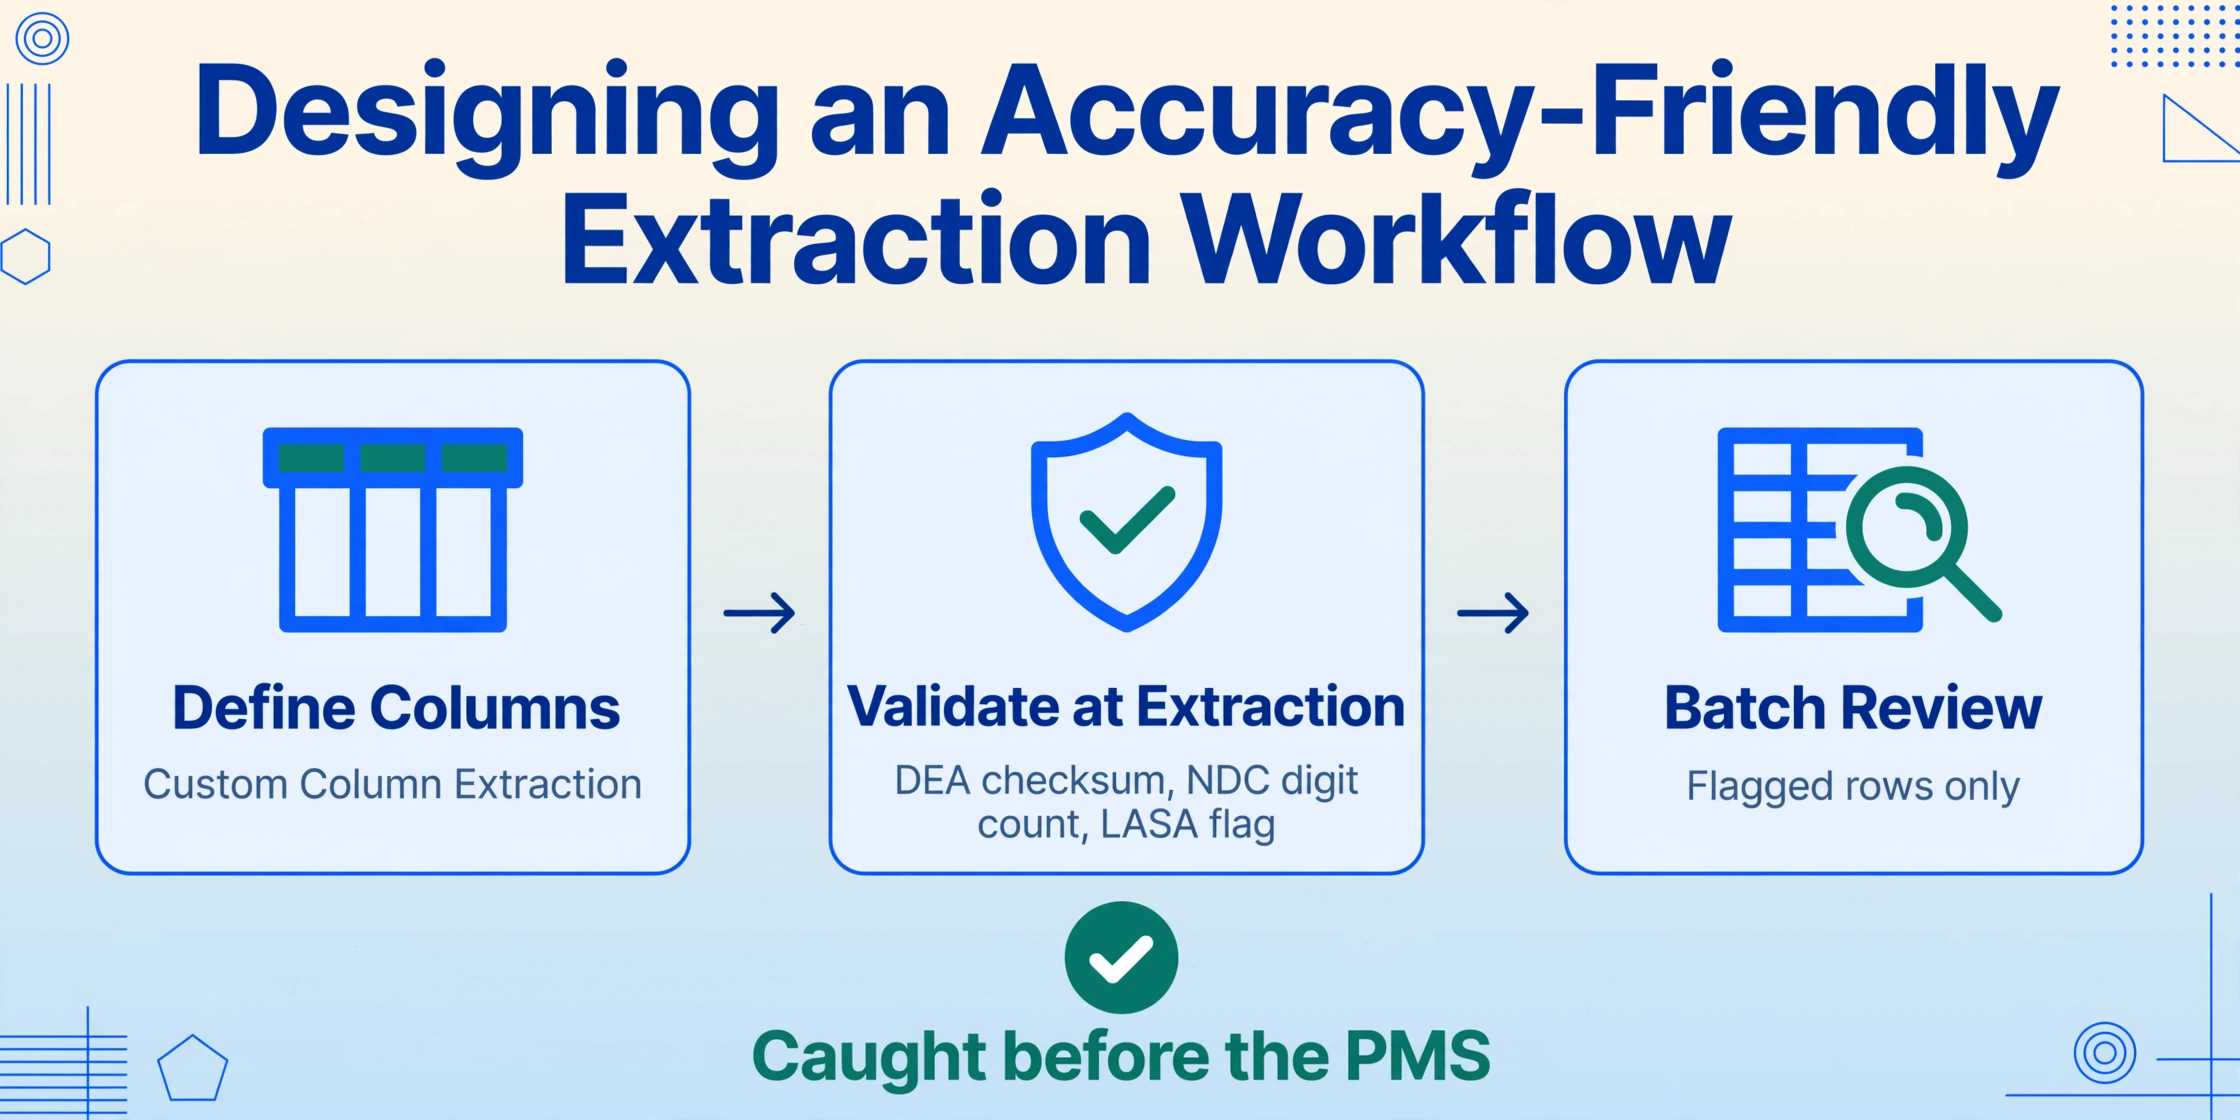
O sistema de extração mais preciso em uma farmácia não é o que tem o maior percentual de destaque — é aquele cujos padrões de erro correspondem à capacidade do seu fluxo de verificação de capturá-los.
Um fluxo de trabalho de precisão prático para extração de prescrições não visa zero erros na etapa de extração. Ele visa padrões de erro que sejam previsíveis, verificáveis e capturados antes de se propagarem. Veja como isso se parece campo por campo:
Os arquivos são processados de forma segura e não são armazenados.
Este fluxo de trabalho transforma a precisão de uma porcentagem única do fornecedor em um parâmetro operacional que você controla. Em vez de perguntar "quão precisa é esta ferramenta?", você pergunte "quais campos meu fluxo de verificação precisa revisar, e em que proporção?" — e a resposta depende da sua combinação de entradas, das camadas de validação integradas do seu PMS e de quais campos têm consequências de conformidade no seu estado.
Perguntas Frequentes
Quão precisa é a IA ao ler prescripções manuscritas?
A precisão da extração de prescripções manuscritas normalmente varia de 82% a 88% para extração a nível de campo, em comparação com 95–99% para prescripções impressas ou eletrónicas. A variação depende muito da legibilidade da caligrafia, da resolução da imagem e de si a prescrição contém instruções SIG de várias linhas. Uma prescrição com um nome de medicamento claramente impresso em letras de imprenta e um NDC escrito de forma ordenada será extraída de forma muito mais confiable que uma com instruções SIG cursivas que abarcan quatro líneas. Esta é uma limitação real — nenhun sistema de extração atual alcanza mais de 90% de precisão em toda a gama de caligrafia médica vista na prática.
A extração por IA reduz erros de medicação em comparação com a entrada manual de dados?
Sim — mas não por ser perfeitamente precisa. A vantagem é que os erros da extração por IA seguem padrões previsíveis (confusão de caracteres em campos de baixa resolução, erros de atribuição de campo em layouts complexos), enquanto os erros de entrada manual de dados são aleatórios e mais difíceis de detectar sistematicamente. Uma farmácia que projeta seu fluxo de verificação para mirar especificamente os modos de falha conhecidos da IA — verificação da contagem de dígitos do NDC, validação do checksum do DEA, sinalização de nomes de medicamentos LASA — pode alcançar uma taxa de erro líquida menor do que a entrada exclusivamente humana, mesmo que a precisão bruta da IA em alguns campos esteja na casa dos 80%.
A extração por IA consegue lidar automaticamente com a conversão do formato do NDC?
Um sistema de extração pode detectar quantos dígitos ele lê e sinalizar NDCs que não correspondem aos formatos esperados, mas a conversão completa de 10 para 11 dígitos exige saber o formato original atribuído pela FDA (4-4-2, 5-3-2 ou 5-4-1) — informação que não está visível no rótulo da receita. A abordagem mais segura é usar a extração para capturar os dígitos e deixar que seu PMS ou um compêndio de dados de medicamentos (que conhece o formato original de cada NDC) faça a conversão. O trabalho do sistema de extração é informar: "Li 9 dígitos onde esperava 10 ou 11" — e não adivinhar onde colocar o zero.
Quais campos da receita são mais importantes verificar após a extração?
O NDC e o nome do medicamento devem ser suas principais prioridades de verificação — erros de NDC são invisíveis para pacientes e para a verificação downstream, e erros no nome do medicamento apresentam o maior risco à segurança do paciente. Os números DEA vêm em seguida: são verificáveis via checksum, mas se propagam para os bancos de dados estaduais do PMP, onde os erros são difíceis de corrigir. A verificação da dosagem é mais importante para medicamentos de índice terapêutico estreito (varfarina, levotiroxina, digoxina), onde pequenos erros de dosagem têm consequências clínicas desproporcionais. A quantidade e o número de renovações, embora importantes, são os itens com maior probabilidade de serem detectados por etapas existentes do fluxo de trabalho da farmácia, como DUR e aconselhamento ao paciente.
Essa abordagem é compatível com sistemas de gestão de farmácia e redes de prescrição eletrônica?
A maioria das ferramentas de extração por IA gera CSV ou Excel primeiro — não diretamente no seu PMS. Isso significa que o resultado da extração serve como uma etapa de pré-verificação: você revisa os dados estruturados em uma planilha, faz correções onde forem sinalizadas e, em seguida, importa ou insere manualmente os dados verificados no seu PMS. A integração direta com PMS existe em plataformas de automação de farmácia empresarial (Asepha, Nodens Health), mas para a maioria das farmácias independentes e redes, o fluxo de extração-para-planilha-para-PMS é o caminho prático, com a etapa da planilha funcionando como seu ponto de verificação em lote.
A precisão da extração de prescrições não é um número que você descobre após a adoção. É um conjunto de expectativas que você calibra antes — por canal de entrada, por tipo de campo e pelo fluxo de verificação que fica entre a extração e a dispensação. As ferramentas que mais ajudam não são as que prometem 99% de precisão em tudo. São as que informam onde são mais fracas, para que você saiba exatamente onde colocar seu segundo par de olhos.
Teste a extração de prescrições em um arquivo de amostra — veja quais campos são extraídos corretamente e quais o seu fluxo de trabalho precisará verificar.