Wie genau ist die Rezeptextraktion?
Eine feldbezogene Analyse
Wenn Ihnen ein Anbieter von Apothekensoftware sagt, dass seine KI-Extraktion „97 % Genauigkeit“ erreicht, was sollten Sie dann tatsächlich erwarten? Die Frage ist nicht, ob die Zahl stimmt – sondern welche 3 % versagen und ob die Fehler auf Felder fallen, bei denen die Fehlertoleranz in Patientenergebnissen gemessen wird. Bei Rezeptdaten bergen verschiedene Felder extrem unterschiedliche Fehlerrisiken: Metformin mit Metronidazol zu verwechseln, wiegt schwerer als eine falsch getippte Nachfüllmenge. Und die Genauigkeit der Extraktion hängt weniger vom KI-Modell ab als davon, wie Ihre eingehenden Dokumente aussehen – dasselbe System, das ein klares E-Rezept mit 99 % liest, kann bei einem gefaxten Rezept aus einer Praxis, die noch ein Thermo-Faxgerät von 2007 verwendet, auf 85 % abfallen. Dieser Artikel schlüsselt die Genauigkeit der Rezeptextraktion Feld für Feld auf, damit Sie Tools anhand des Fehlerprofils bewerten können, das für Ihre Apotheke tatsächlich relevant ist.
Wichtigste Erkenntnisse
- Jeder Apotheken-KI-Anbieter nennt eine einzige Genauigkeitszahl – aber „97 %“ ist ein Durchschnitt über Medikamentennamen (wo eine falsche Extraktion einem Patienten schaden kann) und Nachfüllmengen (wo sie nur nervt).
- Die Felder, auf denen Extraktionsfehler den größten Schaden anrichten – NDC-Nummern und DEA-Identifikatoren – sind genau die, die Ihr bestehender Workflow übersieht, weil nach der Dateneingabe niemand einen NDC gegen das Originalrezept prüft.
- Ein feldbezogenes Genauigkeits-Framework verwandelt Herstellerangaben in einen operativen Parameter: Welche Felder brauchen Ihr zweites Augenpaar und wie oft – basierend auf dem tatsächlichen Eingabemix Ihrer Apotheke, nicht auf einer Marketing-Folie.
Die 5 Sekunden, die Sie nicht zurückbekommen
Eine pharmazeutisch-technische Assistentin, die mit 50 Anschlägen pro Minute tippt, benötigt dennoch etwa 50 Sekunden, um ein einzelnes Rezept in ein Apothekenverwaltungssystem zu übertragen – und jeder 25. dieser Einträge enthält mindestens einen Fehler.
Die gängige Effizienzerzählung zur KI-gestützten Rezepteingabe lautet: Manuelle Dateneingabe ist langsam, KI ist schnell, also führen Sie KI ein. Eine saubere Gleichung, und sie ist nicht falsch – die Zeitersparnis ist real. Aber die zweite Hälfte dieses Arguments – was mit der Genauigkeit passiert – ist der Punkt, an dem die meisten Anbieterdiskussionen bei einem einzigen Prozentpunkt stehen bleiben und zum nächsten Thema übergehen.
Eine systematische Übersichtsarbeit aus dem Jahr 2024, die 62 Studien auswertete und im Research in Social and Administrative Pharmacy veröffentlicht wurde, ermittelte eine globale gepoolte Prävalenz von Abgabefehlern in Apotheken von 1,6 %, wobei einzelne Studien je nach Erkennungsmethode Raten von bis zu 11,53 % berichteten (Um et al., 2024). In einer wegweisenden nationalen Beobachtungsstudie schätzten Flynn et al., dass bei den jährlich in den USA abgegebenen 3 Milliarden Rezepten 51,5 Millionen Abgabefehler auftreten – das sind etwa vier Fehler pro Tag in einer durchschnittlichen Apotheke (Flynn et al., 2003). Die Initiative „Medication Without Harm“ der Weltgesundheitsorganisation (WHO) berichtet, dass medikamentenbedingte Schäden weltweit etwa jeden 20. Patienten betreffen. Und der Bildschirm zur Dateneingabe – an dem ein PTA oder Apotheker ein Rezept liest und in das PMS (Apothekenverwaltungssystem) eingibt – ist der Ort, an dem ein erheblicher Teil dieser Fehler entsteht, bevor auch nur eine Tablette die Flasche verlässt.
Die eigentliche Frage ist nicht: „Wie schnell kann KI ein Rezept erfassen?“, sondern: „Bei welchen Feldern schlägt die Erfassung fehl, und was passiert, wenn das der Fall ist?“ Eine feldbezogene Aufschlüsselung zeigt, dass die Genauigkeit nicht gleichmäßig verteilt ist – einige Felder verfügen über integrierte Validierungsebenen, die Fehler abfangen, bevor sie einen Patienten erreichen; andere haben keine.
Eingabequalität bestimmt die Genauigkeitsuntergrenze
Bevor ein KI-Modell ein Rezept verarbeitet, hat der physische Zustand des Dokuments bereits die maximal erreichbare Genauigkeit festgelegt – und kein Modell kann Informationen wiederherstellen, die im Bild nicht erfasst wurden.
Rezepte gelangen über drei Hauptkanäle in die Apotheke, jeder mit einem eigenen Degradationsprofil:
| Eingabekanal | Typische Bildqualität | Erwartete Extraktionsgenauigkeit | Hauptfehlerquelle |
|---|---|---|---|
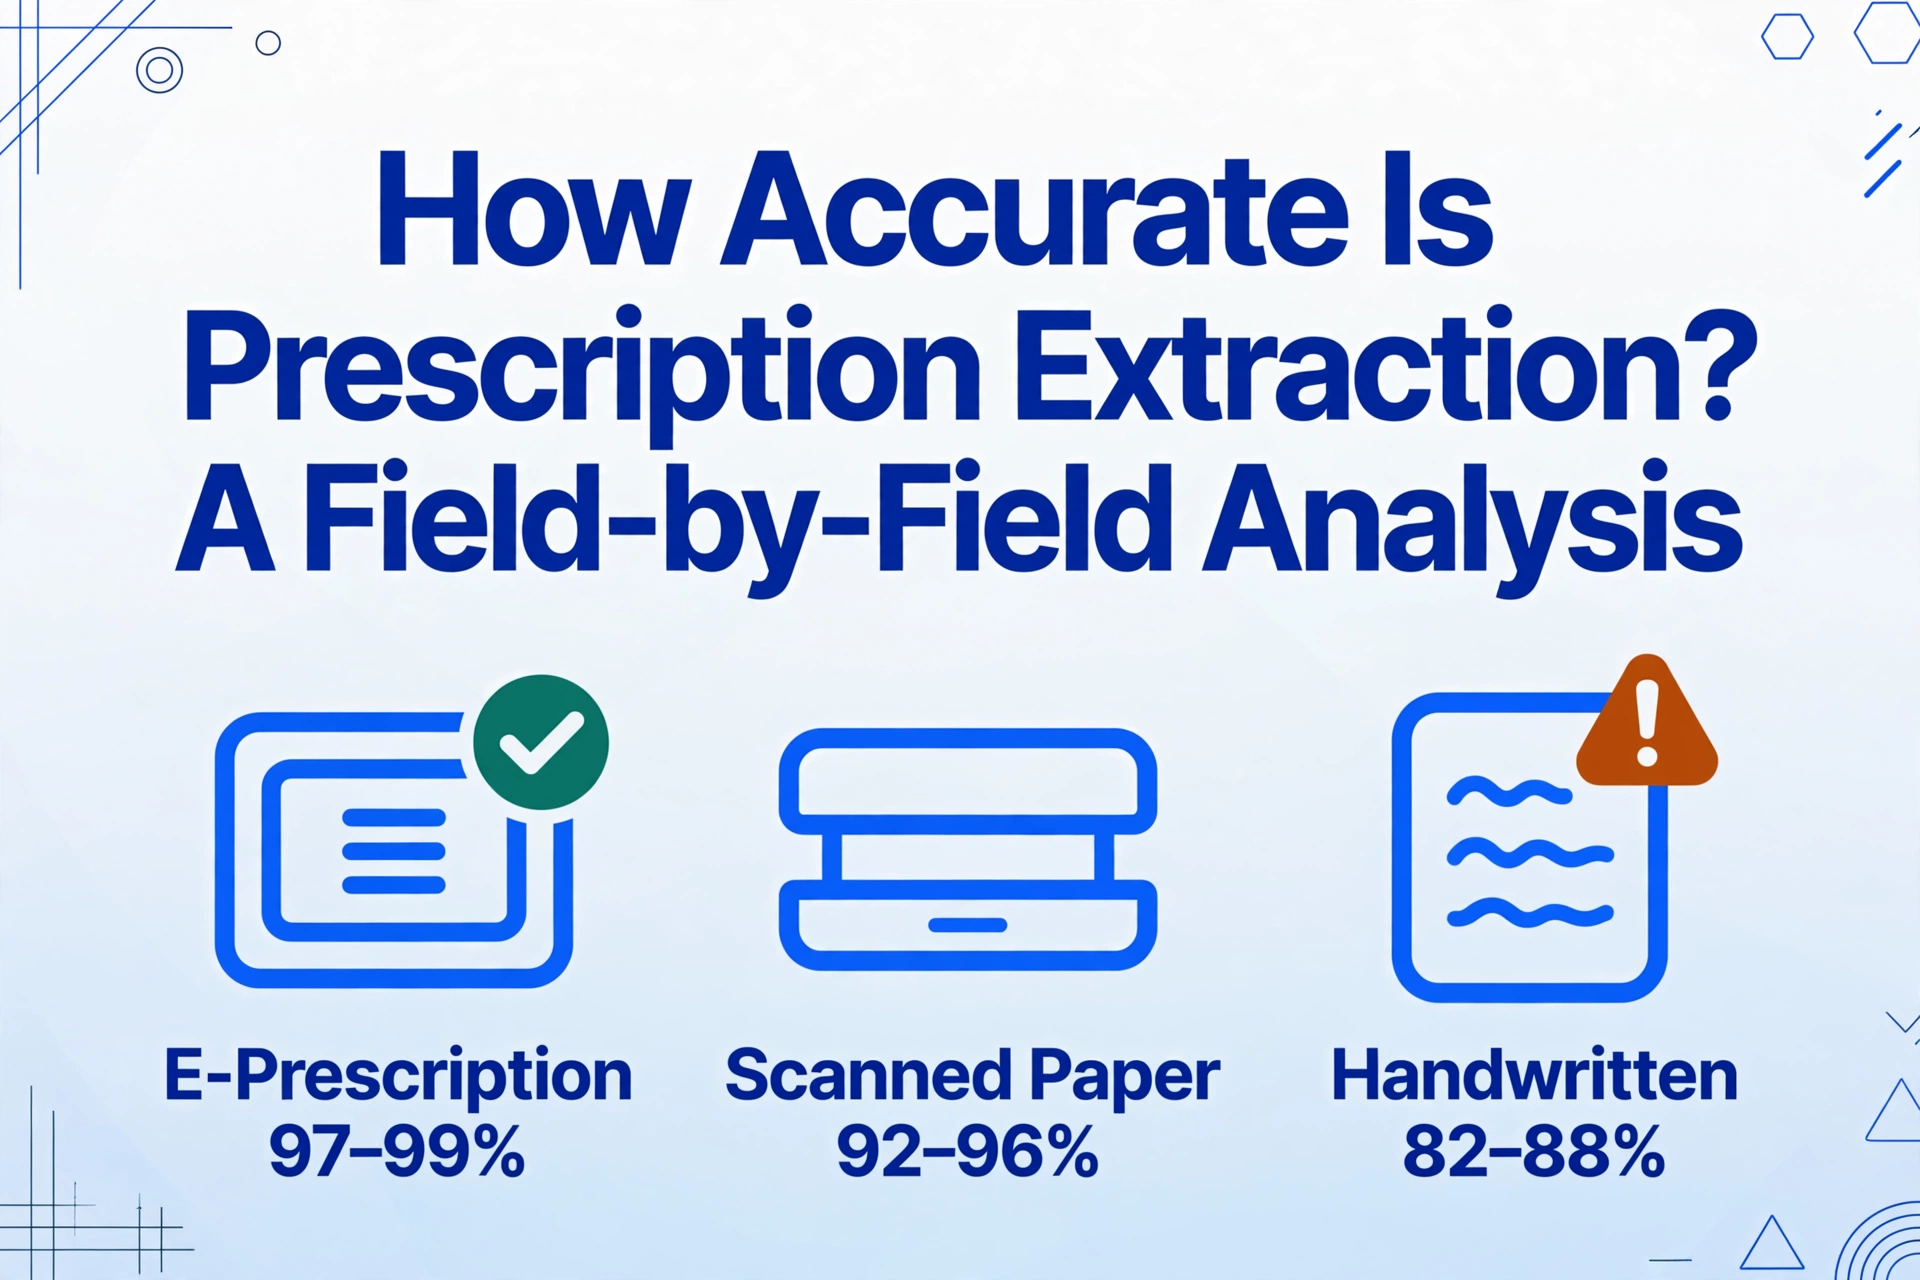
| E-Rezept (SureScripts, EPCS) | Digital, klarer Text | 97–99 % auf Feldebene | Selten; Inkonsistenzen bei der SIG-Code-Normalisierung |
| Gescanntes Papierrezept | 300 DPI Flachbettscan, guter Kontrast | 92–96 % gedruckt; 82–88 % handschriftlich | Handschrift bei mehrzeiligen SIG-Anweisungen |
| Fax-Rezept (Thermopapier) | Niedrige Auflösung, verblasst, schief | 85–92 % auf Feldebene im Durchschnitt | Zeichenfragmentierung; verschmierte Ziffern bei NDC/Dosierung |
Eine Studie von 2024 mit PaddleOCR an echten Rezepten ergab, dass gedruckte Rezepte eine Textextraktionsgenauigkeit von ~95 % erreichten, handschriftliche Rezepte jedoch auf ~85 % fielen – eine Lücke von 10 Prozentpunkten, die selbst mit Vorverarbeitungsschritten wie Rauschunterdrückung und Binarisierung bestehen bleibt. Eine separate Studie zur ANN-gestützten OCR von Rezepten berichtete eine Prescription Accuracy Rate (PAR – der Anteil der Rezepte, bei denen alle kritischen Felder korrekt erkannt wurden) von 85,7 % für ein verbessertes System, gegenüber 78,0 % für die Basis-OCR (Gudi, 2025). Dies ist das Problem der Genauigkeitsuntergrenze: Wenn Ihr eingehendes Faxvolumen hoch ist, startet selbst das beste Modell von einer niedrigeren Basis.
Die praktische Schlussfolgerung ist nicht, die KI-Extraktion für Fax-Rezepte zu vermeiden – sondern Ihren Prüfworkflow so zu gestalten, dass er auf die tatsächlich eingehende Eingabequalität ausgelegt ist, nicht auf den Idealfall. Eine Apotheke, die 80 % E-Rezepte und 20 % Fax-Rezepte verarbeitet, benötigt ein anderes Design der Prüfpunkte als eine Apotheke mit umgekehrtem Verhältnis.
Das Problem der Arzneimittelnamen: Wenn Ähnlichkeit nicht ausreicht
Seit 1975 führt das ISMP (Institute for Safe Medication Practices) eine Liste verwechselbarer Arzneimittelnamen – einen Katalog von Medikamentenpaaren, deren Namen sich in Aussehen oder Aussprache so ähneln, dass es zu echten Abgabefehlern kommt. Für Extraktionssysteme ist diese Liste der Unterschied zwischen „ähnlicher Treffer“ und „falsches Medikament“.
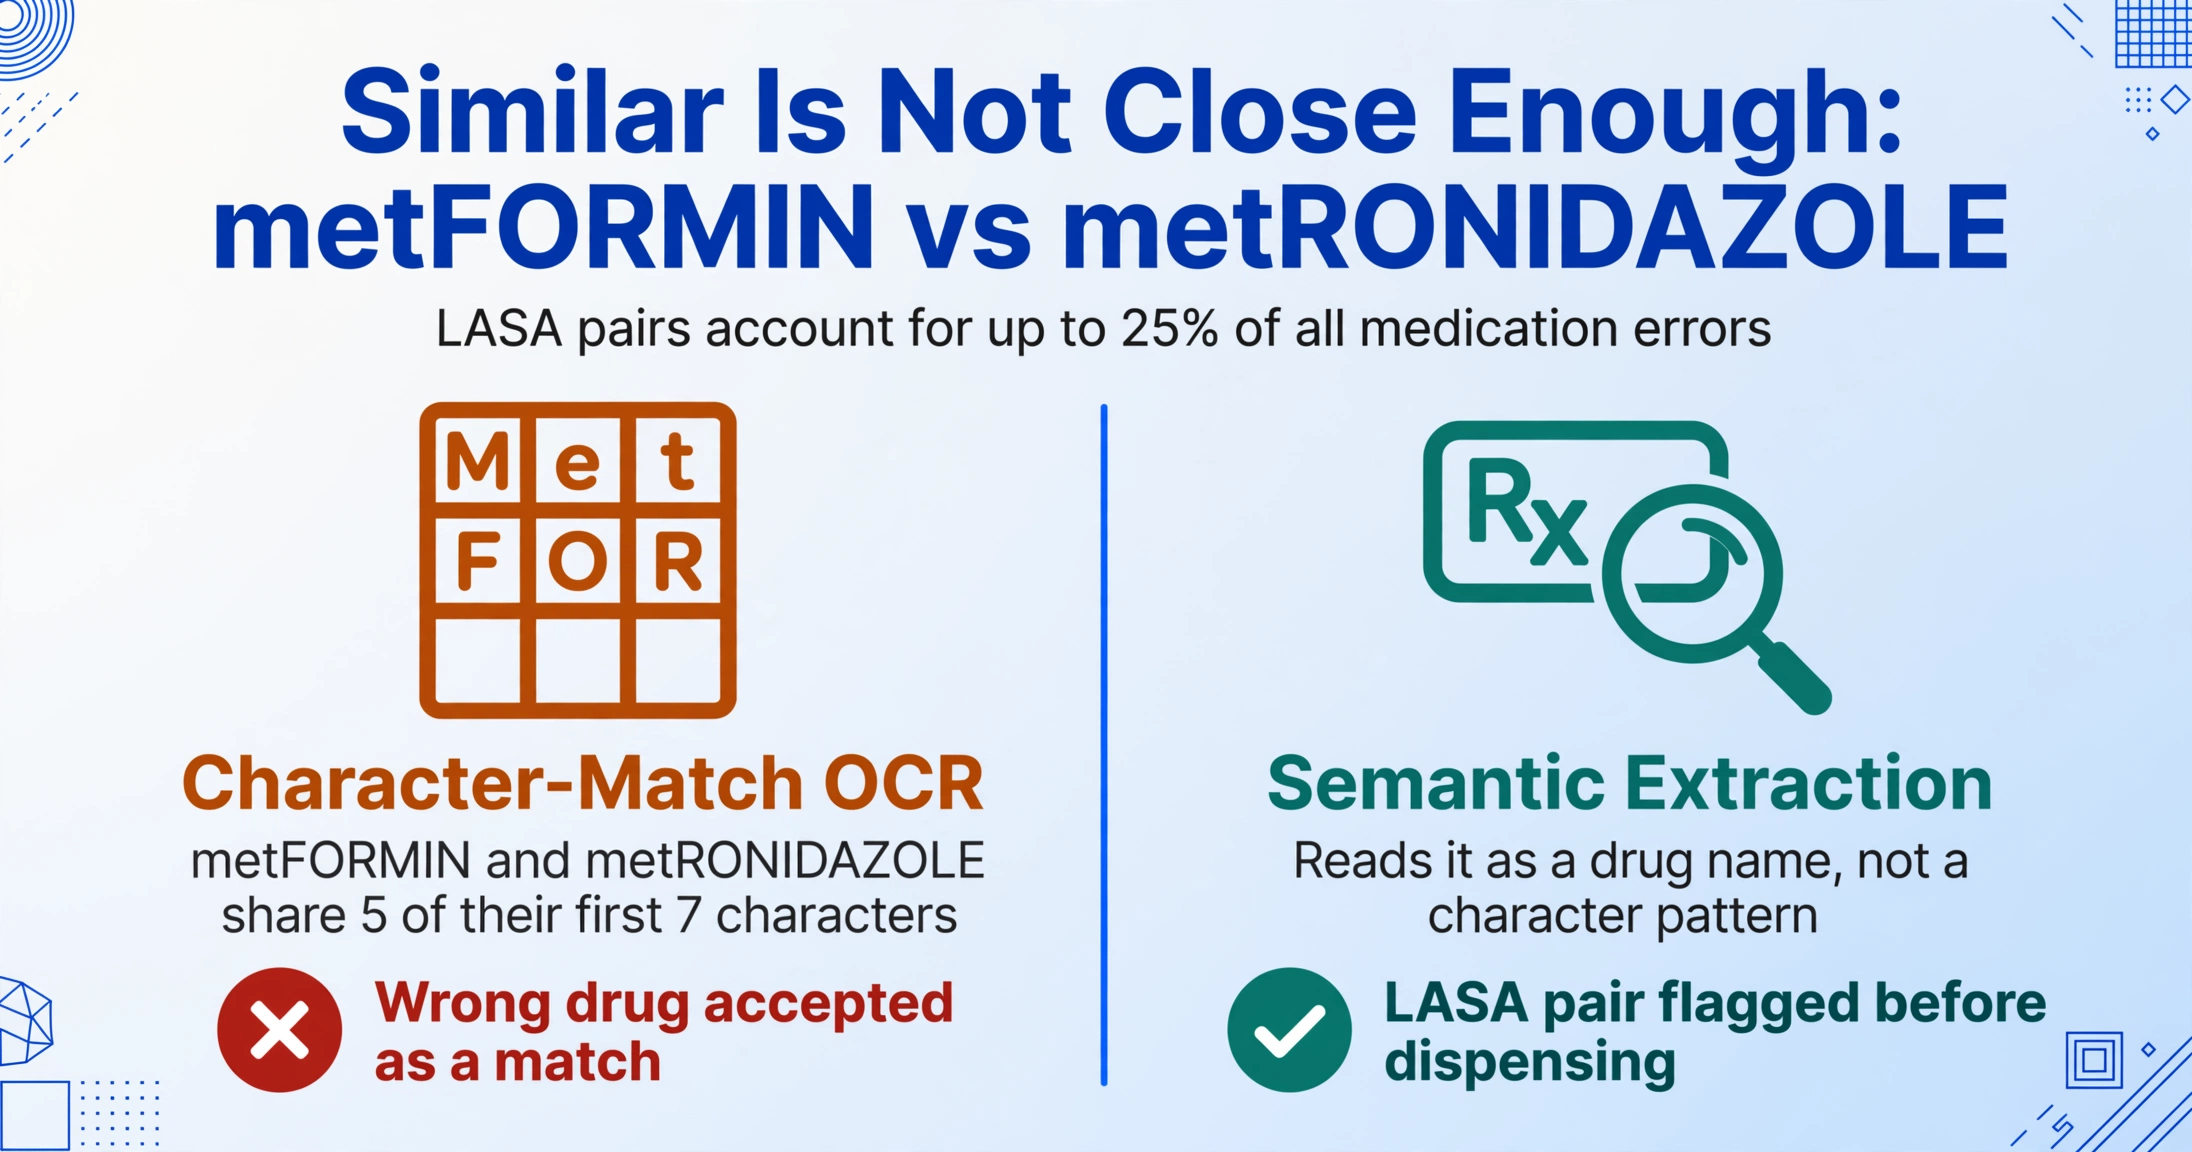
LASA-Arzneimittelnamenpaare (Look-Alike, Sound-Alike) sind Schätzungen zufolge für bis zu 25 % aller Medikationsfehler verantwortlich, und die Liste ist nicht kurz – der aktuelle ISMP-Katalog umfasst hunderte Einträge über Marke-Marke-, Marke-Generikum- und Generikum-Generikum-Paare (ISMP-Liste verwechselbarer Arzneimittelnamen). Die Konsequenzen sind so konkret, dass Arzneimittelnamen geändert wurden, um Verwechslungen zu vermeiden: Losec wurde zu Prilosec, nachdem es wiederholt mit Lasix verwechselt wurde; Brintellix wurde in Trintellix umbenannt, um Verwechslungen mit Brilinta zu vermeiden; Celebrex wurde ursprünglich als Celebra eingeführt, bevor Bedenken wegen Verwechslungen mit Celexa aufkamen.
Für einen menschlichen Pharmazie-Mitarbeiter ist der Schutz vor LASA-Fehlern Schulung, Tall-Man-Lettering (Schreiben von Hydroxyzin und Hydralazin in gemischter Groß-/Kleinschreibung, um sie visuell zu unterscheiden) und unabhängige Doppelkontrollen. Für ein KI-Extraktionssystem ist die Herausforderung anders, aber nicht weniger ernst: Ein OCR-basiertes System sieht Zeichenmuster, keine Arzneimittelnamen. Für eine OCR-Engine teilen sich „Metformin“ und „Metronidazol“ 5 ihrer ersten 7 Zeichen – eine Übereinstimmung mit hoher Konfidenz, die ein naives System akzeptieren könnte. Eine semantische Extraktions-Engine versteht dagegen, dass sie ein Rezept aus einem Hausarztbesuch eines Diabetes-Patienten liest, und gewichtet die Wahrscheinlichkeit zugunsten von Metformin. Sie bringt Kontext in das Zeichenerkennungsproblem.
Ein verwandtes Risiko, das weniger Beachtung findet: Die NDC-zu-Arzneimittelnamen-Kreuzvalidierung ist eine zweite Verteidigungslinie, die die meisten Extraktionstools nicht bieten. Wenn ein System „Lisinopril 10 mg“ extrahiert, aber die NDC in derselben Zeile auf Atorvastatin verweist, kennzeichnet eine gut konzipierte Extraktions-Pipeline die Inkonsistenz, bevor die Daten das Apothekenverwaltungssystem (PMS) erreichen. Diese Art der Intra-Dokument-Validierung – die Prüfung, ob extrahierte Felder intern konsistent sind – verwandelt die Extraktion von einer einmaligen OCR-Aufgabe in eine mehrschichtige Genauigkeitsprüfung.
NDC: Die 10-stellige Falle
Eine einzelne NDC kann je nach Verwendungsort bis zu drei gültige Darstellungen haben – und die Umrechnung zwischen ihnen ist eine mechanische Aufgabe, bei der Menschen konsistent Fehler machen und KI unvorhersehbar Fehler macht.
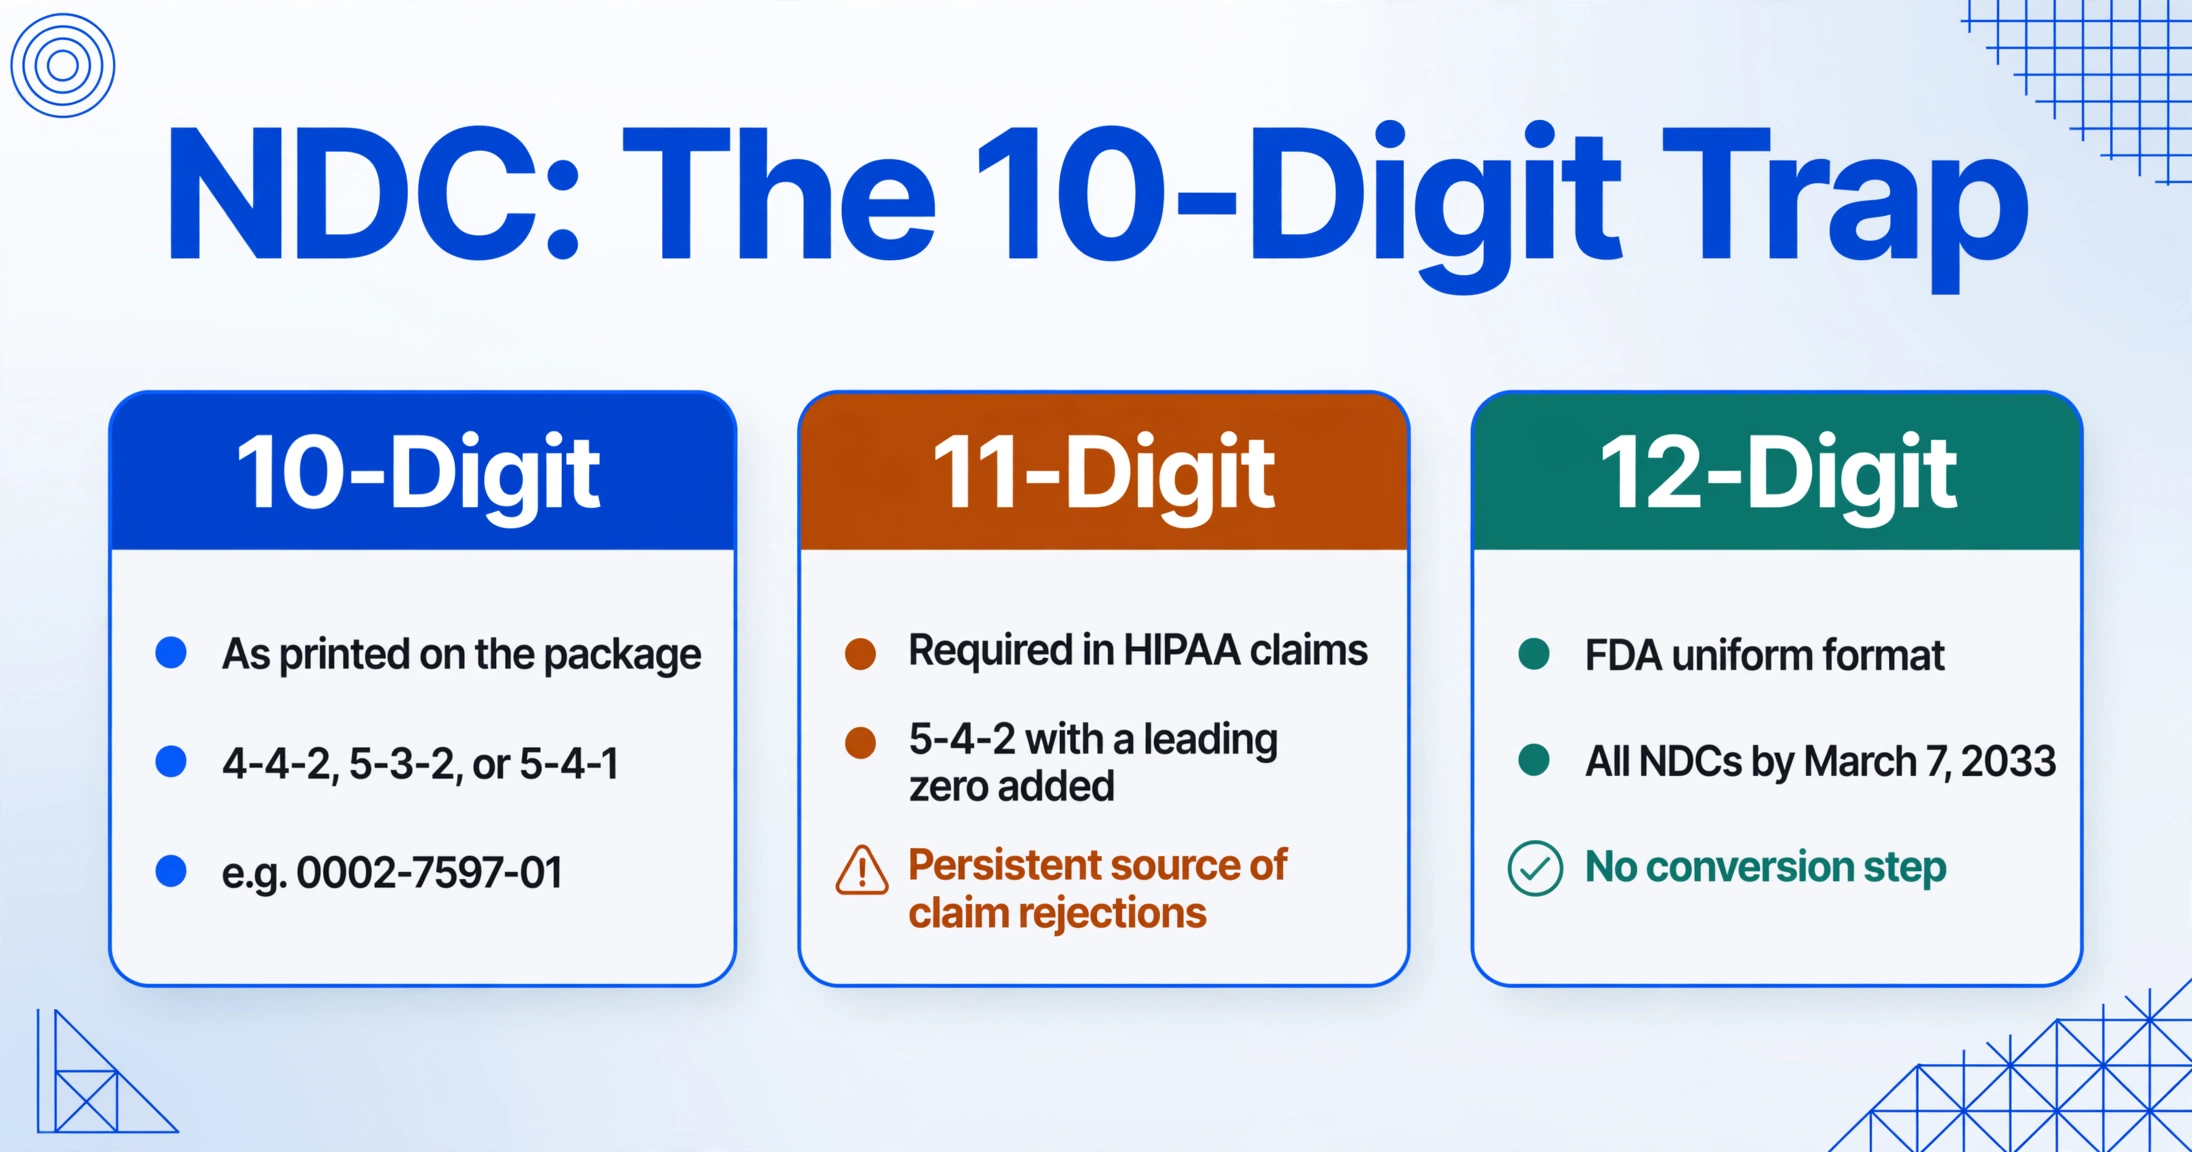
Der NDC (National Drug Code) ist eine 10-stellige Kennung mit drei Segmenten: Labeler Code (4 oder 5 Ziffern), Product Code (3 oder 4 Ziffern) und Package Code (1 oder 2 Ziffern). Die FDA vergibt NDCs in drei möglichen Formaten – 4-4-2, 5-3-2 oder 5-4-1 – was bedeutet, dass die NDC desselben Medikaments auf der Verpackung als 0002-7597-01 (4-4-2) oder 60574-4114-1 (5-4-1) erscheinen kann. Für HIPAA-abgedeckte Transaktionen ist jedoch eine 11-stellige NDC im festen 5-4-2-Format erforderlich, die durch Hinzufügen einer führenden Null zum kurzen Segment erreicht wird – und die Null wird je nachdem, welches der drei ursprünglichen Formate die NDC verwendet, an einer anderen Position eingefügt (FDA-Leitfaden zum NDC-Format).
Diese Umrechnung – von 10 auf 11 Ziffern – ist eine ständige Quelle für Antragsablehnungen. Die FDA selbst räumte in ihrem 2023 vorgeschlagenen Regelwerk zur Überarbeitung des NDC-Formats ein, dass „das Gesundheitssystem und die Kostenträger derzeit 10-stellige NDCs in 11-stellige NDCs umwandeln, was die Gesundheitskosten erhöht und ein Faktor bei Medikationsfehlern sein kann“ (FDA, 2023). Das Problem verschärft sich: Im März 2026 hat die FDA eine Regelung finalisiert, die alle NDCs bis zum 7. März 2033 auf ein einheitliches 12-stelliges Format (6-4-2) umstellt, mit einer dreijährigen Übergangsfrist bis März 2036. In diesem Zeitraum könnte das PMS einer Apotheke gleichzeitig 10-stellige, 11-stellige und 12-stellige NDCs erhalten – drei verschiedene Formate für dieselbe Produktkennung.
Für ein Extraktionssystem hat die Herausforderung der NDC-Genauigkeit zwei Ebenen: das Extrahieren der korrekten Ziffern aus dem Bild und das Wissen, welches Format die extrahierten Ziffern darstellen. Die erste Ebene ist ein OCR-Problem (ist das eine 0 oder eine 8? Ist der Bindestrich vorhanden oder ein Schmierer?). Die zweite Ebene ist ein Problem des Fachwissens: Wenn das System 9 Ziffern aus einem Feld mit der Bezeichnung „NDC“ extrahiert, handelt es sich dann um ein 5-3-1-Format mit fehlender führender Null oder um ein 5-4-0-Format mit fehlender Endnull? Die Antwort bestimmt, ob die Daten als gültige Kennung in Ihr PMS fließen oder als abgelehnter Antrag.
Dosierung, DEA-Nummer und die regulatorische Datenkette
Fehler bei Arzneimittelnamen und NDC sind Datenqualitätsprobleme; Fehler bei Dosierung und DEA-Nummer sind Probleme der regulatorischen Compliance. Dieser Unterschied ist entscheidend, wenn Sie bewerten, welche Extraktionsfehler Ihr Workflow tolerieren kann.
Dosierungsfehler bei der Extraktion fallen typischerweise in drei Kategorien: Einheitenverwechslung (mcg als mg extrahiert – ein 1.000-facher Dosierungsfehler), Verschiebung des Dezimalpunkts (0,5 mg → 5 mg) und Verwechslung von Stärke und Menge (10-mg-Tablette vs. Menge von 10 Tabletten). Das ISMP führt eine Liste fehleranfälliger Abkürzungen und Dosisbezeichnungen, die speziell diese Fehlermodi bei der manuellen Eingabe adressiert – bei der KI-Extraktion ist das Problem jedoch subtiler. Ein Bildverarbeitungsmodell, das „Levothyroxin 0,025 mg“ liest, könnte die Zeichen korrekt transkribieren, sie aber in die falsche Ausgabespalte setzen und die Stärke dem Mengenfeld zuweisen. Der Fehler liegt nicht im Lesen – er liegt in der Feldzuweisung, die ein Verständnis dafür erfordert, was jeder Text bedeutet, nicht nur, was er sagt.
DEA-Nummern tragen eine strukturelle Validierung, die in das Format eingebaut ist: Eine gültige DEA-Nummer besteht aus zwei Buchstaben, gefolgt von sieben Ziffern, wobei der zweite Buchstabe der Anfangsbuchstabe des Nachnamens des Verschreibers ist und die siebte Ziffer eine Prüfsumme ist, die aus den ersten sechs Ziffern berechnet wird. Das bedeutet, dass ein Extraktionssystem sofort eine Formatvalidierung durchführen kann – wenn die extrahierte Zeichenfolge nicht mit dem DEA-Prüfsummenalgorithmus übereinstimmt, wurde sie entweder falsch gelesen oder ist ungültig. Die praktische Auswirkung: Die Extraktion von DEA-Nummern hat eine überprüfbare Genauigkeitsrate – Sie können genau messen, wie oft das System eine Zeichenfolge produziert, die die Prüfsumme besteht, und alles, was dies nicht tut, zur manuellen Überprüfung kennzeichnen. Kein anderes Rezeptfeld bietet diese eingebaute Verifizierung.
Staatliche PMP-Datenanforderungen fügen eine weitere Ebene hinzu: Verschreibungsüberwachungsprogramme in 37 Bundesstaaten verlangen von Verschreibern, vor dem Ausstellen von Rezepten für kontrollierte Substanzen (Schedule II–IV) das PMP-Register zu konsultieren, und die Genauigkeit der PMP-Daten hängt vollständig von den Meldungen der Apotheken und Abgabestellen ab (NASCSA, 2024 PMP-Ressourcen). Jede Abgabestelle ist für die Integrität ihrer übermittelten Daten verantwortlich – „die Sicherstellung, dass PMP-Daten korrekt und vollständig sind, liegt in der Verantwortung“ jeder abgebenden Apotheke (Gesundheitsbehörde des Bundesstaates Washington). Ein Extraktionsfehler, der das PMP-Register erreicht, erzeugt eine dauerhafte Diskrepanz in der Historie kontrollierter Substanzen eines Patienten und könnte bei zukünftigen PMP-Konsultationen falsche Warnungen auslösen.
| Feld | Fehlerfolge | Integrierte Validierung? | Bei der Überprüfung durch Menschen erkennbar? |
|---|---|---|---|
| Arzneimittelname | Falsches Medikament wird abgegeben | DUR-Interaktionsprüfung (teilweise) | Ja – wenn der Apotheker das Etikett mit dem Originalrezept vergleicht |
| NDC | Ablehnung des Abrechnungsanspruchs; Bestandsabweichung | Formatvalidierung möglich; keine semantische Prüfung | Nein – NDC ist für den Patienten auf dem Etikett nicht sichtbar |
| Dosierung/Stärke | Über- oder Unterdosierung | DUR-Dosierungsbereichsprüfung (teilweise) | Teilweise – auf dem Etikett sichtbar, aber Verwechslung von mcg/mg ist subtil |
| DEA-Nummer | Datenverfälschung im PMP; fehlgeschlagene Nachverfolgung von Betäubungsmitteln | Prüfsummenvalidierung (vollständig) | Nein – die ID des Verschreibers ist für den Patienten nicht sichtbar |
| Menge | Falsche Tageversorgung; vorzeitiges Wiederholungsrezept | DUR-Nutzungsprüfung | Ja – auf dem Etikett sichtbar |
| SIG / Anwendungsanweisung | Patient nimmt Medikament falsch ein | Keine automatisierte Prüfung | Ja – der Patient kann dies bei der Beratung überprüfen |
Die Tabelle zeigt eine Asymmetrie: NDC- und DEA-Fehler sind nachgelagert am schwersten zu erkennen und am einfachsten zum Zeitpunkt der Extraktion zu verhindern – da beide über strukturelle Validierungsregeln verfügen, die ein ordnungsgemäß konzipiertes Extraktionssystem anwenden kann, bevor die Daten in Ihr PMS gelangen. Felder ohne integrierte Validierung (Arzneimittelname, SIG-Anweisungen) erfordern eine andere Strategie: menschliche Überprüfung so nah wie möglich am Extraktionspunkt, bevor die Daten weitergegeben werden.
Entwicklung eines akkuraten Extraktions-Workflows
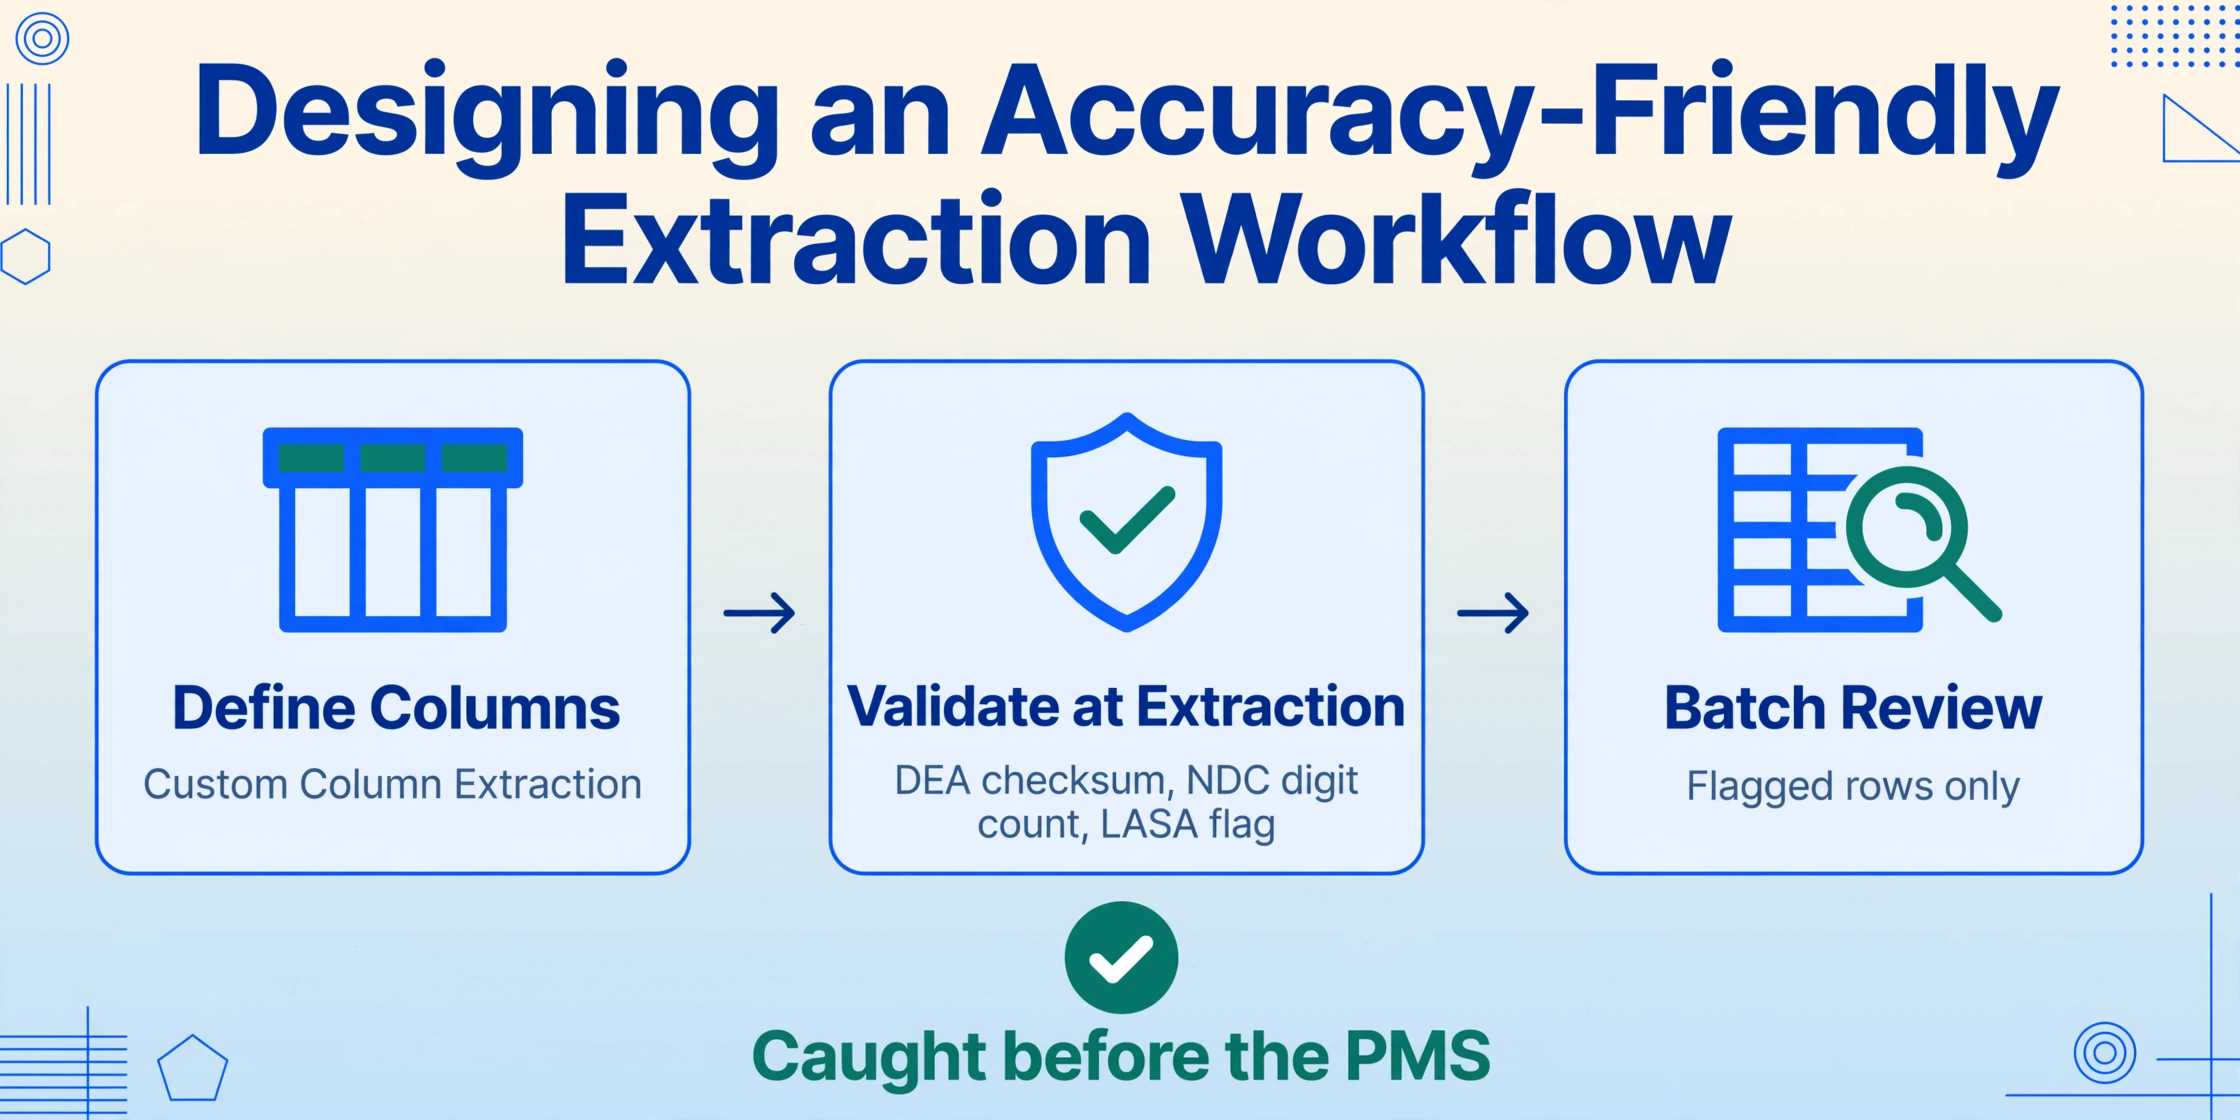
Das akkurateste Extraktionssystem in einer Apotheke ist nicht das mit der höchsten Prozentzahl in der Überschrift – sondern das, dessen Fehlermuster zu den Fähigkeiten Ihres Verifizierungs-Workflows passen, diese Fehler zu erkennen.
Ein praktischer Genauigkeits-Workflow für die Rezeptextraktion zielt nicht auf null Fehler in der Extraktionsphase ab. Er zielt auf Fehlermuster, die vorhersehbar, verifizierbar und abgefangen werden, bevor sie sich ausbreiten. So sieht das Feld für Feld aus:
Dateien werden sicher verarbeitet und nicht gespeichert.
Dieser Workflow macht aus der Genauigkeit einer einzelnen Prozentangabe des Anbieters einen operativen Parameter, den Sie steuern. Statt zu fragen „Wie genau ist dieses Tool?“, fragen Sie: „Welche Felder muss mein Verifizierungsworkflow doppelt prüfen, und mit welcher Rate?“ — und die Antwort hängt von Ihrem Eingabemix, den integrierten Validierungsebenen Ihres PMS und davon ab, welche Felder in Ihrem Bundesstaat Compliance-Konsequenzen haben.
Häufig gestellte Fragen
Wie genau ist KI beim Lesen handschriftlicher Rezepte?
Die Genauigkeit der Extraktion handschriftlicher Rezepte liegt typischerweise zwischen 82 % und 88 % auf Feldebene, verglichen mit 95–99 % bei gedruckten oder E-Rezepten. Die Schwankung hängt stark von der Lesbarkeit der Handschrift, der Bildauflösung und davon ab, ob das Rezept mehrzeilige SIG-Anweisungen enthält. Ein Rezept mit klar in Druckbuchstaben geschriebenem Medikamentennamen und sauber geschriebenem NDC wird weitaus zuverlässiger extrahiert als eines mit kursiven SIG-Anweisungen über vier Zeilen. Dies ist eine echte Einschränkung — kein aktuelles Extraktionssystem erreicht über 90 % Genauigkeit bei der gesamten Bandbreite ärztlicher Handschriften, die in der Praxis vorkommen.
Reduziert KI-Extraktion Medikationsfehler im Vergleich zur manuellen Dateneingabe?
Ja – aber nicht durch perfekte Genauigkeit. Der Vorteil liegt darin, dass KI-Extraktionsfehler vorhersehbaren Mustern folgen (Zeichenverwechslungen in niedrig aufgelösten Feldern, Feldzuordnungsfehler bei komplexen Layouts), während menschliche Eingabefehler zufällig und systematisch schwerer zu erkennen sind. Eine Apotheke, die ihren Prüfworkflow gezielt auf die bekannten Schwachstellen der KI ausrichtet – NDC-Stellenanzahl-Prüfung, DEA-Prüfsummenvalidierung, LASA-Wirkstoffnamensmarkierung – kann eine niedrigere Nettofehlerrate erzielen als bei reiner manueller Eingabe, selbst wenn die Rohgenauigkeit der KI bei einigen Feldern im hohen 80er-Bereich liegt.
Kann KI-Extraktion die NDC-Formatkonvertierung automatisch durchführen?
Ein Extraktionssystem kann erkennen, wie viele Ziffern es ausliest, und NDCs markieren, die nicht den erwarteten Formaten entsprechen. Eine vollständige 10→11-stellige Konvertierung erfordert jedoch die Kenntnis des ursprünglichen FDA-zugewiesenen Formats (4-4-2, 5-3-2 oder 5-4-1) – Informationen, die auf dem Rezeptetikett nicht sichtbar sind. Der sicherste Ansatz ist, die Extraktion zur Ziffernerfassung zu nutzen und die Konvertierung Ihrem PMS oder einem Arzneimitteldaten-Kompendium (das das ursprüngliche Format jeder NDC kennt) zu überlassen. Die Aufgabe des Extraktionssystems ist es, Ihnen mitzuteilen: „Ich habe 9 Ziffern gelesen, wo 10 oder 11 erwartet wurden“ – nicht zu raten, wo die Null hingehört.
Welche Rezeptfelder sind nach der Extraktion am wichtigsten zu überprüfen?
NDC und Wirkstoffname sollten Ihre obersten Prüfprioritäten sein – NDC-Fehler sind für Patienten und nachgelagerte Prüfungen unsichtbar, und Wirkstoffnamenfehler bergen das höchste Patientensicherheitsrisiko. DEA-Nummern sind als nächstes wichtig: Sie sind über eine Prüfsumme verifizierbar, werden aber in staatliche PMP-Datenbanken übertragen, wo Fehler schwer zu korrigieren sind. Die Dosierungsprüfung ist besonders wichtig für Arzneimittel mit enger therapeutischer Breite (Warfarin, Levothyroxin, Digoxin), bei denen kleine Dosierungsfehler überproportionale klinische Auswirkungen haben. Menge und Wiederholungszahlen sind zwar wichtig, werden aber am ehesten durch bestehende Apotheken-Workflow-Schritte wie DUR und Patientenberatung erfasst.
Ist dieser Ansatz mit Apothekenverwaltungssystemen und E-Rezept-Netzwerken kompatibel?
Die meisten KI-Extraktionstools geben zunächst CSV- oder Excel-Dateien aus – nicht direkt in Ihr PMS. Das bedeutet, dass die Extraktionsausgabe als Vorprüfung dient: Sie überprüfen die strukturierten Daten in einer Tabellenkalkulation, korrigieren markierte Einträge und importieren oder geben die geprüften Daten anschließend manuell in Ihr PMS ein. Eine direkte PMS-Integration existiert in Apotheken-Automatisierungsplattformen für Unternehmen (Asepha, Nodens Health), aber für die meisten unabhängigen Apotheken und Apothekenketten ist der Workflow von der Extraktion zur Tabellenkalkulation zum PMS der praktikable Weg, wobei die Tabellenkalkulation als Ihr Batch-Prüfpunkt dient.
Die Extraktionsgenauigkeit von Rezepten ist keine Zahl, die Sie erst nach der Einführung entdecken. Sie ist eine Reihe von Erwartungen, die Sie im Vorfeld kalibrieren – nach Eingabekanal, nach Feldtyp und nach dem Prüfworkflow, der zwischen Extraktion und Abgabe liegt. Die hilfreichsten Tools sind nicht diejenigen, die pauschal 99 % Genauigkeit versprechen. Es sind diejenigen, die Ihnen sagen, wo ihre Schwächen liegen, damit Sie genau wissen, wo Sie Ihre zweite Kontrollinstanz ansetzen müssen.
Testen Sie die Rezeptextraktion mit einer Beispieldatei – sehen Sie, welche Felder sauber extrahiert werden und welche Ihr Workflow prüfen muss.