PDFレポートから検査結果を抽出する方法
Excelに変換 — コーディング不要
CLL Society — 全国規模の患者支援団体 — は、血液検査結果を記録するための無料のExcelテンプレートを提供しています。CBC、血液化学、免疫グロブリンのタブがあり、経時的な値の自動グラフ化や基準範囲外の値のフラグ付けも行えます。よく考え抜かれた設計で、実際の患者ニーズから生まれたことが明らかです。しかし、データ入力の仕組みは40年前から変わらずスプレッドシートと同じ方法です。検査結果のPDFを開き、「Hemoglobin A1c」の横にある値を見つけてセルに入力する。次に別の検査機関で同じ検査が「HbA1c (%)」と異なる表記・形式で記載されていても、また値を見つけて入力し直す。テンプレートは優れています。データ入力がボトルネックなのです。
重要なポイント
- 入力したその数字は、検査機器が血液を分析した瞬間にデジタル化されています。データベースやメールサーバーを機械可読データとして通過し、チェーン全体で自動化されていない唯一のステップは、PDFからスプレッドシートへの手入力だけです。
- テンプレート抽出は、検査機関を変えた瞬間に機能しなくなります。Quest Diagnosticsは「Hemoglobin A1c」、LabCorpは「HbA1c (%)」と表記するため、文字列の完全一致ではなく意味を理解するツールでなければ、2つ目の検査機関のデータで空のセルが発生します。
- ImageToTable.aiは、検査名の意味を理解して検査値を読み取るため、表記の違いに関係なく「HbA1c (%)」「A1C」「Glycohemoglobin」はすべて同じ列に集約されます。あなたの役割は数字の再入力から検証へと変わります。
患者が今も手作業で検査結果を入力する理由
CLL SocietyのExcelテンプレートは特別な例ではありません。Barth Syndrome Foundationも、検査値を記録するための独自のスプレッドシートを配布しており、その説明文には「日付と結果で絞り込める検査結果のスプレッドシートを管理してください」と、手間がかかることを認める記載があります。Redditのr/QuantifiedSelfのセルフトラッキングコミュニティでは、血液検査の経時変化をグラフ化できるツールを求める質問が定期的に寄せられています。患者コミュニティ、慢性疾患の支援団体、健康意識の高い人々は、皆同じ作業手順にたどり着きます。検査機関からPDFを受け取り、スプレッドシートを開いて、手入力する。これが普遍的であるのは、無料で使える唯一の方法だからです。
問題はスプレッドシートではありません。スプレッドシートは正常に機能します。問題はPDFとスプレッドシートの間にある部分、つまり人間がページ上の数値を読み取ってセルに入力するという作業です。四半期ごとの採血で5つのバイオマーカーを追跡している患者の場合、年間20件の値になります。1件のレポートにつき入力に2分かかります。本当のストレスは時間ではなく、データがすでにデジタル化されていることです。検査機関は機械でデータを生成しました。データベースに送信され、レポートに整形され、PDFとしてメールで送られてきました。この一連の流れの中で、デジタル化されていない唯一のステップは、PDFから追跡シートにデータを移す作業だけです。
しかし、このステップを自動化するのは見た目よりも難しいのです。なぜなら、検査レポートは請求書とは異なるからです。
ベンダーAの請求書とベンダーBの請求書には、どちらも明細、合計、日付があり、その構造はおおむね似ています。しかし、Quest Diagnosticsの検査レポートと地元の病院の検査レポートには、構造上の共通点がほとんどありません。検査名が1列目にあることもあれば、3行目にあることもあります。値が名前の隣にあることもあれば、下にあることもあります。基準範囲が同じ行の括弧内にあることもあれば、3インチ右の別の列にあることもあります。そして、ヘモグロビンA1cのラベルは「Hemoglobin A1c」「HbA1c」「A1C」「Glycohemoglobin」のいずれかであり、同じ市内でも、すべて同じ検査を指しています。
実際に追跡しているもの — 検査名、値、単位、基準範囲
検査レポートには、必要な情報以上のものが含まれています。患者の基本情報、依頼医、検体採取時間、検査機関の認定情報、方法に関する注記 — これらはすべてレポートの完全性に関わるものですが、個人の追跡用スプレッドシートには関係ありません。あなたが気にする情報は、5つの列に収まります。
検査日 | 検査名 | 結果値 | 単位 | 基準範囲レポート上の他のすべての項目 — 患者の住所、検査機関のCLIA番号、実施した臨床検査技師のイニシャル — は、追跡目的にはノイズです。上記の5つの列がシグナルです。そして、確実に抽出するのが最も難しいのは検査名です。なぜなら、検査機関によって同じ検査の表記が異なるからです。
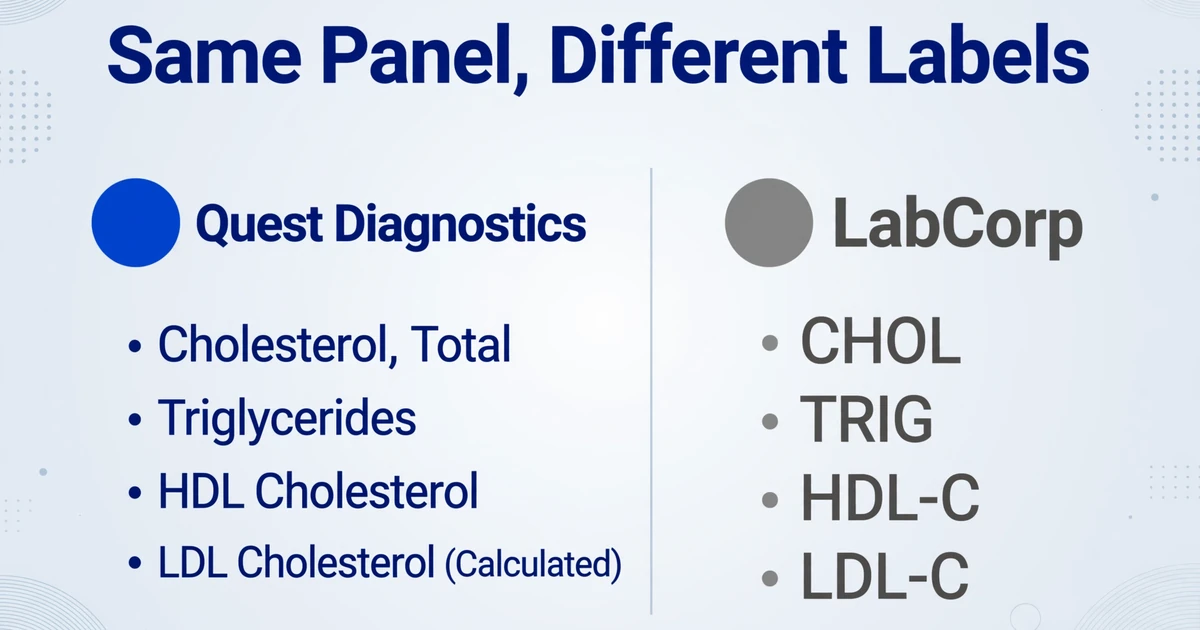
Quest Diagnosticsの脂質パネルでは「Cholesterol, Total」「Triglycerides」「HDL Cholesterol」「LDL Cholesterol (Calculated)」と記載されます。同じパネルがLabCorpでは「CHOL」「TRIG」「HDL-C」「LDL-C」と記載されるかもしれません。病院の検査室では「Total Cholesterol」「Triglyceride」「HDL」「LDL」と印刷されるかもしれません。値は同じ数字です。ラベルは異なる文字列です。テンプレートベースの抽出ツールがLabCorpのレポートで「Cholesterol, Total」を探しても何も見つかりません — なぜならテンプレートにとって「CHOL」は「Cholesterol, Total」ではないからです。両方のラベルの意味を理解している人にとってのみ、それは同じものなのです。
これが、患者コミュニティが今でも手動のExcelテンプレートを配布している理由の核心です。既存の無料ツールで自動抽出が簡単にできるなら、CLL Societyは患者に入力を求めるスプレッドシートを配布する代わりに、そのツールへのリンクを掲載するでしょう。
列名抽出がどのようにあらゆるラボ形式を読み取るか
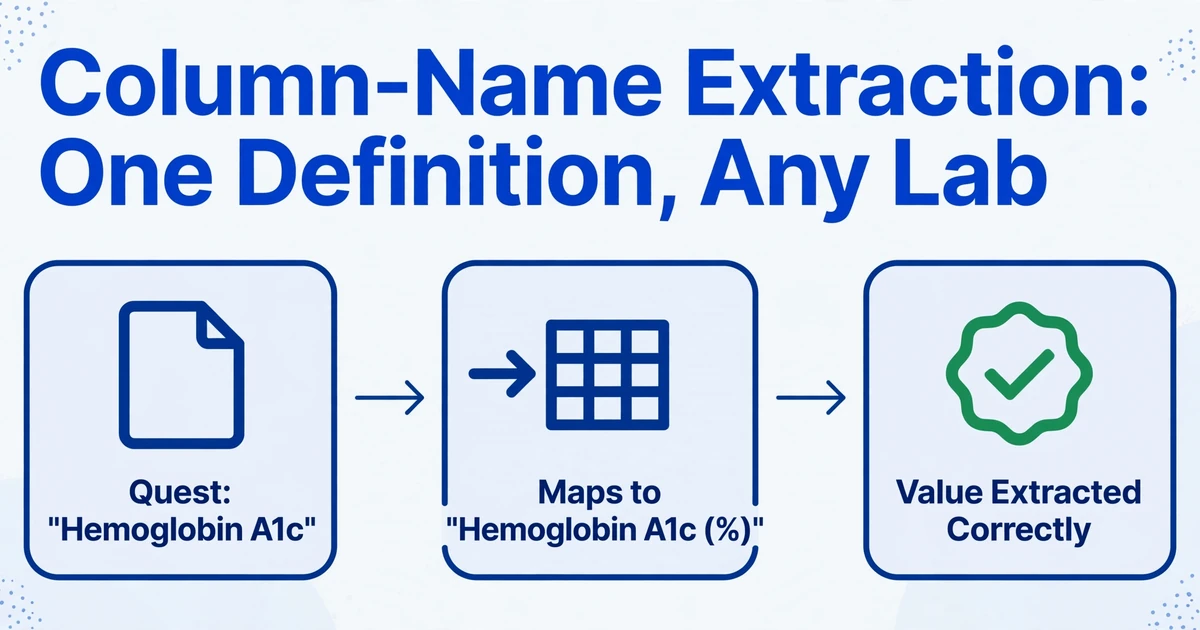
さまざまなラボレポートに対応できるアプローチが列名抽出です。ツールに各値の位置を指定する代わりに、必要な情報を指定すると、ラベルの意味を理解して該当するデータを見つけ出します。スプレッドシートのヘッダーになる列名をツールに入力します:
Test Date  |  Hemoglobin A1c (%)  |  Fasting Glucose (mg/dL)
Total Cholesterol (mg/dL)  |  HDL Cholesterol (mg/dL)  |  LDL Cholesterol (mg/dL)
Triglycerides (mg/dL)  |  TSH (mIU/L)  |  Vitamin D (ng/mL)
AIがQuestのレポートを処理するとき、左の列に印刷された「Hemoglobin A1c」を認識し、対応する値を抽出します。LabCorpのレポートを処理するときは、「HbA1c (%)」— 表記は異なりますが同じ意味 — を同じ列にマッピングします。検査名を「糖化血红蛋白」(中国語)と表記する病院のレポートを処理する場合も、AIは意味的な等価性を理解します。定義した列名が正規のラベルとなり、各ラボの表記方法に関係なくAIがマッピングを処理します。
これは、各ラボのレポート形式ごとに個別のテンプレートを設定する必要があるテンプレートベースの抽出とは逆のアプローチです。また、ページ上のすべてのテキストを抽出するものの、どの数値がどの検査に属するかを理解しない生のOCRとも異なります。列名抽出では、指定した値だけを、指定した列に整理された形で正確に取得できます。
出力はExcelファイルとして生成され、各行が1つのレポート(1回の採血、1つの日付)を表し、各列が1つのバイオマーカーを表します。日付で並べ替えて6か月間のHbA1cの推移を確認できます。Total Cholesterol列から折れ線グラフを作成できます。基準範囲外の値には条件付き書式ルールでフラグを立てられます。スプレッドシートは生成された時点で分析用に構造化されており、1時間の再フォーマット作業は不要です。
臨床研究でEHRラボパネルを扱う研究者の方(フラグ付き値の抽出、複数回の受診記録の識別、システム固有の書式への対応を含む)は、EHRスクリーンショットからのラボ値抽出のガイドをご覧ください。1つの研究で複数の文書タイプを扱う場合は、放射線、病理、退院サマリーにわたる変数抽出で複数ソースの記録の扱い方を説明しています。完全なプレイブック(単位、基準範囲、異常フラグ、クリニックスケールでのバッチ処理)については、ラボレポートデータ抽出の完全ガイドをご覧ください。また、多数の患者の結果を一度に整理する場合は、小規模クリニックでの患者ラボ結果のバッチ整理をご覧ください。
複数のレポートを一度に処理 — 1年分の血液検査を1つのバッチで
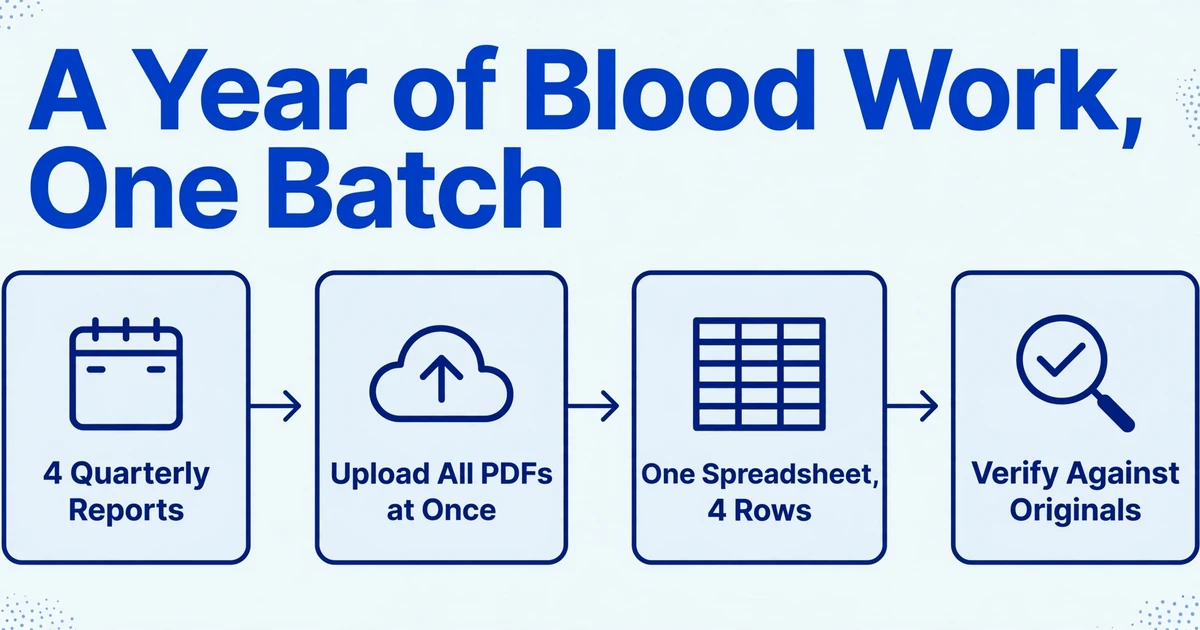
列名アプローチは、複数のレポートをまとめて処理する際にさらに価値が高まります。慢性疾患を管理している患者さんは、年に3〜4回の血液検査を受けることがあり、毎回異なる検査機関や、同じ検査ネットワークの別の場所で行われることもあります。レポートは1年分に及びますが、1つのバッチで数分で処理できます。
4つの四半期PDFを一度にアップロードしてください。AIはそれぞれを独立して読み取ります — 1月のQuest Diagnosticsレポート、4月のLabCorpレポート、7月の病院検査室レポート、10月のQuest Diagnosticsレポート — そしてすべての結果を同じ列セットにマッピングします。出力は、4行(各採血日に対応)と、定義した数のバイオマーカー列を持つ1つのスプレッドシートです。ファイル間のコピー&ペーストは不要。異なる列順の調整も不要。抽出処理が正規化を担当します。
検証ステップは、他のほとんどのドキュメントタイプよりもここで重要です。請求書の金額の入力ミスは50ドルの誤差ですが、検査値の入力ミスは、薬剤調整が必要な傾向を見逃すことにつながる可能性があります。抽出後、元のPDFとスプレッドシートを照合してください — スプレッドシートのHbA1c値がレポートの値と一致しているか、単位(%、mg/dL、mIU/L)が正しいか、基準範囲の端に近い値が転記ミスされていないかを確認します。この検証はレポート1件あたり1分未満で完了し、ワークフローにおいて人間の判断が属するポイントです。AIが入力を排除し、検証が正確性を保証します。
AIが検査レポートでできることとできないこと
検査レポートの抽出には、明確にしておくべき限界があります。
値を抽出するものであり、解釈をするものではありません。 AIは「TSH: 4.8 mIU/L」を読み取り、TSHの列に4.8と入力します。TSHが4.8で境界域の高値であることや、前回の値が2.1だったことは教えてくれません。解釈はあなたと担当医の仕事です。スプレッドシートはその解釈のための原材料であり、一貫した形式で、正確に転記され、分析の準備ができています。
スキャンの品質が精度に影響します。 検査機関のLIS(検査情報システム)から直接生成された鮮明なPDFは、非常に信頼性の高い抽出結果をもたらします。スキャンした印刷物、特にファックス、印刷、再スキャンを経たものは、特定の値の精度を低下させるノイズを生じる可能性があります。影響を受けやすいのは、小数点を含む数値(コンマと見分けがつかなくなることがあります)や、非常に小さなフォントで印刷された値(密度の高い代謝パネルでよく見られます)です。検証中に値が正しくないと思われる場合は、原本と照合してください。
医師の診察の代わりにはなりません。 検査値は文脈の中で意味を持ちます。年齢、服用中の薬、症状、病歴などが、その数値の意味に影響します。抽出とスプレッドシートでのグラフ化は、医療の補助であり、代替ではありません。自動追跡の価値は、診察の合間にデータにアクセスできるようにすることにあります。問題になる前に傾向を確認でき、次の診察では、印象ではなくデータを持参できます。
よくある質問
AIは検査報告書の手書きメモを読めますか?
はい、合理的な範囲内で可能です。医師が欄外に「3ヶ月後に再検査」と書いた場合、そのための列を定義すれば、AIはそれを別のメモ欄として抽出できます。ただし、手書きの検査結果(印刷ではなく完全に手書きの報告書)は、印刷された報告書よりも信頼性が低くなります。ビジョンモデルは手書き文字を読み取りますが、精度は判読性に依存します。そして医療現場の手書き文字は判読性で有名ではありません。追跡の目的には、可能な限り医療機関から印刷版の結果を請求してください。
検査機関ごとに異なる列名を設定する必要がありますか?
いいえ。列名は一度だけ定義します — 「ヘモグロビンA1c(%)」「TSH(mIU/L)」「ビタミンD(ng/mL)」など — AIが各検査機関のラベルを自動的に列名にマッピングします。列名が標準ラベルとして機能し、AIが同じ検査に対する検査機関ごとの表記の違いを処理します。つまり、新しい検査機関や新しい報告書形式を追加する際も、再設定は一切不要です。
英語以外の言語の検査結果はどうなりますか?
AIはあらゆる言語の検査報告書を読み取ります。「空腹血糖」と記載された中国語の病院報告書も、定義した「空腹時血糖(mg/dL)」列にマッピングされます。抽出処理は、異なる英語の略語を正規化するのと同じ方法で、言語間の差異も正規化します。つまり、文字を照合するのではなく、ラベルの意味を理解することで処理します。
PDFではなく画像形式の検査報告書からもデータを抽出できますか?
はい。スマートフォンで撮影した印刷された検査報告書の写真や、患者ポータルの結果のスクリーンショットも、PDFと同じ方法で処理されます。ビジョンモデルは、別途OCRステップを必要とせず、画像から直接テキストを読み取ります。最良の結果を得るには、明るい場所で正面から撮影し、数値がはっきり見えるようにしてください。結果セクションに合わせてトリミングすると効果的ですが、必須ではありません。
家族の検査結果の追跡にも適していますか?
はい。高齢の親や慢性疾患を持つ子どもの医療管理を担当している場合も、同じワークフローが適用されます:検査PDFを収集し、重要なバイオマーカーを定義し、一括アップロードして、追跡用スプレッドシートを取得します。複数の家族の報告書をまとめて処理する場合、患者名列によって誰の結果かを区別できます。専門医の診察室で「去年のクレアチニンは1.1だったか1.3だったか」と思い出そうとした経験がある方なら、実際の数値が入ったスプレッドシート(記憶ではなく抽出された値)があれば、診察での会話の質が変わります。