So extrahieren Sie Labortestergebnisse aus PDF-Berichten
in Excel — ganz ohne Programmierung
Die CLL Society — eine nationale Patientenvertretung — stellt eine kostenlose Excel-Vorlage zur Verfolgung von Bluttest-Ergebnissen bereit. Sie enthält Registerkarten für Blutbild, Blutchemie und Immunglobuline. Sie erstellt automatisch Diagramme der Werte im Zeitverlauf. Sie markiert Ergebnisse außerhalb der Referenzbereiche. Sie ist durchdacht gestaltet und eindeutig das Produkt echter Patientenbedürfnisse. Und der Mechanismus zur Dateneingabe ist derselbe, den Tabellenkalkulationen seit 40 Jahren verwenden: Sie öffnen Ihren Laborbericht als PDF, suchen den Wert neben „Hemoglobin A1c" und tippen ihn in die Zelle. Wenn Ihre nächste Blutentnahme von einem anderen Labor stammt, das denselben Test als „HbA1c (%)" bezeichnet und den Bericht anders formatiert, suchen Sie den Wert erneut und tippen ihn erneut ein. Die Vorlage ist ausgezeichnet. Die Dateneingabe ist der Engpass.
Die wichtigsten Erkenntnisse
- Die Zahl, die Sie gerade eingetippt haben, war bereits digital, als das Labormaschine Ihr Blut analysierte — sie durchlief Datenbanken und E-Mail-Server als maschinenlesbare Daten, und der einzige nicht automatisierte Schritt in der gesamten Kette sind Ihre Finger, die vom PDF zur Tabellenkalkulation wandern.
- Die Extraktion mit Vorlagen scheitert in dem Moment, in dem Sie das Labor wechseln, weil Quest den Test als „Hemoglobin A1c" bezeichnet, während LabCorp ihn als „HbA1c (%)" bezeichnet — und jedes Tool, das exakte Zeichenfolgen statt semantischer Bedeutung abgleicht, erzeugt leere Zellen, sobald es mit Ihrem zweiten Anbieter in Kontakt kommt.
- ImageToTable.ai liest Laborwerte, indem es versteht, was jeder Testname bedeutet, unabhängig von der Bezeichnungskonvention — „HbA1c (%)", „A1C" und „Glykohämoglobin" landen alle in derselben Spalte, und Ihre Rolle verschiebt sich vom erneuten Eintippen von Zahlen hin zum Überprüfen.
Warum Patienten Laborergebnisse weiterhin von Hand abtippen
Die Excel-Vorlage der CLL Society ist kein Einzelfall. Die Barth-Syndrom-Stiftung stellt ebenfalls eine eigene Tabelle zur Erfassung von Laborwerten bereit, mit Hinweisen, die den Aufwand anerkennen: „Führen Sie eine Tabelle mit Laborergebnissen, die nach Datum und Ergebnis gefiltert werden kann." Die Quantified-Self-Community auf Reddits r/QuantifiedSelf fragt regelmäßig nach Tools, die Bluttest-Trends im Zeitverlauf darstellen können. Patientengemeinschaften, Fürsprecher für chronische Erkrankungen und gesundheitsbewusste Menschen kommen alle zum selben Arbeitsablauf: PDF vom Labor holen, neben einer Tabelle öffnen und abtippen. Das ist universell, weil es die einzige kostenlose Option ist.
Das Problem ist nicht die Tabelle – die Tabelle funktioniert einwandfrei. Das Problem ist das, was zwischen PDF und Tabelle liegt: ein Mensch, der Werte von einer Seite abliest und in Zellen tippt. Für einen Patienten, der fünf Biomarker bei vierteljährlichen Blutentnahmen verfolgt, sind das 20 Werte pro Jahr. Das Abtippen dauert zwei Minuten pro Bericht. Die eigentliche Frustration ist nicht die Zeit – es ist die Tatsache, dass die Daten bereits digital sind. Das Labor hat sie von einer Maschine erzeugt. Sie wurden an eine Datenbank übertragen, in einen Bericht formatiert und als PDF per E-Mail versendet. Der einzige nicht-digitale Schritt in der gesamten Kette ist der, bei dem Sie die Daten vom PDF in Ihre Nachverfolgungstabelle übertragen.
Aber diesen Schritt zu automatisieren ist schwieriger als es scheint, denn Laborberichte sind keine Rechnungen.
Eine Rechnung von Anbieter A und eine Rechnung von Anbieter B haben beide Positionen, Summen und Daten – ihre Struktur ist weitgehend ähnlich. Ein Laborbericht von Quest Diagnostics und ein Laborbericht eines örtlichen Krankenhauses haben fast keine gemeinsame strukturelle DNA. Der Testname könnte in Spalte 1 oder Zeile 3 stehen. Der Wert könnte neben dem Namen oder darunter stehen. Der Referenzbereich könnte in Klammern in derselben Zeile oder in einer separaten Spalte drei Zentimeter rechts stehen. Und die Bezeichnung für Hämoglobin A1c könnte „Hemoglobin A1c", „HbA1c", „A1C" oder „Glycohemoglobin" lauten – alles in derselben Stadt, alles für denselben Test.
Was Sie tatsächlich verfolgen – Testname, Wert, Einheit, Referenzbereich
Ein Laborbericht enthält mehr Informationen, als Sie benötigen. Patientendaten, behandelnder Arzt, Zeitpunkt der Probenentnahme, Laborakkreditierung, Methodenhinweise – all das ist für die Integrität des Berichts relevant, aber nicht für eine persönliche Tracking-Tabelle. Was Sie interessiert, passt in fünf Spalten:
Testdatum | Testname | Ergebniswert | Einheit | ReferenzbereichJedes andere Feld im Bericht – die Adresse des Patienten, die CLIA-Nummer des Labors, die Initialen des durchführenden Technologen – ist für Tracking-Zwecke Rauschen. Die fünf Spalten oben sind das Signal. Und die am schwierigsten zuverlässig zu extrahierende ist Testname, weil verschiedene Labore denselben Test unterschiedlich beschreiben.
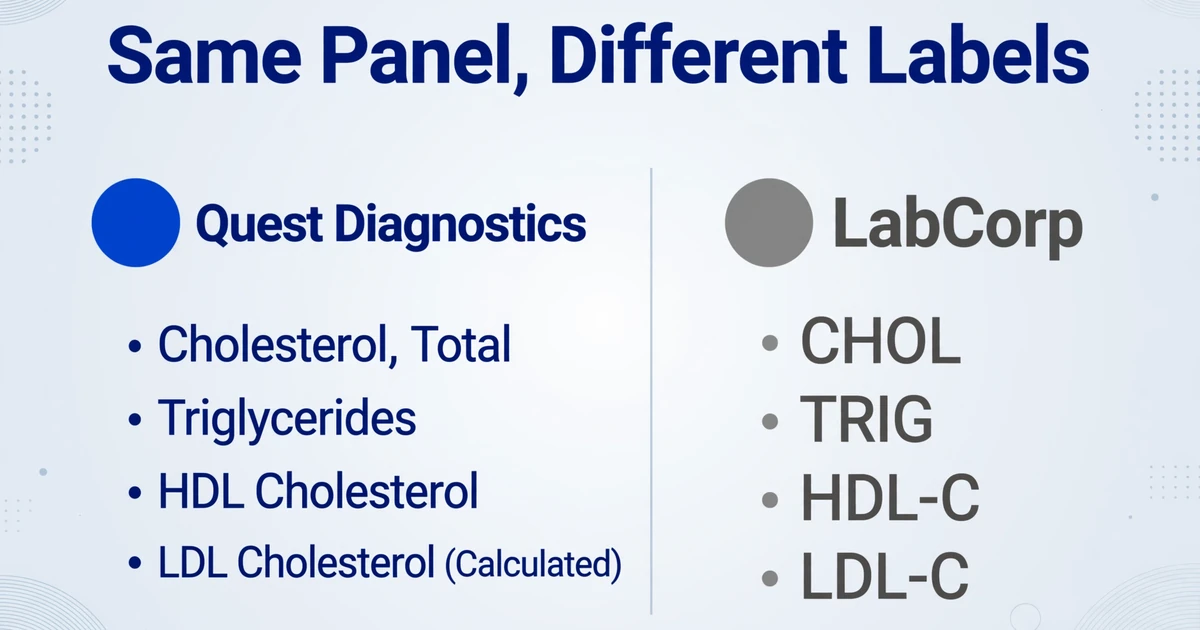
Ein Lipidprofil bei Quest Diagnostics listet „Cholesterol, Total“, „Triglycerides“, „HDL Cholesterol“ und „LDL Cholesterol (Calculated)“ auf. Dasselbe Profil bei LabCorp könnte „CHOL“, „TRIG“, „HDL-C“ und „LDL-C“ auflisten. Ein Krankenhauslabor könnte sie als „Total Cholesterol“, „Triglyceride“, „HDL“ und „LDL“ drucken. Die Werte sind dieselben Zahlen. Die Beschriftungen sind unterschiedliche Zeichenfolgen. Ein vorlagenbasiertes Extraktionstool, das versucht, „Cholesterol, Total“ in einem LabCorp-Bericht zu finden, liefert nichts – weil „CHOL“ für eine Vorlage nicht „Cholesterol, Total“ ist. Es ist nur für jemanden dasselbe, der versteht, was beide Beschriftungen bedeuten.
Dies ist die Kernherausforderung, die erklärt, warum Patientengemeinschaften immer noch manuelle Excel-Vorlagen verteilen. Wenn automatisierte Extraktion mit vorhandenen kostenlosen Tools einfach wäre, würde die CLL Society auf eines verlinken, anstatt eine Tabelle zu verteilen, die Patienten zum Eintippen auffordert.
So liest die Spaltennamens-Extraktion jedes Laborformat
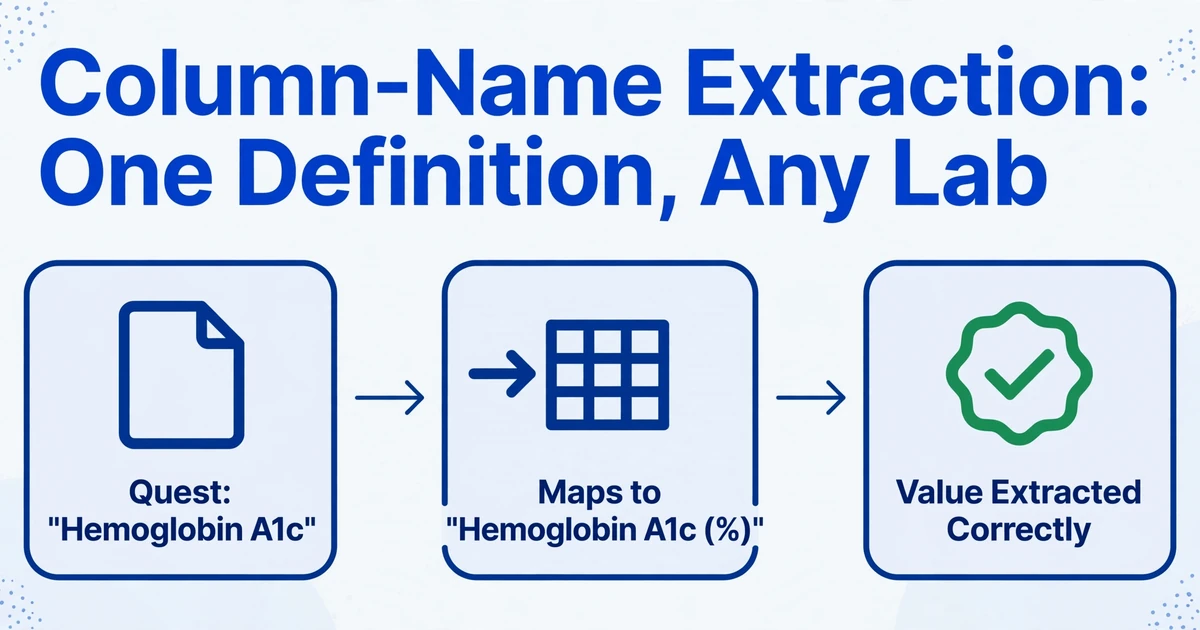
Der Ansatz, der bei verschiedenen Laborberichten funktioniert, ist die Spaltennamens-Extraktion: Statt dem Tool zu sagen, wo jeder Wert auf der Seite steht, sagen Sie ihm, welche Informationen Sie möchten, und es findet die passenden Daten, indem es versteht, was die Bezeichnungen bedeuten. Sie geben die Spaltennamen in das Tool ein – dieselben Spaltennamen, die später Ihre Tabellenkopfzeilen werden:
Test Date  |  Hemoglobin A1c (%)  |  Fasting Glucose (mg/dL)
Total Cholesterol (mg/dL)  |  HDL Cholesterol (mg/dL)  |  LDL Cholesterol (mg/dL)
Triglycerides (mg/dL)  |  TSH (mIU/L)  |  Vitamin D (ng/mL)
Wenn die KI einen Quest-Bericht verarbeitet, sieht sie „Hemoglobin A1c" in der linken Spalte und extrahiert den entsprechenden Wert. Bei einem LabCorp-Bericht sieht sie „HbA1c (%)" – anderer Text, gleiche Bedeutung – und ordnet ihn derselben Spalte zu. Bei einem Krankenhausbericht, der den Test als „糖化血红蛋白" (auf Chinesisch) bezeichnet, versteht die KI die semantische Gleichwertigkeit. Der von Ihnen definierte Spaltenname ist die kanonische Bezeichnung, und die KI übernimmt die Zuordnung, unabhängig davon, wie jedes Labor den Begriff formuliert.
Das ist das Gegenteil der vorlagenbasierten Extraktion, bei der Sie für jedes Labor-Layout eine separate Vorlage konfigurieren müssten. Es ist auch das Gegenteil von roher OCR, die Ihnen den gesamten Text der Seite liefert, ohne Verständnis dafür, welche Zahl zu welchem Test gehört. Die Spaltennamens-Extraktion liefert Ihnen genau die Werte, die Sie angefordert haben, organisiert in genau die Spalten, die Sie benannt haben.
Die Ausgabe erfolgt als Excel-Datei, wobei jede Zeile einen Bericht darstellt – eine Blutentnahme, ein Datum – und jede Spalte einen Biomarker. Sortieren Sie nach Datum, um Ihren HbA1c-Trend über sechs Monate zu sehen. Erstellen Sie ein Liniendiagramm aus der Total-Cholesterol-Spalte. Markieren Sie Werte außerhalb des Referenzbereichs mit einer Regel für die bedingte Formatierung. Die Tabelle ist ab dem Moment ihrer Erstellung für die Analyse strukturiert, nicht erst nach einer Stunde Neuformatierung.
Für Forscher, die mit EHR-Laborpanels in klinischen Studien arbeiten – einschließlich der Extraktion markierter Werte, der Disambiguierung von Mehrfachbesuchsdatensätzen und der Handhabung systemspezifischer Formatierungen – finden Sie in unserem Leitfaden Extraktion von Laborwerten aus EHR-Screenshots weitere Informationen. Wenn Sie mit gemischten Dokumenttypen in einer einzigen Studie arbeiten, behandelt die Extraktion von Variablen aus Radiologie-, Pathologie- und Entlassungsberichten, wie Sie mit Quellen aus mehreren Systemen umgehen. Das vollständige Playbook – Einheiten, Referenzbereiche, abnormale Kennzeichnungen und Batch-Verarbeitung im Klinikmaßstab – finden Sie in unserem vollständigen Leitfaden zur Labordaten-Extraktion. Wenn Sie Ergebnisse für viele Patienten gleichzeitig organisieren möchten, lesen Sie, wie kleine Kliniken Patientenlaborergebnisse im Batch organisieren.
Mehrere Berichte gleichzeitig verarbeiten – Ein Jahr Blutwerte in einem Batch
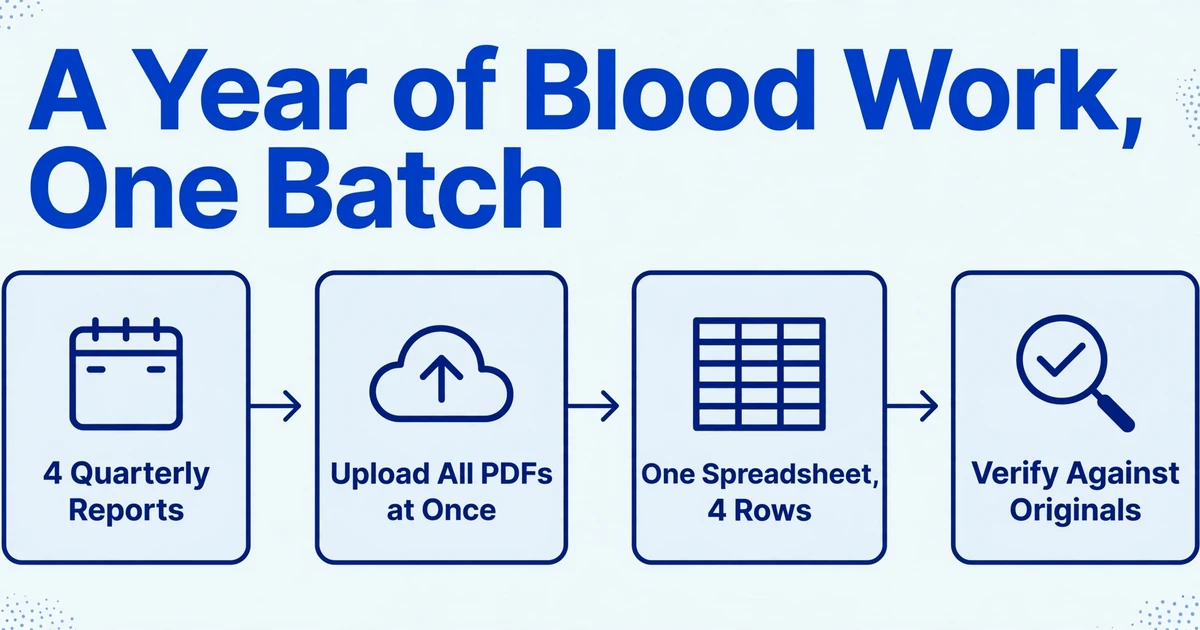
Der Ansatz mit Spaltennamen wird umso wertvoller, wenn Sie mehrere Berichte zusammen verarbeiten. Ein Patient mit einer chronischen Erkrankung hat möglicherweise drei oder vier Blutentnahmen pro Jahr, jeweils von einem anderen Labor oder einer anderen Filiale desselben Labornetzwerks. Die Berichte umfassen ein Jahr, lassen sich aber in einem einzigen Batch in wenigen Minuten verarbeiten.
Laden Sie alle vier Quartals-PDFs auf einmal hoch. Die KI liest jeden einzelnen unabhängig – den Quest-Bericht vom Januar, den LabCorp-Bericht vom April, den Krankenhauslabor-Bericht vom Juli, den Quest-Bericht vom Oktober – und ordnet jedes Ergebnis denselben Spalten zu. Das Ergebnis ist eine Tabelle mit vier Zeilen (eine pro Entnahmedatum) und so vielen Biomarker-Spalten, wie Sie definiert haben. Kein Ausschneiden und Einfügen zwischen Dateien. Kein Abgleichen unterschiedlicher Spaltenreihenfolgen. Die Extraktion übernimmt die Normalisierung.
Der Verifizierungsschritt ist hier wichtiger als bei den meisten Dokumenttypen. Ein falsch eingetippter Rechnungsbetrag ist ein Fehler von $50. Ein falsch eingetippter Laborwert könnte bedeuten, dass ein Trend übersehen wird, der eine Medikamentenanpassung rechtfertigt. Nach der Extraktion gleichen Sie die Tabelle mit den Original-PDFs ab – prüfen Sie, ob der HbA1c-Wert in der Tabelle mit dem Wert im Bericht übereinstimmt, ob die Einheit (%, mg/dL, mIU/L) korrekt ist und ob Werte nahe der Grenzen der Referenzbereiche nicht vertauscht wurden. Diese Verifizierung dauert weniger als eine Minute pro Bericht und ist der Punkt, an dem menschliches Urteilsvermögen in den Arbeitsablauf gehört. Die KI eliminiert das Tippen; die Verifizierung gewährleistet die Genauigkeit.
Was die KI mit Laborberichten kann und was nicht
Die Extraktion aus Laborberichten hat Grenzen, die klar benannt werden sollten.
Sie extrahiert Werte, keine Interpretationen. Die KI liest „TSH: 4,8 mIU/L“ und trägt 4,8 in die TSH-Spalte ein. Sie sagt Ihnen nicht, dass ein TSH von 4,8 grenzwertig hoch ist oder dass Ihr vorheriger Wert 2,1 war. Die Interpretation liegt bei Ihnen und Ihrem Arzt. Die Tabelle ist das Rohmaterial für diese Interpretation – einheitlich formatiert, genau übertragen, bereit für die Analyse.
Die Scanqualität beeinflusst die Genauigkeit. Ein gestochen scharfes PDF, das direkt aus dem LIS (Laborinformationssystem) des Labors erzeugt wurde, liefert eine sehr zuverlässige Extraktion. Ein gescannter Ausdruck – insbesondere einer, der gefaxt, gedruckt und erneut gescannt wurde – kann Artefakte erzeugen, die die Genauigkeit bei bestimmten Werten verringern. Am wahrscheinlichsten betroffen sind Zahlen mit Dezimalstellen (die zu Kommas verschwimmen können) und Werte in sehr kleiner Schrift (häufig bei dichten Stoffwechselprofilen). Wenn ein Wert bei der Überprüfung falsch aussieht, prüfen Sie ihn gegen das Original.
Es ersetzt nicht die Überprüfung durch Ihren Arzt. Laborwerte existieren im Kontext – Ihr Alter, Medikamente, Symptome und Ihre Krankengeschichte spielen alle eine Rolle dabei, was ein bestimmter Wert bedeutet. Extraktion gefolgt von Tabellen-Diagrammen ist eine Ergänzung zur medizinischen Versorgung, kein Ersatz dafür. Der Wert der automatisierten Verfolgung liegt darin, dass sie die Daten zwischen den Terminen zugänglich macht: Sie können einen Trend erkennen, bevor er zum Problem wird, und Sie können Daten – nicht Anekdoten – zu Ihrem nächsten Arztbesuch mitbringen.
FAQ
Kann die KI handschriftliche Notizen auf Laborberichten lesen?
Ja, innerhalb vernünftiger Grenzen. Wenn ein Arzt am Rand „Kontrolle in 3 Monaten“ notiert hat, kann die KI dies als separates Notizfeld extrahieren, wenn Sie eine Spalte dafür definieren. Aber handschriftliche Laborergebnisse – ein Bericht, der vollständig handschriftlich statt gedruckt ist – sind weniger zuverlässig als gedruckte Berichte. Das Vision-Modell liest Handschrift, aber die Genauigkeit hängt von der Lesbarkeit ab, und medizinische Handschrift ist nicht gerade für ihre Lesbarkeit bekannt. Bitten Sie Ihren Anbieter für Tracking-Zwecke wann immer möglich um eine gedruckte Kopie der Ergebnisse.
Brauche ich für verschiedene Labore unterschiedliche Spaltennamen?
Nein. Sie definieren die Spaltennamen einmal – „Hämoglobin A1c (%)“, „TSH (mIU/L)“, „Vitamin D (ng/mL)“ – und die KI ordnet die Bezeichnungen jedes Labors automatisch Ihren Spaltennamen zu. Der Spaltenname dient als kanonische Bezeichnung, und die KI übernimmt die Variationen, wie verschiedene Labore denselben Test beschreiben. Das bedeutet, Sie können jederzeit ein neues Labor oder ein neues Berichtsformat hinzufügen, ohne etwas neu konfigurieren zu müssen.
Was ist mit Laborergebnissen in anderen Sprachen als Englisch?
Die KI liest Laborberichte in jeder Sprache. Ein Krankenhausbericht auf Chinesisch, der „空腹血糖“ (Nüchternglukose) auflistet, wird der von Ihnen definierten Spalte „Nüchternglukose (mg/dL)“ zugeordnet. Die Extraktion normalisiert sprachübergreifend genauso wie sie verschiedene englische Abkürzungen normalisiert – indem sie versteht, was die Bezeichnung bedeutet, nicht indem sie die Zeichen abgleicht.
Kann ich Daten aus Laborberichten extrahieren, die Bilder statt PDFs sind?
Ja. Ein Foto eines gedruckten Laborberichts, aufgenommen mit dem Telefon – oder ein Screenshot von Patientenportal-Ergebnissen – wird genauso verarbeitet wie ein PDF. Das Vision-Modell liest Text direkt aus Bildern, ohne dass ein separater OCR-Schritt erforderlich ist. Für beste Ergebnisse fotografieren Sie den Bericht gerade und bei gutem Licht und stellen Sie sicher, dass die Werte klar sichtbar sind. Ein enger Zuschnitt auf den Ergebnisbereich hilft, ist aber nicht notwendig.
Ist das geeignet, um die Laborergebnisse eines Familienmitglieds zu verfolgen?
Ja. Wenn Sie die Gesundheitsversorgung für ein alterndes Elternteil oder ein Kind mit einer chronischen Erkrankung verwalten, gilt derselbe Arbeitsablauf: Labor-PDFs sammeln, die relevanten Biomarker definieren, Batch-Upload, und Sie erhalten eine Tracking-Tabelle. Die Spalte „Patientenname“ unterscheidet, wessen Ergebnisse wessen sind, wenn Berichte mehrerer Familienmitglieder zusammen verarbeitet werden. Für jeden, der schon einmal in der Praxis eines Spezialisten gesessen hat und versuchte, sich zu erinnern, ob das Kreatinin im letzten Jahr 1,1 oder 1,3 war, verändert eine Tabelle mit den tatsächlichen Werten – extrahiert, nicht erinnert – die Qualität des Gesprächs.