画像からExcelテーブル抽出
有効な方法と無効な方法
Microsoft Excelには2019年から「画像からデータ」機能があります。Google Sheetsは2023年に追加しました。それでも人々は代替手段を探し続けています。印刷された請求書、スキャンしたスプレッドシート、ウェブサイトのテーブルのスクリーンショットにスマートフォンを向けると、組み込みツールはきれいなデータよりも文字化けした出力を生むことが多いからです。問題は文字認識の精度ではありません。テーブル構造の問題です。枠線が薄く、列の間隔が不均一で、見出しが2行に折り返されている場合に、値がどのセルに属するかを判断することこそが課題なのです。
重要なポイント
- 文字化けしたテーブル抽出結果の原因は文字認識の精度ではありません。セルの境界を誤って認識すると、1文字も認識される前に、行全体のデータが誤った列に静かに流れ込んでしまいます。
- テーブル画像をExcelに変換するには、セルの境界の検出、内部のテキストの読み取り、数値が価格なのか数量なのかの判別という3つの処理を同時に行う必要があります。しかしOCR(Excelの組み込みツールの背後にあるピクセルからテキストへのエンジン)は中間のステップしか処理できず、構造的・意味的なエラーが静かに積み重なっていきます。
- ビジュアルLLM(画像を見てテキストも読むモデル)は、人間のようにこれら3つのレイヤーを同時に解きほぐします。これがImageToTable.aiが、OCRでは完全に破綻する枠線のないテーブルや斜めに撮影された写真から、使用可能なExcelデータを抽出できる理由です。
実際のテーブル画像で「Data from Picture」が失敗する理由
ExcelのData from Pictureは、画像をMicrosoftのクラウドOCRエンジンに送信し、テキストの識別とテーブル構造の推定を試みます。鮮明で完全に整列した、均一な照明下のきれいなスプレッドシートの印刷物の写真であれば、実用的な結果が得られるかもしれません。しかし、それ以外のすべて——そして実際の画像のほとんどは「それ以外」に該当します——では機能しなくなります。
根本的な問題はアーキテクチャにあります。Excelのこの機能は光学文字認識に基づいて構築されています。OCRは個々の文字とそのピクセル座標を識別し、ヒューリスティックなルールがテキストブロック間の空間的なギャップを分析してテーブル構造を推測します。これは本質的に脆弱です。わずかなカメラの角度でギャップの計算が狂います。スキャンしたページの折れた角は誤った列境界を作り出します。2列にまたがる結合セルは、グリッドの整列を完全に崩します。
Redditのr/excelフォーラムの経理担当者は、普遍的なフラストレーションを次のように述べています。Home DepotとLowe'sからの週15枚のレシートをExcelに入力する必要があるが、組み込みツールもQuickBooksのエクスポート形式も、独自の列を持つカスタムスプレッドシートというニーズを満たしてくれないのです。r/Accountingの会計士も、財務テーブルについて同じ質問をしました。「画像からExcelへ財務テーブルを変換する最良の無料OCRツールは?」——組み込みツールでは不十分なのです。
3つのレイヤー問題:ピクセル、文字、意味
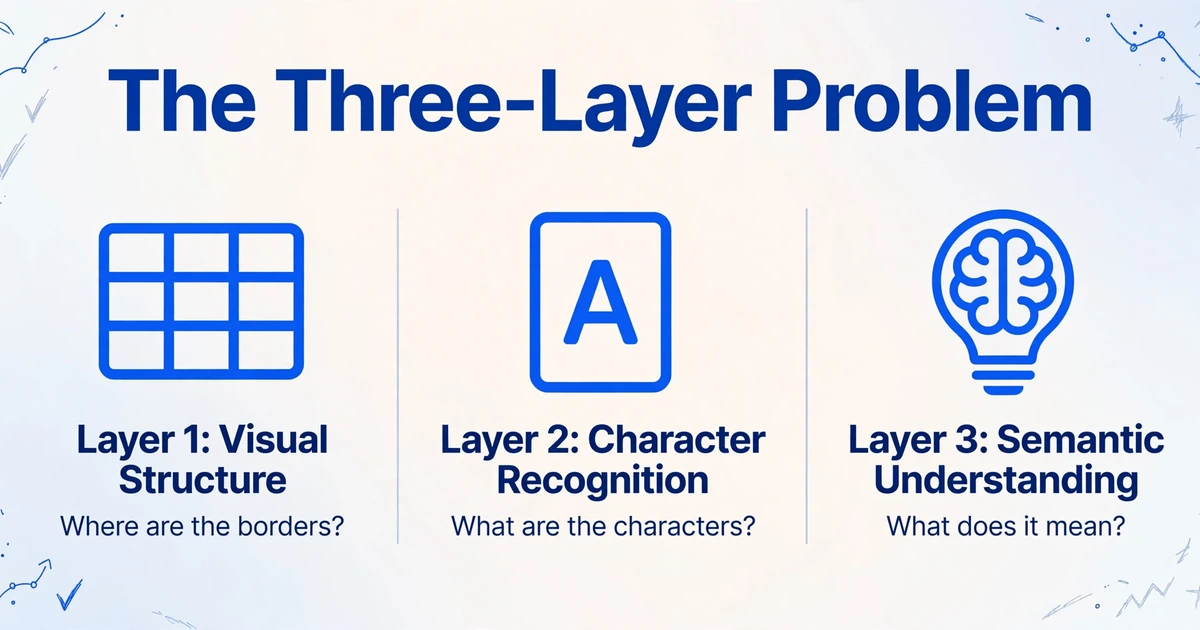
テーブル画像をExcelに変換することは、1つの問題ではありません。同時に解決すべき3つの問題であり、従来のOCRはそのうち中間の1つだけに対応しています。
レイヤー1 — 視覚構造。テーブルの境界線はどこにあるのか。どのセルが結合されているのか。列はどこで終わり、次の列はどこから始まるのか。これはテキストの問題ではなく、視覚の問題です。OCRエンジンは、文字のストロークよりも細い可能性のある構造線ではなく、背景に対するテキストのコントラストを探すため、薄いグリッドのテーブルを見逃すことがよくあります。
レイヤー2 — 文字認識。各セル内の実際の英数字は何か。従来のTesseractスタイルのOCRは、300 DPIのきれいな印刷物では十分に処理できますが、テキストが色付きの背景にある場合、フォントが小さい場合(密度の高いテーブルでよくある)、または画像がページ全体に焦点が均一でないスマートフォン写真の場合、精度は急激に低下します。
レイヤー3 — 意味理解。各値は実際には何を表しているのか。3列目の「1,250」は数量か、単価か、それとも行の合計か。OCRはそれを教えてくれません。文字は読めても、意味は読めないのです。しかし、これこそが必要なものです。ある請求書の「Amount」という列と、別の請求書の「Total Due」という列には同じ種類のデータが含まれており、スプレッドシートではそれらを同じ列に配置する必要があります。
各レイヤーが独立して失敗するということは、3つの独立したエラー要因があるということです。レイヤー1がセル境界を誤読すると、隣接するセルの値が結合されます。レイヤー2が密度の高い数値セル内の「5」を「6」と誤読すると、照合するまでエラーは正しく見えます。レイヤー3が単価と行合計を区別できない場合、抽出されたデータは構造的に間違っています。従来のOCRはレイヤー2のみに対応しており、それも不完全です。
ビジュアルLLMが3つのレイヤーすべてを同時に解決する仕組み
ビジュアル大規模言語モデルは、人間と同じようにドキュメントを処理します。ページ全体を俯瞰し、文脈の中でテキストを読み取り、各値の意味を理解します。3つのレイヤーは受け渡しのある別々のパイプラインではなく、各レイヤーが互いに情報を補完しながら、まとめて処理されます。
これこそが重要なアーキテクチャの転換です。ビジュアルLLMがOCRでは見逃すようなかすかな表の境界線に遭遇すると、セマンティックレイヤーが不整合を検出します。「これは価格のような数値で、互いに関連しないため、2つの別々の列のように見える」と。ビジュアルレイヤーがその領域を再調査し、微妙な線を検出します。テキストレイヤーは、両側の文字列が異なるカテゴリ(製品名と金額)に属することを確認します。3つのレイヤーが相互参照し、正しい構造が浮かび上がります。
この相互参照こそが、ビジュアルLLMが従来のOCRを打ち負かす画像を処理できる理由です。グリッド線がアンチエイリアス処理で消えてしまった低解像度のスクリーンショット、斜めから撮影された印刷スプレッドシートの写真、エッジ検出を妨げる斑点のある背景のスキャン文書などです。モデルは単一のシグナルに依存するのではなく、視覚的・テキスト的・セマンティックな証拠を組み合わせています。
テーブル画像から名前付き列へ:実際に重要な出力
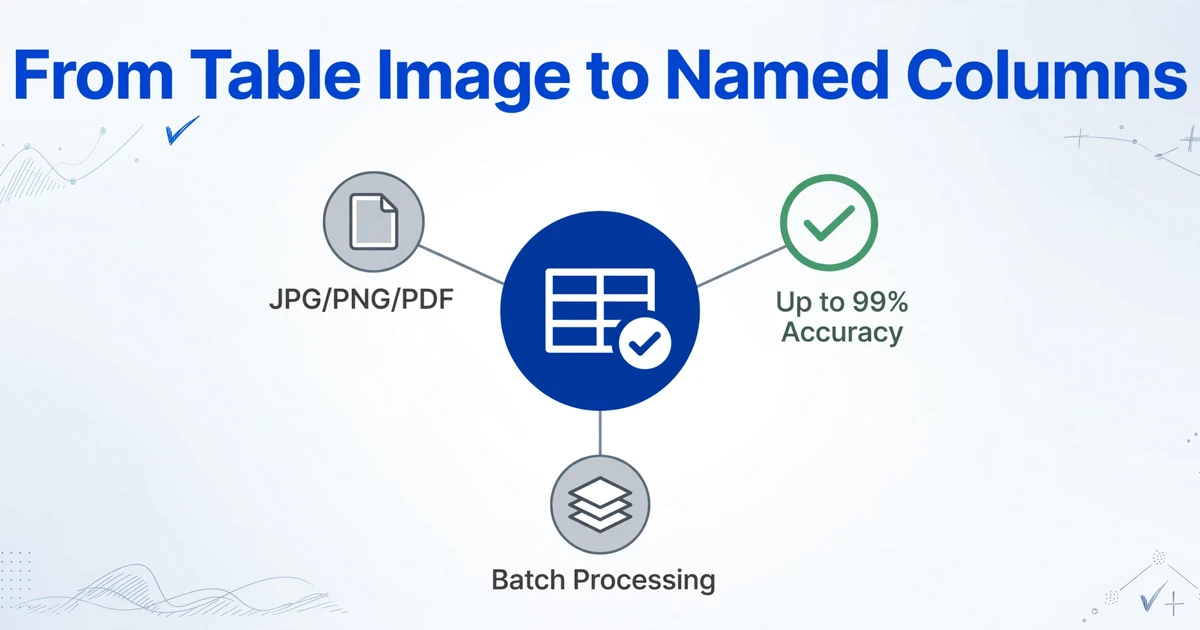
テーブル全体の抽出は最初のステップにすぎません。人々が実際に必要とする出力は、処理するすべての画像で一貫した、ワークフローに関連する特定の列です。
ImageToTable.aiは列名抽出を通じてこれにアプローチします。「テーブルを抽出」と言って列が揃うことを期待する代わりに、必要な列(「日付」「説明」「金額」「カテゴリ」)を指定すると、AIがページ上の位置ではなく意味を理解して各値を特定します。「金額」列は、ある請求書では3番目の列、別の請求書では5番目の列、さらに別の請求書では「合計請求額」とラベル付けされているかもしれません。ビジュアルLLMはピクセル位置ではなくセマンティックな役割でそれを識別します。
ファイルは安全に処理され、保存されることはありません。
この列名アプローチはバッチ処理も可能にします。異なるソースから50枚のテーブル画像をアップロードし、列を一度指定するだけで、一貫したヘッダーを持つ1つの結合スプレッドシートが得られます。処理は1ページあたり5〜10秒かかり、画像品質が良好な場合、印刷されたテーブルデータに対して最大99%の精度を達成します。制限要因はAIではなく、ソース画像の物理的な状態です。
これが実際に重要となる場面
財務チームがベンダー明細を照合する場面。各ベンダーは異なるレイアウトのPDF明細を送ってきますが、照合に必要なのは日付、参照番号、金額の3列だけです。30件の明細を手動でコピー&ペーストすると午後いっぱいかかります。画像から列へのバッチ抽出は数分で完了します。
研究者が公開論文からデータをまとめる場面。学術論文、業界レポート、政府データセットのテーブルのスクリーンショットはすべて異なる形式です。必要なデータポイント(サンプルサイズ、効果量、p値)はすべてのソースで同じです。列名抽出により、これらを分析可能な1つのスプレッドシートに標準化します。
運用チームが配送マニフェストからデータを抽出する場面。配送伝票、梱包リスト、貨物請求書の写真は、異なる運送会社から異なるレイアウトで届きます。必要な列は一貫しています:追跡番号、重量、個数、仕向地。AIは形式に関係なくこれらを読み取ります。
FAQ
これは単に高性能なOCRではないのですか?
いいえ。OCRはピクセルから文字を読み取ります。ビジュアルLLMはドキュメントの構造とコンテンツの意味を理解します。その違いはエッジケースで顕著になります:OCRが誤って分割する結合セル、OCRがまったく検出できない境界線のないテーブル、文脈が解釈を左右する数値などです。ビジュアルLLMは同じ画像を見て、あなたと同じように理解します。つまり、値の集まりがその位置、書式、周囲の数値との関係から小計を形成していることを認識するのです。
抽出精度はどのくらいですか?
鮮明で明るい画像の印刷された表データでは、最大99%の精度を実現します。精度は画像品質に依存します。傾いたり影が入ったりした暗い場所でのスマホ写真は、300 DPIのフラットベッドスキャンよりも精度が低くなります。手書きの内容はさらに精度を下げますが、セマンティックレイヤーがOCRでは完全に見逃すギャップを補完するのに役立ちます。
複数の画像を1つのスプレッドシートに処理できますか?
はい。複数の画像をまとめてアップロードし、列名を一度指定するだけで、AIがすべての画像からデータを抽出し、一貫した列ヘッダーを持つ1つの結合されたExcelファイルにまとめます。処理速度は1ページあたり5〜10秒で、バッチ出力は定義した列構造を保持します。
対応している画像形式とソースは何ですか?
このツールはJPG、PNG、WebP、AVIF、PDF、およびウェブページのスクリーンショットに対応しています。形式よりもソースの方が重要です。明るい場所で撮影された鮮明な写真は最良の結果をもたらしますが、ぎらつきのあるしわくちゃのページを傾いて撮影した写真は、形式に関係なく精度が低くなります。
試すにはどうすればよいですか?
表の画像をアップロードし、必要な列に名前を付けると、AIがデータを抽出します。無料プランは時々の利用に対応し、有料プランは定期的なバッチ処理に対応します。画像からExcelテーブルへの変換ツールは、上記で説明したのと同じビジュアルLLMアーキテクチャに基づいて構築されています。あらゆる画像形式で、文字だけでなくテーブル構造も読み取ります。