Extraction de tableaux d'images vers Excel
Ce qui fonctionne et ce qui ne fonctionne pas
Microsoft Excel dispose d'une fonctionnalité « Données à partir d'une image » depuis 2019. Google Sheets l'a ajoutée en 2023. Pourtant, les utilisateurs continuent de chercher des alternatives — car lorsque vous pointez votre téléphone vers une facture imprimée, une feuille de calcul scannée ou une capture d'écran d'un tableau sur un site web, les outils intégrés produisent plus souvent des résultats brouillés que des données propres. L'échec ne vient pas de la précision de la reconnaissance des caractères. Il vient de la structure du tableau : savoir à quelle cellule appartient une valeur lorsque les bordures sont faibles, que les colonnes sont espacées de manière inégale et que les en-têtes s'étendent sur deux lignes.
Points clés à retenir
- Vos résultats d'extraction de tableaux brouillés ne proviennent pas d'une reconnaissance de caractères imprécise — chaque limite de cellule mal détectée fait silencieusement basculer des lignes entières de données dans de mauvaises colonnes avant même qu'un seul caractère soit reconnu.
- Convertir une image de tableau en Excel nécessite trois opérations simultanées — détecter les limites des cellules, lire le texte à l'intérieur et savoir si un nombre est un prix ou une quantité — mais l'OCR (le moteur pixel-texte derrière l'outil intégré d'Excel) ne gère que l'étape intermédiaire, laissant les erreurs structurelles et sémantiques s'accumuler silencieusement.
- Un LLM visuel — un modèle qui voit à la fois l'image et lit le texte — démêle les trois couches simultanément comme le ferait une personne, c'est ainsi qu'ImageToTable.ai extrait des données Excel exploitables à partir de tableaux sans bordures et de photos inclinées qui brisent complètement l'OCR.
Pourquoi « Données à partir d'une image » échoue sur les vraies images de tableaux
La fonctionnalité Données à partir d'une image d'Excel fonctionne en envoyant votre image au moteur OCR cloud de Microsoft, qui tente d'identifier le texte et d'approximer la structure du tableau. Pour une photo nette et parfaitement alignée d'un document imprimé propre sous un éclairage uniforme, elle peut produire des résultats utilisables. Pour tout le reste — et la plupart des images réelles entrent dans cette catégorie — elle échoue.
Le problème fondamental est architectural : la fonctionnalité d'Excel repose sur la reconnaissance optique de caractères. L'OCR identifie les caractères individuels et leurs coordonnées en pixels, puis des règles heuristiques devinent la structure du tableau en analysant les espaces entre les blocs de texte. C'est fondamentalement fragile. Un léger angle de caméra fausse le calcul des espaces. Un coin plié sur une page scannée crée une fausse limite de colonne. Une cellule fusionnée couvrant deux colonnes brise complètement l'alignement de la grille.
Un charpentier sur le forum r/excel de Reddit a exprimé la frustration universelle : il doit saisir 15 reçus par semaine de Home Depot et Lowe's dans Excel, et ni l'outil intégré ni le format d'export de QuickBooks ne lui donnent ce dont il a besoin — une feuille de calcul personnalisée avec ses propres colonnes. Un comptable sur r/Accounting a posé la même question à propos des tableaux financiers : « meilleur outil OCR gratuit pour convertir des tableaux financiers d'images vers Excel » — les outils intégrés ne suffisent pas.
Le problème en trois couches : pixels, caractères et sens
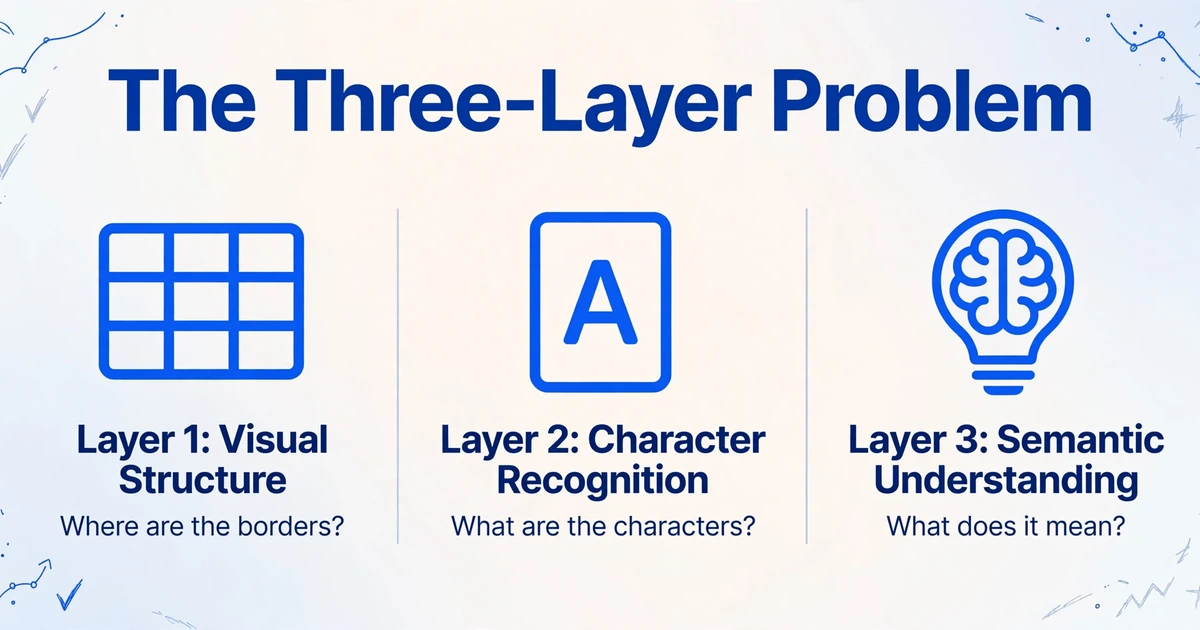
Convertir une image de tableau en Excel n'est pas un seul problème. C'est trois problèmes à résoudre simultanément, et l'OCR traditionnel n'en traite que celui du milieu.
Couche 1 — Structure visuelle. Où se trouvent les bordures du tableau ? Quelles cellules sont fusionnées ? Où une colonne se termine-t-elle et où la suivante commence-t-elle ? C'est un problème de vision, pas un problème de texte. Les moteurs OCR ignorent souvent entièrement les tableaux à grille légère, car ils recherchent un contraste de texte sur un fond, et non des lignes structurelles qui peuvent être plus fines que les traits des caractères.
Couche 2 — Reconnaissance des caractères. Quels sont les caractères alphanumériques réels dans chaque cellule ? L'OCR traditionnel de type Tesseract gère correctement les impressions nettes à 300 DPI, mais la précision chute fortement lorsque le texte se trouve sur un fond coloré, lorsque les polices sont petites (courant dans les tableaux denses), ou lorsque l'image est une photo de téléphone avec une mise au point inégale sur la page.
Couche 3 — Compréhension sémantique. Que représente réellement chaque valeur ? Le « 1 250 » dans la troisième colonne est-il une quantité, un prix unitaire ou un total de ligne ? L'OCR ne peut pas vous le dire. Il lit des caractères, pas le sens. C'est pourtant exactement ce dont vous avez besoin : la colonne intitulée « Montant » sur une facture et « Total dû » sur une autre contiennent le même type de données, et votre feuille de calcul doit les placer dans la même colonne.
Chaque couche qui échoue indépendamment représente trois sources d'erreur distinctes. Si la couche 1 lit mal une limite de cellule, les valeurs des cellules adjacentes sont fusionnées. Si la couche 2 lit un « 5 » comme un « 6 » dans une cellule numérique dense, l'erreur semble correcte jusqu'à la réconciliation. Si la couche 3 ne peut pas distinguer un prix unitaire d'un total de ligne, les données extraites sont structurellement erronées. L'OCR traditionnel ne traite que la couche 2 — et encore, imparfaitement.
Comment les LLM visuels résolvent les trois couches simultanément
Les grands modèles de langage visuels traitent les documents comme le ferait une personne : ils regardent la page dans son ensemble, lisent le texte en contexte et comprennent la signification de chaque valeur. Les trois couches ne sont pas des pipelines distincts avec une transmission entre eux — elles sont traitées ensemble, chaque couche informant les autres.
C'est ce changement architectural qui compte. Lorsqu'un LLM visuel rencontre une bordure de tableau pâle que l'OCR manquerait, la couche sémantique signale l'incohérence : « Cela ressemble à deux colonnes distinctes car les valeurs sont des nombres de type prix qui n'appartiennent pas au même ensemble. » La couche visuelle réexamine la zone et détecte la ligne subtile. La couche textuelle confirme que les chaînes de caractères de chaque côté proviennent de catégories différentes (nom de produit vs montant en dollars). Les trois couches se recoupent, et la structure correcte émerge.
C'est ce recoupement qui permet aux LLM visuels de traiter les images qui déroutent l'OCR traditionnel : des captures d'écran basse résolution où les lignes de grille ont été lissées jusqu'à disparaître, des photos de feuilles de calcul imprimées prises en biais, des documents numérisés avec des fonds tachetés qui perturbent la détection des contours. Le modèle ne s'appuie sur aucun signal unique — il combine des preuves visuelles, textuelles et sémantiques.
De l'image de tableau aux colonnes nommées : le résultat qui compte vraiment
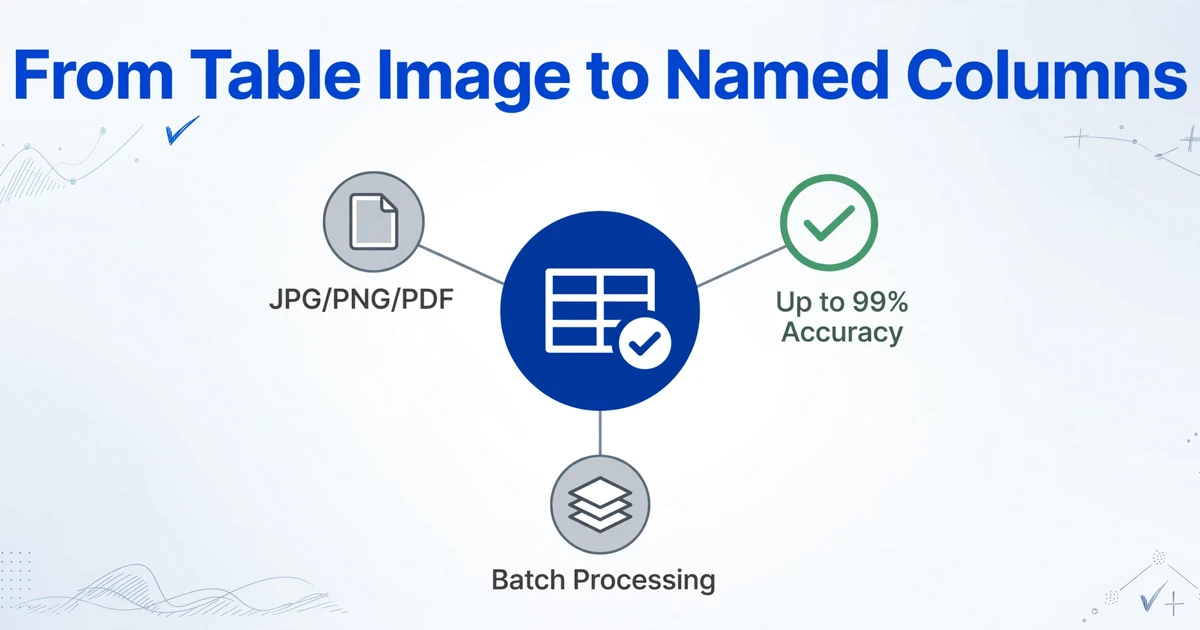
Extraire l'intégralité du tableau n'est que la première étape. Le résultat dont les utilisateurs ont réellement besoin, ce sont des colonnes spécifiques — celles qui sont pertinentes pour leur flux de travail — cohérentes sur chaque image qu'ils traitent.
ImageToTable.ai aborde cela par l'extraction de noms de colonnes : au lieu de dire « extraire le tableau » en espérant que les colonnes s'alignent, vous nommez les colonnes souhaitées — « Date », « Description », « Montant », « Catégorie » — et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non où elle se trouve sur la page. Une colonne « Montant » peut être la troisième colonne sur une facture, la cinquième sur une autre, et étiquetée « Total dû » sur une troisième. Le LLM visuel l'identifie par son rôle sémantique, et non par sa position en pixels.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Cette approche par noms de colonnes permet également le traitement par lots : téléchargez 50 images de tableaux provenant de sources différentes, spécifiez vos colonnes une seule fois, et obtenez une feuille de calcul fusionnée avec des en-têtes cohérents. Le traitement prend de 5 à 10 secondes par page, avec une précision allant jusqu'à 99 % sur les données de tableaux imprimés lorsque la qualité de l'image est raisonnable. Le facteur limitant n'est pas l'IA — c'est l'état physique de l'image source.
Où cela compte vraiment
Les équipes financières qui rapprochent les relevés fournisseurs. Chaque fournisseur envoie un relevé PDF avec une mise en page différente, mais le rapprochement ne nécessite que trois colonnes : Date, Numéro de référence et Montant. Le copier-coller manuel sur 30 relevés prend un après-midi entier. L'extraction par lots d'images vers colonnes prend quelques minutes.
Les chercheurs qui compilent des données issues d'articles publiés. Les captures d'écran de tableaux provenant d'articles académiques, de rapports sectoriels et de jeux de données gouvernementaux ont tous des formats différents. Les points de données nécessaires — taille de l'échantillon, taille de l'effet, valeur p — sont les mêmes pour toutes les sources. L'extraction par noms de colonnes les standardise en une seule feuille de calcul prête pour l'analyse.
Les équipes opérationnelles qui extraient des données de manifestes d'expédition. Les photos de bons de livraison, de listes de colisage et de factures de fret proviennent de différents transporteurs avec des mises en page différentes. Les colonnes nécessaires sont cohérentes : Numéro de suivi, Poids, Pièces, Destination. L'IA les lit quel que soit le format.
FAQ
N'est-ce pas simplement une meilleure OCR ?
Non. L'OCR lit les caractères à partir des pixels. Les LLM visuels comprennent la structure du document et le sens du contenu. La différence apparaît dans les cas limites : les cellules fusionnées que l'OCR divise incorrectement, les tableaux sans bordures visibles que l'OCR ne peut pas détecter du tout, et les valeurs numériques dont l'interprétation dépend du contexte. Un LLM visuel regarde la même image et la comprend comme vous le feriez — en reconnaissant que ce groupe de valeurs forme un sous-total en raison de sa position, de son formatage et de sa relation avec les nombres environnants.
Quelle est la précision de l'extraction ?
Jusqu'à 99 % sur des données de tableaux imprimés avec une image claire et bien éclairée. La précision diminue avec la qualité de l'image — une photo de téléphone inclinée et ombragée dans une lumière tamisée produira une précision inférieure à celle d'un scan à plat à 300 DPI. Le contenu manuscrit réduit encore la précision, bien que la couche sémantique aide à combler les lacunes que l'OCR manquerait entièrement.
Puis-je traiter plusieurs images en un seul tableur ?
Oui. Téléchargez plusieurs images ensemble, spécifiez vos noms de colonnes une fois, et l'IA extrait les données de chaque image dans un seul fichier Excel fusionné avec des en-têtes de colonnes cohérents. La vitesse de traitement est de 5 à 10 secondes par page, et la sortie du lot préserve la structure de colonnes que vous avez définie.
Quels formats et sources d'images fonctionnent ?
L'outil accepte JPG, PNG, WebP, AVIF, PDF et les captures d'écran de pages web. La source importe plus que le format : une photo plate bien éclairée produit les meilleurs résultats ; une photo inclinée d'une page froissée avec des reflets produit une précision inférieure quel que soit le format.
Comment puis-je essayer ceci ?
Téléchargez une image d'un tableau, nommez les colonnes souhaitées, et l'IA extrait les données. Le niveau gratuit couvre une utilisation occasionnelle ; les forfaits payants gèrent le traitement par lots régulier. Le convertisseur d'image en tableau Excel est construit sur la même architecture de LLM visuel décrite ci-dessus — il lit la structure du tableau, pas seulement les caractères, quel que soit le format d'image.