Extração de Tabelas de Imagem para Excel
O Que Funciona e o Que Não Funciona
O Microsoft Excel tem um recurso "Data from Picture" desde 2019. O Google Sheets adicionou isso em 2023. Mesmo assim, as pessoas continuam procurando alternativas — porque quando você aponta o celular para uma fatura impressa, uma planilha digitalizada ou uma captura de tela de uma tabela em um site, as ferramentas integradas produzem resultados distorcidos com mais frequência do que dados limpos. A falha não está na precisão do reconhecimento de caracteres. Está na estrutura da tabela: saber a qual célula um valor pertence quando as bordas estão apagadas, as colunas estão espaçadas de forma irregular e os cabeçalhos se estendem por duas linhas.
Principais Conclusões
- Seus resultados distorcidos de extração de tabelas não vêm de um reconhecimento de caracteres descuidado — cada limite de célula lido incorretamente despeja silenciosamente linhas inteiras de dados em colunas erradas antes mesmo de um único caractere ser reconhecido.
- Converter uma imagem de tabela para Excel exige três coisas ao mesmo tempo — detectar os limites das células, ler o texto dentro delas e saber se um número é um preço ou uma quantidade — mas o OCR (o mecanismo de pixel para texto por trás da ferramenta integrada do Excel) só lida com a etapa intermediária, deixando erros estruturais e semânticos se acumularem silenciosamente.
- Um LLM visual — um modelo que tanto vê a imagem quanto lê o texto — desembaraça as três camadas simultaneamente, como uma pessoa faria, e é assim que o ImageToTable.ai extrai dados utilizáveis do Excel a partir de tabelas sem bordas e fotos angulares que quebram o OCR por completo.
Por que o "Data from Picture" falha em imagens reais de tabelas
O Data from Picture do Excel funciona enviando sua imagem para o mecanismo de OCR em nuvem da Microsoft, que tenta identificar texto e aproximar a estrutura da tabela. Para uma foto nítida e perfeitamente alinhada de uma impressão limpa de planilha sob iluminação uniforme, ele pode produzir resultados utilizáveis. Para todo o resto — e a maioria das imagens do mundo real se enquadra em "todo o resto" — ele falha.
A causa raiz é arquitetural: o recurso do Excel é construído sobre reconhecimento óptico de caracteres. O OCR identifica caracteres individuais e suas coordenadas de pixel; em seguida, regras heurísticas tentam adivinhar a estrutura da tabela analisando lacunas espaciais entre blocos de texto. Isso é fundamentalmente frágil. Um leve ângulo de câmera distorce o cálculo das lacunas. Um canto dobrado em uma página escaneada cria uma falsa borda de coluna. Uma célula mesclada que abrange duas colunas quebra completamente o alinhamento da grade.
Um marceneiro no fórum r/excel do Reddit capturou a frustração universal: ele tem 15 recibos por semana da Home Depot e da Lowe's para inserir no Excel, e nem a ferramenta integrada nem o formato de exportação do QuickBooks lhe dão o que ele precisa — uma planilha personalizada com suas próprias colunas. Um contador no r/Accounting fez a mesma pergunta sobre tabelas financeiras: "melhor ferramenta gratuita de OCR para converter tabelas financeiras de imagens para Excel" — as ferramentas integradas não são suficientes.
O Problema em Três Camadas: Pixels, Caracteres e Significado
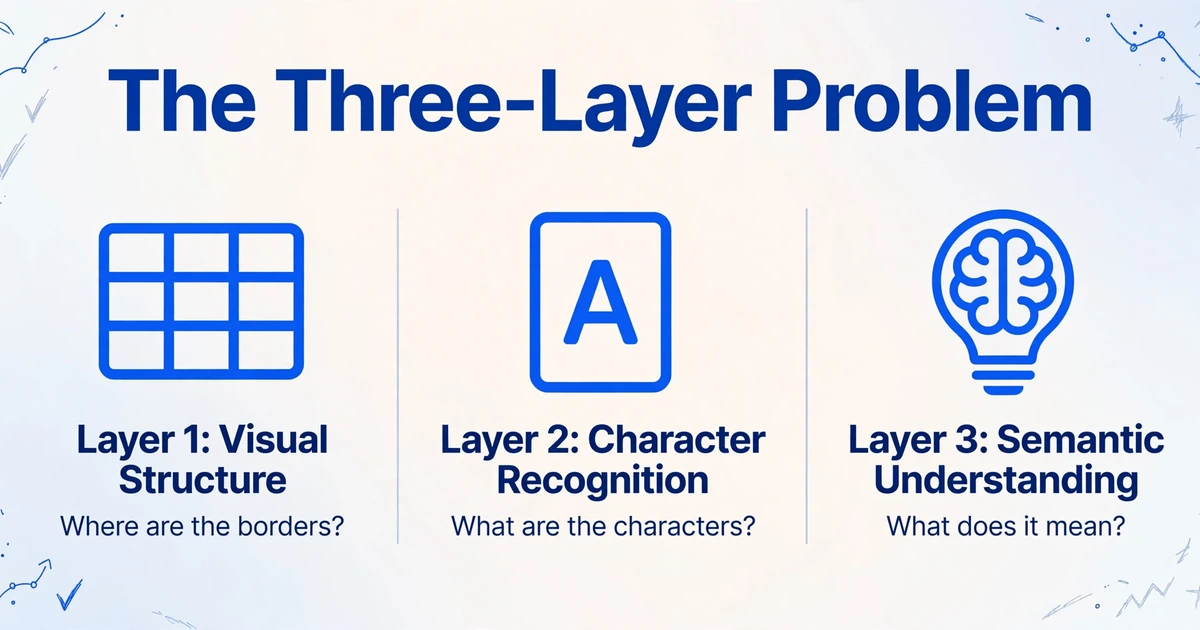
Converter uma imagem de tabela para o Excel não é um problema. São três problemas que precisam ser resolvidos simultaneamente, e o OCR tradicional aborda apenas o do meio.
Camada 1 — Estrutura visual. Onde estão as bordas da tabela? Quais células estão mescladas? Onde uma coluna termina e a próxima começa? Este é um problema de visão, não de texto. Os mecanismos de OCR frequentemente não detectam tabelas com grade leve porque procuram contraste de texto contra um fundo, não linhas estruturais que podem ser mais finas que os traços dos caracteres.
Camada 2 — Reconhecimento de caracteres. Quais são os caracteres alfanuméricos reais em cada célula? O OCR tradicional estilo Tesseract lida adequadamente com impressões limpas a 300 DPI, mas a precisão cai drasticamente quando o texto está sobre um fundo colorido, quando as fontes são pequenas (comum em tabelas densas) ou quando a imagem é uma foto de celular com foco irregular na página.
Camada 3 — Compreensão semântica. O que cada valor realmente representa? "1.250" na terceira coluna é uma quantidade, um preço unitário ou um total da linha? O OCR não consegue dizer. Ele lê caracteres, não significado. No entanto, é exatamente isso que você precisa — a coluna rotulada como "Amount" em uma fatura e "Total Due" em outra contêm o mesmo tipo de dados, e sua planilha precisa deles na mesma coluna.
Cada camada falhando de forma independente significa três fontes independentes de erro. Se a camada 1 interpretar mal um limite de célula, valores de células adjacentes serão mesclados. Se a camada 2 interpretar um "5" como "6" dentro de uma célula numérica densa, o erro parece correto até você reconciliar. Se a camada 3 não conseguir distinguir um preço unitário de um total de linha, os dados extraídos estarão estruturalmente errados. O OCR tradicional aborda apenas a camada 2 — e mesmo assim, de forma imperfeita.
Como os LLMs visuais resolvem as três camadas simultaneamente
Os grandes modelos de linguagem visuais processam documentos da mesma forma que uma pessoa: eles olham a página de forma holística, leem o texto no contexto e entendem o que cada valor significa. As três camadas não são pipelines separados com uma transferência entre eles — elas são processadas juntas, com cada camada informando as outras.
Essa é a mudança arquitetural que importa. Quando um LLM visual encontra uma borda de tabela apagada que o OCR não detectaria, a camada semântica sinaliza a inconsistência: "Isso parece duas colunas separadas porque os valores são números parecidos com preços que não pertencem juntos." A camada visual reexamina a área e detecta a linha sutil. A camada de texto confirma que as strings de cada lado são de categorias diferentes (nome do produto vs. valor em dólar). As três camadas fazem referência cruzada, e a estrutura correta emerge.
Essa referência cruzada é o motivo pelo qual os LLMs visuais lidam com as imagens que derrotam o OCR tradicional: capturas de tela de baixa resolução onde as linhas de grade foram suavizadas até desaparecerem, fotos de planilhas impressas tiradas em ângulo, documentos digitalizados com fundos manchados que confundem a detecção de bordas. O modelo não depende de um único sinal — ele combina evidências visuais, textuais e semânticas.
Da imagem da tabela a colunas nomeadas: a saída que realmente importa
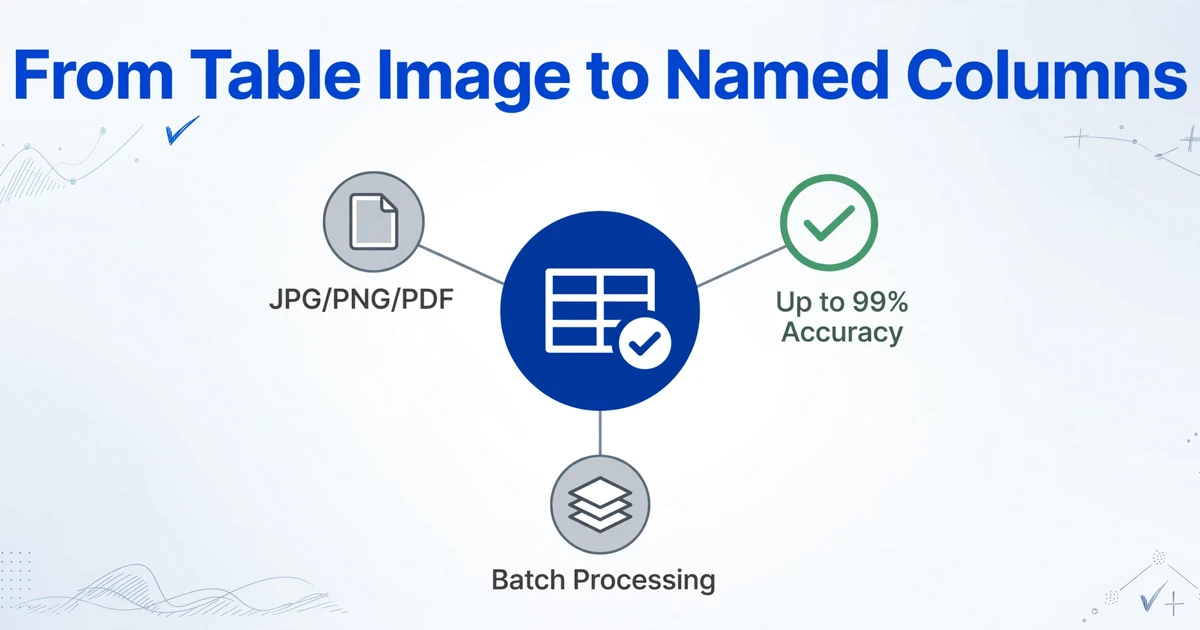
Extrair a tabela inteira é apenas o primeiro passo. A saída que as pessoas realmente precisam são colunas específicas — as relevantes para o fluxo de trabalho delas — consistentes em cada imagem que processam.
O ImageToTable.ai aborda isso por meio da extração de nomes de colunas: em vez de dizer "extraia a tabela" e torcer para as colunas se alinharem, você nomeia as colunas que deseja — "Data", "Descrição", "Valor", "Categoria" — e a IA localiza cada valor entendendo o que ele significa, não onde está na página. Uma coluna "Valor" pode ser a terceira coluna em uma fatura, a quinta em outra e rotulada como "Total a Pagar" em uma terceira. O LLM visual a identifica pelo papel semântico, não pela posição do pixel.
Os arquivos são processados com segurança e não são armazenados.
Essa abordagem baseada em nomes de colunas também permite o processamento em lote: envie 50 imagens de tabelas de fontes diferentes, especifique suas colunas uma vez e obtenha uma planilha mesclada com cabeçalhos consistentes. O processamento leva de 5 a 10 segundos por página, com até 99% de precisão em dados de tabelas impressas quando a qualidade da imagem é razoable. O fator limitante não é a IA — é a condição física da imagem de origem.
Onde Isso Realmente Importa
Equipes de finanças que reconciliam declaraciones de proveedores. Cada provedor envia um estado de conta em PDF com um layout diferente, mas a reconciliação só precisa de três colunas: Data, Número de Referência e Monto. Copiar e colar manualmente em 30 estados de conta leva uma tarde inteira. A extração de colunas de imagens em lote leva minutos.
Pesquisadores que compilam dados de artigos publicados. Capturas de tabelas de artigos acadêmicos, informes do setor e conjuntos de dados governamentais têm todos formatos diferentes. Os pontos de dados necessários — tamanho da muestra, tamanho do efeito, valor p — são os mesmos em todas as fontes. A extração por nome de coluna os estandariza em uma planilha pronta para análise.
Equipes de operações que extraem de manifestos de embarque. Fotos de recibos de entrega, listas de embalaje e facturas de frete vêm de diferentes transportadoras com layouts diferentes. As colunas necessárias são consistentes: Número de Rastreo, Peso, Piezas, Destino. A IA os lê independentemente do formato.
FAQ
Isso não é apenas um OCR melhor?
No. O OCR lê caracteres de pixels. Os LLMs visuais entendem a estrutura do documento e o significado do conteúdo. A diferença se mostra em casos extremos: células mescladas que o OCR divide incorretamente, tabelas sem bordes visibles que o OCR não pode detectar, e valores numéricos onde o contexto determina a interpretação. Um LLM visual olha a mesma imagem e a entende como você faría — reconhecendo que este grupo de valores forma um subtotal por sua posição, formato e relação com os números ao redor.
Qual é a precisão da extração?
Até 99% em dados de tabelas impressas com uma imagem clara e bem iluminada. A precisão diminui com a qualidade da imagem — uma foto de celular inclinada, com sombras e pouca luz produzirá menor precisão do que um scan de mesa a 300 DPI. Conteúdo manuscrito reduz ainda mais a precisão, embora a camada semântica ajude a preencher lacunas que o OCR deixaria passar completamente.
Posso processar várias imagens em uma única planilha?
Sim. Envie várias imagens juntas, especifique os nomes das colunas uma vez, e a IA extrai dados de cada imagem em um único arquivo Excel mesclado com cabeçalhos de coluna consistentes. A velocidade de processamento é de 5 a 10 segundos por página, e a saída do lote preserva a estrutura de colunas que você definiu.
Quais formatos de imagem e fontes funcionam?
A ferramenta aceita JPG, PNG, WebP, AVIF, PDF e capturas de tela de páginas web. A fonte importa mais do que o formato: uma foto plana e bem iluminada produz os melhores resultados; uma foto inclinada de uma página amassada com reflexos produz menor precisão, independentemente do formato.
Como posso testar isso?
Envie uma imagem de uma tabela, nomeie as colunas que deseja, e a IA extrai os dados. O plano gratuito cobre uso ocasional; planos pagos lidam com processamento regular em lote. O conversor de imagem para tabela Excel é construído sobre a mesma arquitetura de LLM visual descrita acima — ele lê a estrutura da tabela, não apenas caracteres, em qualquer formato de imagem.