Extracción de tablas de imagen a Excel
Qué funciona y qué no
Microsoft Excel tiene una función de "Datos desde imagen" desde 2019. Google Sheets la añadió en 2023. Aun así, la gente sigue buscando alternativas, porque cuando apunta su teléfono a una factura impresa, una hoja de cálculo escaneada o una captura de pantalla de una tabla en un sitio web, las herramientas integradas producen resultados distorsionados más a menudo que datos limpios. El fallo no se trata de la precisión del reconocimiento de caracteres. Se trata de la estructura de la tabla: saber a qué celda pertenece un valor cuando los bordes son tenues, las columnas están espaciadas de forma desigual y los encabezados se envuelven en dos líneas.
Conclusiones clave
- Sus resultados de extracción de tablas distorsionados no se deben a un reconocimiento de caracteres descuidado: cada límite de celda mal leído vierte silenciosamente filas enteras de datos en columnas equivocadas antes de que se reconozca un solo carácter.
- Convertir una imagen de tabla a Excel requiere hacer tres cosas a la vez: detectar los límites de las celdas, leer el texto dentro y saber si un número es un precio o una cantidad; pero el OCR (el motor de píxel a texto detrás de la herramienta integrada de Excel) solo maneja el paso intermedio, dejando que los errores estructurales y semánticos se acumulen silenciosamente.
- Un LLM visual —un modelo que tanto ve la imagen como lee el texto— desenreda las tres capas simultáneamente como lo haría una persona, que es como ImageToTable.ai extrae datos de Excel utilizables de tablas sin bordes y fotos en ángulo que rompen el OCR por completo.
Por qué «Datos desde imagen» falla con imágenes de tablas reales
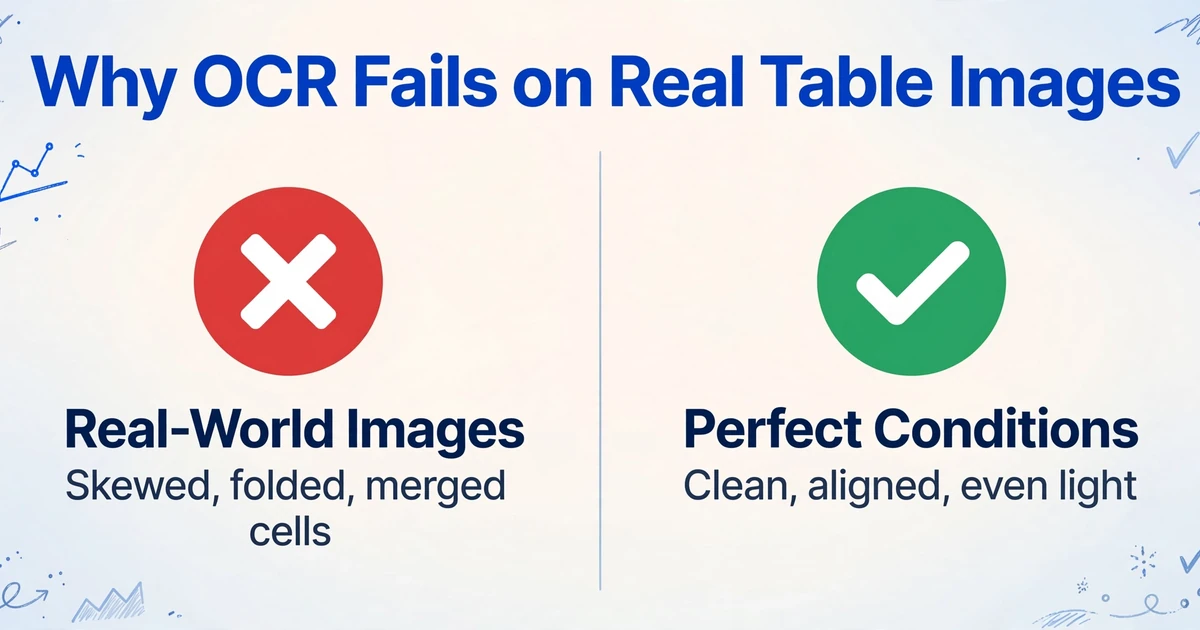
La función Datos desde imagen de Excel funciona enviando su imagen al motor de OCR en la nube de Microsoft, que intenta identificar texto y aproximar la estructura de la tabla. Para una foto nítida y perfectamente alineada de una hoja de cálculo limpia impresa con iluminación uniforme, podría producir resultados utilizables. Para todo lo demás — y la mayoría de las imágenes del mundo real entran en «todo lo demás» — falla.
El problema de raíz es arquitectónico: la función de Excel se basa en el reconocimiento óptico de caracteres. El OCR identifica caracteres individuales y sus coordenadas de píxeles, y luego reglas heurísticas adivinan la estructura de la tabla analizando los espacios entre bloques de texto. Esto es fundamentalmente frágil. Un ligero ángulo de cámara distorsiona el cálculo de los espacios. Una esquina doblada en una página escaneada crea un límite de columna falso. Una celda combinada que abarca dos columnas rompe por completo la alineación de la cuadrícula.
Un carpintero en el foro r/excel de Reddit capturó la frustración universal: tiene que ingresar 15 recibos a la semana de Home Depot y Lowe's en Excel, y ni la herramienta integrada ni el formato de exportación de QuickBooks le dan lo que necesita: una hoja de cálculo personalizada con sus propias columnas. Un contador en r/Accounting hizo la misma pregunta sobre tablas financieras: «mejor herramienta OCR gratuita para convertir tablas financieras de imágenes a Excel» — las herramientas integradas no son suficientes.
El problema de las tres capas: píxeles, caracteres y significado
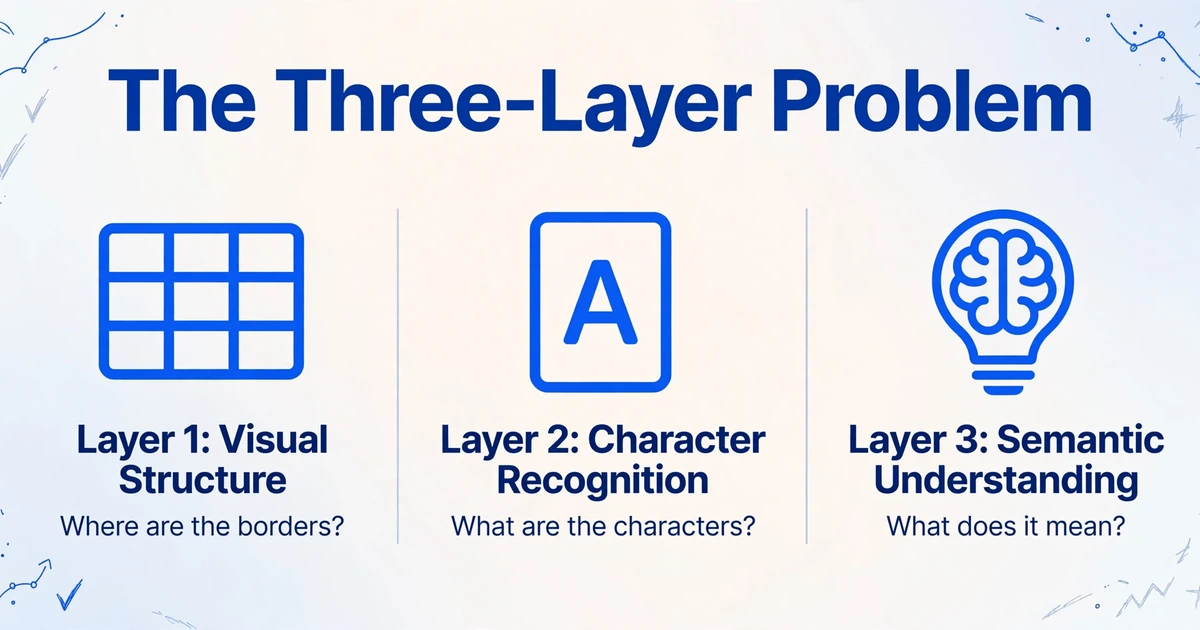
Convertir una imagen de tabla a Excel no es un solo problema. Son tres problemas que deben resolverse simultáneamente, y el OCR tradicional solo aborda el del medio.
Capa 1 — Estructura visual. ¿Dónde están los bordes de la tabla? ¿Qué celdas están combinadas? ¿Dónde termina una columna y comienza la siguiente? Este es un problema de visión, no de texto. Los motores de OCR a menudo pasan por alto las tablas de cuadrícula clara porque buscan contraste de texto sobre un fondo, no líneas estructurales que pueden ser más delgadas que los trazos de los caracteres.
Capa 2 — Reconocimiento de caracteres. ¿Cuáles son los caracteres alfanuméricos reales en cada celda? El OCR tradicional estilo Tesseract maneja esto adecuadamente para impresiones limpias a 300 DPI, pero la precisión cae drásticamente cuando el texto está sobre un fondo de color, cuando las fuentes son pequeñas (común en tablas densas), o cuando la imagen es una foto de teléfono con enfoque desigual en la página.
Capa 3 — Comprensión semántica. ¿Qué representa realmente cada valor? ¿"1,250" en la tercera columna es una cantidad, un precio unitario o un total de línea? El OCR no puede decírselo. Lee caracteres, no significado. Sin embargo, esto es exactamente lo que usted necesita: la columna etiquetada "Monto" en una factura y "Total a pagar" en otra contienen el mismo tipo de datos, y su hoja de cálculo los necesita en la misma columna.
Que cada capa falle de forma independiente significa tres fuentes independientes de error. Si la capa 1 lee mal un límite de celda, los valores de celdas adyacentes se combinan. Si la capa 2 lee mal un "5" como "6" dentro de una celda numérica densa, el error parece correcto hasta que concilia. Si la capa 3 no puede distinguir un precio unitario de un total de línea, los datos extraídos son estructuralmente incorrectos. El OCR tradicional aborda solo la capa 2 — e incluso entonces, de manera imperfecta.
Cómo los LLM visuales resuelven las tres capas simultáneamente
Los grandes modelos de lenguaje visuales procesan los documentos de la misma manera que una persona: observan la página de forma holística, leen el texto en contexto y entienden qué significa cada valor. Las tres capas no son procesos separados con una transferencia entre ellos — se procesan juntos, y cada capa informa a las demás.
Este es el cambio arquitectónico que importa. Cuando un LLM visual encuentra un borde de tabla tenue que el OCR pasaría por alto, la capa semántica señala la inconsistencia: "Esto parece dos columnas separadas porque los valores son números similares a precios que no pertenecen juntos". La capa visual reexamina el área y detecta la línea sutil. La capa de texto confirma que las cadenas a cada lado pertenecen a categorías diferentes (nombre de producto vs. monto en dólares). Las tres capas se contrastan entre sí y surge la estructura correcta.
Esta contrastación es la razón por la que los LLM visuales manejan las imágenes que derrotan al OCR tradicional: capturas de baja resolución donde las líneas de cuadrícula se han suavizado hasta desaparecer, fotos de hojas de cálculo impresas tomadas en ángulo, documentos escaneados con fondos moteados que confunden la detección de bordes. El modelo no depende de una sola señal — combina evidencia visual, textual y semántica.
De la imagen de tabla a columnas con nombre: el resultado que realmente importa
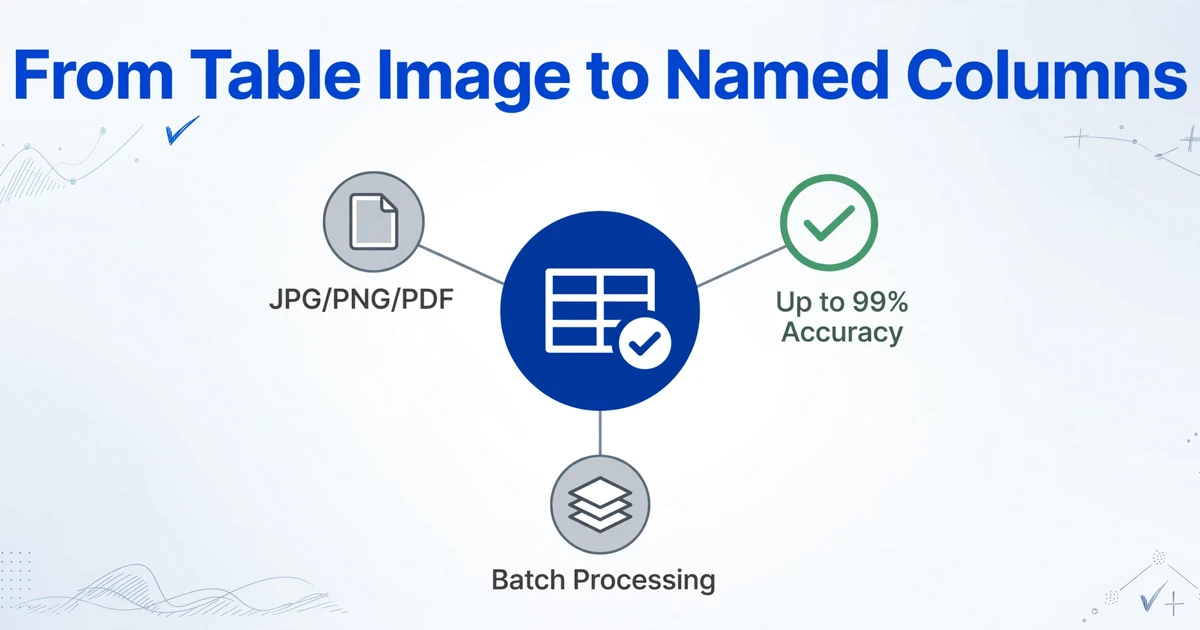
Extraer la tabla completa es solo el primer paso. El resultado que la gente realmente necesita son columnas específicas — las relevantes para su flujo de trabajo — consistentes en cada imagen que procesan.
ImageToTable.ai aborda esto mediante la extracción de nombres de columnas: en lugar de decir "extrae la tabla" y esperar que las columnas coincidan, usted nombra las columnas que desea — "Fecha", "Descripción", "Monto", "Categoría" — y la IA localiza cada valor entendiendo qué significa, no dónde se encuentra en la página. Una columna "Monto" podría ser la tercera columna en una factura, la quinta en otra, y estar etiquetada como "Total a pagar" en una tercera. El LLM visual la identifica por su rol semántico, no por su posición de píxeles.
Los archivos se procesan de forma segura y no se almacenan.
Este enfoque basado en nombres de columna también permite el procesamiento por lotes: suba 50 imágenes de tablas de diferentes fuentes, especifique sus columnas una vez y obtenga una hoja de cálculo combinada con encabezados consistentes. El procesamiento toma de 5 a 10 segundos por página, con hasta un 99% de precisión en datos tabulares impresos cuando la calidad de la imagen es razonable. El factor limitante no es la IA, sino la condición física de la imagen de origen.
Dónde Esto Realmente Importa
Equipos de finanzas que concilian estados de cuenta de proveedores. Cada proveedor envía un estado de cuenta en PDF con un diseño diferente, pero la conciliación solo necesita tres columnas: Fecha, Número de Referencia y Monto. Copiar y pegar manualmente entre 30 estados de cuenta toma una tarde completa. La extracción por lotes de imágenes a columnas toma minutos.
Investigadores que compilan datos de artículos publicados. Las capturas de pantalla de tablas de artículos académicos, informes de la industria y conjuntos de datos gubernamentales tienen diferentes formatos. Los puntos de datos necesarios — tamaño de muestra, tamaño del efecto, valor p — son los mismos en todas las fuentes. La extracción por nombre de columna los estandariza en una sola hoja de cálculo lista para analizar.
Equipos de operaciones que extraen datos de manifiestos de envío. Las fotos de albaranes, listas de empaque y facturas de flete provienen de diferentes transportistas con diferentes diseños. Las columnas necesarias son consistentes: Número de Seguimiento, Peso, Piezas, Destino. La IA las lee independientemente del formato.
Preguntas Frecuentes
¿No es esto simplemente un mejor OCR?
No. El OCR lee caracteres de los píxeles. Los LLM visuales entienden la estructura del documento y el significado del contenido. La diferencia se nota en casos límite: celdas combinadas que el OCR divide incorrectamente, tablas sin bordes visibles que el OCR no puede detectar en absoluto, y valores numéricos donde el contexto determina la interpretación. Un LLM visual observa la misma imagen y la entiende como lo haría usted, reconociendo que este grupo de valores forma un subtotal por su posición, formato y relación con los números circundantes.
¿Qué tan precisa es la extracción?
Hasta un 99 % en datos de tablas impresas con una imagen clara y bien iluminada. La precisión disminuye con la calidad de la imagen: una foto de teléfono inclinada, con sombras y poca luz producirá una precisión menor que un escaneo de cama plana a 300 DPI. El contenido manuscrito reduce aún más la precisión, aunque la capa semántica ayuda a llenar los vacíos que el OCR pasaría por alto por completo.
¿Puedo procesar varias imágenes en una sola hoja de cálculo?
Sí. Suba varias imágenes juntas, especifique los nombres de sus columnas una vez, y la IA extrae los datos de cada imagen en un único archivo de Excel fusionado con encabezados de columna coherentes. La velocidad de procesamiento es de 5 a 10 segundos por página, y el resultado del lote conserva la estructura de columnas que usted definió.
¿Qué formatos y fuentes de imagen funcionan?
La herramienta acepta JPG, PNG, WebP, AVIF, PDF y capturas de pantalla de páginas web. La fuente importa más que el formato: una foto plana y bien iluminada produce los mejores resultados; una foto inclinada de una página arrugada con reflejos produce una precisión menor independientemente del formato.
¿Cómo pruebo esto?
Suba una imagen de una tabla, nombre las columnas que desee, y la IA extrae los datos. El nivel gratuito cubre un uso ocasional; los planes de pago manejan el procesamiento regular por lotes. El conversor de imagen a tabla de Excel está construido sobre la misma arquitectura de LLM visual descrita anteriormente: lee la estructura de la tabla, no solo los caracteres, en cualquier formato de imagen.