手書きOCRの完全ガイド
&データ抽出(2026)
市場の平均的な手書きOCRツールの精度は64%です。つまり、処理するすべての文書で3文字に1文字が誤って認識されることを意味します。一方、トップクラスのAIビジョンモデルは読みやすい手書き文字で85〜95%の精度を達成し、最良のモデルは標準ベンチマークで文字誤り率2%未満を記録しています。64%と95%の差は、チューニングの違いではありません。それは、使えない出力と本番運用可能なワークフローの違いであり、処理する文書タイプ、文書の状態、選択するツールに完全に依存します。このガイドでは、これらの変数を文書タイプごとに詳しく解説し、ベンダーの最良条件のデモではなく、実際の書類に基づいて判断できるようにします。
重要ポイント
- 市場の平均的な手書きOCRツールの精度は64%です。筆記体では単語誤り率95%にまで低下し、意味を理解する前に100語中95語を誤認識します。
- 従来のOCRが手書き文字で機能しないのは、精度の問題ではなく、文字単位で読み取るためです。筆記体には文字間に区切りがないため、最初の文字を照合する前に構造的に破綻します。
- AIビジョンモデルは、顔を認識するのと同じように単語全体を視覚パターンとして読み取り、読みやすい手書き文字で85〜95%の精度を達成します。また、同じ列定義が、活字、筆記体、または同一ページ内での混在のいずれにも、書き手ごとのトレーニングなしで機能します。
手書きデータ抽出が今重要な理由
手書きは特殊なケースではありません。建設、物流、フィールドサービス、ヘルスケア、公益事業において、手書き文書は日常の運用システムです。現場監督は雨の中でクリップボードに現場日誌を記入します。配達ドライバーは納品書に署名を集め、不足数量をメモします。検針員は紙のフォームに80件の検針値を記録します。看護師は患者受け入れシートにチェックを入れ、走り書きのメモを残します。これらはまれな文書ではなく、現場集約型産業のコアデータパイプラインであり、そのデータのほとんどは今でも誰かが手で再入力することでバックエンドシステムに入っています。
2026年の転換点は、AIビジョンモデルが手書きを十分に読み取れるようになり、抽出—単なる文字起こしではなく、スプレッドシートの列への構造化されたフィールドレベルの抽出—が幅広い実世界の文書で実用可能になったことです。IAM Handwriting Databaseベンチマーク(657人の異なる筆者による13,353行のテキスト行)では、最新モデルは現在2%未満の文字誤り率を達成しています(codesota.com、2026年4月)。現代のAI手書き文字認識が実際に何ができるかについての詳細は、AI手書き文字認識とは何か、従来のOCRとどう違うかに関する記事をご覧ください。
この変化を可能にしたのは、従来のOCRへの漸進的な改善ではなく、機械が読む方法の完全なアーキテクチャ変更でした。それがあなたの文書にとってなぜ重要なのかを理解するには、なぜ手書きがそれ以前のあらゆるアプローチを壊してしまったのかを理解する必要があります。
手書きが機械にとって独特に難しい理由
スキャナーアプリで手書きフォームを読み取らせて、完全な意味不明な文字列が返ってきた経験があれば、その結果はすでにご存じでしょう。あまり明らかでないのは、手書き文書の5つの特定の特性が、なぜそれらを印刷文書と根本的に異なるものにしているのか、そしてなぜ各特性が抽出エンジンに異なる能力を要求するのかということです。
筆記体:文字分割の問題
従来のOCRは、テキストを個々の文字に分割して読み取ります。グリフ間の空白ギャップを見つけ、それぞれをバウンディングボックスに分離し、フォントテンプレートライブラリと照合します。筆記体は文字を意図的に連結させます。「charge」という単語の「a」と「r」の間にはギャップがありません。文字照合が始まる前に分割ステップが失敗します。連結した筆記体では、従来のOCRの単語誤り率は95%を超えます。つまり、100語中95語を誤認識します(codesota.com、2026年ベンチマーク)。AIビジョンモデルはこれを完全に回避します。個々の特徴をカタログ化せずに友人の顔を認識するのと同じように、単語全体を視覚パターンとして読み取ります。このアーキテクチャ上の違いが重要な理由について詳しくは、手書き文字認識の仕組みと、AIが従来のOCRに勝る理由をお読みください。
同一ページ内の活字と筆記体の混在
実際の手書き文書のほとんどは両方を組み合わせています。印刷済みの配送伝票フォームには、型印刷されたフィールドラベル(「顧客名:」「注文番号:」)があり、その横に手書きの値が記入されます。印刷された請求書には、欄外に手書きの配送指示が走り書きされています。点検チェックリストには、型印刷された質問と手書きのチェックマークやコメントがあります。抽出エンジンは両方のテキストタイプを同時に処理する必要があります。さらに重要なのは、型印刷されたテキストが、隣接する手書きテキストを解釈するためのコンテキストを提供することを理解する必要があることです。「請求書番号」というラベルは、隣接する手書きフィールドに何が期待されるかをモデルに伝えます。
多様な筆記具
ボールペンは不安定な筆圧を生み出します。「5」が塊と別のダッシュに断片化することがあります。鉛筆は薄い黒鉛を残し、スキャナーは紙の質感と区別するのに苦労します。万年筆はフレックスによって可変のストローク幅を生み出します。均一な印刷フォントで訓練された従来のOCRエンジンは、これらのバリエーションを根本的に異なる文字として見ます。さまざまな筆記具にわたる数百万の筆記サンプルで訓練された最新のAIビジョンモデルは、表面レベルのバリエーションを抽象化し、基礎となる文字構造に焦点を当てます。
カーボンコピーと圧力転写文書
カーボンコピー形式の帳票 — 最上段の用紙に書くと下の複写用紙に圧力が転写される多層紙 — は、建設業・貨物輸送・現場サービスで今も標準的に使われています。最上段のコピーは判読できるかもしれませんが、3枚目は黄色い用紙にかすんだ灰色の印影として届き、原本と比べてコントラストが40%低くなります。ボールペンの筆圧ムラによるインクの濃淡変化が加わることで、カーボンコピーは二重の劣化を起こし、鮮明な一次世代の手書き文字と比べて抽出精度が15〜25ポイント低下します。
現場の条件:汚れ、天候、摩耗
建設現場の日報は作業用手袋を着けた人が扱うため、用紙に汚れ・折り目・土が付着します。納品書はトラックのダッシュボードに置かれ、コーヒーの輪染みや日光による色あせが生じます。検針票は屋外の掲示板にクリップ留めされ、雨の跡が付きます。こうした条件はベンチマークデータセットには存在せず、すべてが抽出精度を低下させます。実際的な意味合いとして、クリーンな実験室サンプルで良好な性能を示す抽出ツールでも、実際の文書では失敗する可能性があります。ベンダー提供のサンプルではなく、自社の実際の書類でテストすることが唯一の信頼できる評価方法です。
従来のOCRとAIによる手書き文字の読み取りの違い
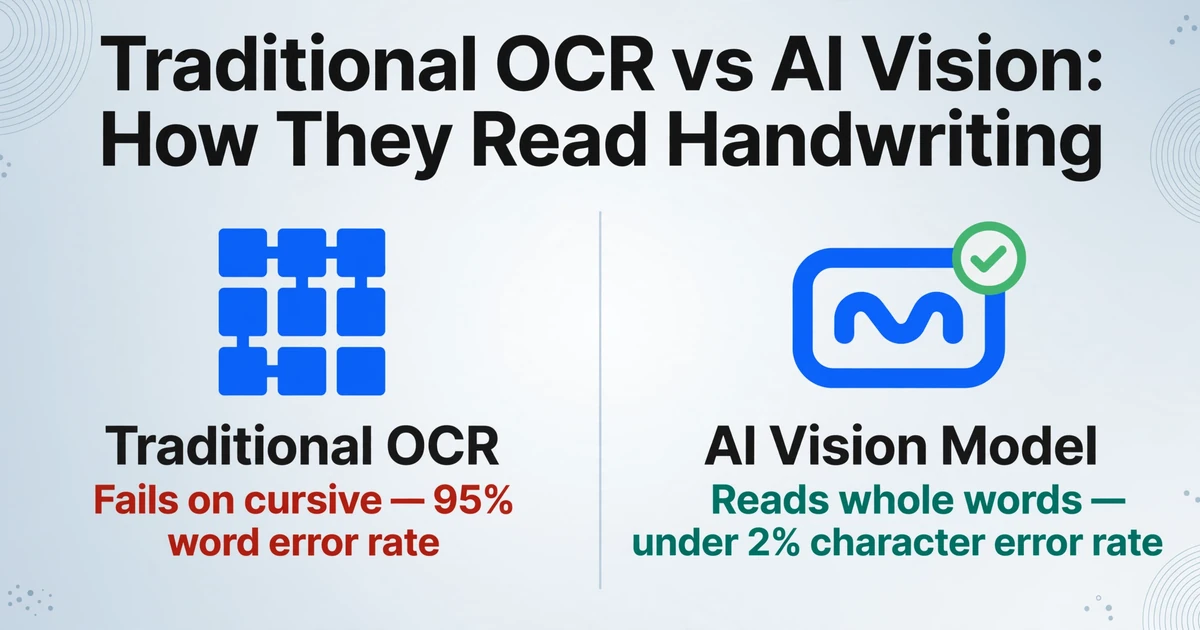
両方のアプローチの出力は似ています — ページ上の内容のデジタル版です。しかし、基盤となるメカニズムが、それぞれが処理できる手書き文字の種類を決定し、その差は漸進的なものではありません。
| 項目 | 従来のOCR | AIビジョンモデル |
|---|---|---|
| 読み取り方式 | 文字単位のセグメンテーション → テンプレートマッチング | 単語全体の視覚認識 → 意味理解 |
| 筆記体の処理 | セグメンテーションで失敗 — 連結した文字には検出できる隙間がない | 連結した筆記を統一された視覚パターンとして読み取る |
| 活字+手書きの混在 | 両者を同一に扱う — 文脈認識なし | 印刷されたラベルを手書きフィールドの意味的文脈として利用 |
| 文書理解 | なし — 純粋な文字ストリームで、フィールドの概念がない | フィールドの関係性を理解:「請求書番号」→ 英数字コードを期待 |
| 劣化耐性 | 低コントラスト、筆圧ムラ、カーボンコピーの色あせで破綻 | 多様な実世界入力を学習 — 中程度の劣化に対応 |
| 出力 | 生テキスト文字列 — フィールド抽出に後処理が必要 | 構造化データ — 各フィールドが独自の列に入り、スプレッドシートにそのままインポート可能 |
実際の違い:従来のOCRでは、手書きの請求書の全文を抽出してから、請求書番号、日付、合計金額を手動で探してスプレッドシートにコピーします。カスタム列抽出を使ったAI抽出では、抽出したい列ヘッダー(「請求書番号」「日付」「取引先名」「合計金額」)を定義するだけで、AIがフィールドの意味を理解して、ページ上のどこに手書きの値があっても特定します。出力を定義するのはあなた、入力を理解するのはAIです。
手書きドキュメントの種類別——抽出すべき項目と期待値
手書きドキュメントの難易度は一律ではなく、重要なフィールドはドキュメントの種類によって大きく異なります。請求書はタイムシートとは構造が異なり、納品書はメーター検針票とは劣化パターンが異なります。このセクションでは、最も一般的な6つの手書きドキュメントカテゴリ、それぞれで重要な具体的なフィールド、そして各タイプに固有の抽出課題を解説します。
手書き請求書
小規模な請負業者、職人、個人事業主は今でも手書きで請求書を作成します——多くの場合、印刷済みテンプレート付きのカーボンコピーパッドを使用します。重要なフィールド:請求書番号、日付、顧客名と住所、明細項目(説明、数量、単価、行合計)、小計、税、支払い合計額。主な課題:手書きの明細項目が最も難しい部分です。請負業者が「Labor — 4 hrs @ $85/hr」を筆記体で1行に書き、次の行に「Materials — 2x plywood sheets @ $42」と書くかもしれません。モデルはこれらのさまざまな形式を、一貫した数量×単価の列に解析する必要があります。複数の請求書を1つのAPスプレッドシートにバッチ処理する方法については、手書き請求書のExcel変換ガイドをご覧ください。
納品書・配達証明書
これらはハイブリッド文書です。印刷された納品書や配達伝票に、実際に受け取った数量、破損メモ、受取人の署名、配達時刻などの手書きの追記が含まれます。重要なフィールド:配達日、注文書番号、受領品目(数量)、不足・破損メモ、受取人名と署名。特有の課題:不足・破損の注記は配達現場で急いで書かれることが多く、読みやすさにばらつきがあります。「2箱破損 — 受領拒否」のようなメモが、指定されたフィールド欄の外、フォーム下部に斜めに走り書きされることもあります。抽出モデルは、定義済みのフォームフィールドだけでなく、ページ上のどこにでも現れるテキストを処理する必要があります。参考:手書き納品書データの抽出。
点検フォーム・現場報告書
安全点検、設備チェック、建設工事の日報はチェックリスト形式で、印刷された基準項目に手書きの回答、チェックマーク、コメント欄が付随します。フィールド:点検者名、日付、場所・現場、各チェックリスト項目(合格/不合格/該当なし)、不合格時のメモ、是正措置、フォローアップ日。特有の課題:チェックボックスとチェックマークはテキスト読み取りを超えた視覚認識が必要です — モデルはチェック済み、未チェック、部分的に記入されたボックスを区別しなければなりません — これは最高のモデルでも最も頻繁に間違える部分です(詳細はAIが手書きフォームを読めるのにチェック済みボックスを見逃す理由を参照)。点検フォーム下部の自由記述コメント欄は、最も価値の高いデータ(何がなぜ失敗したかを記述)である一方、同時に抽出が最も難しい部分です — その日に12枚のフォームを記入した点検者が、限られたスペースに密集した筆記体で書くためです。
タイムシート・勤怠カード
紙のタイムシート — 正式な勤怠カードであれ、現場監督の手書きログであれ — 従業員別、日付別、ジョブコード別の労働時間を記録します。フィールド:従業員名、日付、出勤・退勤時刻、総労働時間、仕事・プロジェクトコード、残業時間、監督者の署名。特有の課題:タイムシートは構造化されたグリッド(列に日付、行に名前)と手書きの数値入力を混在させます。数字はタイムシート上で最も重要度の高いデータです — 時間欄の「4」を「9」と誤読すると給与計算エラーになります。モデルは、列ヘッダー(「時間」)と行ラベル(従業員名)の両方からフィールドの文脈を得る表形式レイアウトを処理する必要があります。構造化抽出については、手書きフォームデータ抽出ガイドをご覧ください。
メーター検針票
公共料金のメーター検針員や施設技術者は、紙のルートシート(メーターID番号、現在の検針値、前回の検針値、使用量を並べた長い表)に検針値を記録します。フィールド:メーターID、日付、現在の検針値、前回の検針値、使用量、異常フラグ。特有の課題:検針値は主に数字で、小さなグリッドセルに素早く書かれるため、斜めになっていたり、サイズが不揃いだったり、取り消し線で修正されていたりすることがよくあります。数字のみのフィールドは、文字セットが限られている(0〜9)分、同時に簡単でありながら、「Reading」というラベルのフィールドには数字と小数点のみが含まれるべきだとモデルが認識することで曖昧な文字を解決できるため、リスクも伴います(1桁の誤りが請求の不一致につながる)。バッチ処理の場合:手書きの検針値をExcelに抽出。
医療・患者受付フォーム
患者登録フォーム、病歴質問票、同意書には、チェックボックス、短いテキストフィールド(氏名、生年月日、保険証番号)、および長い手書きセクション(症状、服薬、アレルギー)が組み合わされています。フィールド:患者名、生年月日、保険会社と保険証番号、病歴チェックボックス、現在の服薬(薬剤名、用量、頻度)、既知のアレルギー、主訴(自由記述)。特有の課題:薬剤名と用量は専門用語であり、汎用OCRでは頻繁に誤読されます。「Atorvastatin 20mg」が「Atorvastatin 20mg」に、「Lisinopril」が「Lis nopril」になるなど。文脈言語モデルを通じて医学用語を理解する抽出ツールは、これらのフィールドで汎用OCRを大幅に上回ります。服薬フィールドの精度は安全上重要であり、信頼スコアに関係なく人間による検証が必要です。
手書き抽出で最良の結果を得る方法
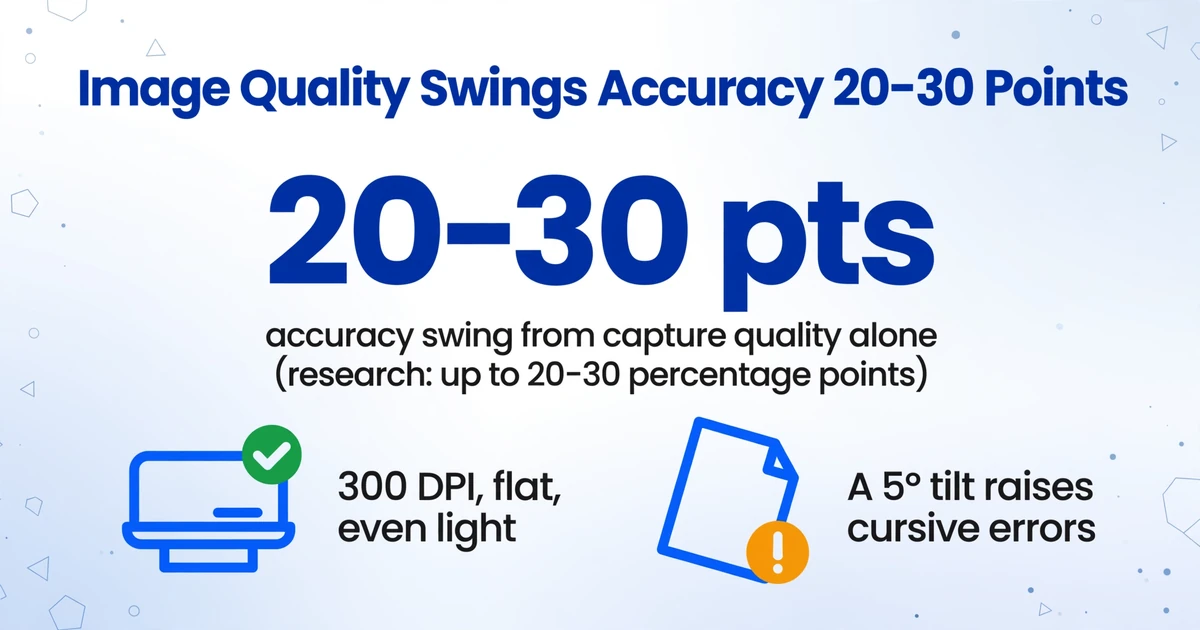
手書き抽出ツールから得られる精度は、ツールの理論上のベンチマークスコアよりも、抽出ワークフローの準備と構成方法に依存します。これらの推奨事項は、どのツールを使用する場合にも適用されます。
最低300DPIで撮影する
画質は抽出精度に影響する最大の制御可能要素であり、研究によれば結果を20〜30ポイントも左右します。一括処理には300DPIのフラットベッドスキャナーを、単文書には均一な照明・フラッシュなし・用紙を平らに置いた最新のスマートフォン(12MP以上)を使用してください。5度の傾きでも筆記体の誤り率が有意に増加することがあります。
可能な場合は機械可読性を考慮したフォーム設計にする
フォームの設計を管理できる場合は、日付や金額などのフィールドに広い空白行ではなく、ボックス型の文字枠を使用してください。文字枠により文字と数字の分離が促され、認識精度が直接向上します。各記入欄の左側に一貫して配置された事前印刷のフィールドラベルは、抽出モデルに強い文脈の手がかりを与えます。
列名は位置ではなく意味で付ける
抽出フィールドを定義する際は、データがページ上のどこにあるかではなく、データが意味するものを表す名前を使用してください。「請求書合計」はレイアウトが変わっても機能しますが、「1ページ目の右下のボックス」はフォーマットが変わると機能しなくなります。意味的な列名により、AIはあらゆる文書レイアウトで値の意味に基づいて値を特定できます。これは、さまざまな形式の複数のソースから届く手書きフォームに対するテンプレート不要の抽出の核となる利点です。
日付ではなく文書タイプごとにバッチ処理する
すべての請求書を1つのバッチで、すべての納品書を別のバッチで処理してください。文書タイプごとにフィールド構造が異なるため、AIの抽出精度は、まったく異なるレイアウトとフィールド意味論を持つ文書タイプ間でコンテキストを切り替えるよりも、均一なバッチ全体に一貫したフィールドレベルの推論を適用できる場合に向上します。
ワークフローに検証ステップを組み込む
実際の文書に対して100%の精度を達成する手書き抽出ツールはありません。100件の請求書のバッチで5%の誤り率は、5件の文書でフィールド修正が必要になることを意味します。ランダムなスポットチェックではなく、抽出値が期待されるパターンに適合しないフィールドにフラグを立ててください(例:有効な数値形式ではない請求書合計、未来日付として解析される日付)。構造化されたフィールド検証は、生のテキスト精度ベンチマークでは見逃されるエラーを捕捉します。
手書き抽出ツールに求めるべき条件
手書き抽出ツールの選定は、宣伝されている精度のパーセンテージが最も高いツールを見つけることだけが目的ではありません。ほとんどの精度の主張は、異なるテストセットと異なる条件下で測定されており、ベンダー間で比較することはできません。代わりに、あなたの特定のドキュメント構成で機能するかどうかを決定する4つの基準に照らしてツールを評価してください。
精度の数値、価格、正直な制限事項を含むツール別の比較については、2026年の最高の手書きOCRソフトウェアと最高の手書きテキスト変換ツールのまとめをご覧ください。
| 基準 | 確認すべきこと | 手書きにとって重要な理由 |
|---|---|---|
| テンプレート不要の抽出 | 「各ドキュメント形式のテンプレートやトレーニングセットを作成せずにフィールドを抽出できますか?」 | 複数のソース(異なる下請け業者、異なる現場作業員)からの手書きドキュメントは、同じドキュメントタイプを表していてもレイアウトが異なります。テンプレートベースのツールでは、各形式ごとに個別のテンプレートを作成して維持する必要があります。これは、書き手に一貫性がない場合、自動化の目的を損なうことになります。セマンティック理解を使用するテンプレート不要のツールは、位置ではなく意味によってフィールドを特定し、形式のバリエーションを自動的に処理します。これはカスタム列抽出パターンです。必要なフィールドに名前を付けると、AIがレイアウトに関係なくそれらを見つけ出します。 |
| バッチ処理機能 | 「手書きドキュメントを一度に50件アップロードして、1つの結合されたスプレッドシートを取得できますか?」 | 手書きドキュメントのワークフローは本質的にバッチワークフローです。1週間分の納品書、1か月分のタイムシート、1ルート分のメーター読み取り値などです。それらを1つずつ処理することは、手動入力の代わりに手動ファイル管理を行うことになります。バッチファーストツールはコレクション全体を処理し、1つの統合された出力スプレッドシートを生成します。これは、これらのドキュメントが現実世界で実際に蓄積される方法に一致します。これはスプレッドシートネイティブアプローチです。出力はExcelまたはGoogle Sheetsに直接出力され、ワークフローの次のステップに進む準備が整います。 |
| 混合コンテンツの処理 | 「ツールは印刷されたラベルと手書きの値の関係を理解していますか?」 | ほとんどの手書きビジネスドキュメントはハイブリッドです。つまり、印刷されたフォームテンプレートに手書きのエントリが含まれています。すべてのテキストを同等に扱うツールは、印刷されたフィールドラベル「顧客名」を手書きの値「John's Plumbing」と一緒に抽出し、どちらがどちらかを整理するのはあなたに任せます。ドキュメントレベルの理解を持つツールは、印刷されたテキストをセマンティックアンカーとして使用し、手書きの値のみを対応する列に抽出します。 |
| 検証ワークフロー | 「どの抽出に人間のレビューが必要かをどうやって知るのですか?」 | 200フィールドのバッチでフィールドレベルの精度が90%の場合、20フィールドにエラーが含まれます。そして、すべてをチェックしない限り、どの20フィールドかはわかりません。低信頼度のフィールド、非準拠の値(テキストを含む日付フィールド)、または欠落した抽出にフラグを立てるツールを使用すると、出力の100%を再チェックする代わりに、注意が必要な10%をレビューできます。 |
評価にはご自身のドキュメントを使用してください。ベンダーのデモは、丁寧な手書きで書かれた清潔でコントラストの高いサンプルを使用しています。しかし、実際のドキュメントにはコーヒーの染み、カーボンコピーの劣化、昼食前に40枚のフォームを記入した人の手書きがあります。本番環境でのパフォーマンスを予測できる唯一の評価は、実際のドキュメントを使ったテストバッチです。
よくある質問
手書きOCRと通常のOCRの違いは何ですか?
通常のOCRは印刷テキスト用に作られています。文字を一つずつ分割し、フォントテンプレートと照合します。手書きOCR(またはHTR — 手書き文字認識)は、手書きサンプルで学習したニューラルネットワークを使用して、単語を全体として認識します。この構造の違いにより、通常のOCRは筆記体で精度が40〜60%に低下しますが、AI手書き認識は読みやすい文字で85〜95%に達します。
AIは同じページの印刷テキストと手書きテキストの両方を読めますか?
はい。最新のAIビジョンモデルは混在コンテンツの文書を処理できます。手書き記入のある印刷済みフォーム、手書きの納品メモ付きの印刷請求書、印刷項目と手書きチェックマークのあるチェックリストなど、個別の処理ステップなしで対応します。モデルは印刷テキストをコンテキストとして使用し、隣接する手書き値の読み取り精度を向上させます。
手書き抽出でどの程度の精度が期待できますか?
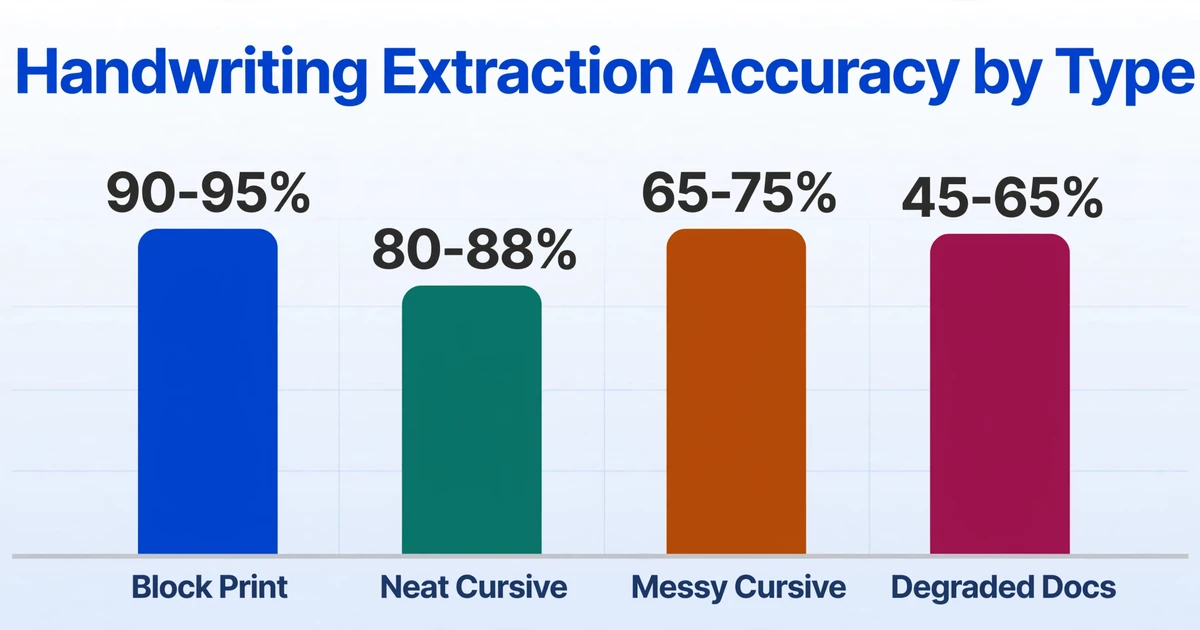
ツールだけでなく、手書きの種類と画像品質に依存します。300 DPIで撮影されたきれいなブロック体の手書き:精度90〜95%。きれいな筆記体:80〜88%。乱雑な筆記体:65〜75%。劣化した文書(カーボンコピー、薄れたインク、現場で傷んだ紙):45〜65%。最良条件と最悪条件の間には20〜30ポイントの差があるため、ベンダーの精度主張を比較するよりも、自社の文書でテストすることが重要です。
手書きOCRは筆記体に対応していますか?
はい、ただし重要な注意点があります。AIモデルは個々の文字を解読するのではなく、単語を視覚パターンとして認識することで筆記体を読み取るため、従来のOCRでは対応できない連結文字を処理できます。ただし、筆記体の精度は書き手によって異なります。一人の書き手による一貫性のある読みやすい筆記体では精度80〜88%ですが、高度に装飾された筆記体や急いで書かれた筆記体では65〜75%に低下します。最も難しいケース(高度に装飾された個人の筆記体、歴史的な筆記体)は、市場のすべてのツールにとって依然として困難です。
AI抽出に最適な手書き文書の種類は何ですか?
明確なフィールド構造を持つ文書(ラベル付きセクション、一貫した情報カテゴリ)が最良の結果を生みます。AIがフィールドラベルを意味的なアンカーとして使用できるためです。手書きの請求書、印刷済みテンプレート付きの納品メモ、検査チェックリスト、列ヘッダー付きのタイムシート、メーター読み取りシートはすべて良好に機能します。構造化されていない手書き(自由形式の手紙やラベルのない会議メモ)は、モデルがアンカーとする構造的手がかりがないため、抽出の信頼性が低くなります。
スマホの写真で大丈夫ですか、それともスキャナーが必要ですか?
基本的な撮影ルールを守れば、ほとんどのユースケースでスマホの写真で対応できます。スマホを文書と平行に保ち、均一な環境光を使用し(フラッシュなし)、文書を平らに保ちます。最新のスマートフォン(12MP以上)で十分な解像度が得られます。ただし、一括処理(一度に50枚以上の文書)の場合は、300 DPIのドキュメントスキャナーの方が一貫した結果が得られ、角度、影、焦点などの写真ごとの変数を排除できます。注意深く撮影したスマホ写真とフラットベッドスキャンの精度差は、通常5〜10ポイントです。
手書きOCRは複数の言語に対応していますか?
主要なAIビジョンモデルは、主要なラテン文字言語(英語、スペイン語、フランス語、ドイツ語、ポルトガル語)をそのまま処理できます。非ラテン文字(中国語、日本語、韓国語、アラビア語、キリル文字)のサポートは改善されつつありますが、ばらつきがあります。日本語と韓国語の認識は2025〜2026年にかけて大幅に進歩しましたが、アラビア語の筆記体は依然として困難です。同じページに複数の言語が混在する文書(例:英語のフォームラベルにスペイン語の手書き回答)を処理する場合は、評価時に特定の言語ペアでの多言語サポートを確認してください。
一度に処理できる文書数は?
ツールによって異なります。バッチ処理対応プラットフォームでは、1回の操作で数十〜数百件の文書を処理できます。すべてのファイルをアップロードし、抽出列を一度定義すれば、統合された出力スプレッドシートを受け取れます。処理時間はほぼ線形にスケールします。10件の文書なら30〜60秒、100件なら文書の複雑さとページ数に応じて5〜8分かかる場合があります。単一文書ツールでは各ファイルを個別に処理する必要があり、10〜15件を超えると非現実的になります。
機密文書の手書き抽出は安全ですか?
セキュリティは手書き技術自体ではなく、ベンダーのインフラに依存します。機密文書(医療フォーム、財務記録、法的文書)の場合、以下を確認してください:処理中の文書の保存場所、転送中および保存中の暗号化の有無、保持期間、処理が自国のサーバーで行われるかどうか、ベンダーが保有するコンプライアンス認証(SOC 2、HIPAA、GDPR)。クラウドベースのツールはリモートサーバーで文書を処理します。厳格なデータ保存要件を持つ組織向けにオンプレミスオプションも存在します。
特定の手書きスタイルに合わせてAIをトレーニングする必要がありますか?
いいえ。最新のAI手書き認識はゼロショット方式です。これまで見たことのない手書きでも、書き手ごとのトレーニングサンプルなしで処理できます。モデルは多様な書き手による数百万の筆記サンプルでトレーニングされており、個人のスタイルのばらつきを抽象化しています。手書きサンプルの収集、データのラベル付け、モデルのトレーニングは不要です。これが、書き手固有の認識モデルの構築を必要とした従来システムと、最新のAI抽出を区別するトレーニング不要/ゼロセットアップアプローチです。
最も構造が一貫したドキュメントタイプから始める
手書き抽出は2026年に実験段階から実用段階へと移行しましたが、魔法ではありません。最良の結果が得られるドキュメントは、構造が一貫しているものです。既知のフィールドに手書きで記入された印刷フォームテンプレートを、適切な解像度でキャプチャし、ドキュメントタイプごとにバッチ処理したものです。最悪の結果になるのは、構造的な手がかりがなく、劣化が激しく、人間でも読むのが難しい手書きのドキュメントです。
ワークフローにおける手書き抽出を評価する最も信頼できる方法は、ベンダーが厳選した見栄えの良いサンプルではなく、チームが毎日扱う実際の書類を使って、ご自身のドキュメントのバッチでテストすることです。最も構造化されたドキュメントタイプ(自由形式の現場検査記録よりも、印刷済みの納品書フォームの方が一般的に優れています)から始め、20〜30サンプルのバッチを実行し、全体的な精度のパーセンテージに頼るのではなく、フィールドレベルのエラーを数えてください。重要なのは、ツールが文字の95%を正しく認識したかどうかではなく、スプレッドシートの請求書番号、金額、顧客名が紙の記載と一致するかどうかです。
技術をより深く理解するには、AI手書き文字認識とは何かから始め、手書きタイプ別の実際の精度ベンチマークを探索し、技術が内部でどのように機能するかをお読みください。ご自身のドキュメントで試す準備ができたら、ある手書きフォームで機能した列定義は、誰の手書きで記入されても、次のフォームでも機能します。