2026年最高の手書き文字認識&
データ抽出ツール
手書きを読むことと、そこから構造化データを抽出することは別々の仕事であり、後者のほうがはるかに難しいものです。手書きページを90%の精度で文字起こしできるビジョンモデルでも、スプレッドシートを正しく埋めることはできないかもしれません。なぜなら、フィールドを列に落とし込むには、追加の処理が必要だからです。単に文字を解読するだけでなく、どの値をどのフィールドに入れるかを判断する必要があります。このギャップこそが、あらゆる「手書きOCR」ランキングでトップのツールが、きれいなテーブルを求められた瞬間に期待を裏切る理由であり、適切な選択が、言葉が必要か列が必要かという点に完全に依存する理由でもあります。
重要なポイント
- すべての手書きツールが同じ見出しの精度数値を宣伝しており、まさにそのためにツールがどれも似たり寄ったりに見えて、選択が不可能に感じられます。
- その数値は比較すべき対象として誤りです。モデルはページを90%の精度で文字起こしできても、各値を正しいスプレッドシートの列に入れるように求めると、おおよそ65%まで落ち込む可能性があります。手書きを読むことと、それをフィールドにマッピングすることの2回成功する必要があるからです。
- 精度スコアを追いかける代わりに、1つの質問をしてください。順序どおりの言葉が必要か、それとも列の値が必要か。そして、ベンチマークではなく、この1つの分岐点が、8つのツールを1つに絞り込みます。
文字起こしと構造化抽出は同じ問題ではない
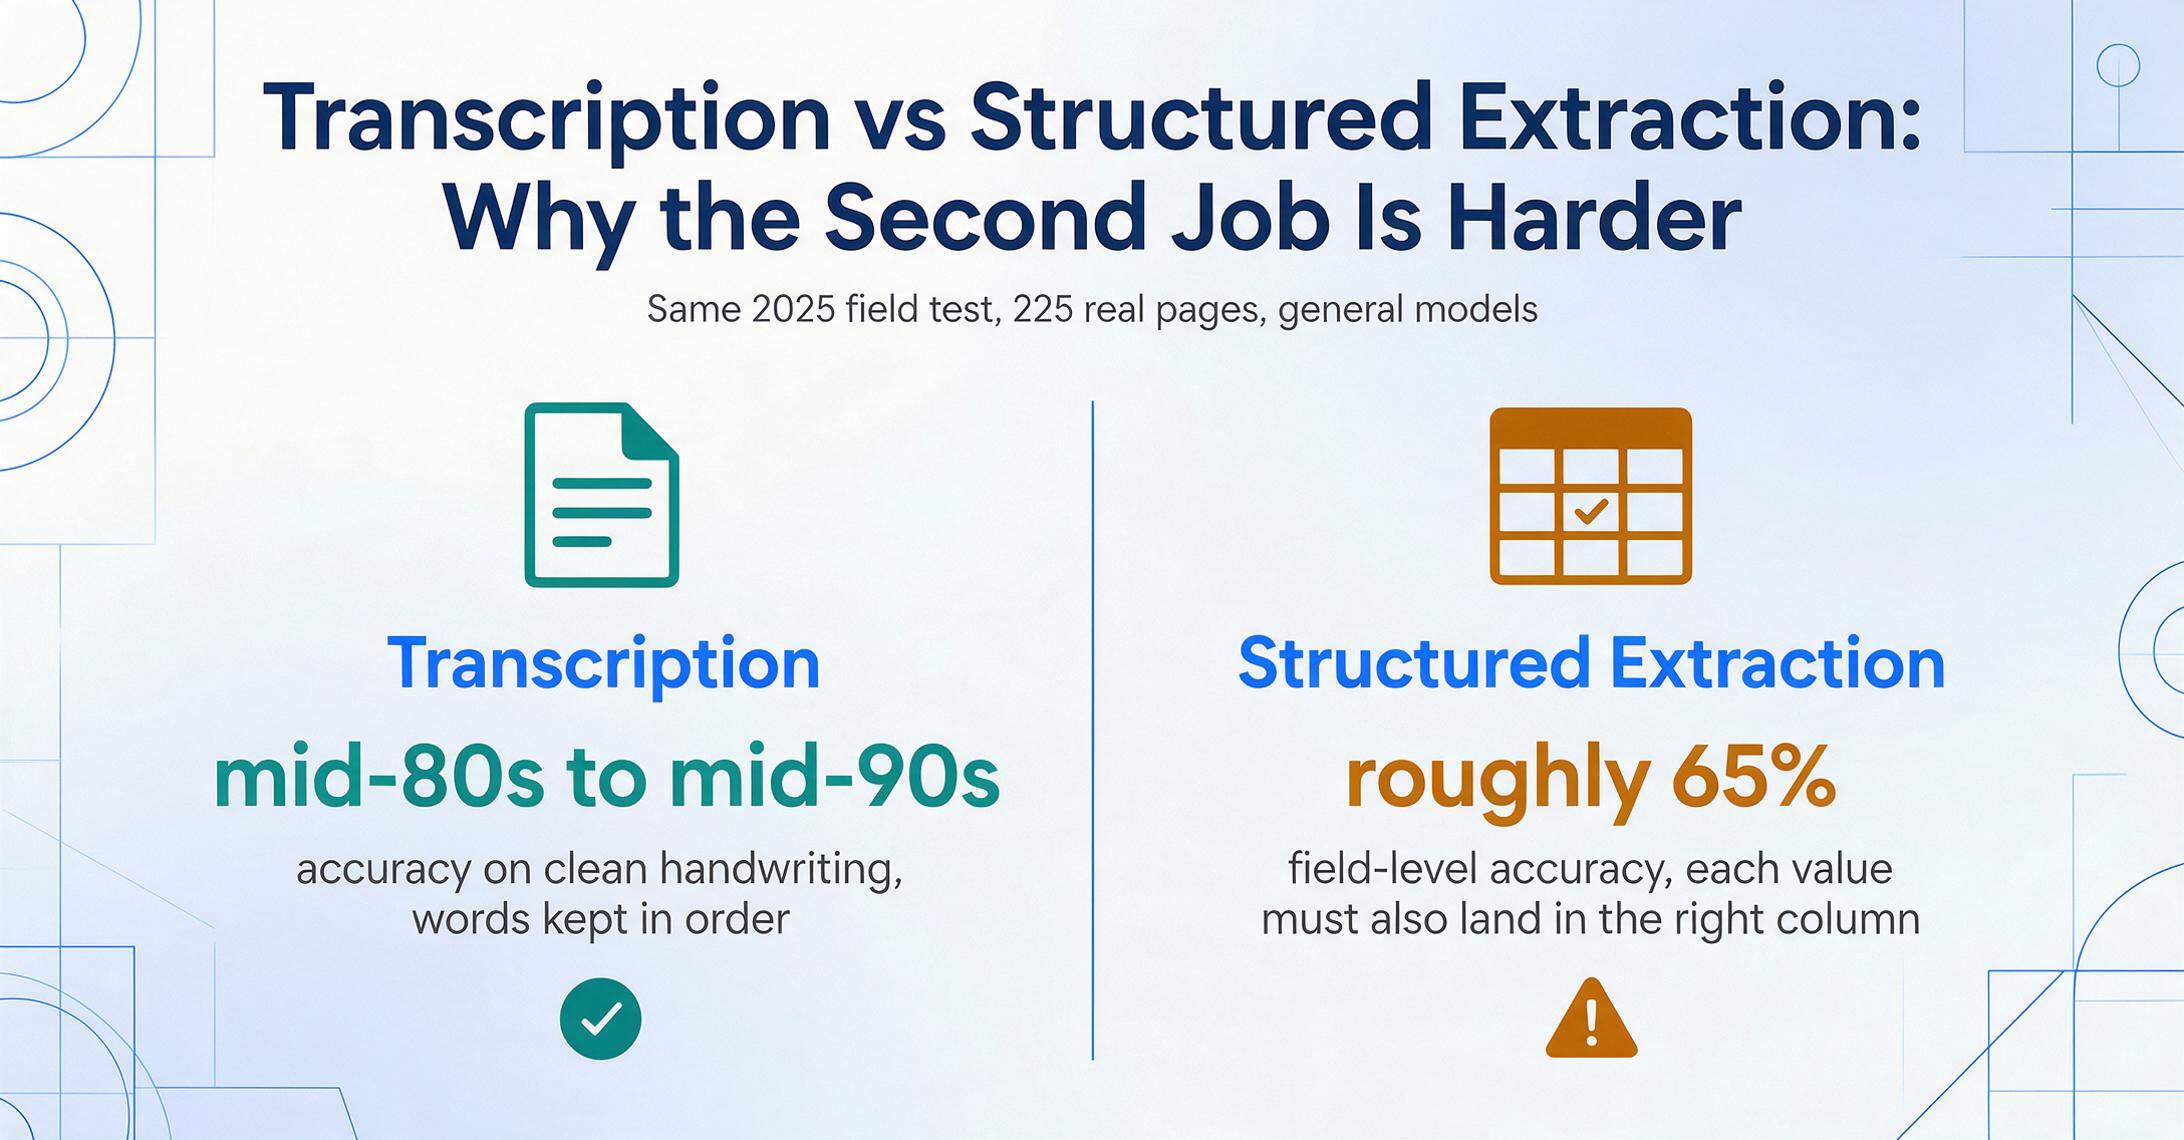
ツールを比較する前に決めておくべき最も重要なことは、実際に必要な作業が2つのうちどちらかということです。文字起こしは、手書きのページを同じ言葉の編集可能なテキストに変換します。日記、手紙、会議メモが、順序どおり、内容を保持したまま、タイプされたバージョンになります。構造化データ抽出は、ページの大部分を意図的に捨てます。手書きの納品書から、日付、品目、数量、署名をスプレッドシートの列に抽出したいだけで、それ以外は不要です。
構造化抽出はより難しいタスクです。モデルはすべての値に対して2回成功する必要があるからです。まず手書きを正しく読み取り、次にドキュメントを十分に理解して、この数字が数量で、あれが単価であると判断する必要があります。
これは理論上の区別ではありません。2025年に広く共有されたr/computervisionのフィールドテストでは、現場技術者による実際の225ページを対象に、一般的なモデルがきれいな手書きを80年代半ばから90年代半ばの精度で文字起こしできる一方、値を正しい列に入れるよう求めると約65%のフィールドレベルの精度に低下し、一部のツールは「逐語的なデータ抽出ではなく、要約や編集を行う傾向がある」と指摘されました。独立したAIMultiple手書き認識ベンチマーク(2026年1月更新)は、根本的な難しさを明確に示しています。タイプされたOCRは99%を超える精度を達成しますが、手書きは「スタイル、間隔、不規則性のばらつきにより課題が残り」、さらにフィールドマッピングのステップが加わると、そのばらつきはさらに複雑になります。
そこで、この総合レビューはより難しいタスクに焦点を当てます。手書きを構造化された、利用可能なデータに変換すること — フォーム、台帳、領収書からフィールド、チェックボックス、テーブルを抽出し、ExcelやGoogle Sheetsに取り込むことです。実際に必要なのが、言葉を順序どおり忠実に書き起こしたもの — 古い手紙、日記、講義ノート — であれば、それは別の問題であり、別の最適なツールがあります。当社の関連レビューである手書き文字テキスト変換ツールとOCRが適切な出発点です。列が必要なのに純粋な文字起こしツールを購入しないように、またその逆がないように、境界線を最初に明確にします。また、構造化出力ではなく、純粋に筆記体の読み取り精度でツールを比較している場合は、手書きOCRソフトウェアの専用レビューで、テクノロジーカテゴリ別に11のツールを評価しています。
選定方法とテスト方法
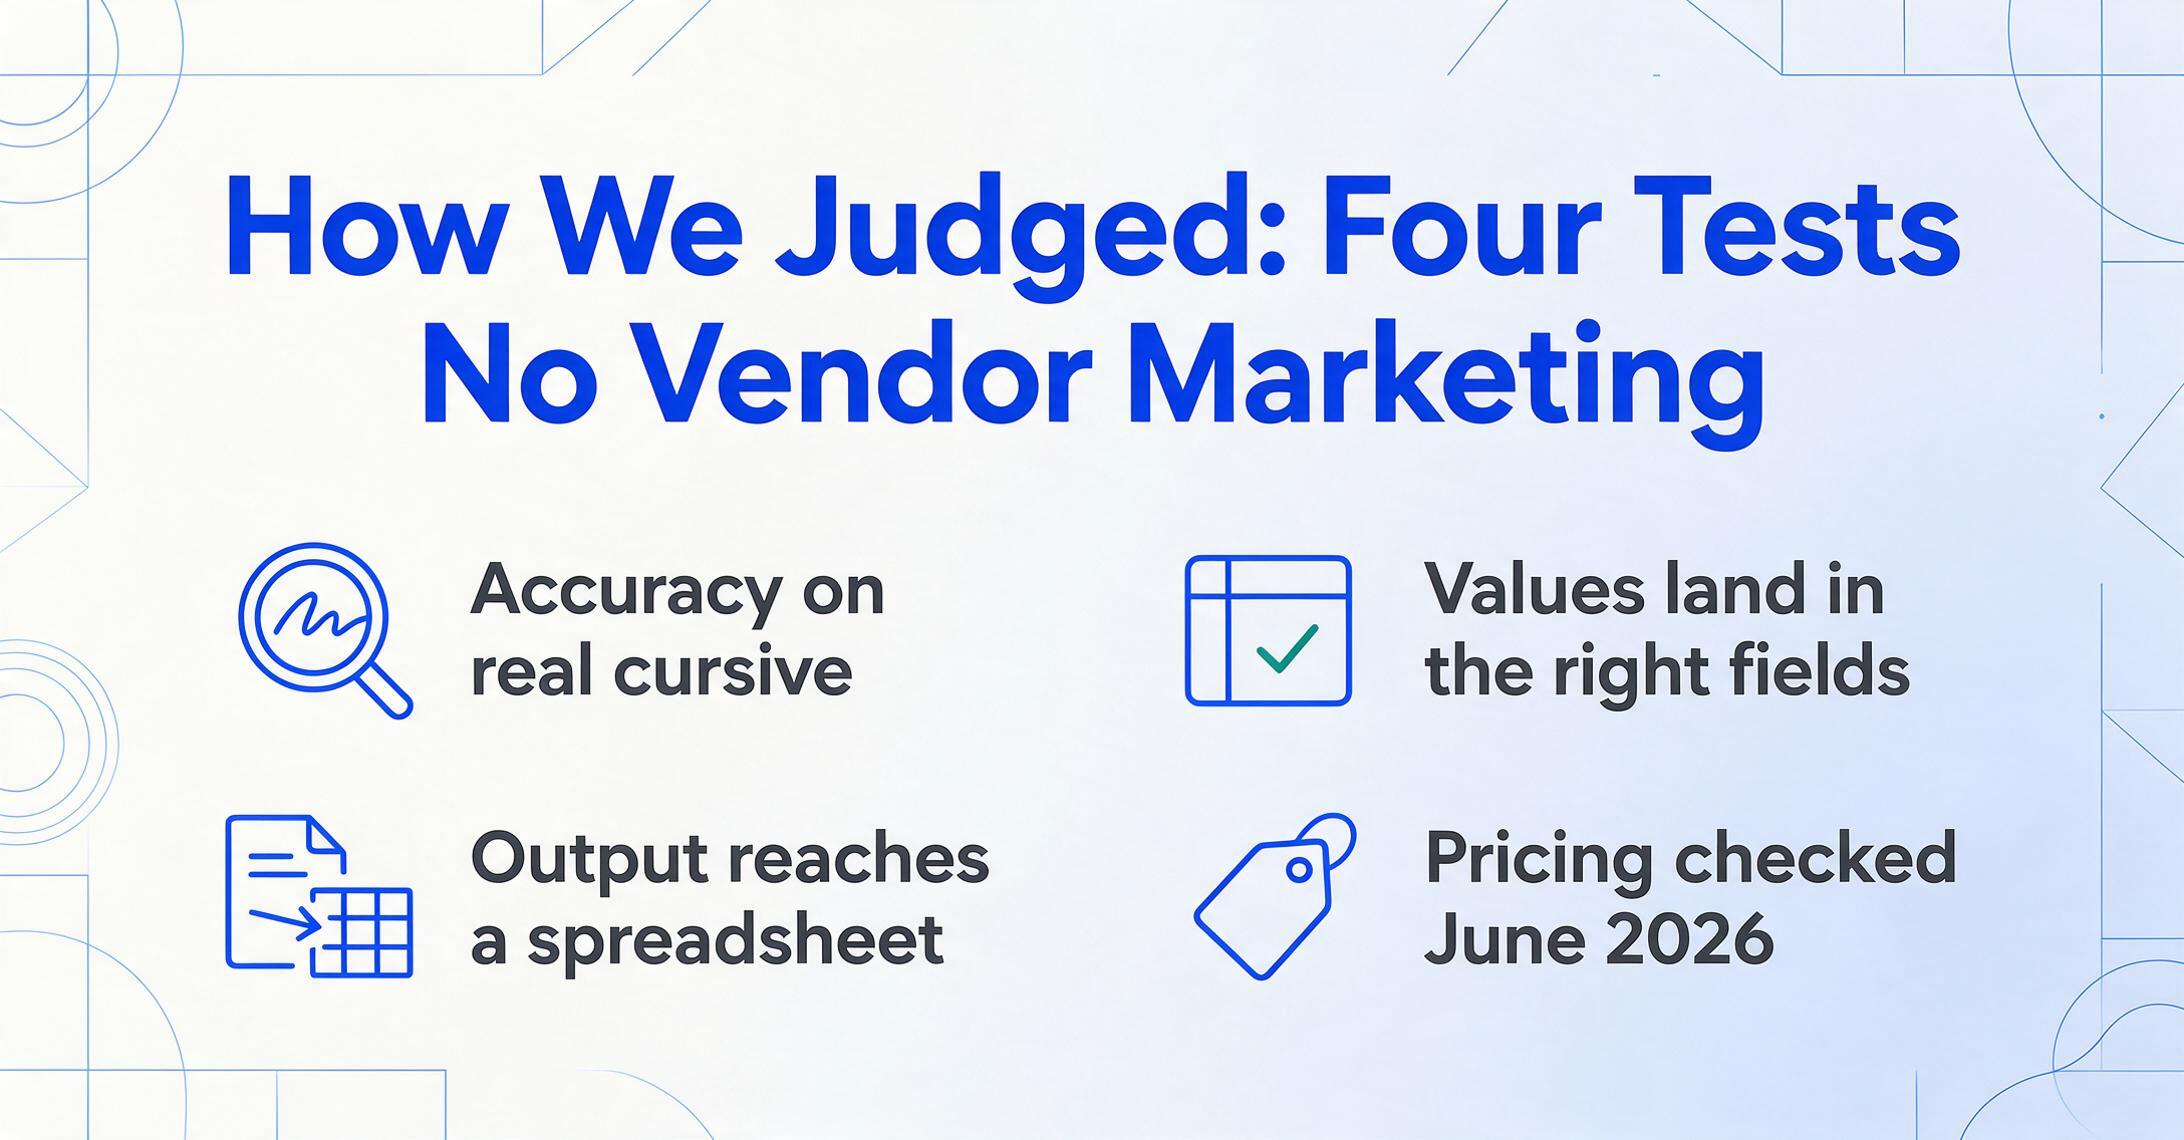
私たちは、手書き文書からテキストだけでなくデータを取り出すために、実際のチームが手に取るであろうツールを評価し、手書きと構造が重なる部分で重要となる作業に基づいて各ツールを判断しました。具体的には、実際の手書き(きれいなブロック体だけでなく、筆記体や乱雑なもの)に対する認識精度、ツールが値を正しいフィールド、テーブル、列にマッピングできるか(フラットな文字起こしを出力するだけではないか)、出力がスプレッドシートにどのように到達するか(ネイティブエクスポートか、自分で組み込む必要がある生のJSONか)、そして正直で最新の価格設定、の4点を重視しました。
精度の数値は独立したベンチマークと実際のユーザーテストに基づいており、すべての数値の出典を明記しています。ベンダーのマーケティング資料は一切使用していません。すべての価格は公開されている価格ページから読み取ったもので、2026年6月時点の価格と表示しています。特に使用量ベースやクレジットベースの価格は変動するため、契約前に必ず確認してください。
完全な開示:このサイトで公開されているツールであるImageToTable.aiは、以下の8つのツールのうちの1つです。私たちは、手書きコンテンツをテンプレートなしで構造化された列に取り込むという、正直な位置づけで配置しました。また、他のツールが明らかに優れている点も挙げています:歴史的アーカイブにはTranskribus、大量のエンジニアリングパイプラインにはクラウドAPI、企業のAPワークフローにはNanonetsです。各ツールには具体的な「最適な用途」と「不向きな用途」を記載しています。
8つのツールを一目で比較
最適なツールを絞り込む最短の方法は、処理量・予算・エンジニアリング支援の有無を各ツールの設計と照合することです。以下に全ツールを並べて比較します。詳細なレビューはこの後に続きます。
| ツール | 初期費用 | 料金モデル | 最適な用途 | 主な制限 | 無料トライアル |
|---|---|---|---|---|---|
| ImageToTable.ai | 無料プランあり、その後$9/月 | クレジット制(1クレジット=1ページ) | コード不要で手書き文字を構造化列&Wordに変換 | エンタープライズ向けAP/ERPワークフロープラットフォームではない | あり(無料デモ、登録不要) |
| Google Document AI | 1,000ページあたり$30〜(Form Parser) | 従量課金API | クラウド規模での大量フォーム/テーブル抽出 | エンジニアリングが必要。筆記体の手書き文字は「まずまず」の精度のみ | あり(GCP無料枠) |
| AWS Textract | 1,000ページあたり$50〜(Forms) | 従量課金API | AWSパイプライン内でのキーと値のペア&テーブル抽出 | 開発者向けツール。複雑な筆記体には弱い | あり(3ヶ月の無料枠) |
| Nanonets | 無料($200クレジット)、その後約$0.30/ページ | クレジット/ブロック単位の従量課金 | 承認フロー&統合機能を備えたエンタープライズAP自動化 | ブロック単位のコスト予測が難しい。大規模運用向け | あり($200クレジット) |
| Affinda | 14日間トライアル、その後約$0.20/ページ | 従量課金(ページ単位) | 柔軟なレイアウト+検証機能を必要とする中規模チーム | 営業主導のプラットフォーム価格。セルフサービスの無料枠なし | あり(14日間、200クレジット) |
| HandwritingOCR.com | 無料(5クレジット)、その後$15/100ページ | PAYGクレジット+月額プラン | 最も複雑な筆記体。ProプランでテーブルをExcelに変換 | 大量処理ではページ単価が上昇 | あり(無料5クレジット) |
| Transkribus | 無料(月50クレジット)、その後€99/年 | クレジット制。サブスク+オンデマンド | 歴史資料・公文書を表形式データに変換 | プロジェクト指向。現代のビジネスフォームには過剰 | あり(月50クレジット) |
| Pen to Print | 無料。Premiumは$2.99/月 | フリーミアムのモバイルアプリ | スマホで自分の読みやすいメモをテキスト化 | 文字起こしのみ。フィールド・列・テーブルには対応しない | あり(無料プラン) |
価格は2026年6月時点で確認済みです。表示されているのはエントリーレベルの公開価格であり、数量、地域、機能の組み合わせによって変動します。表示されている使用量ベースのAPI価格は、構造化(フォーム・表)抽出用であり、基本的なテキストのみのOCRではありません。
手書きからフィールドや表を抽出するために作られたツール
目的が列の取得なら、文字起こしではなく構造化された出力を生成するように設計されたツールから始めましょう。これらのツールは「このフィールドは何か」を後回しではなく最優先のタスクとして扱います。
ImageToTable.ai
ImageToTable.aiは、この記事が扱うまさにその重なり合う領域、つまり実際にはフォームである手書き文書のために作られています。ビジョン大規模モデル上で動作し、印刷テキストと手書きテキストの両方(筆記体、チェックボックス(チェックまたは丸印)、署名を含む)を読み取り、純粋な文字起こしツールでは実現できない方法でスプレッドシートに変換します。領域を描画したりモデルをトレーニングしたりする代わりに、「日付」「品目」「数量」「署名」など、必要な列名を入力するだけで、AIがページ上のどこにある値でもその意味を理解して特定します。これがカスタム列抽出であり、「文字を読む」と「表を埋める」をつなぐ架け橋です。また、ページに明示されていない列を推論することもできます。たとえばカテゴリ(食事/交通/オフィス)を指定すると、手書きの領収書を抽出しながら分類します。さらに、複数のファイルをバッチ処理して1つの結合されたExcelシートにまとめたり、レイアウトを保持したWord文書にエクスポートしたり、Google Sheetsのサイドバーアドオン内で動作したりします。
実際には、手書きと構造化が交差する場面で自然な選択肢となります。たとえば、手書きフォームをスプレッドシートの列に変換したり、手書きの台帳をExcelにバッチ変換したり、確定申告シーズンに向けて手書きの領収書を整理したりするケースです。精度が気になる方は、手書きフォームからチェックボックスとフィールドを読み取る仕組みを読んでみる価値があります。価格はクレジット制で、1クレジット=1ページです。無料ティア(サインアップ不要で試せる毎日のクォータ)があり、その後は月額$9(Basic)、月額$19(Pro)、月額$59(Max)となります。チーム向けはGrowth($149)、Scale($399)、Enterprise($899)です。
最適な用途: テンプレート、トレーニング、コードなしで、手書きのフォーム、台帳、領収書をきれいな構造化列や編集可能なWordファイルに変換する必要がある小規模チームや個人ユーザー向け。不向きな用途: 承認ルーティングやERP転記が組み込まれた機能を必要とする企業のAP部門、書きながらのライブノート作成、中世写本の学術的な文字起こし。
Google Document AI
Google Document AIは、構造解析の分野でForm Parserが非常に優れたクラウドプラットフォームです。予測可能なレイアウトのフォームに最適な、キーと値のペアやバウンディングボックス付きの表セルを返します。課題は実際の手書き文字の認識精度にあります。r/computervisionのフィールドテストでは、文書構造と表検出では優れた結果を示した一方、読みにくい手書きコメント欄では約50%の精度にとどまりました。開発者向けツールであり、Google Cloudプロジェクトを設定し、APIを呼び出し、JSONを自分で解析する必要があります。Form Parserは1,000ページあたり$30(100万ページを超えると$20に低下)、基本OCRは1,000ページあたり$1.50です。
最適な用途: パイプラインとレビューインターフェースを構築できるエンジニアリングチームが、比較的整った構造化フォームを大量に処理する場合。不向きな用途: 非技術系ユーザー、または認識精度が表検出の品質に及ばない読みにくい筆記体のフィールドノート。
AWS Textract
AWS Textractは、すでにAWSを利用しているチーム向けの構造化抽出の主力製品です。AnalyzeDocument APIはフォーム(キーと値のペア)、表、特定のクエリへの回答を抽出し、各要素の座標を返します。明瞭な手書き文字やブロック体には堅牢ですが、独立したテストでは筆記体や読みにくいフィールド記入で約48%の精度にとどまり、AWSは手書き文字サポートが主に英語であることを確認しています。料金はページ単位で機能別です。フォームは1,000ページあたり$50、表は$15、両方の組み合わせは$65、基本のテキストのみのOCRは$1.50です。3か月の無料枠では、月最大100ページのAnalyzeDocumentを利用できます。より詳細な一対一の比較については、AWS Textractの詳細な比較 →をご覧ください。
最適な用途: AWSエコシステム内でドキュメントパイプラインを構築し、バウンディングボックス付きのキーと値および表の抽出を必要とする開発者。不向きな用途: 非開発者、非常に読みにくい筆記体、または精度が低下する非英語の手書き文字。
エンタープライズおよびミッドマーケット向けドキュメントAIプラットフォーム
手書き文字抽出が、承認、検証ルール、ERP転記などの大規模な自動化ワークフローの一部である場合、フル機能のドキュメントAIプラットフォームは、その高い価格に見合う価値があります。ただし、利用量がそれを正当化する場合に限ります。
Nanonets
Nanonetsは、買掛金管理やドキュメント自動化スイートの一環として手書き文字を処理するエンタープライズグレードのプラットフォームです。分類、承認ルール、検証、ERP統合が抽出機能の上に重ねられています。料金はクレジット/ブロックベースのモデルに移行しました。すべてのアカウントは$200のクレジットで無料で開始し、その後、複雑なAIブロックごとに約$0.30を支払います。一般的な請求書は複数のブロックを実行し、エンドツーエンドで約$2になります。GrowthおよびEnterpriseティアは見積もりによる交渉です。この柔軟性は強力ですが、たまに利用するユーザーにとっては予測が非常に難しいものです。直接比較をご検討の場合は、詳細なNanonets比較 →をご覧ください。
最適なケース: 承認ワークフローとシステム統合を備え、手書きおよび印刷ドキュメントを大量に自動化する財務・運用チーム。 不向きなケース: ワークフローを構築せずに、予測可能な定額料金とスプレッドシートの数フィールドを求める個人ユーザーや小規模チーム。
Affinda
Affindaは、長い再トレーニングなしで新しいレイアウトに適応し、フィールドとテーブルの検証機能を備えたミッドマーケット向けドキュメントAIプラットフォームです。これは、手書きフォームがソースによって異なる場合に重要です。公開プラットフォームの料金は使用量ベースで、主に営業主導です。AWS Marketplaceのリストでは、低容量で1ページあたり約$0.20、スケール時には$0.05に低下し、200クレジットの2週間トライアル後に適用されます。そのため、単一バッチをテストするユーザーよりも、予測可能な利用量を持つチームに適しています。
最適なケース: 多様なドキュメントレイアウトにわたる検証付きの適応型抽出を必要とする、金融、保険、物流のミッドマーケットチーム。 不向きなケース: 透明なセルフサービス無料ティアと即時セットアップを求める個人または非常に小規模なチーム。
手書き文字認識の専門エンジン
一般のクラウドAPIでは難しい、複雑な筆記体やかすれたインク、歴史的な文字など、最も困難な手書き文字に対しては、専用エンジンが優れた性能を発揮します。ただし、文字起こしだけでなく構造化された出力を生成するエンジンは限られています。
HandwritingOCR.com
HandwritingOCR.comは、生の手書き文字認識に最も特化したサービスです。r/computervisionコミュニティのフィールドテストでは、構造化フィールドと自由記述コメントの両方において、全225ページで約95%の精度を達成し、文脈の劣化もありませんでした。これは、一般的なOCRが苦手とする複雑な資料に対して、非常に優れた結果です。300以上の言語と筆記体に対応し、Word、Markdown、プレーンテキスト形式でエクスポートできます。月額59ドルのProプランでは、表形式データのExcelエクスポート機能が追加され、単なる文字起こしから構造化出力へと進化します。料金は、従量課金制で100ページあたり15ドル(クレジット有効期限1年)、または月額19ドルで250ページまで利用できます。
最適な用途: 最も困難な文字起こし作業、およびProプランでの表形式手書きデータの処理。不向きな用途: 様々なフォームから意味に基づいて任意の出力列を定義する必要があるチーム、またはページ単価がかさむ非常に高い月間ボリュームの処理。
Transkribus
数世紀前の写本、教区 register、公文書の処理において、Transkribusに匹敵するサービスは他にありません。人文科学分野における手書き文字認識(HTR)の事実上の標準です。250以上の機関会員を擁する欧州の協同組合READ-COOP SCEによって開発・運営されており、100以上の言語と時代特有の文字に対応し、2億ページ以上の文字起こしを処理してきました。データ主権に関するルールを持つ機関向けに、オーストリアのサーバーで処理を行っています。構造化された作業には、表認識機能と、特定の筆記者の手書き文字に微調整可能なトレーニング可能なモデルを提供しており、例えば手書きの系図記録を表形式データに変換する際に非常に役立ちます。料金はクレジットベースで、無料枠は月50クレジット、年間99ユーロのScholarプラン、有効期限のないオンデマンドパック(250クレジットで59.50ユーロ)があります。
最適な用途: プロジェクト規模で、歴史的または特殊な文字から構造化データを抽出するアーキビスト、系図学者、研究者。不向きな用途: 現代のビジネスフォームや単発のバッチ処理。プロジェクト指向のワークフローは、簡単な抽出作業に必要なセットアップよりも手間がかかります。
Pen to Print
Pen to Printは、消費者向けのモバイルオプションとしてここに名を連ねています。ノートページの写真を撮るだけでテキストが得られ、ベンダーはきれいな筆記体に対する高い単語精度を主張しています。この記事の目的に対して、これができないことがまさに名前を挙げる価値のある理由です。つまり、文字起こしはしますが、列内のフィールドではなく単語を返すのです。したがって、構造化抽出の観点では、せいぜい出発点にすぎません。手書きの「フォーム」が実際には自分で再構成するメモにすぎない場合に役立ちます。広告付きで無料、またはPremium(マルチページスキャン、編集)は月額$2.99です。
最適な用途:自分の読みやすい手書き文字をテキスト化してスマートフォンでデジタル化したい学生や個人。不向きな用途:スプレッドシートの列に特定の値をマッピングする必要があるワークフロー。構造化ツールと組み合わせるか、文字起こし優先の選択肢については手書き文字からテキストへの変換のまとめを参照してください。
ユースケース別の選び方
ツールを選ぶ際は、入力、量、出力目標の順に照合してください。この3つで、価格を考慮する前にカテゴリ全体を絞り込めます。
手書きのフォーム、台帳、領収書があり、列としてデータが欲しい場合:ImageToTable.ai。フィールド名を入力するだけで、テンプレートなしで値をマッピングします。手書きフォームからの特定フィールドの処理をご覧ください。
エンジニアと大量のデータがある場合:Google Document AIまたはAWS Textractでフォームとテーブルを大規模に処理。ただし、複雑な筆記体にはレビューステップが必要になることを理解しておいてください。
AP(買掛金)または財務ワークフローを自動化する場合:承認とERP統合が必要ならNanonets。検証機能を備えた適応性の高いミッドマーケット向け抽出ならAffinda。
歴史的またはアーカイブ記録がある場合:時代特有の筆記体や表形式の台帳にはTranskribus。最も読みにくい現代の筆記体にはHandwritingOCR.com。Proプランでは表のExcel変換が可能です。
単に単語を順番通りに取得したいだけの場合:このリストは必要ありません。文字起こし優先のツールを扱う手書き文字からテキストへの変換ツールのまとめから始めてください。
手書き文字よりも一般的なドキュメントを扱うことが多い場合は、関連するまとめ記事であるドキュメントデータ抽出ツール、AI OCRソフトウェア、ノーコードドキュメントAIツール、テーブル・フォーム抽出ツールが視野を広げてくれます。また、一般的なチャットボットでこれができるかが本当の関心事なら、ChatGPTが手書きデータに最適ではない理由に関する記事をご覧ください。
よくある質問
手書きフォームからExcelにデータを抽出するのに最適なツールは?
手書きフォームをコードなしでスプレッドシートの列に変換するには、ImageToTable.aiが最適です。必要な列を指定するだけで、AIが各手書き値を適切なフィールドにマッピングし、ExcelやGoogle Sheetsにエクスポートします。大量処理を行うエンジニアリングチームには、Google Document AIのForm ParserやAWS Textractのフォーム/テーブルAPIがキーと値のペアやテーブルを抽出しますが、パイプラインの構築と手書き文字の確認は自分で行う必要があります。実際のページで2~3個のツールをテストするのが確実です。
手書きデータの抽出が、単に読み取るよりも難しいのはなぜ?
ツールはすべての値に対して2つの処理を正しく行う必要があるからです。まず手書き文字を認識しますが、筆記体や乱雑な文字は、高性能なモデルでも活字ほどの精度は出せません。次に、どの値が日付で、どの値が金額で、どの列に属するかを文書構造から理解する必要があります。実際のテストでは、手書き文字の転写精度が80%台後半~90%台半ばでも、フィールドレベルの構造化抽出では約65%まで低下することがあります。これは2番目の処理で独自のエラーが発生するためです。
ChatGPTやClaudeで手書き文書から構造化データを抽出できる?
手書きの写真を読み取って抽出を試みることは可能で、きれいな1ページならそこそこ正確です。しかし、精度にばらつきがあり、乱雑な文書や複数ページでは精度が低下し、値をそのまま抽出するのではなく要約したり「整理」したりする傾向があります。正確な数値を正確な列に必要とする場合にはリスクがあります。たまに使って後で確認する程度なら問題ありませんが、再現性と精度が重要な構造化抽出には、専用ツールの方が安全です。
手書きツールは筆記体や乱雑な文字に対応している?
専用の手書き文字エンジン(HandwritingOCR.com、ImageToTable.ai、Transkribus)は筆記体向けに設計されており、活字用に作られた従来のOCRよりもはるかに優れています。AWS TextractやGoogle Document AIのような汎用クラウドAPIは、きれいなブロック体には対応しますが、乱雑な筆記体では精度が急激に低下し、45~50%程度になることもよくあります。読みにくい文字に完璧なツールはありません。出力品質は元の文書の読みやすさに依存するため、きれいなサンプルではなく、最も読みにくい実際のページでテストしてください。
手書き文書からデータを抽出する無料の方法はある?
はい、テスト用にあります。ImageToTable.aiは無料枠があり、サインアップなしで1つの文書を試せます。Nanonetsは200ドル分のクレジットから始められます。AWS TextractとGoogle Document AIには無料利用枠があります。Transkribusは月50クレジット、HandwritingOCR.comは5クレジットを無料で提供しています。無料枠は自分の文書で精度を判断するのに十分です。手書きの品質は価格表以上にばらつくため、支払い前に代表的なサンプルでテストしてください。
結論
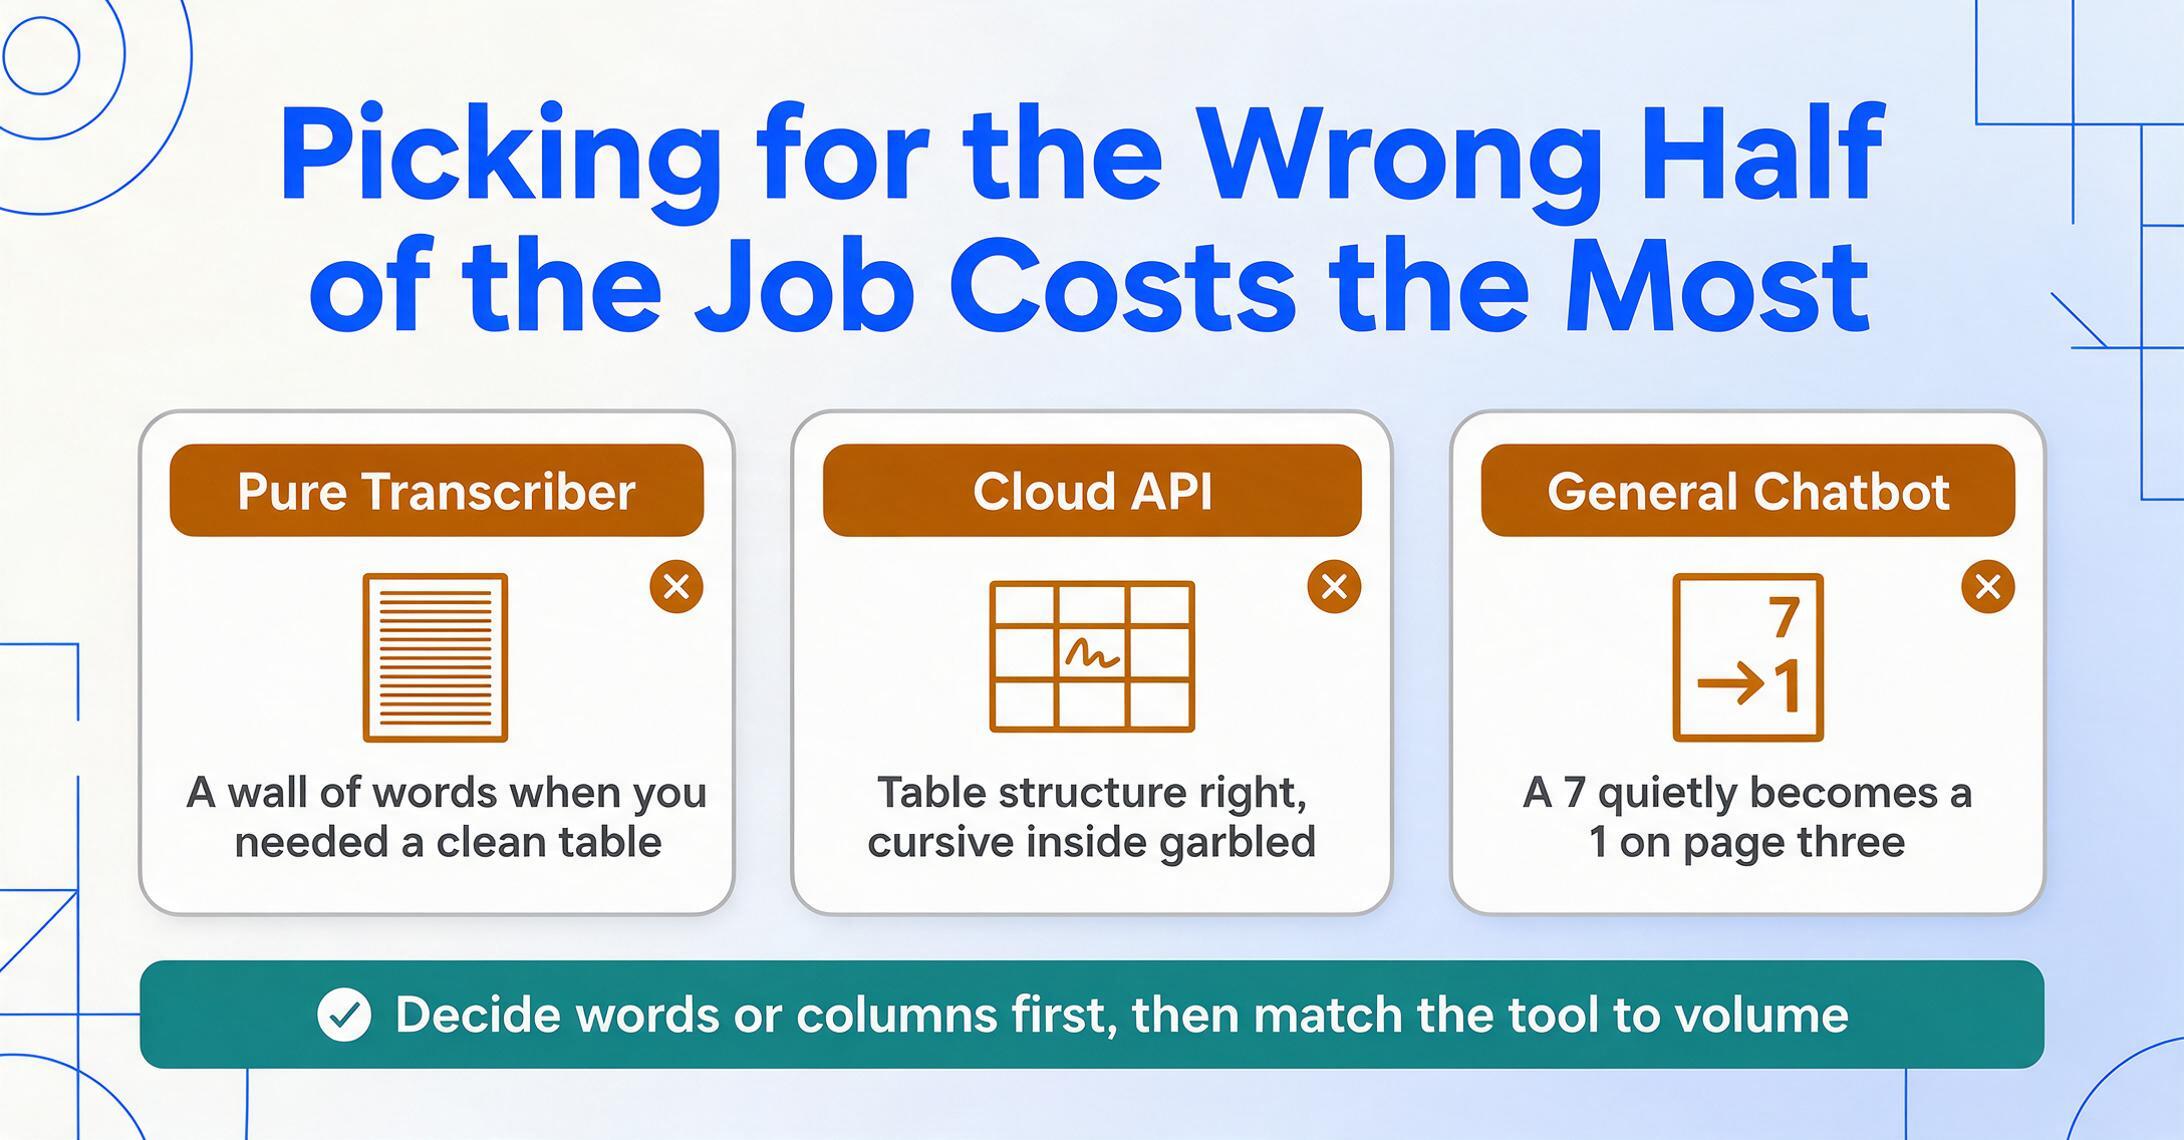
高価な失敗は、評価が低いツールを選ぶことではなく、仕事の半分に合っていないツールを選ぶことです。純粋な文字起こしツールは、きれいなテーブルが必要なときに、ただのテキストの羅列を返します。クラウドAPIはテーブル構造は正確でも、その中の筆記体を誤認識します。一般的なチャットボットは、3ページ目で「7」を「1」と静かに書き換えてしまいます。まず、単語が必要か列が必要かを決め、それからツールをあなたのボリュームとエンジニアリング支援の有無に合わせて選べば、選択肢は1つか2つの誠実なオプションに絞られます。
あなたの手書き文字がフォーム、台帳、領収書にあり、手作業でクリーンアップする文字起こしではなく、特定の値をスプレッドシートの列に抽出したい場合は、実際のページで試すのが最も早い方法です。ImageToTable.aiに手書きドキュメントをアップロード → — サインアップ不要、数秒で結果が得られます。