50件のクライアント確定申告、1つの
申告シーズン向けクライアントサマリー
確定申告シーズンに個人クライアント80件を担当する中規模の税理士事務所には、紙面上では消え、実務では再発するワークフローの問題があります。紙面上では:クライアントがfreee、弥生、または国税庁の確定申告書等作成コーナーで作成した申告書のPDFを渡し、税理士がそれを確認します。実務では:税理士は自身の分析テンプレート(クライアントごとに1行、B様式の全項目に1列ずつ割り当てたスプレッドシート)を開き、すべての数字を再入力します。第一表からの収入合計。7行の控除欄からの控除額。計算欄からの課税所得。源泉徴収欄からの予納税額控除。納付税額または還付額。それが80クライアント分。計算は単純です:申告書1件あたり50以上の項目 × 80クライアント × 1項目あたり約15秒 = 16時間以上のデータ入力 — それが、すべての時間がすでに埋まっている4週間の期間に集中します。80件すべての申告書を1回のアップロードで読み取り、クライアントごとに1行、各項目を各列に出力するバッチ処理ワークフローは、その16時間を、書類の束をスキャンするのにかかる時間にまで短縮します。
重要ポイント
- クライアントの申告書1件あたり50項目を1項目15秒で再入力すると、80クライアントの事務所では4,000以上の項目転記となり、3月15日の期限がミスを許さない2月に16時間のデータ入力が集中します。
- ボトルネックはキー入力速度ではなく認知マッピングです — PDFの視覚的レイアウトに印刷された値をスプレッドシートのセルに照合する作業を、シーズン中に4,000回繰り返し、疲労によってエラー率が増幅されます。
- 出力列を一度定義し、80件すべての申告書を1つのバッチでアップロードすれば、AIが各項目をその意味で読み取ります — 社会保険料控除は、freee、弥生、または2022年の手書き用式のどれから来た場合でも同じ列に配置されます — 2月は印刷された数字の再入力ではなく、控除の漏れを見つける作業になります。
個人申告処理が50件で破綻する理由
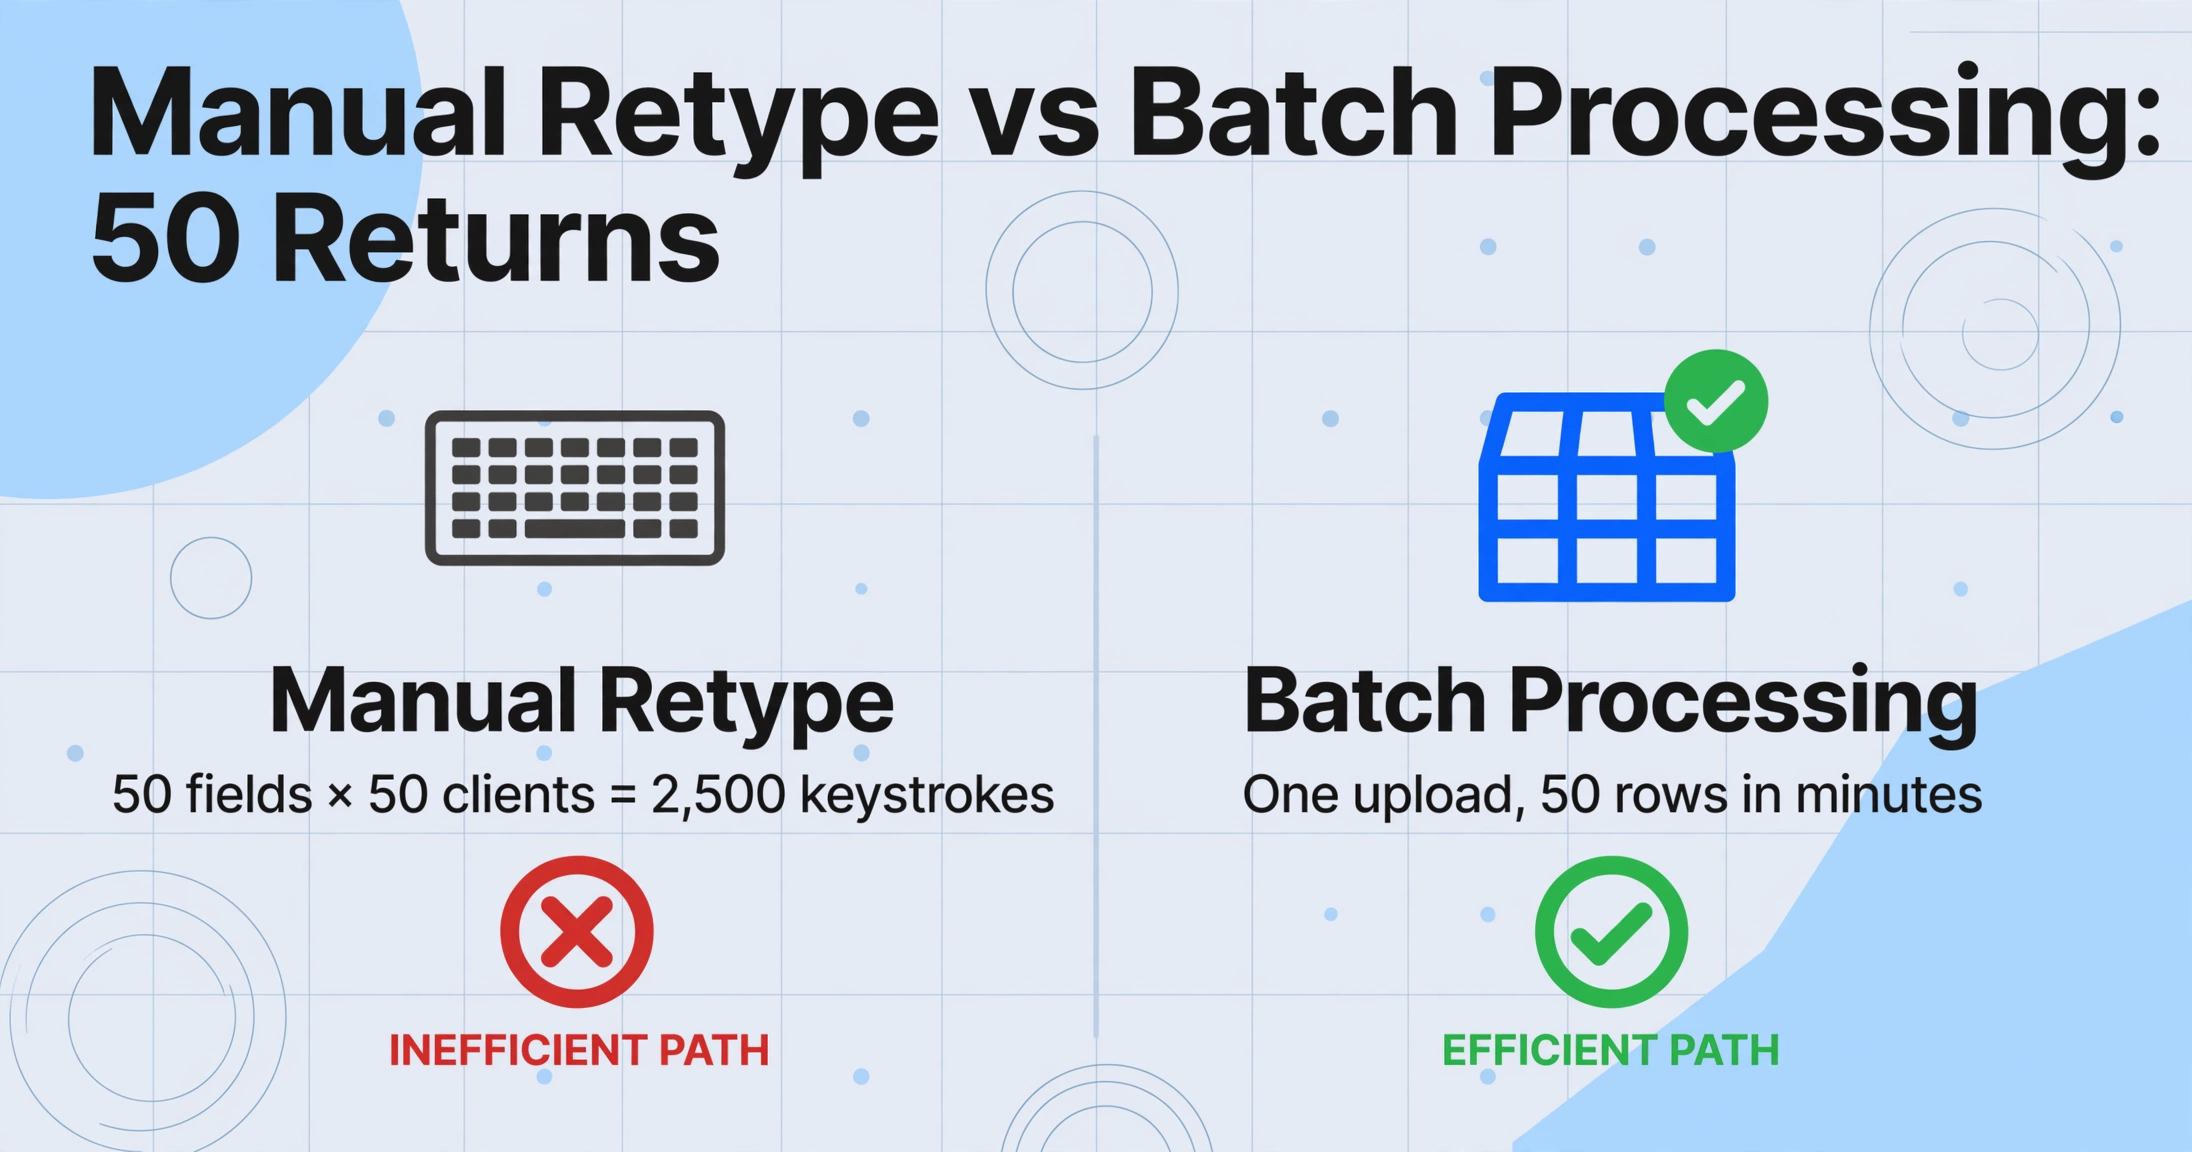
税理士が1件の申告書を確認する際、PDFを開き、数値を読み取り、スプレッドシートに入力し、次の案件に移る。1件あたり5分(50項目×1項目30秒)なら、1件は効率的に処理できる。10件なら午前中で終わる。50件なら、請求可能な時間の1週間分がキー入力に費やされる。そしてその1週間は、1年で最も短い2月に訪れる。所得税法第120条に基づく3月15日の提出期限を控え、前年の申告書を再入力する1日は、クライアントとの今年の税務戦略の検討に充てられない1日を意味する。
構造上の問題は、税務申告書という書類が税務署向けに最適化されており、税理士向けではないことにある。B様式の欄は、中間小計を伴う7つの独立した計算ブロックに整理されている。第一表の控除ブロックは縦型のリストである。第二表の所得内訳は複数列の横型テーブルである。収支内訳書(または青色申告決算書)はその両方に連動する。これら3つの書類をすべて読み、スプレッドシートの1行に集約することは認知的マッピング作業であり、税理士の頭脳はクライアント1件につき3つのPDFを横断する結合処理を行っていることになる。80件なら240回のPDF評価となり、疲労とともにエラー率は複合的に増加する。
真のボトルネックは入力速度ではない。コンテキストスイッチである。PDFから50項目を再入力する税理士は、人間の脳が想定されていない作業を行っている。視覚的なレイアウト上の印刷値を、スプレッドシートのグリッド上のセルに対応付ける作業である。この視覚的マッピングの認知的負荷は、4,000回(50項目×80件)繰り返されると、半日のレビューを2日間のデータ入力作業に変えてしまう。バッチ抽出はマッピングの工程を完全に排除する。税理士は出力列を一度定義し、すべての申告書をアップロードするだけで、各クライアントの1行にすべての項目が所定の列に格納された結果を受け取ることができる。
バッチ処理による確定申告ワークフローの実際
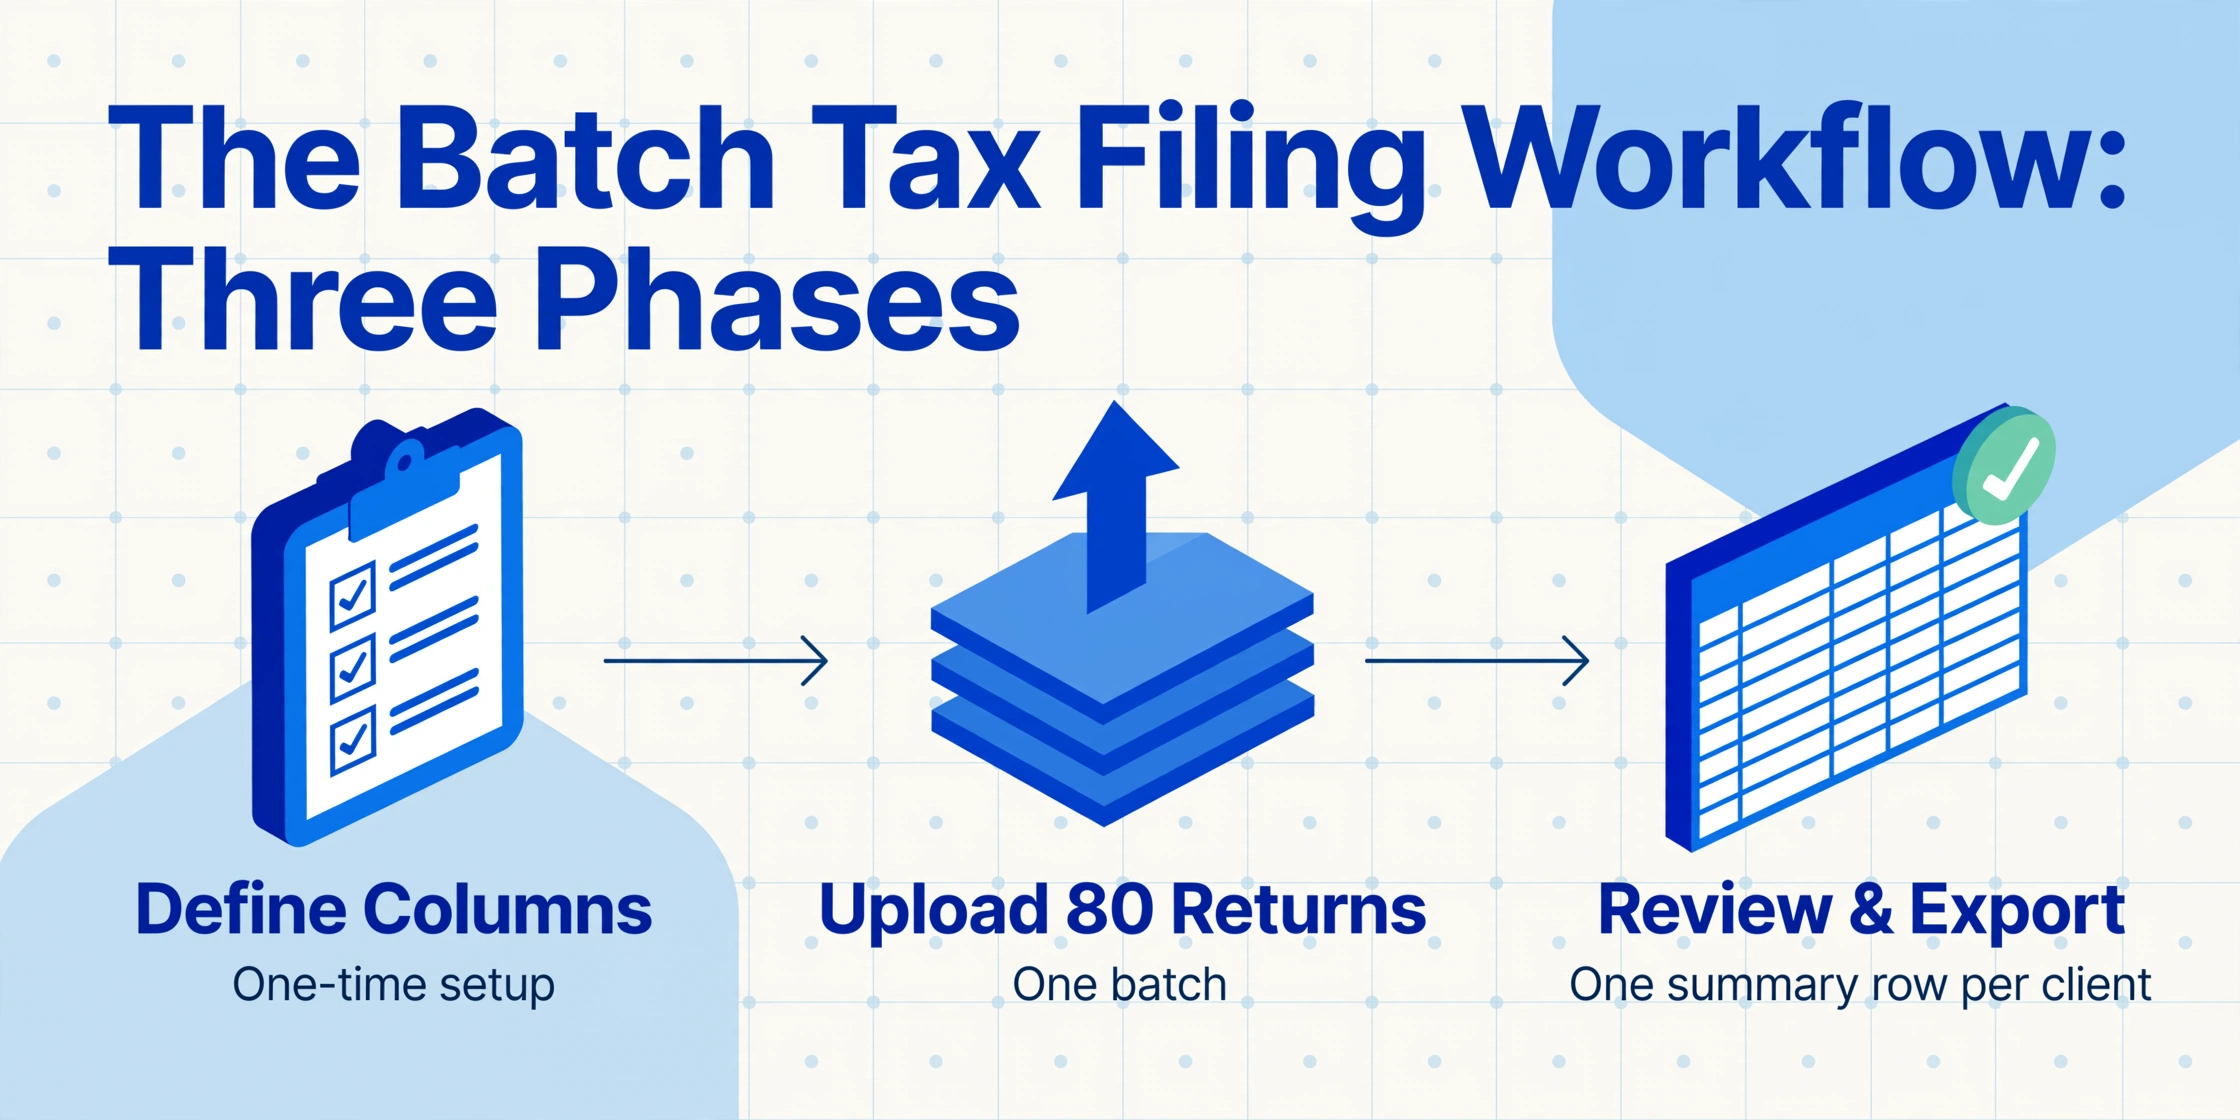
80件のクライアント申告書を処理する税理士向けのバッチ処理ワークフローは3つのフェーズで構成されており、最初のフェーズである列定義は一度設定するだけで、以降の申告シーズンごとに効果を発揮する初期投資です。
クライアントサマリーの列スキーマを一度定義する
税理士のクライアントサマリーに必要な標準的な列セットは、4つのグループで構成されます。収入項目:事業所得(収入金額)、不動産所得、給与所得、雑所得。経費項目:必要経費、所得区分ごとの純利益。控除項目:社会保険料控除、小規模企業共済等掛金控除、生命保険料控除、地震保険料控除、医療費控除、配偶者控除、扶養控除、基礎控除。税額項目:課税所得金額、算出税額、配当控除、外国税額控除、予定納税額、源泉徴収税額、納付税額または還付税額。クライアントメタデータ:クライアント名、対象年、青色申告または白色申告の区分、使用会計ソフト。これらの列が恒久的な出力スキーマとなり、毎年の申告書が、どのソフトウェアで作成されたか、またはクライアントがfreeeから弥生に途中で切り替えたかに関係なく、すべてのクライアントの申告書が同じ列にマッピングされます。
80件すべての申告書を一括アップロードする
PDFをスキャンまたは収集します。各クライアントの申告書は通常4〜6ページです。第一表が2ページ、第二表が1ページ、収入源の数に応じて収支内訳書または青色申告決算書が1〜3ページです。すべての申告書を1つのバッチにアップロードします。AIは各クライアントのページを個別に処理し、同じクライアントに属するページが1つの申告書を構成することを認識し、列スキーマで定義されたすべてのフィールドを抽出して、クライアントごとに1行を出力します。5ページにわたる申告書の場合、行が組み立てられる前に5ページすべてが読み取られるため、第一表の控除合計額が第二表の個別控除項目と照合されるなど、シート間の値が1回の処理で取得されます。処理は混合形式に対応しています。freeeで作成された申告書(サンセリフ体、右寄せの合計)、弥生の印刷物(セリフ体、異なる行間隔)、2022年に手書きで記入されたスキャン済みの紙の申告書などが、すべて同じバッチで処理されます。これは、セマンティック抽出がテンプレートの座標ではなくフィールドの意味に基づいて読み取るためです。
クライアントサマリーのスプレッドシートをエクスポートしてレビューを開始する
出力は、クライアントごとに1行、各フィールドが列に配置された1つのExcelファイルです。税理士は、80件の個別PDFではなく、構造化されたデータセットを手にします。課税所得で並べ替えて、税率区分の境界に近いクライアントを特定します。控除額の合計で並べ替えて、利用可能な控除を十分に活用していないクライアントを特定します。医療費控除の列に¥0が表示されているクライアントで、昨年病院を受診したことがわかっている場合は、レビューが必要です。予定納税額でフィルタリングして、多額の還付が見込まれるクライアントを特定します。これは3月15日の期限前のスケジュール優先事項です。さらに重要なのは、自動検証のために計算列を追加することです。個々の控除項目の合計が第一表の印刷された控除合計と一致するかどうかをクロスチェックし、不一致があれば「CHECK」ラベルでフラグを立てます。OK値の列にある1つのCHECKは、どの行を再確認する必要があるかを正確に示します。すべての行を手動で監査する必要はありません。
ファイルは安全に処理され、保存されません。
クライアント別控除比較:外れ値の検出
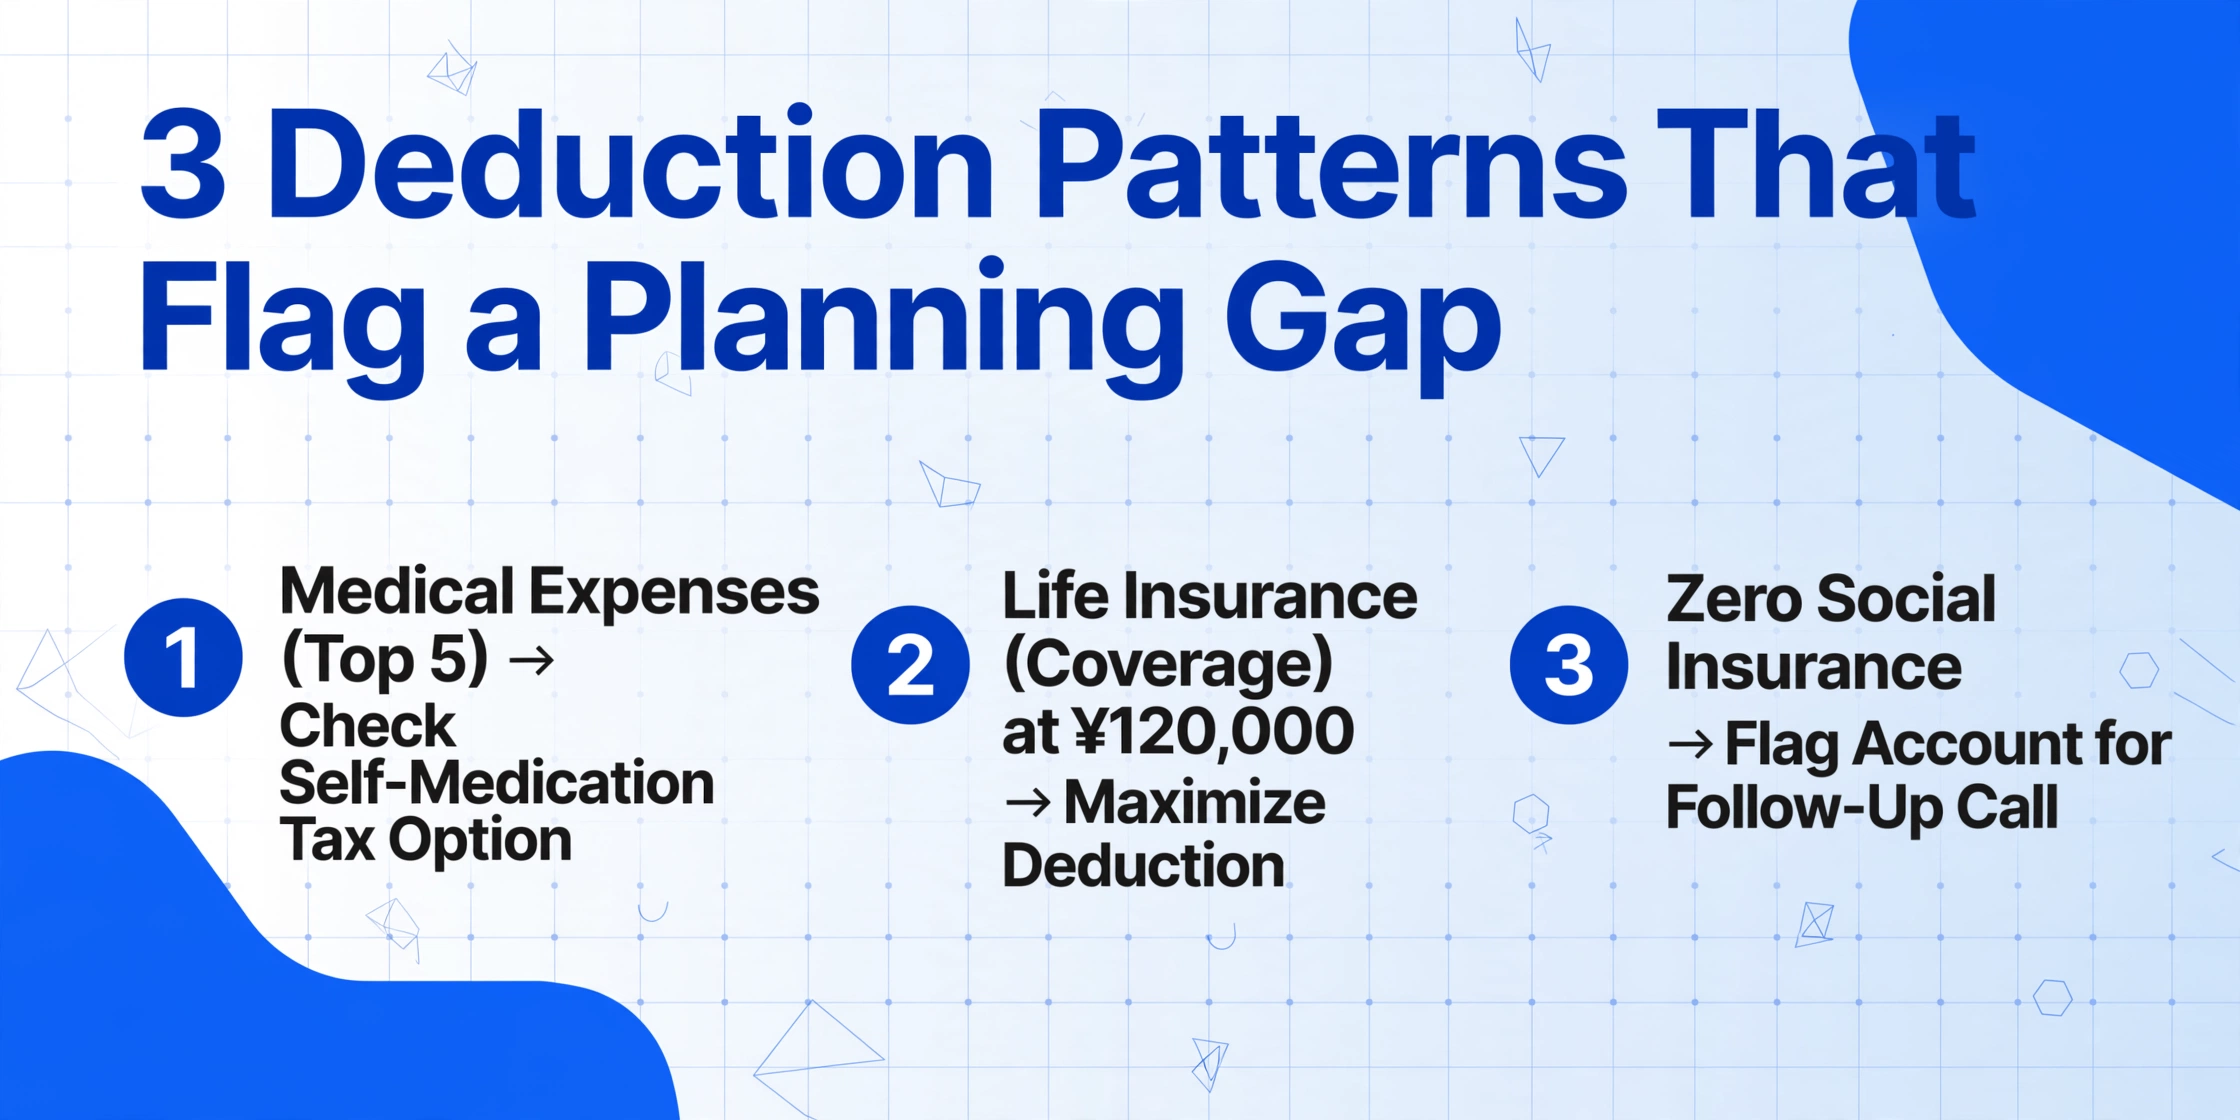
列形式のクライアント集計表は、個別PDFの束では得られないものを可能にします。それは、クライアント横断的な控除パターンの分析です。「医療費控除」列を降順に並べ替えると、上位5行が前年度に多額の医療費を費やしたクライアントを示し、その情報は、OTC医薬品の購入が12,000円を超える場合に別の控除枠を提供する、租税特別措置法第4条の5に基づく医療費控除の代替制度であるセルフメディケーション税制をクライアントが検討したかどうかを、税理士が確認するきっかけとなります。
「生命保険料控除」で並べ替えると、一般生命保険料、個人年金保険料、介護医療保険料の3つの区分(各上限40,000円)にわたる法定上限額である120,000円を示す行が、どのクライアントがこの控除を最大化しているかを示します。そのクライアントの属性に適用されるべき控除区分で0円を示す行、例えば、iDeCoが広く利用可能であるにもかかわらず、小規模企業共済等掛金控除がない自営業のクライアントは、申告期限前に5分の電話で解消できる計画上のギャップを示しています。
最も重要なパターン:控除の過少利用。 年間を通じて国民年金と国民健康保険の保険料を支払っているクライアントは、支払った全額に等しい社会保険料控除を示すはずです。その列にnullまたはゼロの値がある場合、クライアントが自営業で両方を支払っていることが分かっている状況では、抽出時にフィールドが見落とされたか、クライアントが証明書を含めなかったことを意味します。いずれにせよ、列ベースの並べ替えは申告書提出前にそれを捕捉しますが、PDFの束では5ページの文書の2ページ目に埋もれたままになります。
予定納税の管理:誰が納付、誰が還付か
日本の予定納税制度では、前年の税額が15万円を超えた納税者は、前年税額の約3分の1ずつを7月31日と11月30日までに2回前納する必要がある。予定納税額は当年のB様式に記載され、最終的な税額計算に対する控除として計上される。80人の顧客を抱える税理士にとって、予定納税は2つのワークフローの優先順位を生み出す。
第一に、予定納税額と源泉徴収税額の合計が算出税額を上回る顧客は還付対象となる。申告が早いほど還付も早く処理される。算出税額 − 予定納税額 − 源泉徴収税額の差額(マイナス=還付)で列を並べ替えれば、還付対象の顧客が申告順位の最上位に表示される。
第二に、予定納税の基準となった前年が異常に高収入だった顧客——例えば単発のプロジェクトで2024年の所得が膨らんだケース——は、数十万円も過払いしている可能性がある。予定納税額は前年の申告に基づき所得税法第107条に従って自動計算されるが、税務署は所得減少に応じて減額調整を行わない。2025年の所得が400万円だが、2024年の所得が700万円だった顧客——高い方の金額に基づいて予定納税が発生したケース——は、必要額より30万円多く支払っている可能性がある。一覧表では、「予定納税額」が「算出税額」を大幅に上回る行がすぐに目立つ。しかしPDFの束の中では、それは5ページの書類の1ページ目にある1つの数字にすぎず、税理士が全顧客についてこの2つの項目を意識的に比較しない限り見えない。
| 顧客の状況 | 予定納税額 | 算出税額 | 差額 | 優先順位 |
|---|---|---|---|---|
| 所得が700万円から400万円に減少 | 420,000円 | 110,000円 | −310,000円(還付) | 直ちに申告 |
| 所得安定、標準的な源泉徴収 | 180,000円 | 210,000円 | +30,000円(不足) | 期限までに申告 |
| フリーランス1年目、予定納税なし | 0円 | 85,000円 | +85,000円(不足) | 期限までに申告 |
| 給与+副業、源泉徴収で賄える | 0円 | 12,000円 | −138,000円(源泉還付) | 還付申告 |
税理士ソフト(弥生、TKC、MJS)との連携
日本の税理士向けソフトウェア市場は、主に3つのプラットフォームが占めています。抽出されたクライアントサマリースプレッドシートは、これらすべてに直接対応します。その理由は、いずれのソフトもクライアントデータが列形式で整理されていることを前提としているためです。
弥生シリーズ(Yayoi Tax)。 中小規模の税理士事務所で最も普及しているソフトです。弥生シリーズは、「外部データ取込」機能によりCSVインポートでのクライアントデータ移行に対応しています。抽出された「事業所得」「社会保険料控除」などの列は、弥生の内部勘定科目フィールドに直接マッピングされます。シーズン中に80件の申告書を処理する事務所の場合、CSVインポートにより、クライアントバッチごとに約16時間の手動データ入力が1回のインポート操作に置き換わります。この時間削減は、税理士の報酬を正当化する業務である、クライアントファイルごとのレビュー時間の増加に直結します。
TKC(FX2/MXシリーズ)。 中堅から大規模の税理士法人で主流のプラットフォームです。TKCのデータ移行ユーティリティは、列ヘッダー付きの整形されたCSVに対応しており、抽出結果はTKCの標準的なフィールド順序で列スキーマを定義することで、期待されるフィールド順序と一致します。シーズン中に200件以上の申告書を処理するTKC事務所では、バッチ抽出によりデータ入力フェーズが数週間のスタッフ作業から、スキャンとアップロードのみの半日作業に短縮されます。抽出機能の計算列による検証(個別控除フィールドと第一表合計のクロスチェック)は、データがTKCのレビューパイプラインに入る前に算術エラーを検出し、ファームの品質管理ワークフローを遅らせる手動上書きフラグの発生を低減します。
MJS会計(会計大将)。 企業内の経理部門と独立系税理士事務所の両方で広く使用されています。「他システムデータ取込」機能によるインポートに対応しており、抽出結果のExcel出力は中間フォーマット変換なしで直接インポートできます。MJSの内蔵監査機能(控除額合計の検証、必須フィールド欠落の検出)はインポートされた列データに対して動作し、抽出機能自身の計算列によるクロスチェックに続く第二の検証レイヤーを提供します。同一データセットに対する2つの独立した検証パスにより、どちらか一方のレイヤーでは見逃される可能性のあるエラーを捕捉します。
連携手順はプラットフォームに関わらず一貫しています。抽出ツールで一度列を定義し、シーズン分の申告書を一括アップロードし、スプレッドシートをエクスポートして、税理士ソフトにインポートします。列スキーマは年度を超えて維持されます。国税庁によるB様式の年次改訂(毎年1月の「確定申告の手引き」で公表)では、通常、行番号や説明文が調整されますが、フィールド構造は維持されます。「医療費控除」という名前の列は、2025年、2026年、2027年においても同じ概念にマッピングされます。抽出機能は、フォーム上の位置ではなく、フィールドの意味に基づいてデータを読み取ります。
複数年度の追跡:履歴データセットの構築
2026年に80件の申告書を処理し、2027年も同じ列スキーマを使用する税理士は、従来は何年もの手作業による再入力でのみ可能だったデータセット、すなわちすべてのフィールドが同じ列位置に揃えられた複数年度の顧客履歴を作成できます。2027年のスプレッドシートを開き、顧客IDで2026年のデータと結合すれば、各顧客に年度ごとに1行ずつ、計2行が表示され、すべてのフィールドが同じ列に配置されます。「事業所得」で並べ替え、すべての顧客について2026年と2027年を数秒で比較できます。2026年に「生命保険料控除」が12万円だった顧客が、2027年に0円に減少した場合、その理由を確認できます。「医療費」の「事業所得」に対する比率が上昇傾向にあるかどうかを追跡し、顧客が個人的な経費を誤って分類している可能性を示すシグナルを検出できます。
今年構築するデータセットは、来年のレビューにおける優位性です。2026年の列形式データを横に置いて2027年の顧客申告書をレビューする税理士は、PDFのみのレビューでは不可能な情報密度で業務を行えます。列形式の履歴により、すべての前年比較が瞬時に行え、異常値を浮き彫りにする比較は、各年の申告書が別々のPDFフォルダに保存されている場合には税理士が行う時間を持てないものです。
同じバッチ処理ロジックは、類似した申告書構造を持つ税務管轄区域にも適用できます。英国の税理士が80件のSA100セルフアセスメント申告書を1つの集計スプレッドシートに処理する場合も、同一のワークフローに従います。申告書のフィールドの列を定義し、すべての申告書を一度にアップロードし、顧客ごとに1行を受け取ります。フォームの言語や控除名は「医療費控除」から「盲人者控除」に変わりますが、バッチ処理の原則と、申告書ごとの手動入力に対する効率性の向上は変わりません。
同様に、バッチ手法は税務申告書の基礎となる添付書類にも拡張できます。50件の日本の発注書をバッチ処理して1つの調達ダッシュボードにまとめる購買部門も、同じ「列定義は一度、バッチアップロードはすべて」のパターンを使用します。出力されるスプレッドシートは、50行の単純なリストでは答えられない、仕入先別支出、税率別消費税、決済日別支払いといった質問に答えます。バッチの原則は文書の種類に依存しません。スキーマを一度定義し、すべてをアップロードし、文書ごとに1行を取得します。変わるのは列名とレビューの質問であり、ワークフローではありません。
よくある質問
バッチ処理で、白色申告と青色申告のクライアントを同じアップロードで処理できますか?
はい。B様式自体は白色申告と青色申告の両方で同一です。違いは添付書類にあります。白色申告のクライアントは簡易な収支内訳書を添付します。青色申告のクライアントは、貸借対照表、損益計算書、経費内訳を含む詳細な青色申告決算書を添付します。どちらも申告書と一緒に同じバッチでアップロードできます。抽出は各書類を独立して読み取ります。青色申告のクライアントには追加の列(貸借対照表からの資産、負債、純資産)が入力され、白色申告の行は空白のままになります。列スキーマは両方に対応しています。すべての可能な列を定義すれば、該当データのないクライアントの行は単に空セルになります。
クライアントが昨年と今年で会計ソフトを変更した場合(昨年freee、今年弥生)はどうなりますか?
ここで、意味的抽出を用いたバッチ処理が真価を発揮します。freeeが生成した申告書と弥生が生成した申告書は、同じB様式でもフォント、行間、セクションの順序が異なります。freeeの出力に合わせて調整されたテンプレートベースの抽出ツールでは、弥生の印刷物のすべてのフィールドがずれてしまいます。意味的抽出は、「社会保険料控除」をフィールドラベルで読み取るため、フォント、行位置、間隔は無関係です。両方の年の申告書を同じバッチにアップロードすれば、「社会保険料控除」列には、どのソフトウェアで生成されたかにかかわらず、各年の申告書から正しい値が入力されます。最も重要な複数年の比較(この控除額に変化があったか)は、クライアントがソフトウェアを変更しても破綻しません。
80件の申告書を1つのバッチで処理するのにどのくらい時間がかかりますか?
一般的な確定申告書は4~6ページです。80件の場合、約320~480ページになります。時間がかかるのはPDFのスキャンまたは収集ですが、これは期ごとに一度の作業であり、多くの税理士は会計ソフトを使用するクライアントから既にPDFを受け取っています。アップロード後、AIは各申告書を独立して処理します。総処理時間はページ数とサーバー負荷に依存しますが、80件のバッチは通常30分未満で処理が完了します。手作業での再入力に16時間以上(丸2営業日)かかるのと比較すると、このワークフローの変更により、クライアントが実際に費用を支払うレビューやアドバイザリー業務に時間を充てることができます。
抽出機能で、クライアントの収支内訳書の合計額がB様式に転記された金額と一致するか確認できますか?
はい、計算列を使用して可能です。検証用の列を定義します。「収支内訳書 vs. 第一表 収入金額 — 一致? 'OK' : 'CHECK'」とし、収支内訳書の収入合計と第一表の対応する収入フィールドを比較します。抽出機能は同じクライアントバッチ内の両方の書類を読み取り、比較列を自動的に入力します。この列に「CHECK」と表示された場合、収支内訳書と申告書が一致していないことを意味し、まさに税務調査の対象となるような不一致です。申告書提出前に税理士事務所でこれを発見できれば、事後修正の最も一般的な原因を排除できます。
過去に紙で申告し、スキャンコピーしかない顧客でもバッチ抽出は機能しますか?
はい、機能します。2023年と2024年に紙で申告し、2025年からfreeeに切り替えた顧客の場合、過去2年分の申告書はファイルフォルダに保管された印刷物のみです。これらの書類をスキャンするか、スマートフォンで均一な照明の下で撮影し、2025年のPDFと一緒にアップロードしてください。抽出機能は、ソフトウェアで生成されたPDFと同様に、スキャンした紙の申告書も読み取ります。形式ではなく、フィールドの意味に基づいて処理します。出力される3行(2023年、2024年、2025年)は同一の列構造を持ち、これまで紙の申告書を手入力しなければ不可能だった前年比較を可能にします。これは、複数年の所得証明書類が必要な融資申請、ビザ更新、または税務調査において特に有用です。
2月をデータ入力ではなくレビューに充てる
日本の個人所得税の申告期間(2月16日~3月15日)は法律で定められています。この期間における税理士事務所の収益性は、2月の時間をデータ入力とデータ分析のどちらにどれだけ費やすかに大きく左右されます。ここで説明したバッチ処理ワークフローは、その比率を変えます。半日のスキャンと列定義で2日分の再入力が不要になり、抽出された顧客サマリー(顧客ごとに1行、各フィールドが所定の列に配置、控除額合計は第一表と照合済み)がレビュー開始時の実務文書となります。
一度定義した列スキーマは、以降のすべての申告シーズンで有効です。比較分析(控除の未活用、前払税金の過払い、損益計算書の調整)は、データがすでに列に整理されているため、数秒で完了します。そして、複数の申告シーズンにわたって構築されたデータセットは、年を追うごとに価値を増す資産となります。単年度のPDFでは見えない傾向を明らかにする、複数年にわたる顧客の履歴です。毎年2月に変わるのは、申告書の形式ではありません。それは、すでに印刷されている数字を税理士が入力に費やす時間と、その報酬を正当化するパターンを見つけるために費やす時間の配分なのです。