50件の日本語発注書、1つの
調達ダッシュボード
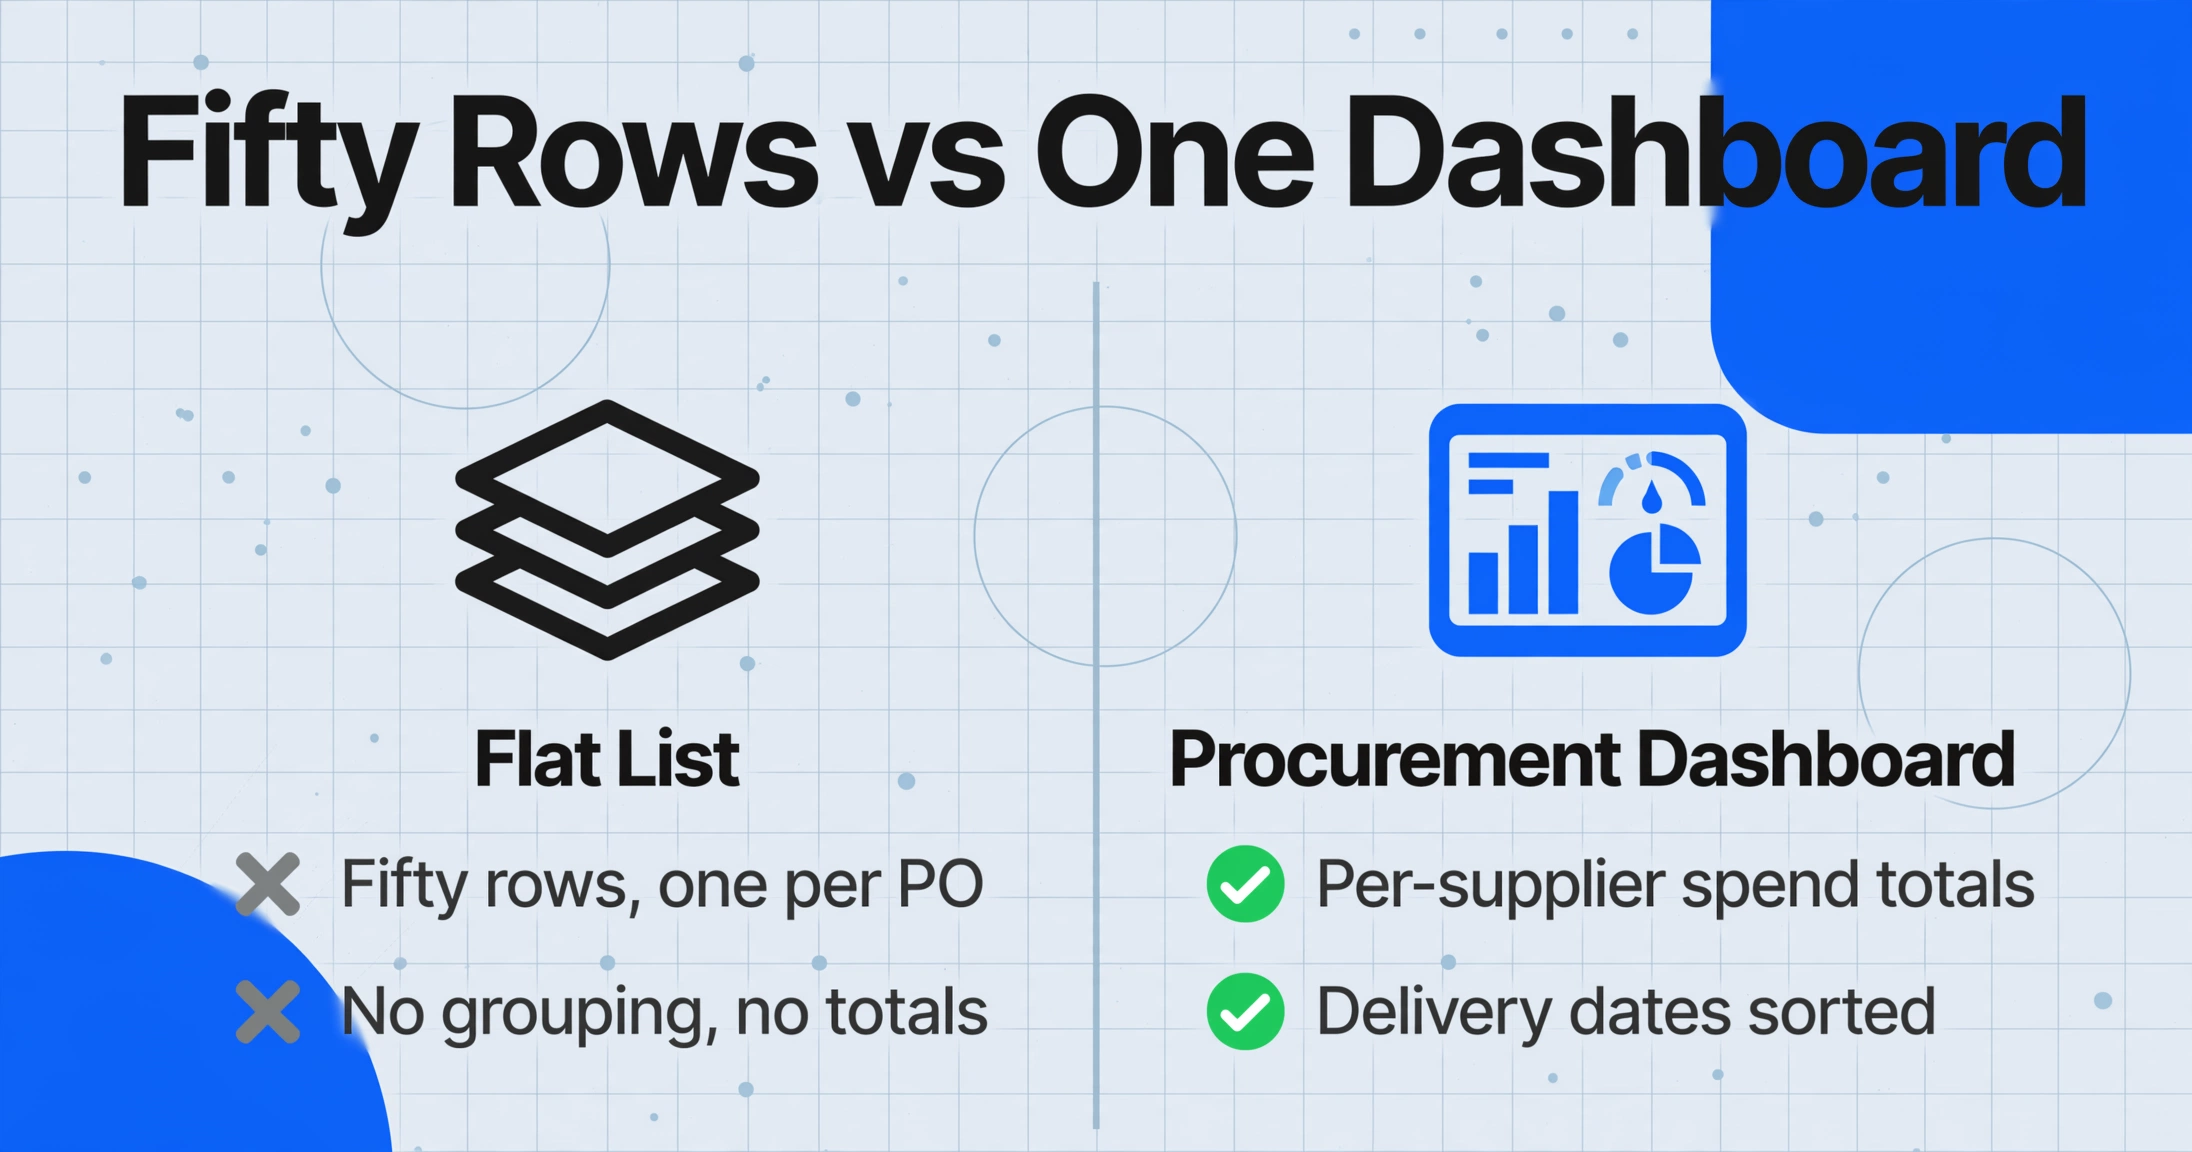
毎月50件の仕入先発注書(発注書、hatchūsho)を受け取る調達部門は、通常、正確なスプレッドシート1つと、答えの出ない4つの質問を抱えることになります。スプレッドシートには発注書ごとに1行 — 発注番号、仕入先、品目、数量、単価、行合計、納期、支払条件(支払条件)、消費税区分(消費税区分)— が各PDFから忠実に入力されています。調達マネージャーが実際に答える必要がある4つの質問:各仕入先にいくら使っているか、今週納品予定のものはどれか、税率区分別の消費税負担はいくらか、各締日(締日、shimebi)にいくらの現金が出ていくか。50行のフラットなリストでは、ピボットテーブルなしにはこれらのどれにも答えられません。列指向のダッシュボード — 同じデータを各質問に答える次元でグループ化・並べ替え・小計するもの — には、数式が読み取れる列にデータが構造化されている必要があります。リストとダッシュボードのギャップは、Excelの機能の問題ではありません。そもそも誰かが50枚のPDFを開いてリストを作っていることが問題なのです。
重要ポイント
- 50件の日本語発注書を手作業で処理すると、調達チームは毎年14時間を費やします — そしてそれは目に見えるコストです。
- 目に見えないコスト:フラットな行のリストでは、どの3社が予算の45%を占めるか、どの納期が同じドックで衝突しそうかは決してわかりません。
- ダッシュボードに必要な12列を一度書き出し、50件すべての発注書を一度に投入すれば、支出・納品・税・支払いの4つのダッシュボード次元は、別の分析プロジェクトではなく、デフォルトの出力になります。
個々の発注書50件を集めても調達ダッシュボードにはならない理由
単一発注書の抽出ワークフロー(日本語の発注書データ抽出ステップバイステップガイドで解説)は、発注書1件あたりの手入力を数分から数秒に短縮します。列名を12個定義し、発注書をアップロードすれば、構造化された行が得られます。月に50件の発注書を受け取る調達マネージャーにとって、このワークフローは個々の発注書の処理を高速化します。しかし、50件の発注書の集合体を有用なものにはしません。
リストとダッシュボードの構造的な違いは、ダッシュボードが単一の行では表現できない次元でデータをグループ化する点にあります。仕入先別の総支出、日付順に並べた納期、税率区分別の消費税合計、締日ごとにまとめた支払義務などです。
1件の発注書の行からは、三菱ケミカルがガスケットAを2,000個、単価480円(税抜)で納品し、合計960,000円、8月15日に埼玉工場へ納品、支払条件は20日締翌月末払い、ということがわかります。しかし、1件の行からはわからないことがあります。今月、三菱ケミカルからの他の8件の発注書を合わせると総支出が340万円になり、調達量で2番目に大きな仕入先になること。4件の異なる仕入先からの発注書の納期がすべて今後7日以内にあり、物流チームが統合ピッキングリストを必要としていること。発注書の明細行のうち820万円が10%の標準税率、食料品関連の明細行160万円が8%の軽減税率で課税されており、この2つの税率区分にまたがる調達の税負担が翌四半期の消費税申告を左右すること。12社の仕入先が20日締めで、その合計支払義務は510万円、一方6社は月末締めで合計280万円——2つの支払日に異なる流動性への影響があること。
これら4つの答えは、同じ50件の発注書ドキュメントの中に存在します。しかし、それらの発注書を1件ずつフラットな行に処理している間は見えません。データが欠けているからではなく、行と行の関係こそがリストをダッシュボードに変える唯一の要素であり、1件ずつ処理する人間は50件の行が揃うまで関係性を見ることができないからです。最後の発注書を入力する頃には、最初の発注書と、同じ仕入先からの次の8件との関係は、記憶であって列ではありません。
ファイルは安全に処理され、保存されません。
抽出スキーマ:4つのダッシュボード軸を支える12の列
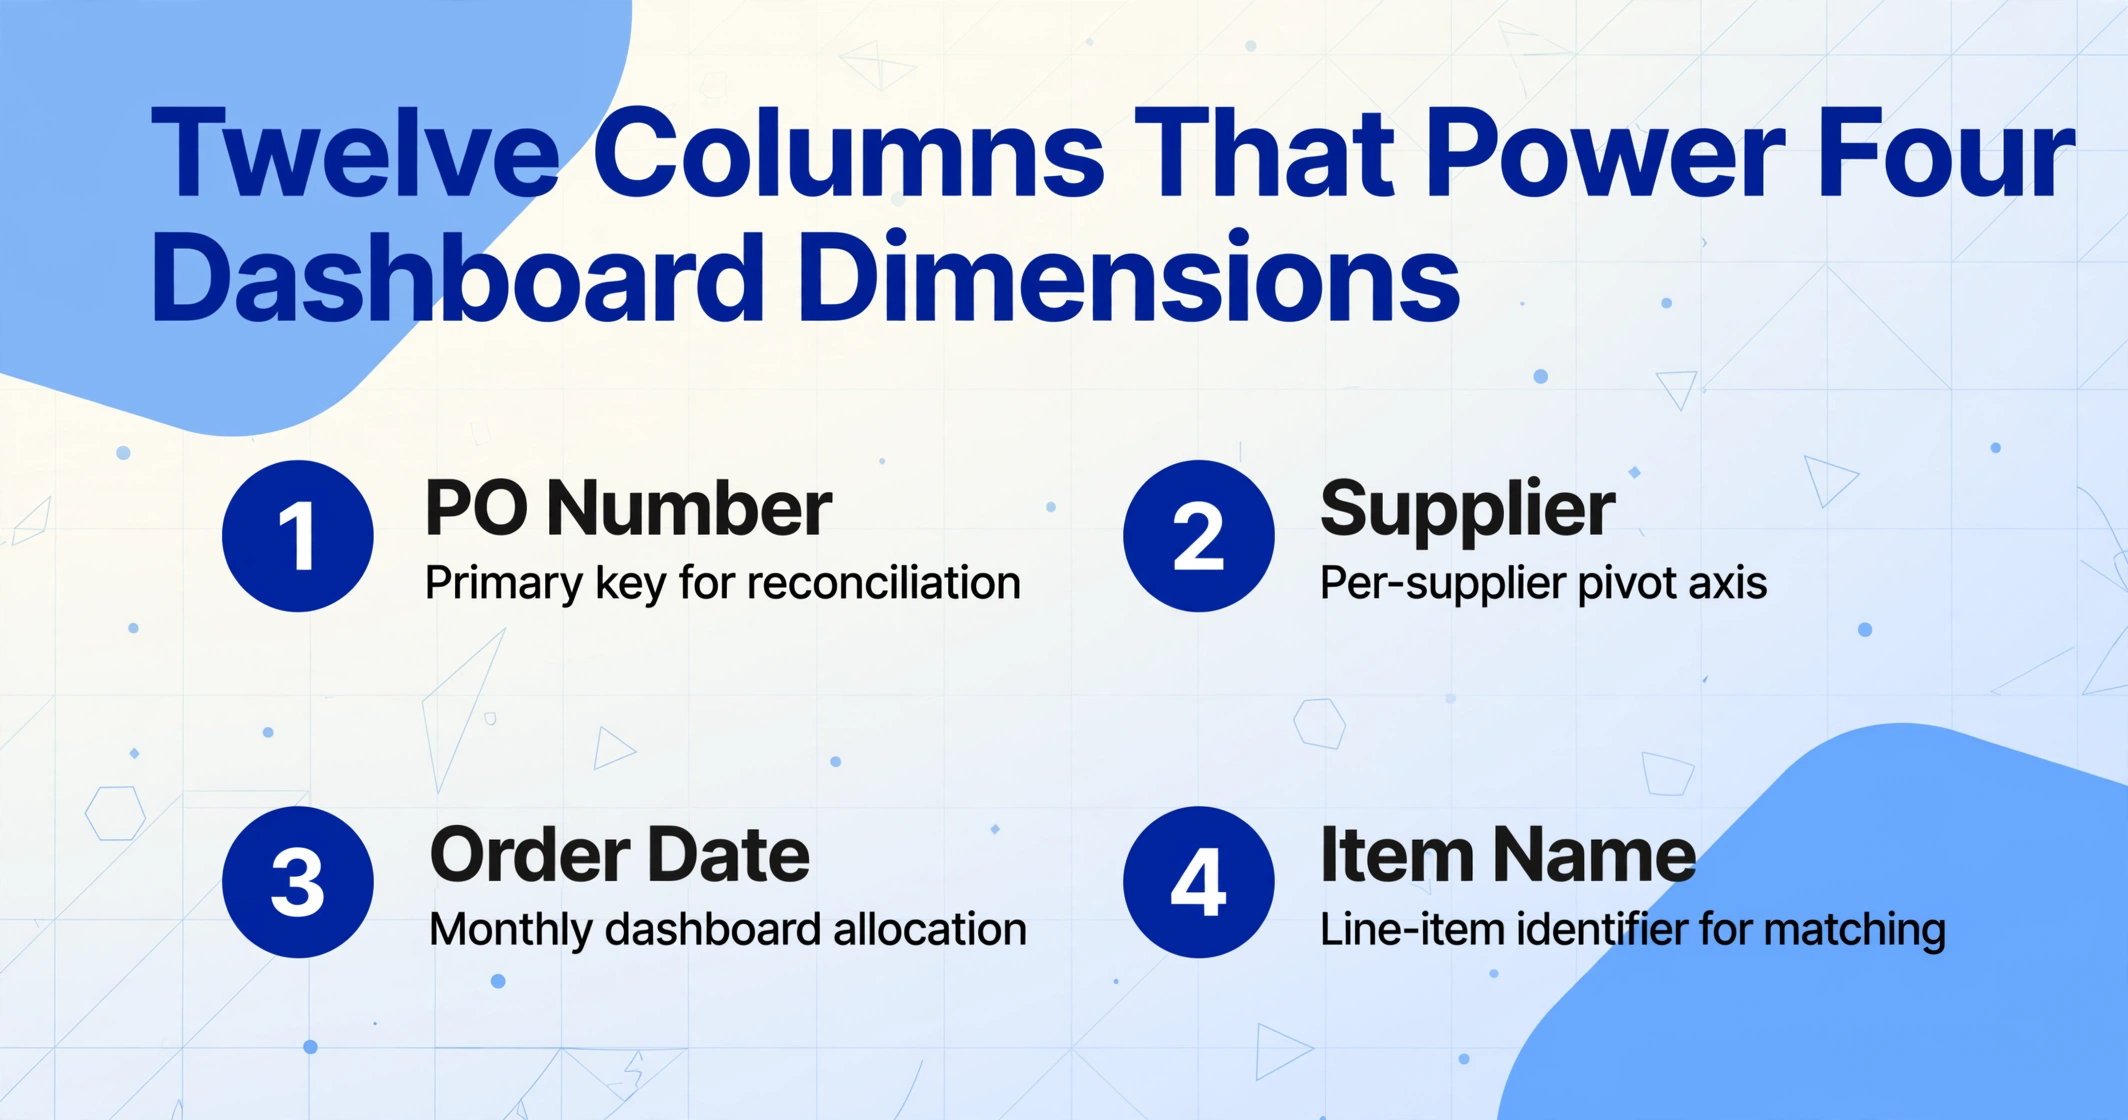
日本語の発注書バッチの抽出スキーマは、単票の発注書抽出のスキーマとは異なります。文書が異なるからではなく、出力先が異なるからです。単票抽出は読むための1行を生成します。バッチ抽出はピボット式が読むテーブルを生成します。単票のワークフローでは暗黙のままにできる分類フィールドも、ダッシュボードでは明示的なディメンションとして扱う必要があるため、列セットに含める必要があります。
カスタム列抽出 — 列名を入力すると、AIが各文書上の該当データを、位置ではなくフィールドの意味を理解して特定する方式 — では、日本語の発注書ダッシュボード用のバッチスキーマは、単票の列セットに2つの分類列を追加します:
| 列名 | 型 | ダッシュボードでの役割 |
|---|---|---|
| PO Number | Identity | 主キー — 3点照合ワークフローにおいて、発注書の行を対応する納品書および請求書にリンクします |
| Supplier | Grouping Dimension | 仕入先ごとのピボット軸。一貫して抽出する必要があります — ある発注書で「㈱日立製作所」、別の発注書で「日立」とするとピボットテーブルが壊れます。発注書のヘッダーに印刷されている正式な仕入先名を使用してください |
| Order Date | Period Allocation | 発注書が属する月次ダッシュボードを決定します。9月30日付の発注は、納品がいつ届くかに関係なく9月のバッチに属します |
| Item Name | Detail | 明細行の識別子。仕入先固有の略称が一般的です — SUS304 vs ステンレス、一式 vs batch — 請求書照合のため、記載どおりに抽出する必要があります |
| Quantity | Detail | 数値の数量。単位は別途抽出してください: 個、式、kg、m、時間。発注書と請求書の単位不一致は照合の痛点です — 発注書では1式、請求書では5個と明細化されているケース |
| Unit Price | Detail | 通常は税抜。請求書では税込単価が表示される場合があります — 税抜の発注書価格と税込の請求書価格を比較すると誤った不一致が発生します |
| Line Amount | Detail | 数量 × 単価。納品書および請求書との明細行レベルの照合に使用します |
| Delivery Date | Timeline Dimension | 商品が到着しなければならない日付。この列で並べ替えて、物流チーム向けの週次納品ピックリストを作成します。今後7日以内の日付の発注書が対応対象のサブセットです |
| Delivery Location | Routing | 具体的な納入先 — 多くの場合、工場名、建物、組立ライン。例: 「株式会社〇〇 埼玉工場 第二組立課 B棟3階」。物流ルーティングには粒度が重要であり、省略せず完全に抽出する必要があります |
| Payment Terms | Cash-Flow Dimension | 複合文字列で表される支払スケジュール:「20日締翌月末払い」は締日が20日、支払いは翌月末まで。「月末締翌々月末払い」は月末締め、支払いは翌々月末まで。計算列で締日を数値として抽出できます — 20、31、または特定の日 — キャッシュフローダッシュボードのグループ化キーを作成します |
| Consumption Tax Classification | Tax Dimension | 推論列 — AIが抽出時に各明細行を分類します: 10%標準(標準的な商品およびサービス)、8%軽減(食品、非アルコール飲料、定期購読新聞)、または非課税(輸出、特定の医療および教育サービス)。この列は発注書に印刷されたフィールドではなく、AIが抽出時に品目説明から導出する分類です。この列でグループ化して、税率区分ごとの調達税負担を明らかにします |
| Total Amount | Aggregation | 発注書レベルの合計で、通常は税抜。仕入先ごとに合計して仕入先別支出を算出します。締日ごとに合計して締日別の支払額を算出します |
支払条件と消費税区分という2つの分類列が、フラットなリストをダッシュボードに変えます。これらがなければ、仕入先別の支出が並べ替えと合計で計算できる唯一のディメンションです。これらがあれば、4つのディメンションが開けます:誰から買っているか、いつ届くか、どう課税されるか、いつ支払うか。
JFTCの必須記載事項(下請代金支払遅延等防止法に基づく)により、法令に適合した日本語の発注書にはすべて同じコアデータが含まれます。形式は仕入先によって異なります — 三菱ケミカルの発注書レイアウトは、地場の下請け業者の手書きファックスとは何の共通点もありません — しかし、フィールドの内容は同じ構造に従います。抽出AIは位置ではなくフィールドの意味で読み取ります:発注番号は、ブランドのレターヘッドの右上に印刷されていようと、ファックス用紙の欄外に鉛筆で書かれていようと、すべての発注書の一意の識別子です。同じ意味論的ロジックが、すべての仕入先の形式にわたってすべての列を特定します。スキーマは一度定義され、50件の発注書に適用されます — そして来月も、その翌月も。
月次バッチ処理:発注書50件を1回のアップロードで1つの構造化スプレッドシートに
スキーマを定義したら、月次バッチ処理はデータ入力からデータ整理へと移行します。バッチワークフローは、単一の発注書ワークフローと、50件規模で重要となる3つの点で異なります。ファイル命名は来歴レイヤーとなり、並列処理でドキュメントごとの待ち時間が短縮され、検証は全行ではなく外れ値に焦点を当てます。
仕入先の発注書を月別に整理 — フォルダ構造が監査証跡
月ごとのフォルダを作成します:/Procurement/POs/2026_08/。8月中に届くすべての仕入先発注書(商社からのメールPDF、中小メーカーからのFAX出力、地元下請け業者からのスキャン紙フォーム)はこのフォルダに入れます。ファイル名には仕入先を識別できる情報を含めます:scan001.pdfではなくMitsubishiChemical_PO-2026-089.pdf。抽出出力にソースファイル名列が含まれる場合、ダッシュボードの各行は特定のPDFに遡って追跡でき、仕入先キー付きファイル名の50件のPDFフォルダがあれば、ソースドキュメントを1つも開かずにダッシュボードを監査対応にできます。
50件すべての発注書を1つのバッチでアップロード — スキーマが全ドキュメントを同一に処理
月間フォルダの全ファイルをアップロードキューにドロップします。バッチ処理は50件のドキュメントを1つのジョブとして処理します。各発注書は同じ列スキーマで独立して処理され、すべての結果が1つのスプレッドシートに統合されます。AIは各ドキュメントを意味的に読み取ります。発注番号は、フォーマットされたPDFヘッダーに発注番号: PO-2026-089と表示されていても、手書きのFAXにPO No. 089と走り書きされていても、発注番号は発注番号です。12列のスキーマが50件すべての発注書で機能するのは、フィールド定義がデータの所在ではなく、データが何であるかを記述しているからです。処理は並列で実行されるため、50件の発注書は1件とほぼ同じ時間で完了します。
全行ではなく外れ値を検証
出力は12列×50行のスプレッドシートです。50件規模での手動検証は、行ごとのチェックから外れ値の検出に移行します。合計金額の降順で並べ替え、上位5件の発注書をスポットチェックします。月間支出の60%を占める最大の調達コミットメントは、抽出エラーの財務的影響が最も大きい行です。消費税区分で並べ替え、食品ライン項目が8%軽減税率、標準品ラインが10%標準税率に分類されていることを確認します。仕入先列に名前の不整合がないかスキャンします。「㈱日立製作所」と「日立」が別々の仕入先として表示されている場合、これらは同一ベンダーであり、ピボットテーブルで二重計上されます。ダッシュボードステップの前にスプレッドシートで仕入先名を修正するか、より良い方法として、スキーマ定義時に仕入先名を正式な登録名に正規化する列ルールを追加します。
出力は、各行が発注書の明細項目、各列が12個のスキーマフィールドの1つに対応する単一のスプレッドシートです。スプレッドシートの構造(同じ列、同じ順序、同じフィールド定義)は、スキーマが再構築されるのではなく再利用されるため、毎月同一です。1月のスキーマに基づいて構築されたダッシュボードは、再フォーマットなしで2月の出力で機能します。一貫性は構造的なものであり、習慣的なものではありません。
ダッシュボードの読み方:1つのスプレッドシートが明らかにする4つの調達ディメンション
50件の発注書明細項目が12列に構造化されているため、ダッシュボードはピボットテーブルと並べ替えビューのセットであり、それぞれが調達マネージャーが毎月必要とする4つの質問の1つに答えます。ダッシュボードは別のドキュメントではありません。これは、12列のサブセットを使用して、4つの異なるレンズを通して見た同じスプレッドシートです。
仕入先別発注書合計 — 誰が調達支出のどのシェアを取得しているか
最初のディメンションは、仕入先列で行をグループ化し、合計金額を合計します。これら2つの列のピボットテーブルは、ランク付けされたベンダー支出リストを生成します:仕入先A:¥5.2M、仕入先B:¥3.4M、仕入先C:¥2.8M、そして30以上のベンダーすべてを通じて続きます。これは、50行のフラットリストが不明瞭にするディメンションです。なぜなら、同じ仕入先の発注書(三菱ケミカルは今月9件、小さな下請け業者は1件)が、注文日ごとに時系列でインターリーブされているためです。仕入先でグループ化すると、集中度が明らかになります:3つの仕入先が月間調達支出の45%を占めています。この集中度は、発注書を1つずつ処理し、各行を順番に入力する場合には見えません。
仕入先別ビューは、手動入力が日常的に見逃すパターンも浮き彫りにします:同じ品目が2つの異なる仕入先から2つの異なる単価で注文されているケースです。仕入先AがガスケットAを1ユニットあたり¥480で見積もり、仕入先Bが別の発注書で同じ品目を¥510で見積もる場合、仕入先別ピボット(品目名でフィルタリング)により、価格差が単一の行の比較になります。フラットリストでは、2つの行は他の30のエントリによって分離され、差分は人間が気付く必要があります。ダッシュボードでは、すべての仕入先にわたる「ガスケットA」のフィルタは1クリックです。
納品スケジュール — 今週が納期の発注書
2つ目のディメンションは、50行を納期日の昇順で並べ替え、今週または今後7日間に絞り込みます。物流に関わる列は、仕入先、品名、数量、納品場所です。出力は受入チーム用のピックリストです。「今週は、埼玉工場の組立ライン3で三菱ケミカルからガスケット2,000個、横浜工場で住友から切削油500リットル、メイン倉庫で地元の仕入先から梱包材12箱を受け入れる予定です。」各行には、特定の受入ドックに対応する納品場所があります。
このビューは納期日のクラスターも浮き彫りにします。5つの異なる仕入先からの7件の発注書がすべて8月28日納期です。物流チームは8月28日が大量受入日であることを事前に把握でき、ドックスペースと検品スタッフを適切に割り当てられます。これは、納期日が50件の個別PDFに散在し、単一のタイムラインにまとめられていない場合には不可能な計画判断です。
消費税区分別内訳 — 税率区分別の調達税負担
3つ目のディメンションは、消費税区分列で行をグループ化します。これは、抽出時にAIが各明細行を10%標準、8%軽減、または非課税に分類した推論列です。この列を明細金額に対してピボットすると、各税率の課税ベースが合計されます。
| 税区分 | 課税ベース(税抜) | 消費税 | 月間調達額に占める割合 |
|---|---|---|---|
| 10%標準 | ¥8,200,000 | ¥820,000 | 72% |
| 8%軽減 | ¥1,600,000 | ¥128,000 | 14% |
| 非課税 | ¥1,500,000 | ¥0 | 13% |
| 合計 | ¥11,300,000 | ¥948,000 | 100% |
この内訳が重要な理由は2つあります。1つ目は、消費税申告に直接つながることです。調達側の仕入税額控除には、2023年10月に施行されたインボイス制度に準拠するため、課税仕入額を10%と8%の税率区分別に区分する必要があります。各仕入先の請求書の税額内訳が発注書の税区分と一致するかを検証する請求書照合ステップでは、このダッシュボードビューを参照テーブルとして使用します。仕入先の請求書が、発注書で8%軽減に分類された食品明細行に10%の消費税を請求している場合、支払承認前に差異が明らかになります。
2つ目は、予算インプットとしての役割です。月間調達支出の72%が10%税率の場合、調達予算の消費税部分は月額約¥820,000になります。これは、財務チームが月末に仕入先の請求書が届き、税額合計が内部見積もりと一致しないことを発見するのではなく、事前に予測できるキャッシュフロー項目です。
締日別の支払条件 — 締日ごとにグループ化された支払義務
4つ目の軸は、支払条件列から抽出した締日(shimebi)ごとに発注書の合計をグループ化します。日本の発注書では、支払条件は単純な「Net 30」の日付計算ではなく、複合的な慣例として表現されます。一般的なパターンは以下のとおりです。
| 発注書の支払条件 | 締日 | 支払猶予(締日から数ヶ月後) | 実務上の意味 |
|---|---|---|---|
| 20日締翌月末払い | 20日 | 約1 | 先月21日から当月20日までの取引をまとめて精算。翌月末までに支払い |
| 月末締翌月末払い | 月末 | 1 | 1暦月分の取引をまとめて精算。翌月末までに支払い |
| 月末締翌々月末払い | 月末 | 2 | 1暦月分の取引。翌々月末までに支払い — 製造業で一般的、実質60日条件 |
| 10日締翌月末払い | 10日 | 約1.5 | 先月11日〜当月10日までの取引。あまり一般的ではないが、一部の大企業バイヤーが使用 |
計算列 — AIが抽出中に計算する列(文書から直接読み取るのではなく)— は、支払条件の文字列を2つの構造化された値に解析します:締日(日番号 — 20、31、10)と支払いラグ(締めから支払いまでの月数 — 翌月末は1、翌々月末は2)。ダッシュボードは発注書の合計を締日ごとにグループ化します:
| 締日 | 仕入先数 | 発注書合計(税抜) | 支払予定日 |
|---|---|---|---|
| 20日締 | 18 | ¥6,300,000 | 翌月末 |
| 月末締(翌月払い) | 8 | ¥3,100,000 | 翌月末 |
| 月末締(翌々月払い) | 4 | ¥1,900,000 | 翌々月末 |
締日グループ化は、調達ダッシュボードのキャッシュフロー軸です。20日締めの18社は、当月20日から約40日後に支払うべき630万円の支払義務を表します。翌々月払いの4社は、190万円をさらに1ヶ月延期します。財務チームは、個々の発注書ではなく、日付クラスターごとの支払いプロファイルを把握でき、50件の個別の支払期日ではなく、2つの支払いの波に合わせて運転資金を計画できます。
月次ダッシュボードから年度別調達分析へ
月次バッチワークフローは、運用期間が長くなるほど価値が高まります。1月のダッシュボードは、1月分の4つの調達質問に答えます。12か月分のダッシュボードを1つの年度別調達台帳に積み重ねると、別の質問に答えることができます。どの仕入先がQ1からQ3にかけて調達支出のシェアを伸ばしたか、季節的な納品パターンが物流スタッフ配置にどう影響するか、消費税率構成が仕入先構成の変化に伴って変わったか、そしてどの仕入先が一貫して長い支払条件を使用しているか——これは年間契約更新時の交渉材料になります。
ダッシュボード構造により、年間集計は再構築作業ではなく構造的な操作になります。各月のスプレッドシートには同じ12列が同じ順序であります。1月から12月を1つの年間台帳に積み重ねるのはコピー&ペースト操作です——スキーマが変わらないため列が揃います。月列を追加して出所を保持すれば、年間台帳は四半期ごとの比較ビューをサポートします。Q1(多くの日本企業は3月決算のため4月~6月)でフィルタリングし、仕入先でピボットし、Q2の仕入先支出と比較できます。Q1からQ3にかけてシェアが30%増えた仕入先は、12か月の個別リストでは決して明らかにならない調達トレンドです。
2026年8月の発注書を処理した同じ12列スキーマは、2025年8月の発注書も処理します——法人税法が企業に7年間の保管を義務付けるアーカイブ文書です。前年度の発注書を遡ってバッチ処理することで、PDFファイルのアーカイブが、監査人が仕入先、月、税区分でナビゲートできる構造化された調達台帳に変わります——元の文書を開くことなく。節約される時間は抽出ステップではなく、前年度の50件の発注書を今月分と同じ速さで処理します。監査対応で節約されます。税務署が2025年度の100万円超の発注書をすべて要求した場合、ダッシュボードを合計金額の降順でフィルタすれば、文書のトレーサビリティを備えたソート済みリストを1分以内に提供できます。
この複数期間バッチ統合パターンは、同じ基本ロジックで税務管轄を越えて適用できます。複数の報告期間にわたって1つの抽出スキーマを適用すると、1つの統合台帳が生成されます。オーストラリアの簿記担当者が4つの四半期BAS申告を1つの年間税務台帳に統合するために使用する四半期バッチアプローチや、カナダの会計士がGST/HST申告を1つの年間税務サマリーに統合する際のアプローチも、同じ構造に従います。列を一度定義し、毎期同じスキーマを実行し、統合を構造から生じさせます。税務フィールドは管轄ごとに変わりますが、バッチ原則は変わりません。
FAQ
各仕入先が異なるPO形式を使用している場合、バッチワークフローは機能しますか?
はい — それがテンプレートベースのOCRに対するセマンティック抽出の決定的な利点です。テンプレートベースのツールでは、仕入先の形式ごとに個別の解析テンプレートが必要であり、仕入先が帳票を再設計したりERPをアップグレードしたりすると、テンプレートが壊れます。セマンティック抽出は、データの意味を理解して各POを読み取ります — 発注番号は、三菱ケミカルのPDFのフォーマットされたテーブルブロックに表示されるか、下請け業者のFAXフォームに手書きされるかに関係なく、識別子です。12列のスキーマは、AIがフィールドの位置ではなくフィールドの意味を検索しているため、バッチ内の50件すべてのPOで機能します。来月、仕入先がPOレイアウトを変更しても、同じスキーマは引き続き機能します — 更新する必要はありません。
ダッシュボードは、10%と8%の消費税率の明細項目が混在する単一のPOをどのように処理しますか?
消費税区分列は、POレベルではなく明細項目レベルで適用されます。3つの明細項目(10%の標準品2つと8%の食品1つ)を持つ単一のPOは、それぞれ独自の税区分を持つ3行をダッシュボードに生成します。ダッシュボードの税額内訳ピボットは、両方の行が同じ発注番号を共有していても、標準税率の支出¥9,600を10%区分に、軽減税率の支出¥3,200を8%区分に正しく割り当てます。POレベルの合計も計算されますが(その発注番号の全明細項目の合計)、税区分は明細ごとの属性です — これはインボイス制度のもとで消費税申告が要求する報告方法です。
計算列は「20日締翌月末払い」のような支払条件から締日をどのように抽出しますか?
日本のPOの支払条件フィールドは、1つのテキスト文字列に2つの値をエンコードする複合表現です。計算列 — 抽出中にAIが計算を実行する列 — は、その文字列を構造化された値に解析します。列名はAIに何を抽出するかを指示します:締日(支払条件から締日番号 — 「20日締」の場合は20、「月末締」の場合は31、「10日締」の場合は10)。2番目の計算列は支払いの遅延を抽出します:支払遅延月数(支払条件から — 「翌月末払い」の場合は1、「翌々月末払い」の場合は2)。AIは日本の支払条件の慣例を読み取り、2つの数値を抽出し、ダッシュボードは抽出された数値をグループ化キーとして使用して締日ごとに行をグループ化します。元の支払条件テキスト文字列は、監査参照用に独自の列に残ります。
1件の発注書が複数ページにまたがる場合、バッチ処理で正しく結合されますか?
はい。発注書の全ページを同じバッチにアップロードしてください。複数ページのPDFをアップロードすると、抽出エンジンは全ページを1つの文書として扱います。ヘッダー項目(発注書番号、仕入先、注文日、支払条件、納品先)は1ページ目から1回だけ抽出され、全ページの明細項目(ヘッダーがなく前ページから続く明細テーブルのみの継続ページを含む)は同じ行セットに収集され、すべて同じ発注書番号にリンクされます。2〜4ページにまたがる12明細の4ページ発注書は、同じ発注書番号・仕入先・注文日を持つ12行のダッシュボード行を生成します。明細の内容は異なりますが、ヘッダーデータは一貫しています。
同じ列スキーマを毎月再利用できますか、それともバッチごとに調整が必要ですか?
そのまま再利用してください。2026年8月バッチ用に定義した12列のスキーマは、修正なしで2026年9月バッチを処理します。1年後の2027年8月バッチも同様です。仕入先が発注書形式を変更したり、新しい仕入先が未見の形式で追加されたりしても、スキーマは両方に対応します。スキーマは「何を抽出するか」を定義しており、「特定の形式のどこを探すか」ではないからです。新しいレポート要件が発生した場合(調達部門が原価部門フィールドの追跡を開始するなど)、スキーマに13番目の列を追加します。過去の月のスプレッドシートには空白セルで遡及追加し、当月以降は値が入ります。スキーマは一度きりの設定ではなく、生きている文書です。重要な規律は、新しい月のバッチを実行する前に、まず過去のスプレッドシートに列を追加することです。これにより年間スタックの整合性が保たれます。
ダッシュボードは日本の会計ソフトに直接エクスポートできますか?
ダッシュボードはExcelスプレッドシート(XLSX)です。日本の主要な会計・調達プラットフォームはすべて、構造化スプレッドシートのインポートに対応しています。弥生会計/弥生販売は、仕入台帳モジュールにCSVデータをインポートでき、列ヘッダーが弥生のフィールド名に直接マッピングされます。発注書番号→伝票番号、仕入先→仕入先、金額→金額。freeeは自動仕訳付きのCSVインポートに対応し、消費税区分列がfreeeの複数税率消費税申告に直接反映されます。マネーフォワード クラウド会計は、仕入管理モジュールへのバッチCSVインポートを受け付けます。中堅企業で使用される勘定奉行は、インポートした発注書データから部門別原価管理に対応しています。ボトルネックはインポート機能ではなく、50件の発注書を1回の操作で構造化スプレッドシートに変換することでした。ダッシュボードのスプレッドシートができれば、これらのプラットフォームへのインポートはファイルアップロードだけです。
同じバッチダッシュボードのアプローチで、他の日本の調達書類も処理できますか?
スキーマは書類の種類ごとに変わりますが、バッチからダッシュボードへの原則はそのまま適用できます。納品書の場合:発注書番号(結合キー)、納品数量、納品日、受領サインの列を定義します。その月のすべての納品書をバッチ処理し、発注書番号でグループ化して、納品数量と注文数量を比較します — 同じバッチワークフローから受領差異レポートを生成します。請求書の場合:請求書番号、発注書番号、請求金額、消費税、振込先の列を定義します。すべての請求書をバッチ処理し、締日でグループ化して、支払予定表を作成します — 調達ダッシュボードの支払い側です。単一発注書抽出ガイドでは、日本の調達チェーンにおける各書類タイプのフィールドレベルの詳細を説明しています。ここで説明するバッチダッシュボードは、その上に重なる集約レイヤーです — 同じ抽出メカニズム、異なる出力ビューです。
行のスプレッドシートから調達意思決定ツールへ
毎月50件の発注書を、各PDFを開いて同じ12フィールドをスプレッドシートに再入力して処理している調達部門は、リストを作っています。そのリストは正確です。しかし、調達マネージャーの役割を正当化する4つの質問には答えられません:どの仕入先が支出のどの割合を得ているか、今週どの納品が到着するか、税率区分ごとの税負担はどうか、締日ごとの支払いプロファイルはどうか。これらの4つの答えには、同じデータを4つの異なるグループ化次元で見ることが必要です — そして、それらの次元を構築するには、データがピボットテーブルで消費できる列に構造化され、単一のスプレッドシートに、バッチ内のすべての発注書に一貫した列定義が適用されている必要があります。
それらの12列を一度定義し、50件の発注書に同時に適用するバッチ抽出ワークフローは、現在1件の発注書を手動で入力するのにかかる時間で構造化されたスプレッドシートを生成します。ダッシュボード — 仕入先別ピボット、納品タイムラインの並べ替え、税区分別グループ、締日クラスター — は、データ入力完了後に誰かがExcelで構築する別の分析プロジェクトではなくなります。それは、フラットな行ではなくダッシュボード対応の列を生成するように設計された抽出ステップの自然な出力です。
調達チームは、現在発注書データの再入力に費やしている毎月70分以上を取り戻します — その70分は年間14時間に相当します。さらに重要なのは、スキーマが定義された最初の月から、追加のデータ操作なしで毎月4つの質問に答えるダッシュボードを得られることです。リストがダッシュボードになるのは、誰かが午後を費やしてピボットテーブルを構築したからではなく、抽出ステップがダッシュボードをデフォルトのビューにしたからです。