50 japanische Bestellungen, ein
Beschaffungs-Dashboard
Eine Beschaffungsabteilung, die monatlich 50 Lieferanten-Bestellungen (発注書, hatchūsho) erhält, hat am Ende typischerweise eine korrekte Tabelle und vier unbeantwortete Fragen. Die Tabelle enthält eine Zeile pro Bestellung – Bestellnummer, Lieferant, Artikel, Menge, Einzelpreis, Positionssumme, Liefertermin, Zahlungsbedingungen (支払条件), Verbrauchssteuer-Klassifizierung (消費税区分) – getreu aus jeder PDF abgetippt. Die vier Fragen, die der Einkaufsleiter tatsächlich beantworten muss: Wie viel gebe ich bei jedem Lieferanten aus, welche Lieferungen sind diese Woche fällig, wie hoch ist meine Verbrauchssteuer-Exposition nach Steuersatzkategorie und wie viel Bargeld fließt an jedem Abrechnungstag (締日, shimebi) ab. Eine flache Liste mit fünfzig Zeilen beantwortet ohne Pivot-Tabelle keine dieser Fragen. Ein spaltenbasiertes Dashboard – bei dem dieselben Daten nach der Dimension gruppiert, sortiert und summiert werden, die jede Frage beantwortet – erfordert, dass die Daten in Spalten strukturiert sind, die eine Formel lesen kann. Die Lücke zwischen einer Liste und einem Dashboard ist keine Excel-Funktion. Es ist die Tatsache, dass jemand immer noch fünfzig PDFs öffnet, um die Liste überhaupt zu erstellen.
Wichtigste Erkenntnisse
- Die manuelle Verarbeitung von fünfzig japanischen Bestellungen kostet Ihr Beschaffungsteam jedes Jahr vierzehn Stunden – und das sind nur die sichtbaren Kosten.
- Die unsichtbaren Kosten: Eine flache Zeilenliste kann Ihnen nie sagen, welche drei Lieferanten 45 % Ihres Budgets verbrauchen oder welche Liefertermine gleichzeitig an einem einzigen Dock kollidieren.
- Definieren Sie einmal die zwölf Spalten, die Ihr Dashboard tatsächlich benötigt, laden Sie alle fünfzig Bestellungen auf einmal hoch, und die vier Dashboard-Dimensionen – Ausgaben, Lieferung, Steuer, Bargeldabfluss – sind kein separates Analyseprojekt mehr, sondern das Standardergebnis.
Warum fünfzig einzelne Bestellzeilen kein Beschaffungs-Dashboard ergeben
Der Workflow zur Einzelbestellungs-Extraktion – beschrieben in der Schritt-für-Schritt-Anleitung zur Extraktion japanischer Bestelldaten – reduziert die manuelle Eingabe pro Bestellung von Minuten auf Sekunden. Zwölf Spaltennamen definieren, eine Bestellung hochladen, eine strukturierte Zeile erhalten. Für einen Beschaffungsmanager, der fünfzig Bestellungen pro Monat erhält, macht dieser Workflow jede einzelne Bestellung schnell. Er macht die Sammlung von fünfzig Bestellungen jedoch nicht nützlich.
Der strukturelle Unterschied zwischen einer Liste und einem Dashboard besteht darin, dass ein Dashboard Daten nach Dimensionen gruppiert, die eine einzelne Zeile nicht ausdrücken kann: Ausgabensummen pro Lieferant, nach Datum sortierte Lieferzusagen, Verbrauchssteuersummen nach Steuersatzstufe und Zahlungsverpflichtungen, gruppiert nach Abrechnungstag.
Eine einzelne Bestellzeile sagt Ihnen, dass Mitsubishi Chemical 2.000 Einheiten Dichtung A zu je 480 ¥ liefert, insgesamt 960.000 ¥ ohne Steuern, zur Lieferung am 15. August an das Werk Saitama, mit Zahlungsbedingungen von 20日締翌月末払い (Abrechnung am 20., Zahlung bis Ende des Folgemonats). Was eine einzelne Zeile nicht sagen kann: dass der Gesamtbetrag über acht weitere Bestellungen von Mitsubishi Chemical in diesem Monat 3,4 Millionen ¥ beträgt – was sie zum zweitgrößten Lieferanten nach Beschaffungsvolumen macht. Dass vier Bestellungen von vier verschiedenen Lieferanten alle Liefertermine innerhalb der nächsten sieben Tage haben und das Logistikteam eine konsolidierte Kommissionierliste benötigt. Dass 8,2 Millionen ¥ an Bestellpositionen mit dem regulären Satz von 10 % besteuert werden, während 1,6 Millionen ¥ an lebensmittelbezogenen Positionen den ermäßigten Satz von 8 % tragen – und die Beschaffungssteuerbelastung über diese beiden Stufen die Verbrauchssteuererklärung des nächsten Quartals bestimmen wird. Dass zwölf Lieferanten ihre Abrechnung am 20. abschließen und ihre kombinierte Zahlungsverpflichtung 5,1 Millionen ¥ beträgt, während sechs Lieferanten am letzten Tag des Monats abschließen und ihre kombinierte Verpflichtung 2,8 Millionen ¥ beträgt – zwei Auszahlungstermine mit zwei unterschiedlichen Liquiditätsauswirkungen.
Diese vier Antworten stecken in denselben fünfzig Bestelldokumenten. Sie sind unsichtbar, wenn diese fünfzig Bestellungen einzeln in flache Zeilen verarbeitet werden – nicht weil die Daten fehlen, sondern weil die Beziehungen zwischen den Zeilen das Einzige sind, was aus einer Liste ein Dashboard macht, und ein Mensch, der eine Bestellung nach der anderen verarbeitet, kann Beziehungen erst erkennen, wenn die fünfzig Zeilen zusammengestellt sind. Bis die letzte Bestellung eingegeben ist, ist die Lieferantenbeziehung der ersten Bestellung zu den nächsten acht desselben Anbieters eine Erinnerung, keine Spalte.
Dateien werden sicher verarbeitet und nicht gespeichert.
Das Extraktionsschema: Zwölf Spalten für vier Dashboard-Dimensionen
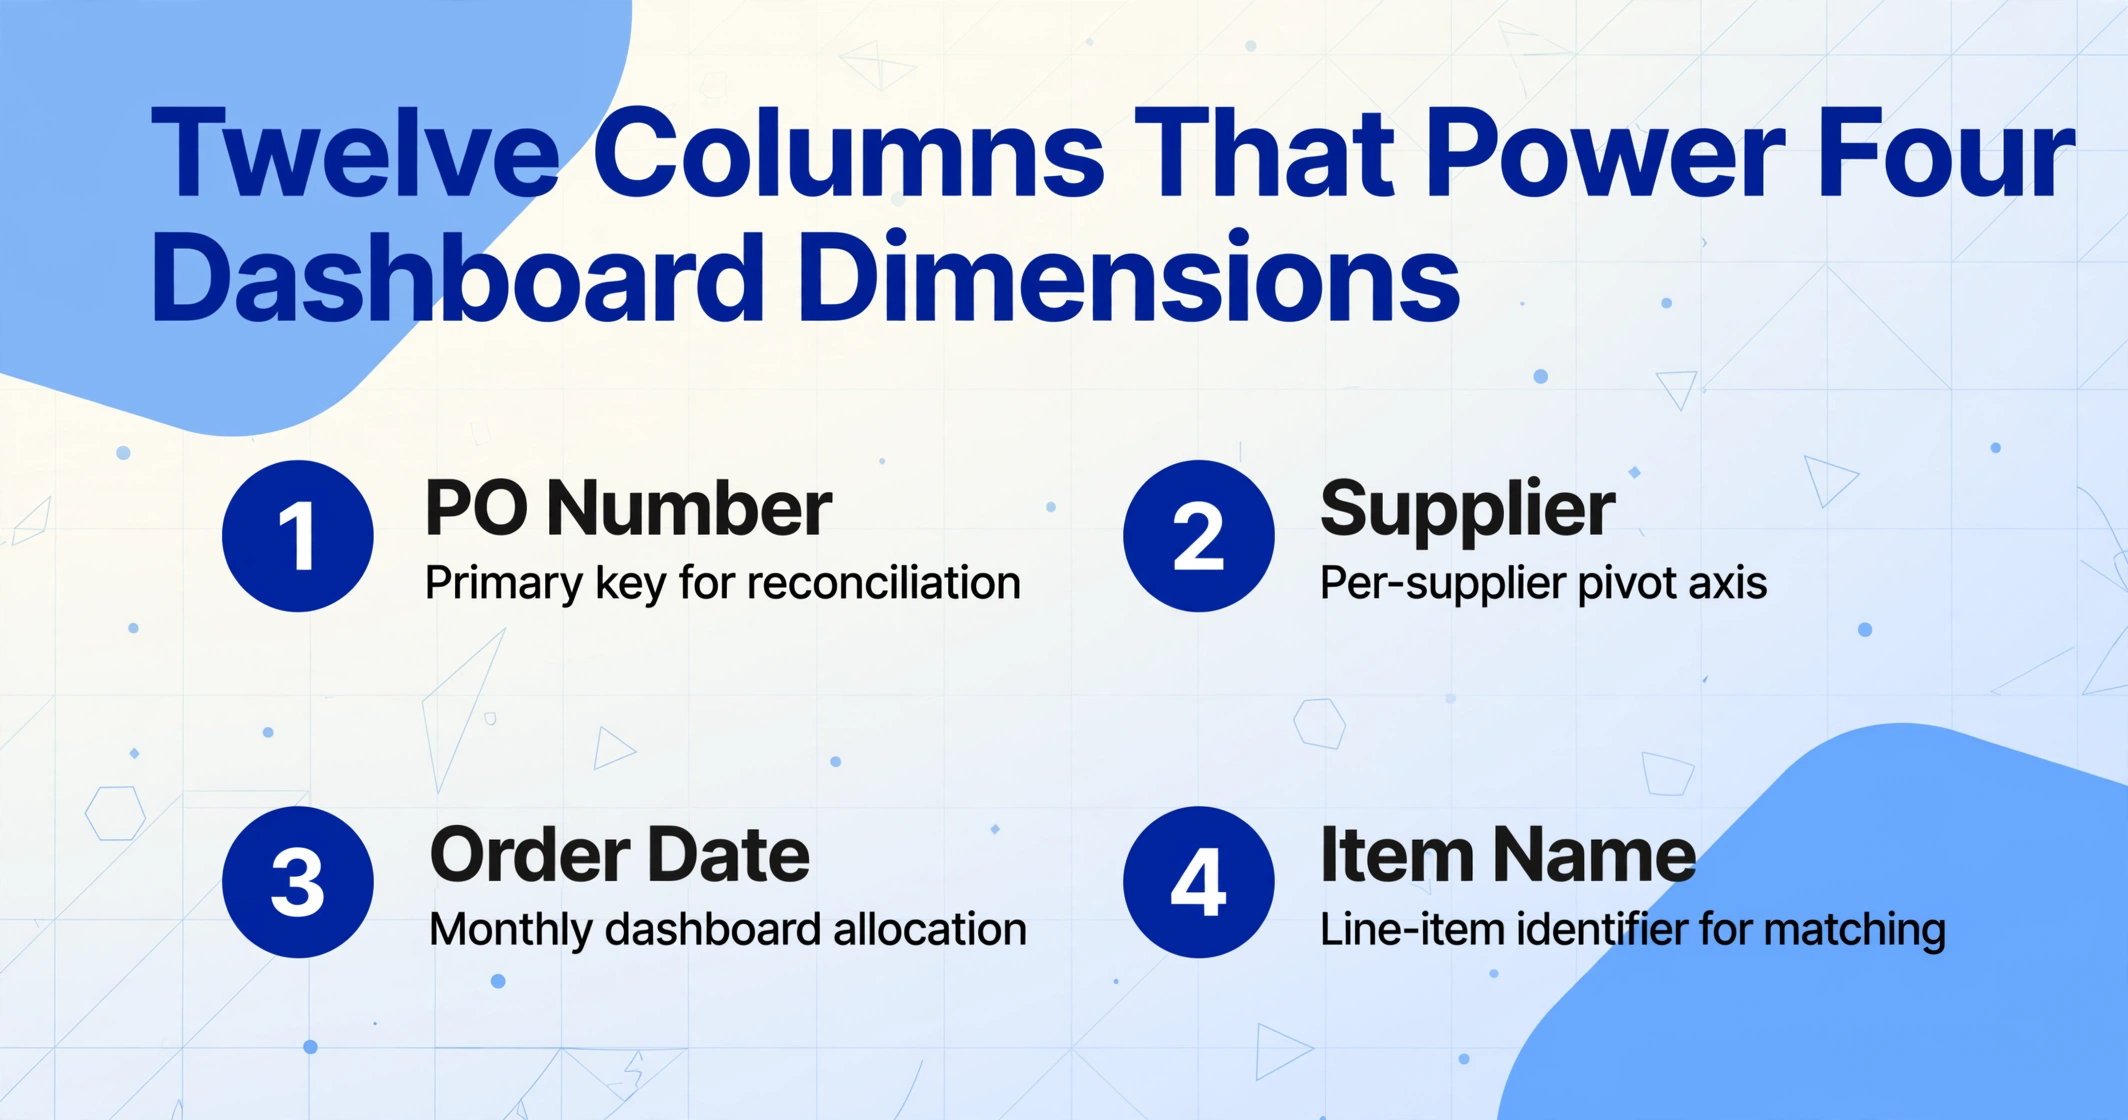
Das Extraktionsschema für einen japanischen Bestellungs-Batch ist nicht dasselbe wie das Schema für eine einzelne Bestellung – nicht weil sich die Dokumente unterscheiden, sondern weil sich das Ausgabeziel unterscheidet. Eine Einzelbestellungs-Extraktion erzeugt eine Zeile, die man liest. Eine Batch-Extraktion erzeugt eine Tabelle, die eine Pivot-Formel liest. Der Spaltensatz muss Klassifikationsfelder enthalten, die der Einzelbestellungs-Workflow implizit lassen kann, die das Dashboard aber als explizite Dimensionen behandeln muss.
Bei der Benutzerdefinierten Spaltenextraktion – bei der Sie die gewünschten Spaltennamen eingeben und die KI die passenden Daten auf jedem Dokument findet, indem sie versteht, was jedes Feld bedeutet, statt wo es steht – erweitert das Batch-Schema für ein japanisches Bestellungs-Dashboard den Einzelbestellungs-Spaltensatz um zwei zusätzliche Klassifikationsspalten:
| Spaltenname | Typ | Dashboard-Rolle |
|---|---|---|
| PO Number (発注番号) | Identität | Primärschlüssel — verknüpft die Bestellzeile mit dem zugehörigen Lieferschein und der Rechnung im Drei-Wege-Abgleich-Workflow |
| Supplier (発注先) | Gruppierungsdimension | Die Pivot-Achse pro Lieferant. Muss konsistent extrahiert werden — „㈱日立製作所" auf einer Bestellung und „日立" auf einer anderen zerbricht die Pivot-Tabelle. Verwenden Sie den vollständigen Lieferantennamen, wie er im Bestellkopf gedruckt ist |
| Order Date (発注日) | Periodenzuordnung | Bestimmt, zu welchem monatlichen Dashboard die Bestellung gehört. Eine Bestellung vom 30. September gehört zum September-Batch, unabhängig davon, wann die Lieferung eintrifft |
| Item Name (品名) | Detail | Positionsbezeichner. Lieferantenspezifische Abkürzungen sind üblich — SUS304 vs. ステンレス, 一式 vs. Batch — und müssen für den Rechnungsabgleich wie geschrieben extrahiert werden |
| Quantity (数量) | Detail | Numerische Menge. Die Einheit separat extrahieren: 個 (Stück), 式 (Los), kg, m, 時間 (Stunden). Einheitenabweichungen zwischen Bestellung und Rechnung sind ein Abgleich-Schwachpunkt — die Bestellung sagt 1式, die Rechnung führt es als 5個 auf |
| Unit Price (単価) | Detail | In der Regel ohne Steuer (税抜). Die Rechnung kann Einzelpreise inklusive Steuer ausweisen — der Vergleich eines 税抜-Bestellpreises mit einem 税込-Rechnungspreis erzeugt falsche Abweichungen |
| Line Amount (金額) | Detail | Menge × Einzelpreis. Wird für den positionsweisen Abgleich mit Lieferscheinen und Rechnungen verwendet |
| Delivery Date (納期) | Zeitachsendimension | Das Datum, an dem die Ware eintreffen muss. Nach dieser Spalte sortieren, um die wöchentliche Liefer-Pickliste für das Logistikteam zu erstellen. Bestellungen mit Terminen innerhalb der nächsten sieben Tage sind die umsetzbare Teilmenge |
| Delivery Location (納入場所) | Routing | Der konkrete Lieferpunkt — oft ein Werksname, Gebäude und Montagelinie. Beispiel: „株式会社〇〇 埼玉工場 第二組立課 B棟3階." Die Granularität ist für das Logistik-Routing entscheidend und muss vollständig ohne Kürzung extrahiert werden |
| Payment Terms (支払条件) | Cashflow-Dimension | Der Zahlungsplan als zusammengesetzter String: „20日締翌月末払い" bedeutet Abrechnungsschluss am 20., Zahlung bis Ende des Folgemonats. „月末締翌々月末払い" bedeutet Monatsendeschluss, Zahlung bis Ende des übernächsten Monats. Eine berechnete Spalte kann den Abrechnungstag (締日) als Zahl extrahieren — 20, 31 oder den konkreten Tag — und so den Gruppierungsschlüssel für das Cashflow-Dashboard erstellen |
| Consumption Tax Classification (消費税区分) | Steuerdimension | Eine abgeleitete Spalte — die KI klassifiziert jede Position während der Extraktion: 10% Standard (Standardwaren und -dienstleistungen), 8% Ermäßigt (Lebensmittel, alkoholfreie Getränke, Abonnementzeitungen) oder Steuerbefreit (非課税 — Exporte, bestimmte medizinische und Bildungsdienstleistungen). Die Spalte ist kein auf der Bestellung gedrucktes Feld; sie ist eine Klassifizierung, die die KI während der Extraktion aus der Positionsbeschreibung ableitet. Nach dieser Spalte gruppieren, um die Beschaffungssteuerbelastung nach Steuersatzklasse aufzuschlüsseln |
| Total Amount (合計金額) | Aggregation | Die Bestellsumme, in der Regel ohne Steuer. Pro Lieferant summieren, um die Ausgaben pro Lieferant zu ermitteln. Pro Abrechnungstag summieren, um die Cash-out-Zahlen pro Shimebi zu ermitteln |
Die beiden Klassifikationsspalten – Zahlungsbedingungen und Verbrauchssteuer-Klassifikation – machen aus einer flachen Liste ein Dashboard. Ohne sie ist die Ausgabe pro Lieferant die einzige Dimension, die Sie durch Sortieren und Summieren berechnen können. Mit ihnen eröffnen sich vier Dimensionen: von wem Sie kaufen, wann es ankommt, wie es besteuert wird und wann Sie dafür zahlen.
Die Pflichtfeldanforderungen der JFTC gemäß dem Subcontract Act (下請代金支払遅延等防止法) stellen sicher, dass jede konforme japanische Bestellung dieselben Kerndaten enthält. Das Format variiert je nach Lieferant – das Bestellungs-Layout von Mitsubishi Chemical hat nichts mit einem handschriftlichen Fax eines lokalen Subunternehmers gemeinsam – aber der Feldinhalt folgt derselben Struktur. Die Extraktions-KI liest nach Feldbedeutung, nicht nach Position: Die Bestellnummer (発注番号) ist die eindeutige Kennung auf jeder Bestellung, unabhängig davon, ob sie oben rechts auf Briefpapier mit Markenlogo gedruckt oder am Rand eines Faxformulars mit Bleistift notiert ist. Dieselbe semantische Logik findet jede Spalte in jedem Lieferantenformat. Das Schema wird einmal definiert und auf fünfzig Bestellungen angewendet – und nächsten Monat, und im Monat danach.
Monatliche Stapelverarbeitung: 50 Bestellungen, ein Upload, eine strukturierte Tabelle
Mit definiertem Schema verlagert sich der Schritt der monatlichen Stapelverarbeitung von Datenerfassung zu Datenorganisation. Der Stapelworkflow unterscheidet sich vom Einzelbestellungs-Workflow in drei Punkten, die im Maßstab von 50 Bestellungen relevant sind: Dateibenennung ist die Provenienzebene, Parallelverarbeitung verkürzt die Wartezeit pro Dokument, und die Verifizierung zielt auf Ausreißer statt auf jede Zeile.
Lieferantenbestellungen nach Monat organisieren – die Ordnerstruktur ist der Prüfpfad
Erstellen Sie einen Ordner pro Monat: /Procurement/POs/2026_08/. Jede Lieferantenbestellung, die im August eintrifft – E-Mail-PDFs von Handelsunternehmen (商社), Faxausdrucke kleiner Hersteller, gescannte Papierformulare lokaler Subunternehmer – kommt in diesen Ordner. Der Dateiname sollte die Lieferantenidentität bewahren: MitsubishiChemical_PO-2026-089.pdf statt scan001.pdf. Wenn die Extraktionsausgabe eine Quellendateinamen-Spalte enthält, führt jede Zeile im Dashboard auf ein bestimmtes PDF zurück – und ein Ordner mit 50 PDFs mit lieferantenbezogenen Dateinamen macht das Dashboard prüfbereit, ohne ein einziges Quelldokument zu öffnen.
Alle 50 Bestellungen in einem Stapel hochladen – das Schema verarbeitet jedes Dokument identisch
Legen Sie alle Dateien aus dem Monatsordner in die Upload-Warteschlange. Stapelverarbeitung behandelt die 50 Dokumente als einen Auftrag: Jede Bestellung wird unabhängig mit demselben Spaltenschema verarbeitet, alle Ergebnisse werden in einer Tabelle zusammengeführt. Die KI liest jedes Dokument nach semantischer Bedeutung – eine Bestellnummer ist eine Bestellnummer, egal ob sie als 発注番号: PO-2026-089 im formatierten PDF-Kopf oder als PO No. 089 handschriftlich auf einem Fax erscheint. Das Zwölf-Spalten-Schema funktioniert über alle 50 Bestellungen hinweg, weil die Felddefinitionen beschreiben, was die Daten sind, nicht wo sie auf dem Formular eines bestimmten Lieferanten stehen. Die Verarbeitung läuft parallel: 50 Bestellungen werden in etwa derselben Zeit abgeschlossen wie eine.
Ausreißer verifizieren – nicht jede Zeile
Die Ausgabe ist eine Tabelle mit 50 Zeilen und zwölf Spalten. Manuelle Verifizierung im Maßstab von 50 Bestellungen verlagert sich von zeilenweiser Prüfung zu Ausreißererkennung. Sortieren Sie nach Gesamtbetrag absteigend und prüfen Sie die fünf größten Bestellungen stichprobenartig – die größten Beschaffungsverpflichtungen, die typischerweise 60 % der monatlichen Ausgaben ausmachen, sind die Zeilen, in denen ein Extraktionsfehler die höchste finanzielle Auswirkung hat. Sortieren Sie nach Verbrauchssteuer-Klassifizierung und verifizieren Sie, dass Lebensmittelpositionen als 8 % ermäßigt und Standardwarenpositionen als 10 % Standard klassifiziert sind. Prüfen Sie die Lieferantenspalte auf Namensinkonsistenzen – wenn „㈱日立製作所" und „日立" als separate Lieferanten erscheinen, sind sie derselbe Anbieter und die Pivot-Tabelle wird doppelt zählen. Korrigieren Sie die Lieferantennamen in der Tabelle vor dem Dashboard-Schritt – oder besser: Fügen Sie während der Schemadefinition eine Spaltenregel hinzu, die Lieferantennamen unter Verwendung des vollständigen registrierten Namens normalisiert.
Die Ausgabe ist eine einzelne Tabelle, in der jede Zeile eine Bestellposition darstellt und jede Spalte einem der zwölf Schemafelder entspricht. Die Tabellenstruktur — gleiche Spalten, gleiche Reihenfolge, gleiche Felddefinitionen — ist jeden Monat identisch, da das Schema wiederverwendet und nicht neu erstellt wird. Ein Dashboard, das auf dem Schema vom Januar basiert, funktioniert mit der Ausgabe vom Februar ohne Neuformatierung. Die Konsistenz ist strukturell, nicht gewohnheitsbedingt.
Das Dashboard lesen: Vier Beschaffungsdimensionen, die eine Tabelle offenlegt
Mit fünfzig Bestellpositionen in zwölf Spalten strukturiert, ist das Dashboard eine Reihe von Pivot-Tabellen und sortierten Ansichten — jede beantwortet eine der vier Fragen, die der Beschaffungsmanager jeden Monat benötigt. Das Dashboard ist kein separates Dokument. Es ist dieselbe Tabelle, betrachtet durch vier verschiedene Linsen, die jeweils eine Teilmenge der zwölf Spalten verwenden.
Bestellsummen pro Lieferant — wer erhält welchen Anteil am Beschaffungsvolumen
Die erste Dimension gruppiert Zeilen nach der Lieferantenspalte und summiert den Gesamtbetrag. Eine Pivot-Tabelle über diese beiden Spalten erzeugt eine Rangliste der Lieferantenausgaben: Lieferant A: ¥5,2 Mio., Lieferant B: ¥3,4 Mio., Lieferant C: ¥2,8 Mio. und so weiter über alle dreißig-plus Lieferanten. Dies ist die Dimension, die die flache Liste von fünfzig Zeilen verschleiert, weil die Bestellungen desselben Lieferanten — Mitsubishi Chemical hat diesen Monat neun, ein kleiner Subunternehmer eine — chronologisch nach Bestelldatum verschachtelt sind. Die Gruppierung nach Lieferant zeigt Konzentration: Drei Lieferanten machen 45 % des monatlichen Beschaffungsvolumens aus. Diese Konzentration ist unsichtbar, wenn man Bestellungen einzeln verarbeitet und jede Zeile sequenziell eingibt.
Die Ansicht pro Lieferant zeigt auch ein Muster, das die manuelle Eingabe regelmäßig übersieht: dasselbe Produkt, von zwei verschiedenen Lieferanten zu zwei verschiedenen Stückpreisen bestellt. Wenn Lieferant A ¥480 pro Einheit für Dichtung A anbietet und Lieferant B ¥510 für dasselbe Produkt auf einer anderen Bestellung verlangt, macht die Pivot-Tabelle pro Lieferant — gefiltert nach Artikelname — den Preisunterschied zu einem Vergleich in einer einzigen Zeile. In einer flachen Liste sind die beiden Zeilen durch dreißig andere Einträge getrennt, und die Differenz erfordert, dass ein Mensch sie bemerkt. Im Dashboard ist ein Filter auf „Dichtung A“ über alle Lieferanten hinweg ein Klick.
Lieferzeitplan – welche Bestellungen sind diese Woche fällig
Die zweite Dimension sortiert die fünfzig Zeilen nach Lieferdatum aufsteigend und filtert nach der aktuellen Woche oder den nächsten sieben Tagen. Die Spalten, die für die Logistik relevant sind: Lieferant, Artikelname, Menge, Lieferort. Die Ausgabe ist eine Auswahlliste für das Wareneingangsteam – „diese Woche erhalten wir 2.000 Dichtungen von Mitsubishi Chemical im Werk Saitama, Montagelinie 3, 500 Liter Kühlflüssigkeit von Sumitomo im Werk Yokohama und zwölf Kartons Verpackungsmaterial von einem lokalen Lieferanten im Hauptlager.“ Jede Zeile hat einen Lieferort, der einem bestimmten Wareneingangsdock zugeordnet ist.
Diese Ansicht zeigt auch Liefertermin-Cluster: sieben Bestellungen von fünf verschiedenen Lieferanten haben alle das Lieferdatum 28. August. Das Logistikteam weiß nun, dass der 28. August ein Tag mit hohem Wareneingangsvolumen ist, und kann Dockkapazität und Prüfpersonal entsprechend einplanen – eine Planungsentscheidung, die nicht möglich ist, wenn Liefertermine über fünfzig einzelne PDFs verstreut und nie zu einer einzigen Zeitleiste zusammengeführt werden.
Verbrauchssteuer-Aufschlüsselung – Steuerbelastung der Beschaffung nach Steuersatz
Die dritte Dimension gruppiert Zeilen nach der Spalte Verbrauchssteuerklassifikation – der abgeleiteten Spalte, in der die KI jede Position während der Extraktion als 10 % Standardsatz, 8 % ermäßigt oder steuerbefreit klassifiziert hat. Eine Pivotierung dieser Spalte gegen den Positionsbetrag summiert die steuerpflichtige Bemessungsgrundlage zu jedem Satz:
| Steuerklassifikation | Steuerpflichtige Bemessungsgrundlage (netto) | Verbrauchssteuer | Anteil an der monatlichen Beschaffung |
|---|---|---|---|
| 10 % Standardsatz | ¥8.200.000 | ¥820.000 | 72 % |
| 8 % ermäßigt | ¥1.600.000 | ¥128.000 | 14 % |
| Steuerbefreit (非課税) | ¥1.500.000 | ¥0 | 13 % |
| Gesamt | ¥11.300.000 | ¥948.000 | 100 % |
Diese Aufschlüsselung ist aus zwei Gründen wichtig. Erstens fließt sie direkt in die Verbrauchssteuererklärung (消費税申告) ein – der vorsteuerabzug auf der Beschaffungsseite (仕入税額控除) erfordert die Aufteilung des steuerpflichtigen Einkaufsbetrags nach den Kategorien 10 % und 8 %, um dem Qualifizierten Rechnungssystem (インボイス制度) zu entsprechen, das im Oktober 2023 in Kraft getreten ist. Der Rechnungsabgleichsschritt – die Überprüfung, dass die Steueraufschlüsselung jeder Lieferantenrechnung mit der Steuerklassifikation der Bestellung übereinstimmt – verwendet diese Dashboard-Ansicht als Referenztabelle. Wenn eine Lieferantenrechnung 10 % Verbrauchssteuer auf eine Lebensmittelposition ausweist, die die Bestellung als 8 % ermäßigt klassifiziert hat, ist die Abweichung vor der Zahlungsfreigabe sichtbar.
Zweitens ist sie eine Budgetierungsgrundlage. Wenn 72 % der monatlichen Beschaffungsausgaben dem 10-%-Satz unterliegen, beträgt der Verbrauchssteueranteil des Beschaffungsbudgets etwa ¥820.000 pro Monat – eine Cashflow-Position, die das Finanzteam vorausplanen kann, statt sie erst am Monatsende zu entdecken, wenn die Lieferantenrechnungen mit Steuerbeträgen eintreffen, die nicht mit der internen Schätzung übereinstimmen.
Zahlungsbedingungen nach Abrechnungstag — Auszahlungsverpflichtungen gruppiert nach 締日
Die vierte Dimension gruppiert Bestellsummen nach dem Abrechnungstag (締日, shimebi), der aus der Spalte „Zahlungsbedingungen“ extrahiert wird. Japanische Bestellungen drücken Zahlungsbedingungen als zusammengesetzte Konvention aus, nicht als einfache „Netto 30“-Datumsberechnung. Die üblichen Muster:
| Zahlungsbedingungen auf der Bestellung | Abrechnungstag (締日) | Zahlungsfenster (Monate nach Abrechnung) | Praktische Bedeutung |
|---|---|---|---|
| 20日締翌月末払い | 20. | ~1 | Transaktionen vom 21. des Vormonats bis zum 20. des laufenden Monats werden gemeinsam abgerechnet. Zahlung bis Ende des Folgemonats fällig |
| 月末締翌月末払い | Letzter Tag des Monats | 1 | Transaktionen des gesamten Kalendermonats werden gemeinsam abgerechnet. Zahlung bis Ende des Folgemonats fällig |
| 月末締翌々月末払い | Letzter Tag des Monats | 2 | Transaktionen des gesamten Kalendermonats. Zahlung bis Ende des übernächsten Monats fällig — üblich im verarbeitenden Gewerbe, effektiv 60-Tage-Bedingungen |
| 10日締翌月末払い | 10. | ~1.5 | Transaktionen vom 11. des Vormonats bis zum 10. des laufenden Monats. Weniger üblich, aber von einigen großen Unternehmenskäufern genutzt |
Eine berechnete Spalte — eine Spalte, deren Wert die KI während der Extraktion berechnet, statt ihn direkt aus dem Dokument zu lesen — parst die Zahlungsbedingungen-Zeichenkette in zwei strukturierte Werte: Abrechnungstag (die Tagesnummer — 20, 31, 10) und Zahlungsverzögerung (die Anzahl der Monate zwischen Abrechnung und Zahlung — 1 für 翌月末, 2 für 翌々月末). Das Dashboard gruppiert dann Bestellsummen nach Abrechnungstag:
| Abrechnungstag (締日) | Anzahl der Lieferanten | Kombinierte Bestellsumme (ohne Steuern) | Geschätztes Zahlungsdatum |
|---|---|---|---|
| 20日締 | 18 | ¥6.300.000 | Ende des Folgemonats |
| 月末締 (翌月払い) | 8 | ¥3.100.000 | Ende des Folgemonats |
| 月末締 (翌々月払い) | 4 | ¥1.900.000 | Ende des übernächsten Monats |
Die Gruppierung nach Abrechnungstag ist die Cashflow-Dimension des Beschaffungs-Dashboards. Achtzehn Lieferanten mit Abschluss am 20. repräsentieren ¥6,3 Millionen an Zahlungsverpflichtungen, die etwa 40 Tage nach dem 20. des Monats fällig sind. Vier Lieferanten mit 翌々月払い-Bedingungen verschieben ¥1,9 Millionen um einen weiteren Monat. Das Finanzteam kennt nun das Auszahlungsprofil nach Datumsclustern, nicht nach einzelnen Bestellungen — und kann das Betriebskapital um zwei Zahlungswellen statt fünfzig einzelner Fälligkeitstermine planen.
Vom monatlichen Dashboard zur Beschaffungsanalyse für das Geschäftsjahr
Der Wert des monatlichen Batch-Workflows wächst mit der Dauer seiner Nutzung. Das Januar-Dashboard beantwortet vier Beschaffungsfragen für Januar. Zwölf monatliche Dashboards, zu einem Beschaffungsregister für das Geschäftsjahr zusammengeführt, beantworten eine andere Reihe von Fragen: Welcher Lieferant hat seinen Anteil an den Beschaffungsausgaben von Q1 auf Q3 gesteigert, wie saisonale Liefermuster die Logistikplanung beeinflussen, ob sich die Mischung der Verbrauchssteuersätze mit der Lieferantenmischung verschoben hat und welche Lieferanten durchgängig längere Zahlungsbedingungen nutzen – ein Verhandlungshebel bei der jährlichen Vertragsverlängerung.
Die Dashboard-Struktur macht die jährliche Konsolidierung zu einer strukturellen Operation statt zu einer Rekonstruktionsübung. Die Tabelle jedes Monats hat dieselben zwölf Spalten in derselben Reihenfolge. Januar bis Dezember in ein Jahresregister zu stapeln ist eine Kopier-Einfüge-Operation – die Spalten stimmen überein, weil sich das Schema nie geändert hat. Fügen Sie eine Monatsspalte hinzu, um die Herkunft zu bewahren, und das Jahresregister unterstützt nun Quartalsvergleiche: Filtern Sie nach Q1 (April–Juni für die meisten japanischen Unternehmen mit Geschäftsjahresende im März, 3月決算), pivotieren Sie nach Lieferant und vergleichen Sie mit den Lieferantenausgaben in Q2. Ein Lieferant, dessen Anteil von Q1 auf Q3 um 30 % gewachsen ist, ist ein Beschaffungstrend, den eine flache Liste über zwölf einzelne Monate nie offenbart.
Dasselbe Zwölf-Spalten-Schema, das die Bestellungen vom August 2026 verarbeitet hat, verarbeitet auch die Bestellungen vom August 2025 – archivierte Dokumente, die das 法人税法 Unternehmen verpflichtet, sieben Jahre lang aufzubewahren. Die nachträgliche Batch-Verarbeitung der Bestellungen eines früheren Geschäftsjahres verwandelt ein Archiv von PDF-Dateien in ein strukturiertes Beschaffungsregister, das ein Prüfer nach Lieferant, Monat und Steuerklassifizierung durchsuchen kann – ohne die Quelldokumente zu öffnen. Die Zeitersparnis liegt nicht im Extraktionsschritt, der die fünfzig Bestellungen eines Vorjahres so schnell verarbeitet wie die des aktuellen Monats. Sie liegt in der Prüfungsantwort: Wenn das Finanzamt (税務署) alle Bestellungen über 1 Million Yen aus dem Geschäftsjahr 2025 anfordert, liefert das Dashboard, gefiltert nach Gesamtbetrag absteigend, eine sortierte Liste mit Dokumentennachvollziehbarkeit in unter einer Minute.
Dieses mehrperiodische Batch-Konsolidierungsmuster lässt sich mit derselben zugrunde liegenden Logik auf andere Steuergebiete übertragen: Ein Extraktionsschema, das über mehrere Berichtszeiträume angewendet wird, erzeugt ein einheitliches Register. Der Quartals-Batch-Ansatz, den australische Buchhalter nutzen, um vier vierteljährliche BAS-Meldungen in ein jährliches Steuerregister zu überführen, und kanadische Buchhalter, die GST/HST-Meldungen in eine jährliche Steuerübersicht konsolidieren, folgt derselben Struktur: Spalten einmal definieren, dasselbe Schema jeden Zeitraum ausführen, die Zusammenführung aus der Struktur entstehen lassen. Die Steuerfelder ändern sich je nach Rechtsraum; das Batch-Prinzip nicht.
FAQ
Funktioniert der Batch-Workflow, wenn jeder Lieferant ein anderes Bestellformat verwendet?
Ja — das ist der entscheidende Vorteil der semantischen Extraktion gegenüber vorlagenbasierter OCR. Ein vorlagenbasiertes Tool erfordert eine separate Parsing-Vorlage pro Lieferantenformat, und wenn ein Lieferant sein Briefpapier neu gestaltet oder sein ERP-System aktualisiert, bricht die Vorlage. Die semantische Extraktion liest jede Bestellung, indem sie versteht, was die Daten bedeuten — eine Bestellnummer (発注番号) ist die Kennung, unabhängig davon, ob sie in einem formatierten Tabellenblock auf einem Mitsubishi-Chemical-PDF oder handschriftlich auf einem Faxformular eines Unterauftragnehmers erscheint. Das Zwölf-Spalten-Schema funktioniert über alle fünfzig Bestellungen im Batch, weil die KI nach der Feldbedeutung sucht, nicht nach der Feldposition. Wenn ein Lieferant nächsten Monat sein Bestelllayout ändert, funktioniert dasselbe Schema weiterhin — nichts muss aktualisiert werden.
Wie behandelt das Dashboard eine einzelne Bestellung mit Positionen zu 10 % und 8 % Verbrauchssteuer?
Die Spalte „Verbrauchssteuerklassifizierung" wird auf Positionsebene angewendet, nicht auf Bestellebene. Eine einzelne Bestellung mit drei Positionen — zwei Standardwaren zu 10 % und ein Lebensmittel zu 8 % — erzeugt drei Zeilen im Dashboard, jede mit eigener Steuerklassifizierung. Die Steueraufschlüsselungs-Pivot des Dashboards ordnet 9.600 ¥ standardbesteuerter Ausgaben korrekt dem 10-%-Bracket und 3.200 ¥ ermäßigt besteuerter Ausgaben dem 8-%-Bracket zu, obwohl beide Zeilen dieselbe Bestellnummer teilen. Der Gesamtbetrag auf Bestellebene wird weiterhin berechnet (Summe aller Positionen für diese Bestellnummer), aber die Steuerklassifizierung ist ein Attribut pro Position — so muss sie gemäß dem Qualifizierten Rechnungssystem (インボイス制度) in der Verbrauchssteuererklärung gemeldet werden.
Wie extrahiert die berechnete Spalte den Abrechnungstag aus Zahlungsbedingungen wie „20日締翌月末払い"?
Das Feld „Zahlungsbedingungen" auf einer japanischen Bestellung ist ein zusammengesetzter Ausdruck, der zwei Werte in einer Textzeichenfolge kodiert. Eine berechnete Spalte — eine Spalte, in der die KI während der Extraktion eine Berechnung durchführt — parst die Zeichenfolge in strukturierte Werte. Der Spaltenname weist die KI an, was zu extrahieren ist: Abrechnungstag (shimebi-Tagesnummer — aus Zahlungsbedingungen; wenn „20日締" dann 20, wenn „月末締" dann 31, wenn „10日締" dann 10). Eine zweite berechnete Spalte extrahiert die Zahlungsverzögerung: Zahlungsverzögerungsmonate (aus Zahlungsbedingungen; wenn „翌月末払い" dann 1, wenn „翌々月末払い" dann 2). Die KI liest die japanische Zahlungsbedingungen-Konvention, extrahiert die beiden numerischen Werte, und das Dashboard gruppiert Zeilen nach Abrechnungstag unter Verwendung der extrahierten Zahl als Gruppierungsschlüssel. Die ursprüngliche Textzeichenfolge der Zahlungsbedingungen bleibt für Prüfzwecke in einer eigenen Spalte.
Was passiert, wenn sich eine einzelne Bestellung über mehrere Seiten erstreckt – führt der Batch diese korrekt zusammen?
Ja. Laden Sie alle Seiten der Bestellung im selben Batch hoch. Wenn eine mehrseitige PDF hochgeladen wird, behandelt die Extraktions-Engine alle Seiten als ein einziges Dokument: Kopfzeilenfelder (Bestellnummer, Lieferant, Bestelldatum, Zahlungsbedingungen, Lieferort) werden einmal von der ersten Seite extrahiert, und Positionszeilen von allen Seiten – einschließlich Fortsetzungsseiten ohne Kopfzeile, die nur eine Tabelle mit Positionen der vorherigen Seite enthalten – werden in derselben Zeilengruppe gesammelt, alle mit derselben Bestellnummer verknüpft. Eine vierseitige Bestellung mit zwölf Positionen über die Seiten zwei bis vier erzeugt zwölf Dashboard-Zeilen, die jeweils dieselbe Bestellnummer, denselben Lieferanten und dasselbe Bestelldatum tragen. Die Positionsdetails variieren, die Kopfzeilendaten sind konsistent.
Kann ich dasselbe Spaltenschema jeden Monat wiederverwenden oder muss es pro Batch angepasst werden?
Verwenden Sie es unverändert wieder. Das für den August-2026-Batch definierte Zwölf-Spalten-Schema verarbeitet den September-2026-Batch ohne Änderung – und den August-2027-Batch ein Jahr später. Ein Lieferant kann sein Bestellformat ändern, ein neuer Lieferant kann mit einem noch nie gesehenen Format angebunden werden, und das Schema verarbeitet beides, weil es beschreibt, welche Daten extrahiert werden sollen, nicht wo in einem bestimmten Format gesucht werden soll. Wenn eine neue Berichtsanforderung entsteht – die Beschaffungsabteilung beginnt mit der Erfassung eines Kostenstellenfelds (原価部門) – fügen Sie dem Schema eine dreizehnte Spalte hinzu. Ergänzen Sie frühere Monatskalkulationstabellen rückwirkend mit leeren Zellen, und ab dem aktuellen Monat wird sie befüllt. Das Schema ist ein lebendes Dokument, keine einmalige Einrichtung. Die wichtigste Disziplin: Wenn Sie eine Spalte hinzufügen, fügen Sie sie zuerst den historischen Tabellen hinzu, bevor Sie den Batch des neuen Monats ausführen – damit der Jahresstapel weiterhin ausgerichtet bleibt.
Kann das Dashboard direkt in japanische Buchhaltungssoftware exportieren?
Das Dashboard ist eine Excel-Tabelle (XLSX). Jede große japanische Buchhaltungs- und Beschaffungsplattform akzeptiert strukturierte Tabellenimporte. Yayoi (弥生会計 / 弥生販売) importiert CSV-Daten in sein Einkaufsbuch-Modul, wobei die Spaltenüberschriften direkt auf Yayois Feldnamen abgebildet werden: Bestellnummer → 伝票番号, Lieferant → 仕入先, Betrag → 金額. freee unterstützt CSV-Import mit automatischer Journaleintragserstellung (自動仕訳), und die Verbrauchssteuer-Klassifizierungsspalte fließt direkt in freees Berichterstattung zur dualen Verbrauchssteuer ein. MoneyForward Cloud Accounting (マネーフォワード クラウド会計) akzeptiert Batch-CSV-Importe in sein Einkaufsverwaltungsmodul. Kanjo Bugyo (勘定奉行), das von mittelständischen japanischen Unternehmen genutzt wird, unterstützt die abteilungsübergreifende Kostenverteilung (部門別原価管理) aus importierten Bestelldaten. Der Engpass war nie die Importfunktion – sondern darin, fünfzig Bestellungen in einem einzigen Vorgang in strukturierte Tabellenform zu bringen. Sobald Sie die Dashboard-Tabelle haben, ist der Import in jede dieser Plattformen ein Datei-Upload.
Kann derselbe Batch-Dashboard-Ansatz andere japanische Beschaffungsdokumente verarbeiten?
Das Schema ändert sich je nach Dokumenttyp; das Batch-zu-Dashboard-Prinzip lässt sich direkt übertragen. Für Lieferscheine (納品書): Definieren Sie Spalten für Bestellnummer (der Verknüpfungsschlüssel), gelieferte Menge, Lieferdatum und Empfangsbestätigung. Verarbeiten Sie alle Lieferscheine des Monats im Batch, gruppieren Sie nach Bestellnummer und vergleichen Sie die gelieferten Mengen mit den bestellten Mengen — ein Empfangsabweichungsbericht, der aus demselben Batch-Workflow generiert wird. Für Rechnungen (請求書): Definieren Sie Spalten für Rechnungsnummer, Bestellnummer, Rechnungsbetrag, Verbrauchssteuer und Überweisungsdaten (振込先). Verarbeiten Sie alle Rechnungen im Batch, gruppieren Sie nach Abrechnungstag und erstellen Sie einen Zahlungsplan — die Auszahlungsseite des Beschaffungs-Dashboards. Der Leitfaden zur Einzel-Bestellung-Extraktion behandelt die feldgenauen Details für jeden Dokumenttyp in der japanischen Beschaffungskette. Das hier beschriebene Batch-Dashboard ist die Aggregationsebene darüber — gleicher Extraktionsmechanismus, andere Ausgabeansicht.
Von einer Tabellenkalkulation mit Zeilen zu einem Beschaffungs-Entscheidungstool
Die Beschaffungsabteilung, die monatlich fünfzig Bestellungen verarbeitet, indem sie jede PDF öffnet und dieselben zwölf Felder manuell in eine Tabellenkalkulation eintippt, erstellt eine Liste. Die Liste ist korrekt. Sie kann die vier Fragen nicht beantworten, die die Rolle des Beschaffungsleiters rechtfertigen: Welche Lieferanten erhalten welchen Ausgabenanteil, welche Lieferungen treffen diese Woche ein, wie hoch ist die Steuerbelastung nach Steuersatz und wie sieht das Auszahlungsprofil nach Abrechnungstag aus? Diese vier Antworten erfordern dieselben Daten, betrachtet durch vier verschiedene Gruppierungsdimensionen — und um diese Dimensionen aufzubauen, müssen die Daten in Spalten strukturiert sein, die eine Pivot-Tabelle verarbeiten kann, in einer einzigen Tabellenkalkulation, mit konsistenten Spaltendefinitionen, die auf jede Bestellung im Batch angewendet werden.
Ein Batch-Extraktions-Workflow, der diese zwölf Spalten einmal definiert und auf fünfzig Bestellungen gleichzeitig anwendet, erzeugt die strukturierte Tabellenkalkulation in der Zeit, die derzeit für die manuelle Eingabe einer einzigen Bestellung benötigt wird. Das Dashboard — die Pivot-Tabelle pro Lieferant, die Lieferzeitachsen-Sortierung, die Steueraufschlüsselungs-Gruppe, die Abrechnungstag-Cluster — ist kein separates Analyseprojekt mehr, das jemand nach der Dateneingabe in Excel erstellt. Es ist das natürliche Ergebnis eines Extraktionsschritts, der darauf ausgelegt war, dashboard-fähige Spalten zu erzeugen, nicht flache Zeilen.
Das Beschaffungsteam erhält die mehr als siebzig Minuten pro Monat zurück, die es derzeit mit dem Abtippen von Bestelldaten verbringt — siebzig Minuten, die sich auf vierzehn Stunden pro Jahr summieren. Noch wichtiger: Sie erhalten ein Dashboard, das die vier Fragen jeden Monat beantwortet, ab dem ersten Monat, in dem das Schema definiert ist, ohne zusätzliche Datenmanipulation. Die Liste wird zum Dashboard, nicht weil jemand einen Nachmittag mit dem Erstellen von Pivot-Tabellen verbracht hat, sondern weil der Extraktionsschritt das Dashboard zur Standardansicht gemacht hat.