APデータ入力ワークフロー:
PDFから総勘定元帳までの5つのステップ
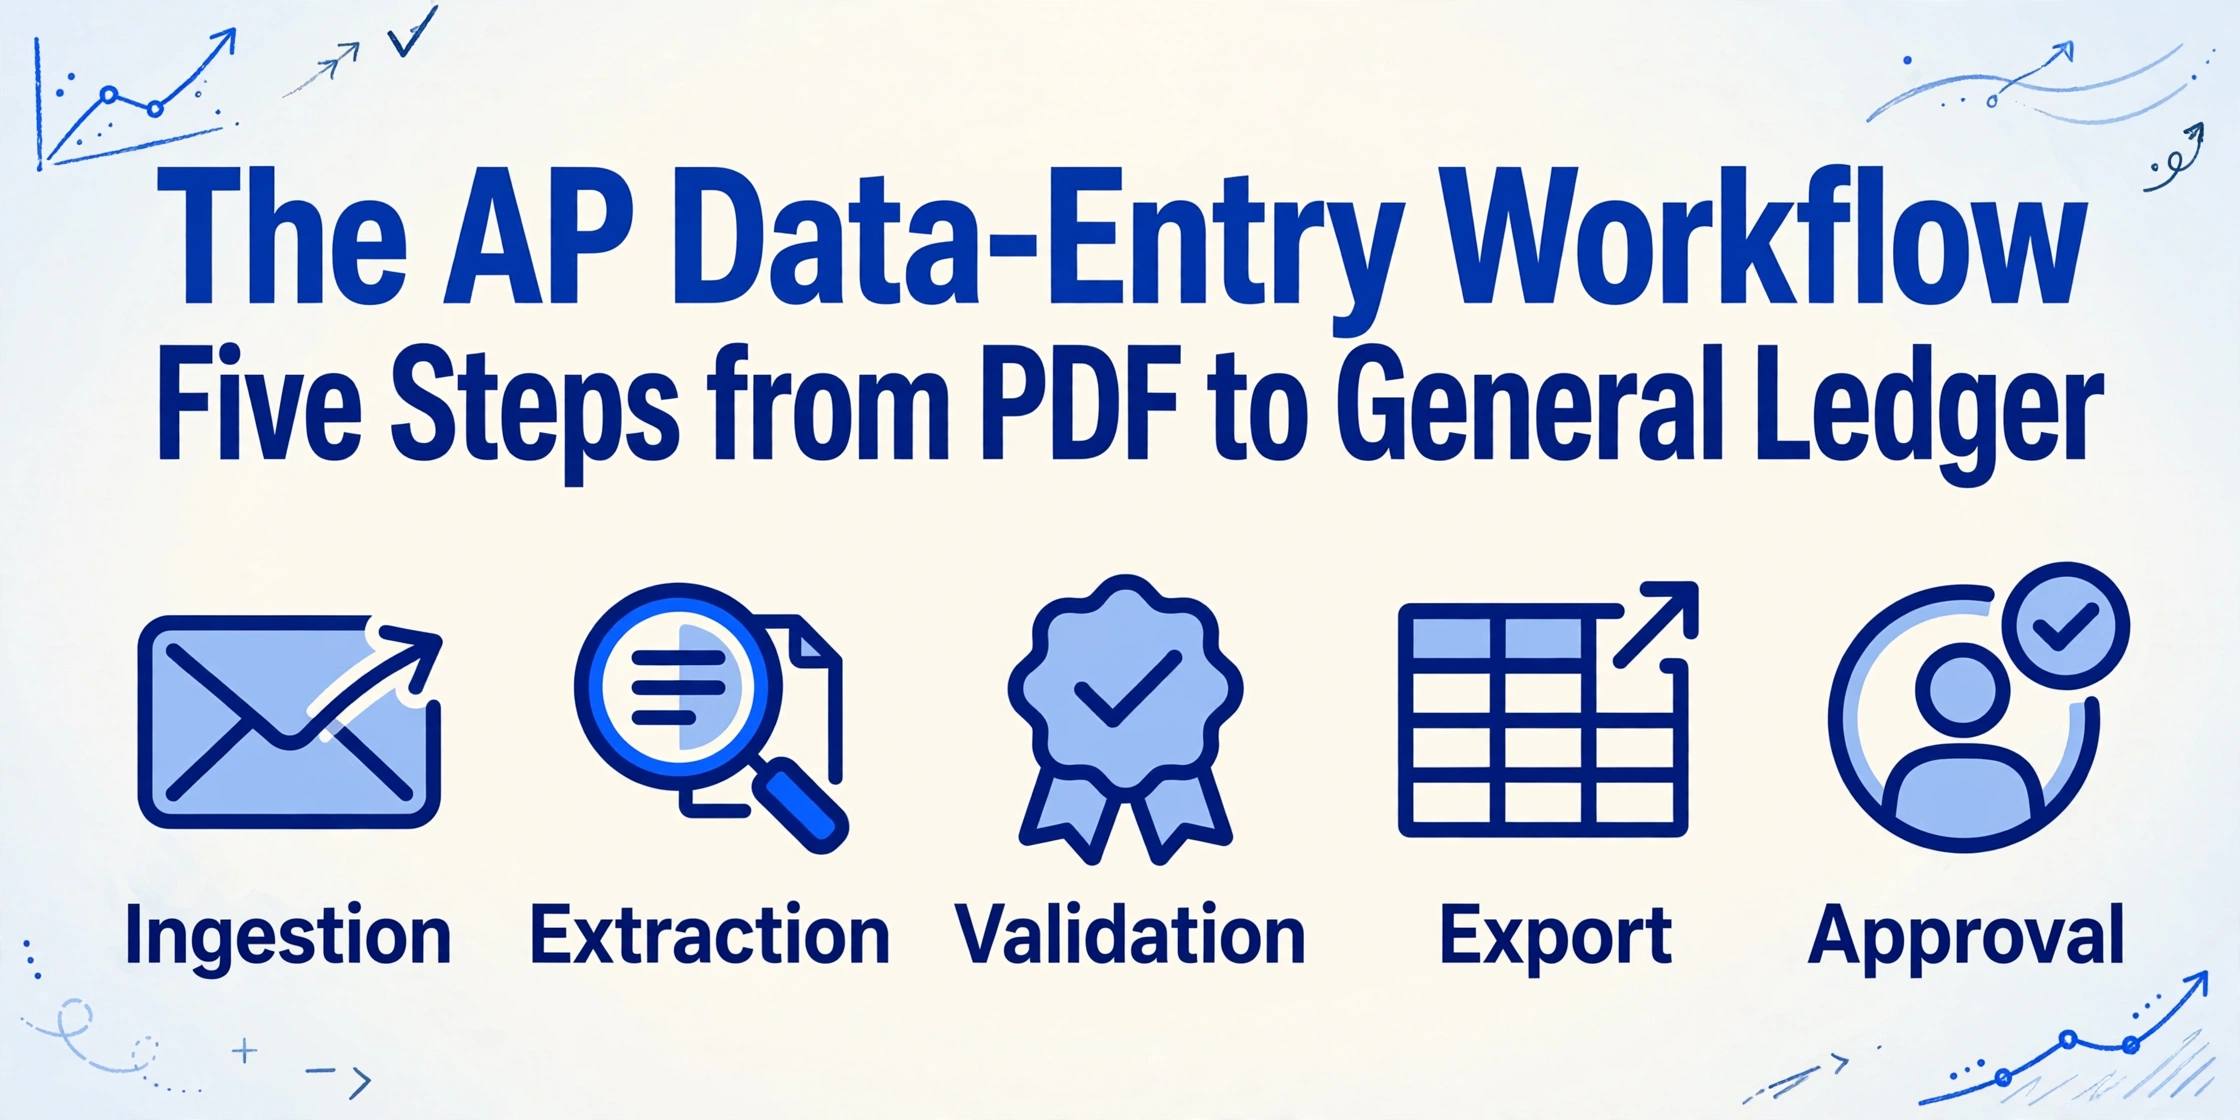
AP自動化は1つの大きな切り替えではありません。5つの個別の引き継ぎがあり、それぞれに独自のツール、独自の障害モード、独自の自動化上限があります。「AP自動化」として販売されているほとんどのツールは、そのうち最大2つの引き継ぎしかカバーしていません。残りの3つは、請求書が滞り、重複がすり抜け、スタッフが手作業でPDFとERP画面を照合しなければならない部分です。抽出ステップだけでなくチェーン全体をカバーすることが、すべてのサプライヤーが異なる形式で請求書を送ってくる場合に機能する自動化と、サンプルでのみ機能する自動化を分けるポイントです。
重要ポイント
- ほとんどのツールがAP自動化と呼ぶものは、請求書が受信トレイから総勘定元帳に到達するまでの5つの引き継ぎのうち、ページからフィールドを読み取るという1つのステップだけを自動化しています。
- 平均($9.40)とベストインクラス($2.78)の請求書あたりコストの70%の差は、より良い抽出から生まれるのではなく、抽出と転記の間の引き継ぎを自動化することから生まれます。
- パイプラインのテスト:APツールが50件の請求書のバッチを1回の操作で会計システムにエクスポートできない場合、APを自動化したことにはなりません。ボトルネックを抽出から再入力に移しただけです。
APデータ入力パイプラインにおける5つの引き継ぎポイント
買掛金(AP)のデータ入力は単一のタスクではありません。それはパイプラインです。つまり、個別のステップが連続し、それぞれが次へ引き継がれます。各引き継ぎは、失敗のリスクポイントであると同時に自動化の機会でもあります。5つのステップは以下の通りです:
ほとんどのAP自動化ツールはステップ2に完全に存在します。一部はステップ1と3にまで拡張されます。ステップ4と5に触れるものはほとんどありません。そして、それが実際に「APを自動化した」という言葉が「請求書データ抽出を自動化しただけで、他は何も変わっていない」という意味になる理由です。パイプライン全体のスループットは、依然として最も遅い引き継ぎによって決まります。
Ardent Partnersの2025年AP Metrics That Matterレポートによると、平均的な組織は1枚の請求書の処理に9.40ドルを費やしています。一方、上位20%のベストインクラスのチームは、エンドツーエンドの自動化を通じてこの数字を2.78ドルまで削減しています。¹ この70%のコスト差は、優れた抽出だけによるものではありません。それは、抽出と転記の間の引き継ぎを自動化することから生まれます。つまり、データが人間の操作を待って滞留するステップを自動化することです。
取り込み:請求書を一元管理する
ほとんどのAP(買掛金)ワークフローにおける最初のボトルネックは、請求書データの読み取りとは関係ありません。請求書をそもそもシステムに取り込むことです。請求書は、メールの添付ファイル、サプライヤーポータル(Coupa、Ariba)、紙の郵便、共有ネットワークドライブ、そして最近ではEDIフィードを通じて届きます。中規模の製造会社のAP担当者は、データ入力に取りかかる前に、7つの異なるチャネルから請求書を集めなければならないかもしれません。添付ファイルの山を処理するメールパーサーは、そのチャネルの1つを取り除くだけですが、多くの場合、それが最も時間のかかるチャネルです。
IOFMの2024年APベンチマーク調査によると、手動での請求書処理は平均して1件あたり12.5分かかり、その最初の1.5分は単にファイルを探して開くだけの作業です。² 1つのフィールドが読み取られる前に、パイプラインはすでに有料のスタッフ時間を消費しているのです。
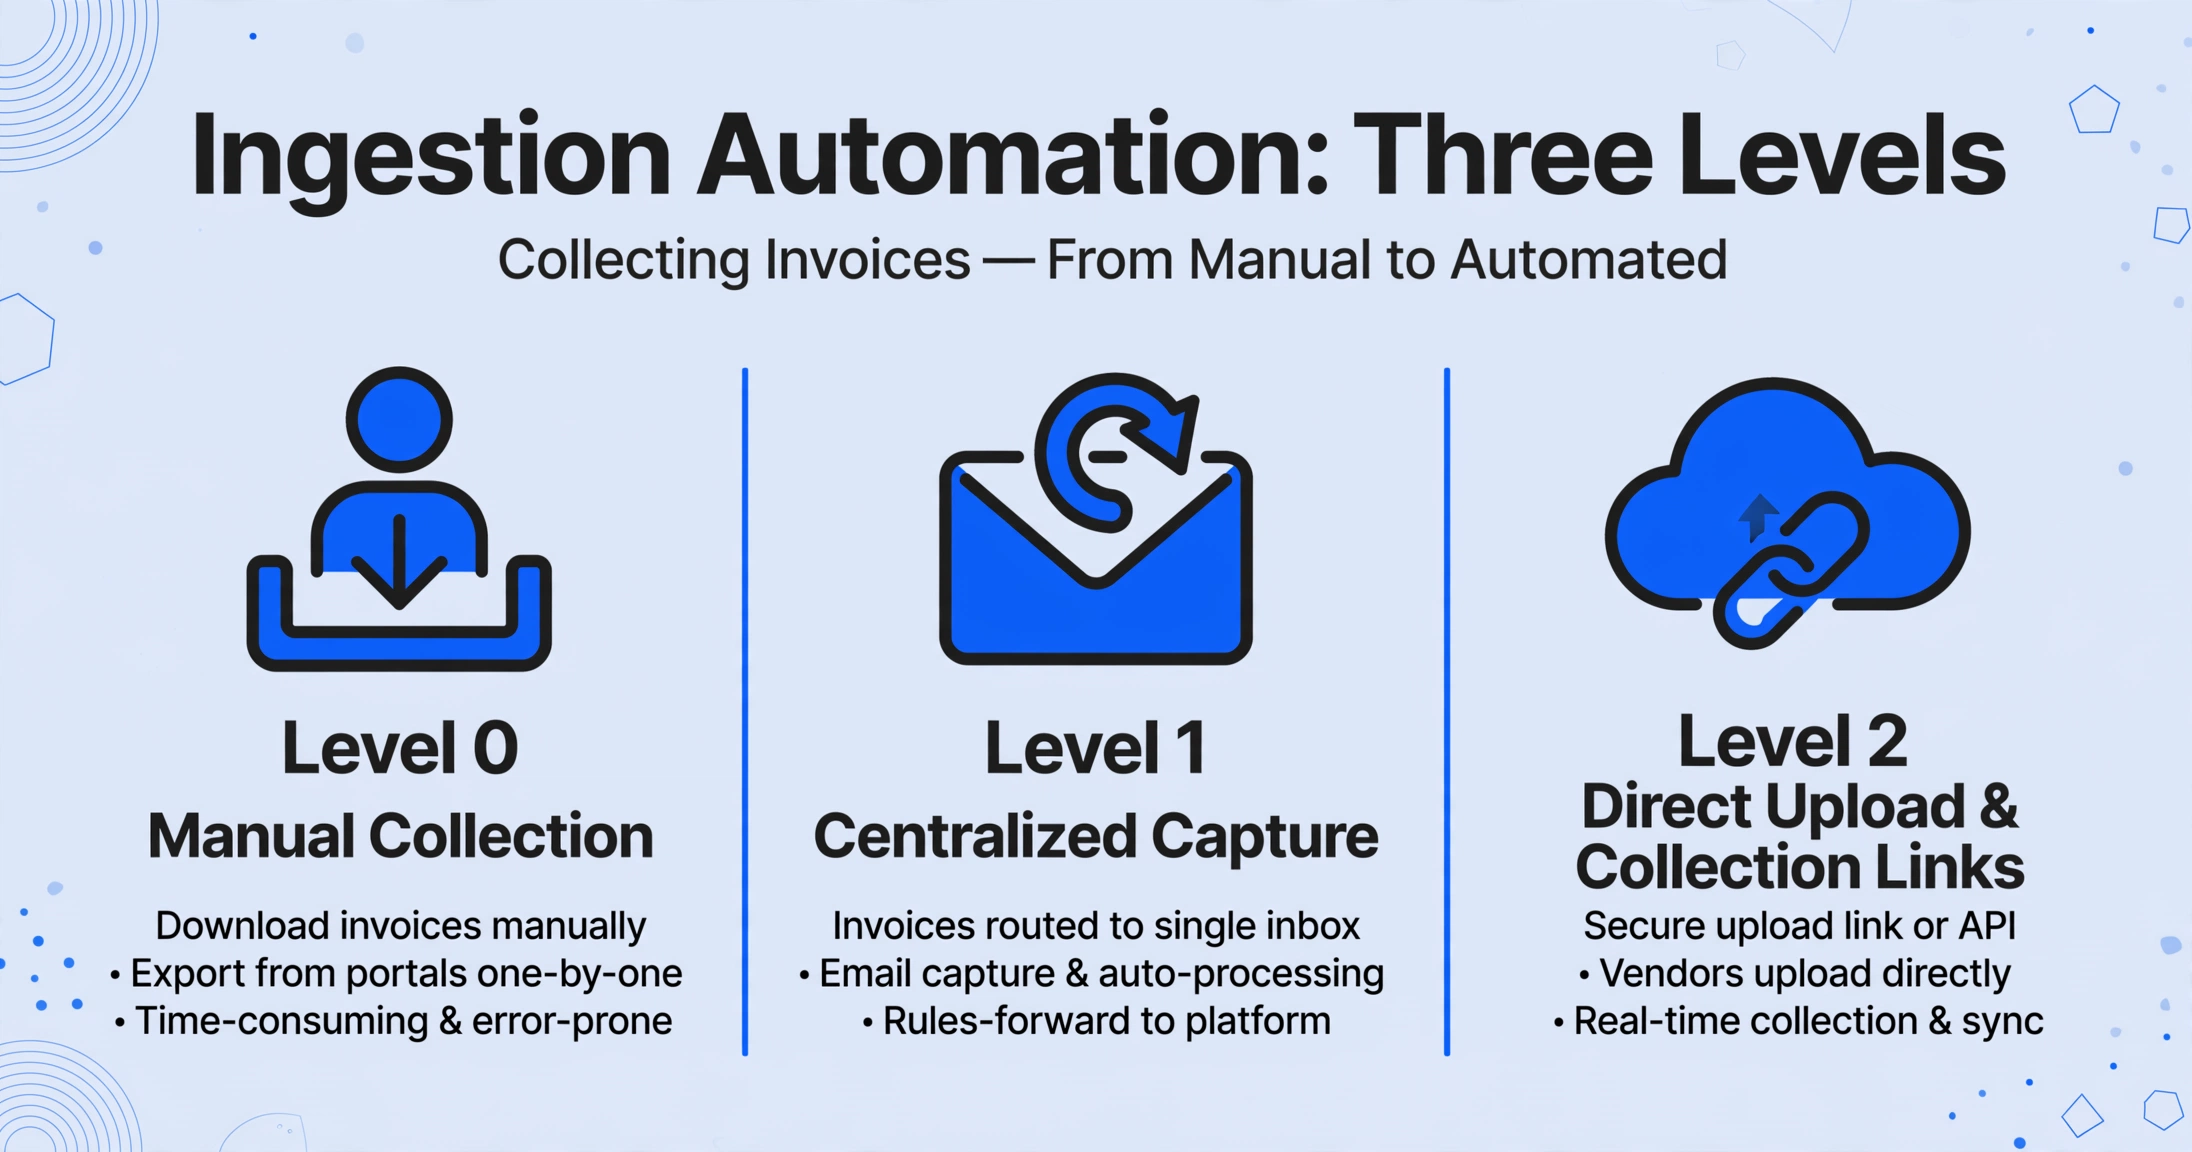
取り込み自動化には次の3つのレベルがあります:
- レベル0 — 手動収集。誰かがメールから添付ファイルをダウンロードし、紙の請求書をスキャンし、各サプライヤーポータルに個別にログインします。これが、ほとんどの中小規模のAPチームがまだ稼働しているレベルです。
- レベル1 — 集中取得。メールパーサーや専用インボックスが添付ファイルを自動的に処理キューにルーティングします。紙の請求書は監視フォルダーにバッチスキャンされます。これにより、複数チャネルを探し回る手間はなくなりますが、フォーマットの問題は解決しません。
- レベル2 — 直接アップロードとコレクションリンク。請求書を追いかける代わりに、サプライヤーや社内関係者に直接アップロードできるリンクを提供します。ImageToTable.aiのコレクションリンク機能はまさにこれを行います:共有可能なURLを生成し(アップロードする側の登録は不要)、送信者がファイルをドロップすると、それはあなたの処理キューに入ります。取り込みステップは「探してダウンロードする」から「キューを開く」へと変わります。
Redditのr/Accountingで、あるユーザーが毎月1,500〜2,000件のサプライヤー請求書がある自分の取り込みの現実をこう述べています。「請求書はPDF添付ファイルとして共有インボックスに届き、誰かが各ファイルを開き、ヘッダー情報をNetSuiteに入力し、手動でPOと照合し、メールで承認を回し、承認者が無視すると追いかけ回す。」³ そのワークフローにおける取り込みステップ(添付ファイルを開いて適切な担当者にルーティングすること)は、完全に手動で、毎月何千回も繰り返されています。
自動化によって変わること:請求書は、インボックスやドライブに散在していた状態から、1つの構造化された取り込みポイントに集約されます。取り込みステップは、1件あたり数分から数秒に短縮されます。
変わらないこと:どの請求書を処理するかを決定し、請求書がないというサプライヤーの問い合わせに対応し、取り込みチャネルを維持する作業は、依然として誰かが行う必要があります。
抽出:最大の変化が起こるステップ
ここが、テクノロジーが最も劇的に進化したステップであり、旧来のアプローチと新しいアプローチの違いが、パイプライン全体で最大の時間節約を生み出す場所です。抽出とは、ドキュメントから個々のフィールドを読み取ることを意味します:請求書番号、発行日、期日、ベンダー名、明細項目の説明、数量、単価、税額、請求書合計。このステップの成否は、その後のすべての引き継ぎに波及します。
旧来の方法:テンプレートベースのOCR
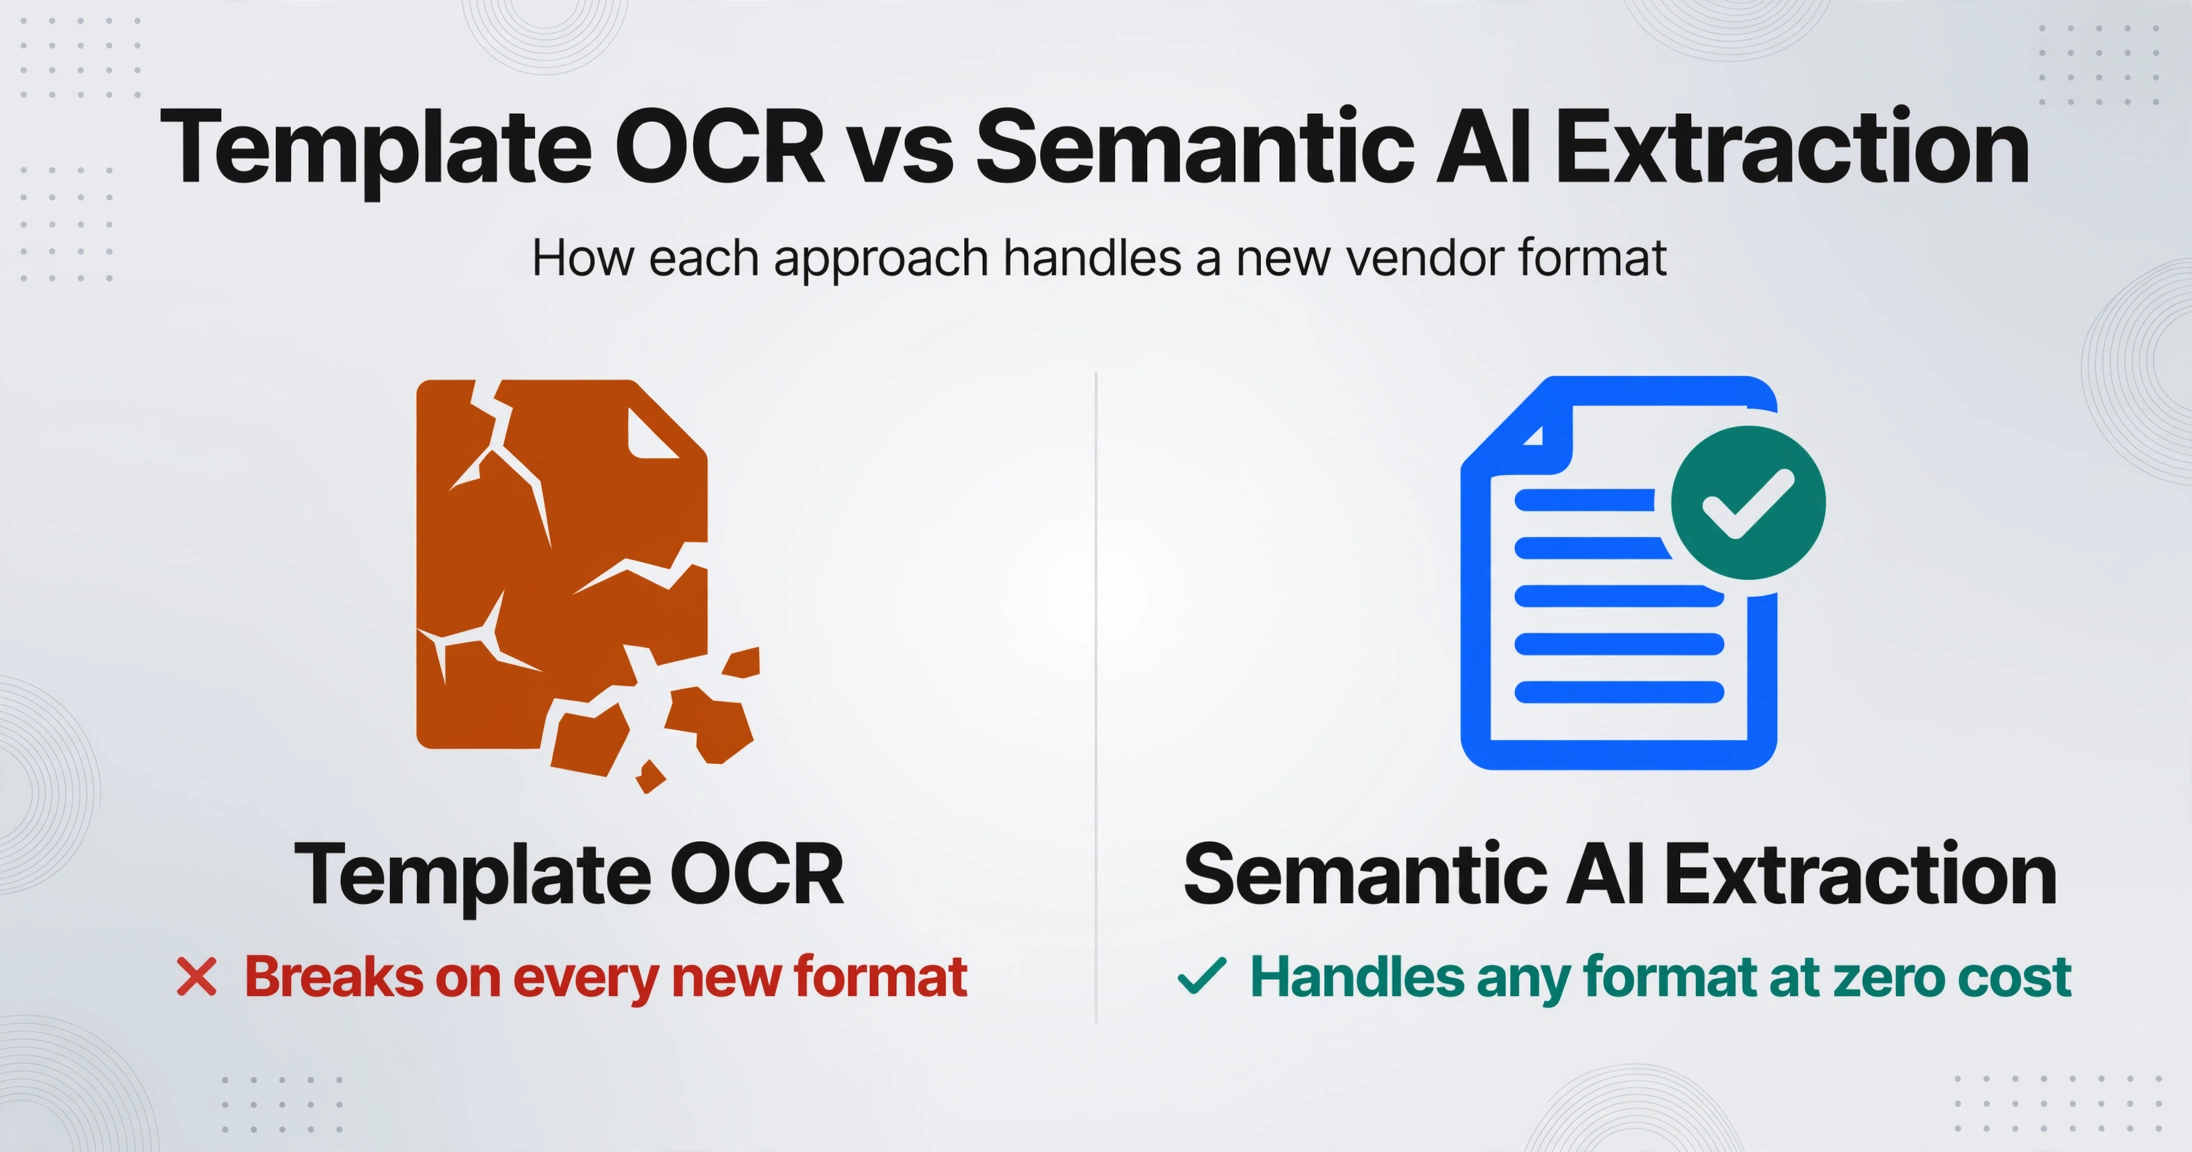
従来のAP自動化ツールは、光学文字認識(OCR)をテンプレートやゾーンマッピングと組み合わせて使用します。ベンダーごとに、各フィールドがページ上のどこにあるかを定義します—「請求書番号は右上隅、3インチ下、右余白から2インチの位置」といった具合です。OCRはそのボックス内の文字を読み取ります。ベンダーが請求書レイアウトを変更すると—そして変更されるでしょう—テンプレートは壊れます。新しいテンプレートを作成します。200社のベンダー、それぞれ独自のフォーマットと定期的なレイアウト変更を掛け合わせると、テンプレートのメンテナンス自体が一つの仕事になります。
1,500〜2,000枚の請求書を処理しているあのRedditユーザーも、ERPに組み込まれたOCRを試したと報告しています:「すべての機械工場と原材料サプライヤーがそれぞれ異なるフォーマットを使用しているため、請求書の半分でOCRが機能しません。」³ これがテンプレート問題を一文で表しています。ツールがデータの位置に依存している場合、新しいフォーマットが登場した瞬間に失敗します。
新しい方法:セマンティックAI抽出
AI駆動の抽出は異なる方法で機能します。各フォーマットにテンプレートをプログラムする代わりに、システムに何を欲しいか — フィールド名 — を伝えると、ビジョン言語モデルがドキュメントを読み取り、各フィールドがどこにあるかではなく、その意味を理解して見つけ出します。「請求書番号」とラベル付けされたフィールドは、右上隅、中央ヘッダー、またはテキストブロック内に埋もれている場合でも、場所に関係なく特定されます。これがカスタム列抽出です。出力テーブルに必要な列名(例:「請求書番号」、「仕入先」、「正味金額」、「税」、「総額」)を入力すると、AIがレイアウトに関係なく各ドキュメントをスキャンしてそれらの値を探します。
このフォーマット非依存のアプローチにより、それぞれ独自の請求書デザインを持つ50社の異なる仕入先からの請求書をバッチ処理し、単一の統合スプレッドシートとして出力できます。手動処理時間の大部分を占めていた抽出ステップは、請求書1枚あたり4分(手動入力)から、ページあたり10秒未満に短縮されます。
ファイルは安全に処理され、保存されません。
その差は量が増えるほど顕著になります。手動で処理される請求書1枚は、データ入力だけで約4分かかります。100枚の請求書を処理するには、ほぼ7時間の入力が必要です。セマンティック抽出では、100枚の請求書が約17分で完了し、出力はすでにスプレッドシートとして構造化され、検証の準備が整っています。
直接的なフィールド抽出に加えて、AIは抽出中に計算列も実行できます。例えば、明細行の金額の合計が請求書の合計と一致するか検証したり、PO金額と請求金額の差を計算したりできます。これにより、検証作業が抽出ステップに前倒しされ、承認キューに到達する前に不一致を検出できます。
検証:台帳に到達する前にエラーを検出する
抽出はデータを生成します。検証はそのデータが正しいかどうかを判断します。ここが、ほとんどのパイプラインで生産性が漏れる受け渡しポイントであり、自動化の上限が多くのベンダーのマーケティングが示唆するよりも低い場所です。
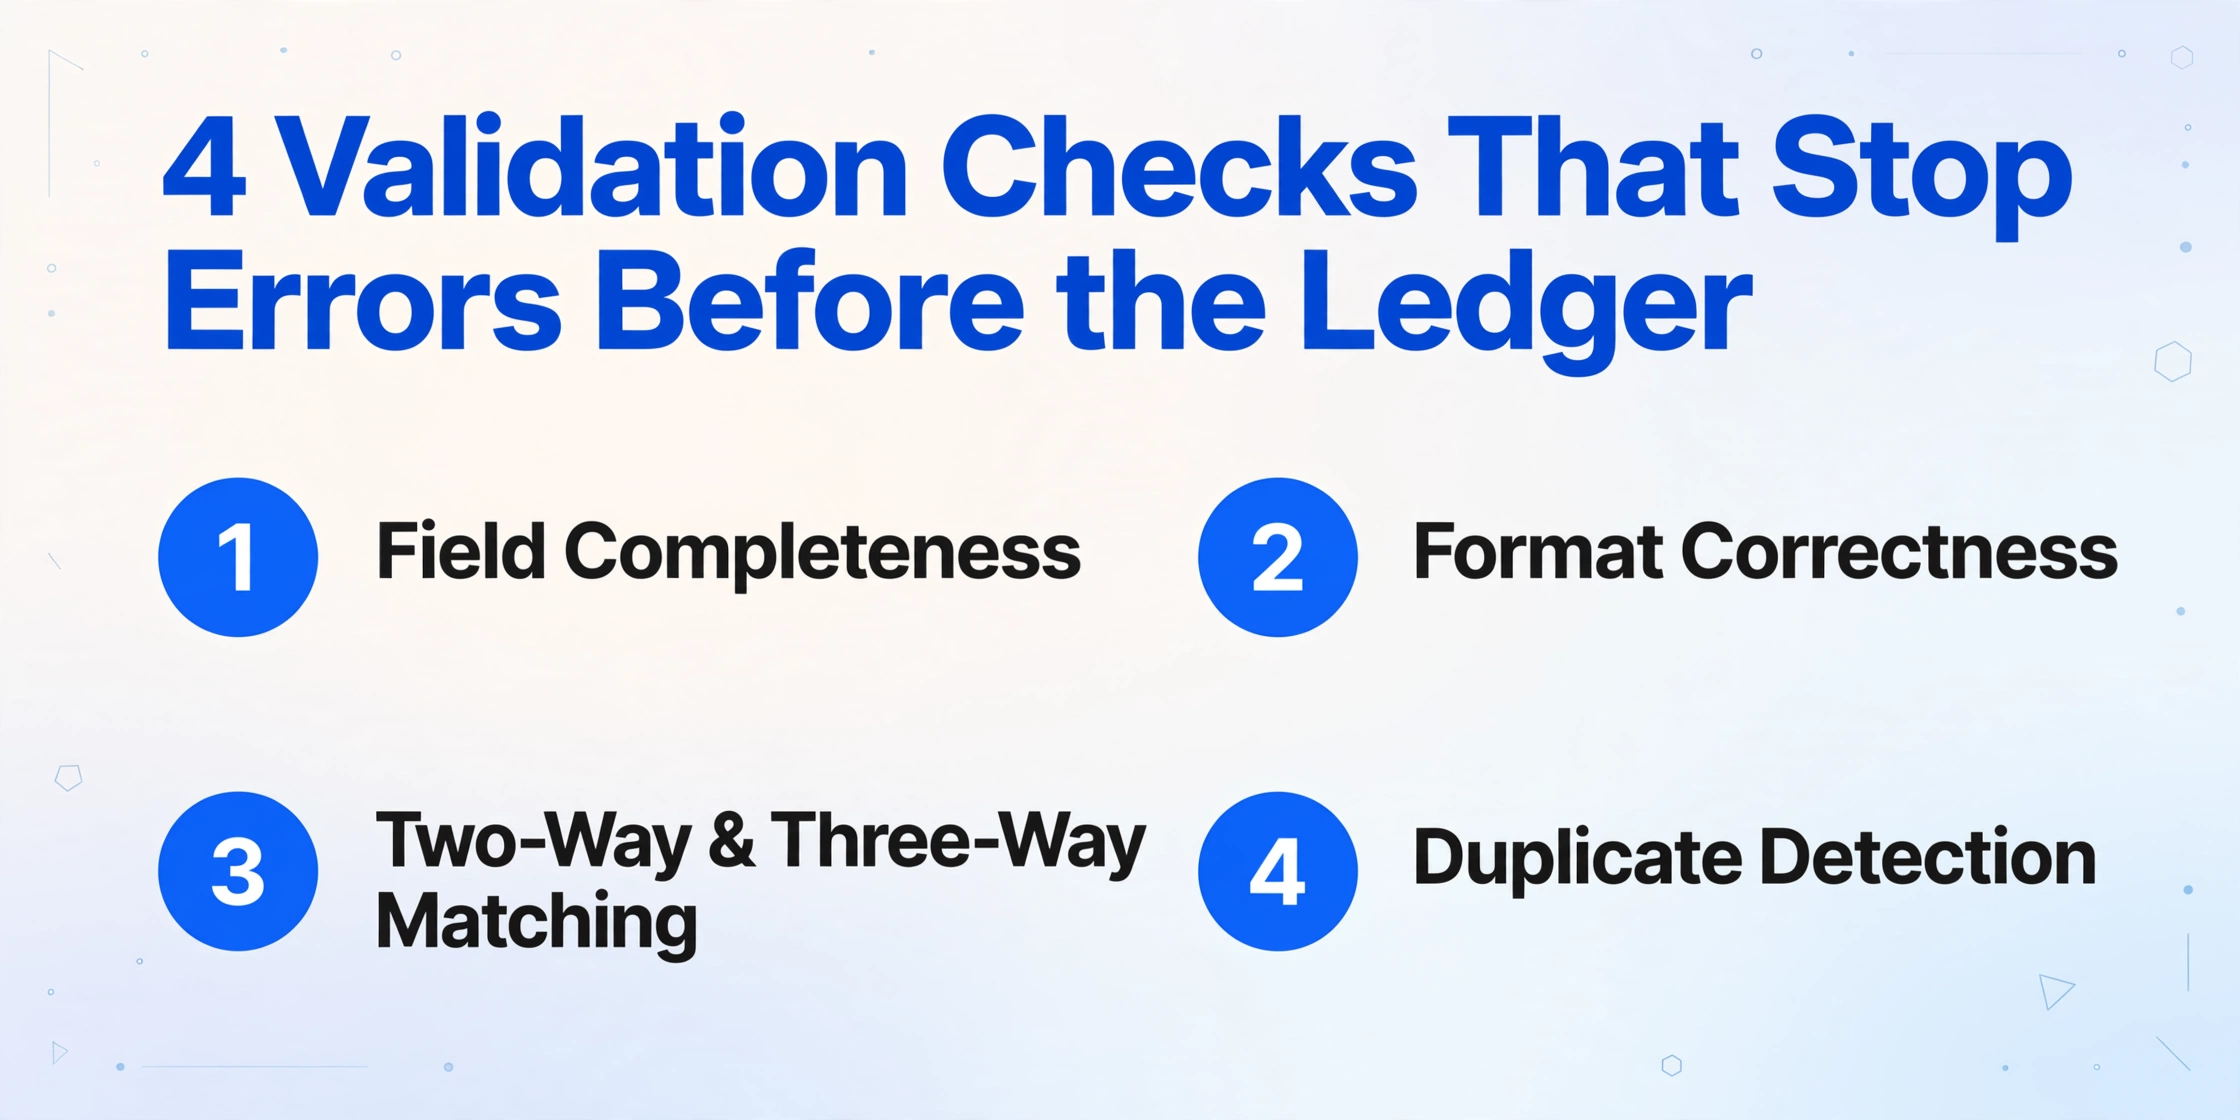
APにおける検証には、いくつかの異なるチェックが含まれます:
- フィールドの完全性。必須フィールドはすべて揃っていますか?請求書の日付の欠落、仕入先の税IDの欠落、または合計額の空白は、ERPに到達する前に請求書を停止させる必要があります。
- 形式の正確性。日付は期待される形式ですか?通貨額は、カンマを小数点区切りとして使用する可能性のある国際的な仕入先全体で正しく解析されていますか?AIは請求書の日付と支払期日を正しく区別しましたか?
- 二重照合と三重照合。請求書の金額は発注書と一致しますか?数量は納品書と一致しますか?三重照合(POと納品書と請求書)は、AP管理のゴールドスタンダードであり、上場企業にとっての中核的なSOXコンプライアンス要件です。
- 重複検出。この請求書はすでに処理されていますか?重複はバイト単位で同一のコピーであることはほとんどないため、簡単な目視チェックでは見逃されます。同じ請求書が2つの経路で届いたり、プレフィックスが異なる番号で2回入力されたりします。それを検出するには、バッチ全体を相互にチェックする必要があり、それが重複請求書検出が自動化するものです。
Ardent Partnersの2025年レポートによると、AP専門家の53%が請求書例外を最大の課題として挙げており、平均例外率は14%です。⁴ 最高水準のチームはこれを9%まで引き下げていますが、それでも請求書の約10件に1件は手動介入が必要であることを意味します。
残る例外には依然として人が必要ですが、レビューが請求書の再読取りを意味する必要はありません。ImageToTable.aiのレビュー画面は、抽出された各セルをそのソースに結び付けます。「Net Amount」セルにカーソルを合わせると、一致する領域が元のスキャン上でハイライトされます。領域をクリックすると、それが埋めたセルにジャンプします。スポットチェックは完全な再読取りではなく数秒になり、auto-annotateは誰かがファイルを開く前にハイライトを生成できます。
自動化で変わること:形式の自動標準化、重複フラグ付け、基本的なPO照合。AIは計算(合計が明細行の合計と一致するか)を検証し、必須フィールドの欠落にフラグを立て、請求書が人の手に渡る前に日付・通貨形式を正規化できます。
変わらないこと:不完全な納品データによる三重照合、価格設定に関する仕入先との紛争解決、品目明細の説明がPOの範囲と一致するかどうかの判断。これらには、メールのスレッド、契約書、人の記憶の中にあるコンテキストが必要であり、請求書のページにはありません。
書き出しと転記:会計ソフトへの橋渡し
ここが、単なる抽出ツールと、実際にAPのループを完結させるツールを分ける引き継ぎポイントです。請求書データを抽出し、検証しました。次に、それを会計システム(QuickBooks、Xero、NetSuite、SAP、または財務チームが使用するあらゆるERP)に取り込む必要があります。書き出しのステップでは、フォーマット互換性、バッチ処理、統合の深さによって、二重入力がまだ必要かどうかが決まります。
書き出しの最良のシナリオは直接統合です。抽出されたデータが会計ソフトに自動的に流れ込み、請求書(ベンダービル)が明細行、税コード、支払期日付きで作成されます。実際には、ほとんどの中小規模のAPチームはこの間に位置します。
- 手動での再入力。Excelに抽出し、その後同じデータをQuickBooksに手入力します。これは自動化の目的を無効にします。抽出時間は節約できても、再入力に時間を費やしているからです。
- CSV/Excelインポート。抽出ツールから書き出し、ERPのインポートテンプレートに合うようにスプレッドシートを整形し、アップロードします。改善ではありますが、フォーマット整形の手間を伴う手動の引き継ぎが残ります。
- スプレッドシートへの直接書き込み。ワークフローがスプレッドシート上で完結する場合、抽出結果はGoogle SheetsやExcelに直接書き込まれます。中間の書き出し・インポートステップはありません。ImageToTable.aiのGoogle SheetsアドオンとExcel書き出しは、このパターン向けに設計されています。抽出データが作業中のシートに直接追記されます。
書き出しの引き継ぎは、パイプライン設計が最も重要になるポイントです。抽出ツールがクリーンで構造化された出力を生成しても、会計システムに接続できなければ、パイプラインを自動化したことにはなりません。1つのステップを自動化し、次の引き継ぎポイントに新しい手動作業を生み出しただけです。IOFMのデータによると、データ入力ステップ(抽出)は手動で1件あたり約4分かかりますが、その後の転記と照合にはさらに3〜4分かかります。抽出を自動化しても手動での転記が必要なツールは、問題の半分しか解決していません。
バッチ書き出しはここで重要です。請求書を1件ずつ処理する(1件抽出、1件書き出し、1件転記)のでは拡張性がありません。バッチファースト設計とは、50枚の請求書を一度にアップロードし、50件すべてを並行して抽出し、バッチ全体を検証し、50行すべてを含む単一のスプレッドシートまたはCSVに書き出すことを意味します。「50件すべて抽出」から「50件すべて転記」までのステップは、1回の操作であるべきで、50回ではありません。その操作の実用的な形式、つまり50件の個別書き出しではなく、支払い準備完了ログに1請求書1行でまとめる方法は、バッチアップロードから買掛金(AP)ログを作成することです。
自動化が置き換えない人間のステップ
APパイプラインのすべてのステップを自動化すべきではありません。現在のAIが確実に提供できない判断を必要とするステップもあれば、組織がモデルに委任すべきではないコンプライアンスや受託者責任を伴うステップもあります。
承認ステップが最も明確な例です。45,000ドルの設備請求書をレビューするAPマネージャーは、単に数字が合っているかを確認しているわけではありません。設備が実際に受領されたか、価格が交渉済みの契約と一致するか、予算に余裕があるか、購入が適切に承認されたかを検証しています。これらはガバナンス上の決定であり、データ入力の決定ではありません。自動化は請求書を適切な承認者にルーティングし、関連するコンテキスト(PO詳細、受領状況、残予算)を表示できますが、支払いを承認すべきではありません。これが、Ardent Partnersのデータがベストインクラスのタッチレス処理率を49.2%と示す理由であり、100%ではない理由です。残りの50.8%の請求書には、人間の監視が有効な承認、例外解決、複雑な検証が含まれます。
GLコードとコストセンターの割り当てはグレーゾーンにあります。AIはベンダーと説明に基づいてGL勘定科目を提案できます。また、継続的な取引先では正確に当てることが多いですが、資本化と費用化の判断、または単一の請求書を複数のコストセンターに配分する判断には、ビジネスコンテキストを理解する財務担当者が必要です。
重要な原則:人間が遅くエラーを起こしやすい機械的なステップ(フィールドの読み取り、データ入力、形式チェック)を自動化し、人間が価値を付加する判断ステップ(承認、紛争解決、戦略的配分)を保持します。パイプラインが速くなるのは、人間が排除されるからではなく、人間が本来得意でない部分から解放されるからです。
パイプラインが壊れる箇所:形式の断片化と統合のギャップ
ほとんどのAP自動化の失敗には共通の根本原因があります:パイプラインは最も弱い引き継ぎポイントと同じ強さしかありません。請求書データを完璧に抽出してもERPにエクスポートできないツールは、壊れたパイプラインです。取り込みと抽出を自動化しても検証を完全に手動のままにするワークフローは、依然としてボトルネックを生み出します。パイプラインがどこで壊れるかを理解することで、デモのステップ2だけではなく、実際のワークフローに基づいてツールを評価できます。
最も一般的な2つの失敗ポイント:
抽出ステップでの形式の断片化。これはRedditユーザーが説明した内容です。一部のベンダー形式では機能するが、他の形式では機能しないOCR。従来のテンプレートベースのOCRは、新しいベンダー形式ごとに新しいテンプレートが必要になるため、ここで失敗します。産業サプライヤー、サービスプロバイダー、国際的なベンダーはすべて請求書の形式が異なります。ここでこそ、セマンティックAI抽出が変革的です。位置ではなく意味に基づいてフィールドを特定することで、限界費用ゼロで形式のバリエーションを処理します。200のテンプレートを維持する必要はありません。1セットの列名を維持するだけです。
エクスポートステップでの統合ギャップ。データは抽出されクリーンですが、ERPに取り込むには再フォーマット、手動のCSVマッピング、または最悪の場合、再入力が必要です。エクスポートの引き継ぎは、バッチ処理が不可欠になるポイントです。50件の請求書を抽出処理し、その後すべてを1回の操作でエクスポートすることで、同じエクスポートワークフローの49回の繰り返しを排除します。Google Sheetsを主要なAPトラッカーとして使用するチームにとって、アドオンアプローチ(抽出データがシートに直接書き込まれる)は、エクスポートの引き継ぎを完全に排除します。
パイプラインのテスト。AP自動化ツールを評価する際は、CoupaやMediusのようなエンタープライズプラットフォームでも、軽量な抽出ツールでも、実際のワークフローにおける5つの引き継ぎポイント(取り込み、抽出、検証、エクスポート、承認)すべてに照らして評価してください。抽出で10/10でもエクスポートで0/10のツールは、古いボトルネックを除去した場所に新しいボトルネックを作り出します。パイプライン全体の速度は、依然として最も遅いステップに制限されます。
FAQ
ImageToTable.aiはQuickBooksやNetSuiteと直接統合できますか?
ImageToTable.aiはネイティブなERP統合を提供していません。抽出されたデータは、Excel(XLSX)、CSV、またはアドオン経由でGoogle Sheetsに直接エクスポートされます。QuickBooksとXeroのユーザーは、バッチをExcelにエクスポートし、会計ソフトのインポート機能を使用する必要があります。通常は30秒のステップです。NetSuiteとSAPのユーザーには、CSV形式が標準のインポートテンプレートに対応します。ERPにAPIレベルの統合が必要な場合は、ミドルウェアのステップか、その特定の引き継ぎ用に構築されたツールが必要になります。
1回のバッチで処理できる請求書は何枚ですか?
無料プランでは処理できるファイル数に制限があり、有料プランはそこから拡張されます:Basic(月額$9)は中程度のボリュームのチーム向け、Pro(月額$19)はより高いスループットに対応、Max(月額$59)は最も高いクレジット割り当てで大量のバッチ処理向けに設計されています。各有料プランにはバッチあたりの上限も設定されています — Basicは100ファイル、Proは200、Maxは300 — そしてバッチ内の各ファイルは1クレジットを消費します。50枚の請求書のバッチは50クレジットを消費し、すべての有料プランの範囲内に十分収まります。処理自体は並列化されています:バッチ内の請求書は同時に抽出されるため、50枚の請求書は5枚とほぼ同じ実時間で完了します。
手書きの請求書や紙のスキャンは処理できますか?
はい。抽出を担うビジョン言語モデルは、手書き、印刷テキスト、表、チェックボックスを読み取ります。紙の請求書の場合は、先にスキャンまたは撮影する必要があります — アップロードはJPG、PNG、PDF、WebPに対応しています。手書きの精度は読みやすさに依存します:明確なブロック体は確実に抽出されますが、乱雑な筆記体や強い取り消し線がある場合は精度が低くなり、検証中に手動レビューが必要になる場合があります。
複数通貨の請求書ではどうなりますか — 金額を混同しませんか?
AIは請求書から通貨記号またはコード(USD、EUR、GBP、JPYなど)を直接読み取り、抽出された出力に含めます。請求書の通貨と、現地通貨で記載された税額を区別します。後処理では、必要に応じて計算列を使用して換算レートを適用できます — 例えば、抽出された金額に固定為替レートを掛ける列を定義できます。このツールは通貨を自動変換しません。これはより安全な動作です:通貨換算は明示的なステップであるべきであり、AIが黙って決定するものではありません。
ベンダーごとにテンプレートを設定する必要がありますか?
いいえ。これがテンプレートベースのOCRとAI駆動型抽出の核心的な違いです。ImageToTable.aiでは、抽出したい列名を定義するだけで — 「請求書番号」「仕入先」「PO番号」「正味金額」「税額」「合計」— AIがベンダーのレイアウトに関係なく、各請求書からこれらのフィールドを自動的に見つけ出します。列設定はツール内で再利用可能なテンプレートとして保存できますが、そのテンプレートが定義するのは「何を」抽出するかであり、「どこから」抽出するかではありません。まったく馴染みのない請求書形式の新しいベンダーでも、ファイルをアップロードする以外の設定は一切不要です。
ツールが読み取れる形式で請求書を送ってもらうにはどうすればよいですか?
サプライヤーに請求書の送り方を変えてもらう必要はありません。このツールは、ほぼすべてのサプライヤーがすでに使用しているPDF、画像、スクリーンショットに対応しています。取り込み工程をさらに効率化したい場合は、コレクションリンク機能をご利用ください。共有可能なURLを生成してサプライヤーに送信すれば、サプライヤーは請求書を直接あなたの処理キューにアップロードできます。サプライヤー側での登録やログインは不要です。これにより、メールの添付ファイルを探す手間がワークフローから完全に排除されます。
どの程度の精度が期待できますか?また、出力を再確認すべきタイミングはいつですか?
印刷された請求書データは、一般的なフィールド(日付、金額、仕入先名)で最大99%の精度を達成します。手書き文字やスキャン品質の低い文書では精度が低下します。実用的な目安として、クリーンなPDF請求書を送ってくる定期的なベンダーの場合は、検証時に10件ごとに1件をサンプルチェックしてください。初回のベンダー、手書きの請求書、複雑な明細行テーブルを含む請求書の場合は、転記前に抽出結果全体を確認してください。検証ステップが存在するのには理由があります — 自動抽出により、チェック作業が「すべての請求書のすべてのフィールドを読む」ことから「エッジケースを確認する」ことに軽減されますが、人間によるレビューの必要性が完全になくなるわけではありません。
APデータ入力パイプラインには5つの引き継ぎポイントがあります。そのうち2つを自動化するのは出発点にすぎません。4つを自動化し — 5つ目は人間の判断のために残す — ことが、請求書1件あたり$9.40と$2.78の測定可能なコスト差が実際に生まれるポイントです。